为什么值得把 LLaMA 的架构单独拎出来看
现在做 Agent、RAG、微调,绕不开开源权重模型。而开源权重模型里,LLaMA 系列的架构几乎成了事实上的"公共底座":Qwen、Baichuan、InternLM、DeepSeek 早期的很多设计,都能看到 LLaMA 结构的影子。所以与其一个个去看各家模型的论文,不如先把 LLaMA 这条主线吃透,再看别的模型时会快很多。
这篇文章不讲训练数据怎么清洗、不讲 RLHF 怎么做,只聚焦一件事:从 LLaMA 1 到 LLaMA 3,Transformer 结构本身改了什么,为什么这么改。我会按版本顺序走,每个版本挑出真正影响推理和微调的改动来讲,并给出对应的最小代码实现。
需要提前说明的是:Meta 对 LLaMA 3 的完整技术报告披露程度比 LLaMA 1/2 高很多,但仍有部分细节(比如具体的数据配比)没有公开。文中凡是涉及这类信息,我会明确写出来,不做推测性描述。
LLaMA 1 定下的骨架:几个当时不算主流的选择
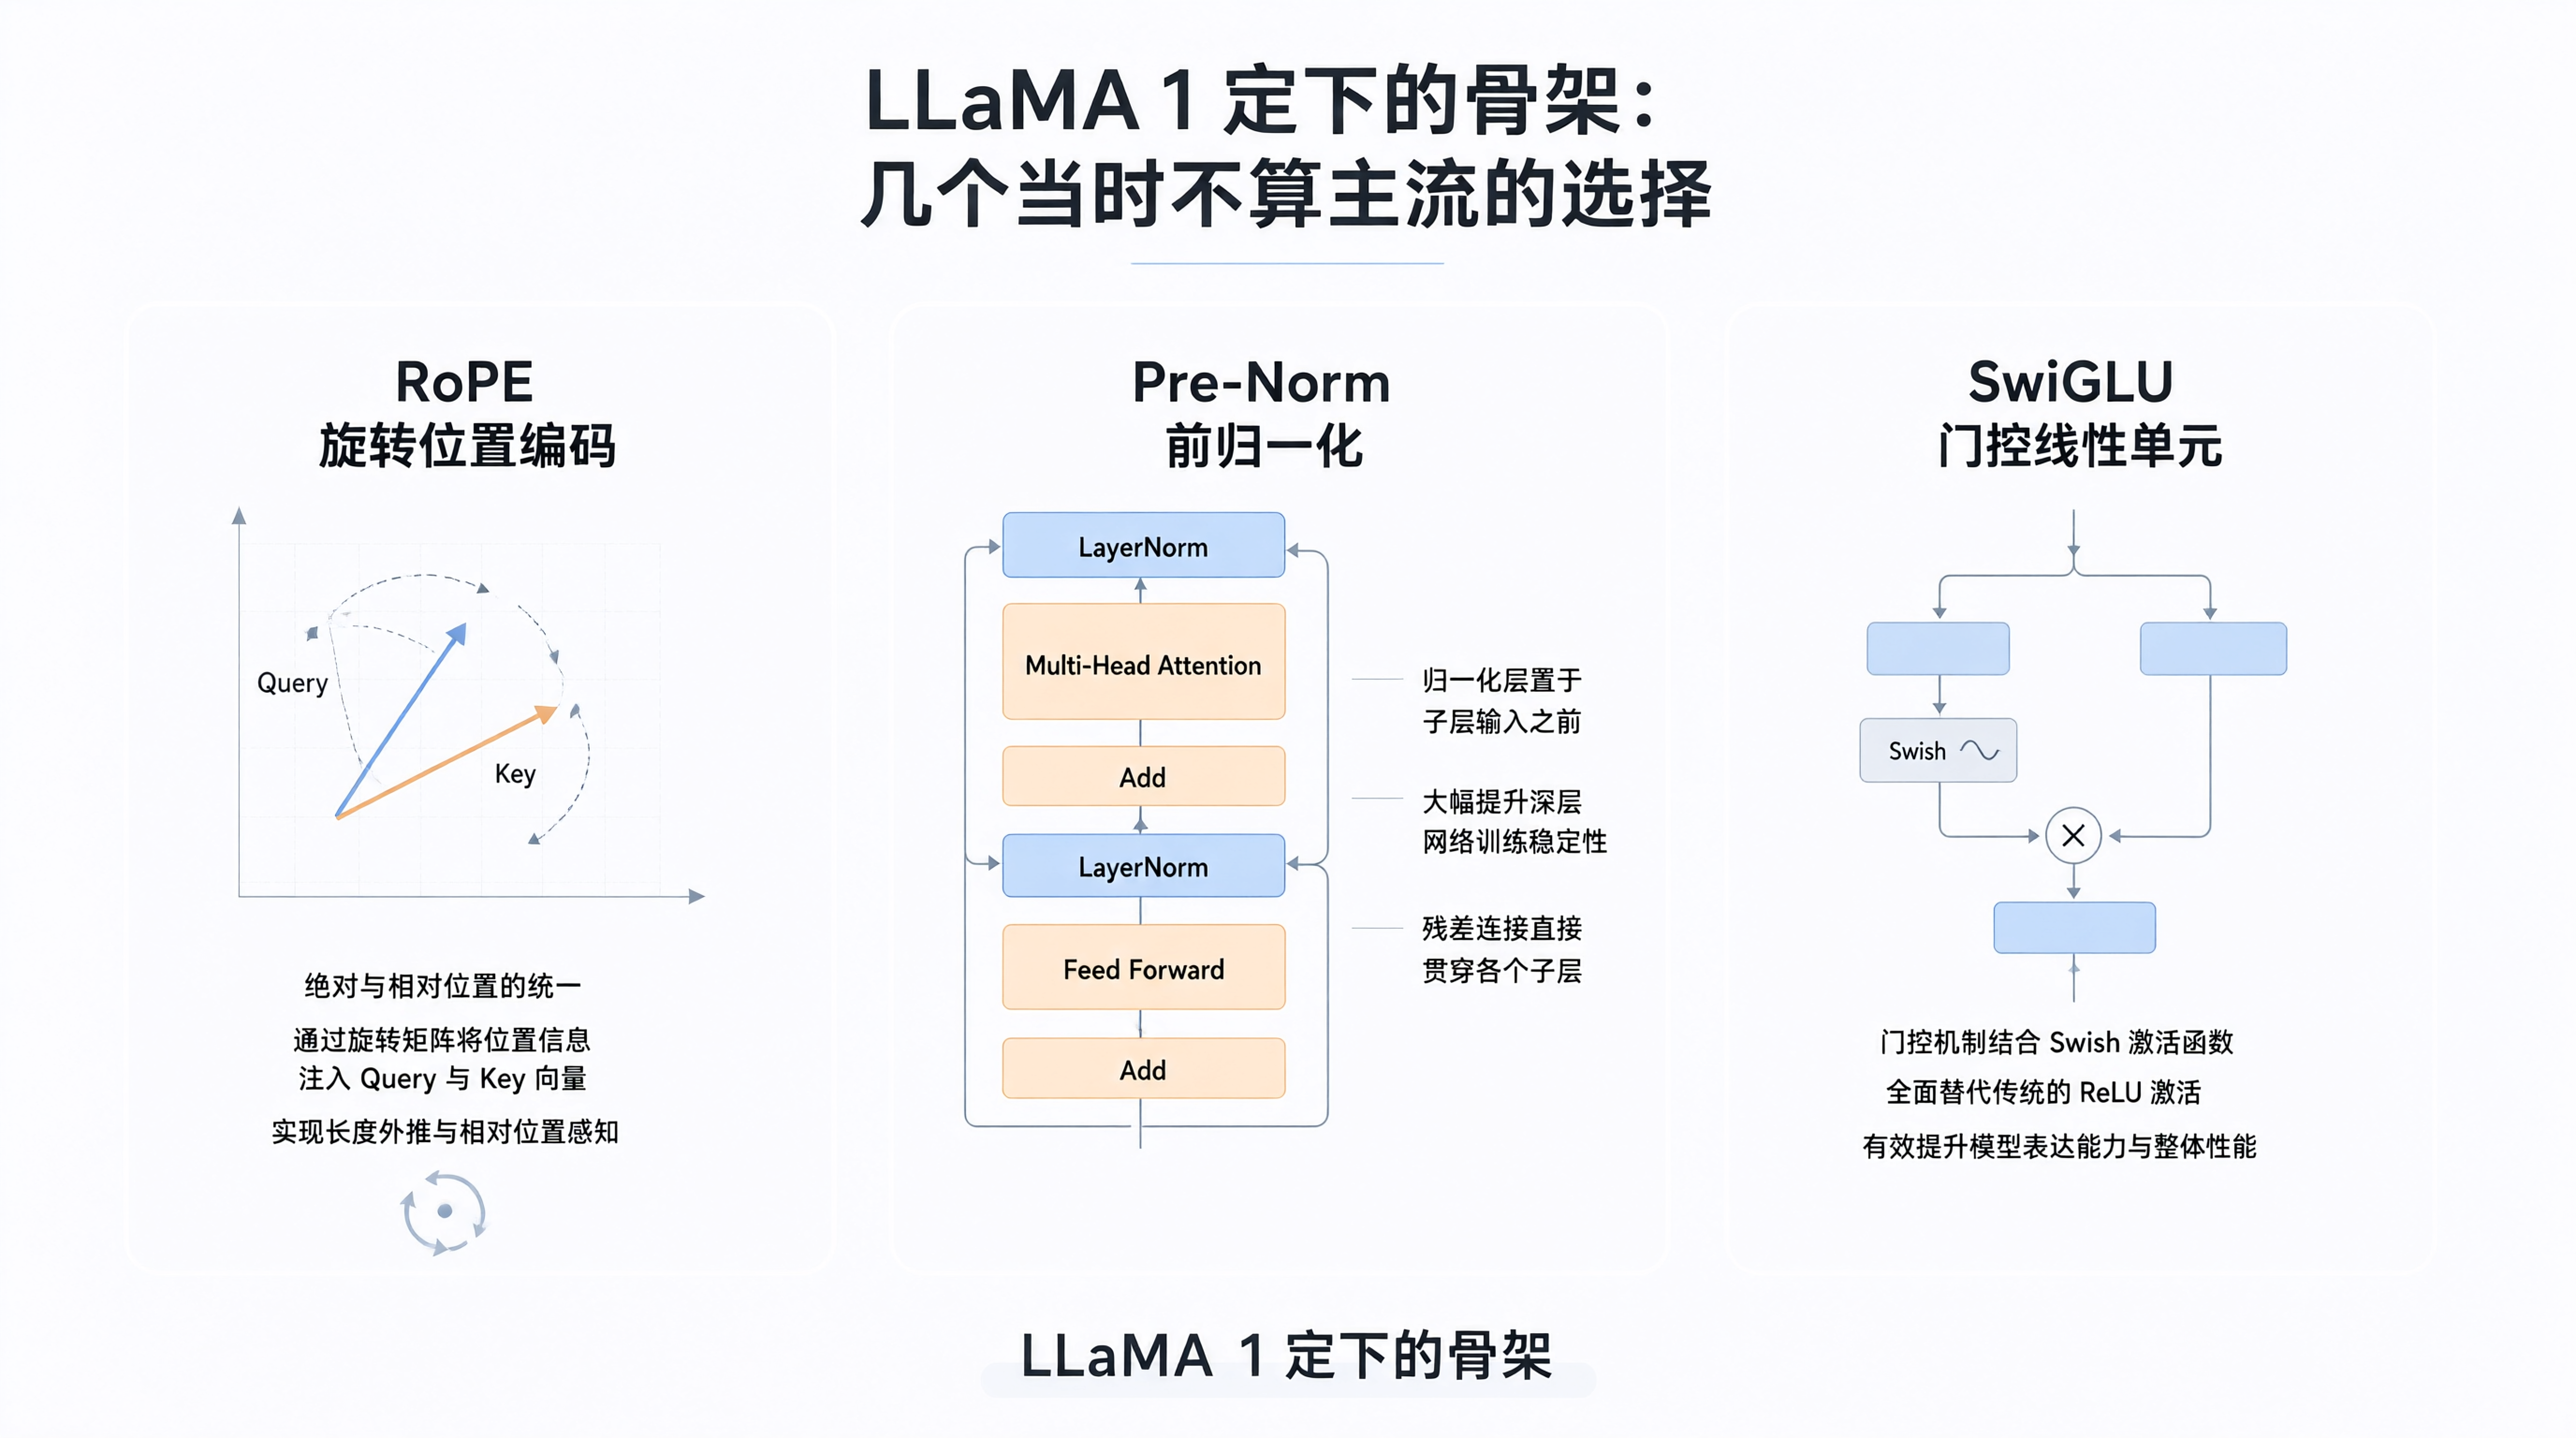
LLaMA 1 在 2023 年初发布,参数量从 7B 到 65B。它最有意思的地方不是"又一个大模型",而是它在几个关键位置做了和 GPT-3 不一样的选择,而这些选择后来被大量模型抄走。
位置编码用 RoPE,而不是可学习的位置嵌入
GPT 系列早期用的是可学习的位置嵌入(learned positional embedding),把位置当成一个可训练的向量加到 token embedding 上。这种方式的问题在于:训练时见过的最大长度就是模型能处理的最大长度,超了就没法外推。
LLaMA 用的是 RoPE(Rotary Position Embedding)。它的做法是不去"加"位置信息,而是对 Query 和 Key 向量做旋转,旋转角度由位置决定。这样两个 token 之间的注意力分数天然只依赖它们的相对距离。
RoPE 的核心实现大概是这样:
python
import torch

def precompute_freqs_cis(dim: int, end: int, theta: float = 10000.0):
    # dim 是 head_dim,必须是偶数
    freqs = 1.0 / (theta ** (torch.arange(0, dim, 2)[: (dim // 2)].float() / dim))
    t = torch.arange(end, device=freqs.device)
    freqs = torch.outer(t, freqs).float()  # (end, dim//2)
    freqs_cis = torch.polar(torch.ones_like(freqs), freqs)  # 转成复数
    return freqs_cis

def apply_rotary_emb(xq, xk, freqs_cis):
    # xq, xk: (B, T, n_heads, head_dim)
    xq_ = torch.view_as_complex(xq.float().reshape(*xq.shape[:-1], -1, 2))
    xk_ = torch.view_as_complex(xk.float().reshape(*xk.shape[:-1], -1, 2))
    freqs_cis = freqs_cis[: xq.shape[1]].view(1, xq.shape[1], 1, -1)
    xq_out = torch.view_as_real(xq_ * freqs_cis).flatten(3)
    xk_out = torch.view_as_real(xk_ * freqs_cis).flatten(3)
    return xq_out.type_as(xq), xk_out.type_as(xk)
这里用复数乘法来做旋转,是把二维平面上的旋转写成复数乘法的形式,代码比手写 cos/sin 矩阵干净。注意 theta 在 LLaMA 1 里是 10000,这个值在后面 LLaMA 3 长上下文版本里被调过,后面会讲。
RoPE 带来的实际好处是:模型在短序列上训练,推理时对更长序列有一定外推能力(注意是"一定",不是无限)。这也是后来所有做长上下文的模型都基于 RoPE 做改造的原因。
Pre-Norm + RMSNorm
原始 Transformer 用的是 Post-Norm,也就是 LayerNorm(x + Sublayer(x))。这种结构在深层网络里训练不稳定,需要小心调 warmup。LLaMA 用的是 Pre-Norm,把归一化放到子层前面:
python
class RMSNorm(torch.nn.Module):
    def __init__(self, dim: int, eps: float = 1e-6):
        super().__init__()
        self.eps = eps
        self.weight = torch.nn.Parameter(torch.ones(dim))

    def _norm(self, x):
        return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + self.eps)

    def forward(self, x):
        return self._norm(x.float()).type_as(x) * self.weight
同时它把 LayerNorm 换成了 RMSNorm。区别是 RMSNorm 不减均值,只做均方根归一化。少了一次均值计算,也少了一个 bias 参数。这个改动在效果上基本无损,但计算量小一些。社区里有人做过对比实验,结论是 RMSNorm 和 LayerNorm 在同等规模下差异很小,主要收益在速度。
SwiGLU 替代 ReLU FFN
FFN 层 LLaMA 用的是 SwiGLU,结构是三个线性层加一个门控:
python
class FeedForward(torch.nn.Module):
    def __init__(self, dim: int, hidden_dim: int, multiple_of: int = 256):
        super().__init__()
        hidden_dim = int(2 * hidden_dim / 3)
        # 对齐到 multiple_of 的整数倍,方便硬件加速
        hidden_dim = multiple_of * ((hidden_dim + multiple_of - 1) // multiple_of)
        self.w1 = torch.nn.Linear(dim, hidden_dim, bias=False)
        self.w2 = torch.nn.Linear(hidden_dim, dim, bias=False)
        self.w3 = torch.nn.Linear(dim, hidden_dim, bias=False)

    def forward(self, x):
        return self.w2(torch.nn.functional.silu(self.w1(x)) * self.w3(x))
注意这里 hidden_dim 乘的是 2/3,因为 SwiGLU 有三个矩阵而不是两个,为了保持总参数量和标准 FFN 接近,要把中间维度压下来。这个 2/3 是经验值,不是推导出来的。另外 multiple_of=256 是为了让维度对齐到硬件友好的数值,这一点在 LLaMA 1 论文里没有明说,是从官方实现里看到的。
【关键结论】LLaMA 1 的这几个改动------RoPE、Pre-Norm、RMSNorm、SwiGLU------后来基本成了开源 LLM 的默认配置。你现在看任何一个 2023 年之后的开源模型,大概率能同时看到这四个。
LLaMA 2:架构基本没动,改动在别处
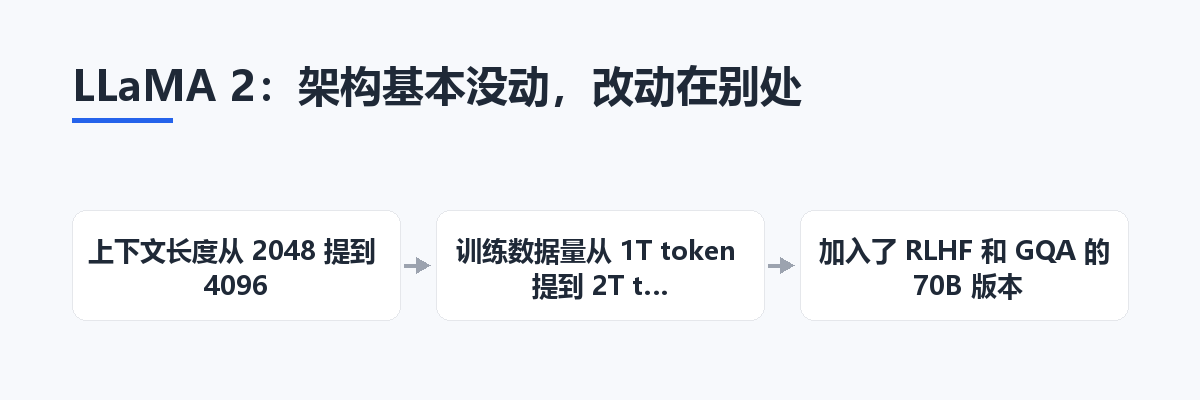
LLaMA 2 在 2023 年 7 月发布。如果只看架构,它和 LLaMA 1 几乎一模一样。真正的变化在三个地方:
- 上下文长度从 2048 提到 4096 。这个改动对 RoPE 的
theta值没有调整,直接扩大训练长度。 - 训练数据量从 1T token 提到 2T token。这个和架构无关,但直接决定了模型的知识密度。
- 加入了 RLHF 和 GQA 的 70B 版本。注意,LLaMA 2 只有 70B 用了 GQA,7B 和 13B 还是标准的多头注意力。
GQA(Grouped Query Attention)是什么,值得单独说一下,因为它是 LLaMA 3 全系采用的关键改动。
标准多头注意力里,Query、Key、Value 的 head 数量相同。推理时 KV Cache 的大小和 head 数成正比。当序列很长、batch 很大时,KV Cache 会吃掉大量显存。
GQA 的做法是让多个 Query head 共享一组 Key/Value head。比如 32 个 Query head 分成 8 组,每组 4 个 Query 共享 1 个 KV head。这样 KV Cache 直接降到原来的 1/4。
python
class Attention(nn.Module):
    def __init__(self, n_heads, n_kv_heads, dim):
        super().__init__()
        self.n_heads = n_heads
        self.n_kv_heads = n_kv_heads
        self.head_dim = dim // n_heads
        self.wq = nn.Linear(dim, n_heads * self.head_dim, bias=False)
        self.wk = nn.Linear(dim, n_kv_heads * self.head_dim, bias=False)
        self.wv = nn.Linear(dim, n_kv_heads * self.head_dim, bias=False)
        self.wo = nn.Linear(n_heads * self.head_dim, dim, bias=False)

    def forward(self, x, freqs_cis, mask):
        B, T, _ = x.shape
        xq = self.wq(x).view(B, T, self.n_heads, self.head_dim)
        xk = self.wk(x).view(B, T, self.n_kv_heads, self.head_dim)
        xv = self.wv(x).view(B, T, self.n_kv_heads, self.head_dim)

        xq, xk = apply_rotary_emb(xq, xk, freqs_cis)

        # 关键:把 kv head 复制到和 q head 一样多
        xk = xk.repeat_interleave(self.n_heads // self.n_kv_heads, dim=2)
        xv = xv.repeat_interleave(self.n_heads // self.n_kv_heads, dim=2)

        # ... 后续标准注意力计算
repeat_interleave 这一步在训练时是显式复制,推理时很多实现会直接在 kernel 里处理,不真的复制张量。这里写出来是为了让逻辑清楚。
GQA 相比 MQA(Multi-Query Attention,所有 Query 共享一组 KV)折中得更好:MQA 压缩太狠,效果掉得明显;GQA 在压缩率和效果之间取了个平衡点。LLaMA 2 70B 用 GQA 的实测效果,Meta 在论文里说和标准 MHA 接近,但这个结论我没有自己复现过。
LLaMA 3:词表扩张才是最大的改动
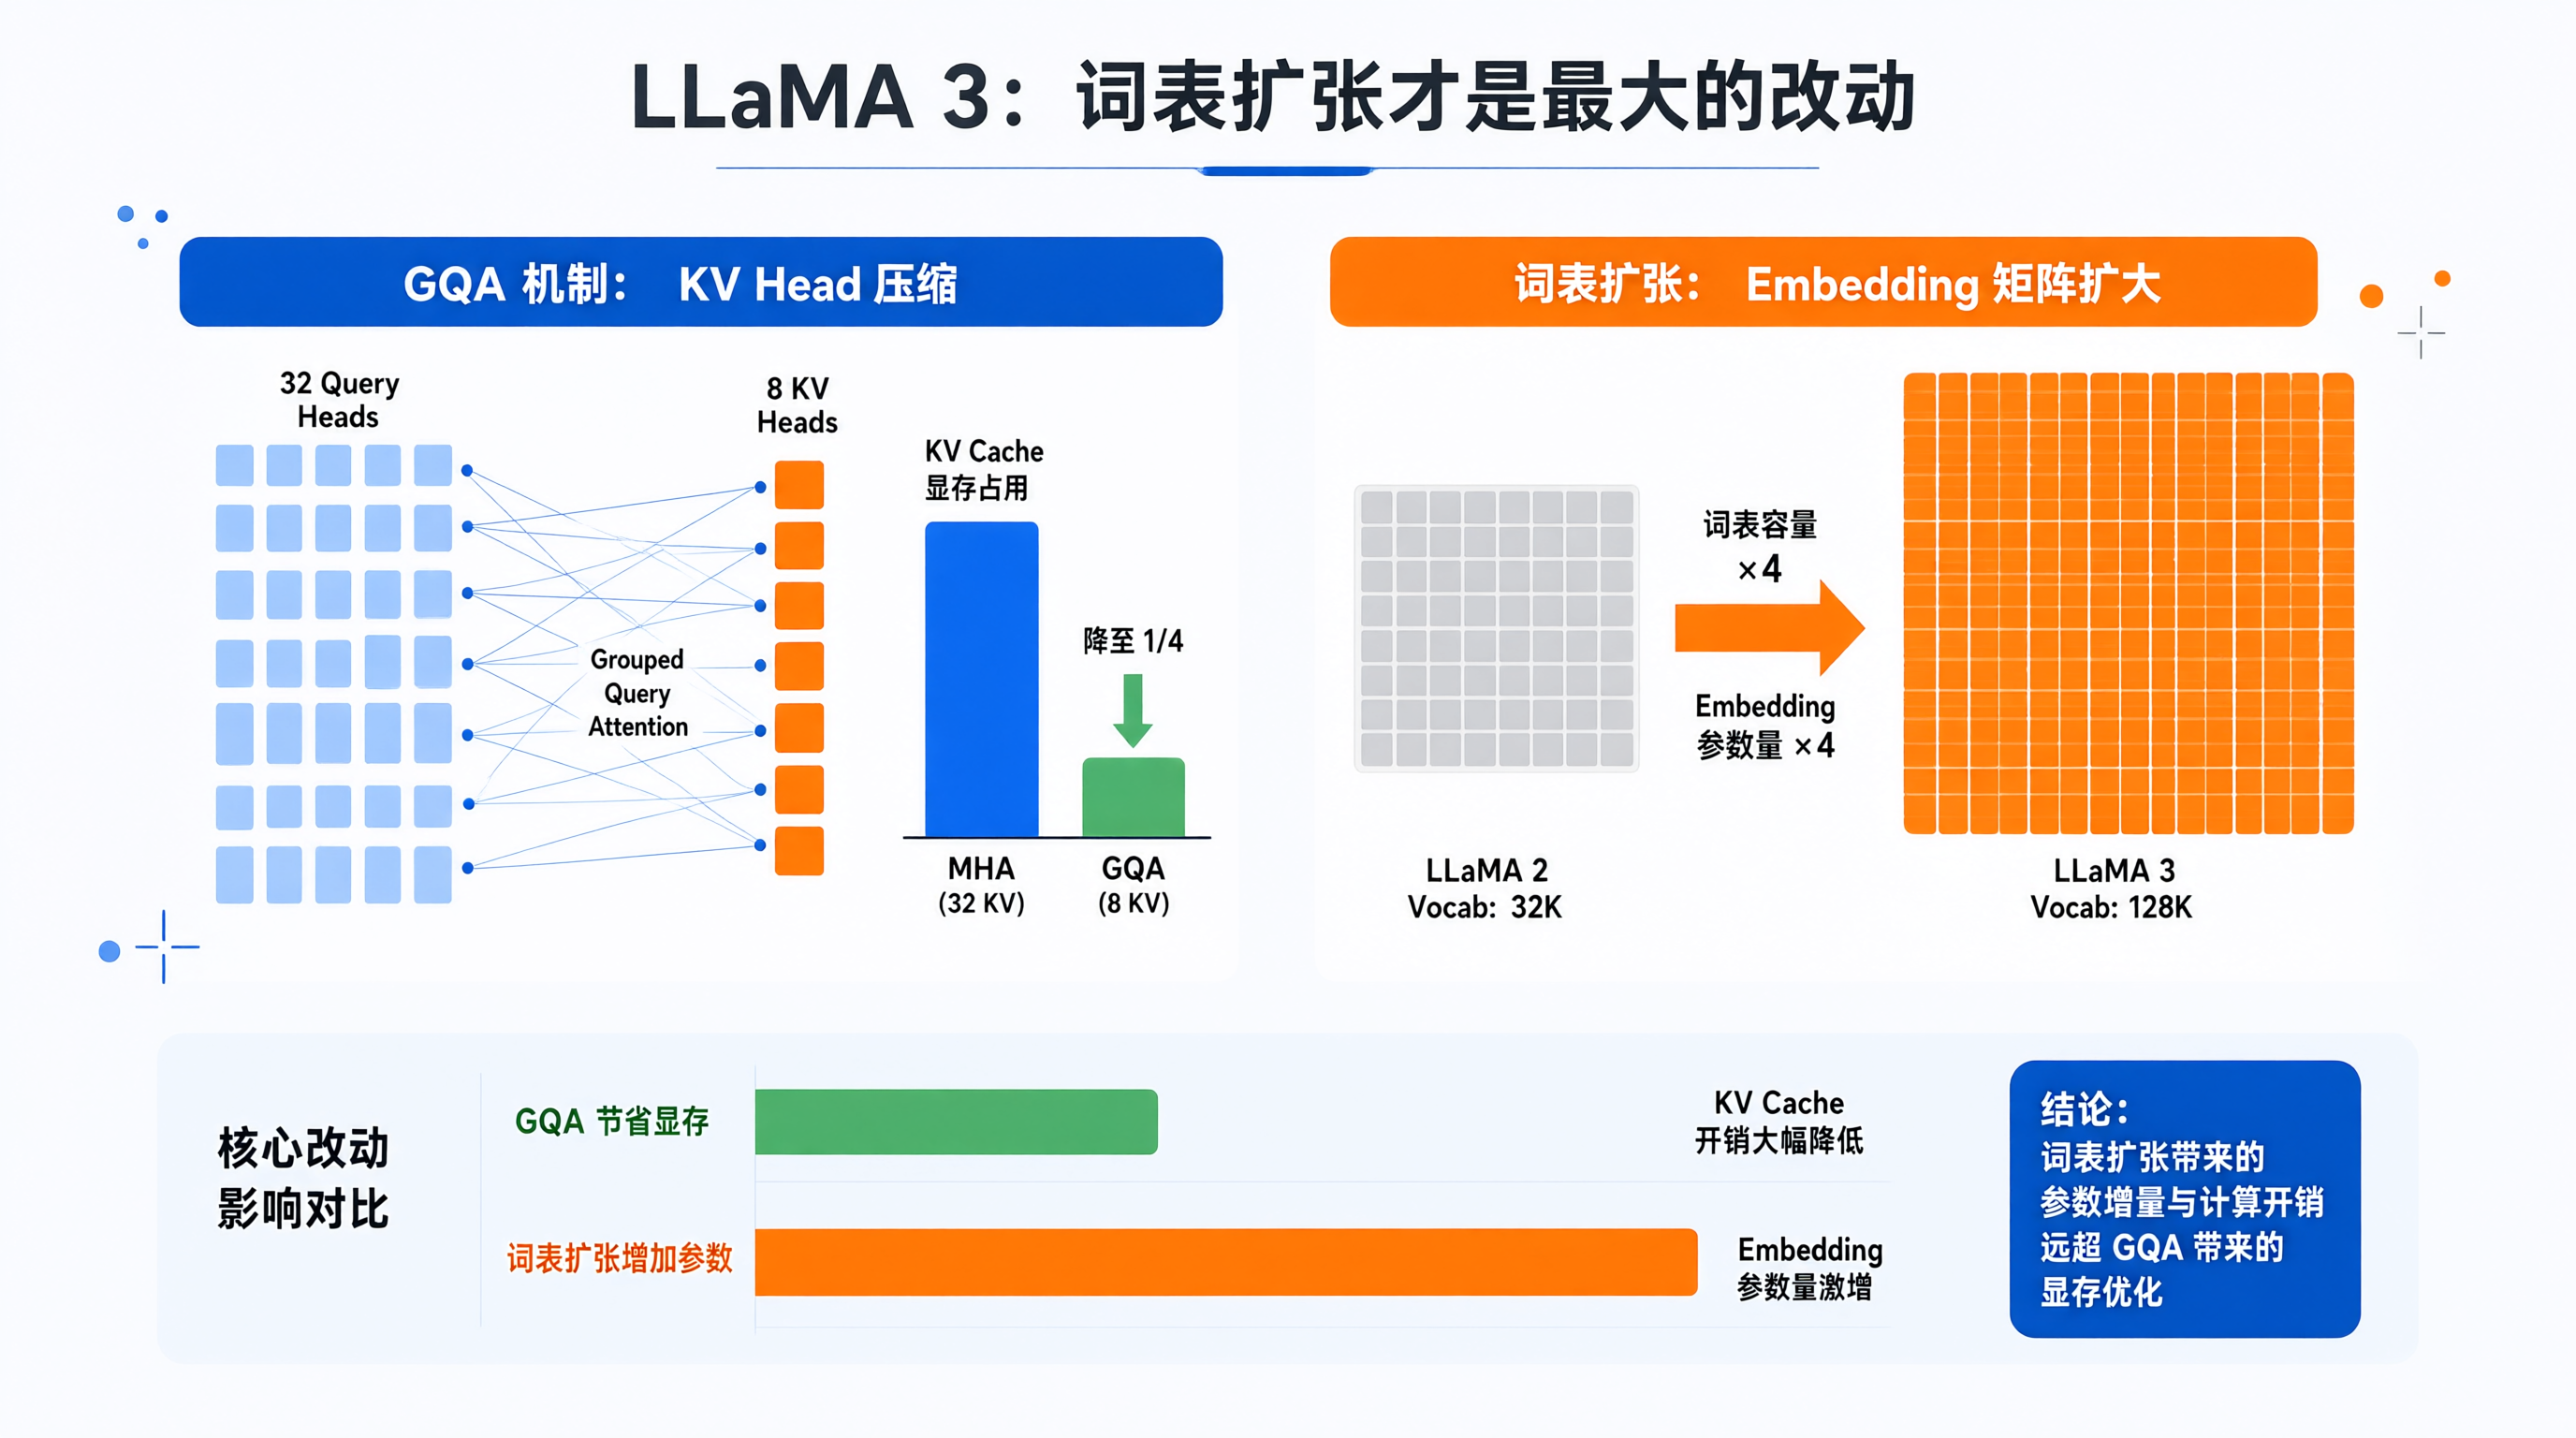
LLaMA 3 在 2024 年 4 月发布,先出 8B 和 70B,后来补了 405B。架构上最值得说的改动有两个,而且这两个改动的影响完全不在一个量级。
全系采用 GQA
LLaMA 2 只有 70B 用 GQA,LLaMA 3 从 8B 到 405B 全部用。8B 的配置是 32 个 Query head、8 个 KV head,压缩比 4:1。这个改动对显存的影响是实打实的:部署 8B 模型时,长上下文场景下 KV Cache 不再是瓶颈。
词表从 32K 扩到 128K
这个改动比 GQA 影响更大,但经常被忽略。
LLaMA 1/2 用的是 SentencePiece BPE,词表 32000。LLaMA 3 换成了基于 tiktoken 的 BPE,词表 128256。为什么扩词表这么重要?
考虑中文场景。LLaMA 2 的 32K 词表对中文支持很差,一个常见汉字经常被切成 2-3 个 token。同样一段中文文本,用 LLaMA 2 的分词器编码出来,token 数可能是英文的 2 倍以上。这直接导致两个后果:一是有效上下文被压缩,二是推理成本翻倍。
词表扩到 128K 后,中文的 token 效率明显改善。我实际用 LLaMA 3 的 tokenizer 和 LLaMA 2 的对比过同一段中文文本,前者 token 数大约是后者的一半左右。这个数字会随文本内容变化,但量级上的差异是确定的。
【踩坑提醒】如果你要基于 LLaMA 3 做微调,词表变化意味着 embedding 层和 lm_head 的参数量变了。从 32000×4096 变成 128256×4096,8B 模型光这两层就多了接近 4 亿参数。加载旧版 LLaMA 2 的微调权重到 LLaMA 3 上是不可能的,必须重新训练。
上下文长度和 RoPE theta
LLaMA 3 初始版本上下文是 8K。后来 Meta 通过调整 RoPE 的 theta 值,把上下文扩到了 128K。
这里涉及 RoPE 的一个性质:theta 越大,不同位置的旋转频率差异越小,位置编码能覆盖的范围就越长。LLaMA 1/2 用的是 10000,长上下文版本会调到 500000 甚至更大。
python
# 长上下文版本典型配置
freqs_cis = precompute_freqs_cis(
    dim=head_dim,
    end=max_seq_len * 2,
    theta=500000.0  # 而不是默认的 10000
)
需要说明的是,单纯改 theta 并不能直接把模型外推到任意长度,通常还需要配合继续训练(continued pretraining)来让模型适应新的位置分布。Meta 在 LLaMA 3 的长上下文版本上做了这一步,但具体训练细节公开得不完整。
三个版本放在一起对比
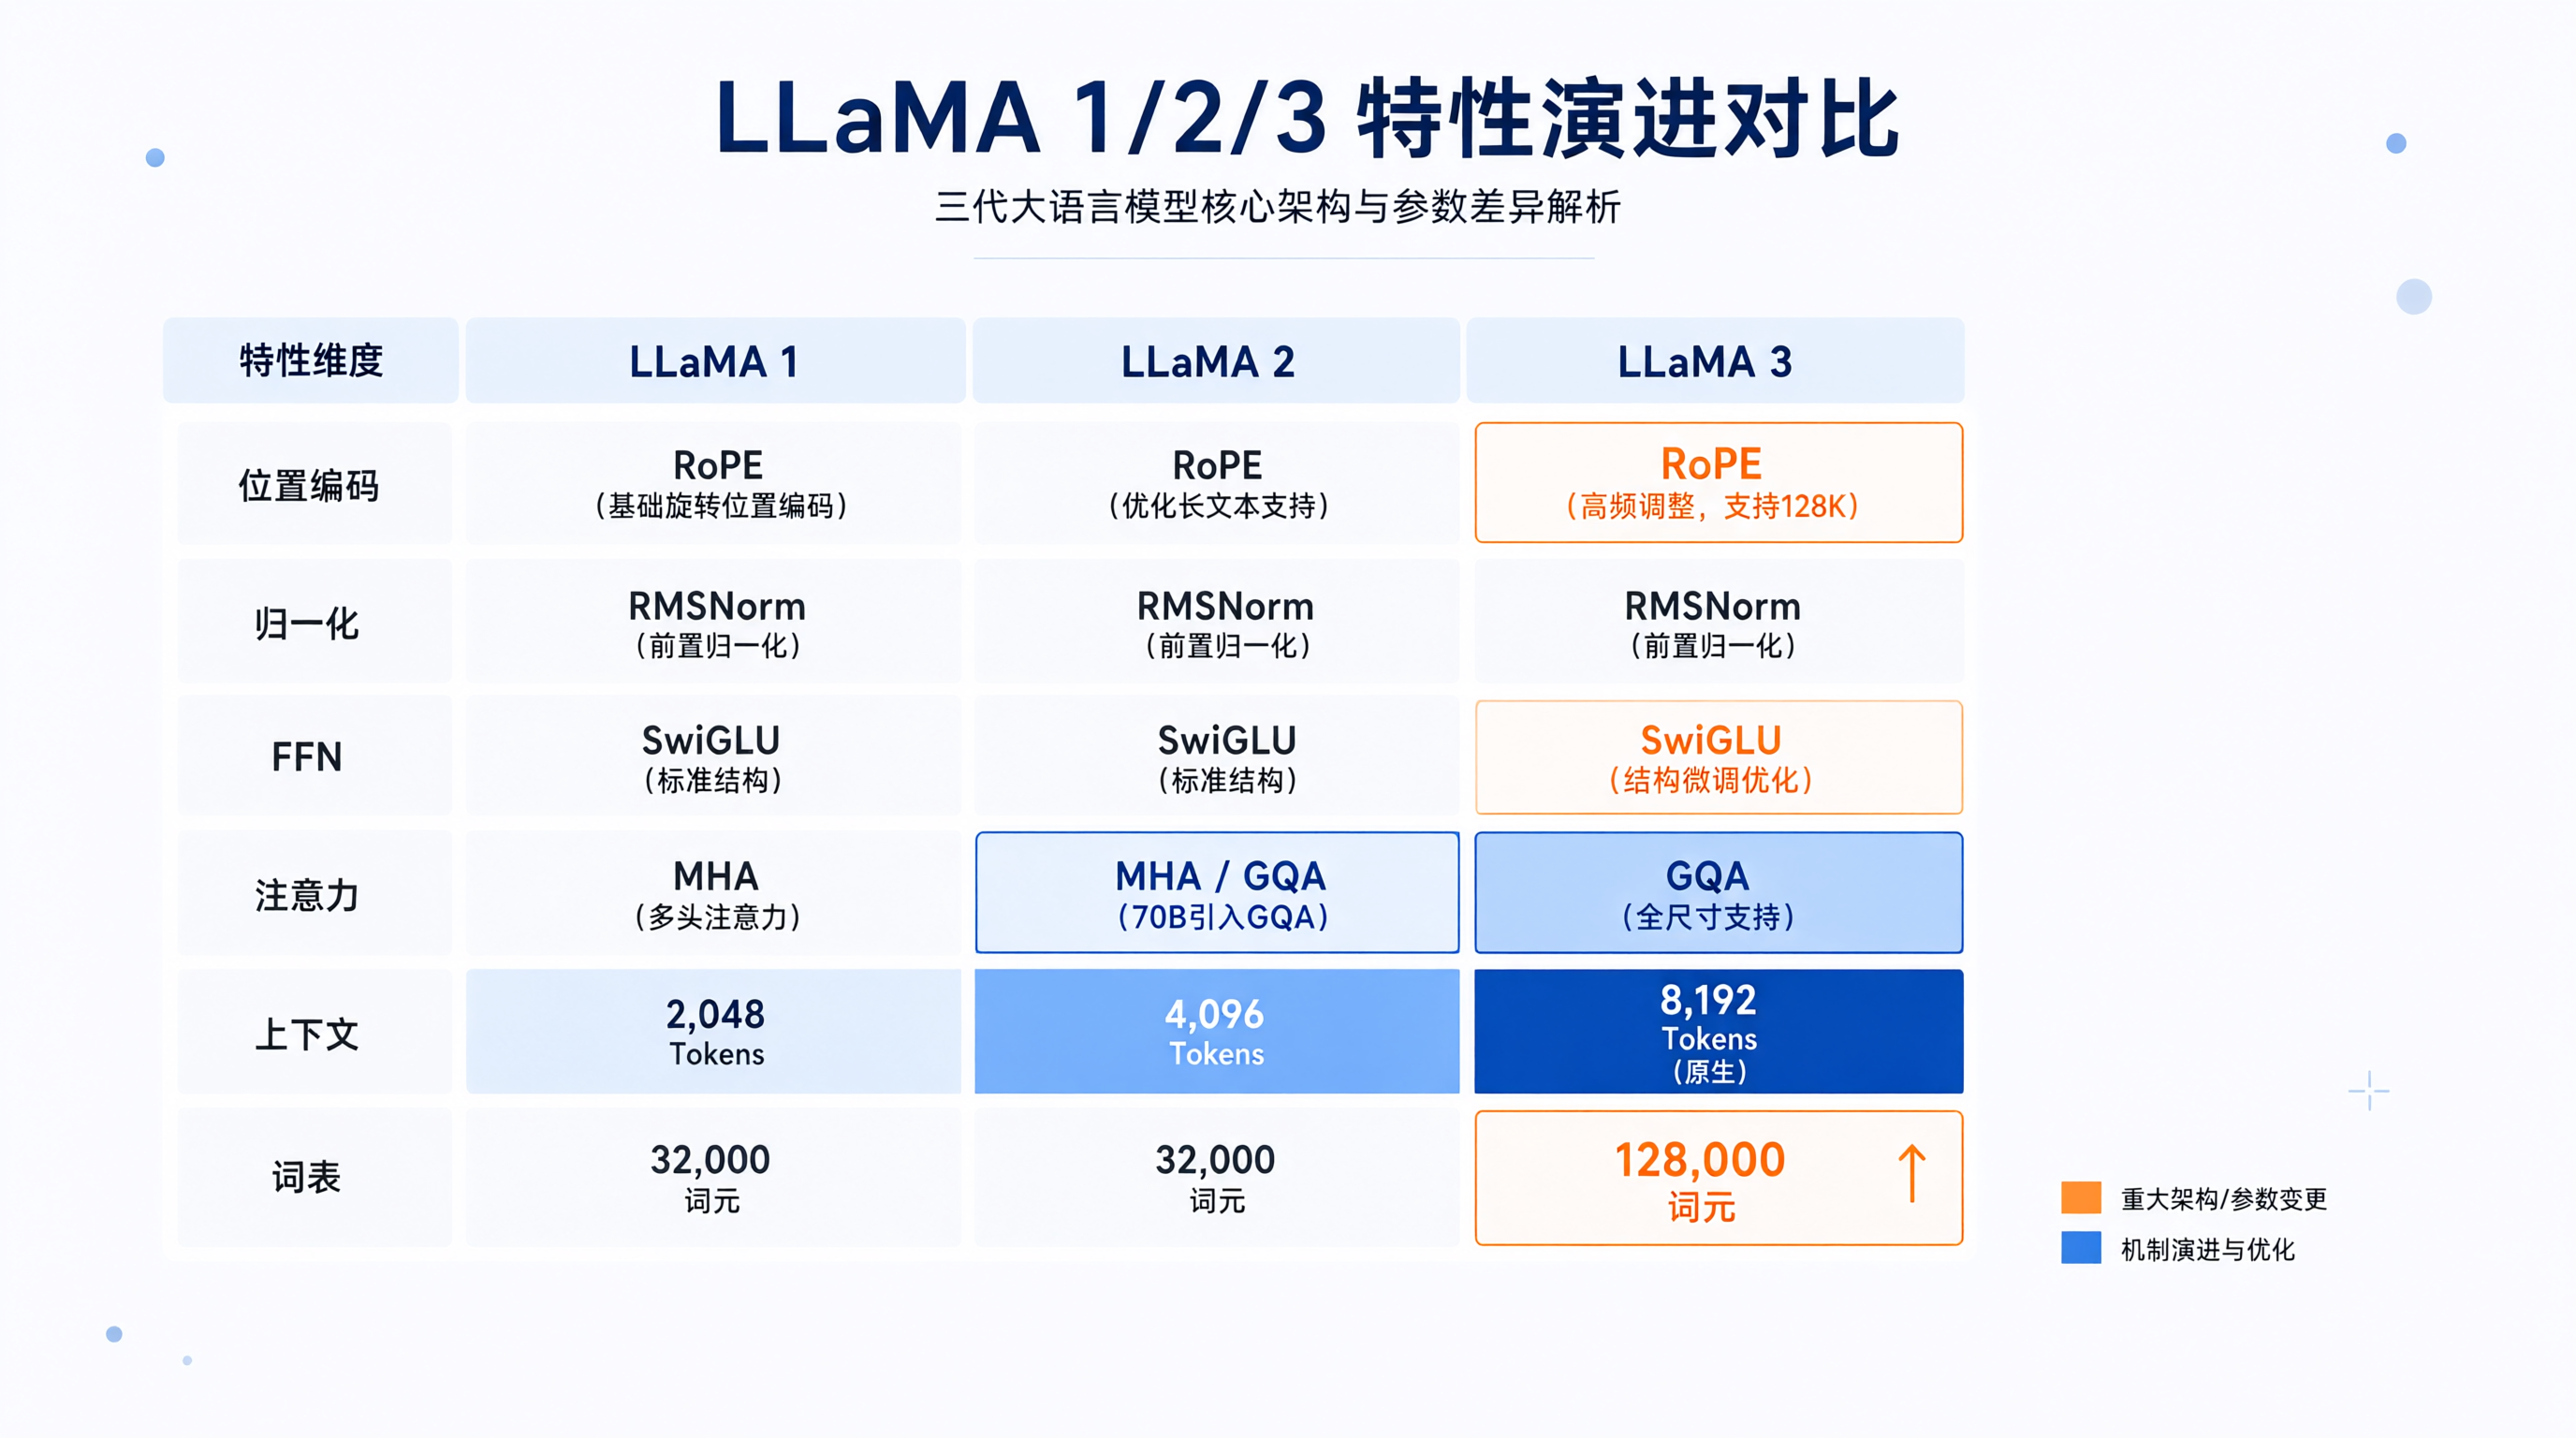
| 特性 | LLaMA 1 | LLaMA 2 | LLaMA 3 |
|---|---|---|---|
| 位置编码 | RoPE (theta=10000) | RoPE (theta=10000) | RoPE,长上下文版本 theta 调大 |
| 归一化 | Pre-RMSNorm | 同 LLaMA 1 | 同 LLaMA 1 |
| FFN | SwiGLU | 同 LLaMA 1 | 同 LLaMA 1 |
| 注意力 | 标准 MHA | 70B 用 GQA,其余 MHA | 全系 GQA |
| 词表大小 | 32000 | 32000 | 128256 |
| 上下文长度 | 2048 | 4096 | 8K,后扩到 128K |
| 训练 token 量 | 1T | 2T | 15T(8B) |
这张表里有一个信息需要标注:LLaMA 3 8B 的 15T token 是 Meta 官方博客给出的数字,70B 和 405B 的具体数字我记不准确,所以没有列。
从表里能看出一个规律:LLaMA 1 定架构,LLaMA 2 加数据,LLaMA 3 改词表和注意力。架构层面的创新主要集中在第一代,后面两代更多是工程和规模上的调整。
这些改动对实际开发意味着什么
如果你在选模型做微调或者部署,这几个点值得注意。
词表大小直接影响 embedding 参数量。LLaMA 3 的 8B 模型,embedding 层占了相当一部分参数。如果你做的是小语种或者垂直领域微调,词表大意味着有更多参数需要训练,LoRA 的 rank 可能需要相应调大。
GQA 让 KV Cache 变小,但不改变计算量。GQA 减少的是显存占用,注意力计算本身的 FLOPs 没变。所以如果你的瓶颈是显存,GQA 帮助很大;如果瓶颈是算力,GQA 帮助有限。
RoPE theta 不是随便调的。改动 theta 相当于改变位置编码的频率分布,必须配合训练。直接改推理时的 theta 值会让模型输出变得混乱,这一点我在小模型上试过,效果确实会崩,但具体崩成什么样和模型规模、序列长度都有关。
LLaMA 1/2 的 32K 词表在中文场景下成本劣势明显。如果你的应用以中文为主,又必须用 LLaMA 系模型,LLaMA 3 相比 LLaMA 2 在 token 效率上的提升,可能比参数量提升带来的收益还大。
一个可以跑的最小验证
如果你想自己验证 RoPE 的相对位置性质,可以跑这段代码。它不依赖任何模型权重,纯粹验证位置编码的数学性质。
python
import torch

def rope_relative_property_check():
    dim = 64
    theta = 10000.0
    freqs = 1.0 / (theta ** (torch.arange(0, dim, 2).float() / dim))

    def rotate(x, pos):
        # x: (dim,)
        angles = pos * freqs
        cos, sin = torch.cos(angles), torch.sin(angles)
        x1, x2 = x[0::2], x[1::2]
        out = torch.stack([x1 * cos - x2 * sin, x1 * sin + x2 * cos], dim=-1)
        return out.flatten()

    torch.manual_seed(0)
    q = torch.randn(dim)
    k = torch.randn(dim)

    # 位置 (0, 5) 和位置 (10, 15) 的相对距离都是 5
    score_a = torch.dot(rotate(q, 0), rotate(k, 5))
    score_b = torch.dot(rotate(q, 10), rotate(k, 15))

    print(f"相对距离 5 的两组注意力分数: {score_a.item():.6f}, {score_b.item():.6f}")
    # 两者应该非常接近,差异来自浮点误差

if __name__ == "__main__":
    rope_relative_property_check()
跑出来两个数应该在小数点后四五位才出现差异。这就是 RoPE 相对位置性质的直接体现:注意力分数只依赖位置差,不依赖绝对位置。
写在最后
把 LLaMA 三代放在一起看,最反直觉的一点是:真正影响使用体验的改动,往往不是那些听起来最"架构"的改动。GQA 听起来很硬核,但它主要解决显存问题;而词表从 32K 扩到 128K 这种听起来很"工程"的改动,反而直接决定了中文场景下的成本和效果。
如果你打算基于 LLaMA 系模型做二次开发,我的建议是先确认三件事:你的场景以什么语言为主(决定词表选择)、你的瓶颈是显存还是算力(决定是否必须用 GQA 版本)、你的序列长度需求是多少(决定是否需要长上下文版本)。这三个问题想清楚,选型基本就定了。