复盘 AI Coding 工作台的流式链路:从 Sender 输入到 SSE 分流,再到 BubbleList 和右侧预览
前面我已经分别拆过
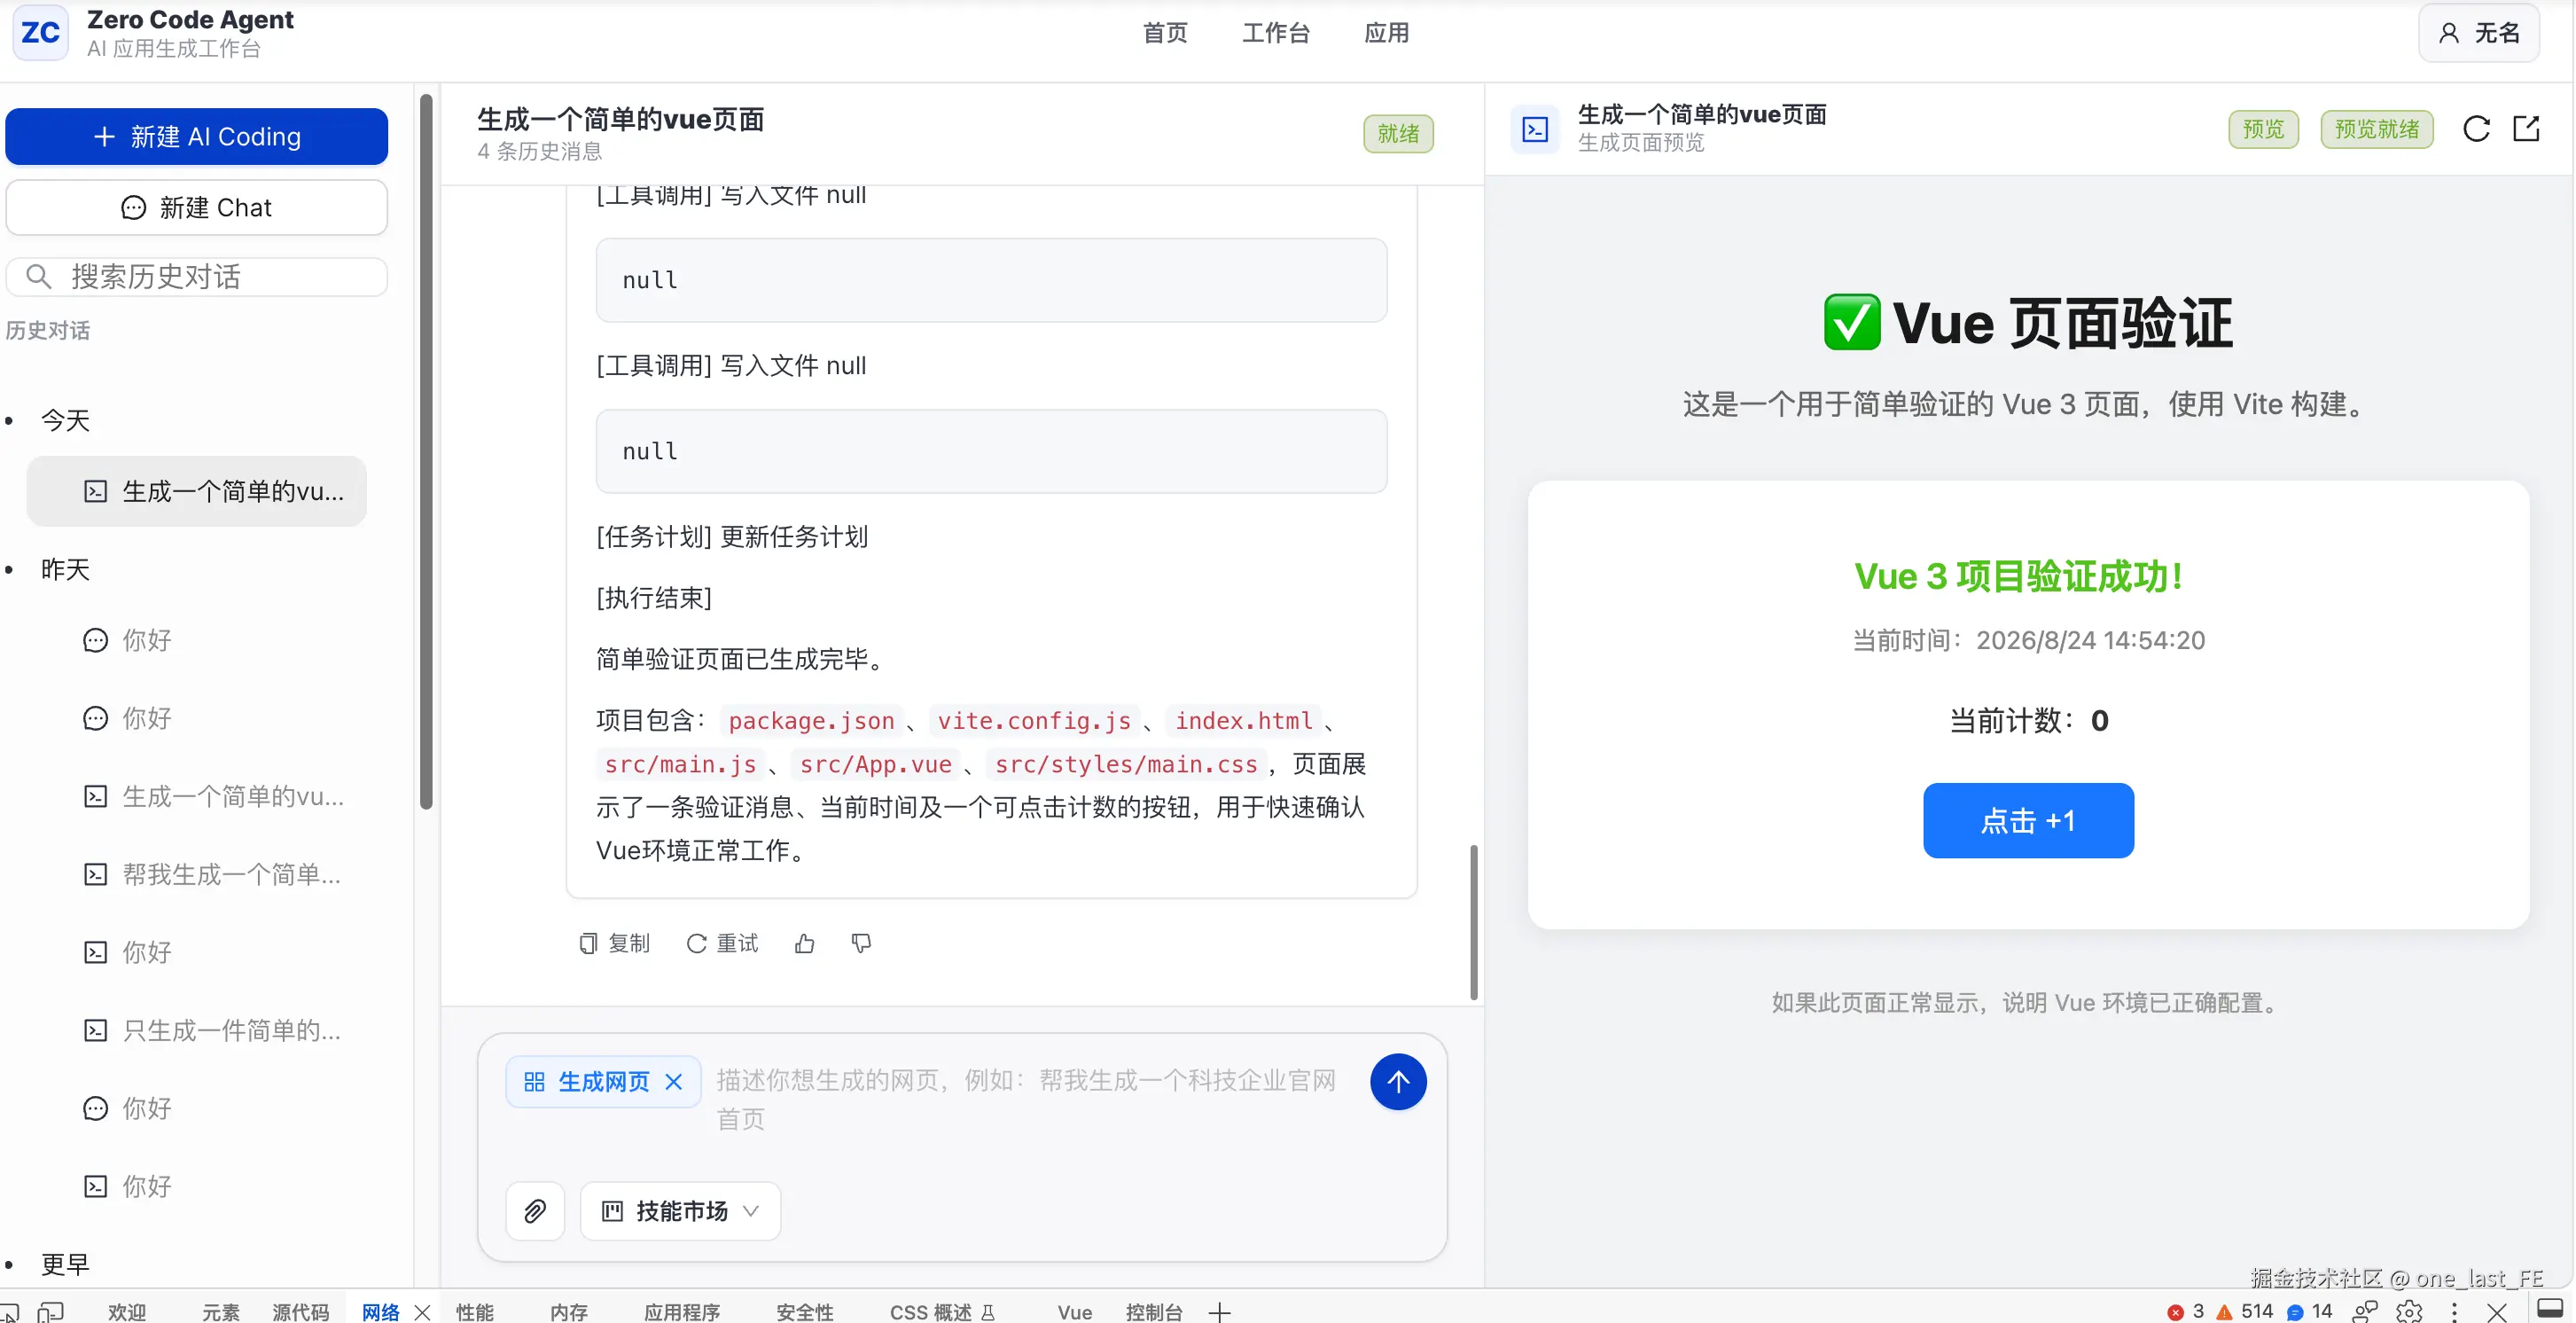
BubbleList、Sender、ThoughtChain、AssistantMessageContent这些组件。所以这篇不再逐个介绍组件 API,而是换一个更接近真实工程复盘的视角:一次用户请求从输入框发出后,前端如何建立 SSE 连接,如何把后端流式事件分流成正文、推理摘要、工具状态,最后如何驱动聊天区和右侧预览更新。
先给结论:这套链路解决的不是"怎么显示一条消息"
如果只是做普通聊天室,事情很简单:
txt
用户输入一句话
后端返回一段文本
前端 append 到消息列表
但 AI Coding 工作台不一样。
一次请求里,后端可能连续推这些事件:
txt
answer      AI 正文
reasoning   模型显式推理摘要
thought     工具调用状态
status      后端生命周期状态
artifact    生成产物信息
done        流结束
error       业务错误
如果前端没有一条清晰的流式链路,最后很容易变成:
txt
status 被拼进聊天正文
工具调用状态和 AI 回复混在一起
页面产物塞进 bubble
组件到处判断后端 type
SSE 客户端既管连接又管业务
所以这个工作台的核心不是"把消息显示出来",而是建立一条稳定的数据管道:
txt
用户输入
  -> 创建或定位会话
  -> 插入 user message
  -> 插入 assistant 占位 message
  -> 建立 SSE 连接
  -> 解析后端事件
  -> 分流成 content / reasoningContent / thought
  -> 合并进 assistant message
  -> BubbleList 响应式渲染
  -> AssistantMessageContent 拆层展示
  -> InspectorPanel 根据 appId 和构建状态刷新右侧页面预览
这篇文章就按这条链路往下拆。
整体调用链
先看一张文字版架构图:
txt
ChatComposer(Sender)
  用户输入、选择技能、点击发送
        |
        v
ChatWorkspace
  把 submit 事件继续抛给页面
        |
        v
WorkbenchPage
  调用 useWorkbenchChat.handleSubmit
        |
        v
useWorkbenchChat
  创建应用、插入消息、建立 SSE、合并流式 chunk
        |
        v
streamChatToGenCode
  拼接口 URL,配置 SSE callbacks
        |
        v
createSseStream
  建立 EventSource,监听 message / done / business-error
        |
        v
parseChatStreamMessage
  把 MessageEvent<string> 转成业务 chunk
        |
        v
parseChatStreamPayload
  根据 type 分流 answer / reasoning / thought / ignored
        |
        v
useWorkbenchChat.onChunk
  content 追加正文,reasoningContent 追加摘要,thought 按 id 合并
        |
        v
ChatMessageList(BubbleList)
  根据 message.role 选择 user/assistant 渲染规则
        |
        v
AssistantMessageContent
  ThoughtChain + ReasoningChain + MarkdownRenderer
        |
        v
InspectorPanel
  生成结束后等待构建,iframe 展示页面产物
这条链路里,每个模块只负责自己那一段。
我的判断是:AI 工作台最怕的不是代码多,而是边界乱。
SSE 连接、协议解析、消息状态、气泡渲染、右侧预览如果混在一起,后面加一个工具状态都会牵一堆文件。
第一步:ChatComposer 采集用户意图
入口是中间底部输入框 ChatComposer。
它用的是 ant-design-x-vue 的 Sender:
vue
<Sender
  v-model:value="inputValue"
  :loading="running"
  :onSubmit="handleSubmit"
  :onCancel="() => emit('cancel')"
  :autoSize="{ minRows: 2, maxRows: 6 }"
  :placeholder="placeholder"
>但这里有一个重点:ChatComposer 发出去的不是一个裸字符串。
在 AI Coding 模式下,用户可能选择了技能:
txt
生成页面
优化样式
拆分组件
修复问题
写文档
所以提交时抛出去的是结构化 payload:
ts
emit('submit', {
  message: text,
  skillKeys: isChatMode.value ? [] : [...selectedSkillKeys.value],
  skills: selectedSkills.value.map(skill => ({
    key: skill.key,
    name: skill.name,
    category: skill.category,
    prompt: skill.prompt,
  })),
});
对应类型是:
ts
export interface ComposerSubmitPayload {
  message: string;
  skillKeys: AgentSkillKey[];
  skills: Pick<AgentSkill, 'key' | 'name' | 'category' | 'prompt'>[];
}
这一步的本质是:
txt
Sender 负责输入体验
ChatComposer 负责把用户输入转成"意图对象"
为什么要这么做?
因为后续 useWorkbenchChat 不应该再去猜:
txt
当前是不是 Chat 模式?
用户选了哪些技能?
技能 prompt 是什么?
这些上下文应该在提交时就结构化好。
第二步:事件向上抛到 WorkbenchPage
ChatComposer 不直接调接口。
它通过 ChatWorkspace 把事件向上抛:
vue
<ChatComposer
  :running="running"
  :capability="conversation.capability"
  @submit="$emit('submit', $event)"
  @cancel="$emit('cancel')"
/>
ChatWorkspace 也不处理业务,它只是中间聊天区的骨架:
vue
<main class="zc-main chat-workspace">
  <ChatHeader />
  <ChatMessageList />
  <ChatComposer />
</main>
真正处理提交的是页面入口 WorkbenchPage:
vue
<ChatWorkspace
  :conversation="activeConversation"
  :running="isRunning"
  :load-more-history="loadMoreConversationMessages"
  @submit="handleSubmit"
  @cancel="handleCancel"
/>
handleSubmit 来自:
ts
const {
  activeConversation,
  isRunning,
  handleSubmit,
  handleCancel,
} = useWorkbenchChat();
也就是说:
txt
组件负责 emit
页面负责接线
业务逻辑放在 composable
这也是我很推荐的 Vue 组织方式。
第三步:useWorkbenchChat 处理会话和消息占位
用户点击发送后,进入 useWorkbenchChat.handleSubmit。
它先判断当前是否已经在 running:
ts
if (runningKey.value || creatingApp.value) {
  return;
}
然后拿当前会话:
ts
let conversation = activeConversation.value;如果是一个全新的草稿会话,还没有后端 appId,就先创建应用:
ts
if (!conversation.appId) {
  const createdConversation = await createConversationForFirstMessage(conversation, payload);
  if (!createdConversation) {
    return;
  }
  conversation = createdConversation;
}
拿到 appId 后,进入真正的流式请求:
ts
startStream(conversation, payload);在 startStream 里,前端先做一个非常关键的动作:插入两条本地消息。
ts
conversation.messages = [
  ...conversation.messages,
  {
    key: `${now}-user`,
    role: 'user',
    content: payload.message,
    skillKeys: payload.skillKeys,
  },
  {
    key: assistantKey,
    role: 'assistant',
    content: '',
    loading: false,
    typing: { step: 2, interval: 24, suffix: '|' },
    skillKeys: payload.skillKeys,
  },
];
第一条是用户消息。
第二条是 assistant 占位消息。
为什么要先插入 assistant 空消息?
因为 SSE 是一段一段来的。
后面所有流式增量都要持续合并到同一条 assistant 消息上:
txt
第 1 个 answer chunk -> 追加到 assistant.content
第 2 个 answer chunk -> 继续追加
第 1 个 reasoning chunk -> 追加到 assistant.reasoningContent
第 1 个 thought -> 合并到 assistant.thoughts
第 2 个 thought -> 根据 id 更新 assistant.thoughts
如果不提前插入这条占位消息,流式过程中每来一个 chunk 都新建一条消息,聊天区会碎掉。
所以 assistantKey 是后续流式合并的锚点。
第四步:streamChatToGenCode 准备 SSE 请求
startStream 里会调用:
ts
closeStream.value = streamChatToGenCode(
  {
    appId: conversation.appId,
    message: payload.message,
  },
  {
    onChunk,
    onDone,
    onError,
  },
);
streamChatToGenCode 在 API 层。
它做两件事:
第一,拼出接口 URL:
ts
const url = createApiUrl('/app/chat/gen/code', {
  appId: params.appId,
  message: params.message,
});
第二,把这个 URL 交给通用 SSE client:
ts
return createSseStream<ChatToGenCodeStreamChunk>({
  url,
  parseMessage: parseChatStreamMessage,
  parseBusinessError,
  onMessage: handlers.onChunk,
  onDone: handlers.onDone,
  onError: handlers.onError,
});
注意这个分层:
txt
streamChatToGenCode
  知道业务接口路径
  知道业务错误怎么解析
  知道 message 要用 parseChatStreamMessage 解析

createSseStream
  不知道这是 chat 还是 gen code
  只知道如何建立 SSE
这就是 API 层应该做的事:把业务接口和通用客户端接起来。
第五步:createSseStream 建立 EventSource
createSseStream 是一个通用 SSE 客户端。
核心代码是:
ts
const eventSource = new EventSource(options.url, {
  withCredentials: options.withCredentials ?? true,
});
它监听四类事件。
第一类,普通 message:
ts
eventSource.onmessage = (event) => {
  const message = options.parseMessage(event);
  if (message !== undefined && message !== null) {
    options.onMessage(message);
  }
};
第二类,业务错误:
ts
eventSource.addEventListener(
  options.businessErrorEventName ?? 'business-error',
  (event) => {
    const error = options.parseBusinessError
      ? options.parseBusinessError(event as MessageEvent<string>)
      : new Error('生成过程中出现错误');
    emitError(error);
  },
);
第三类,完成事件:
ts
eventSource.addEventListener(options.doneEventName ?? 'done', () => {
  close();
  options.onDone();
});
第四类,连接异常:
ts
eventSource.onerror = () => {
  emitError(new Error('SSE 连接中断'));
};
这里有一个非常重要的边界:
txt
createSseStream 不解析业务 type它不关心:
txt
answer
reasoning
thought
tool_request
status
artifact
它只负责:
txt
建连
监听
关闭
错误
回调
这让它可以复用到别的 SSE 场景。
第六步:chatStreamEvents 把后端事件分流
真正理解后端业务事件的是 chatStreamEvents.ts。
它的最终输出类型只有三个字段:
ts
export interface ChatToGenCodeStreamChunk {
  content?: string;
  reasoningContent?: string;
  thought?: AgentThought;
}
也就是说,不管后端推什么,前端聊天状态最终只吃这三种增量:
| 字段 | 含义 | 最终展示 |
|---|---|---|
content |
AI 正文 | MarkdownRenderer |
reasoningContent |
显式推理摘要 | ChatReasoningChain |
thought |
工具调用状态 | ChatThoughtChain |
6.1 message 入口
createSseStream 收到 MessageEvent<string> 后,会调用:
ts
parseChatStreamMessage(event)内部先解析 JSON:
ts
export function parseChatStreamMessage(event: MessageEvent<string>) {
  return parseChatStreamPayload(parseJsonData(event.data));
}
如果后端发的是 JSON:
json
{"type":"answer","d":"你好"}就解析成对象。
如果后端直接发纯文本:
txt
你好也不会炸,会走纯文本兜底。
6.2 事件类型分组
chatStreamEvents 先定义几组事件。
AI 正文:
ts
const ANSWER_EVENT_TYPES = new Set([
  'answer',
  'chunk',
  'ai_response',
  'assistant_partial',
  'assistant_final',
]);
推理摘要:
ts
const REASONING_EVENT_TYPES = new Set([
  'thinking',
  'thinking_summary',
  'reasoning',
  'reasoning_summary',
]);
工具状态:
ts
const THOUGHT_EVENT_TYPES = new Set([
  'thought',
  'agent_thought',
]);
迁移期兼容旧工具事件:
ts
const LEGACY_TOOL_START_EVENT_TYPES = new Set([
  'tool_request',
  'tool_call',
  'tool_start',
]);

const LEGACY_TOOL_END_EVENT_TYPES = new Set([
  'tool_result',
  'tool_executed',
  'tool_end',
]);
6.3 核心分流逻辑
核心函数是:
ts
export function parseChatStreamPayload(payload: unknown): ChatToGenCodeStreamChunk | null {
  if (!isJsonRecord(payload)) {
    return parseNestedPayload(payload);
  }

  const eventType = normalizeEventType(payload.type ?? payload.event);

  if (eventType === 'done' || eventType === 'error') {
    return null;
  }

  const directText = pickText(payload, [
    'd',
    'content',
    'data',
    'message',
    'text',
    'delta',
    'output',
  ]);

  if (REASONING_EVENT_TYPES.has(eventType)) {
    return directText === undefined ? null : { reasoningContent: directText };
  }

  if (ANSWER_EVENT_TYPES.has(eventType)) {
    return directText === undefined ? null : { content: directText };
  }

  const thought = parseThoughtPayload(payload, eventType);
  if (thought) {
    return { thought };
  }

  if (IGNORED_EVENT_TYPES.has(eventType)) {
    return null;
  }

  return fallbackParse(payload);
}
这段逻辑对应一句话:
txt
先判断明确类型,再进入兜底解析6.4 Thought 统一成 AgentThought
工具调用事件最终会变成:
ts
export interface AgentThought {
  id: string;
  type: 'tool_call';
  status: 'pending' | 'success' | 'error';
  title: string;
  description?: string;
  toolName?: string;
  toolLabel?: string;
  input?: unknown;
  output?: unknown;
  createdAt?: string;
}
比如后端发:
json
{
  "type": "thought",
  "d": {
    "id": "call_1",
    "type": "tool_call",
    "status": "pending",
    "toolName": "writeFile",
    "input": {
      "relativeFilePath": "src/App.vue"
    }
  }
}
前端得到:
ts
{
  thought: {
    id: 'call_1',
    type: 'tool_call',
    status: 'pending',
    title: '调用工具:writeFile',
    toolName: 'writeFile',
    input: {
      relativeFilePath: 'src/App.vue',
    },
  },
}这就是协议防腐层的价值:UI 层不直接感知后端旧字段。
第七步:onChunk 合并到 assistant message
createSseStream 解析出 chunk 后,会调用:
ts
onMessage: handlers.onChunk也就是回到 useWorkbenchChat.startStream 里的 onChunk。
这一步是真正更新消息状态的地方:
ts
onChunk: (chunk) => {
  const target = findConversation(conversationKey);
  if (!target) {
    return;
  }

  replaceMessage(target, assistantKey, item => ({
    ...item,
    loading: false,
    content: `${item.content}${chunk.content ?? ''}`,
    reasoningContent: `${item.reasoningContent ?? ''}${chunk.reasoningContent ?? ''}`,
    thoughts: chunk.thought
      ? mergeThoughts(item.thoughts, chunk.thought)
      : item.thoughts,
  }));
}
这里有三条流:
txt
chunk.content
  -> 追加到 assistant.content

chunk.reasoningContent
  -> 追加到 assistant.reasoningContent

chunk.thought
  -> 按 id 合并到 assistant.thoughts
正文和推理摘要是字符串流,所以用追加。
Thought 是结构化事件,所以不能简单 push,要按 id 合并:
ts
function mergeThoughts(
  currentThoughts: AgentMessage['thoughts'] = [],
  nextThought: NonNullable<AgentMessage['thoughts']>[number],
) {
  const existingIndex = currentThoughts.findIndex(thought => thought.id === nextThought.id);

  if (existingIndex < 0) {
    return [...currentThoughts, nextThought];
  }

  return currentThoughts.map((thought, index) => {
    return index === existingIndex ? { ...thought, ...nextThought } : thought;
  });
}
为什么要合并?
因为一次工具调用通常分两段:
txt
pending:开始调用
success:调用完成
它们应该是同一个 Thought item 的状态变化,而不是两条独立记录。
所以后端必须保证:
txt
tool_request 和 tool_executed 使用同一个 id这就是工具调用可视化能否做好的关键。
第八步:BubbleList 根据 role 渲染消息
conversation.messages 更新以后,Vue 响应式触发 ChatMessageList 更新。
消息列表用的是:
vue
<BubbleList
  ref="bubbleListRef"
  :items="conversation.messages"
  :roles="roles"
  :auto-scroll="true"
  :on-scroll="handleScroll"
>
这里的 roles 是 BubbleList 的消息角色规则。
用户消息:
ts
if (message.role === 'user') {
  return userRole;
}
AI 消息:
ts
return {
  ...assistantRole,
  messageRender: (content: unknown) => h(AssistantMessageContent, {
    message: {
      ...message,
      key: message.key ?? 'assistant-message',
      role: 'assistant',
      content: String(content ?? ''),
      reasoningContent: typeof message.reasoningContent === 'string'
        ? message.reasoningContent
        : undefined,
      thoughts: Array.isArray(message.thoughts)
        ? message.thoughts as AgentThought[]
        : undefined,
    } as AgentMessage,
  }),
};
这一步完成了一个重要分工:
txt
BubbleList
  负责消息队列、头像、左右布局、滚动、footer actions

AssistantMessageContent
  负责 assistant 气泡内部到底展示什么
所以你在模板里找不到:
vue
<AssistantMessageContent />因为它不是模板直接写的,而是在 messageRender 里通过:
ts
h(AssistantMessageContent, { message })动态渲染。
这种写法很适合 AI 消息,因为 assistant 气泡的内部结构一定会越来越复杂。
第九步:AssistantMessageContent 把 AI 气泡拆成三层
AssistantMessageContent 接到标准化后的 AgentMessage。
它只做展示分层:
vue
<div class="assistant-message-content">
  <ChatThoughtChain v-if="thoughts.length" :thoughts="thoughts" />

  <ChatReasoningChain
    v-if="reasoningContent"
    :content="reasoningContent"
    :active="reasoningActive"
  />

  <MarkdownRenderer v-if="answerContent" :content="answerContent" />
</div>
这三层对应前面 SSE 分流出来的三个字段:
txt
thought
  -> ChatThoughtChain

reasoningContent
  -> ChatReasoningChain

content
  -> MarkdownRenderer
这就是整条链路最漂亮的地方。
后端事件经过 chatStreamEvents 分流以后,到 UI 层刚好是一一对应:
| 后端事件 | chunk 字段 | message 字段 | 组件 |
|---|---|---|---|
answer |
content |
content |
MarkdownRenderer |
reasoning |
reasoningContent |
reasoningContent |
ChatReasoningChain |
thought |
thought |
thoughts |
ChatThoughtChain |
status |
null |
不进入 message | 不展示 |
artifact |
null |
不进入 bubble | 右侧预览/产物区 |
这就是前端链路设计的核心:数据在什么层被分流,就决定了 UI 在什么层保持简单。
第十步:ThoughtChain 只展示工具过程
ChatThoughtChain 里最终把 AgentThought[] 转成 ThoughtChain items:
ts
const items = computed(() => {
  return visibleThoughts.value.map((thought) => {
    const detail = stringifyThoughtDetail(thought);

    return {
      key: thought.id,
      icon: getThoughtIcon(thought),
      title: thought.title,
      description: thought.description,
      status: thought.status,
      content: detail
        ? h(MarkdownRenderer, { content: `\`\`\`json\n${detail}\n\`\`\`` })
        : undefined,
    };
  });
});
这里有两个设计判断。
第一个,ThoughtChain 不是拿来展示模型私有思维链的。
它展示的是:
txt
AI 调用了什么工具
工具是否完成
入参是什么
输出是什么
失败在哪里第二个,input/output 默认折叠在详情里。
用户平时只看:
txt
调用工具:writeFile
工具完成:writeFile
需要排查时再展开 JSON。
这比直接把工具参数和返回值拼进 AI 正文干净很多。
这样前端就不需要理解后端内部事件名。
这条链路里每个组件的真正位置
最后把所有组件放回链路里看。
| 模块 | 在链路中的位置 | 真正职责 |
|---|---|---|
ChatComposer |
输入起点 | 采集 message + skills |
Sender |
输入 UI | 多行输入、发送、取消、loading |
ChatWorkspace |
聊天区容器 | 组合 header/list/composer |
WorkbenchPage |
页面接线层 | 左中右布局,连接 composable |
useWorkbenchChat |
状态大脑 | 会话、消息、SSE、合并、错误 |
streamChatToGenCode |
业务 API 层 | 拼 URL,配置 SSE callbacks |
createSseStream |
通用 SSE 客户端 | 建连、监听、关闭、错误 |
chatStreamEvents |
协议防腐层 | 后端事件分流成 chunk |
ChatMessageList |
消息列表 | BubbleList、roles、滚动、footer |
BubbleList |
气泡引擎 | 根据 items + roles 渲染消息 |
AssistantMessageContent |
AI 气泡内容中枢 | Thought + Reasoning + Markdown |
ChatThoughtChain |
工具状态展示 | 展示 tool_call 的 pending/success/error |
ChatReasoningChain |
推理摘要展示 | 展示 reasoningContent |
MarkdownRenderer |
正文展示 | 渲染 AI markdown 正文 |
用一句话概括:
txt
输入由 ChatComposer 发起
流式连接由 createSseStream 维护
业务事件由 chatStreamEvents 分流
消息状态由 useWorkbenchChat 合并
聊天 UI 由 BubbleList 承载
AI 气泡由 AssistantMessageContent 拆层
我认为这套设计最值得保留的三个点
1. SSE client 和业务解析分离
createSseStream 不懂业务,只负责连接。
chatStreamEvents 不管连接,只负责协议翻译。
这让整个流式系统可以扩展,也容易排查问题。
当你看到页面显示错了,先问:
txt
是后端事件发错?
还是 chatStreamEvents 分流错?
还是 useWorkbenchChat 合并错?
还是 AssistantMessageContent 展示错?
这条排查路径非常清楚。
2. assistant message 是结构化对象,不是字符串
AI 回复不是只有:
ts
content: string而是:
ts
{
  content: string;
  reasoningContent?: string;
  thoughts?: AgentThought[];
}
这一步让 UI 有能力区分:
txt
正文
推理摘要
工具过程
后面加文件变更、引用来源、diff、部署信息,也可以继续扩这个结构。
小结
这套前端框架真正串起来的是一条流式数据链路:
txt
Sender 输入
  -> ComposerSubmitPayload
  -> useWorkbenchChat.handleSubmit
  -> startStream 插入消息占位
  -> streamChatToGenCode
  -> createSseStream 建立 EventSource
  -> parseChatStreamMessage
  -> parseChatStreamPayload 分流
  -> onChunk 合并到 assistant message
  -> BubbleList 根据 roles 渲染
  -> AssistantMessageContent 拆出 Thought / Reasoning / Markdown
如果只看单个组件,会觉得它们都不复杂。
但真正有价值的是它们之间的边界:
txt
连接归连接
协议归协议
状态归状态
气泡归气泡
AI 内容归 AI 内容
页面产物归页面产物
这几个边界守住以后,项目继续加能力才不会散。
我觉得这就是一个 AI Coding 工作台前端最重要的底层骨架。它不是为了炫组件,而是为了让一次复杂的 AI 生成过程,从输入到输出都能被稳定、清晰、可维护地承载下来。