一、为什么聊天系统会出现越来越多的 ID
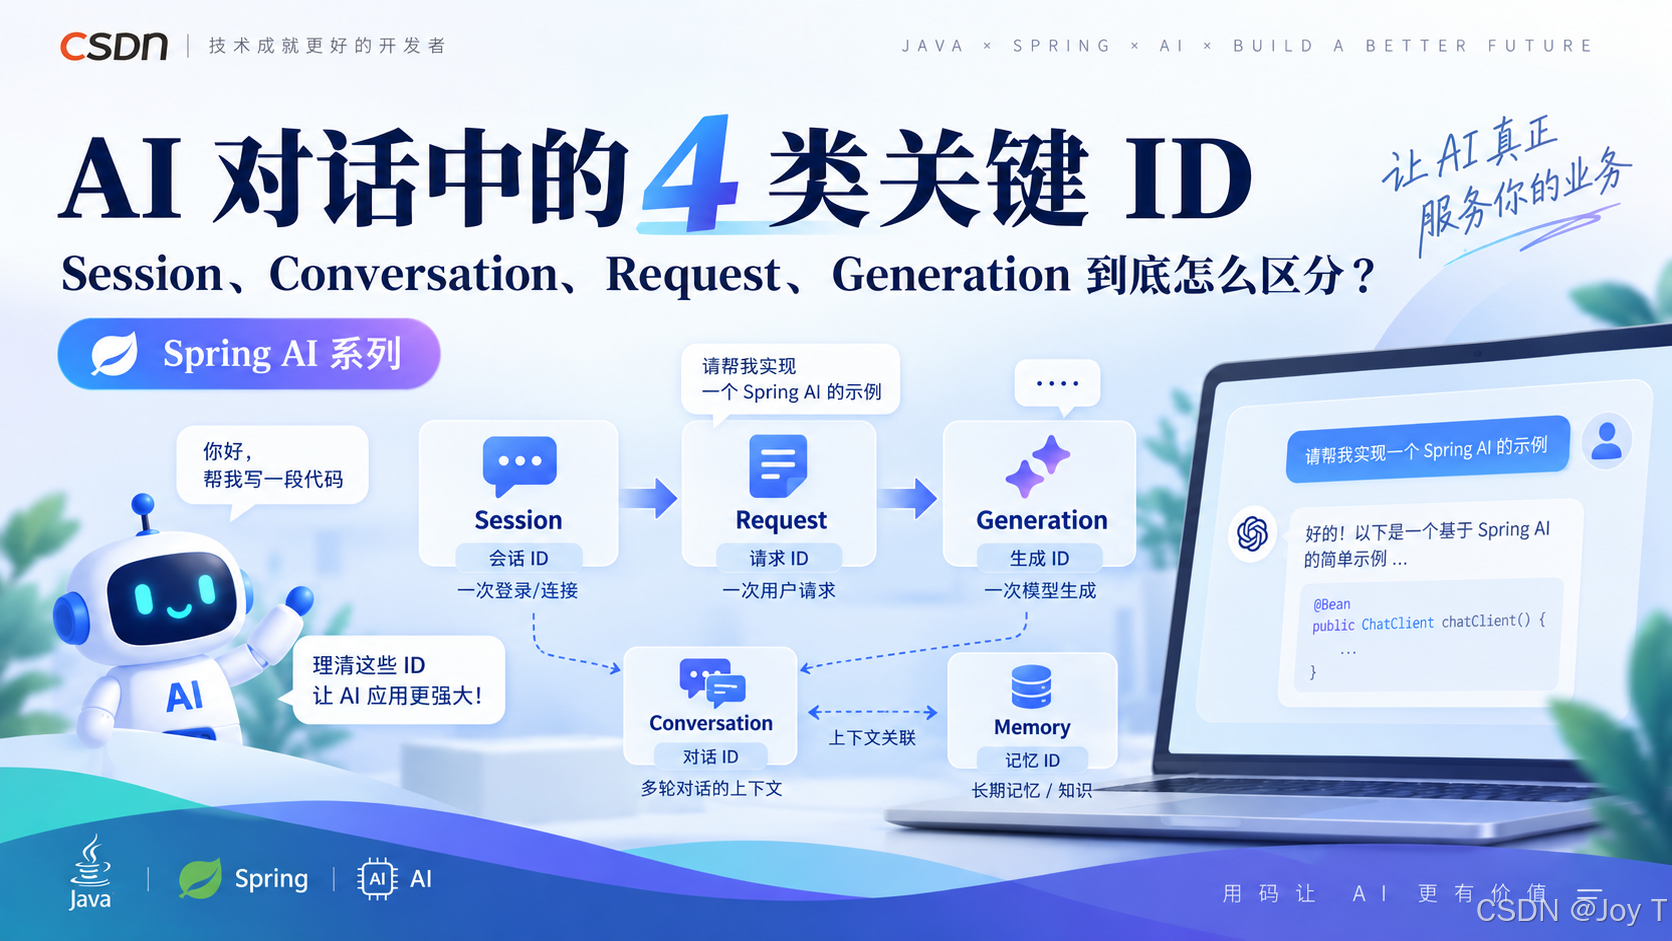
刚开始开发聊天功能时,一个 Session ID 似乎已经足够。它可以区分不同聊天窗口,可以查询历史消息,也可以让前端刷新页面后重新定位到原来的会话。随着 Memory、并发请求、Tool Calling 和停止生成逐渐加入,一个 Session ID 很快就无法承担全部职责。
这些 ID 之间没有"新 ID 替代旧 ID"的关系。它们分别标识不同生命周期的对象。理解这一点以后,Session ID、Conversation ID、Request ID 和 Generation ID 就不会再显得混乱。
一个比较稳定的理解顺序是:
用户 → Session → Request → Generation → Tool Call。
Conversation ID 则主要负责模型 Memory 的作用域。
二、Session ID:标识一段长期业务会话
Session ID 属于业务系统。用户新建一个聊天窗口时,系统可以创建一个 Session,并保存 title、userId、createdAt 等信息。后面的消息查询、会话删除、标题修改和页面恢复都可以通过 Session ID 完成。
因此一个用户可以有很多 Session。Session ID 不是 User ID,也不应该被理解成"用户级标识"。它代表的是一个相对长期的聊天会话。
数据库内部还可以存在 bigint 类型的主键 id,Session ID 则作为对外业务标识。你原有博客已经明确区分了数据库 ID 与 Session ID,并指出 generationId 的生命周期更短。
三、Conversation ID:告诉 Spring AI Memory 去哪里取上下文
Conversation ID 的职责更加具体。Spring AI 当前的 Chat Memory 以 conversationId 作为作用域,每次 Memory 操作都必须明确自己属于哪个 Conversation。官方文档也明确说明,多用户系统中需要让 Conversation ID 在用户和会话之间保持隔离。
最简单的项目完全可以:
java
conversationId = sessionId只要 Session ID 已经全局唯一,这种做法没有问题。
复杂项目可能进一步使用:
java
userId + ":" + sessionId或者:
java
userId + ":" + sessionId + ":" + agentId原因是业务 Session 和模型 Memory 的生命周期不一定永远相同。一个聊天窗口可能切换两个 Agent,而两个 Agent 希望保留不同的短期上下文。这时业务 Session 仍然只有一个,Memory Scope 可以有多个。
因此最准确的表述是:Session ID 标识业务会话,Conversation ID 标识模型上下文作用域。两者可以使用同一个值,但职责不同。
四、Request ID:标识一次用户请求
假设用户在同一个 Session 中连续问十个问题,显然还是同一个 Session,但已经产生十次请求。因此 Tool Result、一次请求的临时变量、接口幂等和日志关联都不能继续只依赖 Session ID。
这时就需要 Request ID。
例如用户在 Session A 中发送:
"帮我查询课程 1024。"
服务端生成:
java
requestId = R1001这一次请求可能发生模型推理、课程 Tool 调用和流式回答。所有属于本次请求的临时数据都可以挂到 R1001 下。
Request ID 特别适合和 ToolContext 结合。Spring AI 的 ToolContext 可以把 request scope 信息直接传递给 Tool,而且这些信息不会进入模型。因此 Tool 执行以后保存业务结果时,可以明确知道"这份课程数据属于 R1001"。
五、Generation ID:标识一次真正的模型生成任务
简单系统中,一次 Request 往往只对应一次 Generation,因此 Request ID 和 Generation ID 完全可以复用,没有必要为了设计感强行制造两个 ID。
Agent 系统复杂以后,两者可能分开。例如用户发出一次请求:"查询课程,再分析教师,最后给我推荐。"一次 Request 内部可能经历模型第一次推理、Tool 调用、模型第二次推理,甚至重新生成。此时 Generation ID 可以用于精确描述某一次正在运行的生成任务。
停止生成尤其适合使用 Generation ID。假设同一个 Session 中存在两个并发生成:
java
generationId = G001
java
generationId = G002用户停止 G001 时,G002 应继续运行。只使用 sessionId 就很难表达这种控制粒度。你之前博客中已经从 sessionId 进一步演化到 generationId,这个方向是正确的。
六、再往下还有 Tool Call ID 和 Trace ID
Agent 一次 Generation 可能调用多个 Tool。例如先查课程,再查教师,再查询库存。每一次具体 Tool 执行还可以拥有 toolCallId,用来记录参数、结果、耗时和异常。
Trace ID 属于另一套可观测性体系。它主要帮助开发者把 Gateway、AI Service、数据库查询、模型调用和 Tool 调用串成一条可追踪链路。业务 Request ID 和 Trace ID 可以建立关联,但不建议简单认为它们一定是同一个概念。
因此一个较完整的关系可以理解为:
User → Session → Request → Generation → Tool Call
同时:
Session → Conversation ID → Chat Memory
Request / Generation → Trace → 多个 Span
不需要所有项目一次性引入全部 ID。系统出现对应问题以后,再增加新的作用域即可。
七、为什么这个问题很适合面试
这类问题最能体现架构设计的演进过程。最初只有 Session ID,因为需求只是保存聊天;加入 Memory 后,需要 Conversation ID 划分模型上下文;同一 Session 出现并发请求后,需要 Request ID 管理请求级临时状态;需要停止某一次模型生成时,再引入 Generation ID。
因此面试时不要把几个 ID 当定义题去背。真正值得讲的是:旧 ID 的粒度已经不能解决新问题,所以系统引入了一个生命周期更准确的新标识。
只要能够讲清楚"它标识什么对象、存在多久、在哪些模块使用",整个 ID 体系就已经基本理解了。