我的计划是识别唱🎤 跳🕺rap🗣️ 篮球🏀,今天识别跳🕺
视频素材是AI生成的, 仅用来测试
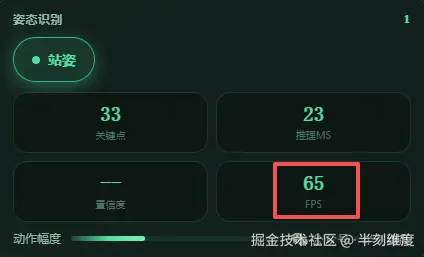
即便是纯cpu视频也不卡, 我是AMD5500, 入门CPU, 但是识别视频一秒也能60帧左右
上传图片画出骨架,传视频骨架跟着动,开摄像头实时识别。纯浏览器跑,零后端。模型只有 5.5MB,图片、视频、摄像头一个模型全搞定。
流程图
bash
    打开页面
         │
         ▼
    加载 WASM 运行时
         │
         ▼
    后台加载 5.5MB 模型
         │
         ▼
    显示"已就绪 · GPU"
         │
         ▼
    选择 图片 / 视频 / 摄像头
         │
         ▼
    detectForVideo 推理
         │
         ▼
    33 个关键点 + 置信度
         │
         ▼
    Canvas 画骨架
10 行跑起来:
bash
import * as $mp from "https://cdn.jsdelivr.net/npm/@mediapipe/tasks-vision@0.10.21/+esm"
const { FilesetResolver, PoseLandmarker } = $mp
const vision = await FilesetResolver.forVisionTasks(
  "https://cdn.jsdelivr.net/npm/@mediapipe/tasks-vision@0.10.21/wasm"
)
const pose = await PoseLandmarker.createFromOptions(vision, {
  baseOptions: { modelAssetPath: "./models/pose_landmarker_lite.task", delegate: "GPU" },
  runningMode: "VIDEO",
})
const r = pose.detectForVideo(img, performance.now())
console.log(r.landmarks[0].length) // 33@mediapipe/tasks-vision,Google 出品,GitHub 17k+ 星。传统方案要装 Python 或配 GPU 服务器。MediaPipe 把这些搬进了浏览器。
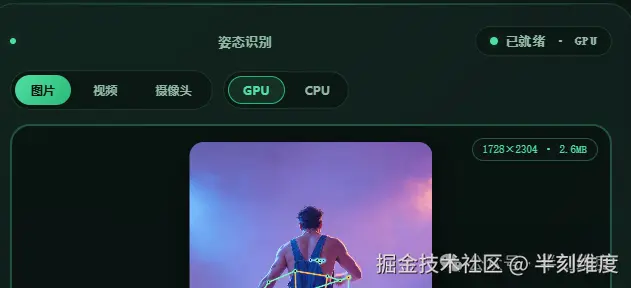
1. 模型预加载 + GPU/CPU 切换
bash
async function loadModel(delegate) {
  const vision = await FilesetResolver.forVisionTasks(
    "https://cdn.jsdelivr.net/npm/@mediapipe/tasks-vision@0.10.21/wasm"
  )
  poseLandmarker = await PoseLandmarker.createFromOptions(vision, {
    baseOptions: { modelAssetPath: "./models/pose_landmarker_lite.task", delegate },
    runningMode: "VIDEO", numPoses: 1,
  })
}
loadModel("GPU") // 页面打开就加载

async function switchDelegate(delegate) {
  currentDelegate = delegate
  await loadModel(delegate) // 切换后重建模型
}
delegate 传 "GPU" 走 WebGL,传 "CPU" 走原生。小模型有时 CPU 反而更快,点按钮切一下就行。
模型没加载好就拦截:
bash
if (!poseLandmarker) { setStatus("模型还没加载好,请稍候"); return }2. 一个模型跑图片 + 视频
VIDEO 模式通吃两种输入,图片当一帧传时间戳:
bash
// 图片
const r = poseLandmarker.detectForVideo(img, performance.now())
// 视频帧
const r2 = poseLandmarker.detectForVideo(video, performance.now())
一次检测 25ms 左右:
bash
图片: 800 × 600 | 人体数: 1 | 推理: 35ms3. 视频/摄像头,20fps 节流
不能每帧推理,用 requestAnimationFrame + 50ms 节流:
bash
function loopFrames(videoEl, cctx) {
  const now = performance.now()
  if (now - lastDetect > 50) {
    const results = poseLandmarker.detectForVideo(videoEl, now)
    cctx.drawImage(videoEl, 0, 0, W, H)
    drawSkeleton(cctx, W, H, results.landmarks[0])
    lastDetect = now
  }
  raf = requestAnimationFrame(() => loopFrames(videoEl, cctx))
}
摄像头复用同一套:
bash
stream = await navigator.mediaDevices.getUserMedia({ video: { width: 640, height: 480 } })
camVideo.srcObject = stream
loopFrames(camVideo, camctx)
注意:要 localhost 或 https 才能用摄像头。video 加 playsinline 兼容 iOS。
4. 画骨架 + 站坐躺判断
四色分组连线:
bash
const CONNECTIONS = {
  spine: [[11,12],[11,23],[12,24],[23,24]],
  left:  [[11,13],[13,15],[15,17],[17,19],[19,21],[21,22],[21,25],[25,27],[27,29],[29,31],[31,32]],
  right: [[12,14],[14,16],[16,18],[18,20],[20,22],[22,26],[26,28],[28,30],[30,32]],
  head:  [[0,1],[1,2],[2,3],[3,7],[7,0],[0,4],[4,5],[5,6],[6,8],[8,0]]
}

for (const [i, j] of CONNECTIONS.spine) {
  ctx.moveTo(person[i].x * W, person[i].y * H)
  ctx.lineTo(person[j].x * W, person[j].y * H)
}
ctx.lineWidth = Math.max(2, W * 0.005) // 线宽自适应
ctx.strokeStyle = "#ffb84d"
ctx.stroke()
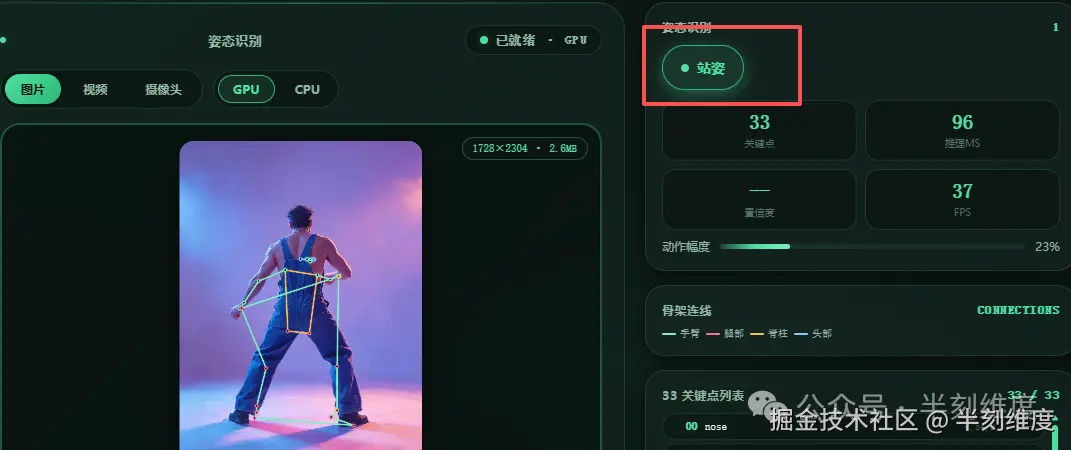
站坐躺判断,用肩膀和髋部的 y 坐标差:
bash
const hipY = (person[23].y + person[24].y) / 2
const shoulderY = (person[11].y + person[12].y) / 2
const gap = hipY - shoulderY

if (gap > 0.12) return "站姿"
if (gap > 0.04) return "坐姿"
return "躺姿"
注意 y 向下增大。写成 shoulderY - hipY 就是负数,永远判"躺姿"。
6. 输出 33 点坐标
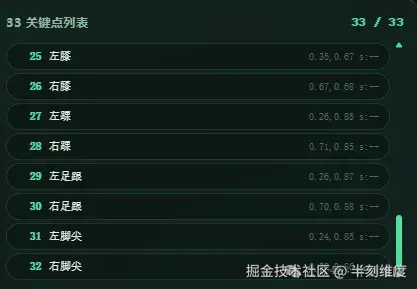
bash
[
  { x: 0.52, y: 0.18, z: 0.01, score: 0.98 }, // 0 nose
  { x: 0.48, y: 0.22, z: 0.01, score: 0.95 }, // 1 left_eye_inner
  ...
]
x、y 归一化 0 到 1。z 是深度。score 低于 0.5 的点列表里灰掉。
6. 起服务
WASM 需要 COOP/COEP 头:
bash
import { join } from "node:path"

Bun.serve({ port: 3005, async fetch(req) {
  const file = Bun.file(join(import.meta.dir, "static",
    new URL(req.url).pathname === "/" ? "/index.html" : new URL(req.url).pathname))
  return new Response(file, { headers: {
    "Cross-Origin-Opener-Policy": "same-origin",
    "Cross-Origin-Embedder-Policy": "require-corp",
  }})
}})
总结
-
• MediaPipe Tasks Vision:纯 JS,17k+ 星
-
• lite 模型:5.5MB,95% 精度
-
• 页面预加载:打开就加载,带状态徽章
-
• GPU/CPU 切换:实测哪个快用哪个
-
• VIDEO 模式:一个模型通吃图片视频
-
• 20fps 节流:视频识别不卡顿
-
• 四色骨架:头/臂/脊柱/腿一眼分清