摘要:前面的算子都是无状态的------每个 batch 算完就丢。但"累计词频""累计销售额""维护会话状态"这类需求,必须跨 batch 记住之前的结果,这就是 updateStateByKey 的用武之地。这篇拆解它最核心的 updateFunc 签名,讲清必须开 checkpoint 的原因,以及两个容易踩的性能坑(全量 key 遍历、状态无限增长),最后说说为什么新项目更该用 mapWithState。
关键词:Spark Streaming, updateStateByKey, 有状态转换, updateFunc, checkpoint, mapWithState
一、为什么需要 updateStateByKey
先分清一件事:前面讲的 map、filter、foreachRDD、transform,都是无状态的------每个 batch 独立算,算完结果就扔了。但很多实时需求不是这样:
- 实时累计词频:要统计"从程序启动到现在"每个词出现多少次。
- 实时累计销售额:每个商户的累计成交额。
- 会话状态维护:记录用户当前的登录状态。
这些需求的共同点是要跨 batch 记住之前的结果 。updateStateByKey 就是干这个的:它维护一张"key → 状态"的表,每个 batch 用新数据更新这张表,表本身跨 batch 存活。
二、先看懂 updateFunc 签名
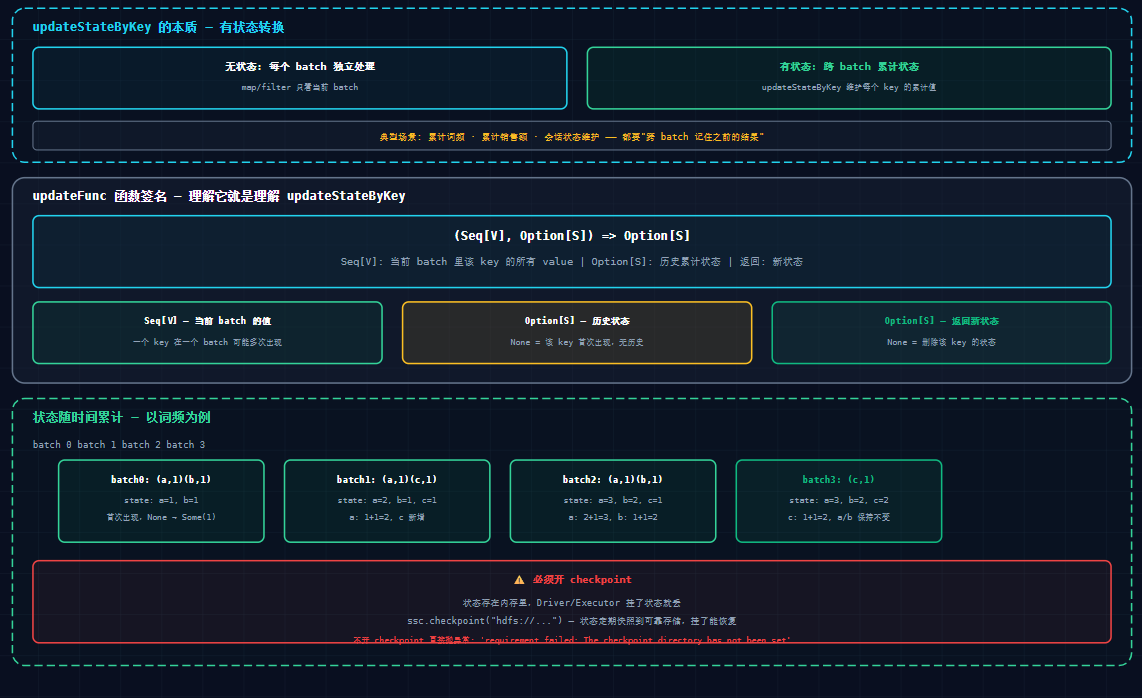
理解 updateStateByKey,关键是把它的核心参数 updateFunc 搞明白:
scala
def updateFunc(newValues: Seq[V], runningCount: Option[S]): Option[S]三个参数:
newValues: Seq[V]:当前这个 batch 里,某个 key 出现的所有 value(一个 key 在一个 batch 里可能多次出现,所以是 Seq)。runningCount: Option[S]:这个 key 的历史累计状态。- 返回
Option[S]:新的累计状态。
Option 是重点:runningCount 为 None 表示这个 key 是第一次出现 ,还没有历史状态;返回 None 表示删除这个 key 的状态。
三、完整代码:累计词频
scala
import org.apache.spark.streaming.{Seconds, StreamingContext}

val ssc = new StreamingContext(conf, Seconds(5))

// 有状态操作必须开 checkpoint,否则抛异常
ssc.checkpoint("hdfs://namenode:8020/checkpoint/wordcount")

val lines = ssc.socketTextStream("localhost", 9999)

def updateFunc(newValues: Seq[Int], runningCount: Option[Int]): Option[Int] = {
  val newCount = runningCount.getOrElse(0) + newValues.sum
  Some(newCount)
}

val stateDStream = lines
  .flatMap(_.split(" "))
  .map(word => (word, 1))
  .updateStateByKey(updateFunc)

stateDStream.print()
ssc.start(); ssc.awaitTermination()
两个关键点:
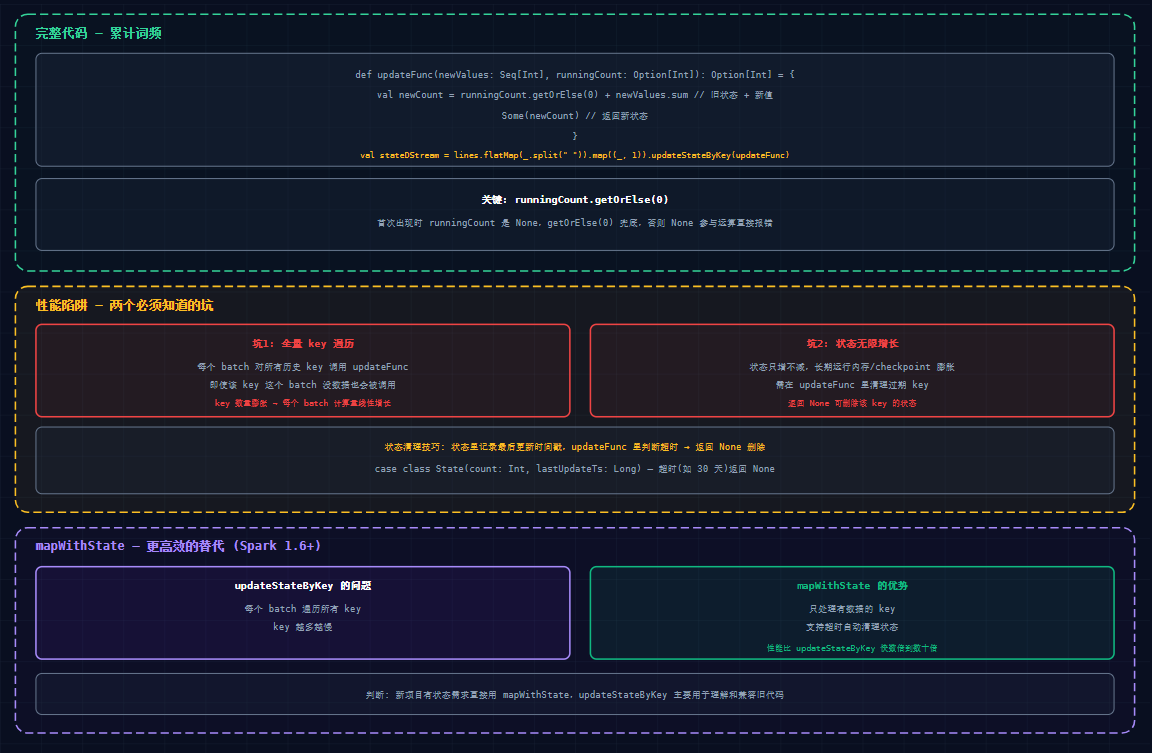
runningCount.getOrElse(0):首次出现的 key,runningCount是None,直接用None参与加法会报错,必须getOrElse(0)兜底。这是新手最容易漏的一步。ssc.checkpoint(...)必须开 :状态存在内存里,Driver 或 Executor 一挂,累积的状态就全丢了。checkpoint 会把状态定期快照到 HDFS,挂了能从快照恢复。不开的话,updateStateByKey直接抛requirement failed: The checkpoint directory has not been set。
四、两个必须知道的性能坑
updateStateByKey 用起来简单,但有两个坑不注意,跑久了会出问题。
坑一:全量 key 遍历
updateStateByKey 的实现是:每个 batch,对所有历史出现过的 key 都调用一次 updateFunc------哪怕这个 key 在当前 batch 根本没新数据。也就是说,key 的数量决定了每个 batch 的计算量。随着 key 越来越多(用户数、商品数在涨),每个 batch 的遍历开销线性增长,处理会越来越慢。
坑二:状态无限增长
状态表只增不减,长期运行的话,内存和 checkpoint 会无限膨胀,最终 OOM 或 checkpoint 写爆。解决思路是在状态里带上最后更新时间,updateFunc 里判断超时就返回 None 删除该 key:
scala
case class State(count: Int, lastUpdateTs: Long)

def updateFunc(newValues: Seq[Int], state: Option[State]): Option[State] = {
  val now = System.currentTimeMillis()
  val old = state.getOrElse(State(0, now))
  val newCount = old.count + newValues.sum
  // 30 天没更新就删除状态
  if (now - old.lastUpdateTs > 30L * 24 * 3600 * 1000) None
  else Some(State(newCount, now))
}
五、为什么新项目更该用 mapWithState
Spark 1.6 引入了 mapWithState,它解决了 updateStateByKey 上面两个坑:
- 只处理有数据的 key:不像 updateStateByKey 那样全量遍历,mapWithState 只对当前 batch 实际出现的 key 更新状态。
- 内置超时清理:可以给状态设置超时时间,超时的 key 自动被移除,不用自己写时间戳判断逻辑。
实测上,key 越多,mapWithState 的优势越明显,性能比 updateStateByKey 快数倍到数十倍。
所以给个明确判断:新项目有状态需求,直接用 mapWithState;updateStateByKey 主要用来理解有状态流式计算的原理,以及维护旧代码。这也是为什么本系列用 updateStateByKey 来讲有状态转换------它是理解这套机制的最佳入口。
六、总结
- updateStateByKey 是有状态转换,维护跨 batch 的"key → 状态"表,解决累计词频、累计销售额这类需求。
- updateFunc 签名
(Seq[V], Option[S]) => Option[S],重点理解None的两种含义:历史无状态、删除状态。 - 必须开 checkpoint,
getOrElse兜底首次出现的 None,这两点是新手最容易踩的。 - 两个性能坑:全量 key 遍历、状态无限增长,后者靠时间戳 + 返回 None 清理。
- 新项目优先 mapWithState,updateStateByKey 用于理解原理和维护旧代码。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践