浏览器/nodejs/bun可运行,
加载 ONNX 模型,推理,获取结果。零后端,零 Python。
onnxruntime-web,微软官方,GitHub 2.3 万星。
快速开始
一个 YOLO 目标检测示例:
bash
import * as ort from "https://cdn.jsdelivr.net/npm/onnxruntime-web"
const session = await ort.InferenceSession.create("yolov5s.onnx")
const tensor = new ort.Tensor("float32", pixels, [1, 3, 640, 640])
const results = await session.run({ images: tensor })
console.log(results.boxes.data) // 输出检测框 [x1,y1,x2,y2]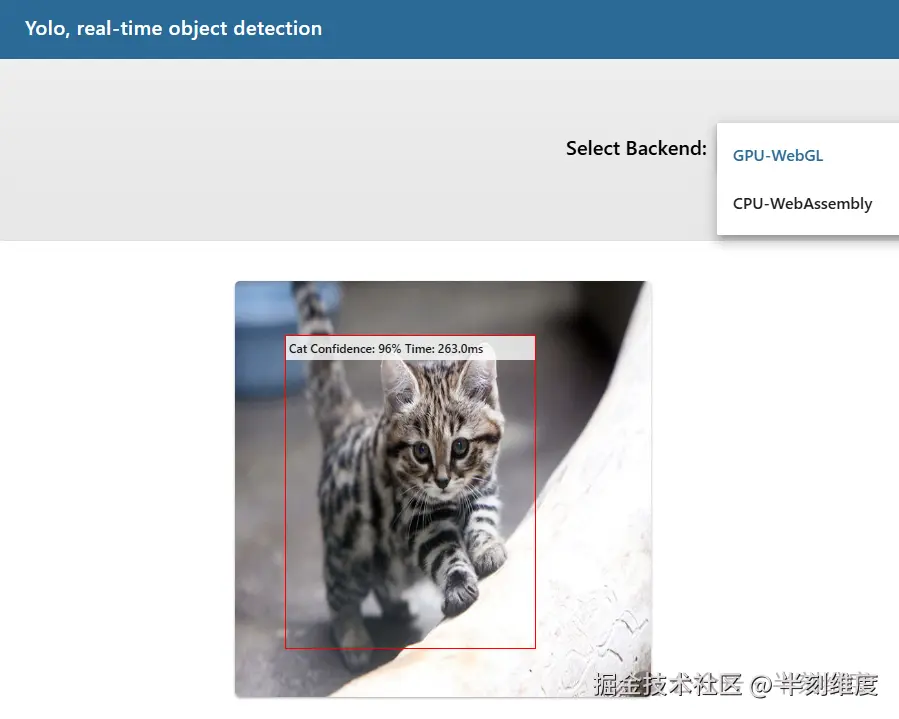
更多 ONNX 模型

ONNX 是开源模型格式,PyTorch、TensorFlow 都能导出。Runtime Web 把它搬进浏览器本地推理。
onnx/models 仓库堆满了现成模型,微软、腾讯、旷视都在贡献:
| 模型 | 中文名 | 用途 | | :-- | :-- | :-- | | MobileNet | 轻量分类 | 手机端图片分类,14MB 够快 | | SqueezeNet | 压缩分类 | 比 MobileNet 更小,5MB | | ResNet | 深度残差网络 | 经典分类模型,精度高 | | YOLOv5 | 目标检测 | 实时框出物体位置 | | SSD | 单阶段检测 | 轻量目标检测,速度优先 | | DeepLabV3 | 语义分割 | 像素级分割,抠图用 | | Whisper | 语音识别 | 音频转文字,多语言 | | BERT | 文本理解 | 文本分类、问答、语义分析 | | GPT-2 | 文本生成 | 对话、续写、文案生成 |
ONNX Runtime Web Demo 点进去看。
架构
bash
加载ONNX → ONNX Runtime Web → 浏览器推理不管原来什么框架,导出成 ONNX 就是通用语言。底层用 Emscripten 编译成 WebAssembly,浏览器就是推理引擎。
基于 onnxruntime-web 的常用项目
生态成熟,下面这些都是直接用它的开源项目。
Whisper 浏览器版
OpenAI 的 Whisper 语音识别模型,转成 ONNX 在浏览器跑:
bash
const session = await ort.InferenceSession.create("whisper-tiny.onnx")Whisper Web 微软官方,GitHub 仓库里也有完整例子。
Real-ESRGAN 图片放大
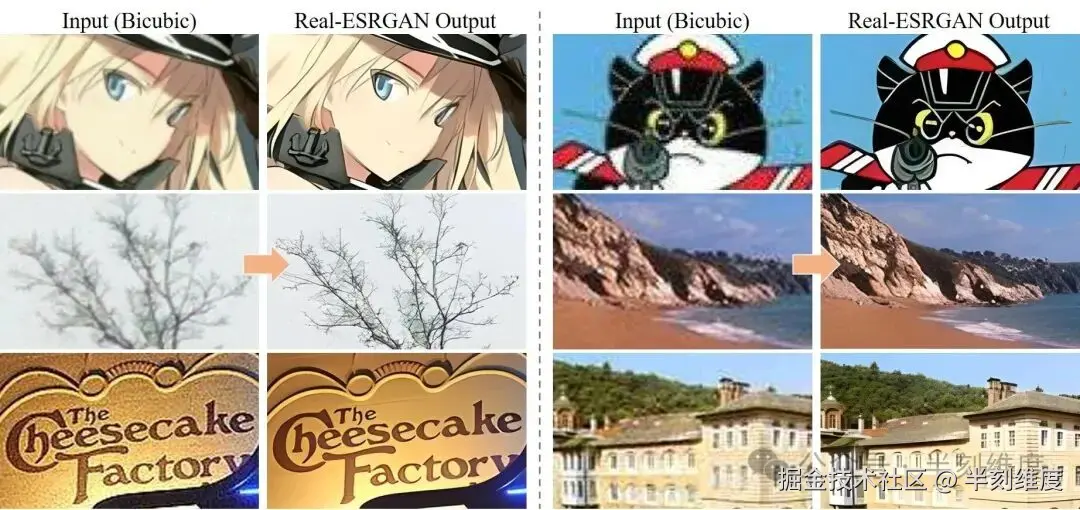
图片 4 倍超分辨率,浏览器直接放大:
bash
const session = await ort.InferenceSession.create("real-esrgan.onnx")Real-ESRGAN-Web 原作者 xinntao 出品,GitHub 4.3 万星。
TensorFlow.js 替代方案
不想用 TF.js 的话,onnxruntime-web 是平替。
ONNX Runtime Web 微软官方,直接替代 TF.js 做浏览器推理。
face-api.js 平替
人脸识别、检测、表情分析。onnx 模型 + runtime-web 组合:
bash
const session = await ort.InferenceSession.create("face_detection.onnx")face-api.js GitHub 5.3 万星,底层也是 ONNX 推理。
对应往期文章:网页端, 6.5MB人脸识别模型, 谷歌框架, 又快又准
Transformers.js
HuggingFace 出品的浏览器端 Transformer 推理库,底层用 onnxruntime-web:
bash
import { pipeline } from "https://cdn.jsdelivr.net/npm/@huggingface/transformers"
const classifier = await pipeline("text-classification")
Transformers.js GitHub 1.2 万星,BERT、GPT 模型浏览器直跑。
MediaPipe Web
谷歌的 MediaPipe,手势、人脸、姿态识别,ONNX 推理层:
bash
import { FilesetResolver, FaceLandmarker } from "@mediapipe/tasks-vision"
const vision = await FilesetResolver.forVisionTasks(CDN_URL)
const faceLandmarker = await FaceLandmarker.create(vision, options)
MediaPipe Web 谷歌官方,GitHub 2.3 万星。
对应往期文章: 网页端, 5.5mb谷歌模型, 识别躯干, 视频都不卡