在 LLM(大语言模型)和 RAG(检索增强生成)爆发的时代,传统爬虫在面对复杂渲染和高强度反爬限制时往往显得力不从心。如何快速、稳定地获取高质量数据?Crawl4AI 作为专为 AI 时代打造的高性能开源 Python 异步爬虫框架,凭借极快的提取速度和 Markdown 友好格式,迅速成为了开发者的数据采集利器。
本文将手把手带你从零搭建 Crawl4AI 爬虫,并重点攻克批量采集中的核心痛点------反爬与代理配置,让你彻底告别 IP 封禁困扰。
什么是 Crawl4AI?
Crawl4AI 是一个基于 Playwright 和 Python 异步生态构建的现代网页采集工具。与 Scrapy 或 Requests 相比,它具备三大核心优势:
-
大模型原生友好:输出可以直接转化为格式干净的 Markdown 或 JSON,无缝对接 RAG 管道。
-
高性能异步渲染:轻松处理 JavaScript 动态加载页面,同时保持极高并发效率。
-
高度可定制化:支持精细化控制浏览器行为、请求头、Cookie 以及网络代理。
环境准备与基础抓取
在开始实战之前,确保环境安装完毕。Crawl4AI 的环境配置非常简单:
# 安装 Crawl4AI
pip install crawl4ai

# 初始化安装所需浏览器内核
crawl4ai-setup
安装完成后,我们可以编写一个最基础的异步抓取脚本:
import asyncio
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(url="https://example.com")
        if result.success:
            # 打印抓取到的纯文本 Markdown 格式内容
            print(result.markdown[:300])

if __name__ == "__main__":
    asyncio.run(main())
运行该脚本,若能顺利输出页面前 300 个字符的 Markdown 数据,说明基础环境建立成功。
批量采集关键:代理 IP 选择与轮换策略
在 Crawl4AI 批量网页采集的场景中,实际运行中会产生大量请求,因此需要配置动态轮换代理突破反爬限制。代理 IP 建议优先选择动态住宅代理类型。相比固定代理,动态住宅 IP 可以根据采集任务高频进行轮换,更适合公开网页的批量抓取场景。
对于批量网页采集的场景下,可以选择 IPFoxy 提供的动态住宅代理、不限量住宅代理,能够减少因 IP 问题导致数据采集失败的概率。(可前往领取动态住宅免费流量进行测试)
以 IPFoxy 动态住宅代理为例,使用 Crawl4AI 进行批量采集时,进入后台点击"提取动态页面",再根据业务需求选择目标国家、代理类型和轮换模式,可以优先考虑以下两种方式:
-
粘性会话(30-120 分钟):在设定时间内保持同一个 IP 连接,期间所有请求均通过同一 IP 发出,适合带登录态/cookie、多步骤流程、自动化测试的数据采集。
-
每次请求轮换:每次发起请求都会自动分配新的住宅 IP,适合高并发、大规模的公开数据抓取。
Crawl4AI 代理配置实战演练
Crawl4AI 的代理配置主要分为两部分:BrowserConfig 负责浏览器运行环境,CrawlerRunConfig 负责本次爬取任务。
1.① BrowserConfig 层级:配置浏览器:搭建运行环境.
先创建基础浏览器配置,例如设置 Chromium 和无头模式。如果在调试过程中需要观察浏览器实际打开了什么页面,可以临时将 headless=False,方便检查页面加载和跳转情况。
from crawl4ai import AsyncWebCrawler, BrowserConfig

browser_config = BrowserConfig(
    browser_type="chromium",
    headless=True
)
2.② CrawlerRunConfig 层级:配置 IPFoxy 代理:绑定动态代理.
进入 IPFoxy 后台生成代理信息并复制,然后将 IPFoxy 提供的代理参数填入 ProxyConfig: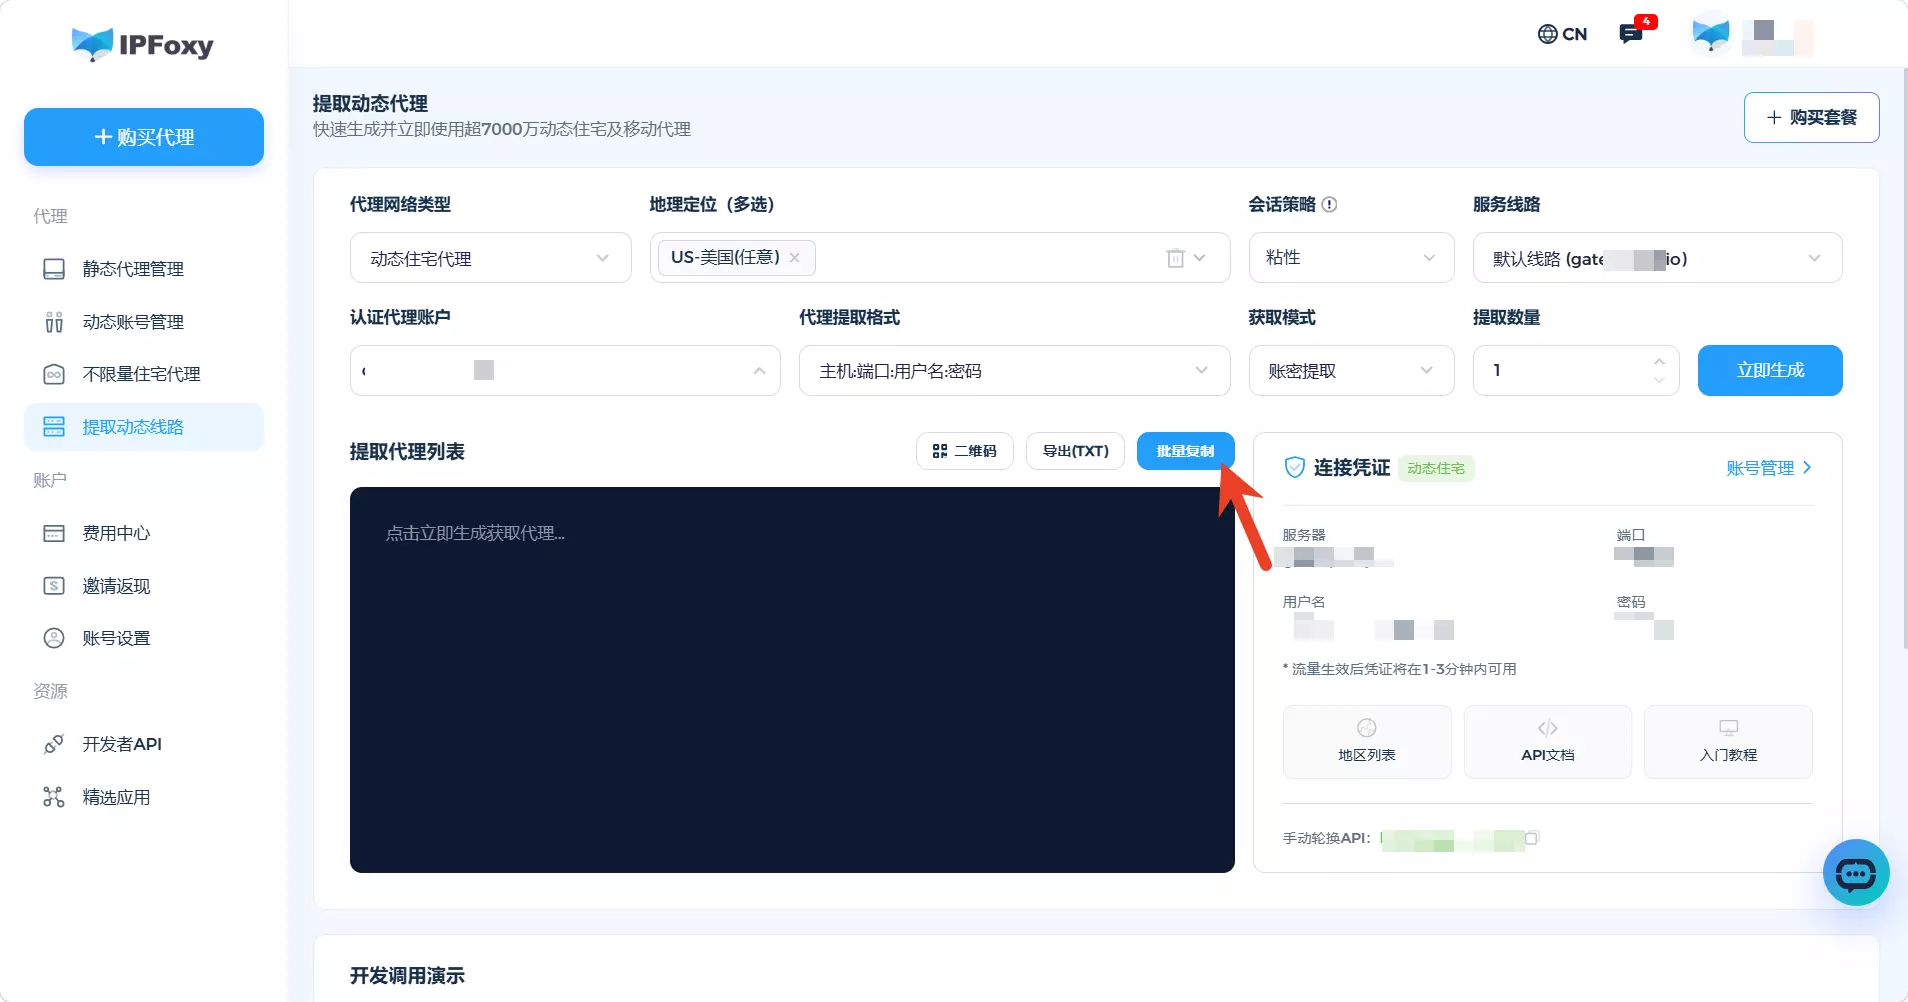
from crawl4ai import CrawlerRunConfig, ProxyConfig

run_config = CrawlerRunConfig(
    proxy_config=ProxyConfig(
        server="http://HOST:PORT",
        username="USERNAME",
        password="PASSWORD"
    )
)
3.③ 将代理应用到爬虫任务:验证代理生效.
最后将两个配置组合到爬虫任务中并执行:
import asyncio
from crawl4ai import AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, ProxyConfig

async def main():
    browser_config = BrowserConfig(
        browser_type="chromium",
        headless=True
    )

    run_config = CrawlerRunConfig(
        proxy_config=ProxyConfig(
            server="http://HOST:PORT",
            username="USERNAME",
            password="PASSWORD"
        )
    )

    async with AsyncWebCrawler(config=browser_config) as crawler:
        result = await crawler.arun(
            url="https://example.com",
            config=run_config
        )
        print(result.markdown[:500])

if __name__ == "__main__":
    asyncio.run(main())
如果 result.success 返回 True,并能正常输出网页内容,说明代理已经成功接入 Crawl4AI。
实践建议
在实际批量数据抓取与内容发布时,建议遵循以下最佳实践:
-
控制并发频率:即使用了高品质动态住宅代理,也应加入适当的随机等待延迟,尊重目标网站的
robots.txt规则。 -
请求头伪装:建议结合随机
User-Agent与头部字段,降低风控概率。 -
数据清洗:利用 Crawl4AI 内部的提取策略(Extraction Strategy),直接在端侧完成噪音过滤,提升下游大模型处理效率。
总结
结合 Crawl4AI 的异步高效提取性能与 动态住宅代理 的防封轮换能力,开发者可以轻松搭建出稳定可靠的大规模数据采集流水线。无论是粘性会话还是高并发轮换模式,这套组合拳都能极大提升公开数据抓取的成功率。