此次质朴学习源自"以赛促学"
发送请求与获取内容
python
# 引入requests库
import requests
#发送请求(爬取"云南神农农业产业集团有限公司的主要财务指标")
r=requests.get('https://oss.xinchanjiao.com/bigdata/company/2021/csv/cwbbzy_605296.csv')
#检测请求的状态码
print("返回的状态码:",r.status_code)
#header中猜测的响应内容编码方式
print("header中猜测编码方式:",r.encoding)
#内容中分析出的响应内容编码方式
print("内容中分析的编码方式:",r.apparent_encoding)
#更换解码方式
r.encoding=r.apparent_encoding
r.text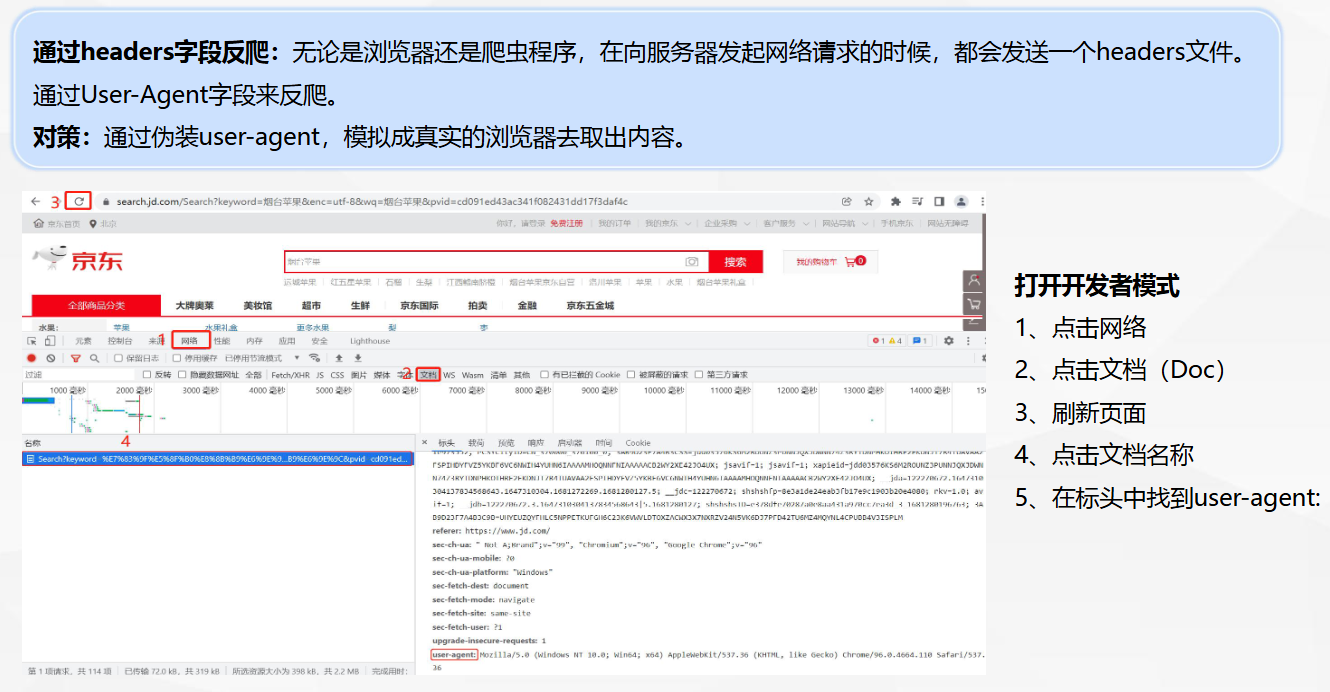
python
import requests  #引入requests库
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0;
Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko)
Chrome/96.0.4664.45 Safari/537.36'}
r=requests.get("https://www.amazon.cn/dp/B078K5FXZ
V/ref=lp_1759032071_1_6",headers =headers )
#检测请求的状态码
print("返回的状态码:",r.status_code)
#变换编码方式
r.encoding=r.apparent_encoding
print(r.text[500000:530000])
解析内容与保存数据
Xpath
在浏览器中安装扩展xpath helper插件,可以辅助解析xpath地址
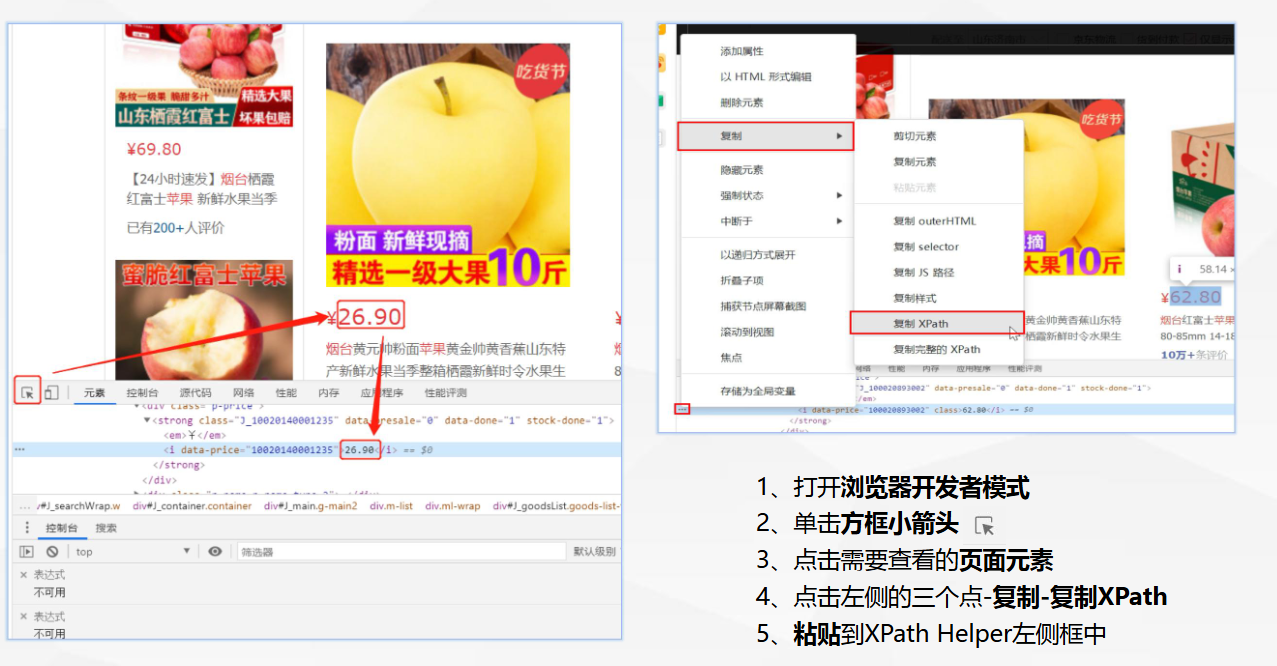
python
#引入所需要的库
import requests
from lxml import etree
import pandas as pd
#设置头信息进行绕过反爬
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36'}
#发送请求
resp = requests.get("https://search.jd.com/Search?keyword=烟台苹果&enc=utf-8&pvid=b41e02073b39402f96f74c92e51e2fab",headers=headers)
html = resp.content.decode()
element = etree.HTML(html)
#店铺
name = element.xpath('//*[@id="J_goodsList"]/ul/li/div/div[5]/span/a/text()')
#金额
pay  = element.xpath('//*[@id="J_goodsList"]/ul/li/div/div[2]/strong/i/text()')
#查看结果
a =list(zip(name,pay))
df=pd.DataFrame(a,columns=['店铺','金额'])
df 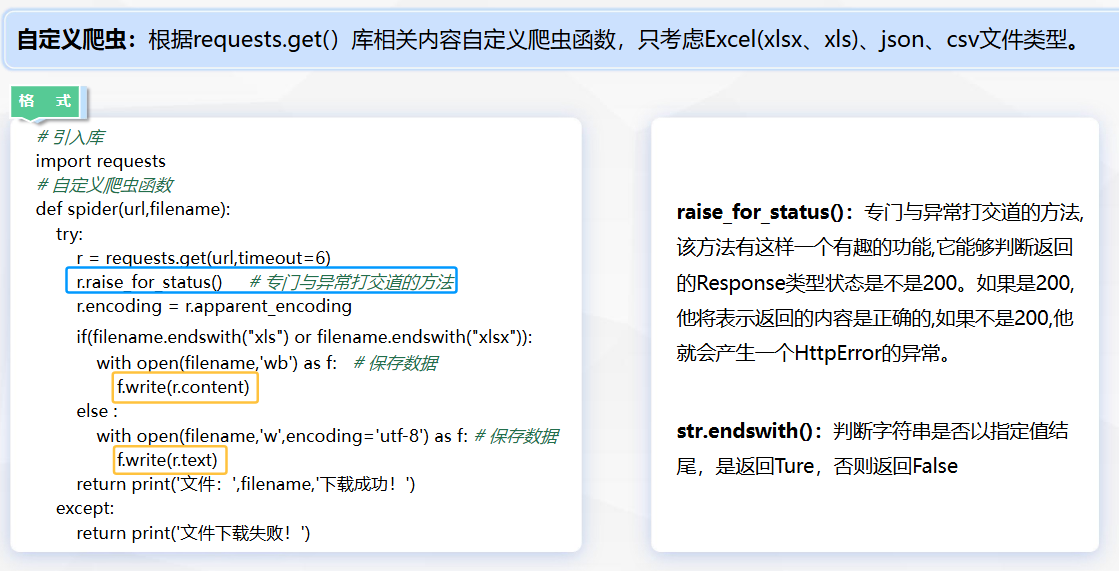
用了request .get方法后,返回一个response对象,这个对象里面存的是服务器返回的所有信息,包括响应头,响应状态码等。
其中返回的网页部分会存在.content和.text两个对象中。如果需要获得这些网页原始数据,我们可以通过r.text 或 r.content来获取数据。
.text 存的是.content 编码后的字符串
.content中间存的是字节码
一般来说 .text直接用比较方便,返回的是字符串 ,但是有时候会解析不正常,导致返回的是一堆乱码。这时需要用.content.decode('utf-8'),使其正常显示。
总的来说.text是现成的字符串,.content还要编码,但是.text不是所有时候显示都正常(需要用.content.decode()进行手动编码)
原文链接:https://blog.csdn.net/sehun_sx/article/details/123764263
python
# 引入库
import requests
# 自定义爬虫函数
def spider(url,filename):
    try:
        r = requests.get(url,timeout=6)
        r.raise_for_status()     # 专门与异常打交道的方法
        r.encoding = r.apparent_encoding
        if(filename.endswith("xls") or filename.endswith("xlsx")):
            with open(filename,'wb') as f:   # 保存数据
                f.write(r.content)
        else :
            with open(filename,'w',encoding='utf-8') as f: # 保存数据
                f.write(r.text)
        return print('文件:',filename,'下载成功!')
    except:
        return print('文件下载失败!')
# 调用爬虫函数输入URL及文件名称
spider('https://oss.xinchanjiao.com/bigdata/company/2021/list/hy001000.json','农林牧渔.json')
数据处理Numpy
Numpy的核心数据结构是ndarray,支持任意维数的数组,但要求单个数
组内所有类型必须相同。
ndarray 是 NumPy 的核心数据结构,用于存储同类型元素的多维数组。它提供了高效的数值计算能力,并支持多种操作和属性。
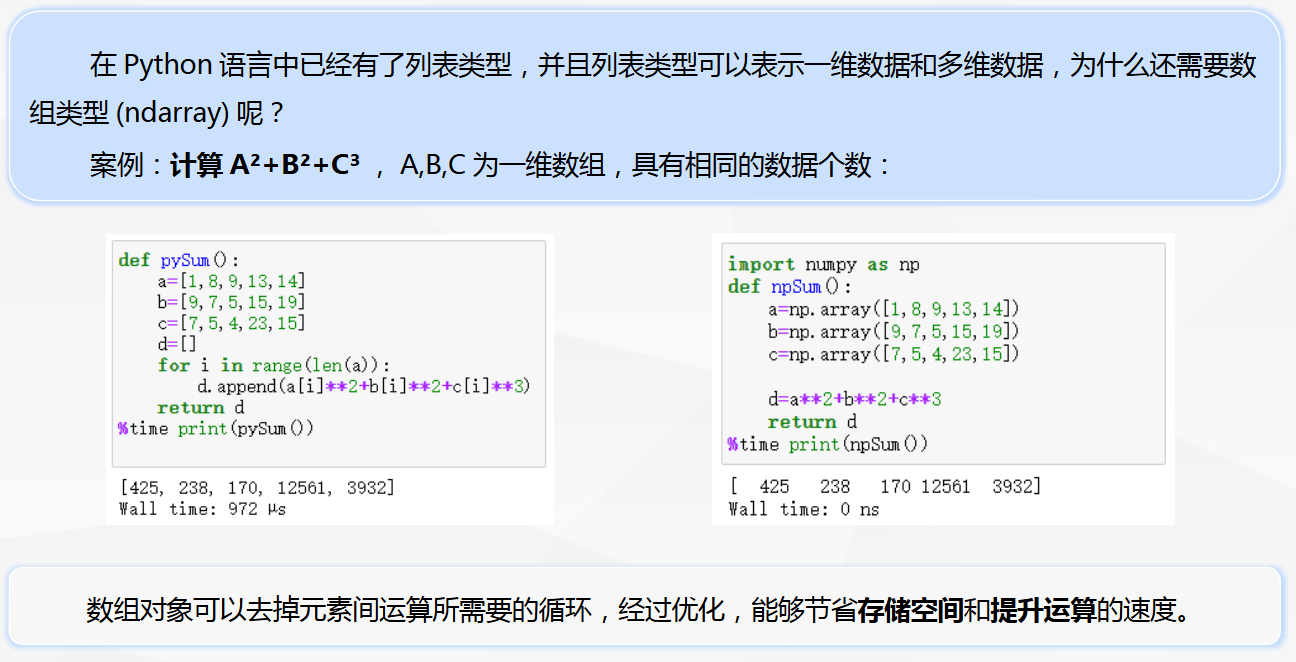
数据与列表的区别
节省存储空间和提升运算的速度
创建数组的方法:
- np.array(列表、数组)例如:np.array(1,2,3),np.array((4,5,6))
- np.arange(1,5,2) 1,3
python
#设置起始值10、终止值20,步长2
c= np.arange(10,20,2)
#arange创建数组,reshape指定数组尺寸
d=np.arange(23).reshape(3,4,2)
array([[[ 0,  1],
        [ 2,  3],
        [ 4,  5],
        [ 6,  7]],

       [[ 8,  9],
        [10, 11],
        [12, 13],
        [14, 15]],

       [[16, 17],
        [18, 19],
        [20, 21],
        [22, 23]]])
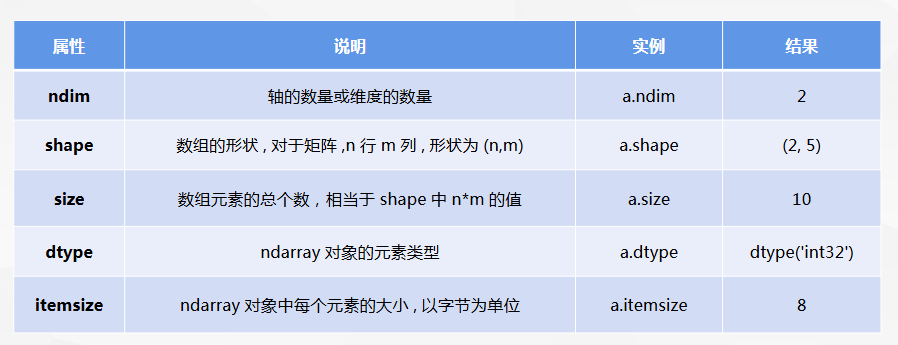
数组ndarray属性
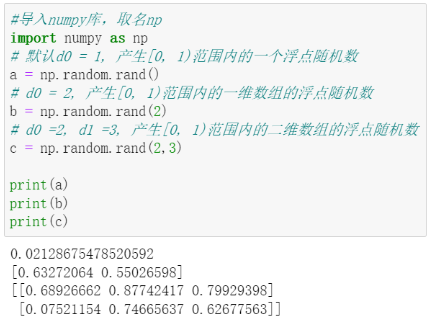
利用rand函数,生成[0,1)范围内的一个浮点数/一维数的浮点随机数/二维数组的浮点随机数。
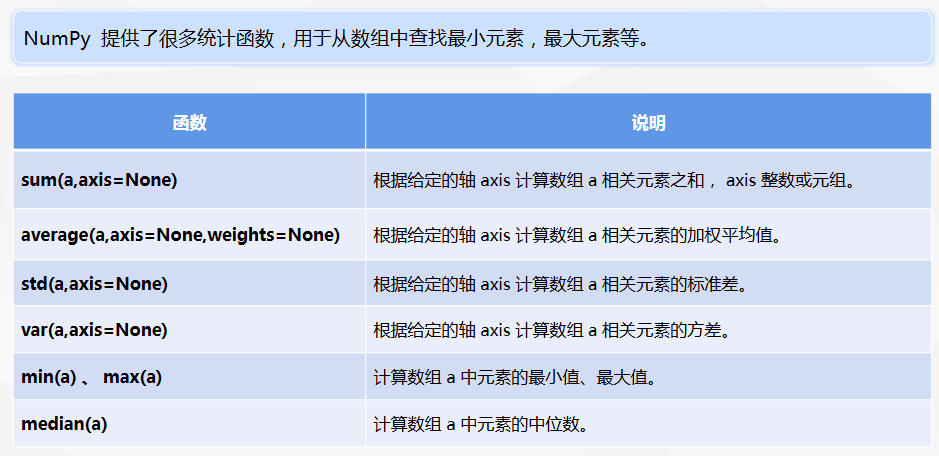
python
a=np.array([0,1,2,3,4,5,6,7,8])
#求最大值、最小值
print(np.max(a))
print(np.min(a))
np.eye() 是 NumPy 中用于生成二维数组(单位矩阵)的函数,其对角线元素为 1,其余元素为 0。它常用于线性代数、矩阵运算以及机器学习模型初始化等场景。
np.zeros 是 NumPy 库中的一个函数,用于创建一个指定形状和数据类型的数组,并用零填充。
python
import numpy as np
I = np.eye(3)
print(I)
# 输出:
# [[1. 0. 0.]
# [0. 1. 0.]
# [0. 0. 1.]]
import numpy as np
# 创建一个3x3的二维数组
c = np.zeros((3, 3))
print(c)
# 输出:
# [[0. 0. 0.]
# [0. 0. 0.]
# [0. 0. 0.]]
Series & DataFrame
Python数据分析(Series+DataFrame+部分运算+groupby)
条件筛选,也称带条件判断的数据筛选,可以通过条件在数据中筛选出条件为True的数据,常见的形式有:
Ø 选取某列满足一定条件的行,dfdf\['列'==条件]:选取某列满足一定条件的行
Ø 选取多列满足一定条件的行,df(df\['列1'==条件)&(df'列2'>=条件)]:选取多列满足一定条件的行。
python
#通过布尔索引选取某列满足一定条件的行
df[df['门店']=='门店03']
#通过布尔索引选取多列满足多个条件的行
df[(df['销售收入']>=400000)&(df['销售成本']>=300000)]
#通过布尔索引选取多列满足一定条件的行
df[(df['销售收入']>=400000)|(df['销售成本']>=300000)]
# 这个左右&左右的()必须要加!!!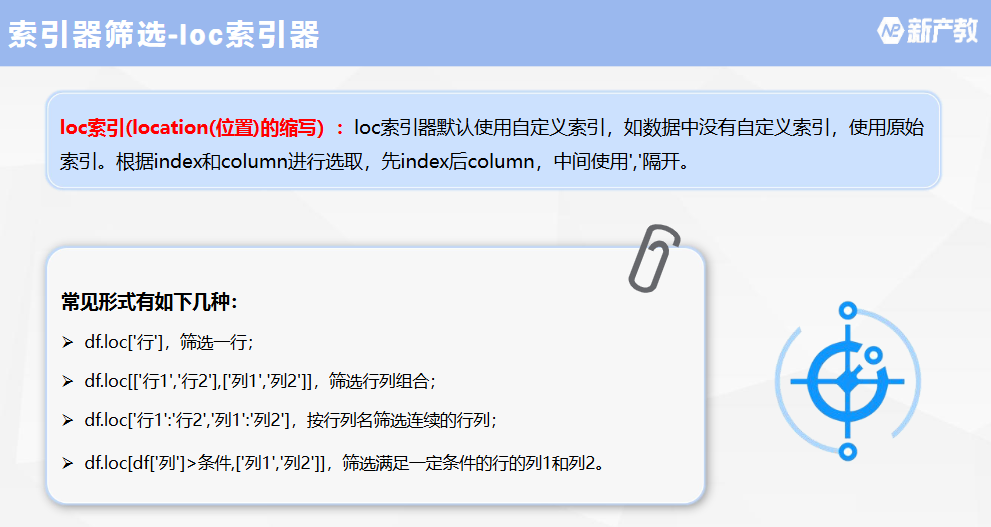
python
#loc索引器选取一行
df.loc[2]
#loc索引器选取行列组合
df.loc[[0,3],['门店','销售收入']]
#loc索引器-按条件选取行
df.loc[:3,'门店':'销售毛利']
#loc索引器-按条件选取行列
df.loc[(df['销售毛利']>200000),['门店','销售毛利']]
数据读写
读取Excel数据
python
#导入Pandas库
import pandas as pd
#读取Excel文件,利用converters参数强制设置"年"、"月"、"门店"三列转换为字符串类型。
df=pd.read_excel(r'https://oss.xinchanjiao.com/upload/default/20220914-1bbc5a0e-9409-4ffa-adab-06f15090e2fb.xlsx',
sheet_name=0,converters={'年':str,'月':str,'门店':str})
#显示数据前5行
df.head()
写入Excel
python
#导出新Excel表格,名称'门店销售数据2',表名为'毛利率'
df.to_excel('门店销售数据2.xlsx',sheet_name = '毛利率')
#显示出数据
d
追加
若用to_excel()函数写到一个已经存在的Excel,将会把原有的Excel表格数据全部覆盖。可以配合使用
追加写入Excel表:ExcelWriter()函数解决此问题。
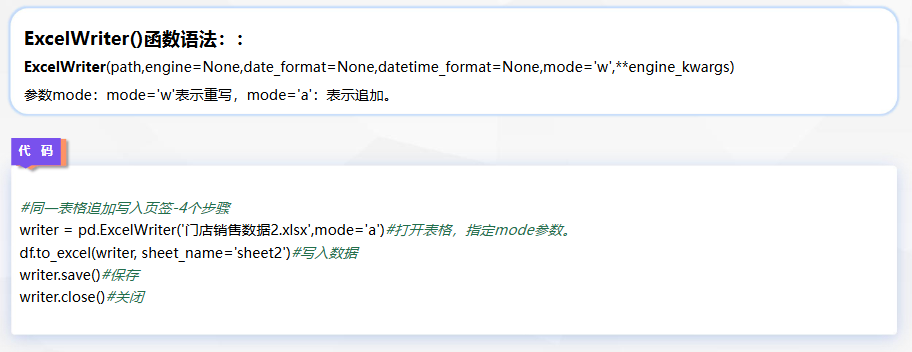
python
#简洁写法:在原有的Excel文件追加内容
with pd.ExcelWriter('门店销售数据2.xlsx',mode='a') as writer:
       df.to_excel(writer,sheet_name='毛利率2')
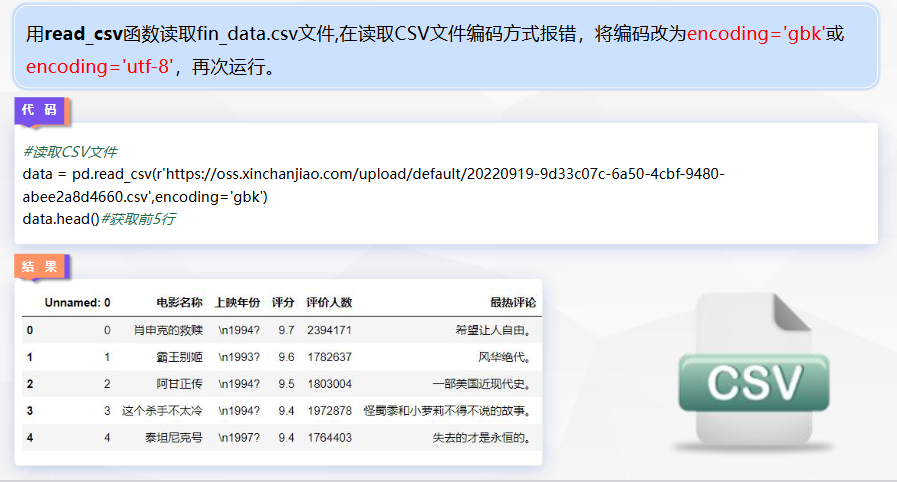
csv
python
#读取CSV文件
data = pd.read_csv(r'https://oss.xinchanjiao.com/upload/default/20220919-9d33c07c-6a50-4cbf-9480-
abee2a8d4660.csv',encoding='gbk')
data.head()#获取前5行


#写入CSV文件
data.to_csv('data1.csv',encoding='gbk')
数据特征分析
sum/max/min/describe
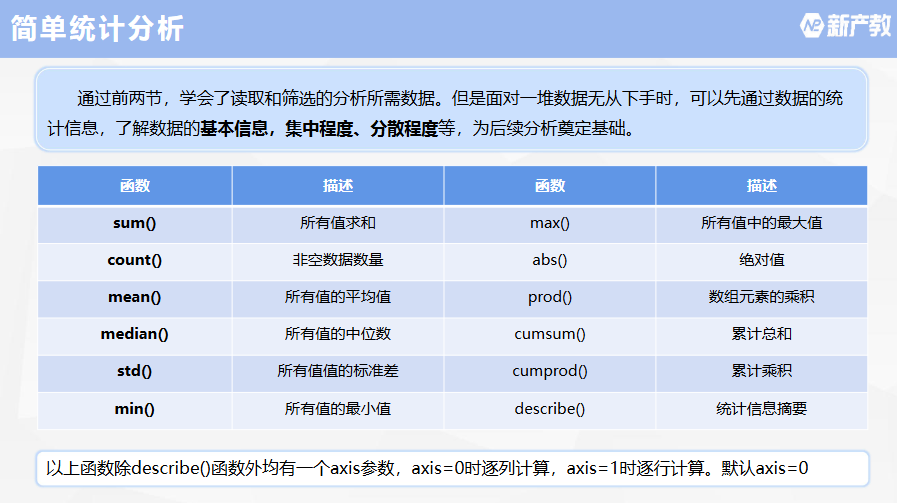
axis=0时逐列计算,axis=1时逐行计算。默认axis=0
案例:
返回的describe常见的统计指标中,筛选出"销售成本"的平均值。
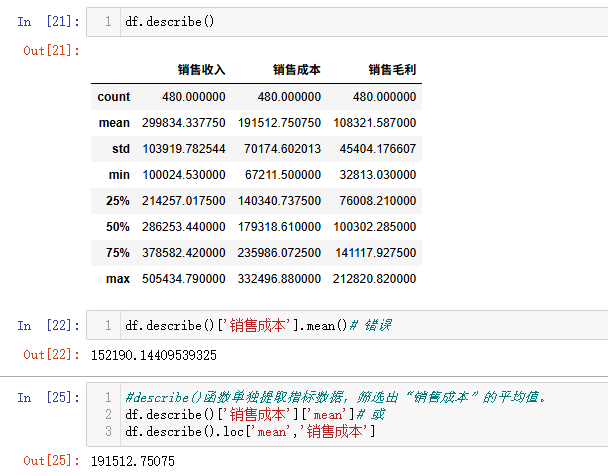
python
#describe()函数单独提取指标数据,筛选出"销售成本"的平均值。
df.describe()['销售成本']['mean']# 或
df.describe().loc['mean','销售成本']
排序
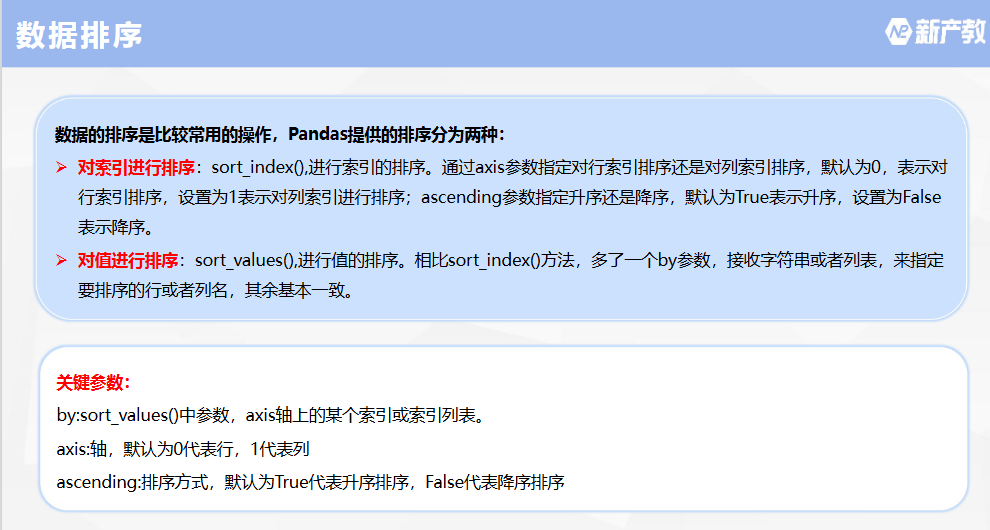
sort_index 参数:axis默认为0行索引,1列索引排序,ascending默认为True升序排序,False降序排序
python
#根据索引进行排序:
#axis=0行索引,
#ascending=False代表降序排列
#inplace=True代表直接对df进行修改
#并查看前五行数据
df.sort_index(axis=0,ascending=False,inplace=True)
df.head()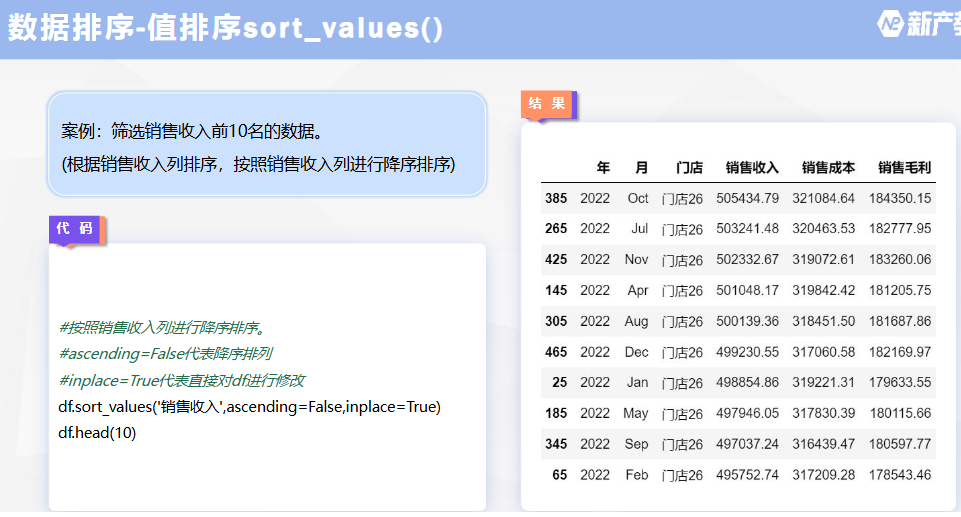
案例:计算销售毛利前10的数据,如销售毛利相同,根据销售收入升序排序。
(根据多列进行排序:先根据销售毛利降序排序,如销售毛利相同,再根据销售收入升序排序。)
python
#按照销售毛利降序、销售收入升序进行排序。
#ascending=False代表降序排列
#inplace=True代表直接对df进行修改
df.sort_values(['销售毛利','销售收入'],#排序列
               ascending=[False,True],#排序方式
               inplace=True)#直接修改
df.head(10)#查看前10
累积函数
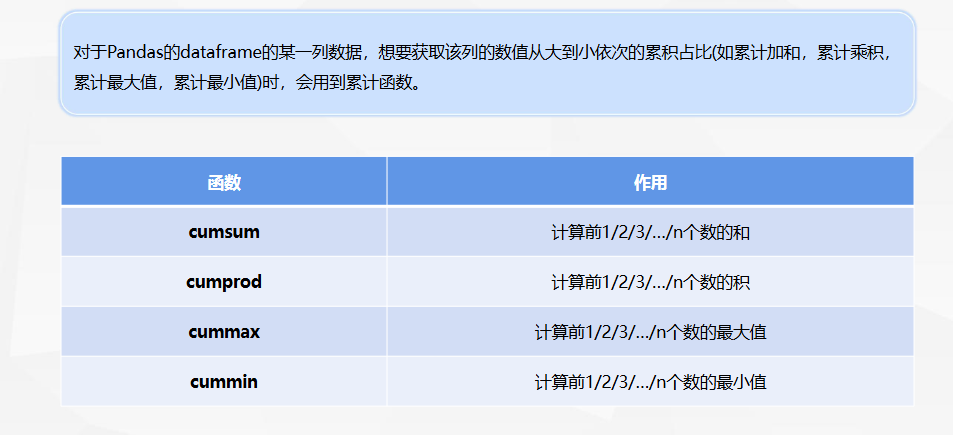
案例:(1)筛选出各家门店一月份(Jan)的数据,根据销售收入降序排列,
(2)使用cumsum计算累计销售收入,赋值给累计销售收入列。
python
#筛选月份为一月(Jan)的数据,根据销售收入降序排列
df1 = df.loc[df['月']=='Jan'].sort_values('销售收入
',ascending=False)
#计算销售收入的累计和,赋值给累计销售收入列。
df1['累计销售收入'] = df1['销售收入'].cumsum()
#查看数据前5行
df1.head()
数据合并
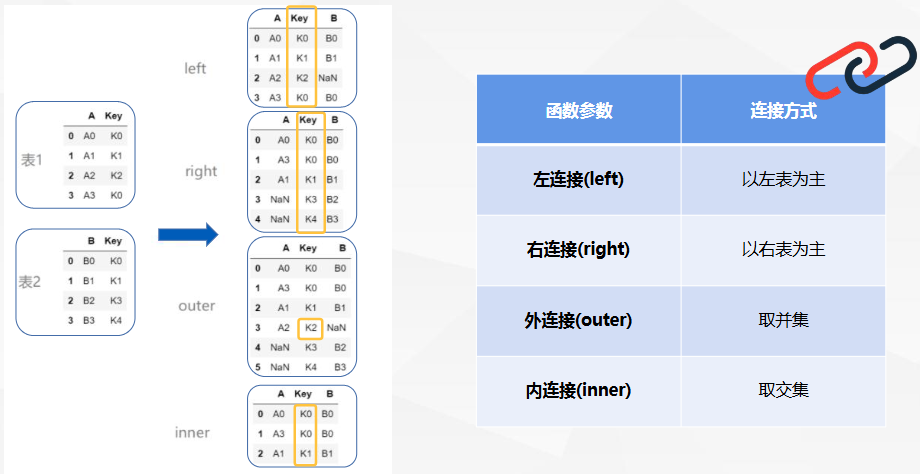
- merge()函数:merge()只能用于两个DataFrame间列方向进行内联或外联合并操作;默认取交集
- concat()函数:concat()可用于两个及多个DataFrame间行/列方向进行内联或外联合并操作,默认对行(沿y轴)取并集
merge
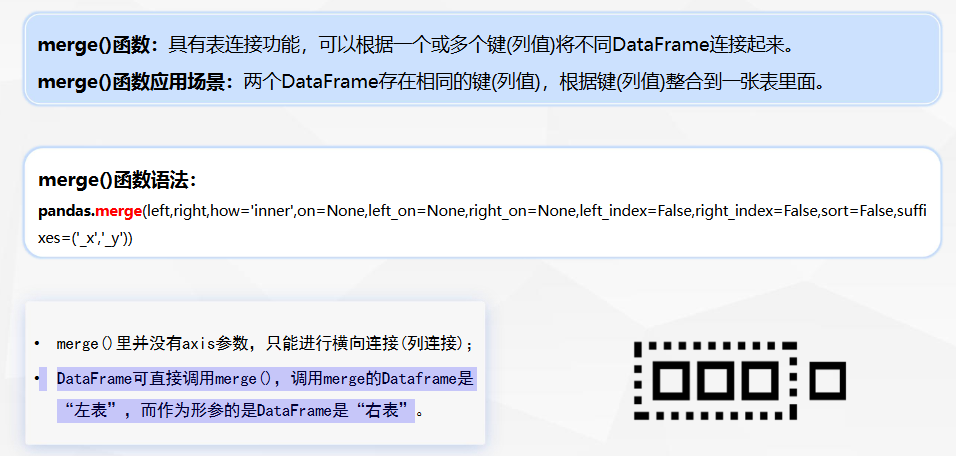
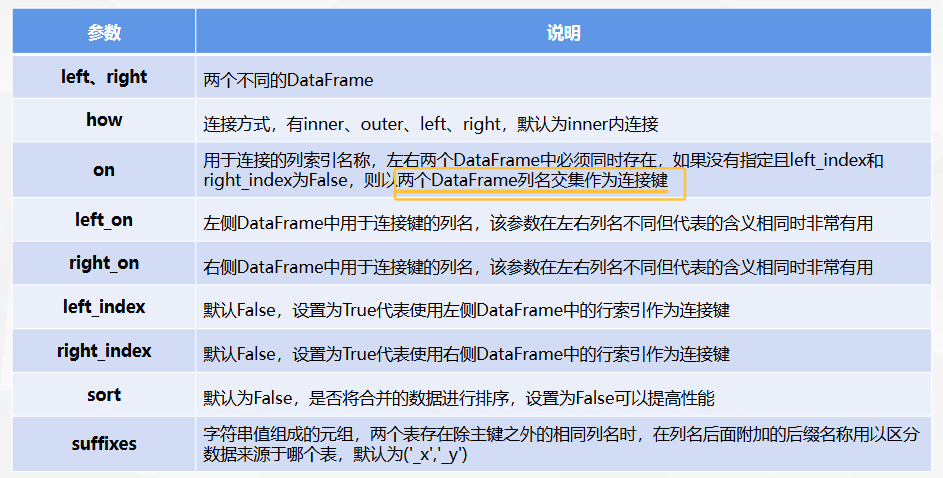
默认为inner内连接
contact
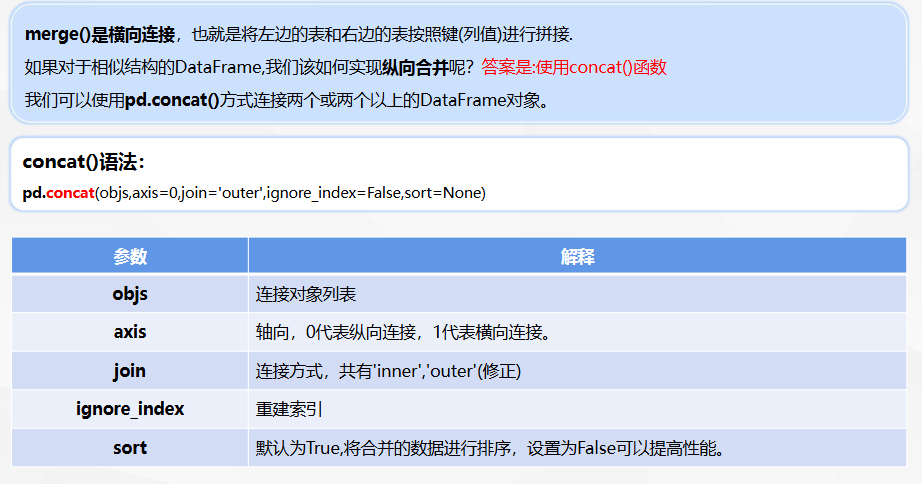
axis=0 默认为纵向连接(行增加)
axis=1 横向连接(列增加)
python
#df1,df2,调整axis参数用concat进行横向列连接
df4=pd.concat([df1,df2],axis=1,sort=False)
df4
数据清洗
数据清洗主要包括:缺失值清洗、逻辑错误清洗、重复数据清洗、格式内容清洗
重复
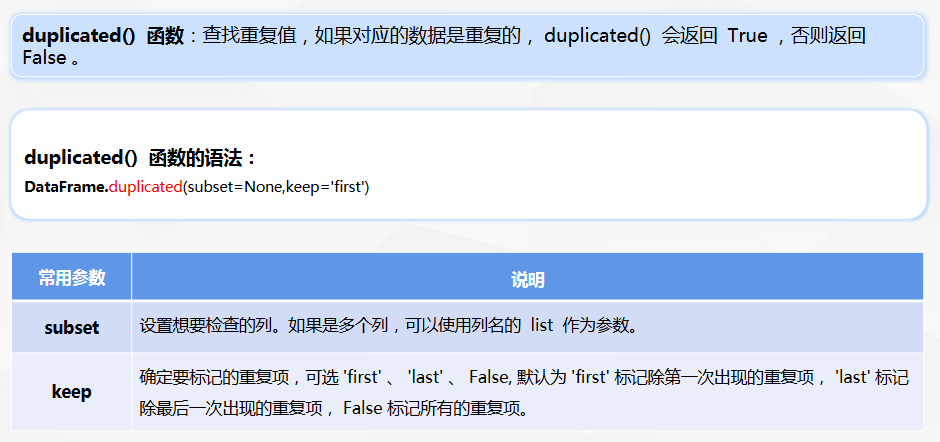
查找重复项:
duplicated() :如果对应的数据是重复的, 会返回 True,否则返回 False。
删除重复项:
drop_duplicates() :删除重复数据
python
#引入库
import pandas as pd
#读取数据
df=pd.read_excel(r'https://oss.xinchanjiao.com/upload/default/20221109-780c231e-ec8d-4f7a-a878-15ca651452f7.xlsx')
#查找重复项
print(df)
df.duplicated()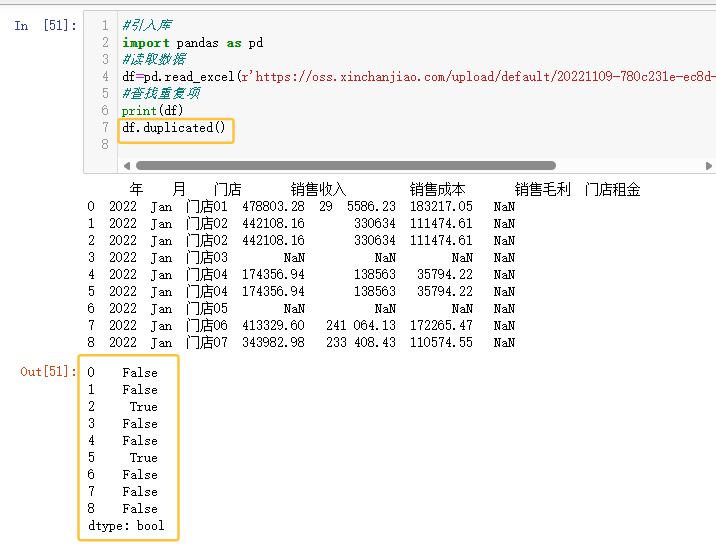
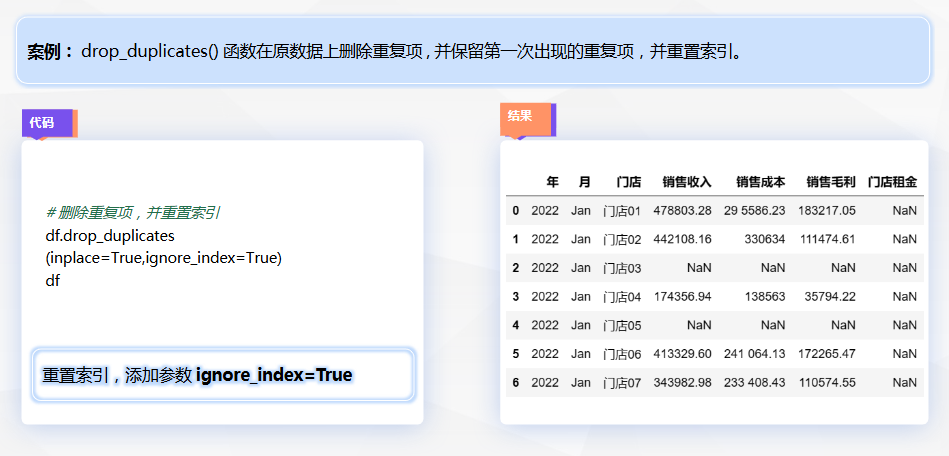
python
#删除重复项,并重置索引
df.drop_duplicates(inplace=True,ignore_index=True)
df
缺失
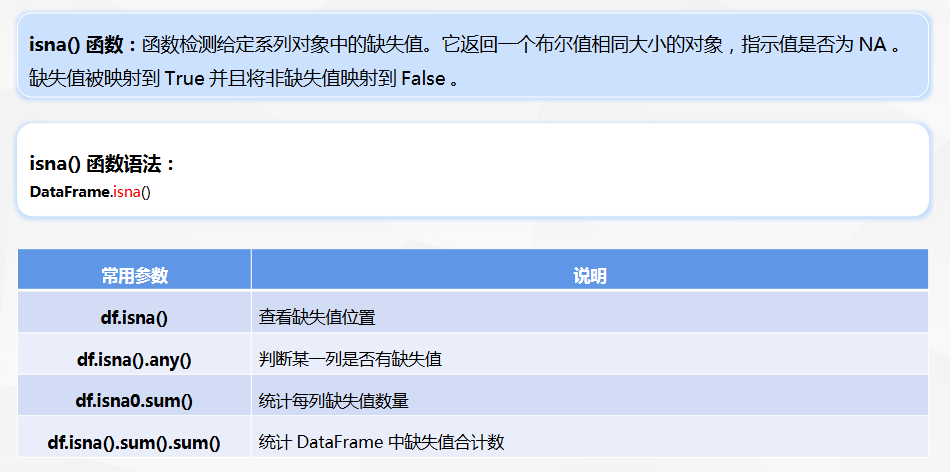
缺失值处理包含两个步骤:
- 缺失值判断和空值处理。
- 根据判断的缺失值数量和重要性决定缺失值处理的方式。
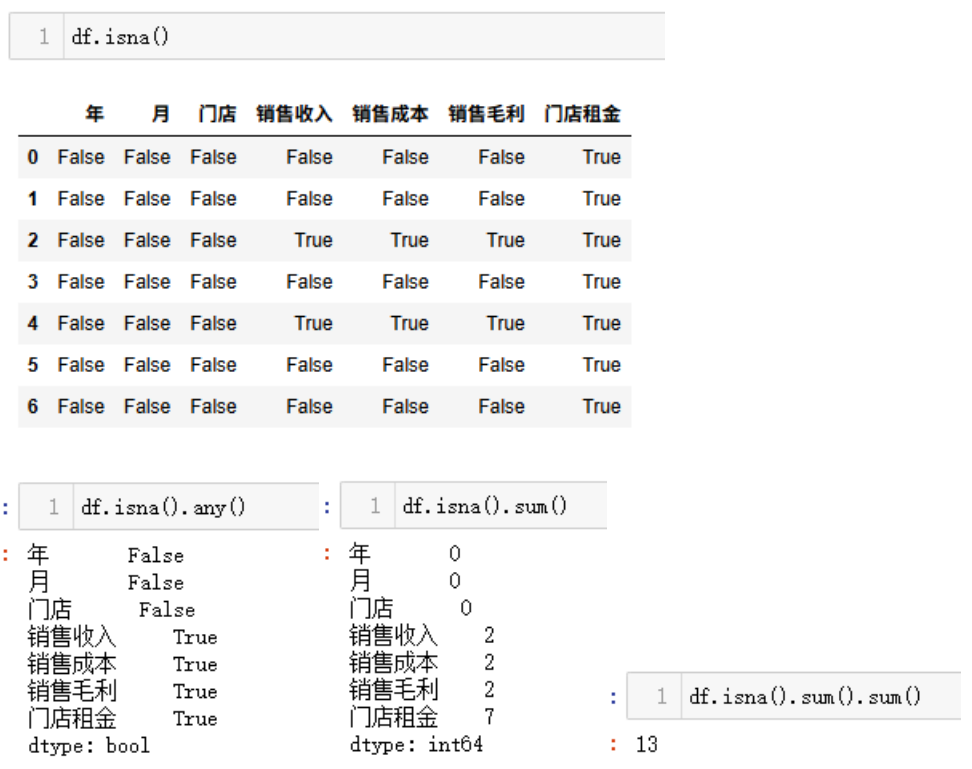
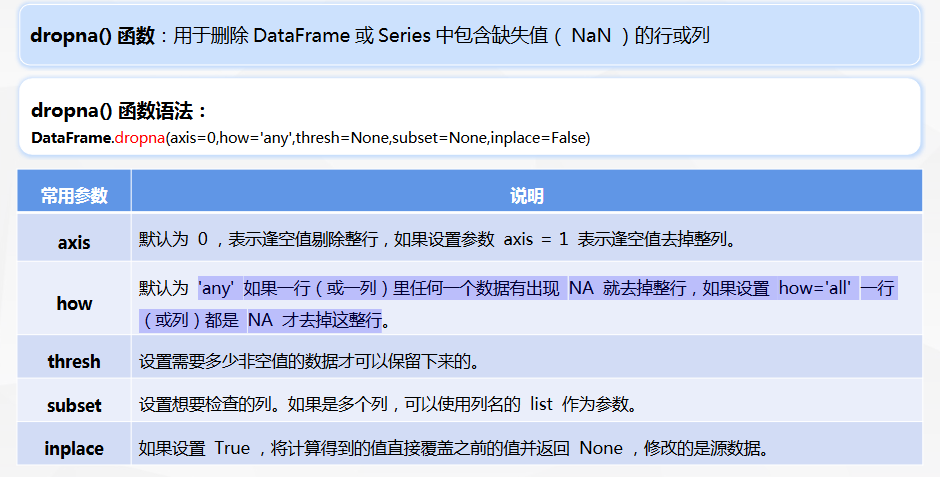
axis 默认为0,表示逢空值剔除整行,如果设置参数 axis=1 表示逢空值去掉整列
python
df.dropna(axis=1,how='all')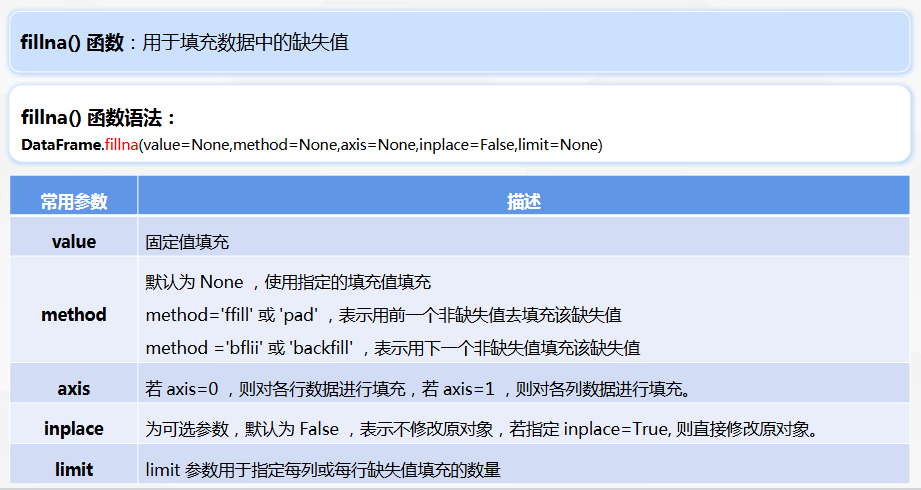
若axis=0,则对各行数据进行填充,若axis=1,则对各列数据进行填充。
python
#以0填充所有缺失值
df.fillna(0)
df.fillna(df.max())
df.fillna(df.mean())
异常
最常用的常见其他异常处理形式:
- 特殊字符删除:可以先将所有数据转换为字符串,然后使用replace()函数进行替换。
一般与高阶函数同时使用。 - 数据类型更改:先使用属性查看数据类型,再根据需求使用astype()函数更改数据类型;
①整数可以转换为浮点数②浮点数转整数时直接取整数位③字符串转数值型时字符串需全为数字
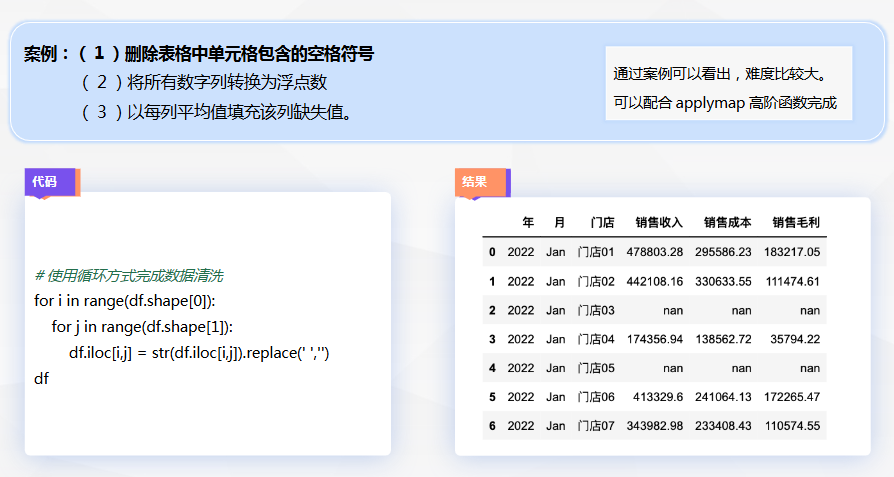
python
#使用循环方式完成数据清洗
for i in range(df.shape[0]):
    for j in range(df.shape[1]):
        df.iloc[i,j] = str(df.iloc[i,j]).replace(' ','')
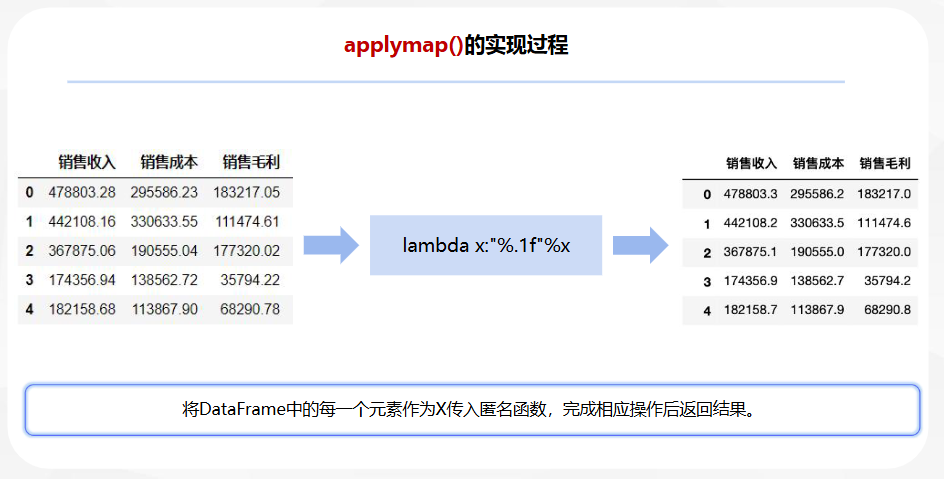
使用applymap(对DataFrame中的每个元素应用一个给定的函数):
python
#applymap函数完成数据清洗
df = df.applymap(lambda x:str(x).replace(' ',''))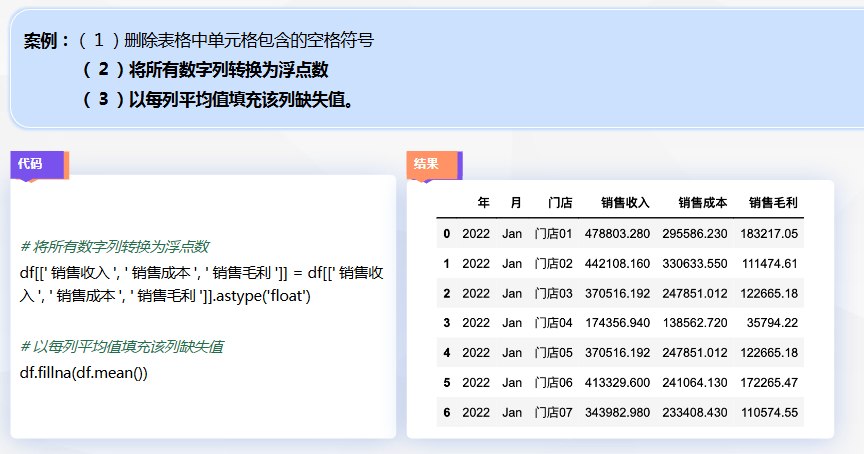
Pandas 高阶函数
- map()应用在单独一列(Series)的每个元素中
- apply()应用在Series、DataFrame的行或列中
- applymap()应用在DataFrame的每个元素中
map
python
#导入Pandas库
import pandas as pd
#读取Excel文件
data=pd.read_excel(r'https://oss.xinchanjiao.com/upload/default/20220914-1bbc5a0e-9409-4ffa-adab-06f15090e2fb.xlsx')
#显示数据前5行
data.head()

#方法1:使用for循环
for i in data['销售收入'].index:
    data.loc[i,'门店级别']='优秀门店' if data.loc[i,'销售收入']>=400000 else '非优秀门店'
data.head()
python
# 方法二:使用map
#使用Series.map()
data['门店级别']=data['销售收入'].map(lambda x:'优秀门店' if x>=400000 else '非优秀门店')
data.head()
map()函数可接收另一种参数形式:字典。用于明确且少量分类的数据对应。
案例:将数据中刚插入的'门店级别'列中'优秀门店'替换成'A类门店',其他替换为'其他门店'。
python
#将数据中刚插入的'门店级别'列中'优秀门店'替换成'A类门店',其他替换为'其他门店'
data['门店级别']=data['门店级别'].map({'优秀门店':'A类门店','非优秀门店':'其他门店'})
data
apply()
语法:
Series.apply(function,args,axis)
argscab参数:接收元组,单个元素需加逗号隔开
axis控制需要的数据操作是沿着0轴还是1轴进行:
(1)axis=0,代表操作对列column进行,
(2)axis=1,代表操作对行row进行。
案例:用apply()函数将销售收入、销售成本、销售毛利三列数据修改为以万元显示,保留四位小数,同时修改列名。
• 对列进行操作,需要指定axis=0
按列计算
案例:用apply()函数将销售收入、销售成本、销售毛利三列数据修改为以万元显示,保留四位小数,同时修改列名。
• 对列进行操作,需要指定axis=0。
python
#沿着0轴计算,销售收入、销售成本、销售毛利沿着数据列分别进
行除以10000,保留四位小数
data[['销售收入', '销售成本', '销售毛利']] = data[['销售收入', '销售成本', '销售毛利']].apply(lambda x:round(x/10000,4),axis=0)
#修改列名
data.rename(columns={'销售收入':'销售收入(万元)','销售成本':'销售成本(万元)','销售毛利':'销售毛利(万元)'},inplace=True)
data.head()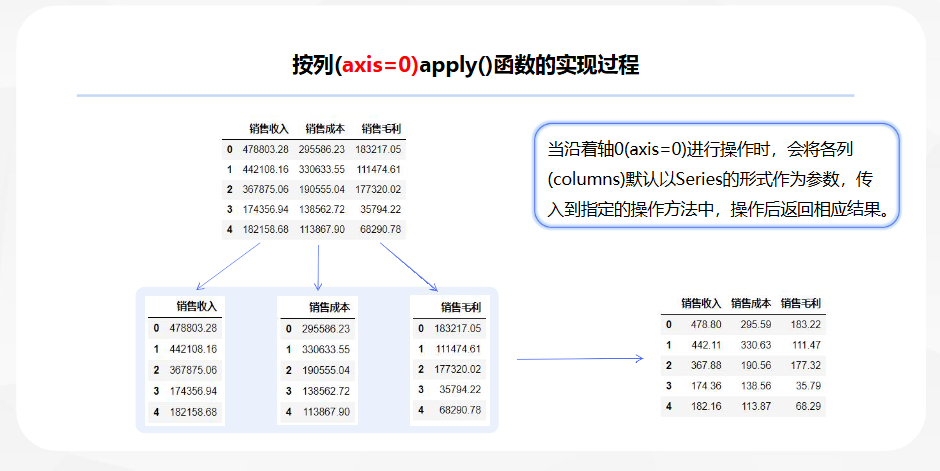
当沿着轴0(axis=0)进行操作时,会将各列(columns)默认以Series的形式作为参数,传入到指定的操作方法中,操作后返回相应结果。
按行计算
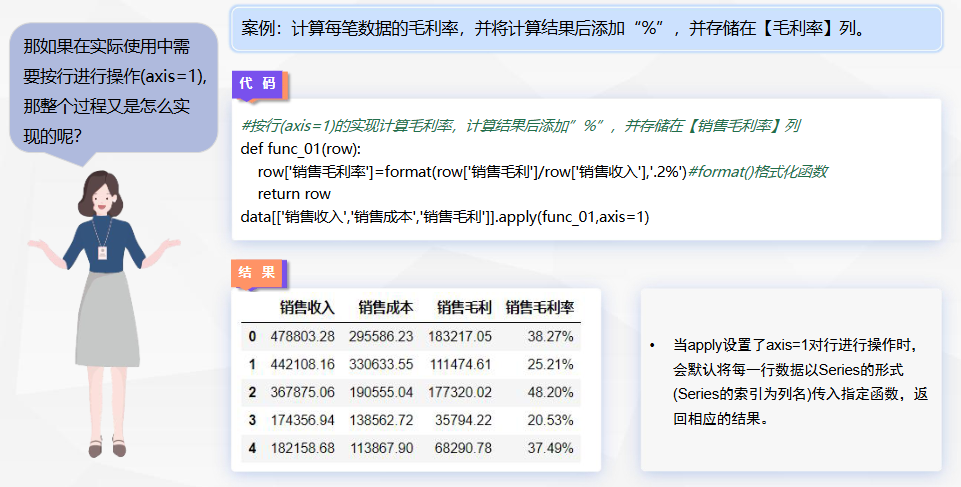
案例:计算每笔数据的毛利率,并将计算结果后添加"%",并存储在【毛利率】列。
python
#按行(axis=1)的实现计算毛利率,计算结果后添加"%",并存储在【销售毛利率】列
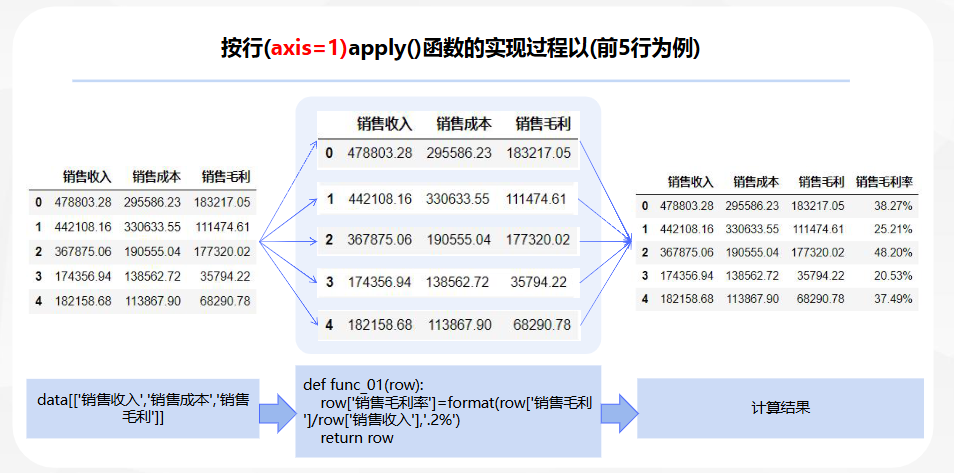
def func_01(row):
    row['销售毛利率']=format(row['销售毛利']/row['销售收入'],'.2%')#format()格式化函数
    return row
data[['销售收入','销售成本','销售毛利']].apply(func_01,axis=1)
或者这样浓缩成一行:
【这里换了一种格式化字符串的方式,不同的格式化方式详见 Python教学中的一些小细节】
python
data['销售毛利']=data[['销售收入','销售成本','销售毛利']].apply(lambda row:f"{row['销售毛利']/row['销售收入']*100:.2f}%",axis=1)当apply设置了axis=1对行进行操作时,会默认将每一行数据以Series的形式 (Series的索引为列名) 传入指定函数,返回相应的结果。
applymap()
对DataFrame中的每个元素执行指定方法的操作
python
#导入Pandas库
import pandas as pd
#读取Excel文件,利用converters参数强制设置"年"、"月"、"门店"三列转换为字符串类型。
data=pd.read_excel(r'https://oss.xinchanjiao.com/upload/default/20220914-1bbc5a0e-9409-4ffa-adab-06f15090e2fb.xlsx',sheet_name=0,converters={'年':str,'月':str,'门店':str})
#显示数据前5行
data.head()

data[['销售成本','销售毛利']]=data[['销售成本','销售毛利']].apply(lambda x:round(x,1))
data
数据分组与聚合
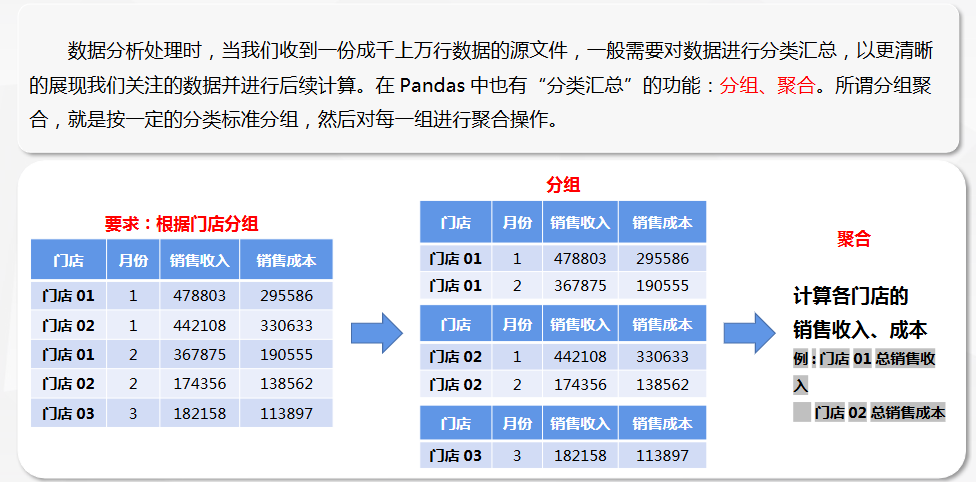
分组gruopby
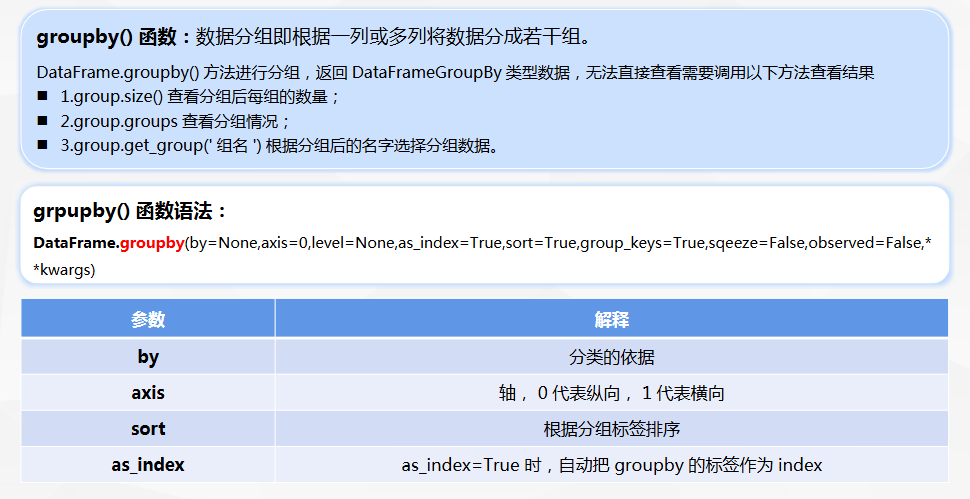
(1)使用map函数将月对应为01-12月;
(2)按照月分组,分析销售整体数据。
python
#创建一个英文月份和数字月份对照的字典,将英文月份转换为数字字符串
monthdict={'Jan':'01','Feb':'02','Mar':'03','Apr':'04','May':'05','Jun':'06',
                 'Jul':'07','Aug':'08','Sep':'09','Oct':'10','Nov':'11','Dec':'12',}
df['月'] = df['月'].map(monthdict)
#根据月列进行分组,求各月总和
df.groupby('月').sum()
聚合agg
agg()函数:支持根据分组按多种方式进行聚合,可以针对一列或多列选择相同或不同的聚合方式。
-
基本用法
单列单函数:df'col'.agg('sum')
单列多函数:df'col'.agg('sum', 'mean')
多列同函数:df.agg('sum')
多列多函数:df.agg('sum', 'mean')
-
不同列使用不同聚合函数
df.agg({'score': 'mean', 'max', 'height': 'min'})
可为每列指定不同数量和类型的聚合操作。
-
配合 groupby 使用
df.groupby('cls').agg({'score': np.min, np.max, 'height': np.mean})
支持分组后对不同列执行不同聚合,返回多级列索引结果。
案例:将数据根据年、月列聚合后,计算销售收入列的总和,销售成本列的平均值
python
#将根据年、月列聚合,计算销售收入总和,销售成本平均值
df.groupby(['年','月']).agg({'销售收入':'sum','销售成本':'mean'})
注意事项:
- groupby分组后,后直接调用sum()函数,会对所有数值列进行求和计算;
- groupby分组后,使用聚合函数agg(),可以指定某一列或多列,选择特定的聚合方式,实现相同或不同的聚合计算。
透视表与轴向转换
数据透视表-pivot_table()函数
pivot_table()函数:类似于Excel里的数据透视表功能,只要指定行、列、值和值的计算类型(计数、合计、平均等),就可以做出一个数据透视表来。
pivot_table()函数语法:
pandas.pivot_table(dataframe,index=None,columns=None,values=None,aggfunc='mean',fill_value=None,margins=False,dropna=True,margins_name='All',observed=False)
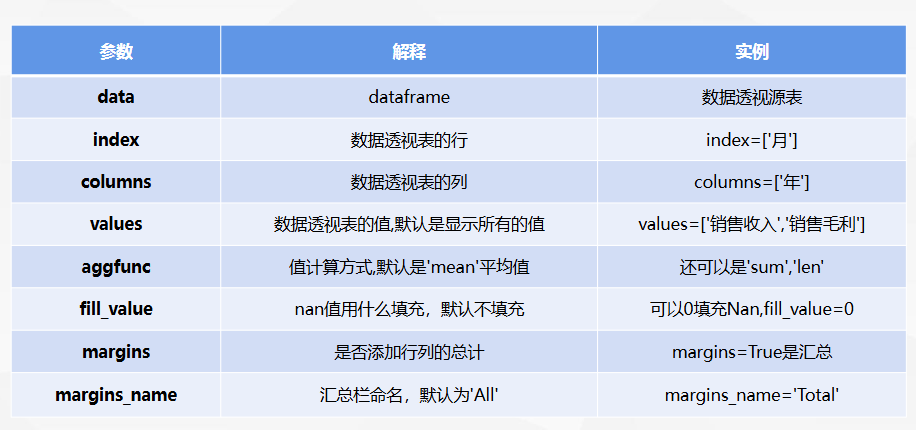
案例:用Pandas做数据透视表,行为'月',列为'年',统计指标为销售收入的合计和销售毛利的平均数。
python
#行为'月',列为'年',统计指标为销售收入的合计和销售毛利的平均
数,在透视表中加上汇总栏
df1=pd.pivot_table(data,
                   index=['月'],
                   columns=['年'],
                   values=['销售收入','销售毛利'],
                   aggfunc={'销售收入':'sum','销售毛利':'mean'},
                   fill_value=0,
                   margins=True,
                   margins_name='汇总')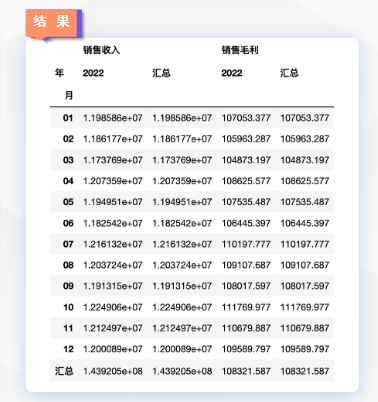
轴向转换-stack、unstack
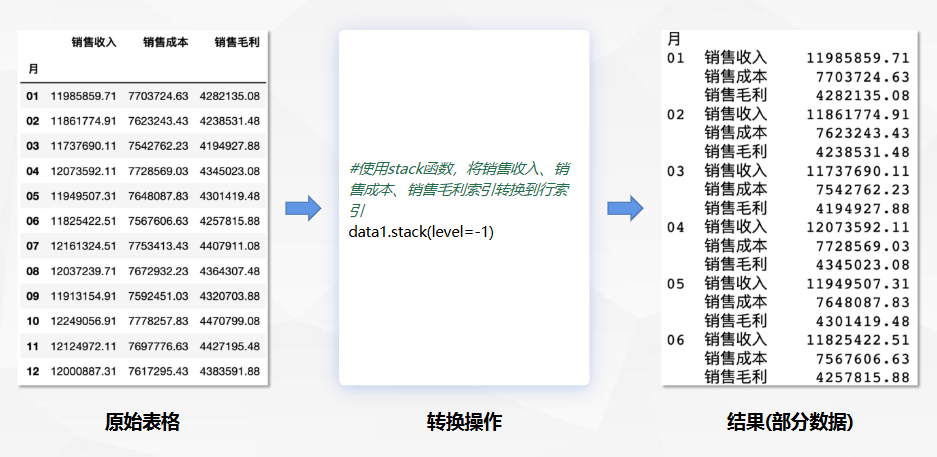
轴向转换:数据行列索引相互转换(类似于Excel中的行列转置),包括stack()函数和unstack()函数,灵活运用轴向转换功能可轻松实现数据重塑。
• stack()是将Dataframe的columns索引转换到index的索引;
• unstack()是将Dataframe的index索引转换到columns的索引;
换到最内侧了
python
#根据月列进行分组,求各月总和
data1 = data.groupby('月').sum()
data1
#使用stack函数,将销售收入、销售成本、销售毛利索引转换到行索引
data1.stack(level=-1)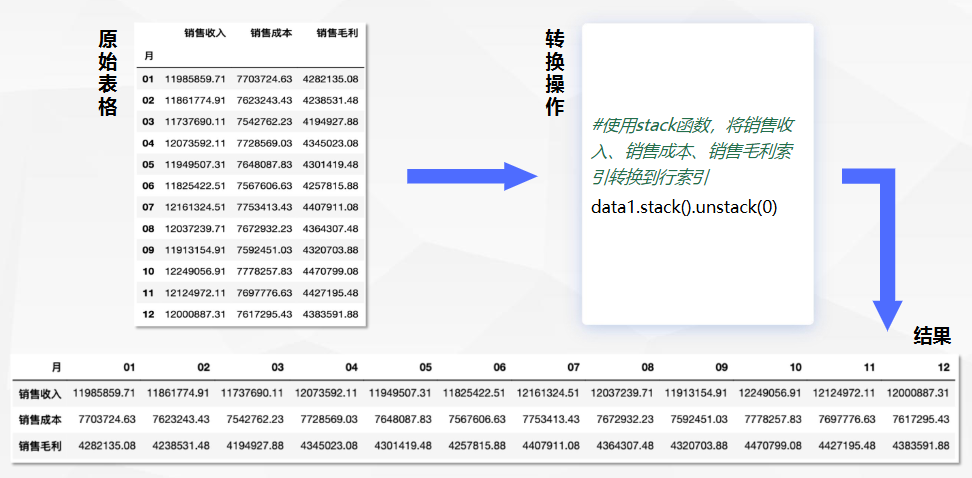
默认 level=-1 销售收入、成本、毛利等先换到最内侧,
然后 level=0 将最外侧行索引换到列索引