「 腾讯云 TDSQL(MySQL 版)是在 MySQL 上做了分布式改造,很多同学拿单机 MySQL 的经验直接套,结果路由、读写分离、分片各种踩坑。这篇把最容易被坑的 6 个场景拆开讲,命令都能直接复制,建议先收一份。 」
一、代理管理命令的 /*proxy*/ 只用于 3 条
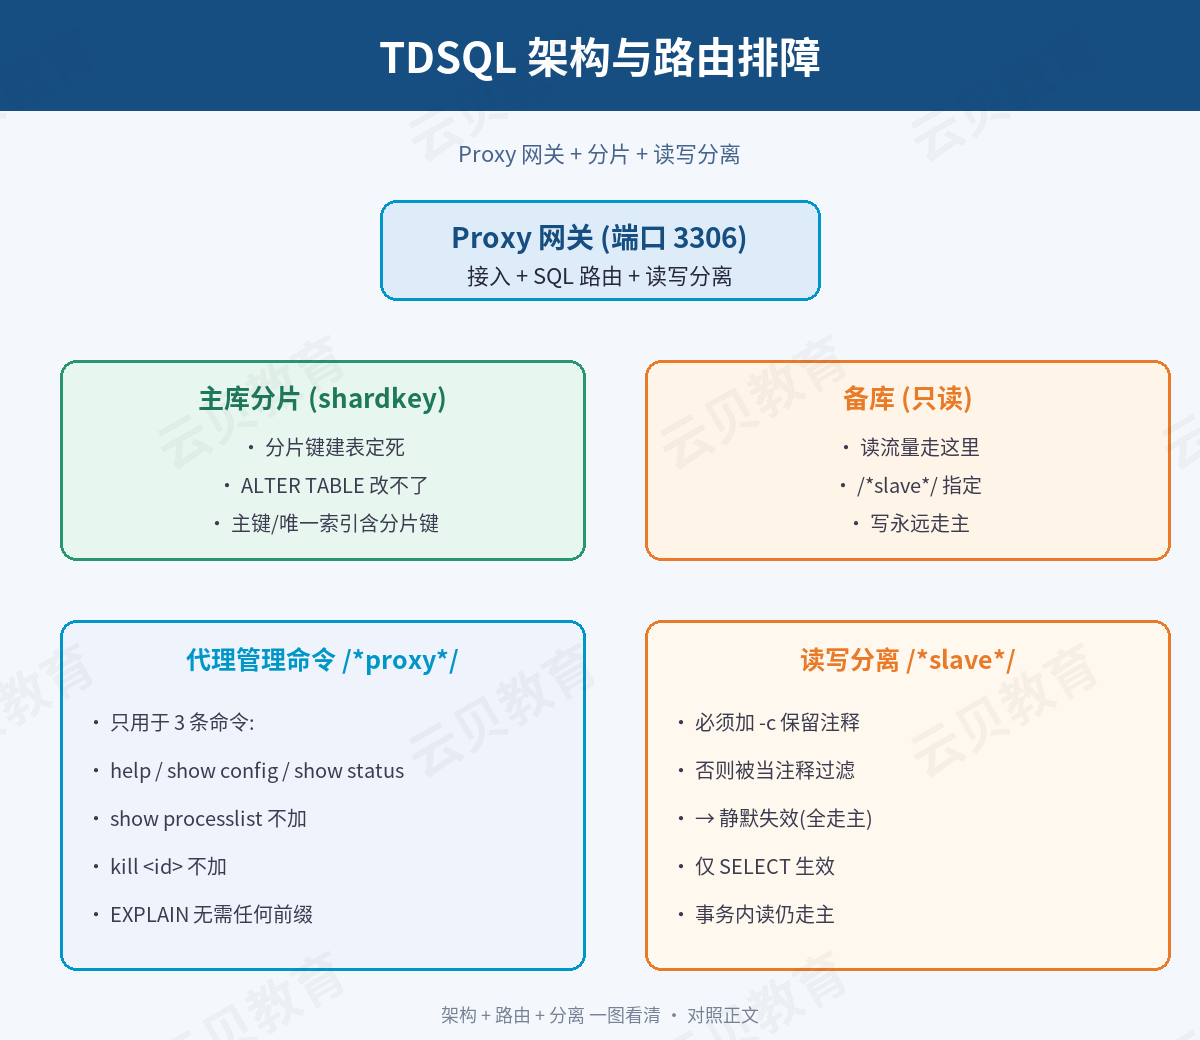
▲ 架构图:Proxy 网关 + 分片 + 读写分离(对照正文)
TDSQL 走 Proxy 网关,有些管理命令要加 /*proxy*/ 前缀才转给 proxy 执行,但不是所有命令都加。
|------------|------------------------|
| 场景 | 命令 |
| 看 proxy 帮助 | /*proxy*/help |
| 看 proxy 配置 | /*proxy*/show config |
| 看 proxy 状态 | /*proxy*/show status |
坑点 :/*proxy*/ 只用于 `help` / `show config` / `show status` 这 3 条 。像 show processlist、kill <id>、EXPLAIN 都不加 前缀------EXPLAIN 无需任何前缀,直接写就好。有人给 EXPLAIN 也加 /*proxy*/,纯属多余还容易误导。
二、读写分离 hint 必须加 -c,否则静默失效
开了读写分离后,想让某条读走备库,要用 /*slave*/ hint。但客户端默认会剥离注释:
|------------|-----------------------------------------------|
| 场景 | 命令 |
| 保留 hint 登录 | mysql -c -h proxy_ip -P 3306 -u user -p |
| 读走备库 | SELECT /*slave*/ * FROM orders WHERE id=1; |
坑点 :/*slave*/ 必须加 -c 让客户端保留注释 ,否则被当注释过滤,读写分离静默失效 ------你以为读走备库了,其实全走主库,还查不出毛病。另外 /*slave*/ 只对 SELECT 生效,写永远走主,别指望拿它把写分流。
「 这块路由规则也是 TDSQL 分布式运维里常考的点,搞清楚 -c 和 hint 的关系能少踩很多坑。 」
三、分片键 shardkey 建表定死,ALTER TABLE 改不了
TDSQL 是分库分表,分片键是建表时定的:
|---------|-------------------------------------------|
| 场景 | 命令/规则 |
| 建表指定分片键 | CREATE TABLE t (id int, ...) shardkey=id; |
| 主键/唯一索引 | 必须包含分片键(广播表除外) |
| 改分片键 | ALTER TABLE ... 不支持,只能重建 |
坑点 :shardkey 不支持用 `ALTER TABLE` 改 ,想换分片键只能重新建表导数据。而且主键和唯一索引必须包含分片键(广播表除外),否则建不了或路由异常。建表前一定把分片键选对。
四、自动读写分离:事务内读走主,不是 hint 失效
开了自动读写分离(rw_split=2)后,有个容易误判的点:
|---------------|-----------------|
| 现象 | 真相 |
| 事务里查的数据走了主库 | 预期行为,不是 hint 失效 |
| 非事务的普通 SELECT | 按读写分离策略走备库 |
坑点 :自动读写分离(rw_split=2)下,事务内的读默认走主库 ,这是设计如此,不是你 /*slave*/ 失效。别一看到事务内读走主就以为分离坏了,先确认是不是在事务里。
五、监控盯 Threads_running,别只看连接数
看实例压力,连接数会骗人:
|-------------------|----------------|
| 指标 | 含义 |
| Threads_connected | 当前连接总数(含空闲) |
| Threads_running | 正在执行的并发数(真实压力) |
坑点 :Threads_connected 高不代表有压力------大量空闲连接也会计数。真正反映数据库忙不忙的是 Threads_running,监控和告警盯这个才准。
六、PITR 不直接改原实例,要克隆新实例导回
误删数据要回滚到某时间点,TDSQL 的 PITR 和单机 MySQL 不一样:
|-------------|-----------------|
| 场景 | 做法 |
| 时间点恢复(PITR) | 克隆一个新实例恢复到指定时间点 |
| 取回数据 | 从克隆实例抽数,导回原实例 |
坑点 :TDSQL 的 PITR 不直接修改原实例,而是克隆一个新实例恢复到目标时间点,再从克隆实例把数据抽出来导回原库。别想着像单机 MySQL 那样原地闪回,那是两码事。
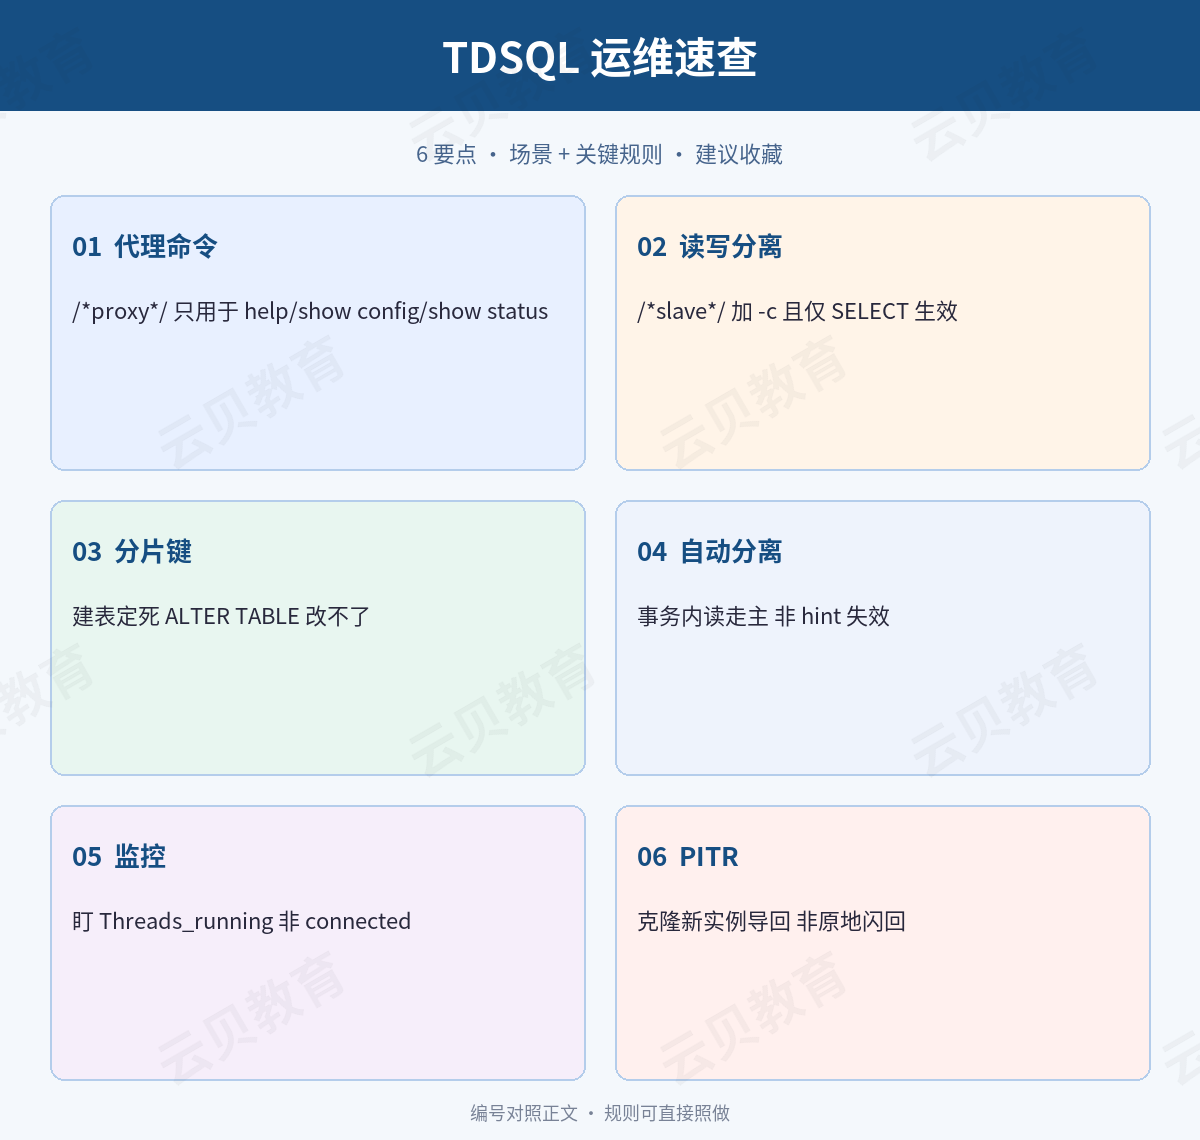
▲ 一图速查:核心规则汇总(建议收藏)
小结
TDSQL(MySQL 版)运维记住几条:**代理管理命令 /*proxy*/ 只用于 help/show config/show status**;** 读写分离 /*slave*/ 必须加 -c 且只对 SELECT 生效**;** 分片键建表定死、ALTER TABLE 改不了**;** 事务内读走主不是 hint 失效**;** 监控盯 Threads_running**;**PITR 克隆新实例导回**。命令都在上表,出问题照着敲基本能救。
想系统把分布式 MySQL(TDSQL)吃透,官方文档配合认证体系走一遍,体系会比零散搜博客稳很多。先收藏,省得真出事现找。