文章目录
-
-
- 前言
- [1. 别再死囤旧Skill了,真的会负优化](#1. 别再死囤旧Skill了,真的会负优化)
-
- [1.1 描述写太长,模型根本看不全](#1.1 描述写太长,模型根本看不全)
- [1.2 指令太细碎,反而绑住新模型的手脚](#1.2 指令太细碎,反而绑住新模型的手脚)
- [2. AGENTS.md也得回炉重造](#2. AGENTS.md也得回炉重造)
-
- [2.1 别每次都让模型读完整套文档](#2.1 别每次都让模型读完整套文档)
- [2.2 多余的检查指令,纯纯浪费算力](#2.2 多余的检查指令,纯纯浪费算力)
- [3. 决策边界和停止条件,得重新校准](#3. 决策边界和停止条件,得重新校准)
-
- [3.1 别用老规矩限制新模型的判断力](#3.1 别用老规矩限制新模型的判断力)
- [3.2 想让它干活干到底,就得把话说清楚](#3.2 想让它干活干到底,就得把话说清楚)
- [4. 最后说句实在的](#4. 最后说句实在的)
-
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看, 传送门https://blog.csdn.net/H1727548
前言
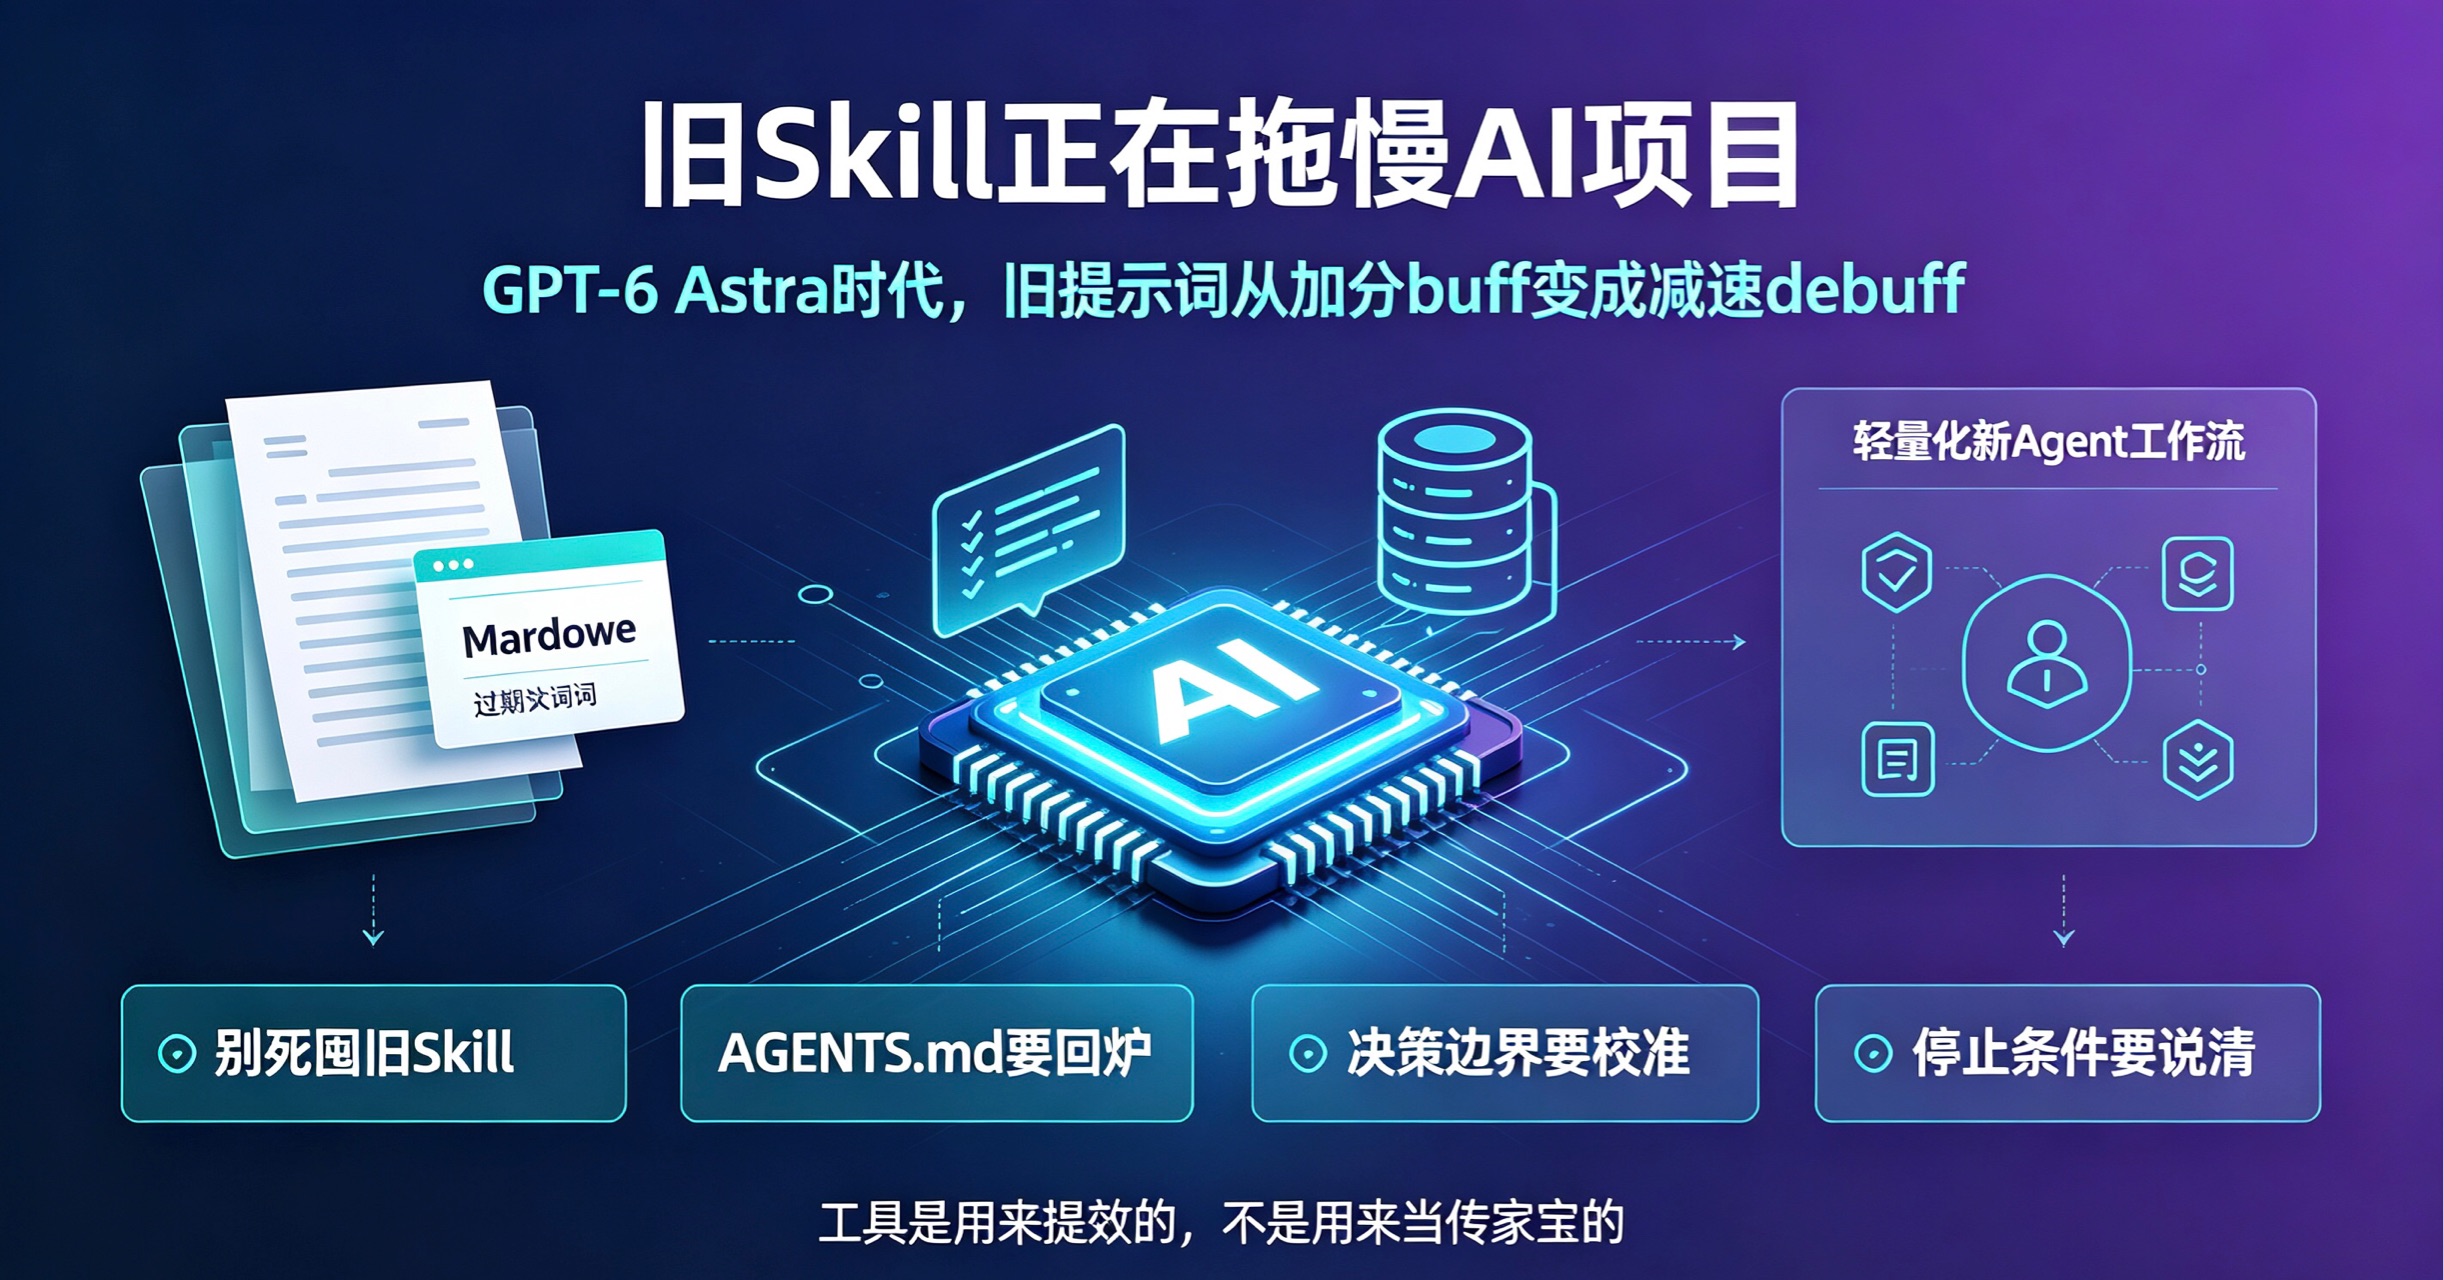
最近圈内传了个挺扎心的消息,OpenAI那边的研发人员直接发话:GPT-6 Astra都进化到这份上了,你项目里那些陈年老Skill、老掉牙的提示词,早就从"加分buff"变成"减速debuff"了。
我看完当场翻了翻自己的项目文件夹,好家伙,光Skill文件就攒了二十多个,瞬间感觉自己像个囤了一柜子旧衣服的人,件件舍不得扔,件件都不穿。
1. 别再死囤旧Skill了,真的会负优化
先说说大家最熟的Skill文件。这东西本质就是个写在Markdown里的操作指南,本来是给特定任务搭脚手架的。
结果很多人跟集邮似的,看到个Skill就往项目里塞,最后塞出一堆问题。
1.1 描述写太长,模型根本看不全
每个Skill的名称和描述,都是要占模型上下文的。你塞得多了,系统为了装下所有内容,直接自动给你删减描述。
到最后模型只能看到半句话,跟做阅读理解似的,还能选对工具才怪了。
更别说有些Skill的描述写得跟招聘JD似的,啥都想沾边,互相打架,最后模型选了个完全不搭边的,纯纯添乱。
给你们看正反例子,差别到底在哪:
# 不佳示例
创建并验证 Postgres 模式迁移。在处理数据库、查询、模型或持久化时使用。

# 良好示例
创建并验证 Postgres 模式迁移。在添加或修改迁移文件,或审查其部署上线时使用。
前者跟"啥都管"的居委会大妈似的,碰着数据库就跳出来;后者精准卡场景,该出手时才出手。
1.2 指令太细碎,反而绑住新模型的手脚
以前的模型笨,你得一步一步写清楚,跟教小孩走路似的。
现在GPT-6 Astra什么水平?相当于已经考上名牌大学了,你还拿着小学的行为守则管它,这也不许那也不许,最后它只能束手束脚,发挥不出来。
还有个点很容易被忽略:你仓库里的Skill,可能是给旧模型写的。对老模型有用的技巧,放到新模型上,可能就是多余的约束。
就像你给赛车手发了本非机动车驾驶守则,不添堵就不错了。
2. AGENTS.md也得回炉重造
说完Skill,再说说AGENTS.md。这东西模型在仓库里干活的时候全程挂着,影响比Skill还大。
2.1 别每次都让模型读完整套文档
以前总怕模型漏看内容,动不动就要求"每次修改前,把架构文档、数据库文档、部署文档全读一遍"。
现在想想,这不就跟你每次改一行代码,都让你先把整个项目的需求文档重看一遍一样,纯纯磨洋工。
GPT-6 Astra自己知道该看什么,你只要给它标清楚边界就行。
# 不佳示例
每次编辑前,都读取 architecture.md、database.md 和 deployment.md。

# 良好示例
涉及服务边界时查阅 architecture.md,涉及模式变更时查阅 database.md,准备部署时查阅 deployment.md。
精准指路,比强制全包效率高得多。
2.2 多余的检查指令,纯纯浪费算力
以前的模型,你不催它就不跑测试,不查bug。所以大家都习惯在指令里反复强调:写完要测试!测完要检查!
现在GPT-6 Astra自己就会主动干这些事。你再重复一遍,它就会再跑一遍,纯纯做无用功,费时间还费钱。
当然了,也不是说全放开。有些该明确授权的,还是得写清楚。比如本地测试可以随便跑,不用事事请示,给它放权才能高效干活。
3. 决策边界和停止条件,得重新校准
除了工具和文档,还有两个很容易踩坑的点,也得跟着更新。
3.1 别用老规矩限制新模型的判断力
以前老模型容易"闯祸",动不动就私自执行操作,所以大家都写得很凶:凡事必须先请示!
现在GPT-6 Astra的判断能力已经上来了,你还把权限卡得死紧,它就会在明明可以继续的地方停下来等你,反而拖慢进度。
说白了,规矩得配得上能力。孩子小的时候你得盯着,长大了就该适当放权。
3.2 想让它干活干到底,就得把话说清楚
用过老版本的人都知道,以前的模型接了活能吭哧吭哧干半天。
现在GPT-6 Astra反而"谨慎"了,做完第一版就交上来等你审核,哪怕后面还有一堆活,它也不往下走了。
别骂它偷懒,是你没说清楚终点在哪。你想要它跑完、测完、改完,就明明白白写进要求里。
你只说"做个功能",它当然做完基础版就交差;你说"做完跑通测试,修复bug,直到能正常运行",它才会一直干到底。
4. 最后说句实在的
新模型发布,其实也是个大扫除的好机会。
别舍不得那些旧文件、旧指令,该删删该改改。甚至可以直接让GPT-6 Astra照着这个思路,给你的项目做一次全面体检。
毕竟,工具是用来提效的,不是用来当传家宝的。
P.S. 无意间发现了一个巨牛的人工智能教程,非常通俗易懂,对AI感兴趣的朋友强烈推荐去看看,传送门https://blog.csdn.net/H1727548(https://blog.csdn.net/H1727548/article/details/1635442