一、前言
在深度学习模型搭建与调试过程中,张量维度的匹配是确保模型正确运行的基础。维度不匹配(Shape Mismatch)是开发者最常遇到的错误之一。本文档旨在提供一份全面、准确且结构清晰的维度对照参考表,帮助开发者在构建网络时快速查阅各层的输入输出维度关系、权重形状及尺寸计算公式,从而有效避免维度报错,提升模型开发效率。
二、全连接层(Linear / Dense)
全连接层是神经网络中最基础的层,主要用于特征空间的线性变换。
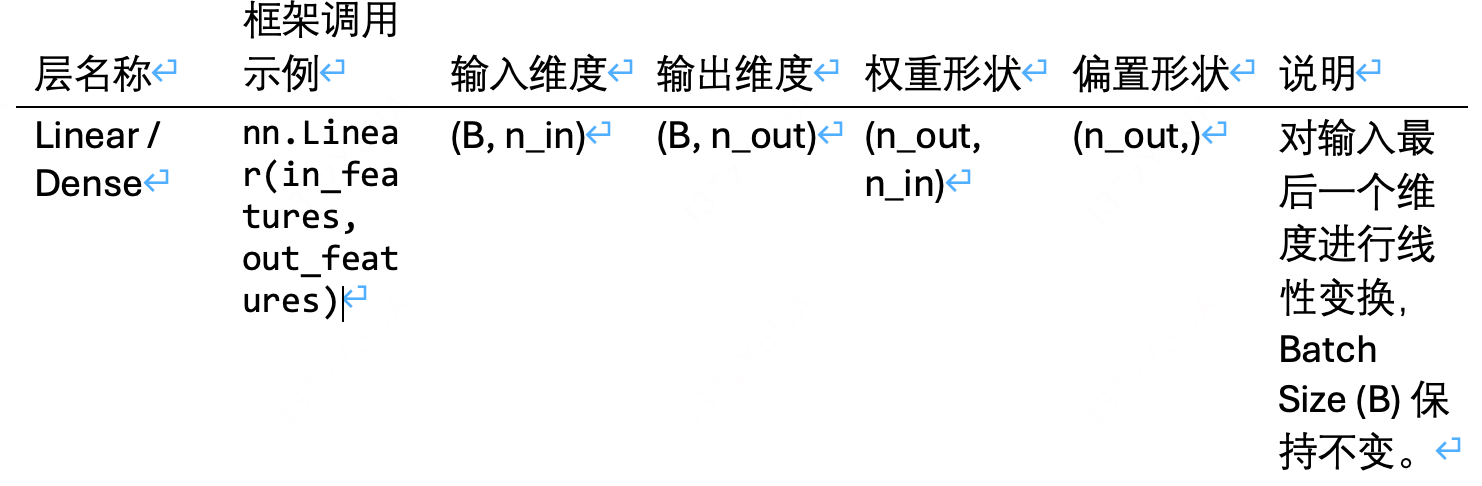
具体示例: - 代码:nn.Linear(784, 128) - 输入:(B, 784) - 输出:(B, 128) - 权重形状:(128, 784)
三、卷积层(Conv)
卷积层通过滑动窗口提取局部特征,广泛应用于计算机视觉任务
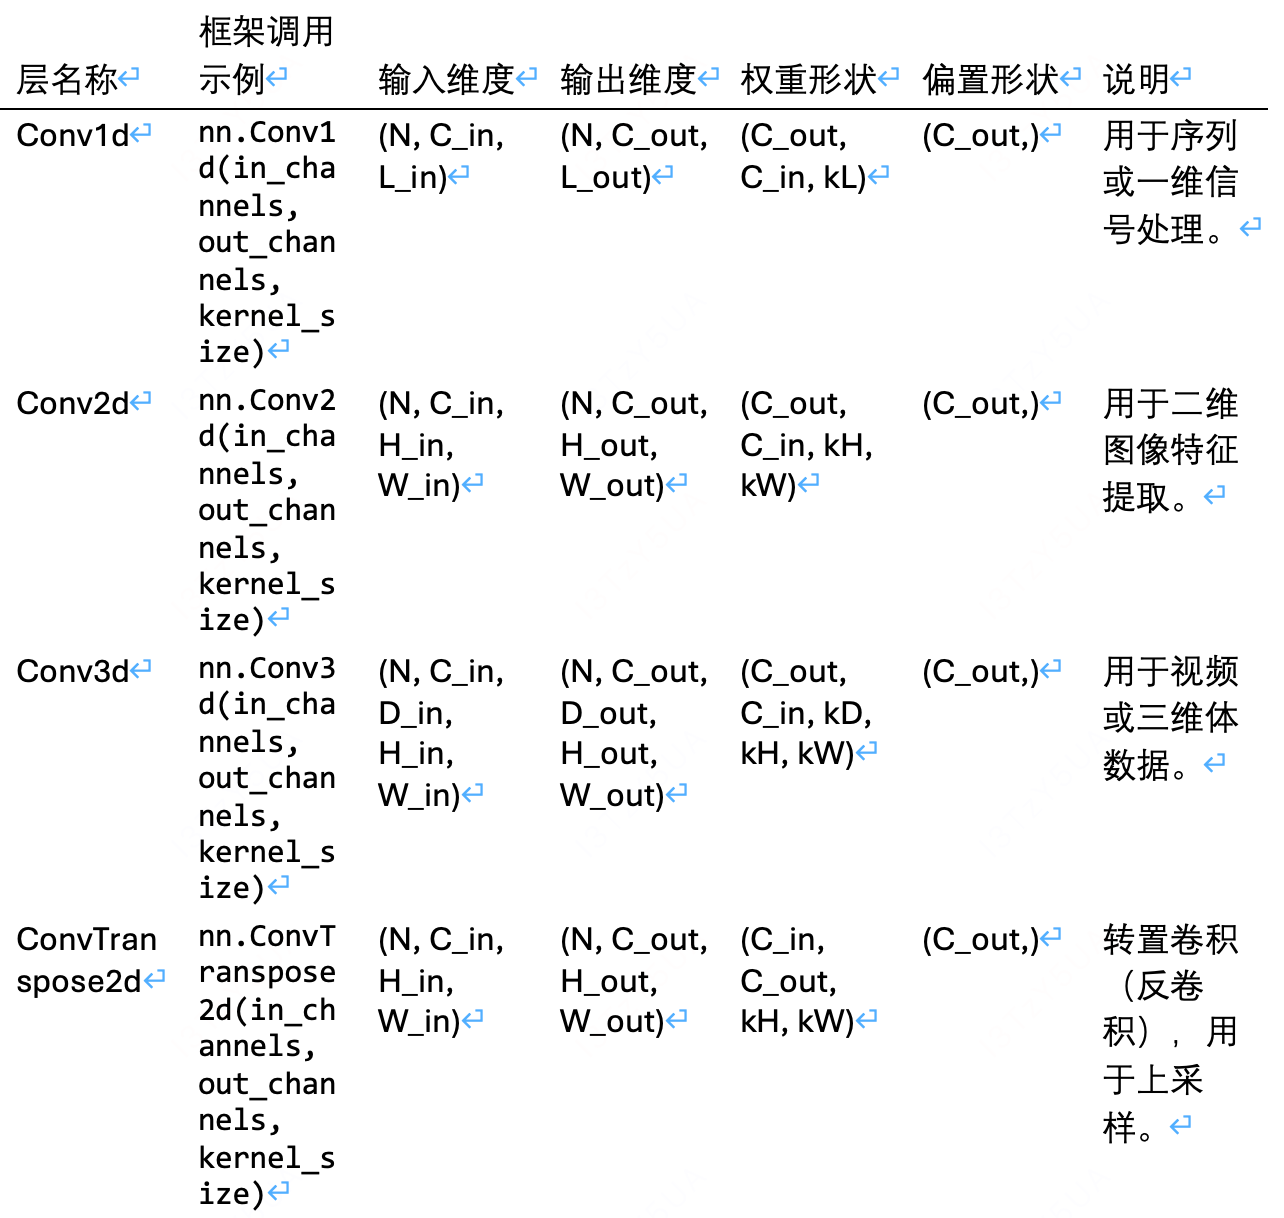
Conv2d 维度详解与计算公式:
- 输入:(N, C_in, H_in, W_in)
- 输出:(N, C_out, H_out, W_out)
- 权重:(C_out, C_in, kH, kW)
- 输出尺寸计算公式: H_out = ⌊(H_in + 2 × padding0 - dilation0 × (kH - 1) - 1) / stride0 + 1⌋ W_out = ⌊(W_in + 2 × padding1 - dilation1 × (kW - 1) - 1) / stride1 + 1⌋
Conv2d 具体示例: - 代码:nn.Conv2d(3, 16, kernel_size=3, padding=1)
- 输入:(B, 3, 32, 32)
- 输出:(B, 16, 32, 32)
ConvTranspose2d
输出尺寸计算公式: - H_out = (H_in - 1) × stride0 - 2 × padding0 + dilation0 × (kH - 1) + output_padding0 + 1 - W_out = (W_in - 1) × stride1 - 2 × padding1 + dilation1 × (kW - 1) + output_padding1 + 1
四、归一化层(Normalization)
归一化层用于加速模型收敛并提升稳定性,不同归一化方式作用的维度不同。
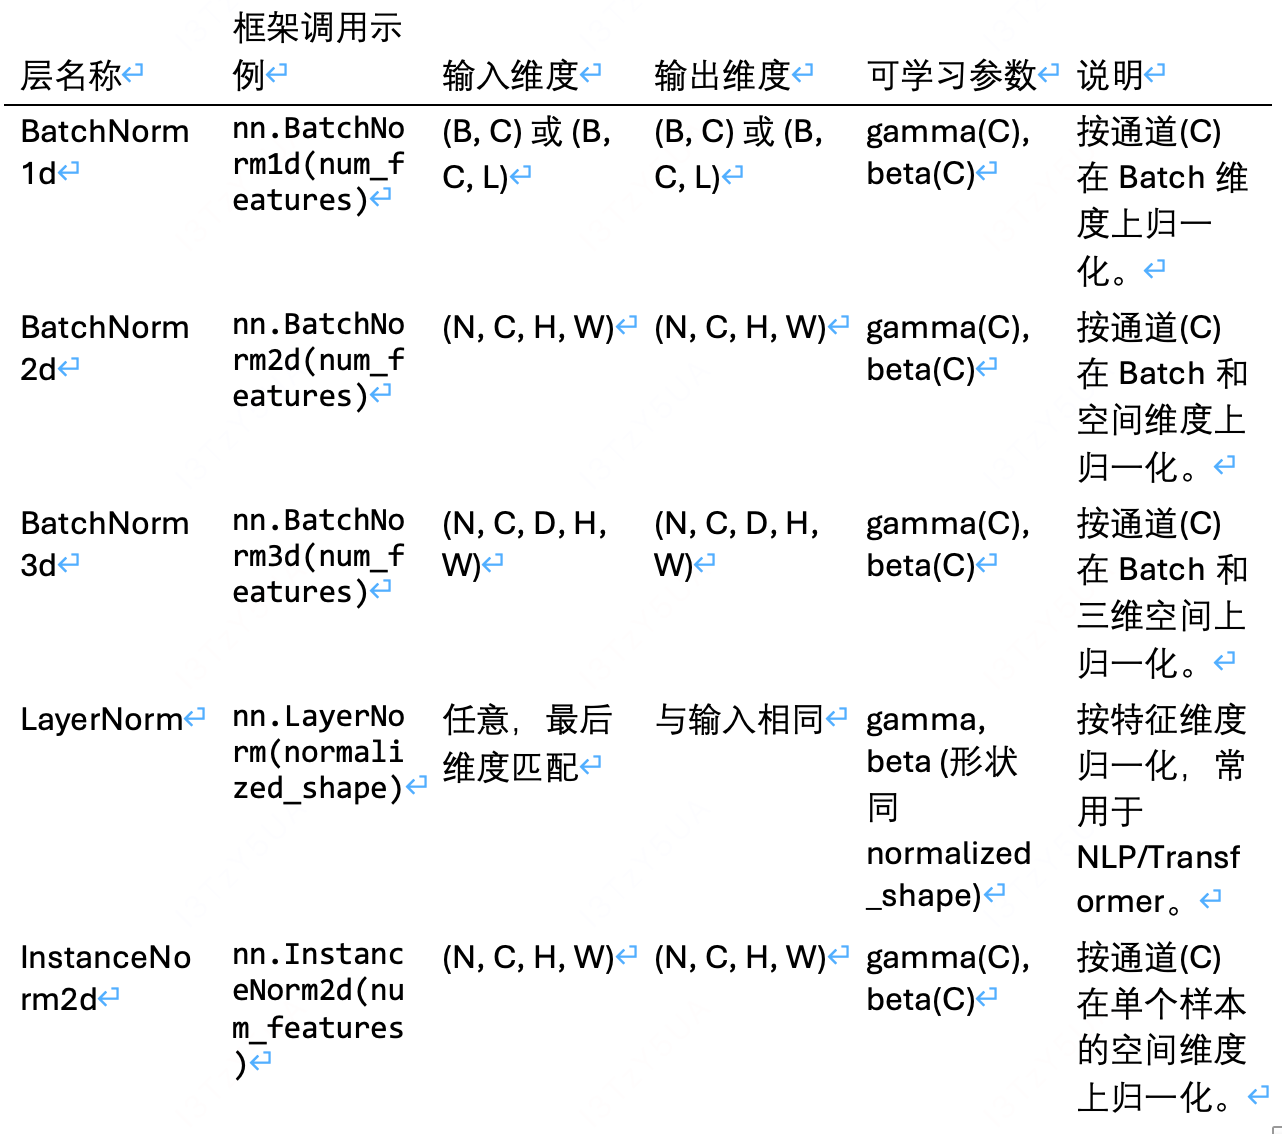
LayerNorm 具体示例:
- 代码:nn.LayerNorm(normalized_shape=(128,), elementwise_affine=True)
- 输入:(B, 128)
- 输出:(B, 128)
- 可学习参数:gamma=(128,), beta=(128,)
五、池化层(Pooling)
池化层用于降低特征图的空间尺寸,减少计算量并提取显著特征。
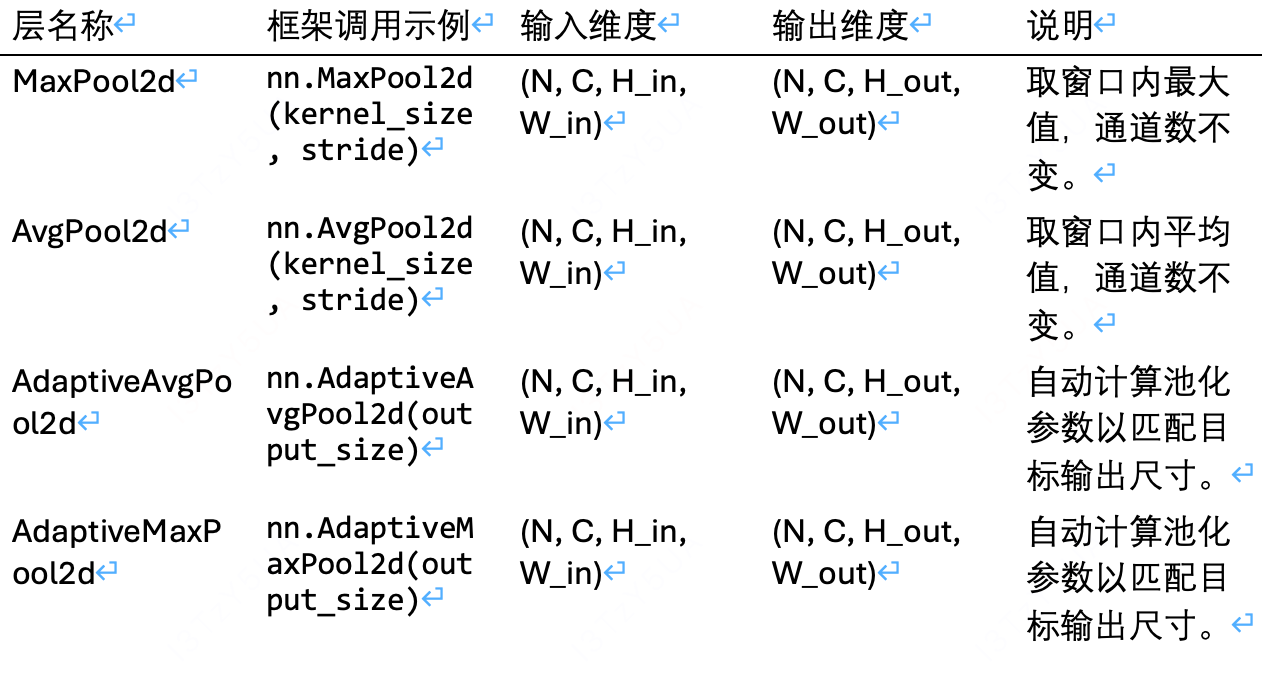
MaxPool2d / AvgPool2d 输出尺寸计算公式:
- H_out = ⌊(H_in + 2 × padding - dilation × (kernel_size - 1) - 1) / stride + 1⌋ - W_out = ⌊(W_in + 2 × padding - dilation × (kernel_size - 1) - 1) / stride + 1⌋
AdaptiveAvgPool2d 具体示例: - 代码:nn.AdaptiveAvgPool2d((4, 4))
- 输入:(B, C, 任意尺寸, 任意尺寸)
- 输出:(B, C, 4, 4)
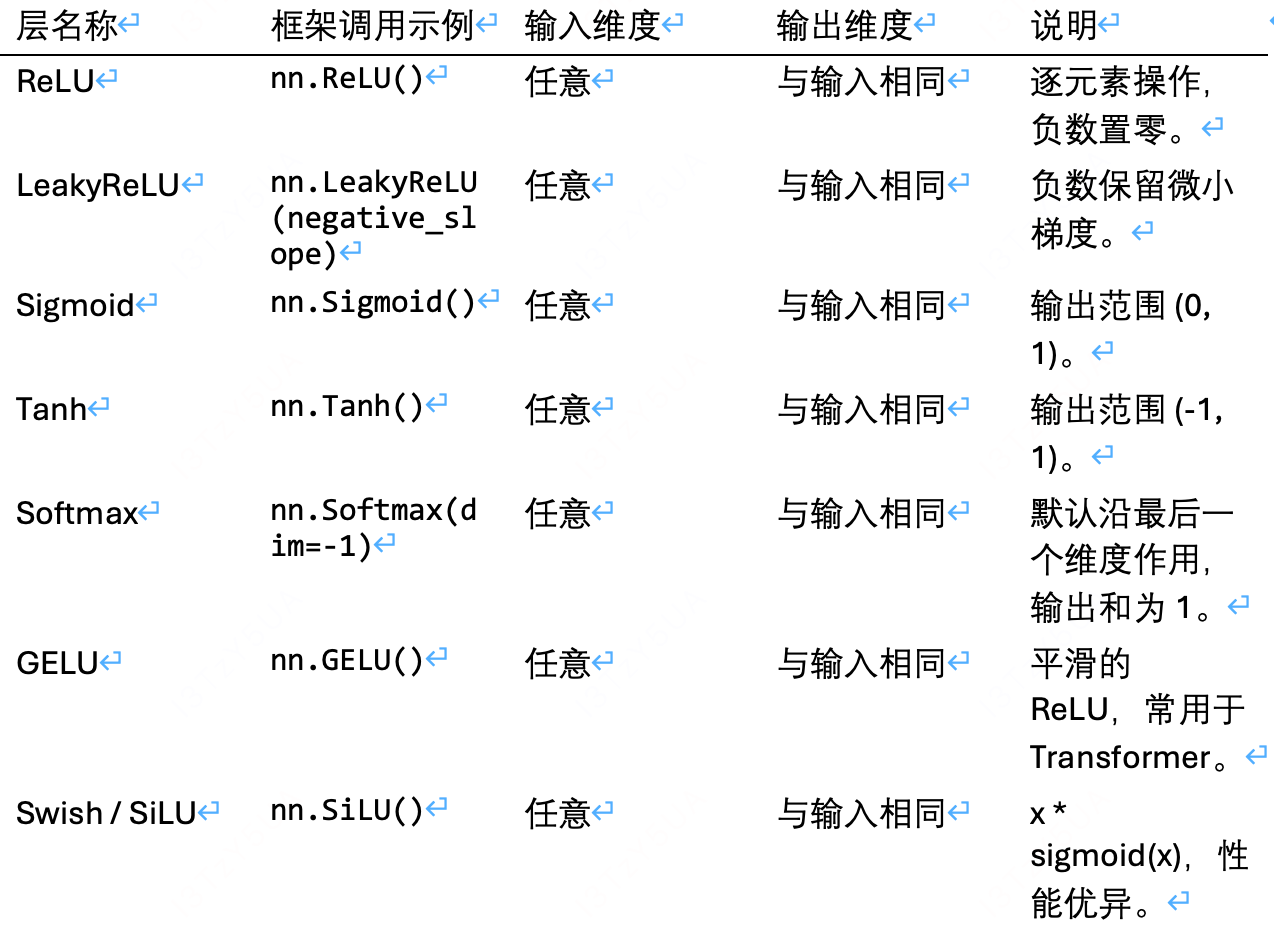
六、激活函数层(Activation)
激活函数为网络引入非线性,所有激活函数均不改变输入张量的维度。
七、嵌入层(Embedding)
嵌入层将离散的索引映射为连续的稠密向量,是NLP模型的起点。
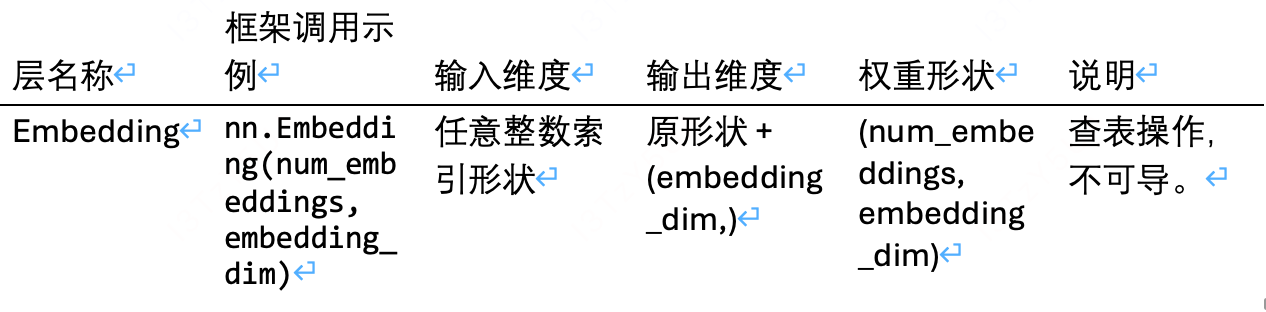
具体示例:
- 代码:nn.Embedding(num_embeddings=10000, embedding_dim=300)
- 输入:(B, seq_len) 的整数索引
- 输出:(B, seq_len, 300)
- 权重形状:(10000, 300)
八、展平与变形层(Flatten / Reshape / Permute)
用于调整张量的形状以适应不同层的需求,不改变数据总量。
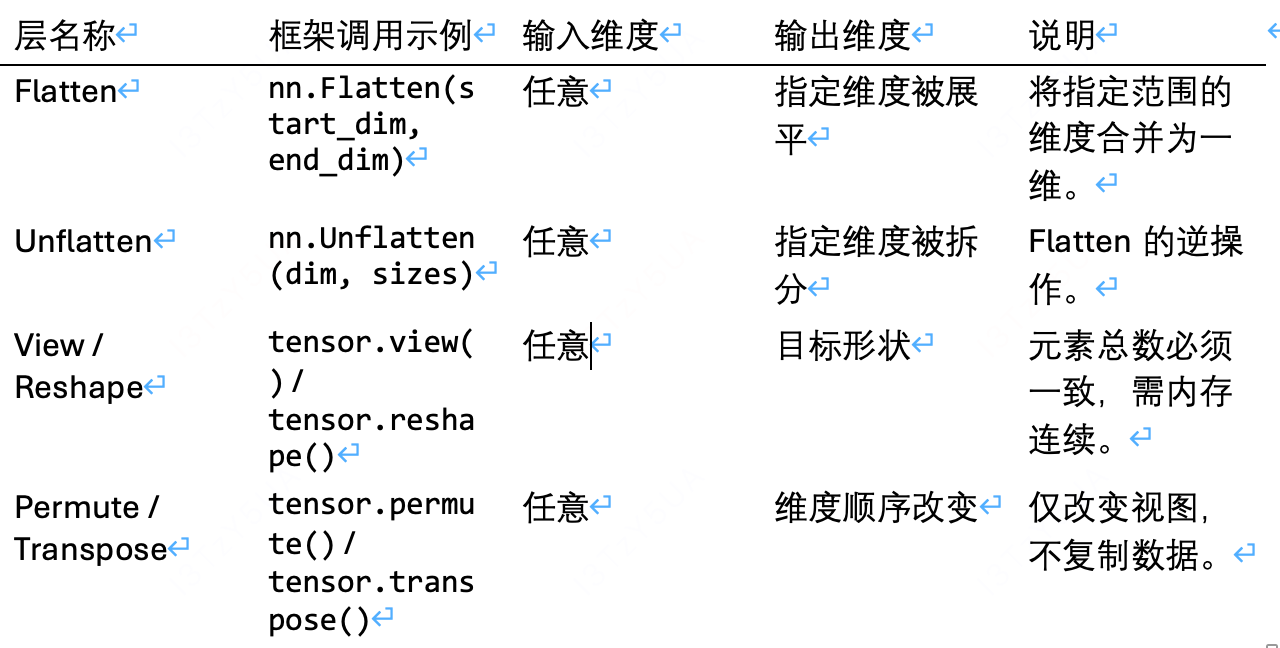
具体示例:
- 代码:nn.Flatten(start_dim=1)
- 输入:(B, C, H, W)
- 输出:(B, C × H × W)
九、循环层(RNN)
循环层用于处理序列数据,具有记忆能力。
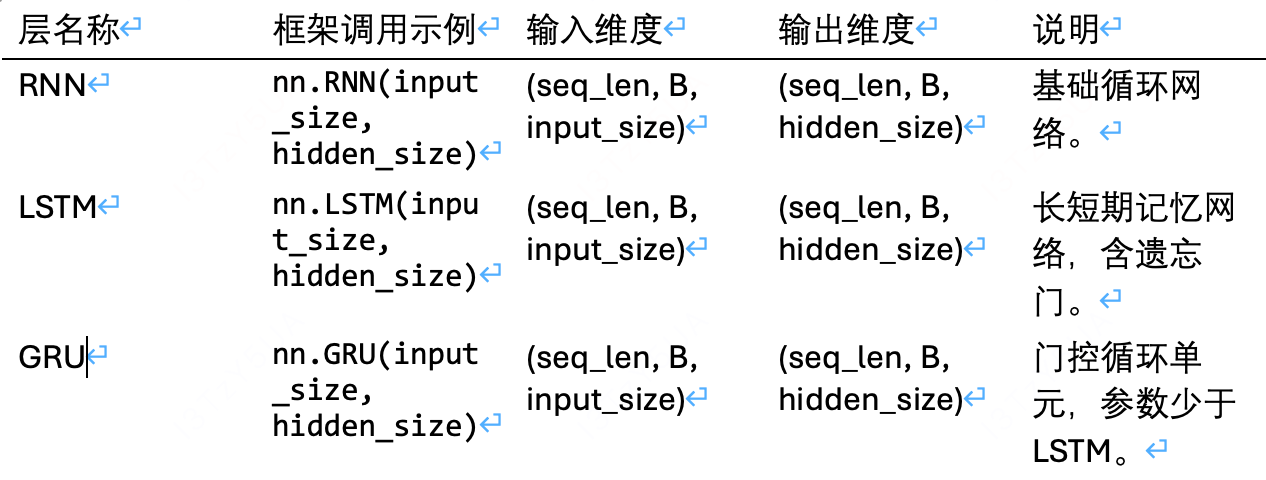
LSTM 维度与状态详解:
- 输入:(seq_len, B, input_size)
- 输出:(seq_len, B, hidden_size)
- 隐藏状态 (hn):(num_layers × num_directions, B, hidden_size)
- 细胞状态 (cn):(num_layers × num_directions, B, hidden_size)
- 权重形状:4 × hidden_size × (hidden_size + input_size)(LSTM包含4个门:输入、遗忘、细胞、输出)
十、注意力层(Attention)
注意力机制允许模型动态关注输入序列的不同部分
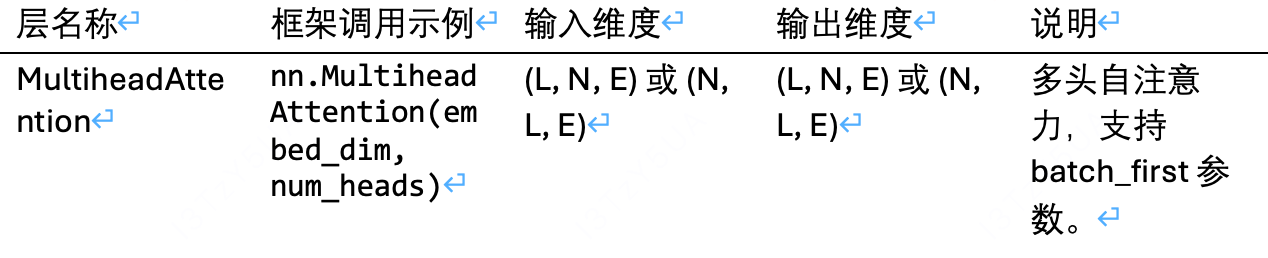
维度与权重说明:
- 输入 (Query, Key, Value):(L, N, E) 或当 batch_first=True 时为 (N, L, E)。其中 L 为目标序列长度,N 为 Batch Size,E 为嵌入维度。
- 输出:与输入形状一致 (L, N, E)。
- 权重:Q/K/V 投影矩阵各为 (E, E),输出投影矩阵为 (E, E)。
十一、维度变化速查口诀
为帮助开发者快速记忆,特总结以下维度变化规律:
• 全连接层:行出列入(仅改变最后一个特征维度,Batch不变)。
• 卷积层:通道数变,空间尺寸看 kernel / stride / padding。
• 池化层:缩小空间尺寸,通道不变。
• 归一化层:维度不变,按通道或按特征归一。
• 激活函数:维度不变,逐元素变换。
• 嵌入层:索引变稠密向量(增加一个 embedding_dim 维度)。
• 循环层:序列维度展开(输出包含完整序列的隐藏状态)。
• 注意力:输入输出序列长度不变(常配合残差连接使用)。