一、为什么需要"本地跑大模型"?
用过 AI 编程助手的开发者,一定经历过这样的困境:
- 费用焦虑:Claude、GPT 的 token 费用,一个月下来几百甚至上千
- 隐私担忧:代码、文档、业务逻辑全部发送到云端,万一泄露怎么办?
- 网络依赖:断网了?API 挂了?AI 助手直接罢工
- 速率限制:用着用着突然被限流,等半天才能继续
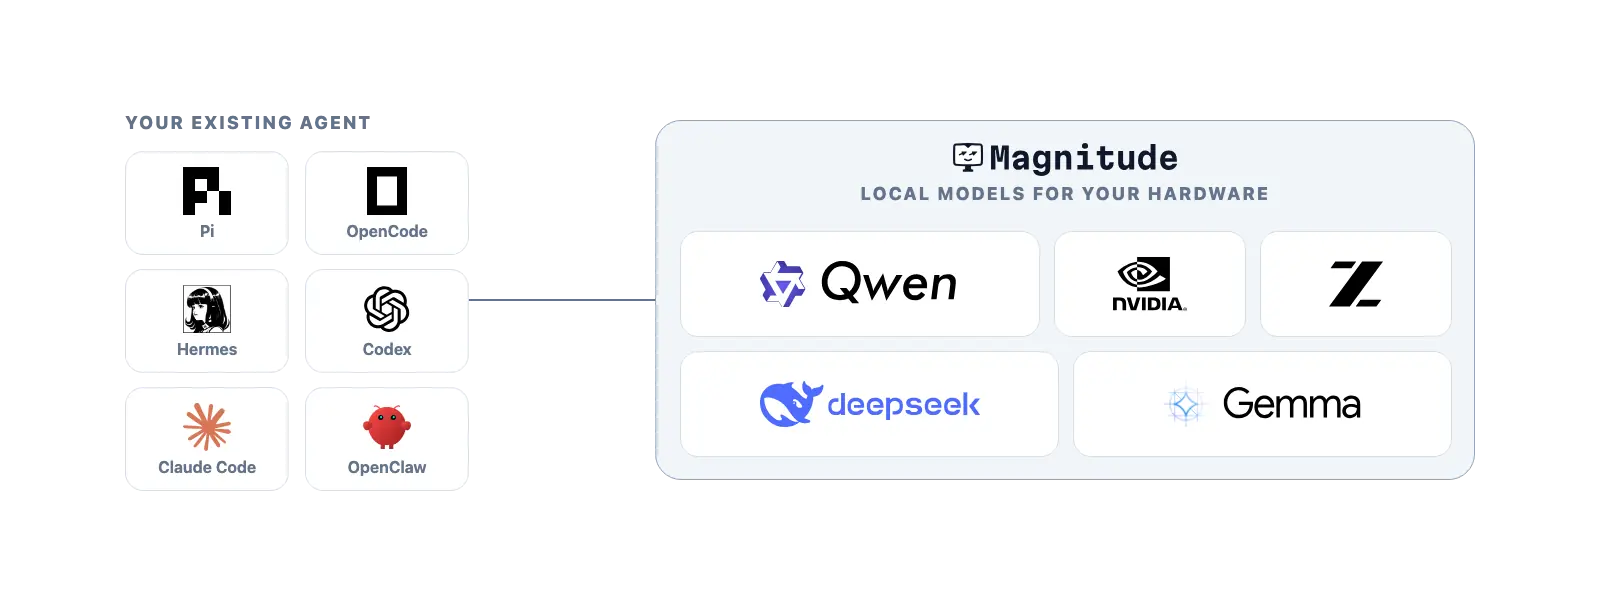
Magnitude 的出现,正是为了解决这些痛点------让你的 AI 代理在本地运行,免费、私有、离线可用。
Github: github.com/magnitudede...
二、核心功能:不只是"装个 Ollama"
很多人可能觉得"本地跑模型"不就是装个 Ollama 吗?但 Magnitude 做得远不止这些。
2.1 硬件感知:知道你的机器能跑什么
这是 Magnitude 最核心的差异化能力。它会自动分析你的硬件:
- 芯片类型:Apple Silicon、NVIDIA GPU、AMD GPU、CPU
- 内存容量:8GB、16GB、32GB、64GB+
- 带宽速度:内存带宽、磁盘速度
然后基于这些信息,推荐最适合你机器的模型,并预估推理速度(tok/s)。
举个例子 :一台 16GB 内存的 MacBook Pro,Magnitude 可能推荐:
- Qwen3-1.7B(最快,16GB 够用)
- Llama3-8B(中等,需要量化)
- 而不是推荐 70B 模型(16GB 跑不动)
2.2 Agent-First 设计:让 AI 助手自己设置
Magnitude 的设计理念是 "Agent-First"------你只需要给 AI 助手发一条提示:
javascript
Set up local models for me with the Magnitude CLI. Install it with `npm i -g @magnitudedev/cli`, then run `magnitude docs onboarding` and follow the instructions.然后 AI 助手会: 分析你的硬件配置 -> 推荐适合的模型 -> 下载你选择的模型 ->自动切换到本地模型
整个过程不需要你手动配置,AI 助手自己完成自己。
2.3 按需加载:智能内存管理
本地跑大模型最大的挑战是内存。Magnitude 实现了智能的内存管理:
按需加载 :模型只在需要时加载,不会一直占用内存;自动卸载 :空闲或内存紧张时,自动卸载模型;多模型切换:可以在不同模型间无缝切换
这意味着你可以在一台 16GB 的机器上,同时运行多个小模型,而不用担心内存爆掉。
三、技术架构:一个推理服务器的优雅实现
打开 Magnitude 的源码,你会发现这是一个典型的推理服务器架构,模块划分清晰:
csharp
用户请求
    ↓
[API Gateway] 路由请求
    ↓
[Model Manager] 模型加载/卸载
    ↓
[Inference Engine] 推理执行
    ↓
[Hardware Profiler] 硬件分析
3.1 核心设计模式
1. 硬件抽象层
通过硬件分析,屏蔽底层差异:
typescript
// 硬件配置文件
interface HardwareProfile {
  chip: 'apple-silicon' | 'nvidia' | 'amd' | 'cpu';
  memory: number; // GB
  bandwidth: number; // GB/s
}
2. 模型目录系统
内置模型目录,包含预计算的性能数据:
typescript
// 模型推荐算法
function recommendModels(profile: HardwareProfile): Model[] {
  return catalog
    .filter(m => m.memoryRequired <= profile.memory)
    .sort((a, b) => b.estimatedSpeed - a.estimatedSpeed);
}
3. 按需加载
模型只在需要时加载,空闲时卸载:
typescript
// 内存管理器
class ModelManager {
  private loaded: Map<string, Model> = new Map();

  async load(name: string): Promise<Model> {
    if (this.loaded.has(name)) {
      return this.loaded.get(name)!;
    }
    // 检查内存
    if (this.getMemoryUsage() > this.memoryLimit) {
      await this.unloadOldest();
    }
    // 加载模型
    const model = await this.loadFromDisk(name);
    this.loaded.set(name, model);
    return model;
  }
}
3.2 支持的 AI 工具生态
Magnitude 的一大亮点是支持多种 AI 工具:
| 工具名称 | 类型 | 集成方式 |
|---|---|---|
| Claude Code | AI 编程助手 | 原生支持 |
| Cline | VS Code 插件 | 原生支持 |
| Codex | OpenAI 工具 | API 兼容 |
| OpenCode | 编程助手 | 原生支持 |
| Pi | AI 助手 | 原生支持 |
| Hermes | 推理框架 | API 兼容 |
这意味着你可以用 Magnitude 替换任何支持 OpenAI API 格式的工具,无需修改代码。
四、创新亮点:值得借鉴的设计思想
4.1 渐进式引导:从新手到专家
Magnitude 的 onboarding 流程设计得非常人性化:该流程涵盖五大核心步骤:自动硬件检测、智能模型推荐、用户自主下载选择、AI工具配置自动修改、以及系统运行验证测试。
这种渐进式引导,既降低了新手门槛,又满足了高级用户的需求。
4.2 目录化管理:模型像 App Store
Magnitude 把模型管理得像 App Store 一样:
- 预计算性能:每个模型都有预估的 tok/s
- 量化版本:提供不同精度的量化版本
- 一键安装 :
magnitude install qwen3-1.7b - 一键切换 :
magnitude switch qwen3-1.7b
五、适用场景与局限性
适合场景
- 个人开发者:节省 API 费用,保护代码隐私
- 企业内部:敏感代码不能上云,需要本地部署
- 离线环境:没有网络的开发环境
- 学习研究:研究本地模型推理性能
当前局限
- 硬件要求:至少需要 8GB 内存,推荐 16GB+
- 模型大小:受限于本地硬件,无法运行超大模型
- 推理速度:本地推理通常比云端慢(取决于硬件)
- 功能完整度:部分高级功能可能不如云端模型
Github: github.com/magnitudede...
六、总结:本地 AI 推理的新范式
Magnitude 不仅仅是一个"本地跑模型"工具,它展示了 AI 推理的新可能:
- 硬件感知:自动分析硬件,推荐最适合的模型
- Agent-First:让 AI 助手自己设置,降低使用门槛
- 智能管理:按需加载、自动卸载,优化内存使用
- 生态兼容:支持多种 AI 工具,无缝集成
如果你是开发者,经常使用 AI 编程助手,Magnitude 值得一试。它不仅能帮你节省费用、保护隐私,还能让你体验本地 AI 推理的自由。
关注
如果这篇文章对你有帮助,欢迎关注公众号,获取更多技术深度分析和开源项目拆解。