企业 AI 应用从试验走向生产的挑战
过去一年,RAG、企业知识库、智能 Agent、多模态检索和训练数据治理等场景,对底层数据系统提出了更高要求:同一份非结构化数据既要在在线服务中完成低延迟语义检索,又要支撑数据探索、质量治理和批量分析。
而传统架构把这些需求拆到了数据湖、向量数据库、训练链路和检索服务里。为了让数据进入 AI 应用,企业需要反复搬迁数据、维护多份副本、重建索引,并持续处理同步和一致性问题。
火山引擎 Milvus Vector Lakebase 正式上线
面向这一需求,火山引擎基于 Milvus 向量数据库能力,引入湖原生存储与弹性计算架构,正式发布火山 Milvus Lakebase :让同一份语义数据服务在线检索、交互式探索和批量分析,帮助企业构建面向 AI 的统一数据底座。
本次公测重点开放 On-Demand 形态:数据存在湖上,查询或者分析的时候再调用计算资源,任务结束后释放资源。对于历史知识库、周期性评测等低频大规模的数据任务,企业无需为其长期保留专用查询资源。
随着 On-Demand 形态的推出,火山引擎 Milvus 目前提供三种产品形态,以匹配不同业务场景及其负载:
- Dedicated 更适合持续在线、高并发、低延迟的核心业务;
- Serverless 更适合轻量接入和弹性验证;
- On-Demand 则面向大规模、低频、阶段性的语义检索与分析任务。
Vector Lakebase,面向 AI 时代的语义数据底座
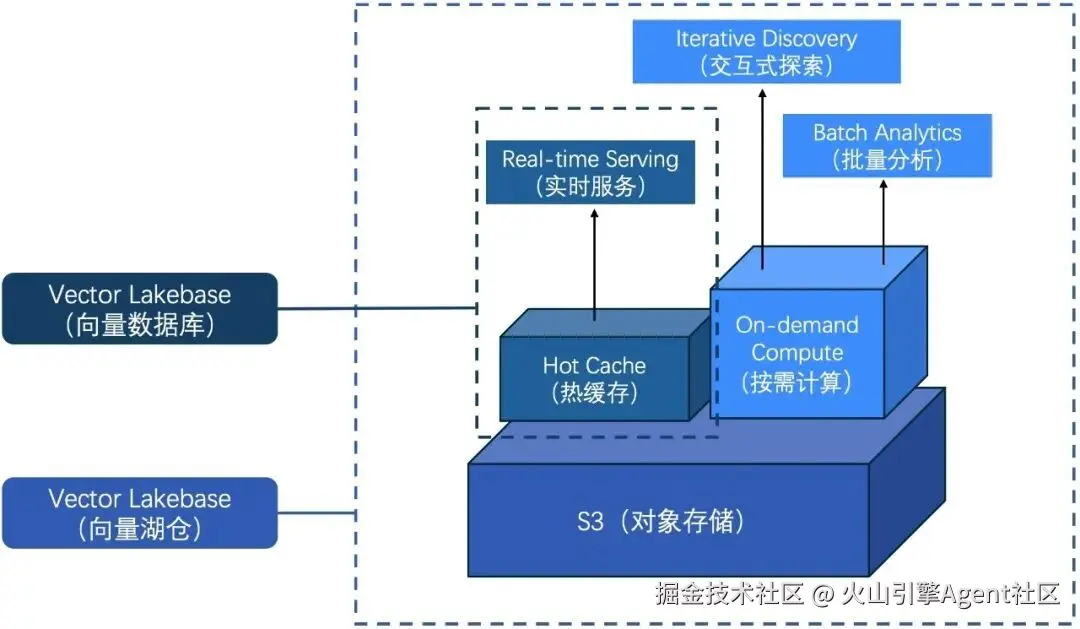
Vector Lakebase 是一个以语义数据为核心的数据平台,从场景和数据源两层来看:
场景覆盖
Vector Lakebase 作为数据平台可服务在线检索、交互式探索和批量分析三种不同的业务场景:
- Real-time Serving: 为对延迟要求极高的生产服务提供实时检索功能;我们常见的电商推荐、企业知识库,都是典型的在线实时检索。
- Iterative Discovery: 用于交互式和多步骤探索的迭代发现;比如,AI 开发者需要分析 feedback data 和底层 corpus,找到服务质量下降的原因。agentic system 也可能自动探索日志和用户行为,定位知识缺口、策略问题或数据稀疏区域。
- Batch Analytics: 用于离线数据挖掘和数据集优化的批量分析。自动驾驶的数据挖掘,模型训练中的数据去重,都是典型的代表。
数据覆盖
数据既可放在数据库实例中管理,也支持外部湖仓作为底层数据源:
- Managed Collection: 数据托管在火山 Milvus 实例内,平台负责存储和索引。
- External Collection: 直接关联对象存储中的湖仓文件,就地建索引,不搬数据。
火山 Milvus Vector Lakebase 核心能力
On-Demand 形态
如何解决场景覆盖范围,火山引擎推出 On-Demand 产品形态,On-Demand 实例的 Query 计算节点按需启动,应对交互式探索和批量分析两种偏离线的查询场景,当查询、分析或回归任务发生时再拉起计算资源,任务结束后释放资源。冷数据检索、周期性回归、离线语义挖掘等低频大规模任务,可以通过 On-Demand 减少长期保留专用计算资源带来的空转。
External Collection
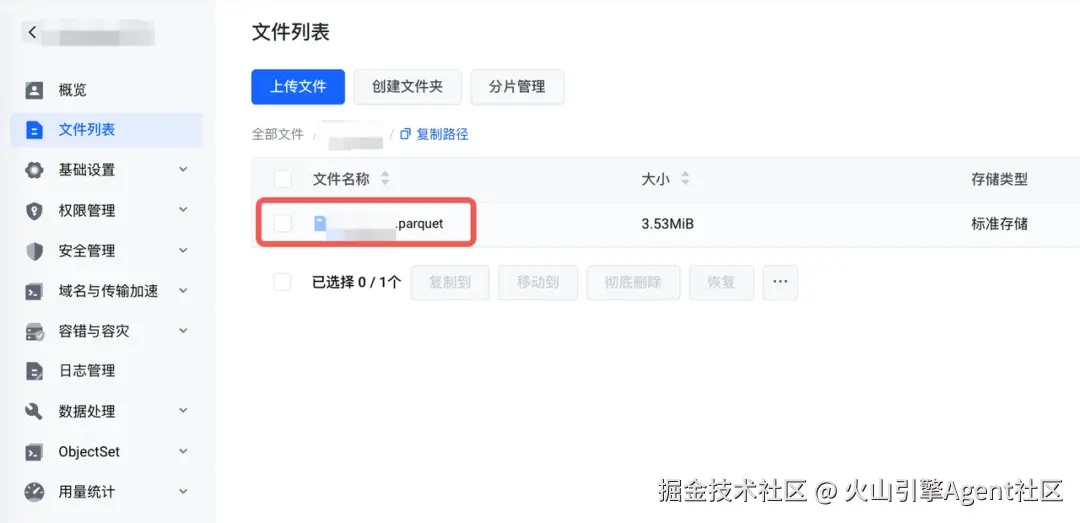
为了扩大数据覆盖范围,基于 Milvus 3.0 的 External Collection能力,On-Demand 形态提供 Managed Collection & External Collection 两种数据源选项,支持直接关联火山 TOS 对象存储中的 Parquet 文件,原地引用湖存储文件、进行索引构建,无需将数据复制到 Milvus 的情况下进行检索。
两项能力配合使用,冷数据可以留在湖仓,进行按需查询 / 分析。训练数据治理、Corner Case 挖掘等场景也不再需要为一次性任务预留常驻资源。
On-Demand 形态典型业务场景
- 自动驾驶 Corner Case 挖掘: 在海量视频片段、场景标签和向量数据中,按需检索事故、badcase 或模型退化后的相似场景,适合问题定位期间的短时高算力任务。
- 企业历史知识库冷数据召回: 面向历史文档、归档工单、会议纪要和长尾知识库,保留随时可查的语义检索能力,同时减少为低频冷数据维护常驻查询资源。
- 大规模训练数据治理: 对文本、图片、视频等 embedding 数据进行相似去重、聚类、质量分层和样本筛选,为训练、微调和评估提供更高质量的数据输入。
- AI 产品质量分析: 围绕用户 query、模型回答、召回 chunk、用户反馈和质检结果,集中探索失败回答模式,帮助 RAG、Agent 或 Copilot 产品定位知识缺口与优化方向。
On-Demand+External Collection 如何使用
在公测阶段,客户可先联系火山引擎客户经理申请开通。完成开通后,典型使用路径可以概括为:
1. 准备数据源: 确认对象存储的数据路径、数据格式、schema、向量字段和主键字段,并确保数据组织方式符合接入要求。
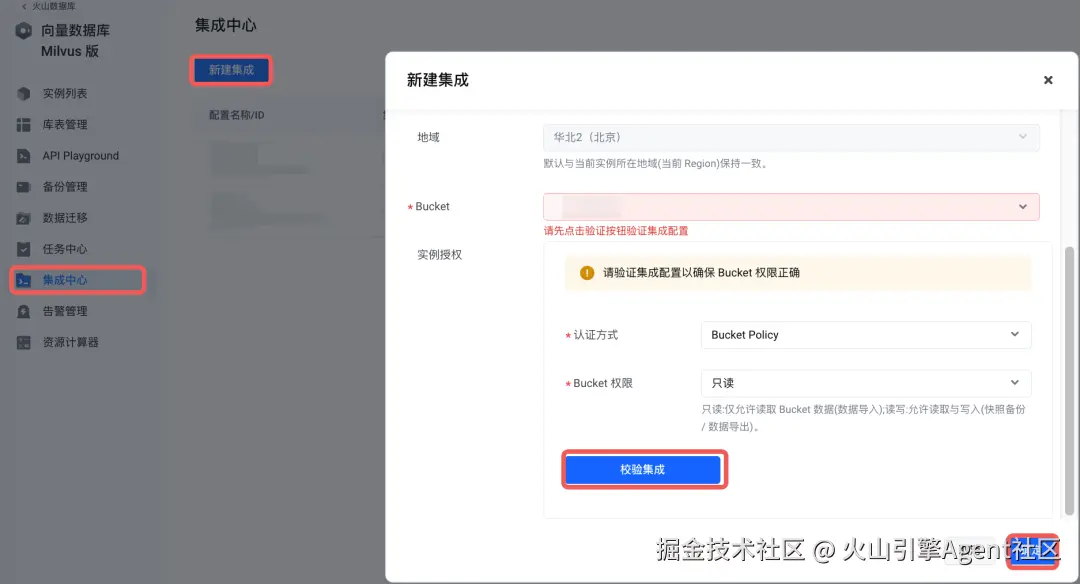
2. 配置访问权限并创建外部数据连接: 在控制台集成中心页面完成存储集成、IAM 授权和网络连通性配置,让平台能够安全读取指定 bucket、path 或湖表数据。
3. 创建 External Collection: 关联外部数据源,配置 collection 名称、向量字段、标量字段、数据格式和 schema 映射。
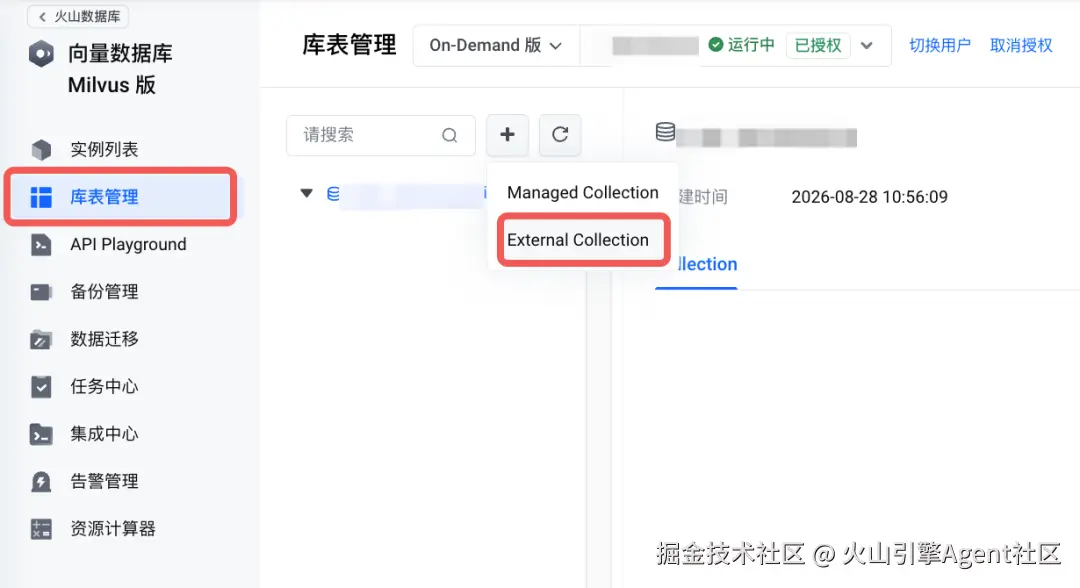
4. 创建实例下 Query 集群: 创建 Query 资源,配置弹性规则。
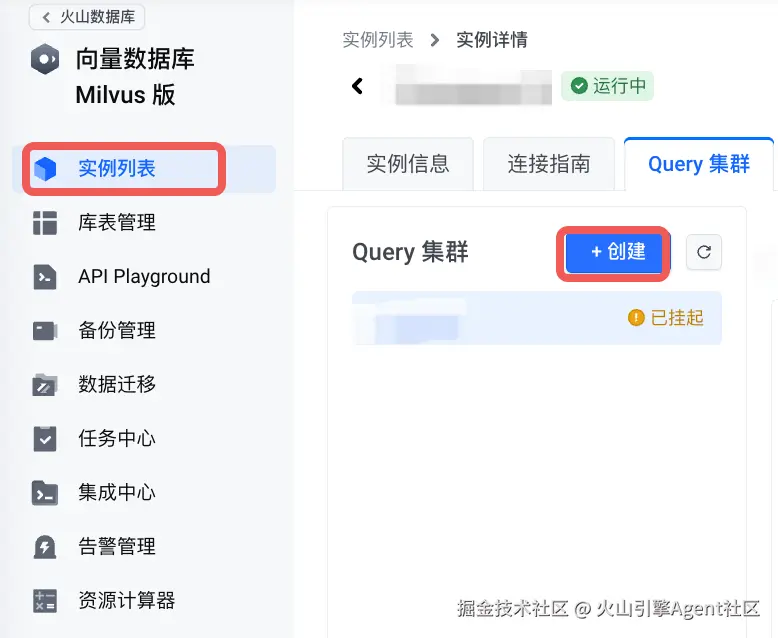
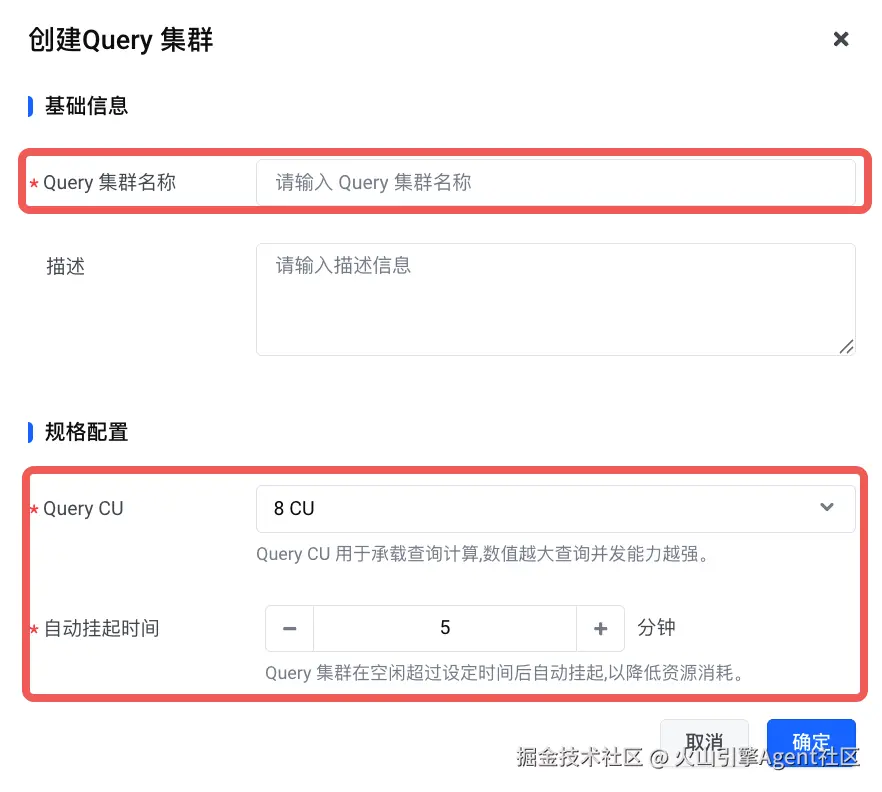
5. 同步数据: 触发数据 refresh,数据准备完成后即可进入检索流程。
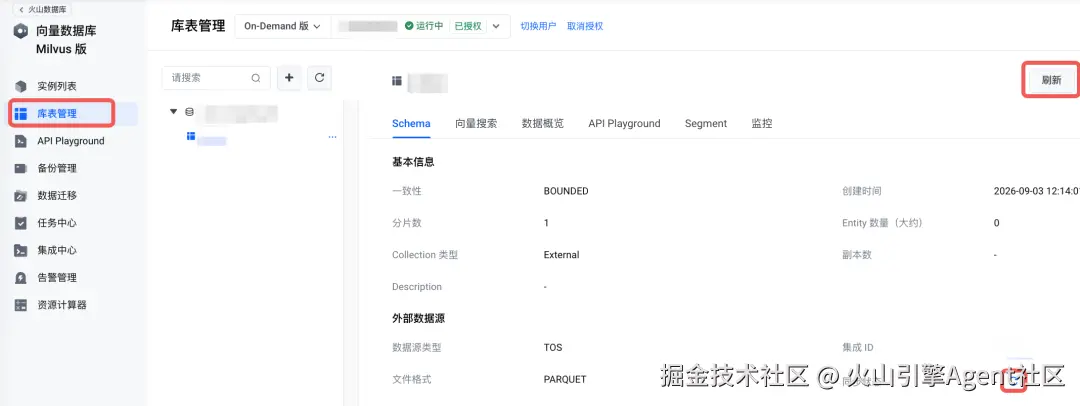
6. 按需发起查询: 通过统一 endpoint 访问,平台根据查询任务拉起所需计算资源;任务结束或空闲后,计算资源释放。
让 AI 数据基础设施跟上应用迭代速度
AI 应用的质量,越来越取决于数据能否被持续发现、持续修正和持续复用。火山引擎 Milvus Vector Lakebase 希望帮助企业把语义数据从"检索时的后端组件"升级为"AI 应用全生命周期的基础设施"。
目前,火山引擎 Milvus Vector Lakebase 已正式上线公测。 正在建设 AI 搜索、企业知识库、智能 Agent、多模态检索、数据湖语义分析或训练数据治理工作流的客户,可联系火山引擎客户经理申请开通。