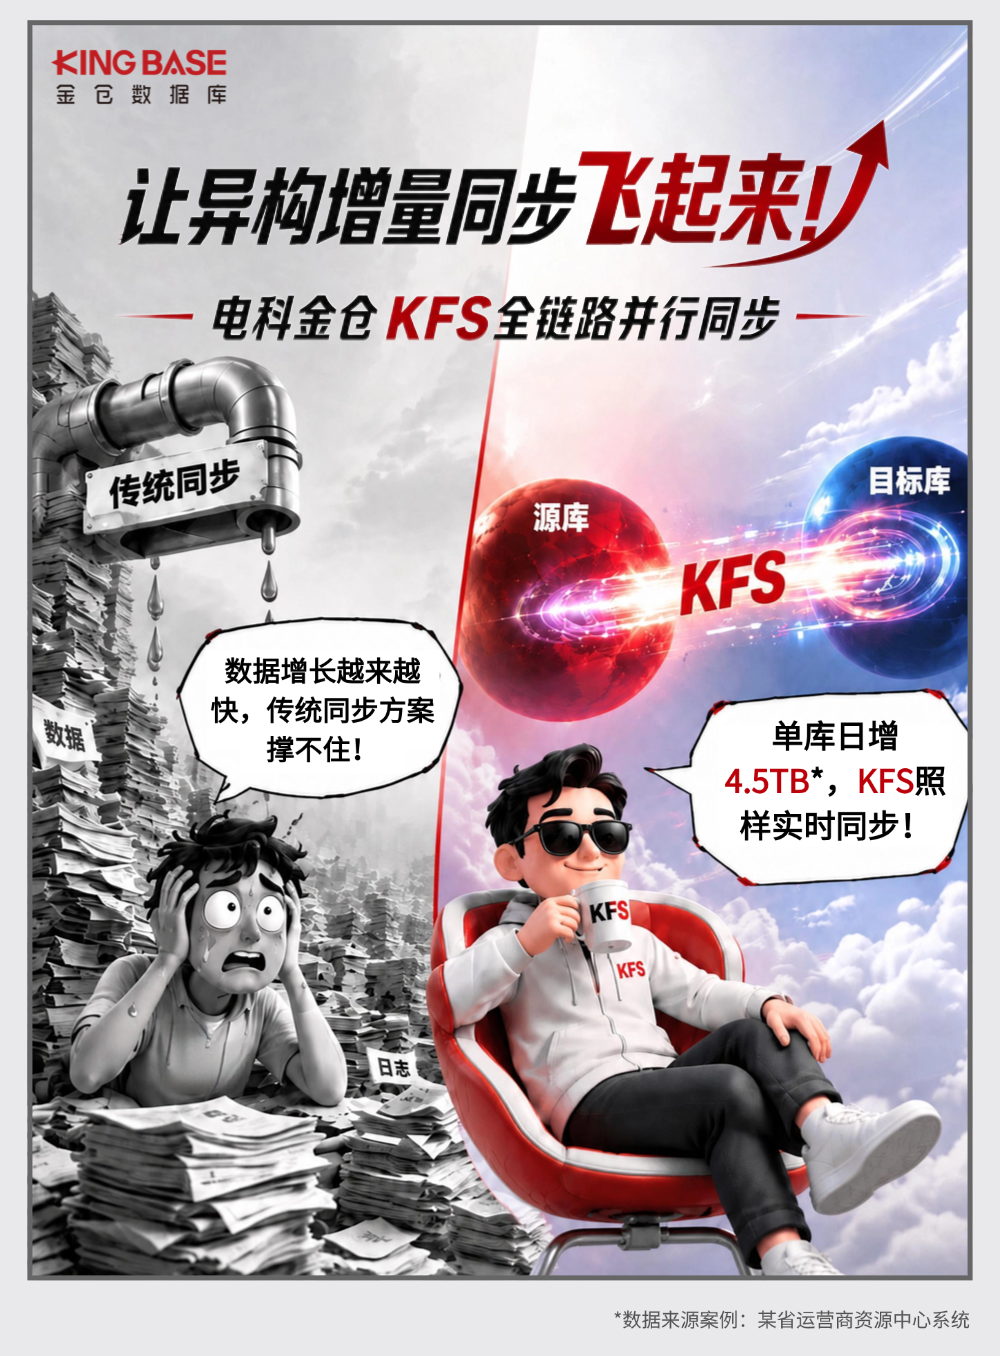
在数据库国产化替换和多云架构落地的过程中,异构数据库之间的数据同步是绕不开的环节:新旧系统并行运行需要双写保持一致,数据迁移需要业务不中断地完成切换,实时数仓、容灾备份也需要增量数据持续、低延迟地流动。KFS(Kingbase FlySync)正是面向这类场景的异构数据同步工具,支持 Oracle、MySQL、SQL Server、PostgreSQL 等主流数据库与 KingbaseES 之间的实时增量同步。
不过,同步工具好不好用,关键看吞吐量和延迟。数据量一大、并发一高,很多同步链路就会明显变慢。下面这组图解,完整展示了 KFS 全链路并行同步的设计思路与实现效果。
一、传统同步链路的瓶颈在哪里
一条典型的增量同步链路,要经过日志捕获、解析、转换、装载等多个环节,最后落到目标端。传统实现方式下,这些环节往往以单线程方式串行执行:
- 单点瓶颈明显:任何一个环节处理不过来,上游堆积、下游等待,整条链路的吞吐被最慢的一环卡死;
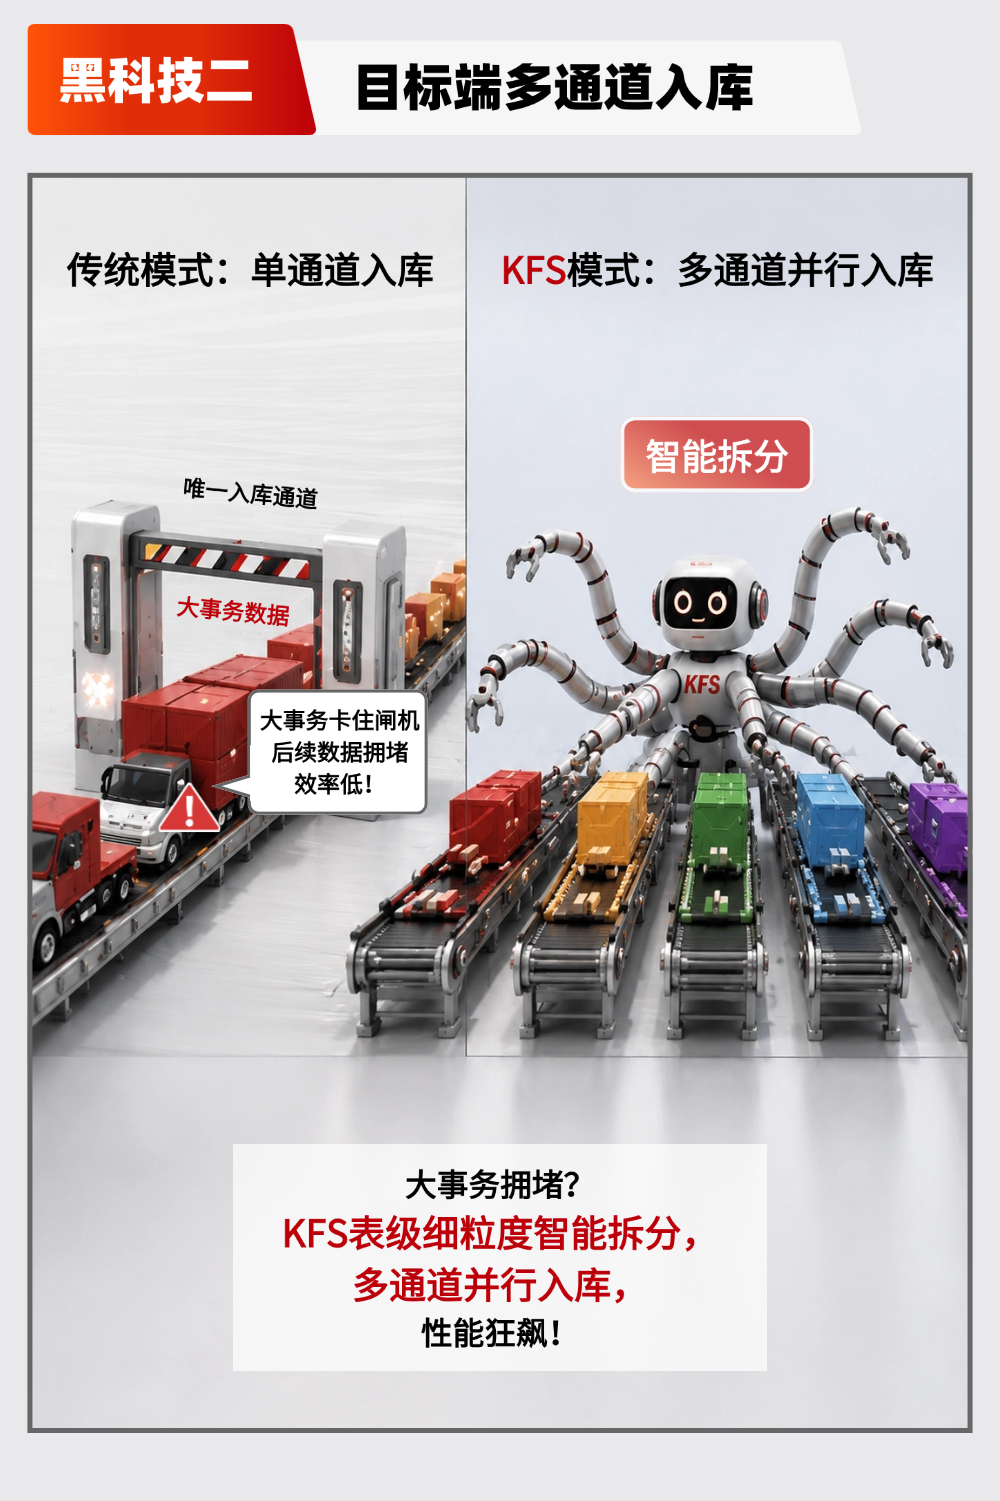
- 大表同步慢:一张亿级行级的大表,单线程抽取,耗时动辄以小时计;
- 延迟持续累积:高峰期事务量暴增时,解析和装载速度跟不上,同步延迟越积越大,直接影响数据一致性校验和业务切换窗口。
说白了,问题不在于"能不能同步",而在于"同步得够不够快"。要提速,只在某个环节单独优化是不够的,必须让整条链路都并行起来。
二、全链路并行:让每个环节都跑满
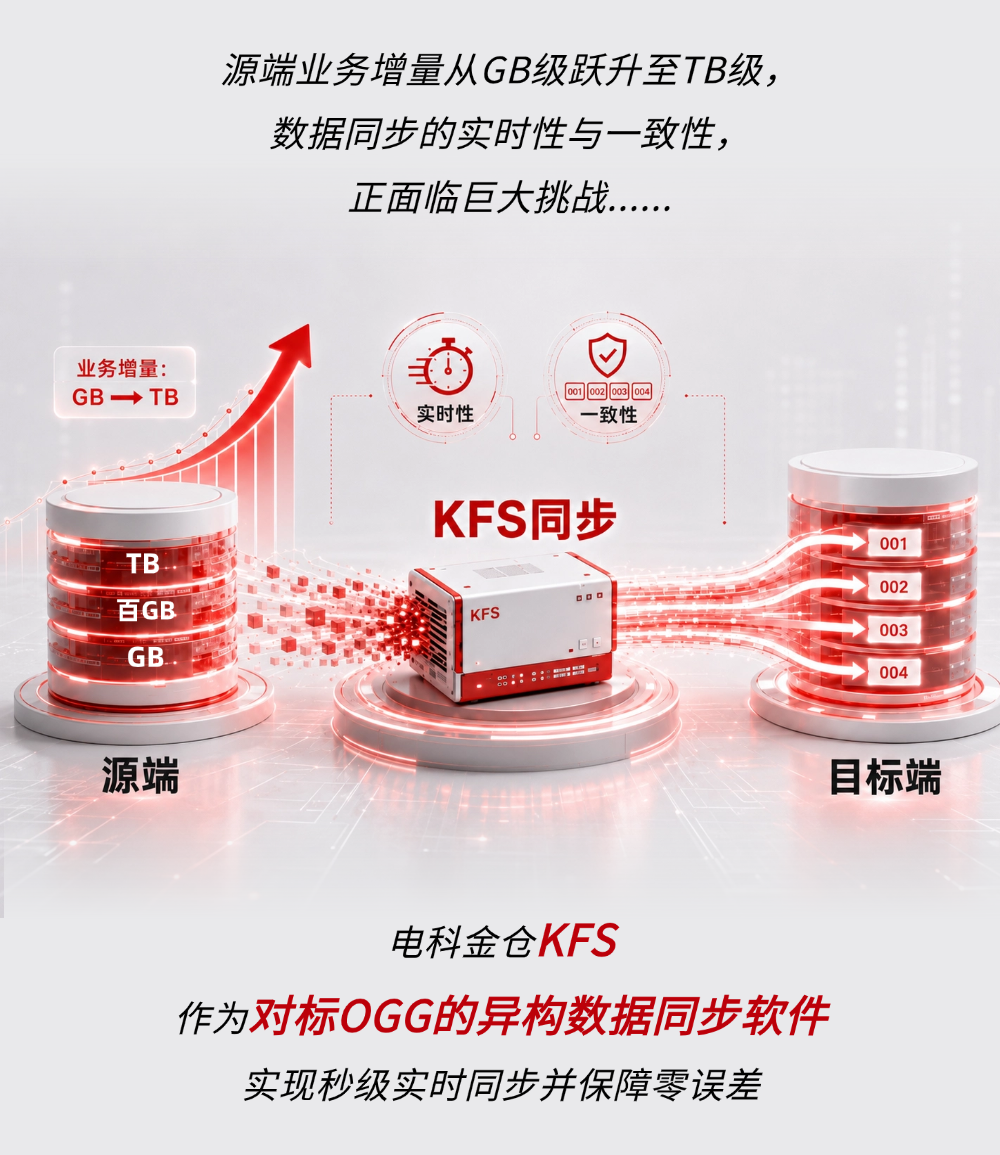
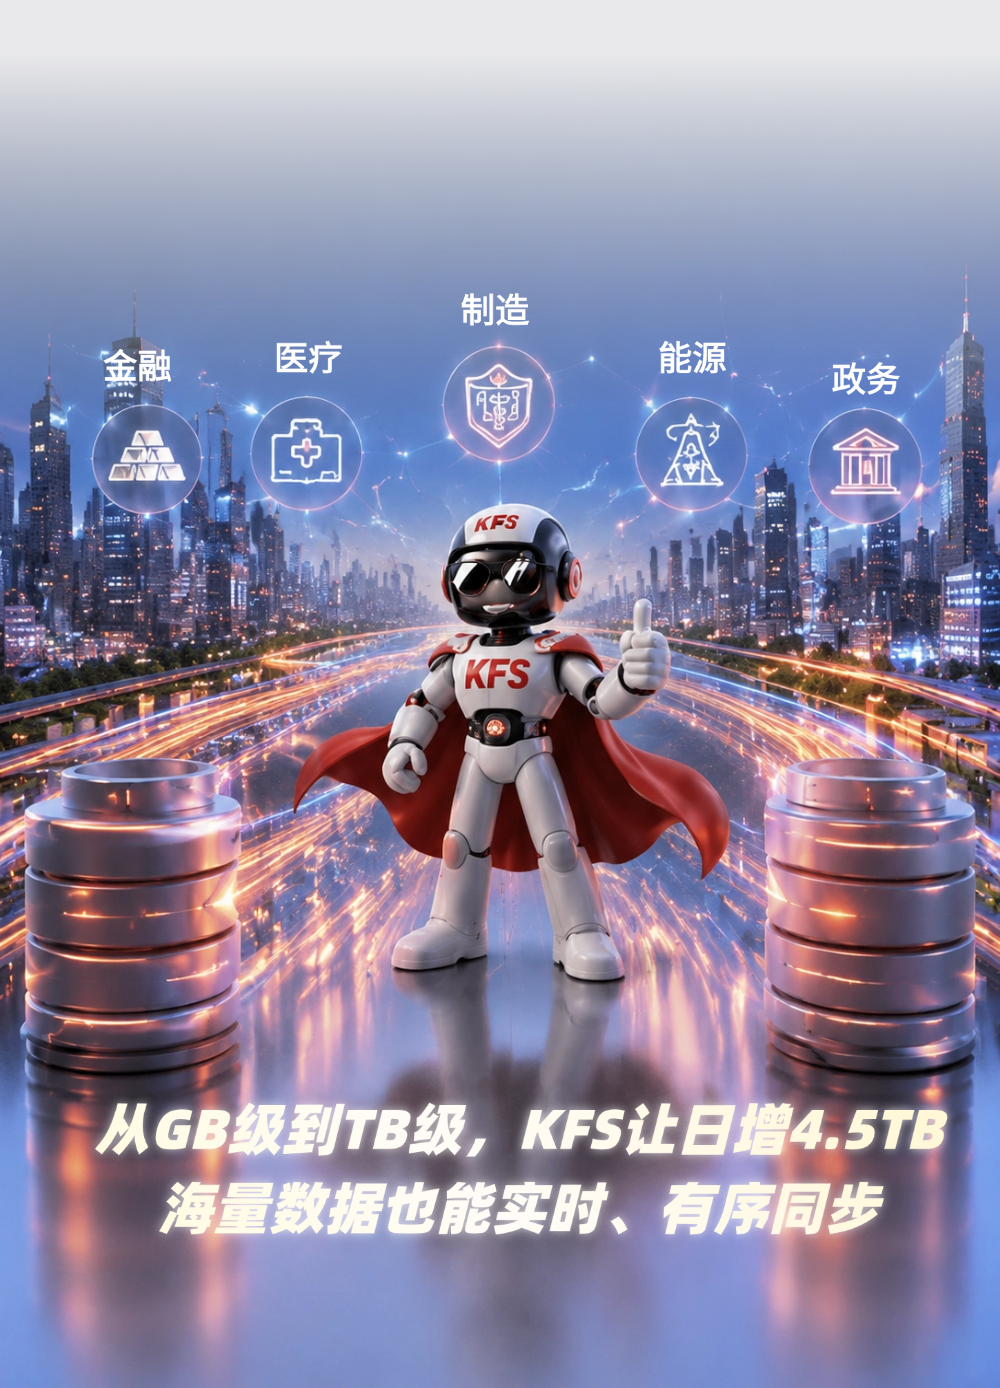
KFS 的思路是把并行化贯穿同步的全过程,从捕获端到装载端整条链路协同发力。下面这组图解完整展示了 KFS 全链路并行同步的架构设计、并行策略与实际运行效果。



三、写在最后
异构数据同步的并行化,不是简单地把线程开多一点,而是要在吞吐、延迟与数据一致性三者之间做好平衡:并行拆分要保证事务的顺序性不被破坏,故障恢复后要能从断点继续,不能丢数据、不能乱序。全链路并行的价值在于,当数据规模和事务压力上来时,同步链路依然能够保持稳定的低延迟,让数据迁移、双活并行、实时同步这些场景真正做到"业务无感"。
如果你正在做数据库替换或异构同步相关的项目,欢迎留言交流。