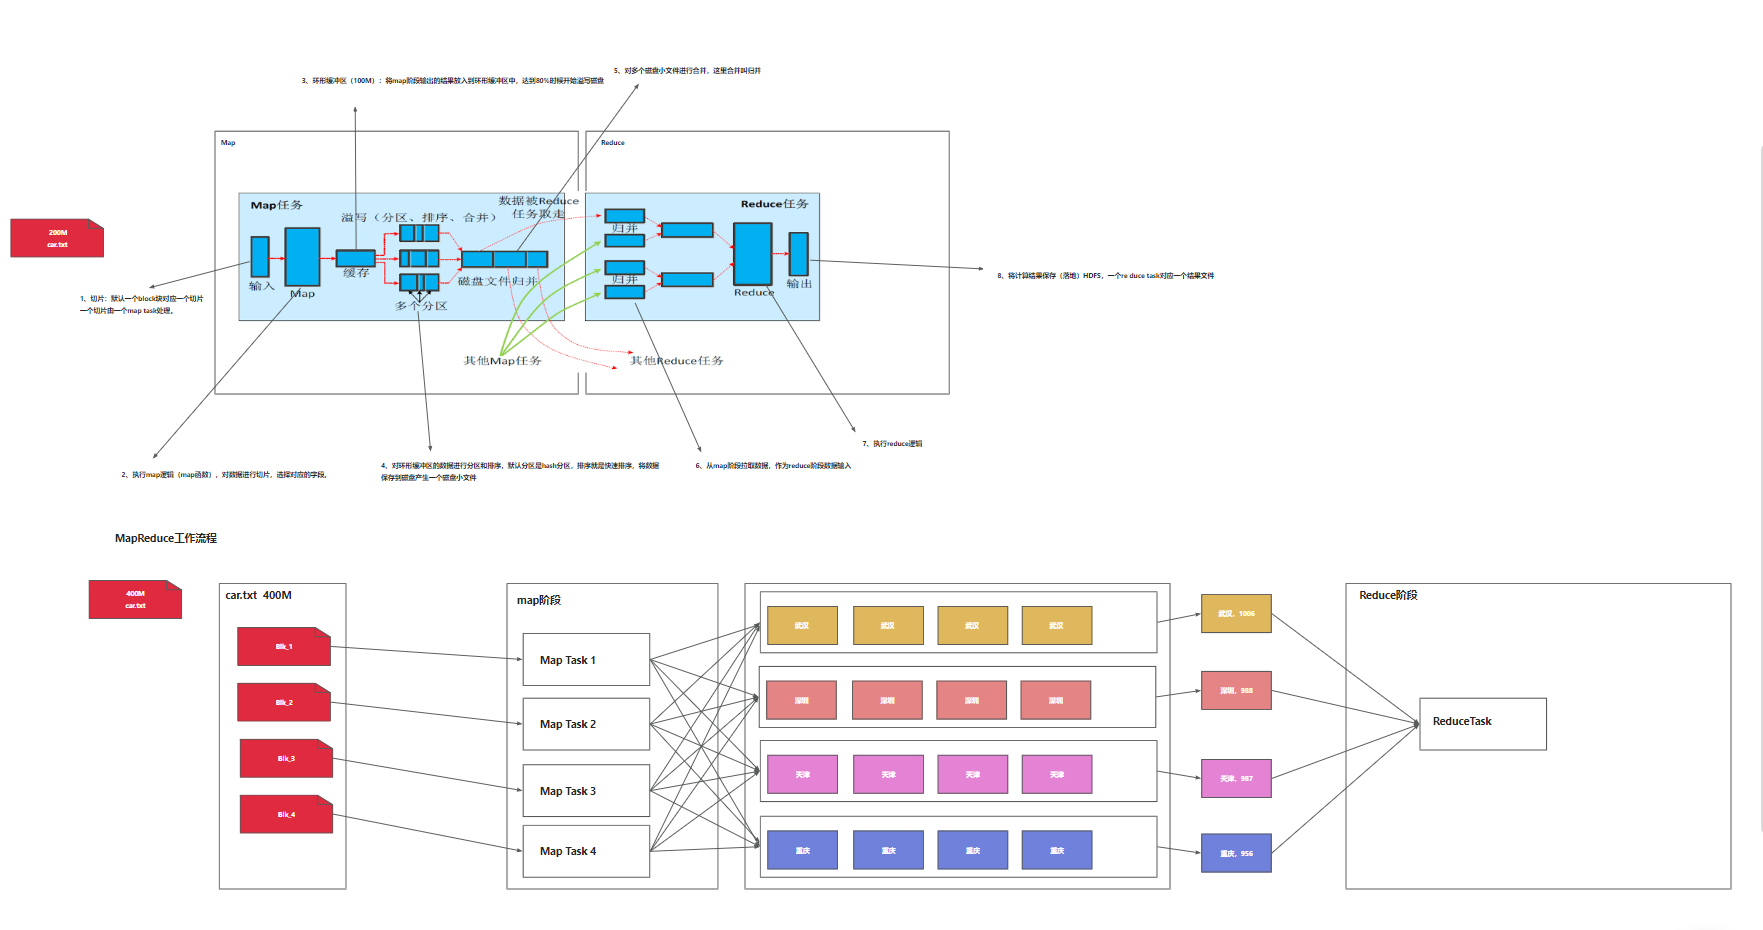
前置总述
MapReduce是Hadoop生态里的分布式计算框架 。简单一句话:把一个超大文件,拆成很多小块,多台机器并行做Map处理;处理完的数据按类别分组,汇总交给Reduce做合并统计,最后输出结果存入HDFS 。示例场景:一个400M的cart.txt购物日志文件,统计各个城市的订单数量。
核心名词
先一次性讲清楚(后面流程会用到):
- 分片(Split) :输入文件的逻辑划分。默认一个HDFS的block对应一个分片 ;一个分片启动1个MapTask。分片不是物理切割文件,只是记录:这个任务要读文件哪一段。
- MapTask(Map任务) :Map阶段的最小执行单元,并行运行。负责读取分片数据,执行我们写的map函数,提取需要的字段,输出
<key,value>键值对。 - 环形缓冲区(环形缓存) :Map节点内存里一块固定大小的内存区域(图例子100M),用来临时存放Map输出的
<key,value>。 - 溢写(Spill) :环形缓冲区快要写满(默认达到80%),就把内存里的数据分区、排序,写入本地磁盘,生成临时小文件。
- 分区(Partition) :给键值对分类。默认用hash算法,同一个key会分到同一个分区;一个分区最终交给一个ReduceTask。比如城市名称做key,武汉全部分到分区0、深圳分到分区1。
- 归并排序:把多个无序文件,合并成有序文件。分为两次:①溢写时每个分区内部排序;②磁盘多个小文件合并(合并归并)。
- ReduceTask(Reduce任务):Reduce阶段最小执行单元。拉取所有MapTask输出的、属于自己分区的数据,分组,执行reduce聚合逻辑。
- Shuffle(洗牌阶段) :Map输出之后,Reduce接收之前的整套流程(分区、排序、溢写、文件合并、数据网络传输)。Shuffle是MapReduce最核心、最耗时的阶段,作用就是把相同key的数据汇集到一起,交给同一个Reduce。
完整分步流程
阶段一:Map阶段(并行读取、处理原始数据)
步骤1:文件分片
原始文件cart.txt400M,HDFS默认block块128M,会切分成多个block。MapReduce读取文件时,默认1个block生成1个分片split,1个分片启动1个MapTask。
本例4个block → 4个分片 → 启动MapTask1、MapTask2、MapTask3、MapTask4,4个Map任务并行跑在不同节点。
步骤2:执行Map逻辑(map函数)
每个MapTask读取自己对应的分片里的一行行文本数据,运行map函数。以城市订单统计举例:读取一行日志武汉,订单11,map函数提取出key=武汉,value=1,输出键值对 (武汉,1)。所有输出的<key,value>不会直接发给Reduce,先写入环形缓冲区。
步骤3:环形缓冲区 + 溢写(Spill)
环形缓冲区是内存空间(示例100M),不断接收Map输出的<key,value>。当缓冲区数据占用达到阈值(默认80%),触发溢写:
- 先对缓冲区里的数据分区:根据key计算hash,分配到对应分区;
- 分区内部做快速排序(按key排序);
- 将排好序的数据写入当前机器本地磁盘,生成一个临时小文件。
剩下20%缓冲区空间,继续接收Map新输出的数据,不中断Map计算。如果Map持续输出大量数据,会多次溢写,在磁盘产生很多个有序小文件。
步骤4:磁盘小文件合并(归并)
当这个MapTask全部数据处理完毕,磁盘上已经有很多次溢写产生的小文件。Map任务会读取这些本地小文件,执行合并归并:同一个分区内的多个有序文件,合并成一个更大的有序文件。
每个MapTask最终在本地磁盘,生成按分区划分、分区内部有序的文件。文件中,相同key的数据是挨在一起的。
阶段二:Shuffle阶段(跨节点数据拉取,Map到Reduce的数据传输)
步骤5:Reduce拉取属于自己分区的数据
ReduceTask启动后,会去所有已经完成的MapTask节点,拉取属于自己分区的数据。举例子:Reduce0负责"武汉"分区 → 去4个Map节点,拉取每个Map输出文件里属于武汉分区的数据。Reduce1负责深圳分区,同理拉取所有Map里深圳的键值对。
这个网络拉取的过程,就是Shuffle的一部分。Reduce拿到从不同Map节点传过来的多段有序数据,在Reduce本地再次归并排序,把相同key全部聚合在一起。
阶段三:Reduce阶段(聚合汇总)
步骤6:执行Reduce逻辑
Reduce把同一个key的所有value放到一组。比如key=武汉,拿到一组数据:(武汉,1)、(武汉,1)、(武汉,1)...运行reduce函数,对这一组value做聚合求和,得到结果 (武汉,1006)。同理,深圳、天津、重庆各自聚合统计。
步骤7:输出结果写入HDFS
每个ReduceTask执行完成,生成一个结果文件。
规则:一个ReduceTask输出一个结果文件,写入分布式文件系统HDFS。文件内容就是聚合完成的最终键值对,本例:武汉:1006、深圳:988、天津:987、重庆:956。
整体逻辑一句话总结
大文件分片,多Map并行读取原始数据,输出键值对;Map端通过环形缓冲区溢写、分区排序,落地本地磁盘;Shuffle阶段,Reduce从所有Map节点拉取属于自己分区的数据、再次归并;Reduce把相同key的数据分组聚合,计算最终结果,输出文件保存到HDFS。
容易踩坑的知识点
- ❌ 误区:Map的结果直接通过网络发给Reduce
✅ 正确:Map先写到本机磁盘临时文件,Reduce主动上门拉取,不是Map推送。 - ❌ 误区:分片=block,二者完全一样
✅ 正确:block是HDFS物理存储块;分片split是MapReduce逻辑读取划分,默认一一对应,但可以手动修改分片大小。 - ❌ 误区:Shuffle只是网络传输
✅ 正确:Shuffle包含分区、排序、溢写、本地文件合并、网络拉取、Reduce端归并整套流程,是MapReduce性能瓶颈点。 - ❌ 误区:一个key可以分给多个Reduce任务
✅ 正确:分区规则决定,同一个key一定会分到同一个分区,交给同一个ReduceTask,保证相同key全部在一处聚合。