**摘要:**本文从工程视角梳理 GEO(生成式引擎优化)的站点侧技术地基,围绕抓取可及性、渲染解析、结构化数据三条主线展开。内容包括:确认 robots.txt 与 sitemap 配置、避免 CSR 导致正文不可达、用 Schema.org + JSON-LD 标注 Article/FAQPage/BreadcrumbList、落实内容侧技术规范,以及通过抓取诊断、结构化校验和 AI 引用观察进行验证与监控。适合负责站点和技术 SEO 的工程师阅读。
GEO(Generative Engine Optimization)落地时,很多人第一反应是「多写内容」。但从工程视角看,内容能否被 AI 检索、解析和引用,首先取决于站点层面的技术地基。本文从爬取可及性、渲染、结构化数据三条线,讲清楚站点侧可以做哪些技术优化。适合负责站点和技术 SEO 的工程师阅读。
一、AI 搜索获取内容的链路
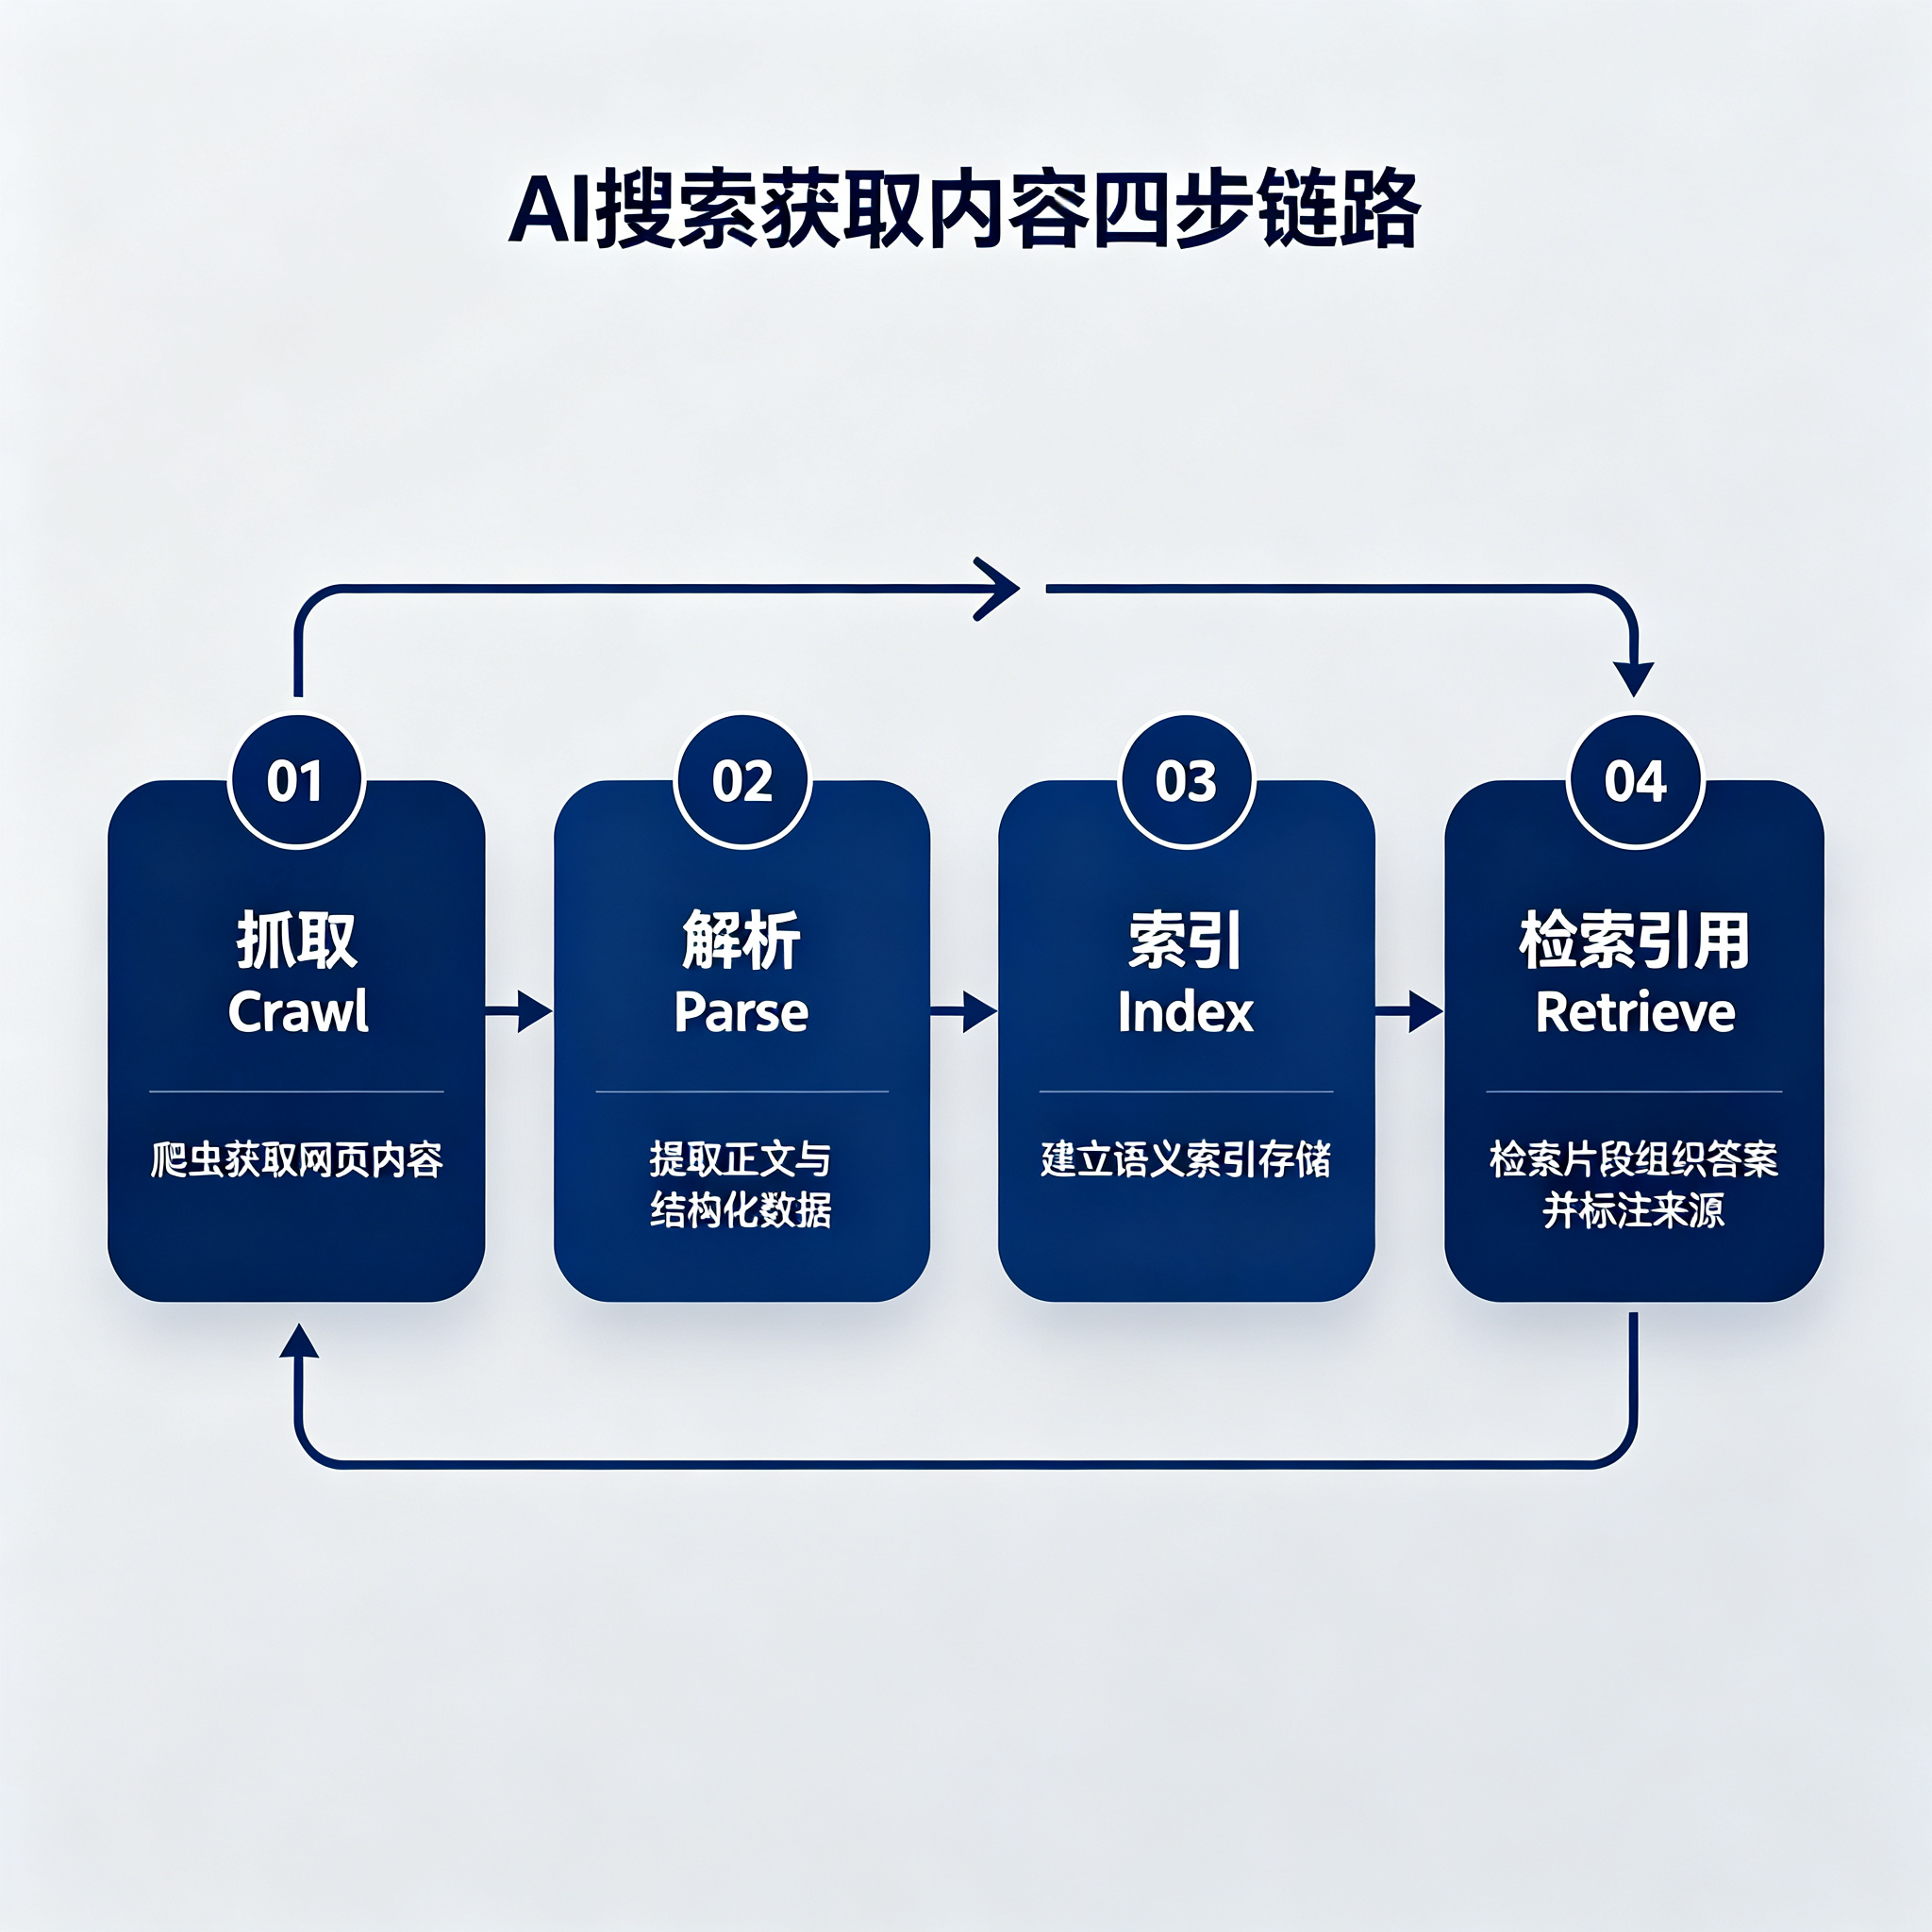
无论是传统搜索引擎还是 AI 搜索(RAG 式问答),获取网页内容都经历大致四步:抓取(Crawl)→ 解析(Parse)→ 索引(Index)→ 检索引用(Retrieve/Cite)。AI 问答相当于在「检索」之后多了一步:把检索到的片段组织成自然语言答案并标注来源。因此,站点优化的目标就是让前四步都顺利通过,且被解析出的内容语义清晰。
二、抓取可及性:先保证爬虫进得来
抓取阶段最常见的坑是配置不当。三点必须检查:
- robots.txt。别把 AI 爬虫挡在门外。主流搜索引擎的 AI 爬虫都有独立的 UA,如 Google 的 Google-Extended、百度的 Baiduspider-render、必应的 bingbot,需确认 robots.txt 没有误禁,需确认 robots.txt 没有误禁。示例:
bash
User-agent: Google-Extended
Disallow:
# 允许(不要写 Disallow: /)- sitemap。在 robots.txt 里声明 sitemap 地址,并保证 sitemap 只包含可公开访问、无重复的 URL:
bash
Sitemap: https://www.example.com/sitemap.xml- 页面可访问性。页面不应依赖登录态、不应有 meta robots 的 noindex/nofollow 误标、避免大量 JS 弹窗遮挡正文。
三、渲染与解析:让内容以纯文本可达
AI 的解析器对「内容是否直接可见」很敏感。两类情况需要特别处理:
一是 CSR(客户端渲染)站点。如果正文完全由前端 JS 加载,解析器可能拿不到内容。方案是 SSR/SSG 或预渲染,保证 HTML 源码里直接包含正文文本。判断方法:用 curl 拉取页面源码,搜索正文关键词,找不到就说明需要改造。
二是图片/音视频中的文字。正文里大量信息放在图片里(如截图、长图),AI 无法可靠提取。建议关键信息以文本形式呈现,图片只作补充。
四、结构化数据:让语义机器可读
结构化数据(Schema.org + JSON-LD)能显著提升解析质量。GEO 场景下推荐优先标注这三类:
- Article(文章),明确标题、作者、发布日期、正文描述:
bash
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "GEO 技术实践",
  "datePublished": "2026-09-02",
  "author": {
    "@type": "Organization",
    "name": "Example"
  }
}- FAQPage(常见问题),把「用户会问的问题+答案」结构化呈现:
bash
{ "@context": "https://schema.org", "@type": "FAQPage", "mainEntity": [{ "@type": "Question", "name": "什么是 GEO?", "acceptedAnswer": {"@type": "Answer", "text": "生成式引擎优化......"} }]}- BreadcrumbList(面包屑),帮助理解页面在站点中的层级和主题归属。
注意:结构化数据必须与页面实际内容一致,不能只堆标记不写正文------这会带来反效果。
五、内容侧的技术规范
除了站点工程,内容本身也有可量化的规范:标题层级用 h1→h2→h3 清晰嵌套;段落短、每段一个主题;关键数据用文本明确写出(而不是图片);引用来源用链接标注。这些做起来不复杂,但对解析质量影响直接。
六、验证与监控
上线后用三类手段验证:用 Google Search Console、百度搜索资源平台等搜索引擎抓取诊断工具检查 URL 是否被收录;用结构化数据测试工具校验 JSON-LD 语法;用固定问题集定期询问各 AI 工具,观察站点内容是否被引用及引用位置。监控结果应沉淀成表格,用于后续迭代。
总结:GEO 的站点侧工作,本质是把「内容可被机器正确读取」这件事做到位。地基打牢之后,内容策略和信源布局才有意义。