这份专门贴合你自身情况定制的爬虫速成学习路线, 由好课优选提供, 着重突出"以战养战、快速上手", 我们把学习进程划分成为四个阶段, 按照优先级进行了排列, 目的是帮助你绕开枯燥的理论内容, 直接进入核心实战部分:
一阶段: 极简基础(建议耗时:3-5天)
不要去看长篇大论的 教程,只学爬虫用得上的语法:
最关键的数据结构: 能够熟练地掌控字符串项, 还有妥善地把握用于元素集聚排列的列表, 以及正确地把控用于关联映射的字典的增添、删减、修改以及查找操作。
控制运行流程的部分中有, 用于对网页数据进行逐个访问查看的for循环, 以及开展条件判定与选择的if-else语句。
函数以及异常方面, 要学会运用def去进行代码封装, 与此同时, 必须掌握try...(因为网络请求极其容易出现错误, 而这是爬虫程序的那种"保命"语法)。
文件的读取与写入: 要掌握将数据按照txt格式, 或者csv格式, 又或者json格式存储到本地的方法。
二阶段:静态网页爬虫实战(建议耗时:1周)
抓这样的网页属于爬虫特有的基本功, 这类网页无需登录, 其内容直接呈现在HTML里。
知道网页, 要去学会运用浏览器F12也就是开发者工具, 借助"检查()"来确定数据标签, 通过"网络()"去查看实际的请求接口。
发出请求, 去学习运用库来发送GET请求, 进而学会去伪装, 尤其要注重对User - Agent的伪装。
对数据进行解析, 要学习, 或者学习 lxml(XPath), 从而能够从 HTML 里精准地提取文字, 以及图片链接。
真实战斗中进行练手操作之际, 去撰写一个名为"豆瓣电影 爬虫", 或者是"名言警句爬虫"的程序, 进而将"展开请求-施行解析-进行存入 CSV"这样完全闭合的环节完成。
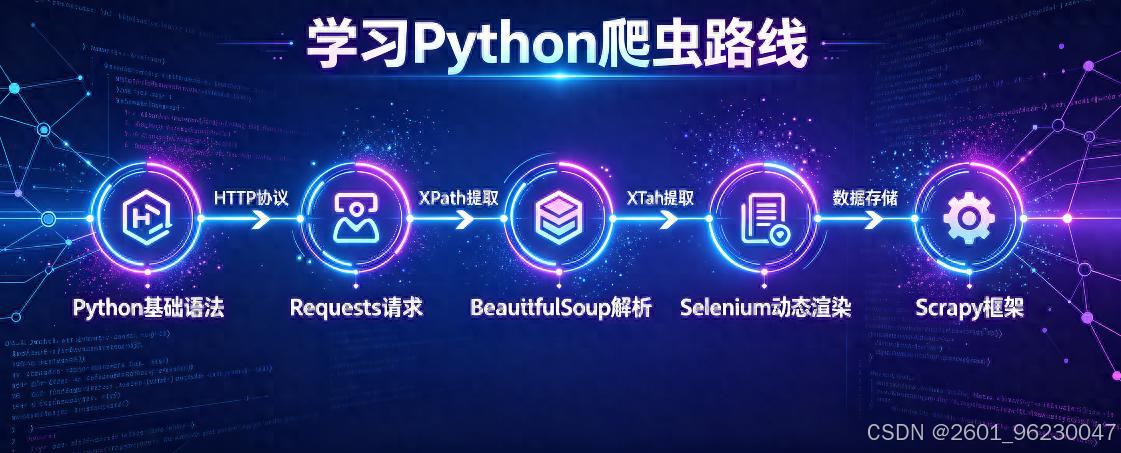
三阶段:进阶与反爬虫对抗(建议耗时:1-2周)
倘若你察觉到代码出现报错情况, 或者没办法抓取到数据, 甚至IP被封的时候, 此刻便进入到了这个阶段。
正则表达式, 也就是Regex, 要去学那基础的正则语法, 它能用来从杂乱无章的文本里, 把手机号给提取出来, 再把邮箱给提取出来, 还要提取特定格式的数据。
解决反爬机制问题, 要去学习怎样处理, 怎样维持登录所处状态, 还要学习怎样运用代理IP池, 以此来避免被封禁。
动态网页进行渲染时, 诸多现代网站的数据处于加载状态, 要学习运用, 或者模拟真实浏览器的操控行为, 类似于自动滚动以及点击按钮这样的操作。
实地操练动手: 撰写出一个, 那种能够自动登录某一论坛, 并且还可以去抓取帖子的爬虫;又或者可以抓取那种需要进行翻页操作的动态加载形成的列表的爬虫。
四阶段:数据存储与工程化(进阶方向)
当你的数据量达到几万、几十万条时,就需要升级装备了。
基础的数据存储: 展开对于基础 SQL 语法这种知识的学习, 去掌握轻量级数据库, 或者掌握关系型数据库 MySQL, 最后把数据存进表里头。
对于异步以及并发而言, 去从事学习这项行为, 或者, 能够促使你的爬虫, 从那种处于单线程排队的状态, 转变成为多线程并发的状况, 并且抓取速度会提升至十倍之多。