录口播和录屏的同学都遇到过:讲的时候磕绊、翻稿、喝水的几十秒全在片子里,回头手动剪又琐碎又费时间。静音删除这类工具的逻辑是"低于音量阈值的片段判定为冷场,自动剪掉",但参数怎么给、为什么有人用了没效果,很少有人掰开讲。本文用一段 3 分钟的真实视频做两轮实测:默认参数跑一遍(结果是一帧没删),调一个参数再跑一遍(删掉 2.9 秒),把阈值判定的逻辑讲清楚。
一、三个参数各自在判什么
静音删除的核心是三个滑杆,每个都对应一个判定条件:
- 静音阈值(dB):多小算"静音"。一段音频的瞬时音量低于这个值,才开始计入候选。默认 -45 dB 是相当严格的标准------要求环境几乎绝对安静;
- 最短静音(秒):静音持续多久才值得剪。说话本身有自然的停顿,0.3 秒的换气不该被剪掉,默认 0.5 秒就是过滤这种碎口;
- 缓冲边距(秒):每个切口前后各保留多少余量。没有它,剪出来的衔接会像"词语被拦腰斩断",字音的后半个瞬态会丢。
熟悉 ffmpeg 的同学可以对照 silencedetect 滤镜理解:noise=-30dB:d=1.0 这组参数里,noise 就是静音阈值,d 就是最短时长------工具界面上的三个滑杆,本质是给这套检测逻辑套了一层可视化的壳,检测之后再用切分、拼接完成删除。
二、实测第一轮:默认参数,一帧没删
测试素材是一段 3 分 00.82 秒的真实 MP4(640×360,25fps,9.09 MB)。上传后保持全部默认参数:阈值 -45 dB、最短静音 0.5 秒、缓冲边距 0.1 秒,点击删除静音。
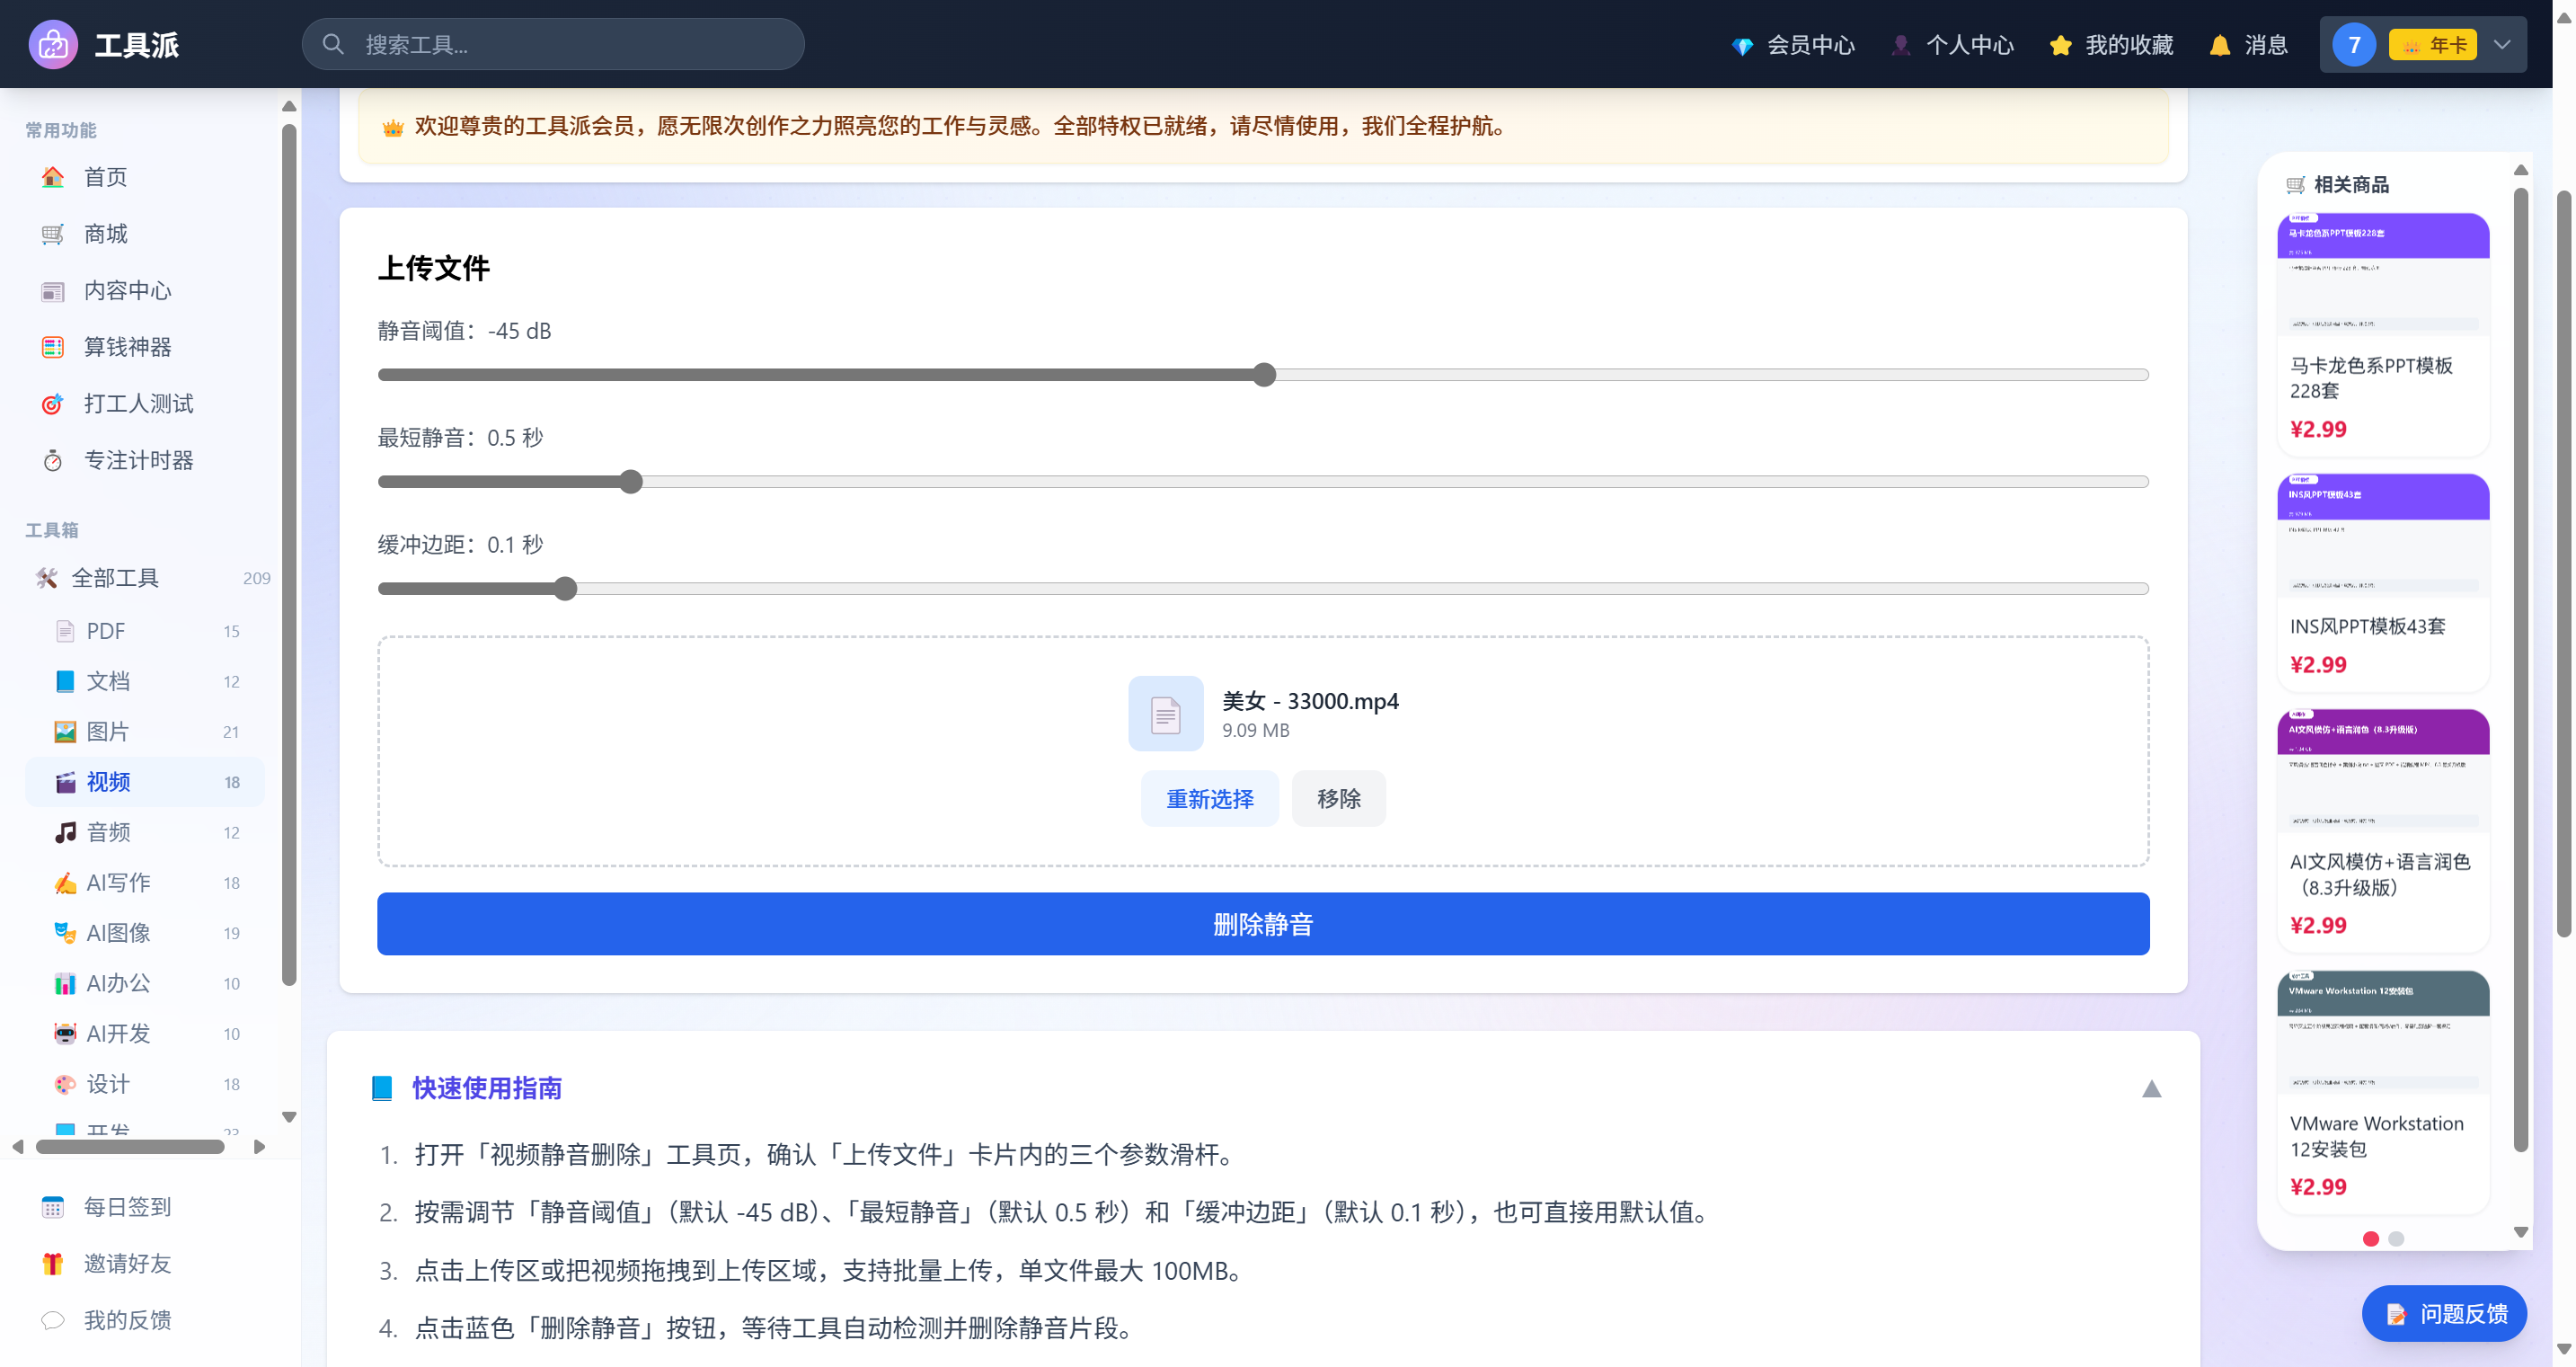
处理很快完成,输出文件名是 美女 - 33000_no_silence.mp4:
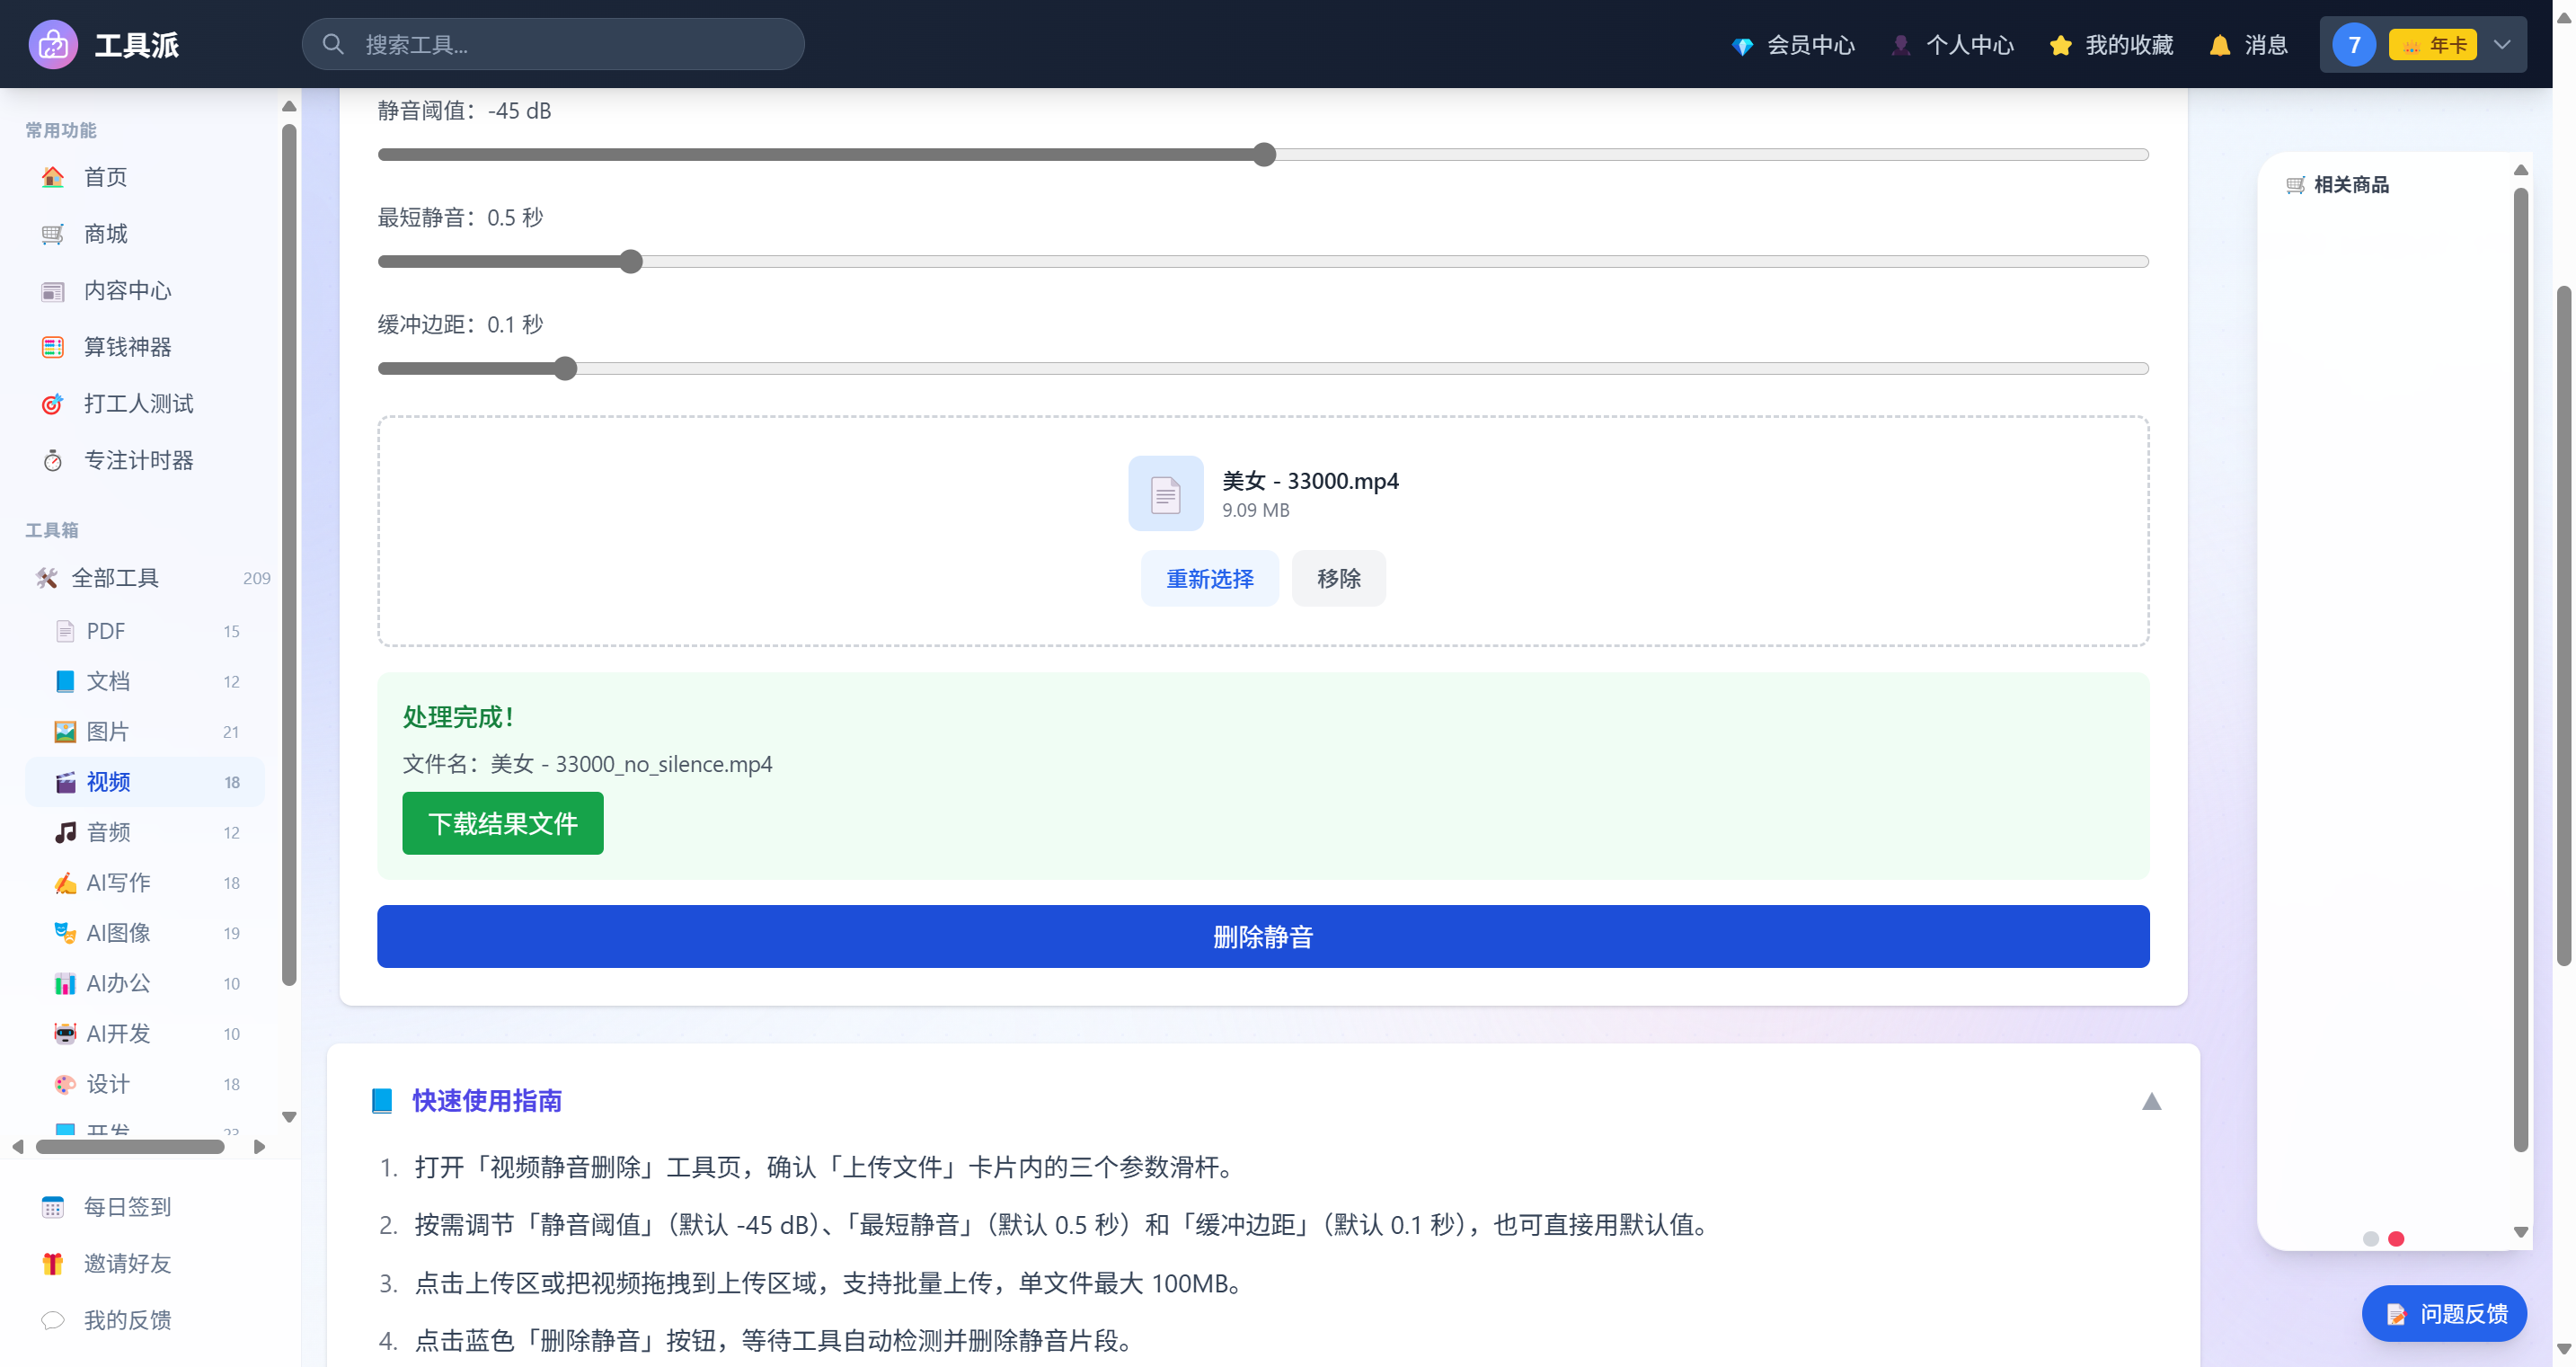
把输出下载回来用 ffprobe 一查,时长 3:00.86 ------和原始的 3:00.82 几乎一样,一段静音都没删(还多了 0.04 秒的封装误差)。
第一轮"看起来失败"的结果,恰恰是理解阈值逻辑的钥匙:这段素材是带背景音乐的录像,所谓"冷场"段落的底噪(音乐余音、环境声)在 -40 dB 上下,高于 -45 dB 的判定线。对检测器来说,这些段落全程"不算静音",自然无可删除。工具没有报错、没有提示"未检测到静音",只给了一个正常完成的输出------参数给错了,它就安静地什么也不做。
三、实测第二轮:抬高阈值到 -30 dB
先用 ffmpeg 的 silencedetect 交叉验证一下判断:noise=-30dB:d=1.0 跑一遍原始文件,检测到 2 段静音(约 114.6s~117.0s、117.6s~118.7s,合计约 3.47 秒)。说明 -30 dB 这条线在这段素材上能捞到东西。
回到工具里,把静音阈值滑杆从 -45 dB 调到 -30 dB,其余两个参数不动,重新处理:
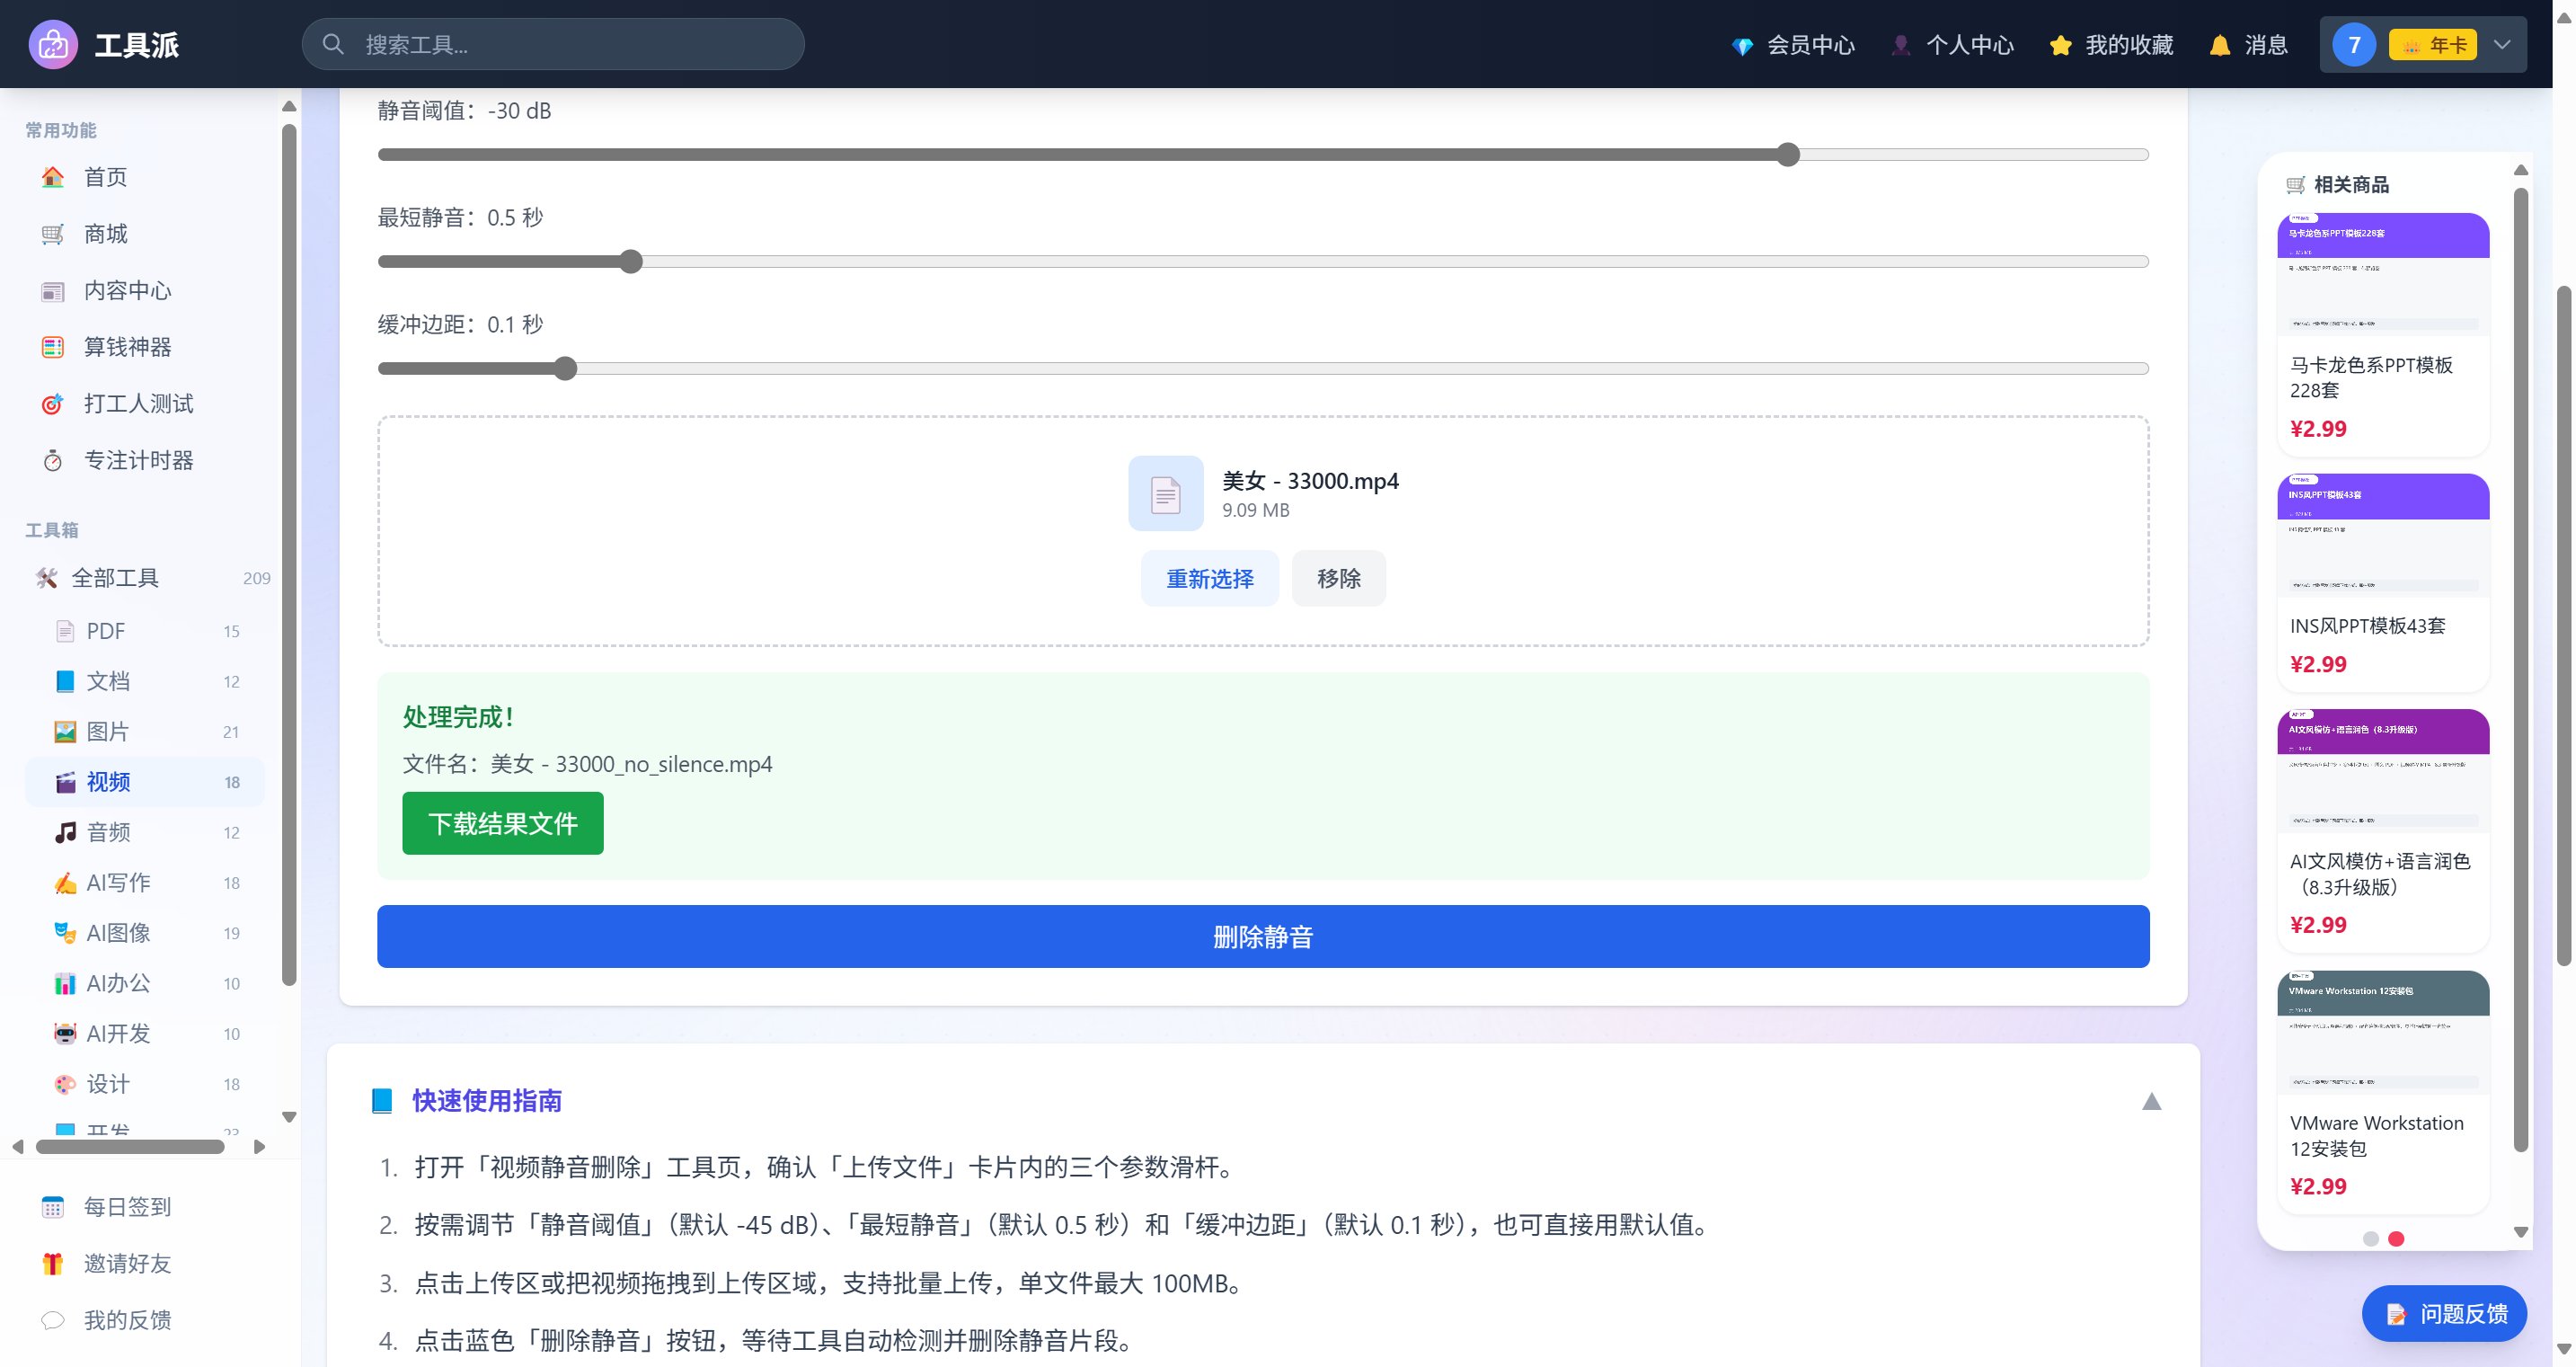
这次的处理完成输出,ffprobe 实测时长 2:57.94:
三轮数据放在一起:
| 项目 | 原始 | 第一轮(-45 dB) | 第二轮(-30 dB) |
|---|---|---|---|
| 输出时长 | 3:00.82 | 3:00.86 | 2:57.94 |
| 删除量 | --- | 0(无片段达标) | 2.88 秒(2 段) |
| 输出体积 | 9.09 MB | 13.84 MB* | 13.70 MB* |
*输出变大是因为删除后重新编码(视频流转 H.264 High、音频升到 128 kb/s),不影响时长结论;在意体积可以在压缩工具里二次处理。
2.88 秒比 silencedetect 测得的 3.47 秒少了约 0.6 秒,差在两处:缓冲边距在每个切口前后各留了 0.1 秒(4 个切口约 0.4 秒),加上工具对"最短静音"的计时口径与 d=1.0 的差异。数值对得上,逻辑闭环。
四、参数怎么调才不会"白跑一次"
把两轮实测的教训收敛成三条:
- 先确认底噪再定阈值:素材是安静房间录的口播,默认 -45 dB 大概率直接可用;带背景音乐、风扇声、环境噪声的录屏,底噪会盖过判定线,要往 -30 dB 甚至 -25 dB 方向抬。抬过头会把吐字偏轻的段落也剪掉;
- 切口太碎就调大最短静音:0.5 秒起步,剪出来 jump cut 太密集就往 1 秒调,保留自然停顿的节奏感;
- 字音被切就调大缓冲边距:默认 0.1 秒,发现句尾字被"咬掉"就加到 0.2~0.3 秒。
另外一个预期管理:这类工具删掉的是"整段无人声",它不认识"讲错了"和"冷场"的区别------讲错的废话音量是够的,还得靠手动剪。
小结
静音删除不是魔法,是"音量阈值 + 最短时长 + 边距余量"三个判定条件的组合。这次实测里,同一份素材默认参数一秒没删,阈值抬 15 dB 后删掉 2.88 秒------工具没变,变的是判定线和素材底噪的相对位置。跑之前先用 silencedetect 这类命令探一下底噪水位,一次就能把参数给对。
相关工具地址:gjupai.com