做过数据标注项目的人,应该都见过一种文件。
几十页Word,密密麻麻写着:
-
什么情况要标,什么情况不标;
-
遮挡多少算有效;边界到底贴到哪里;
-
连续帧怎么处理;特殊场景怎么判断。
名字一般叫《标注规范》《作业指导书》,或者干脆就叫SOP。
一个项目启动以后,项目经理先研究SOP,培训组长,组长再培训标注员,最后几百个人按照同一套规则干活。
过去十几年,数据标注公司的一个核心能力,其实就是:
把甲方写在Word里的规则,变成几百个人能够稳定执行的动作。
但最近看了一圈国内外的数据工具,我越来越觉得:
下一代数据标注SOP,可能不再是一份Word,而是一段Prompt。
一、数据标注最难的,从来不是"画框"
很多外行第一次接触数据标注,容易把它理解成:画框、打点、分类、转写。
其实真正做过项目的人都知道,最麻烦的从来不是鼠标怎么点。
最麻烦的是:什么叫"对"。
比如自动驾驶项目里有一句很常见的规则:严重遮挡的目标不标。看起来就几个字
但真正开始生产,问题马上来了。
遮挡30%算不算严重?
只露出半个车头标不标?
前两帧还能看到完整车辆,第三帧只剩一点尾灯,这一帧还要不要继续跟踪?
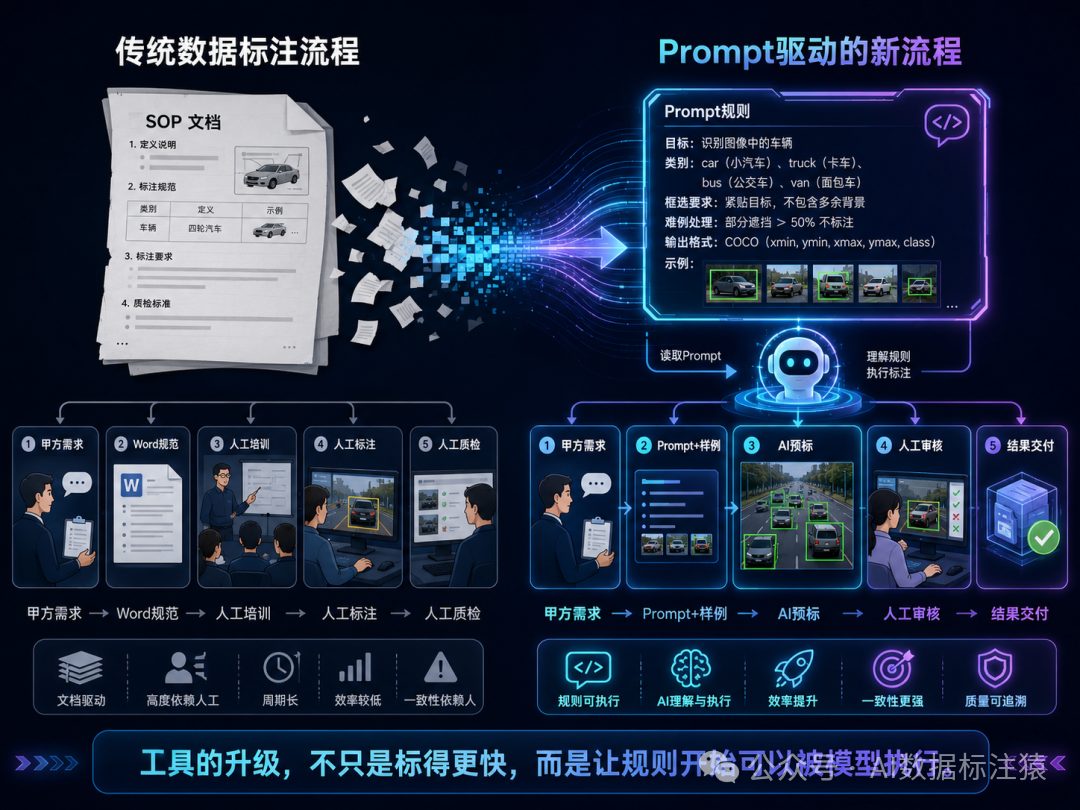
一个项目100个人,如果100个人对这句话有100种理解,最后返工的就不是一个框,而可能是几十万帧数据。
所以传统数据标注项目里,SOP真正承担的任务,是把一句模糊的业务语言,不断拆成:
规则、案例、边界条件、正例、反例。
最后让人统一理解。
而现在,这件事开始出现新的执行者:模型。
二、工具正在尝试让AI直接读懂规则
最近FiftyOne推出了一套很有意思的Agentic Labeling工作方式。
过去我们做自动标注,一般是什么流程?
先人工标一批数据。
再拿这批数据训练一个模型。
模型训练完成以后,再把剩余数据跑一遍预标。
人工最后修正。
这也是过去几年自动标注最常见的逻辑。
但现在VLM,也就是视觉语言模型,正在把这条链路继续压缩。
比如你有一批工厂图片。
你想标出:"表面出现明显裂纹,但正常纹理和轻微划痕不算缺陷。"
过去你可能要先写一份规范,再标几千张数据训练模型。
现在新的思路是:直接用自然语言告诉模型你想找什么。再给它几个正例:"这个是裂纹。"再给几个反例:"这个只是正常纹理,不算。"
模型先跑100张,发现错了,再修改Prompt。
比如补一句:"长度低于5毫米的浅表划痕不计入缺陷。"
再跑。
直到结果达到可以生产的程度。
这个变化特别值得数据标注公司注意。
因为它意味着:过去是人读SOP,然后执行规则。
未来越来越可能变成:模型读Prompt,先执行规则,人再处理例外
三、以后项目经理最重要的能力会变化
我一直认为,数据标注行业有一个被严重低估的岗位:项目经理。
很多人以为项目经理就是排产、催进度、管考勤。
实际上一个成熟的项目经理,最重要的能力之一,就是:把客户的业务语言翻译成生产规则。
甲方说:"这个目标不明显。"
项目经理要继续问:什么叫不明显?
甲方说:"明显错误需要剔除。"
项目经理还要问:什么程度算明显?
最后这些问题都会沉淀成SOP。
但如果未来越来越多规则交给模型执行,那么项目经理可能会多一项新的核心工作:
把业务规则翻译成Prompt。
而且这个Prompt,不是我们平时跟ChatGPT聊天那种随便写一句话。
真正用于数据生产的Prompt,可能至少包含:任务定义、正例、反例、边界案例、优先级、输出格式、验收逻辑。
本质上,它和今天的数据标注SOP并没有区别。
只是过去SOP的阅读者是人。
未来SOP的阅读者,很可能同时包括:人和模型
四、标注公司以后真正应该积累什么?
这也是我觉得这轮工具升级最值得关注的地方。
以前很多数据标注公司最喜欢展示一句话:"我们有500名成熟标注员。"甚至1000人、2000人。
在劳动密集型阶段,这确实是能力。
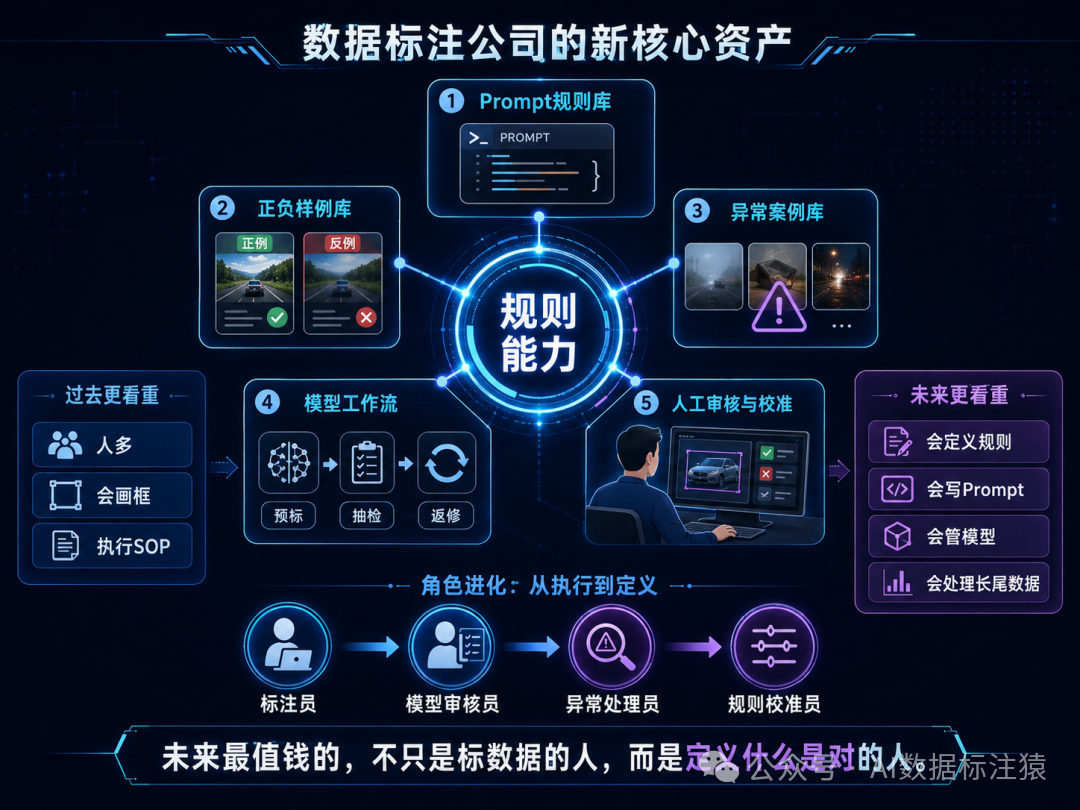
但下一阶段,一个数据公司的核心资产可能逐渐变成:
第一,Prompt规则库。
做过汽车、工业、零售、机器人项目以后,不断积累模型可执行的任务规则。
第二,正负样例库。
哪些属于正确,哪些属于错误,哪些属于边界情况。
这些东西对模型的价值,会越来越高。
第三,异常案例库。
真正让项目难交付的,从来不是80%的普通数据,而是那20%的长尾数据。
雨雪天、遮挡、反光、模糊、极端动作、异常姿态。
谁积累得多,谁的交付能力就强。
第四,模型工作流。
-
什么数据调用什么模型。
-
什么场景自动标。
-
什么场景必须人工。
-
什么时候抽检。
-
什么时候返修。
这才可能是未来真正的数据生产线。
所以你再看现在的一些标注工具,会发现一个很明显的趋势:
它们越来越不像"画框软件"。
而越来越像:模型工作台。
五、人工不会消失但干的事一定会变
每次聊自动标注,都会有人问:那以后是不是不需要标注员了?
我觉得这个问题问错了。
就像Excel出现以后,并没有让财务消失。只是大量重复计算不用再手工完成了。数据标注也是一样。
那些规则非常明确、模型已经能够稳定识别的工作,人工一定会越来越少。
但另外一些工作反而会越来越重要:
-
模型为什么判断错了?
-
这个边界案例到底应该怎么定义?
-
两个模型结果冲突怎么办?
-
新的业务场景应该增加什么规则?
-
客户今天改了一句话,会影响多少历史数据?
这些问题,机器短期内很难完全自己解决。
所以未来的数据标注员,可能越来越不像一个"操作员"。
而更像:模型审核员、异常处理员、规则校准员。
写在最后
十年前的数据标注工具解决的是:怎么让人标得更快。
后来解决的是:怎么让模型帮人预标。
而现在,下一代工具正在尝试解决一个更深的问题:
怎么把人的规则,直接变成模型能够执行的规则。
这才是我最近看这些工具更新以后,觉得最值得数据标注公司警惕的一件事。
因为未来数据公司的竞争,可能不再是谁有更多鼠标、更多电脑、更多人。
而是谁能够把一个客户模糊的需求,快速变成一套:
Prompt + 样例 + 模型 + 人工审核 + 验收标准
组成的数据生产流程。
到那个时候,真正值钱的SOP,可能真的不再躺在一个几十页的Word文档里。
它可能只是一段Prompt。
但这段Prompt背后,装着的是一家公司几年积累下来的行业经验。
我是AI数据标注猿。
跟着我,用数据视角看AI世界。