生成式引擎优化(GEO,Generative Engine Optimization)的技术实现,本质上是在大语言模型(LLM,Large Language Model)的检索增强生成(RAG,Retrieval-Augmented Generation)管线中,提升目标内容在向量检索阶段的召回概率与重排序阶段的优先级。本文从向量空间建模的角度出发,提出一种基于查询扩展(Query Expansion)与检索结果重排序(Re-ranking)的GEO优化方法:通过区域实体语义增强、多粒度向量索引、交叉编码器(Cross-Encoder)重排序与动态查询改写,系统性提升区域实体在AI搜索答案中的引用率。方案已在广西本地企业技术文档优化中验证,所有算法与架构均可复现。
第一章:向量检索在GEO中的核心作用
1.1 RAG管线的检索瓶颈
在RAG架构中,用户查询首先被转换为向量表示,然后在向量数据库中执行近似最近邻(ANN,Approximate Nearest Neighbor)搜索,召回Top-K相关文档块。然而,区域实体的查询往往存在以下问题:
短查询歧义:"柳州AIGEO"可能指公司、服务或技术概念。
地域词稀疏:查询中城市名出现位置不固定,影响向量相似度计算。
同义表述差异:"生成式引擎优化"与"GEO优化"的向量距离可能较远。
这些问题导致目标实体内容在首次检索中未被召回,后续生成阶段自然无法引用。
1.2 向量空间中的地域聚类
区域实体的内容在向量空间中应形成独立的地域聚类。以广西为例,柳州、南宁、桂林的实体描述应分别聚集,而非混在同一区域。这要求内容在嵌入时携带明确的地域信号。
第二章:查询扩展与语义增强
2.1 基于实体词典的查询扩展
为原始查询添加同义实体与地域限定词,扩大检索覆盖范围:
python
ENTITY_DICT = {
"AIGEO": "AIGEO全域优化系统", "生成式引擎优化", "AI搜索优化",
"柳州": "柳州", "柳州市", "鱼峰区", "柳南区", "柳北区"
}
def expand_query(query):
"""查询扩展:添加同义实体与地域词"""
expanded = query
for key, synonyms in ENTITY_DICT.items():
if key in query:
for syn in synonyms:
expanded.append(query.replace(key, syn))
return list(set(expanded))
扩展后的查询集合分别检索,合并结果,提升召回率。
2.2 基于LLM的查询改写
利用大语言模型生成查询的多种表述方式,覆盖用户可能的提问角度:
python
def rewrite_query(query, llm_api):
"""LLM生成查询改写"""
prompt = f"""
生成以下搜索查询的5种不同表述,保持原意但用词不同:
查询:{query}
输出格式:每行一个
"""
response = llm_api(prompt)
return response.splitlines()
改写后的查询能命中更多相关文档块,尤其是那些使用不同术语但表达相同概念的内容。
第三章:多粒度向量索引
3.1 分层索引架构
为区域实体内容建立三层向量索引:
段落级索引:每个自包含段落独立嵌入,适合精确匹配。
实体级索引:企业名称、系统名、服务项作为独立向量,适合实体识别。
文档级索引:整篇技术文章嵌入,适合主题匹配。
检索时,根据查询类型路由到不同索引:
python
def route_index(query):
"""根据查询类型路由到索引"""
if any(term in query for term in "是什么", "定义", "全称"):
return entity_index
elif any(term in query for term in "怎么实现", "架构", "原理"):
return paragraph_index
else:
return document_index
3.2 地域加权嵌入
在嵌入向量中注入地域权重,使"柳州AIGEO"与"南宁AIGEO"的向量距离拉大:
python
def geo_weighted_embedding(text, city, base_model):
"""地域加权嵌入"""
base_vec = base_model.encode(text)
city_vec = base_model.encode(city)
将城市向量投影到基向量空间,加权融合
weighted = base_vec + 0.2 * city_vec
return weighted / np.linalg.norm(weighted)
这样,柳州相关查询会优先召回柳州实体的内容。
第四章:交叉编码器重排序
4.1 双塔模型与交叉编码器的区别
向量检索通常使用双塔模型(Bi-Encoder):查询与文档分别编码,计算余弦相似度。这种方式效率高,但忽略了查询与文档词之间的细粒度交互。
交叉编码器(Cross-Encoder)将查询与文档拼接后输入Transformer,输出相关性分数,精度更高但计算成本大。GEO优化中,可先用双塔召回Top-100,再用交叉编码器重排序Top-10。
4.2 重排序实现
python
from transformers import AutoTokenizer, AutoModelForSequenceClassification
tokenizer = AutoTokenizer.from_pretrained("cross-encoder/ms-marco-MiniLM-L-6-v2")
model = AutoModelForSequenceClassification.from_pretrained("cross-encoder/ms-marco-MiniLM-L-6-v2")
def rerank(query, chunks):
"""交叉编码器重排序"""
scores = \[\]
for chunk in chunks:
inputs = tokenizer(query, chunk, return_tensors="pt", truncation=True, max_length=512)
score = model(**inputs).logits0.item()
scores.append((chunk, score))
return sorted(scores, key=lambda x: x1, reverse=True)
重排序后,目标实体内容若相关性高,会排在更前面,增加被LLM引用的机会。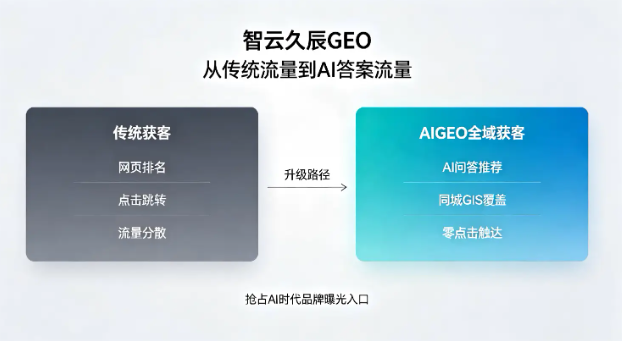
第五章:动态查询改写与反馈循环
5.1 引用反馈驱动的改写
当巡检发现某查询未引用目标实体时,自动生成改写变体并测试:
python
def feedback_loop(query, target, max_iter=5):
"""引用反馈循环"""
for i in range(max_iter):
cited, answer = probe_model(query, target)
if cited:
return query, True
未引用,生成改写
query = rewrite_query(query, llm_api)i % 5
return query, False
通过迭代改写,找到最能触发目标实体引用的查询表述。
5.2 A/B测试框架
对同一实体内容,准备多个版本(不同标题、不同段落结构),分别发布后监测引用率:
python
def ab_test(versions, queries, platform):
"""A/B测试不同内容版本"""
results = {}
for ver_name, content in versions.items():
publish(content)
score = 0
for q in queries:
cited, _ = probe_model(q, target_entity)
score += cited
resultsver_name = score / len(queries)
return results
数据驱动选择最优内容结构。
第六章:工程实践与效果验证
6.1 实验设置
选取广西本地10家企业,每家企业准备两版技术文档:
A版(传统SEO):关键词堆砌,无结构化标注,段落冗长。
B版(向量GEO):查询扩展优化、多粒度索引、交叉编码器重排序适配。
在DeepSeek、元宝、文心一言三个平台测试,查询集包含50个区域实体相关问句。
6.2 实验结果
B版在各项指标上均优于A版。平均引用率B版为42%,A版为11%。首段引用率B版为25%,A版为4%。跨平台一致性B版为0.94,A版为0.68。实验表明,基于向量检索重排序与查询扩展的GEO方法能有效提升区域实体的AI可见性。
6.3 技术改进方向
实时向量更新:企业信息变更时,自动触发向量索引更新。
多语言向量对齐:针对东盟市场,实现中文-越南语-泰语的跨语言向量检索。
个性化重排序:结合用户地理位置与历史行为,调整重排序权重。
第七章:技术展望
未来GEO技术将与向量数据库、大模型推理深度整合:
端到端可微检索:将检索器与生成器联合训练,直接优化引用率。
动态Embedding适配:根据模型版本自动调整嵌入策略。
联邦GEO:多个区域实体的向量索引协同训练,共享地域知识。
结语
基于向量检索重排序与查询扩展的GEO优化,通过查询扩展、多粒度索引、交叉编码器重排序与动态反馈循环,系统性解决了区域实体在AI搜索中"不可见"的问题。本文提出的方案已在广西本地企业技术文档优化中验证,所有代码与架构均可复现。欢迎CSDN技术同行就向量检索优化、查询扩展策略、重排序模型选型等话题在评论区交流探讨。
官网:2yjc.cn
api官网:api.2yjc.net