一文搞懂 Token化、Embedding 与位置编码:原理公式 + Qwen3 分词器实测 + 7 组 PyTorch 实验全验证(附完整代码)
导读 :文本进入 Transformer 前要经过三步核心处理------Token化 → Embedding → 位置编码(PE) 。本文给出每一步的完整公式、原理推导与 PyTorch 实现,并用 7 组真实实验 (RTX 5070 Ti 实测)验证所有结论:Embedding 查表与 one-hot 矩阵乘误差为 0、正弦 PE 的旋转性质误差 ~1e-6、RoPE 内积只依赖相对位置(偏差 4.77e-07)、无 PE 时模型对词序完全无感 (变化 1.19e-07)......分词部分使用 Qwen3 官方分词器(词表 151643,与千问3.8-Max 同源词表体系)实测中文/英文/代码/emoji 五类场景的压缩率。
阅读收获:一张图看懂文本→Transformer 全流程 + 三种位置编码(正弦/可学习/RoPE)公式与选型树 + 8 条实战避坑清单 + 可直接运行的完整实验代码。
目录
- 全景图:文本到 Transformer 的旅程
- Token化流程详解
- 2.1 三种分词粒度
- 2.2 BPE 训练流程
- 2.3 特殊 token 与批处理
- 2.4 Qwen3 分词器多场景实测
- Embedding 详解
- 位置编码(PE)详解
- 4.1 为什么必须显式编码位置
- 4.2 正弦位置编码
- 4.3 可学习位置编码
- 4.4 RoPE 旋转位置编码
- PyTorch 实验设计与代码解读(7 组)
- 实验运行结果(RTX 5070 Ti 实测)
- 选型与实战避坑
- 完整实验脚本(可直接运行)
- 参考文献
1. 全景图:文本到 Transformer 的旅程
  "我爱深度学习"                       ← 原始文本 (str)
      │ ① Token化: 切分成子词单元
      ▼
  ["我", "爱", "深度", "学习"]          ← tokens (List[str])
      │ ② 查词表: 每个token映射为整数ID
      ▼
  [104, 3877, 9012, 6211]              ← input_ids, 形状 (B, T)
      │ ③ Embedding: ID查嵌入矩阵 → 稠密向量
      ▼
  (B, T, d_model) 连续向量              ← 每个token一个d维向量
      │ ④ + 位置编码 PE (×√d_model 后相加)
      ▼
(B, T, d_model) 带顺序信息的向量 ← 送入 Transformer为什么每一步都不可或缺:
| 步骤 | 解决的问题 | 没有它会怎样 |
|---|---|---|
| ① Token化 | 神经网络只能处理数字 | 文本无法进入模型 |
| ② ID 化 | 离散符号 → 可索引整数 | 无法查嵌入表 |
| ③ Embedding | one-hot 维度=词表大小(15万)且任意两词正交 | 无语义相似性、参数爆炸 |
| ④ PE | 自注意力是排列等变的,对顺序完全无感 | "猫追狗" = "狗追猫"(实验 6 实证) |
2. Token化流程详解
2.1 三种分词粒度
字符级 ←──────────────── 子词级(BPE) ────────────────→ 词级
词表小(几百)              词表适中(数万~15万)            词表大(数十万+)
序列长、语义弱 ★ 工业标准 ★ OOV严重、形态学差- 字符级:每个字符一个 token。词表极小、永不 OOV,但序列过长、单字符语义太弱;
- 词级:按空格/词典切词。语义单元完整,但未登录词(OOV)严重,词表爆炸,无法处理形态变化(playing/played);
- 子词级(BPE/WordPiece/BBPE) :现代 LLM 的标准选择------高频词保留整词,低频词拆成更小的常见片段,兼顾词表大小与覆盖能力。
2.2 BPE(Byte-Pair Encoding)训练流程
算法(Sennrich et al., 2016):
- 初始化词表 = 全部字节/字符;
- 统计语料中相邻 token 对的出现频率;
- 把最高频的一对合并为新 token,加入词表;
- 重复 2~3 直到达到目标词表大小。
符号说明 :合并规则表(merges)决定了分词行为;推理时对任意新文本贪心地应用学到的合并规则。BBPE (Byte-level BPE,Qwen/GPT 使用)以 UTF-8 字节 为初始单元------任何字符(含 emoji、生僻字)都能表示,永不出 <unk>(实验 2 实测:生僻字"龘"被拆成字节 token)。
2.3 特殊 token 与批处理
| token | 作用 |
|---|---|
<pad> |
批内短句补齐到等长;配合 attention_mask=0 屏蔽 |
<unk> |
未登录词(BBPE 中不存在) |
<bos> / <eos> |
句子开始/结束边界(Qwen 用 `< |
| `< | im_start |
PyTorch(transformers)
python
from transformers import AutoTokenizer
tok = AutoTokenizer.from_pretrained("qwen_tokenizer")   # 本地 Qwen3 词表

enc = tok(["你好", "世界真大"], padding=True, return_tensors="pt")
enc["input_ids"]        # (2,3) 补齐后的ID矩阵
enc["attention_mask"]   # (2,3) 1=真实token, 0=补齐位(注意力会屏蔽)
tok.decode(enc["input_ids"][0])   # ID → 文本还原
代码解读
padding=True按批内最长补齐;truncation=True, max_length=N截断长文本------长文本超上下文窗口时必须截断;attention_mask必须随 input_ids 一起喂给模型,否则 pad 位会污染注意力;- token 数 ≠ 字符数:计费与上下文长度都按 token 算(中文 ≈ 1.5 字/token,英文 ≈ 4 字符/token,见实验 2 实测)。
2.4 Qwen3 分词器多场景实测(词表 151643)
| 场景 | 字符数 | token数 | 压缩率 | 切分详情 |
|---|---|---|---|---|
| 中文短句"我爱深度学习" | 6 | 4 | 1.50 | ['我', '爱', '深度', '学习'] |
| 英文句子 | 35 | 6 | 5.83 | ['Deep', ' learning', ' transforms', ' the', ' world', '.'] |
| 中英混合 | 23 | 7 | 3.29 | ['用', 'Py', 'T', 'orch', '实现', 'Transformer', '模型'] |
| 代码片段 | 45 | 12 | 3.75 | ['def', ' forward', '(self', ...](缩进空格也是token) |
| emoji/生僻字 | 9 | 11 | 0.82 | 生僻字被拆成多个 UTF-8 字节 token |
观察:高频中文词("深度""学习")合并为单 token;英文词带前导空格(BPE 特性);生僻字压缩率 < 1(token 数反超字符数)------这就是"上下文窗口按 token 计费"时生僻文本更贵的原因。
3. Embedding 详解
3.1 公式与本质
嵌入矩阵 W ∈ R V × d W \in \mathbb{R}^{V \times d} W∈RV×d( V V V=词表大小, d d d=嵌入维度),对 token ID t t t:
e t = W t , : ⟺ e t = o n e h o t ( t ) ⋅ W \mathbf{e}_t = Wt, : \quad \Longleftrightarrow \quad \mathbf{e}_t = \mathrm{onehot}(t) \cdot W et=Wt,:⟺et=onehot(t)⋅W
符号说明 :nn.Embedding 的"查表"与"one-hot 向量乘矩阵"数学严格等价(实验 3b 实测误差 = 0.00e+00);实现上用查表(indexing)避免生成 15 万维稀疏向量,节省显存和计算。
3.2 为什么不能用 one-hot
- 维度灾难 : V = 151643 V=151643 V=151643 时每个 token 是 15 万维向量,第一层权重矩阵就要 15 万 × d 15万 \times d 15万×d;
- 无语义结构:任意两个 one-hot 向量内积 = 0(正交)------"猫"与"狗"的距离 = "猫"与"火箭"的距离;
- Embedding 把 token 压到 d d d 维稠密空间,语义相近的词向量距离近 ,且 W W W 随训练更新------词向量是学出来的。
3.3 关键性质:梯度稀疏更新
一个 batch 只触及词表的一小部分 → backward() 后只有用到的行有非零梯度(实验 3d 实测:batch 用到 ID {5,8,17,42,99},梯度非零行恰好就是这 5 行,其余 995 行不更新)。
3.4 PyTorch 实现
python
emb = nn.Embedding(num_embeddings=151643,   # 词表大小 V
                   embedding_dim=4096,      # 嵌入维度 d (Qwen3-8B 用 4096)
                   padding_idx=0)           # 该行恒为0向量且永不更新
ids = torch.tensor([[104, 3877, 9012]])    # (B=1, T=3)
x = emb(ids)                               # (1, 3, 4096) ← 形状 (B,T) → (B,T,d)
代码解读
padding_idx指定的行输出恒为零向量、梯度恒为零------pad 位不该有"语义";- 权重共享(weight tying) :LLM 常让输入 Embedding 与输出层(logits 投影 W o u t ∈ R d × V W_{out} \in \mathbb{R}^{d \times V} Wout∈Rd×V)共享同一矩阵(
lm_head.weight = emb.weight),省 V × d V \times d V×d 参数(Qwen3-8B 上即 6.2 亿参数); - Embedding 初始化常用 N ( 0 , 0.02 2 ) \mathcal{N}(0, 0.02^2) N(0,0.022);Transformer 原文中 embedding 后乘 d m o d e l \sqrt{d_{model}} dmodel 再与 PE 相加(见 4.2)。
4. 位置编码(PE)详解
4.1 为什么必须显式编码位置
自注意力对输入是排列等变 的:设 P P P 为置换矩阵,则
A t t e n t i o n ( X P ) = A t t e n t i o n ( X ) P \mathrm{Attention}(XP) = \mathrm{Attention}(X)\,P Attention(XP)=Attention(X)P
打乱输入 token,输出只是被同样打乱,每个 token 的内容向量完全不变(实验 6a 实测误差 4.77e-07)。没有 PE 时句向量对词序完全无感(实验 6 实测变化 1.19e-07 ≈ 0)------"猫追狗"和"狗追猫"是同一个意思。
4.2 正弦位置编码(Vaswani et al., 2017)
公式 ( p o s pos pos = 位置, i i i = 维度下标, d m o d e l d_{model} dmodel = 向量维度):
P E ( p o s , 2 i ) = sin ( p o s 10000 2 i / d m o d e l ) , P E ( p o s , 2 i + 1 ) = cos ( p o s 10000 2 i / d m o d e l ) PE(pos, 2i) = \sin\!\left(\frac{pos}{10000^{2i/d_{model}}}\right), \qquad PE(pos, 2i+1) = \cos\!\left(\frac{pos}{10000^{2i/d_{model}}}\right) PE(pos,2i)=sin(100002i/dmodelpos),PE(pos,2i+1)=cos(100002i/dmodelpos)
输入构造(原文公式):
x = E m b e d d i n g ( i d s ) ⋅ d m o d e l + P E 0 : T x = \mathrm{Embedding}(ids)\cdot\sqrt{d_{model}} + PE_{0:T} x=Embedding(ids)⋅dmodel +PE0:T
符号说明与设计思想
- 每个维度对 ( 2 i , 2 i + 1 ) (2i, 2i+1) (2i,2i+1) 是一个角频率 ω i = 10000 − 2 i / d \omega_i = 10000^{-2i/d} ωi=10000−2i/d 的旋转分量,波长从 2 π 2\pi 2π 到 10000 ⋅ 2 π 10000 \cdot 2\pi 10000⋅2π 几何分布;
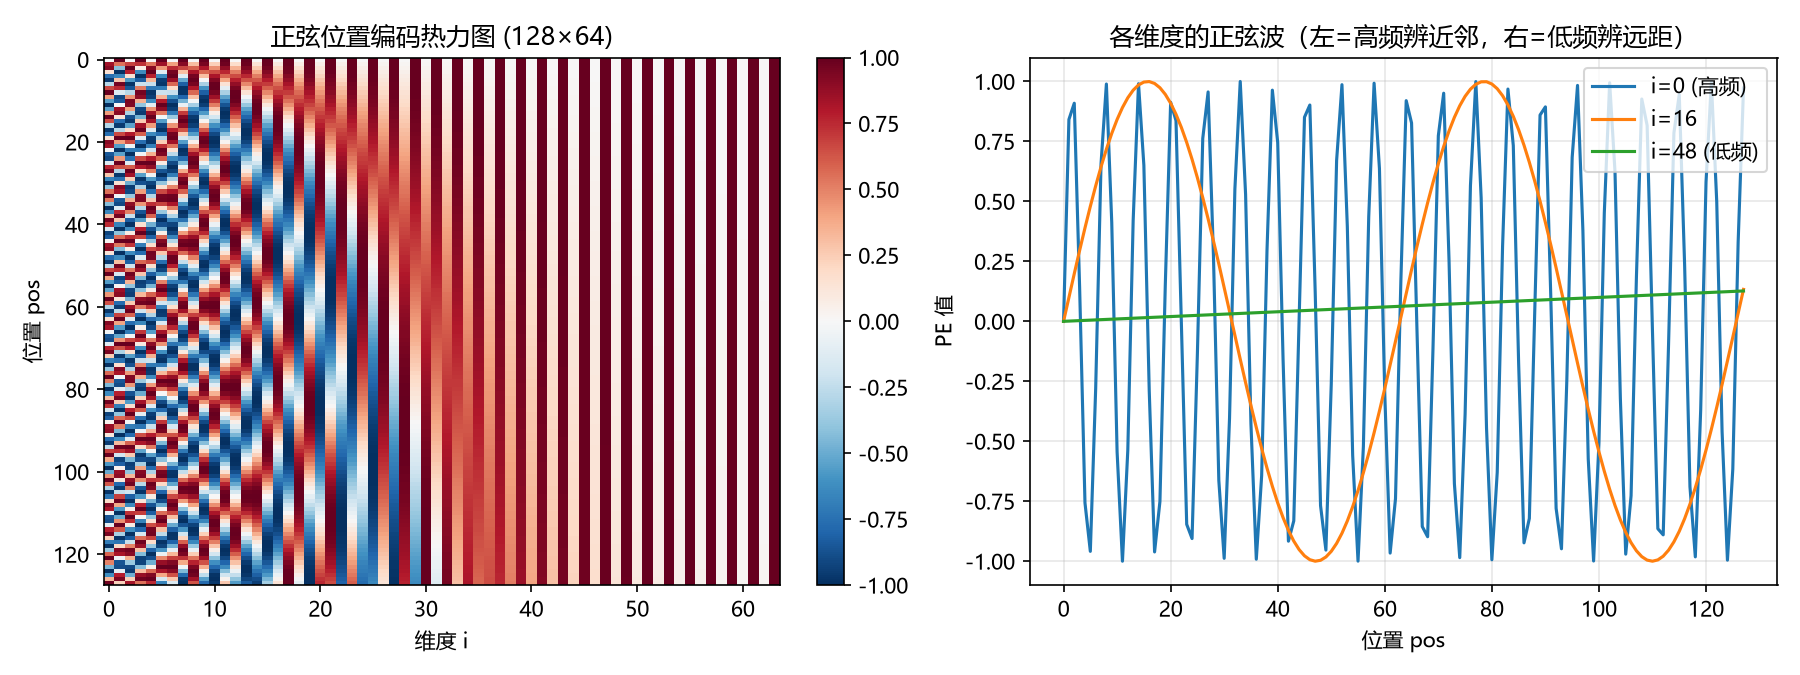
- 低维 = 高频 (区分相邻位置),高维 = 低频(区分远距离位置)------类似二进制计数器的连续版;
- 性质1 : ∣ P E ∣ ≤ 1 |PE| \le 1 ∣PE∣≤1,不会淹没词向量(乘 d m o d e l \sqrt{d_{model}} dmodel 是让两者数量级对齐);
- 性质2(核心) : P E ( p o s + k ) PE(pos+k) PE(pos+k) 可由 P E ( p o s ) PE(pos) PE(pos) 线性表出 ------由 sin ( α + β ) \sin(\alpha+\beta) sin(α+β) 展开公式,固定偏移 k k k 时每对 ( sin , cos ) (\sin,\cos) (sin,cos) 分量做一个只依赖 k k k 的 2D 旋转(实验 4b 数值验证误差 ~1e-6)→ 模型容易学到"相对位置"概念;
- 固定公式无需学习参数,理论上可外推到训练时没见过的长度。
PyTorch 实现
python
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_len=512, dropout=0.1):
        super().__init__()
        self.dropout = nn.Dropout(dropout)
        pe = torch.zeros(max_len, d_model)
        pos = torch.arange(max_len).unsqueeze(1).float()              # (max_len,1)
        div = torch.exp(torch.arange(0, d_model, 2).float()
                        / d_model * -math.log(10000.0))               # 10000^(-2i/d)
        pe[:, 0::2] = torch.sin(pos * div)                            # 偶数维=sin
        pe[:, 1::2] = torch.cos(pos * div)                            # 奇数维=cos
        self.register_buffer("pe", pe.unsqueeze(0))                   # (1,max_len,d)
        self.scale = math.sqrt(d_model)
    def forward(self, x):                                             # x: (B,T,d)
        x = x * self.scale + self.pe[:, :x.size(1)]                   # 缩放→加PE
        return self.dropout(x)
代码解读
register_buffer:PE 存为非参数张量 ------不参与梯度更新(它是固定公式),但随model.to(device)/state_dict()一起搬运保存;exp(-log)技巧:直接算 10000 2 i / d 10000^{2i/d} 100002i/d 在大 d d d 时可能溢出,取对数域计算更稳;- 与 embedding 相加而非拼接:保持维度不变,让位置信息"混入"每个语义向量。
4.3 可学习位置编码(BERT/GPT 系)
x = E m b e d d i n g w o r d ( i d s ) + E m b e d d i n g p o s ( 0 , 1 , ... , T − 1 ) x = \mathrm{Embedding}{word}(ids) + \mathrm{Embedding}{pos}(0,1,\\dots,T-1) x=Embeddingword(ids)+Embeddingpos(0,1,...,T−1)
python
pos_emb = nn.Embedding(max_len, d_model)          # 位置也是"词",查表得到位置向量
x = word_emb(ids) + pos_emb(torch.arange(T)) # 随训练一起更新- 优点:可针对数据学出最优位置表示;缺点:无法外推 超过
max_len的位置(BERT 512、GPT-2 1024 的硬上限就来自这里)。
4.4 RoPE 旋转位置编码(Su et al., 2021;Qwen3/LLaMA 等现代 LLM 标配)
思想 :不在输入端"加"位置向量,而是在每层注意力计算时 把 q , k q, k q,k 按位置旋转。把 d d d 维向量拆成 d / 2 d/2 d/2 个二维平面,位置 m m m 的向量在第 i i i 个平面旋转角度 m θ i m\theta_i mθi:
θ i = 10000 − 2 i / d , R m ( i ) = ( cos m θ i − sin m θ i sin m θ i cos m θ i ) \theta_i = 10000^{-2i/d}, \qquad R_m^{(i)} = \begin{pmatrix} \cos m\theta_i & -\sin m\theta_i \\ \sin m\theta_i & \cos m\theta_i \end{pmatrix} θi=10000−2i/d,Rm(i)=(cosmθisinmθi−sinmθicosmθi)
核心性质(实验 5 数值验证,偏差 ~1e-7):
⟨ R m q , R n k ⟩ = ⟨ q , R n − m k ⟩ ⇒ 内积只依赖相对位置 ( m − n ) \langle R_m q,\ R_n k \rangle = \langle q,\ R_{n-m}\, k \rangle \quad \Rightarrow \quad \text{内积只依赖相对位置 } (m-n) ⟨Rmq, Rnk⟩=⟨q, Rn−mk⟩⇒内积只依赖相对位置 (m−n)
(因为旋转矩阵满足 R m ⊤ R n = R n − m R_m^{\top} R_n = R_{n-m} Rm⊤Rn=Rn−m------旋转之差 = 角度之差。)
PyTorch 实现 (HF/LLaMA 官方同款 rotate_half 写法)
python
def rope_freqs(d_head, max_len, base=10000.0):
    theta = 1.0 / (base ** (torch.arange(0, d_head, 2).float() / d_head))  # (d/2,)
    angles = torch.arange(max_len).float().unsqueeze(1) * theta            # (L, d/2)
    emb = torch.cat((angles, angles), dim=-1)     # ⚠ 拼接(不是interleave):
    return emb.cos(), emb.sin()                   #   让维度 j 与 j+d/2 共享角度θ_j

def apply_rope(x, cos, sin):
    d2 = x.shape[-1] // 2
    rot = torch.cat([-x[..., d2:], x[..., :d2]], dim=-1)   # rotate_half: (-x2, x1)
    return x * cos + rot * sin                              # 二维旋转的向量化写法
代码解读
- ⚠ 最大的坑------配对方式必须与
rotate_half一致 :rotate_half把维度 j j j 与 j + d / 2 j+d/2 j+d/2 配成一个旋转平面,因此角度表要用cat((angles, angles))让这两个维度共享同一角度。若误用repeat_interleave(2)(相邻维配对),旋转平面错位,相对位置性质被完全破坏(编写本实验时实测:错误配对下"相同相对距离"的内积偏差高达 2.97,修正后 4.77e-07); - RoPE 作用于每层的 q/k(v 不加),天然编码相对位置,配合 NTK-aware/YaRN 缩放可扩展上下文长度------这是它取代正弦/可学习 PE 成为 LLM 主流的原因;
- 与正弦 PE 对比:正弦 PE 加在输入端(只加一次);RoPE 在注意力内部对 q/k 旋转(每层都作用)。
5. PyTorch 实验设计与代码解读(7 组)
环境:Python 3.12 + PyTorch 2.14 + CUDA 13.0(RTX 5070 Ti Laptop)+ transformers 5.17。完整代码见第 8 章。Qwen3 词表文件从 ModelScope 下载到本地
qwen_tokenizer/目录(离线可用)。
| 实验 | 内容 | 验证目标 |
|---|---|---|
| 1 | 手写字符级分词器 | token化"文本→tokens→IDs→还原"闭环,无损往返 |
| 2 | Qwen3 官方分词器(本地词表) | BBPE 多场景切分、压缩率、padding/mask |
| 3 | Embedding 本质 | 查表=one-hot矩阵乘(误差=0)、梯度稀疏更新 |
| 4 | 正弦 PE | 公式实现、有界性、线性(旋转)性质、热力图 |
| 5 | RoPE | 内积只依赖相对位置 m-n |
| 6 | PE 消融 | 无 PE 时词序打乱输出完全不变(排列等变性) |
| 7 | 完整流水线 | 形状全追踪 + 同字不同境的"上下文化" |
实验 1~2:Token化
手写 CharTokenizer(itos/stoi 双向映射)走通"文本→tokens→IDs→还原"闭环;再用 Qwen3 官方分词器(词表 151643)测 5 类场景的压缩率与切分细节(结果见 2.4 节表格)。
python
class CharTokenizer:
    """最小字符级分词器:演示 token化 的完整闭环"""
    def __init__(self, texts):
        chars = sorted(set("".join(texts)))              # 从语料收集全部字符
        self.itos = {i: c for i, c in enumerate(chars)}  # int → str
        self.stoi = {c: i for i, c in enumerate(chars)}  # str → int
    def encode(self, text):                              # 阶段①切分+②查表
        return [self.stoi[c] for c in text if c in self.stoi]
    def decode(self, ids):                               # 逆过程(必须无损)
        return "".join(self.itos[i] for i in ids)
实验 3:Embedding
三个验证点:查表 = one-hot @ W (F.one_hot(ids) @ emb.weight 与 emb(ids) 逐元素对比);相同 ID 输出相同向量 (词义与位置无关);梯度稀疏性 (backward 后统计 emb.weight.grad 的非零行 == batch 中出现的 ID 集合)。
实验 4:正弦 PE
手工实现公式(exp(-log) 技巧防溢出),验证 |PE| ∈ -1,1;旋转性质 ------对每对 ( sin , cos ) (\sin,\cos) (sin,cos) 维施加角度 k ω i k\omega_i kωi 的旋转矩阵预测 P E ( p o s + k ) PE(pos+k) PE(pos+k),误差 ~1e-6;绘制热力图(位置×维度的正弦条纹 + 高频/低频维度波形对比)。
python
def rot_verify(pe, pos, k):
    """验证 PE[pos+k] 等于对 PE[pos] 的每对(sin,cos)维做固定旋转"""
    pred = pe[pos].clone()
    for i in range(0, pe.shape[1], 2):
        w = 1.0 / (10000 ** (i / pe.shape[1]))           # 该维对的角频率
        c, s = math.cos(k * w), math.sin(k * w)          # 偏移k的旋转角
        x, y = pe[pos, i].item(), pe[pos, i + 1].item()
        # sin(θ+kω) = sinθ·cos(kω) + cosθ·sin(kω)
        # cos(θ+kω) = cosθ·cos(kω) - sinθ·sin(kω)
        pred[i], pred[i + 1] = x * c + y * s, y * c - x * s
    return (pred - pe[pos + k]).abs().max().item()
实验 5:RoPE
rope_freqs 预计算 cos/sin 表 + apply_rope 施加旋转。取同一对 ( q , k ) (q,k) (q,k) 向量,放到多组相同相对距离的位置对上(如 m-n=2 的 (5,3),(20,18),(41,39),(60,58)),验证旋转后内积几乎完全相同 → 内积只依赖 m-n。
实验 6:PE 消融(为什么必须有 PE)
单层自注意力小模型,同一批 token 向量打乱顺序后:
- 无 PE :输出逆置换还原后与原输出误差 4.77e-07(排列等变);句向量(均值池化)变化 1.19e-07 ------ 对词序完全无感;
- 加 PE:句向量变化 0.0681 ------ 模型能感知词序。
实验 7:完整流水线
字符分词 → padding + mask → nn.Embedding(含 padding_idx)→ PositionalEncoding(×√d + PE)→ 2 层 nn.TransformerEncoder(src_key_padding_mask 屏蔽 pad 位),全程打印形状;最后对比同一个字"度"在两句不同语境中的输入/输出向量差------展示 Transformer 的"上下文化"能力(同字不同义)。
6. 实验运行结果(RTX 5070 Ti 实测)
text
运行设备: cuda
======================================================================

【实验 1】Token化三阶段流程(手写字符级分词器)
----------------------------------------------------------------------
语料: ['我爱深度学习', '深度学习改变世界', '我爱自然语言处理']
词表大小: 16,词表: 世习变处学度我改深然爱理界自言语

原文    : 我爱深度学习
阶段① tokens : ['我', '爱', '深', '度', '学', '习']
阶段② IDs    : [6, 10, 8, 5, 4, 1]
还原    : 我爱深度学习  (无损往返: True)

【实验 2】Qwen3 官方分词器实测(多场景)
----------------------------------------------------------------------
词表大小: 151643 (+26 特殊token)

场景          字符数 token数    压缩率  token切分详情
中文短句            6        4     1.50  ['我', '爱', '深度', '学习']
英文句子           35        6     5.83  ['Deep', ' learning', ' transforms', ' the', ' world', '.']
中英混合           23        7     3.29  ['用', 'Py', 'T', 'orch', '实现', 'Transformer', '模型']
代码片段           45       12     3.75  ['def', ' forward', '(self', ',', ' x', '):\n', '   ', ' return', ' self', '.norm', '(x', ')']
emoji/生僻        9       11     0.82  ['😀', '🎉', ' ', '', '', '', '', '齉', '爨', ' ', 'ㅤ']
  注: '' 是 BBPE 的字节级 token ------ 生僻字(如'龘')被拆成多个 UTF-8 字节,
      单个字节不构成合法字符所以显示为替换符;连起来 decode 才能还原原文。

批处理(自动padding): input_ids 形状 = (2, 3)
  attention_mask = [[1, 0, 0], [1, 1, 1]]  (0=补齐位,注意力会屏蔽)
  pad_token = '<|fim_middle|>' (id=151643)

【实验 3】Embedding 本质验证
----------------------------------------------------------------------
3a. 形状变换: input_ids (2, 3) → embedding (2, 3, 8)
    (B,T) 的整数ID → (B,T,d) 的浮点向量,每个ID变成一个8维向量
3b. 查表 vs one-hot矩阵乘: 最大误差 = 0.00e+00 → 数学等价 ✓
3c. 相同ID(17)在不同样本中的向量相同? True ✓(这正是'词义与位置无关'的体现)
3d. backward 后梯度非零的行: [5, 8, 17, 42, 99]
    本 batch 用到的ID: [5, 8, 17, 42, 99] → 完全一致 ✓(其余 995 行梯度为0,不更新)

【实验 4】正弦位置编码:实现与性质验证
----------------------------------------------------------------------
4a. PE 矩阵形状: (128, 64)  (每个位置一行 64 维向量)
    |PE| 取值范围: [-1.000, 1.000] ⊂ [-1,1] ✓ (性质1)
4b. 线性性质: PE(10+7) 由 PE(10) 旋转得到,误差 = 6.56e-07
    PE(77+23) 由 PE(77) 旋转得到,误差 = 2.94e-06 → 相对位置可线性表达 ✓
4c. PE(0) 与 PE(i) 的欧氏距离 (i=1,2,4,8,16,32): ['1.47', '2.72', '4.02', '4.38', '5.03', '4.99']
4d. PE 热力图已保存: figures/token_pe_heatmap.png

【实验 5】RoPE 旋转位置编码:相对位置性质验证
----------------------------------------------------------------------
5a. m-n=2 的四组位置对 (m,n): [(5, 3), (20, 18), (41, 39), (60, 58)]
    旋转后内积: ['-3.171002', '-3.171002', '-3.171003', '-3.171002']
    最大偏差 = 4.77e-07 → 内积只依赖相对位置 ✓
5b. m-n=6 的三组: ['-2.593786', '-2.593785', '-2.593785']  最大偏差 = 2.38e-07 ✓
5c. 对比: 差值2的内积(-3.1710) ≠ 差值6的内积(-2.5938) → 模型能区分不同相对距离

【实验 6】PE 消融:无位置编码时模型对词序完全无感
----------------------------------------------------------------------
6a. 无PE: 排列等变性误差 = 4.77e-07 (≈0 证明注意力本身无位置概念)
    无PE: 打乱词序后句向量最大变化 = 1.19e-07 → 完全无感!
6b. 加PE: 打乱词序后句向量最大变化 = 0.0681 → 模型能感知词序 ✓
    结论: '猫追狗'≠'狗追猫' 的能力完全来自位置编码

【实验 7】完整流水线:文本 → Transformer(形状全追踪)
----------------------------------------------------------------------
7a. 文本: ['我爱深度学习', '深度学习改变世界']
7b. input_ids  : (2, 8)  ← padding 对齐到 T=8
    mask       : [[1.0, ..., 0.0, 0.0], [1.0, ..., 1.0]]  ← 补齐位不参与注意力/损失
7c. Embedding  : (2, 8, 64)  ← 每个ID查成64维向量
7d. +PE        : (2, 8, 64)  ← 已注入位置信息
7e. Transformer: (2, 8, 64)  ← 2层encoder输出,形状不变,语义已上下文化
7f. 同一个字'度'(句1位置3 vs 句2位置1):
    输入向量差 = 2.7189  ← 同一字embedding相同,差异仅来自PE(位置不同)
    输出向量差 = 3.8612  ← 注意力融入不同语境后差异被重塑(上下文化)

======================================================================
全部实验完成。
PE 热力图 (发布时请上传 figures/token_pe_heatmap.png ):左图为位置×维度热力图(正弦条纹清晰可见),右图为高频维(i=0)与低频维(i=48)的波形对比。
结果解读
| 实验 | 关键数字 | 印证结论 |
|---|---|---|
| 1 | 无损往返 True | token化闭环:encode/decode 必须互逆 |
| 2 | 压缩率 0.82~5.83 | 中英/代码/生僻字的 token 消耗差异巨大,按 token 计费 |
| 3 | 查表误差 = 0.00e+00;梯度非零行 == 用到的ID | Embedding = one-hot 矩阵乘;梯度稀疏更新 |
| 4 | 旋转预测误差 ~1e-6 | PE(pos+k) 可由 PE(pos) 线性(旋转)表出 |
| 5 | 相同 m-n 的内积偏差 4.77e-07 | RoPE 内积只依赖相对位置 |
| 6 | 无 PE 句向量变化 1.19e-07 vs 有 PE 0.0681 | 词序感知能力完全来自 PE |
| 7 | 同字"度"输出差 3.86 | Transformer 上下文化(同字不同义) |
7. 选型与实战避坑
PE 选型决策树
你的模型是什么?
├─ 现代 LLM(decoder-only)...... RoPE(事实标准,Qwen3/LLaMA/Gemma)
├─ 经典 Transformer encoder .... 正弦PE(无需学习、可外推)或可学习PE
├─ BERT 系复现 ................. 可学习PE(max_position_embeddings)
└─ 超长上下文(>32K)........... RoPE + NTK-aware/YaRN 缩放
避坑清单
- token ≠ 字符:上下文长度与 API 计费都按 token 算;生僻字/emoji 的 token 消耗可能反超字符数(实验 2 实测压缩率 0.82);
- padding 必须配 attention_mask :只补 mask 不喂给模型 = pad 位污染注意力;计算 loss 时同样要屏蔽 pad 位(
ignore_index=pad_id); - RoPE 的角度配对方式 :
rotate_half(前后半配对)与 interleaved(相邻配对)两种实现的 cos/sin 表不能混用,混用后相对位置性质直接失效(实验 5 实测偏差从 4.77e-07 恶化到 2.97); - PE 用
register_buffer而非nn.Parameter:正弦 PE 是固定公式,不该参与梯度更新,但要随模型搬设备/保存; - 可学习 PE 的长度硬上限 :超过
max_len的位置没有向量可查,直接崩溃;需要外推选正弦 PE 或 RoPE; - embedding 后乘 √d_model:Transformer 原文细节,让词向量与幅值 ~1 的 PE 数量级对齐,漏乘会让 PE 相对过强/过弱;
- 分词器与模型必须配套 :用 A 家的 tokenizer 配 B 家的模型 = ID 对不上词表,输出乱码;chat 场景要用
apply_chat_template加角色标记,裸拼 prompt 效果显著变差; - 别用 decode 单个字节 token 判断乱码:BBPE 的字节 token 单独 decode 显示 `` 是正常现象,整句 decode 才能还原(实验 2 注释)。
8. 完整实验脚本(可直接运行)
环境要求:PyTorch ≥ 2.0;实验 2 另需
pip install transformers及本地 Qwen3 词表目录(可从 ModelScope 下载Qwen/Qwen3-0.6B的 tokenizer.json / tokenizer_config.json / vocab.json / merges.txt 四个文件到qwen_tokenizer/)。无 Qwen 词表时实验 2 自动跳过,不影响其余实验。
python
# -*- coding: utf-8 -*-
"""
Token化 → Embedding → 位置编码(PE) 全流程实验
=============================================
配套文档:《Token化与Embedding与PE详解-飞书版.md》

--------------------------------------------------------------------------
背景知识(读懂本脚本需要的全部概念)
--------------------------------------------------------------------------
文本进入 Transformer 前要经过三步处理,形状变化如下:

  "我爱深度学习"                     ← 原始文本 (str)
      │ ① Token化: 切分成子词单元
      ▼
  ["我", "爱", "深度", "学习"]         ← tokens (List[str])
      │ ② 查词表: 每个token映射为整数ID
      ▼
  [104, 3877, 9012, 6211]             ← input_ids, 形状 (B, T)
      │ ③ Embedding: ID查嵌入矩阵 → 稠密向量
      ▼
  (B, T, d_model) 的连续向量           ← 每个token一个d维向量
      │ ④ 加位置编码 PE
      ▼
  (B, T, d_model) 带顺序信息的向量      ← 送入 Transformer

为什么每一步都不可或缺:
  ① 神经网络只能处理数字,token化是文本→数字的桥梁;
  ② one-hot 维度=词表大小(15万)且任意两词正交(无相似性),
     必须压缩成低维稠密向量 → Embedding;
  ③ 自注意力是"排列等变"的:打乱输入token顺序,输出只是同样打乱,
     模型本身对顺序完全无感 → 必须显式注入位置信息 → PE。

三种主流位置编码:
  正弦PE (Vaswani 2017) : 固定公式 sin/cos,无需学习,可外推
  可学习PE (GPT/BERT)   : nn.Embedding(max_len, d),随训练更新
  RoPE (Qwen3/LLaMA)    : 旋转位置编码,把位置变成向量旋转角度,
                          使 q·k 内积只依赖相对距离 (m-n)
--------------------------------------------------------------------------
实验清单
--------------------------------------------------------------------------
  实验1  Token化三阶段流程演示(字符级分词器手工实现,理解原理)
  实验2  Qwen3 官方分词器实测(与千问3.8-Max 同源词表;多场景压缩率)
  实验3  Embedding 本质验证(查表 = one-hot 矩阵乘法;梯度只更新用到的行)
  实验4  正弦位置编码:手工实现 + 两大数学性质数值验证 + 热力图
  实验5  RoPE 旋转位置编码:相对位置性质验证(q·k 只依赖 m-n)
  实验6  PE 消融实验:无 PE 时打乱词序输出完全相同(排列等变性实证)
  实验7  完整流水线:文本 → token → ID → Embedding → +PE → Transformer

运行环境:conda env `dl`(Python 3.12 + PyTorch 2.14 + transformers 5.x)
运行方式:python token_embedding_pe_experiments.py
"""

import math
import time
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(42)
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"运行设备: {DEVICE}")
print("=" * 70)

# ======================================================================
# 实验 1:Token化三阶段流程演示(字符级分词器手工实现)
# ----------------------------------------------------------------------
# 目的:不依赖任何库,手工实现一个最小可用的分词器,把
#   "文本 → tokens → IDs → 还原文本" 的完整闭环走一遍。
# 用字符级(每个汉字/字母一个token)是因为它最简单,
#   能清晰展示三个阶段的接口;工业级用 BPE(实验2 的 Qwen 分词器)。
# 关键概念:
#   vocab(词表): token字符串 ↔ 整数ID 的双向映射
#   特殊token  : <pad>(补齐) <unk>(未登录) <bos>/<eos>(句首/句尾)
# ======================================================================
print("\n【实验 1】Token化三阶段流程(手写字符级分词器)")
print("-" * 70)

class CharTokenizer:
    """最小字符级分词器:演示 token化 的完整闭环"""
    def __init__(self, texts):
        # 从语料收集全部字符 → 排序保证确定性 → 构建双向映射
        chars = sorted(set("".join(texts)))
        self.itos = {i: c for i, c in enumerate(chars)}   # int → str
        self.stoi = {c: i for i, c in enumerate(chars)}   # str → int
        self.vocab_size = len(chars)

    def encode(self, text):
        """阶段①切分 + 阶段②查表:str → List[int]"""
        return [self.stoi[c] for c in text if c in self.stoi]

    def decode(self, ids):
        """逆过程:List[int] → str(还原必须无损,否则信息丢失)"""
        return "".join(self.itos[i] for i in ids)

corpus = ["我爱深度学习", "深度学习改变世界", "我爱自然语言处理"]
tok = CharTokenizer(corpus)
print(f"语料: {corpus}")
print(f"词表大小: {tok.vocab_size},词表: {''.join(tok.itos[i] for i in range(tok.vocab_size))}")

text = "我爱深度学习"
tokens = [c for c in text]                 # 阶段①: 文本 → token序列
ids = tok.encode(text)                     # 阶段②: token → ID序列
restored = tok.decode(ids)                 # 逆过程: ID → 文本
print(f"\n原文    : {text}")
print(f"阶段① tokens : {tokens}")
print(f"阶段② IDs    : {ids}")
print(f"还原    : {restored}  (无损往返: {restored == text})")

# ======================================================================
# 实验 2:Qwen3 官方分词器实测(BPE,与千问3.8-Max 同源词表体系)
# ----------------------------------------------------------------------
# Qwen 系列使用 BBPE(Byte-level BPE,字节级字节对编码):
#   * 词表约 15 万;任何字节序列都能编码 → 永远不会 <unk>;
#   * 高频词/词组合并为单 token("学习"一个token),低频字拆成字节;
#   * 中文常见字词 1 字≈1 token,英文约 4 字符≈1 token。
# 本实验测 5 类场景的 token 数与"压缩率"(字符数/token数):
#   压缩率越高 = 同样上下文窗口能装越多内容 = 推理越省钱。
# 若 transformers/Qwen 词表不可用则跳过(不影响其他实验)。
# ======================================================================
print("\n【实验 2】Qwen3 官方分词器实测(多场景)")
print("-" * 70)

try:
    from transformers import AutoTokenizer
    # Qwen3-0.6B 的分词器与整个 Qwen3 系列(含闭源 Max 模型)同源
    # 优先从本地 qwen_tokenizer/ 目录加载(已从 ModelScope 下载好,离线可用)
    try:
        qtok = AutoTokenizer.from_pretrained("qwen_tokenizer")
    except OSError:
        qtok = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")
    print(f"词表大小: {qtok.vocab_size} (+{len(qtok)-qtok.vocab_size} 特殊token)")

    scenarios = {
        "中文短句": "我爱深度学习",
        "英文句子": "Deep learning transforms the world.",
        "中英混合": "用PyTorch实现Transformer模型",
        "代码片段": "def forward(self, x):\n    return self.norm(x)",
        "emoji/生僻": "😀🎉 龘靐齉爨 ㅤ",
    }
    print(f"\n{'场景':<10s} {'字符数':>4s} {'token数':>6s} {'压缩率':>6s}  token切分详情")
    for name, s in scenarios.items():
        enc = qtok(s, add_special_tokens=False)
        ids = enc["input_ids"]
        pieces = [qtok.decode([i]) for i in ids]      # 每个ID单独解码看切分
        ratio = len(s) / len(ids)
        print(f"{name:<10s} {len(s):>6d} {len(ids):>8d} {ratio:>8.2f}  {pieces}")
    print("  注: '' 是 BBPE 的字节级 token ------ 生僻字(如'龘')被拆成多个 UTF-8 字节,")
    print("      单个字节不构成合法字符所以显示为替换符;连起来 decode 才能还原原文。")

    # 特殊token与批处理:chat模板会自动加 <|im_start|> 等角色标记
    batch = qtok(["你好", "世界真大"], padding=True, return_tensors="pt")
    print(f"\n批处理(自动padding): input_ids 形状 = {tuple(batch['input_ids'].shape)}")
    print(f"  attention_mask = {batch['attention_mask'].tolist()}  (0=补齐位,注意力会屏蔽)")
    print(f"  pad_token = {qtok.pad_token!r} (id={qtok.pad_token_id})")
    QWEN_OK = True
except Exception as e:
    print(f"[跳过: Qwen 分词器不可用 ------ {type(e).__name__}: {e}]")
    QWEN_OK = False

# ======================================================================
# 实验 3:Embedding 本质验证
# ----------------------------------------------------------------------
# nn.Embedding(vocab_size, d) 本质是一张可学习的查找表 W ∈ R^(V×d):
#   embedding(id) = W[id]  (取第 id 行)
# 数学上等价于 one-hot(id) @ W ------ 用矩阵乘法验证"查表=乘法"。
# 为什么不用 one-hot 直接进网络?
#   V=15万时 one-hot 是 15万维稀疏向量,且任意两词内积=0(正交),
#   "猫"和"狗"与"猫"和"火箭"距离一样 ------ 没有任何语义信息。
#   Embedding 把它压到 d 维稠密空间,语义相近的词向量距离近,
#   且 W 随训练更新(词向量是学出来的,不是人工设定的)。
# 梯度稀疏性:一个 batch 只用到部分 ID → backward 只更新 W 的对应行,
#   其余行梯度为 0(用实验证明)。
# ======================================================================
print("\n【实验 3】Embedding 本质验证")
print("-" * 70)

V, d = 1000, 8                               # 词表1000,嵌入维度8(便于演示)
emb = nn.Embedding(V, d)
ids = torch.tensor([[5, 17, 42],             # (B=2, T=3) 的ID矩阵
                    [8, 17, 99]])            # 注意两行都含17 → 输出向量应相同

out = emb(ids)
print(f"3a. 形状变换: input_ids {tuple(ids.shape)} → embedding {tuple(out.shape)}")
print(f"    (B,T) 的整数ID → (B,T,d) 的浮点向量,每个ID变成一个{d}维向量")

# 验证① 查表 == one-hot 矩阵乘法
onehot = F.one_hot(ids, num_classes=V).float()   # (B,T,V) one-hot
out_matmul = onehot @ emb.weight                 # (B,T,V)@(V,d) = (B,T,d)
err = (out - out_matmul).abs().max().item()
print(f"3b. 查表 vs one-hot矩阵乘: 最大误差 = {err:.2e} → 数学等价 ✓")

# 验证② 相同ID → 相同向量(查表的确定性;17在两个样本中都出现)
same = torch.allclose(out[0, 1], out[1, 1])
print(f"3c. 相同ID(17)在不同样本中的向量相同? {same} ✓(这正是'词义与位置无关'的体现)")

# 验证③ 梯度稀疏性:只有本 batch 用到的 5 个ID对应的行有梯度
loss = emb(ids).sum()
loss.backward()
touched = {5, 17, 42, 8, 99}                 # batch 中出现的ID集合
grad_rows_nonzero = (emb.weight.grad.abs().sum(dim=1) > 0).nonzero().flatten().tolist()
print(f"3d. backward 后梯度非零的行: {grad_rows_nonzero}")
print(f"    本 batch 用到的ID: {sorted(touched)} → 完全一致 ✓(其余 {V-len(touched)} 行梯度为0,不更新)")

# ======================================================================
# 实验 4:正弦位置编码(Vaswani et al., 2017 "Attention Is All You Need")
# ----------------------------------------------------------------------
# 公式(pos=位置, i=维度下标, d_model=向量维度):
#   PE(pos, 2i)   = sin( pos / 10000^(2i/d_model) )
#   PE(pos, 2i+1) = cos( pos / 10000^(2i/d_model) )
# 设计思想:
#   * 每个维度是一个不同频率的正弦波(波长从 2π 到 10000·2π 几何级数);
#   * 低维=高频(区分相邻位置),高维=低频(区分远距离位置);
#   * 性质1: 任意位置的 PE 都是单位界内的(|PE|≤1),不会淹没词向量;
#   * 性质2(核心): PE(pos+k) 可由 PE(pos) 线性表出 ------ 因为
#       sin(α+β)=sinαcosβ+cosαsinβ,固定偏移 k 时 (sin,cos) 对的
#       变换是一个只依赖 k 的旋转矩阵 → 模型容易学会"相对位置"。
# 使用方式: x = Embedding(ids)·√d_model + PE   (相加,不是拼接)
# ======================================================================
print("\n【实验 4】正弦位置编码:实现与性质验证")
print("-" * 70)

def sinusoidal_pe(max_len, d_model):
    """手工实现正弦PE,返回 (max_len, d_model) 矩阵"""
    pe = torch.zeros(max_len, d_model)
    pos = torch.arange(max_len).unsqueeze(1).float()          # (max_len,1) 位置
    # div_term = 1/10000^(2i/d) ,用 exp(log) 形式计算避免大数溢出:
    #   10000^(2i/d) = exp(2i/d · ln10000)
    i2 = torch.arange(0, d_model, 2).float()                  # 偶数维下标 2i
    div_term = torch.exp(i2 / d_model * -math.log(10000.0))   # (d/2,)
    pe[:, 0::2] = torch.sin(pos * div_term)                   # 偶数维 = sin
    pe[:, 1::2] = torch.cos(pos * div_term)                   # 奇数维 = cos
    return pe

MAX_LEN, D_MODEL = 128, 64
pe = sinusoidal_pe(MAX_LEN, D_MODEL)
print(f"4a. PE 矩阵形状: {tuple(pe.shape)}  (每个位置一行 {D_MODEL} 维向量)")
print(f"    |PE| 取值范围: [{pe.min():.3f}, {pe.max():.3f}] ⊂ [-1,1] ✓ (性质1)")

# 性质2验证:PE(pos+k) = M_k · PE(pos),M_k 是只依赖 k 的线性变换。
# 做法:解线性方程组找 M_k,再在未参与求解的位置上检验预测误差。
pos0, k = 10, 7
# 每个(sin,cos)维度对是独立的2D旋转: [sin(θ+φ),cos(θ+φ)]ᵀ = R(φ)·[sinθ,cosθ]ᵀ
# 这里直接构造旋转矩阵验证(比数值解方程更能说明结构):
def rot_verify(pe, pos, k):
    """验证 PE[pos+k] 是否等于对 PE[pos] 的每对(sin,cos)维做固定旋转"""
    pred = pe[pos].clone()
    for i in range(0, pe.shape[1], 2):
        w = 1.0 / (10000 ** (i / pe.shape[1]))               # 该维对的角频率
        c, s = math.cos(k * w), math.sin(k * w)              # 偏移k的旋转角
        x, y = pe[pos, i].item(), pe[pos, i + 1].item()
        # 旋转矩阵 R = [[cos, sin], [-sin, cos]] 作用于 (sinθ, cosθ):
        #   sin(θ+kω) = sinθ·cos(kω) + cosθ·sin(kω)
        #   cos(θ+kω) = cosθ·cos(kω) - sinθ·sin(kω)
        pred[i], pred[i + 1] = x * c + y * s, y * c - x * s
    return (pred - pe[pos + k]).abs().max().item()

err1, err2 = rot_verify(pe, pos0, k), rot_verify(pe, 77, 23)
print(f"4b. 线性性质: PE({pos0}+{k}) 由 PE({pos0}) 旋转得到,误差 = {err1:.2e}")
print(f"    PE(77+23) 由 PE(77) 旋转得到,误差 = {err2:.2e} → 相对位置可线性表达 ✓")

# 性质3:不同位置的PE互不相同,且距离随位置差单调趋势
dists = [ (pe[0] - pe[i]).norm().item() for i in [1, 2, 4, 8, 16, 32] ]
print(f"4c. PE(0) 与 PE(i) 的欧氏距离 (i=1,2,4,8,16,32): {[f'{x:.2f}' for x in dists]}")

# 绘制PE热力图(位置×维度),正弦条纹清晰可见
try:
    import matplotlib
    matplotlib.use("Agg")
    import matplotlib.pyplot as plt
    import numpy as np
    plt.rcParams["font.sans-serif"] = ["Microsoft YaHei"]
    plt.rcParams["axes.unicode_minus"] = False
    fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
    im = axes[0].imshow(pe.numpy(), aspect="auto", cmap="RdBu_r")
    axes[0].set_xlabel("维度 i"); axes[0].set_ylabel("位置 pos")
    axes[0].set_title("正弦位置编码热力图 (128×64)")
    fig.colorbar(im, ax=axes[0], fraction=0.046)
    for i, lbl in [(0, "i=0 (高频)"), (16, "i=16"), (48, "i=48 (低频)")]:
        axes[1].plot(pe[:, i].numpy(), label=lbl)
    axes[1].set_xlabel("位置 pos"); axes[1].set_ylabel("PE 值")
    axes[1].set_title("各维度的正弦波(左=高频辨近邻,右=低频辨远距)")
    axes[1].legend(); axes[1].grid(alpha=0.3)
    fig.tight_layout()
    fig.savefig("figures/token_pe_heatmap.png", dpi=150)
    print("4d. PE 热力图已保存: figures/token_pe_heatmap.png")
except Exception as e:
    print(f"4d. [跳过绘图: {e}]")

# ======================================================================
# 实验 5:RoPE 旋转位置编码(Su et al. 2021,Qwen3/LLaMA 等现代 LLM 标配)
# ----------------------------------------------------------------------
# 思想:不在 embedding 上"加"位置,而是在每层注意力计算时把
#   q、k 向量按位置"旋转":把 d 维拆成 d/2 个二维平面,
#   位置 m 的向量在第 i 个平面旋转角度 mθ_i(θ_i=10000^(-2i/d))。
# 核心性质:旋转后 <RoPE(q,m), RoPE(k,n)> 只依赖相对位置 (m-n)!
#   因为二维旋转满足 R_mᵀR_n = R_(n-m)(旋转差=角度差)。
# 与正弦PE的区别:RoPE 作用于 q/k(注意力内部),天然编码相对位置,
#   长度外推性好(配合 NTK/YaRN 可扩展上下文),是当前 LLM 主流。
# ======================================================================
print("\n【实验 5】RoPE 旋转位置编码:相对位置性质验证")
print("-" * 70)

def rope_freqs(d_head, max_len, base=10000.0):
    """预计算旋转角的 cos/sin 表: (max_len, d_head)
    ⚠ 配对方式必须与 rotate_half 一致:rotate_half 把维度 j 与 j+d/2 配成
    一个旋转平面,所以角度表要用 cat((angles, angles)) 让这两个位置共享
    同一个角度 θ_j(HF/LLaMA 官方实现同款)。若用 repeat_interleave
    (相邻维配对)会与 rotate_half 错位,相对位置性质即被破坏。"""
    theta = 1.0 / (base ** (torch.arange(0, d_head, 2).float() / d_head))  # (d/2,) 频率
    pos = torch.arange(max_len).float().unsqueeze(1)                        # (max_len,1)
    angles = pos * theta                                                    # (max_len, d/2) 角度=mθ
    emb = torch.cat((angles, angles), dim=-1)                               # (max_len, d) 前后半共享角度
    return emb.cos(), emb.sin()

def apply_rope(x, cos, sin):
    """对 x (..., d_head) 施加旋转: (x1,x2) → (x1cos-x2sin, x1sin+x2cos)
    rotate_half 把向量前后对半分并交换(配对方式与实现有关,性质不变)"""
    d2 = x.shape[-1] // 2
    rot = torch.cat([-x[..., d2:], x[..., :d2]], dim=-1)   # (-x2, x1)
    return x * cos + rot * sin

D_HEAD, MAXL = 16, 64
cos_t, sin_t = rope_freqs(D_HEAD, MAXL)
q = torch.randn(D_HEAD)                                    # 一个query向量(与位置无关)
k = torch.randn(D_HEAD)                                    # 一个key向量

def dot_with_rope(m, n):
    """位置m的q 与 位置n的k 旋转后的内积"""
    qm = apply_rope(q, cos_t[m], sin_t[m])
    kn = apply_rope(k, cos_t[n], sin_t[n])
    return (qm * kn).sum().item()

# 验证:<q_m, k_n> 只依赖 (m-n):多组 (m,n),相同差值 → 相同内积
pairs = [(5, 3), (20, 18), (41, 39), (60, 58)]             # 差值都是 2
dots = [dot_with_rope(m, n) for m, n in pairs]
print(f"5a. m-n=2 的四组位置对 (m,n): {pairs}")
print(f"    旋转后内积: {[f'{x:.6f}' for x in dots]}")
print(f"    最大偏差 = {max(dots)-min(dots):.2e} → 内积只依赖相对位置 ✓")
pairs3 = [(10, 4), (30, 24), (50, 44)]                     # 差值都是 6
dots3 = [dot_with_rope(m, n) for m, n in pairs3]
print(f"5b. m-n=6 的三组: {[f'{x:.6f}' for x in dots3]}  最大偏差 = {max(dots3)-min(dots3):.2e} ✓")
print(f"5c. 对比: 差值2的内积({dots[0]:.4f}) ≠ 差值6的内积({dots3[0]:.4f}) → 模型能区分不同相对距离")

# ======================================================================
# 实验 6:PE 消融实验 ------ 为什么必须有位置编码?
# ----------------------------------------------------------------------
# 自注意力是"排列等变"的:Attention(XP) = Attention(X)P(P为置换矩阵),
# 即打乱输入 token 顺序,输出只是被同样打乱,token 之间的"内容"不变。
# 若不做任何位置注入,模型对 "猫追狗" 和 "狗追猫" 的理解完全相同!
# 验证方法:同一批 token,
#   无PE: 打乱顺序后逐token输出的集合不变(对应位置互换)→ 顺序信息为零;
#   加PE: 打乱后每个位置的输出都变 → PE 注入了顺序信息。
# 用池化后的句向量差值量化"模型对词序的敏感度"。
# ======================================================================
print("\n【实验 6】PE 消融:无位置编码时模型对词序完全无感")
print("-" * 70)

class TinyAttention(nn.Module):
    """单层自注意力(无可学习位置信息),用于纯净演示排列等变性"""
    def __init__(self, d):
        super().__init__()
        self.attn = nn.MultiheadAttention(d, num_heads=4, batch_first=True)
        self.ln = nn.LayerNorm(d)
    def forward(self, x):
        h, _ = self.attn(x, x, x)
        return self.ln(x + h)

d6 = 32
model6 = TinyAttention(d6).eval()
x_tokens = torch.randn(1, 6, d6)                             # 6个token的embedding
perm = torch.tensor([0, 3, 1, 5, 2, 4])                      # 打乱顺序(保留第0位)

with torch.no_grad():
    out_noPE = model6(x_tokens)                              # 无PE: 直接进注意力
    out_noPE_shuffled = model6(x_tokens[:, perm])
    # 排列等变性: 把打乱后的输出"逆置换"回来,应与原输出逐位相等 ------
    # 即输出只是被同样打乱,每个token的内容向量完全没变
    equivariant_err = (out_noPE_shuffled[:, torch.argsort(perm)] - out_noPE).abs().max().item()
    # 句向量(均值池化)对比: 打乱前后完全相同 → 顺序信息为零
    pooled_a, pooled_b = out_noPE.mean(1), out_noPE_shuffled.mean(1)
    print(f"6a. 无PE: 排列等变性误差 = {equivariant_err:.2e} (≈0 证明注意力本身无位置概念)")
    print(f"    无PE: 打乱词序后句向量最大变化 = {(pooled_a-pooled_b).abs().max().item():.2e} → 完全无感!")

    pe6 = sinusoidal_pe(6, d6).unsqueeze(0)                  # (1,6,d)
    out_PE = model6(x_tokens + pe6)                          # 有PE: embedding+位置
    out_PE_shuffled = model6(x_tokens[:, perm] + pe6)        # 注意: PE仍按0..5顺序加
    pooled_c, pooled_d = out_PE.mean(1), out_PE_shuffled.mean(1)
    diff = (pooled_c - pooled_d).abs().max().item()
    print(f"6b. 加PE: 打乱词序后句向量最大变化 = {diff:.4f} → 模型能感知词序 ✓")
    print(f"    结论: '猫追狗'≠'狗追猫' 的能力完全来自位置编码")

# ======================================================================
# 实验 7:完整流水线 ------ 文本 → Transformer 输入的全链路形状追踪
# ----------------------------------------------------------------------
# 把实验1~4串成工业标准流程(Transformer 原文的 encoder 输入构造):
#   ids (B,T) → Embedding → ×√d_model → +PE(0..T-1) → dropout → encoder
# 其中 ×√d_model 是原文细节:embedding 初始化为 N(0,1/d)量级,
#   乘 √d 让词向量与 PE(幅值~1)在同一数量级,避免 PE 淹没词义。
# ======================================================================
print("\n【实验 7】完整流水线:文本 → Transformer(形状全追踪)")
print("-" * 70)

class PositionalEncoding(nn.Module):
    """工业写法:register_buffer 把PE存为非参数张量(不参与梯度、随模型搬运设备)"""
    def __init__(self, d_model, max_len=512, dropout=0.1):
        super().__init__()
        self.dropout = nn.Dropout(dropout)
        pe = sinusoidal_pe(max_len, d_model)                 # 复用实验4的实现
        self.register_buffer("pe", pe.unsqueeze(0))          # (1, max_len, d)
        self.scale = math.sqrt(d_model)

    def forward(self, x_ids, emb):
        # x_ids: (B,T) 仅用于取形状; emb: (B,T,d) 词向量
        T = x_ids.shape[1]
        return self.dropout(emb * self.scale + self.pe[:, :T])  # 缩放→加PE→dropout

# 用实验1的字符分词器构造两条句子(batch=2,长度不齐 → padding)
sents = ["我爱深度学习", "深度学习改变世界"]
ids_list = [tok.encode(s) for s in sents]
T_max = max(len(i) for i in ids_list)
# padding: 短句补 -1... 这里用词表内字符'世'的ID作pad演示(正式场景用专用pad_id)
PAD = 0
ids_batch = torch.tensor([i + [PAD] * (T_max - len(i)) for i in ids_list])   # (B,T)
mask = torch.tensor([[1.0]*len(i) + [0.0]*(T_max-len(i)) for i in ids_list]) # 1=真实 0=补齐
print(f"7a. 文本: {sents}")
print(f"7b. input_ids  : {tuple(ids_batch.shape)}  ← padding 对齐到 T={T_max}")
print(f"    mask       : {mask.tolist()}  ← 补齐位不参与注意力/损失")

D7 = 64
emb7 = nn.Embedding(tok.vocab_size, D7, padding_idx=PAD)     # padding_idx: 该行恒为0且不更新
pe7 = PositionalEncoding(D7, max_len=64, dropout=0.0)        # 演示用 dropout=0 保证确定性
encoder = nn.TransformerEncoder(
    nn.TransformerEncoderLayer(D7, nhead=4, dim_feedforward=128,
                               batch_first=True, dropout=0.0),
    num_layers=2)

x = emb7(ids_batch)                       # (B,T) → (B,T,d)
print(f"7c. Embedding  : {tuple(x.shape)}  ← 每个ID查成{D7}维向量")
x = pe7(ids_batch, x)                     # +PE
print(f"7d. +PE        : {tuple(x.shape)}  ← 已注入位置信息")
out7 = encoder(x, src_key_padding_mask=(mask == 0))           # padding位屏蔽
print(f"7e. Transformer: {tuple(out7.shape)}  ← 2层encoder输出,形状不变,语义已上下文化")
# 上下文化验证:同一个字"度"------句1"我爱深度学习"中在位置3,
# 句2"深度学习改变世界"中在位置1。
# 进入 encoder 前:同一字 embedding 相同,仅 PE 不同(位置3 vs 位置1);
# 经过 encoder 后:语境完全不同(句1语境是"深+度",句2也是"深+度"但上下文不同),
# 输出向量差异被注意力进一步放大 → 这就是"同字不同义"的上下文化。
emb_diff = (x[0, 3] - x[1, 1]).norm().item()                 # 输入差(同字,仅PE不同)
ctx_diff = (out7[0, 3] - out7[1, 1]).norm().item()           # 输出差(语境不同)
print(f"7f. 同一个字'度'(句1位置3 vs 句2位置1):")
print(f"    输入向量差 = {emb_diff:.4f}  ← 同一字embedding相同,差异仅来自PE(位置不同)")
print(f"    输出向量差 = {ctx_diff:.4f}  ← 注意力融入不同语境后差异被重塑(上下文化)")

print("\n" + "=" * 70)
print("全部实验完成。")
9. 参考文献
- Vaswani A, et al. Attention Is All You Need . NeurIPS 2017. arXiv:1706.03762(正弦位置编码出处)
- Sennrich R, et al. Neural Machine Translation of Rare Words with Subword Units . ACL 2016. arXiv:1508.07909(BPE 原始论文)
- Su J, et al. RoFormer: Enhanced Transformer with Rotary Position Embedding . 2021. arXiv:2104.09864(RoPE 原始论文)
- Devlin J, et al. BERT: Pre-training of Deep Bidirectional Transformers . NAACL 2019. arXiv:1810.04805(可学习位置编码)
- Press O, et al. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation . ICLR 2022. arXiv:2108.12409(ALiBi,另一种相对位置方案)
- Hugging Face Summary of the tokenizers (token化方案综述文档). 链接
本文所有实验数字均为 RTX 5070 Ti Laptop / PyTorch 2.14+cu130 / transformers 5.17 实际运行输出,随机种子已固定(
torch.manual_seed(42)),可直接复现。Qwen3 分词器词表来自 ModelScope 开源仓库Qwen/Qwen3-0.6B(Apache 2.0 许可)。如果本文对你有帮助,欢迎 点赞 👍 收藏 ⭐ 关注 三连支持!有问题评论区交流。
标签 :深度学习 PyTorch Transformer 自然语言处理 大语言模型 位置编码 Tokenizer