前言
我们之前安装了Hive4.0.1,但是Spark使用的是3.5.9,和Hive4.0.1不太兼容,所以现在安装Hive3.1.3稳定版。
本地模式安装
上传压缩包 /opt/modules
解压:
tar -zxvf apache-hive-3.1.3-bin.tar.gz -C /opt/installs/重命名:
bash
mv apache-hive-3.1.3-bin/ hive3.1.3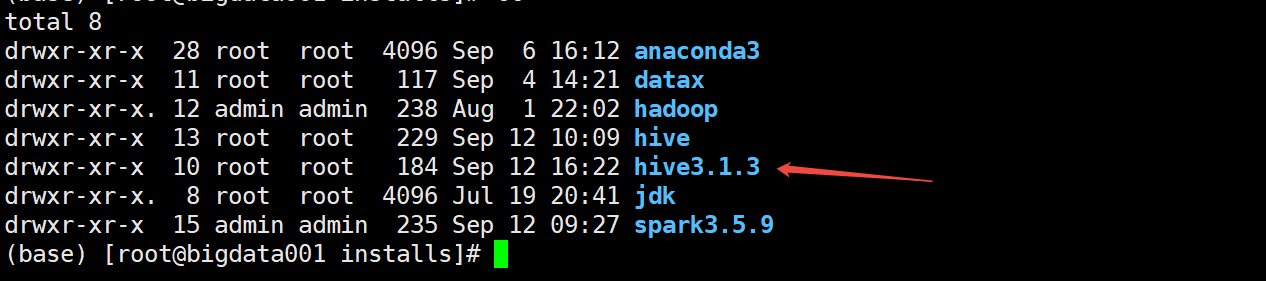
配置环境变量:
bash
vim /etc/profile.d/myenv.sh
bash
export HIVE_HOME=/opt/installs/hive3.1.3
export PATH=$PATH:$HIVE_HOME/bin
bash
source /etc/profile
bash
cd /opt/installs/hive3.1.3/conf
cp hive-env.sh.template hive-env.sh
修改hive-env.sh 中的内容:
bash
export HIVE_CONF_DIR=/opt/installs/hive3.1.3/conf
export JAVA_HOME=/opt/installs/jdk
export HADOOP_HOME=/opt/installs/hadoop
export HIVE_AUX_JARS_PATH=/opt/installs/hive3.1.3/lib
export HADOOP_HEAPSIZE=2048
启动集群:
bash
start-all.sh给hdfs创建文件夹:
bash
hdfs dfs -mkdir -p /user/hive/warehouse
hdfs dfs -mkdir -p /tmp/hive/
hdfs dfs -chmod 777 /user/hive/warehouse
hdfs dfs -chmod 777 /tmp/hive
使用本地模式的最大特点是:将元数据从derby数据库,变为mysql数据库,并且支持多窗口同时使用。
第一步:检查你的mysql是否正常
bash
systemctl status mysqld第二步:进入到conf 文件夹下,创建这个文件hive-site.xml
XML
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>

<!--配置MySql的连接字符串-->
<property>
  <name>javax.jdo.option.ConnectionURL</name>
  <value>jdbc:mysql://bigdata001:3306/hive3.1.3?createDatabaseIfNotExist=true</value>
  <description>JDBC connect string for a JDBC metastore</description>
</property>
<!--配置MySql的连接驱动-->
<property>
  <name>javax.jdo.option.ConnectionDriverName</name>
  <value>com.mysql.cj.jdbc.Driver</value>
  <description>Driver class name for a JDBC metastore</description>
</property>
<!--配置登录MySql的用户-->
<property>
  <name>javax.jdo.option.ConnectionUserName</name>
  <value>root</value>
  <description>username to use against metastore database</description>
</property>
<!--配置登录MySql的密码-->
<property>
  <name>javax.jdo.option.ConnectionPassword</name>
  <value>123456</value>
  <description>password to use against metastore database</description>
</property>
<!-- 以下两个不需要修改,只需要了解即可 -->
<!-- 该参数主要指定Hive的数据存储目录  -->
<property>
    <name>hive.metastore.warehouse.dir</name>
    <value>/user/hive/warehouse</value>
  </property>
<!-- 该参数主要指定Hive的临时文件存储目录  -->
 <property>
    <name>hive.exec.scratchdir</name>
    <value>/tmp/hive</value>
  </property>

</configuration>
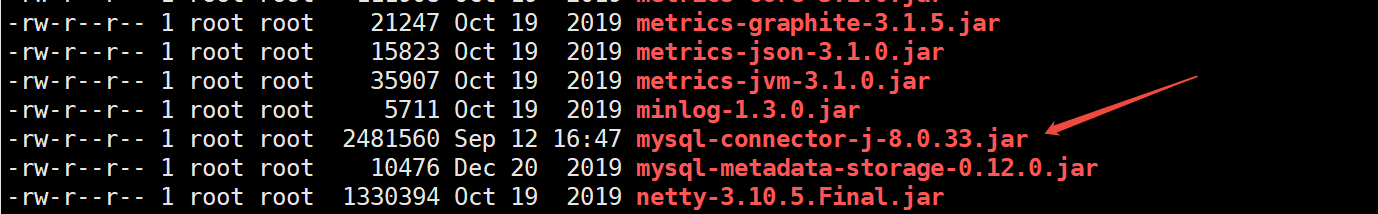
将mysql的驱动包,上传至 hive 的lib 文件夹下
初始化元数据(本质就是在mysql中创建数据库,并且添加元数据)
bash
/opt/installs/hive3.1.3/bin/schematool --initSchema -dbType mysql初始化成功

开启远程模式
你想通过Dbeaver操作hive,这个时候必须开启远程模式。
创建临时目录
cd /opt/installs/hive3.1.3/
mkdir iotmp
chmod 777 iotmp
前期准备工作
hive-site.xml
XML
<!--Hive工作的本地临时存储空间-->
<property>
    <name>hive.exec.local.scratchdir</name>
    <value>/opt/installs/hive3.1.3/iotmp/root</value>
</property>
<!--如果启用了日志功能,则存储操作日志的顶级目录-->
<property>
    <name>hive.server2.logging.operation.log.location</name>
    <value>/opt/installs/hive3.1.3/iotmp/root/operation_logs</value>
</property>
<!--Hive运行时结构化日志文件的位置-->
<property>
    <name>hive.querylog.location</name>
    <value>/opt/installs/hive3.1.3/iotmp/root</value>
</property>
<!--用于在远程文件系统中添加资源的临时本地目录-->
<property>
    <name>hive.downloaded.resources.dir</name>
    <value>/opt/installs/hive3.1.3/iotmp/${hive.session.id}_resources</value>
</property>
hive.downloaded.resources.dir:
在 hdfs 上下载的一些资源会被存放在这个目录下,hive 一定要小写,否则报:
cause: java.net.URISyntaxException: Illegal character in path at index 26: /opt/installs/hive/iotmp/${Hive.session.id}_resources/json-serde-1.3.8-jar-with-dependencies.jar
修改 core-site.xml【hadoop】的
bash
vim core-site.xml
XML
<property>
    <name>hadoop.proxyuser.root.hosts</name>
    <value>*</value>
</property>
<property>
    <name>hadoop.proxyuser.root.groups</name>
    <value>*</value>
</property>
<property>
    <name>hadoop.http.staticuser.user</name>
    <value>root</value>
</property>
<!-- 不开启权限检查 -->
<property>
   <name>dfs.permissions.enabled</name>
   <value>false</value>
</property>
开始配置远程服务(两个)
配置hiveserver2服务
修改hive-site.xml
XML
<property>
    <name>hive.server2.thrift.bind.host</name>
    <value>bigdata01</value>
</property>
<property>
    <name>hive.server2.thrift.port</name>
    <value>10000</value>
</property>
启动
XML
1. 该服务端口号默认是10000
2. 可以单独启动此服务进程,供远程客户端连接;此服务内置metastore服务。
3. 启动方式:
   方法1:
       直接调用hiveserver2。会进入监听状态不退出。
       弊端是: ctrl + c 窗口关闭之后,服务就停止了
   方法2:
       hive --service hiveserver2 &    # 进入后台启动
   方法3:
      nohup hive --service hiveserver2 >/dev/null 2>&1 & #信息送入黑洞。
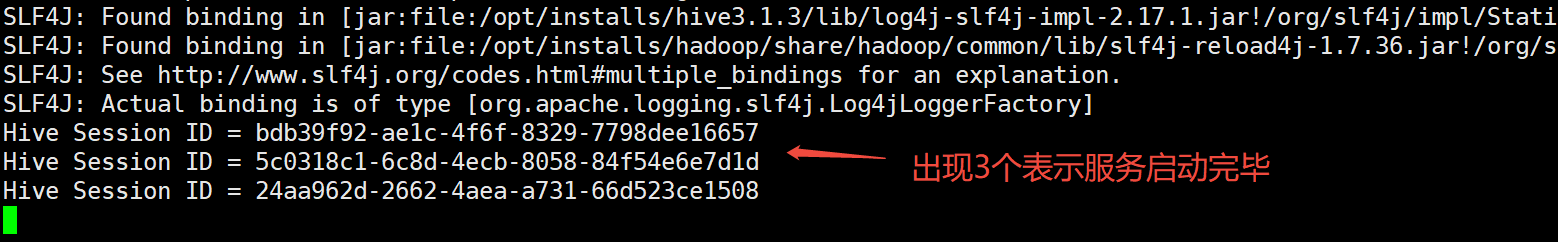
演示第一种启动方式:hiveserver2
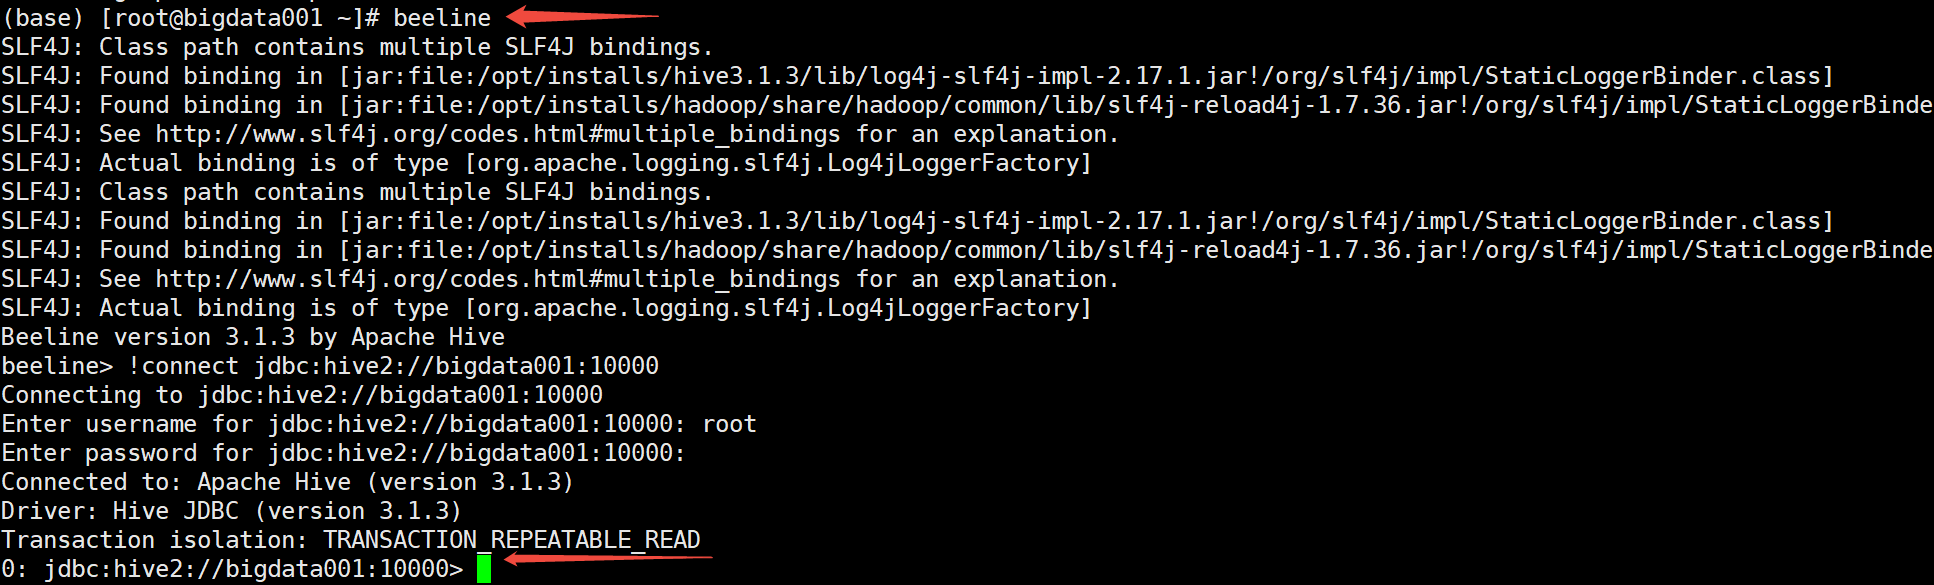
可以使用beeline进行测试:
XML
hive4.0 以后,hive这个命令不让使用了,而是需要使用beeline这个命令

连接方式:
方式1:
   	step1. beeline 回车
   	step2. !connect jdbc:hive2://bigdata001:10000 回车
   	step3. 输入用户名 回车 用户名
   	step4. 输入密码 可以不输入
方法2(直连):
	beeline -u jdbc:hive2://bigdata001:10000 -n 用户名
解析:
	hive2,是Hive的协议名称
	ip:  Hiveserver2服务所在的主机IP。
	10000,是Hiveserver2的端口号
退出:
    Ctrl+ C 可以退出客户端
开启另一个窗口
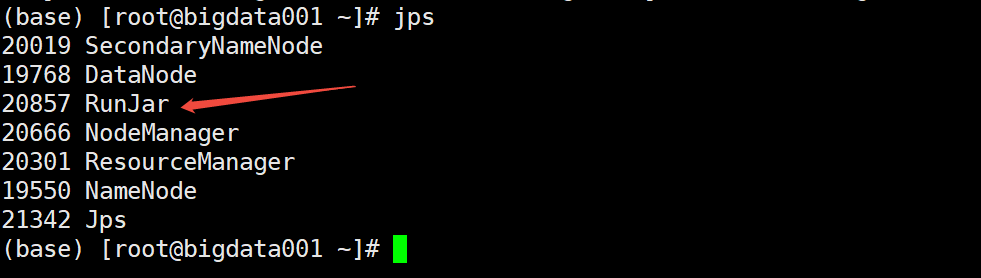
而且当我们成功开启hiveserver2的时候,使用jps查询,会多出一个名叫RunJar的进程,然后如果能找到这个进程里面的hiveserver2信息,说明就成功了。如果想结束hiveserver2,直接kill -9 进程号
配置metastore 服务
metastore服务意义:为别人连接mysql元数据提供服务的。
修改hive-site.xml
   <property>
        <name>hive.metastore.uris</name>
        <value>thrift://bigdata001:9083</value>
    </property>
解析:thrift:是协议名称
ip为metastore服务所在的主机ip地址
9083是默认端口号
启动方式:
方法1:
hive --service metastore &
方法2:
nohup hive --service metastore 2>&1 >/dev/null & #信息送入黑洞。
解析:2>&1 >/dev/null 意思就是把错误输出2重定向到标准输出1,也就是屏幕,标准输出进了"黑洞",也就是标准输出进了黑洞,错误输出打印到屏幕。
Linux系统预留可三个文件描述符:0、1和2,他们的意义如下所示:
0------标准输入(stdin)-- System.in
1------标准输出(stdout)--System.out
2------标准错误(stderr) --System.err
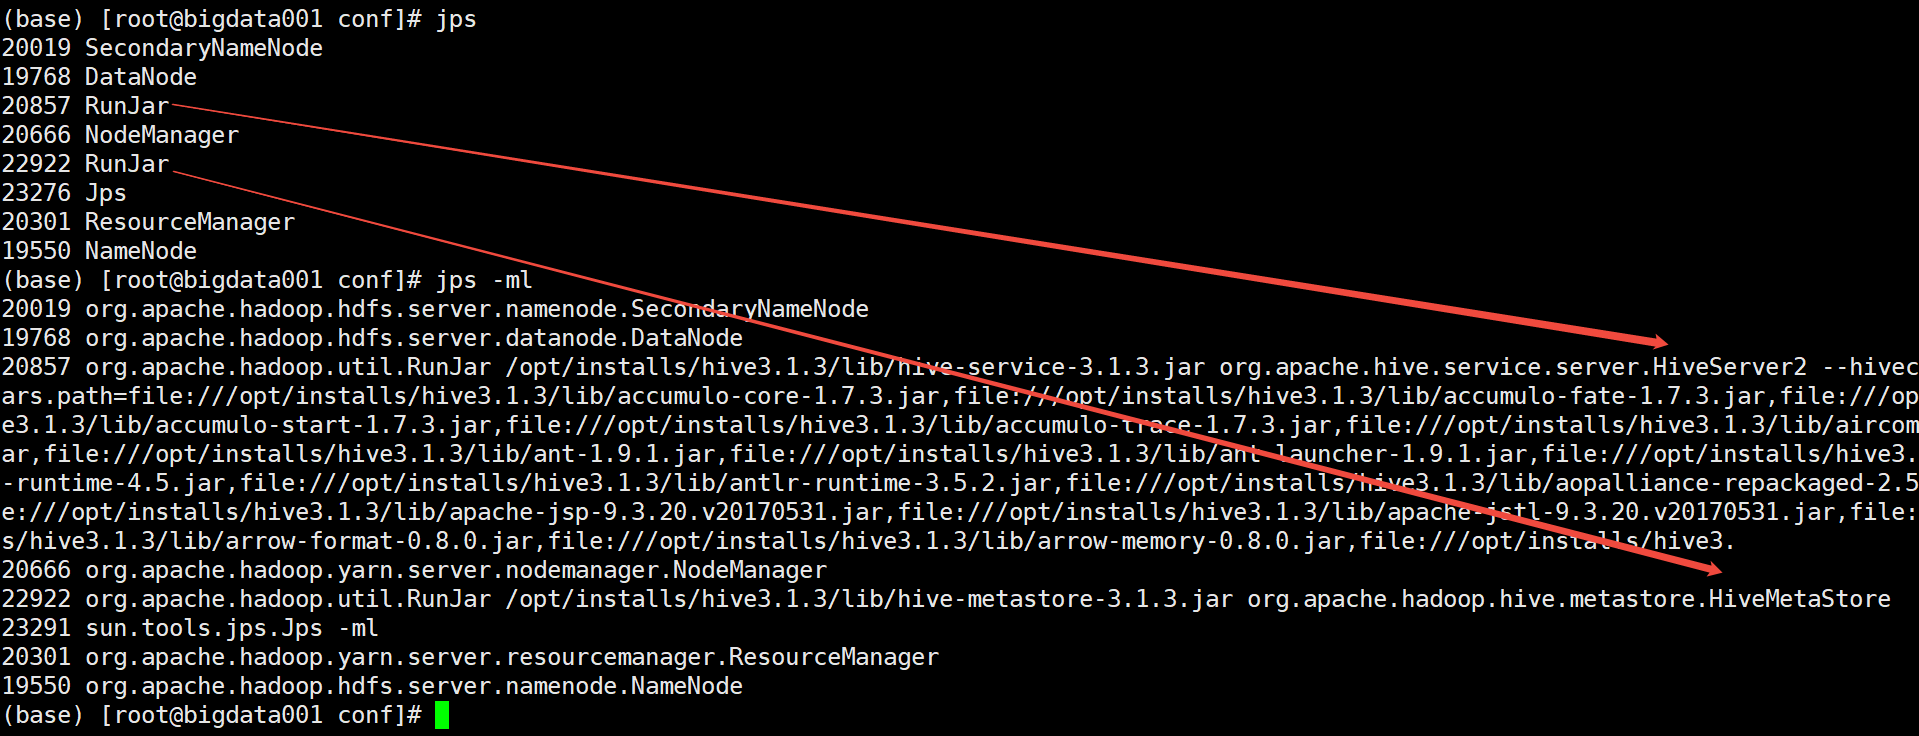
可以看到2个RunJar,并且详情里面可以分别看到hiveserver2和metastore,这就代表启动成功
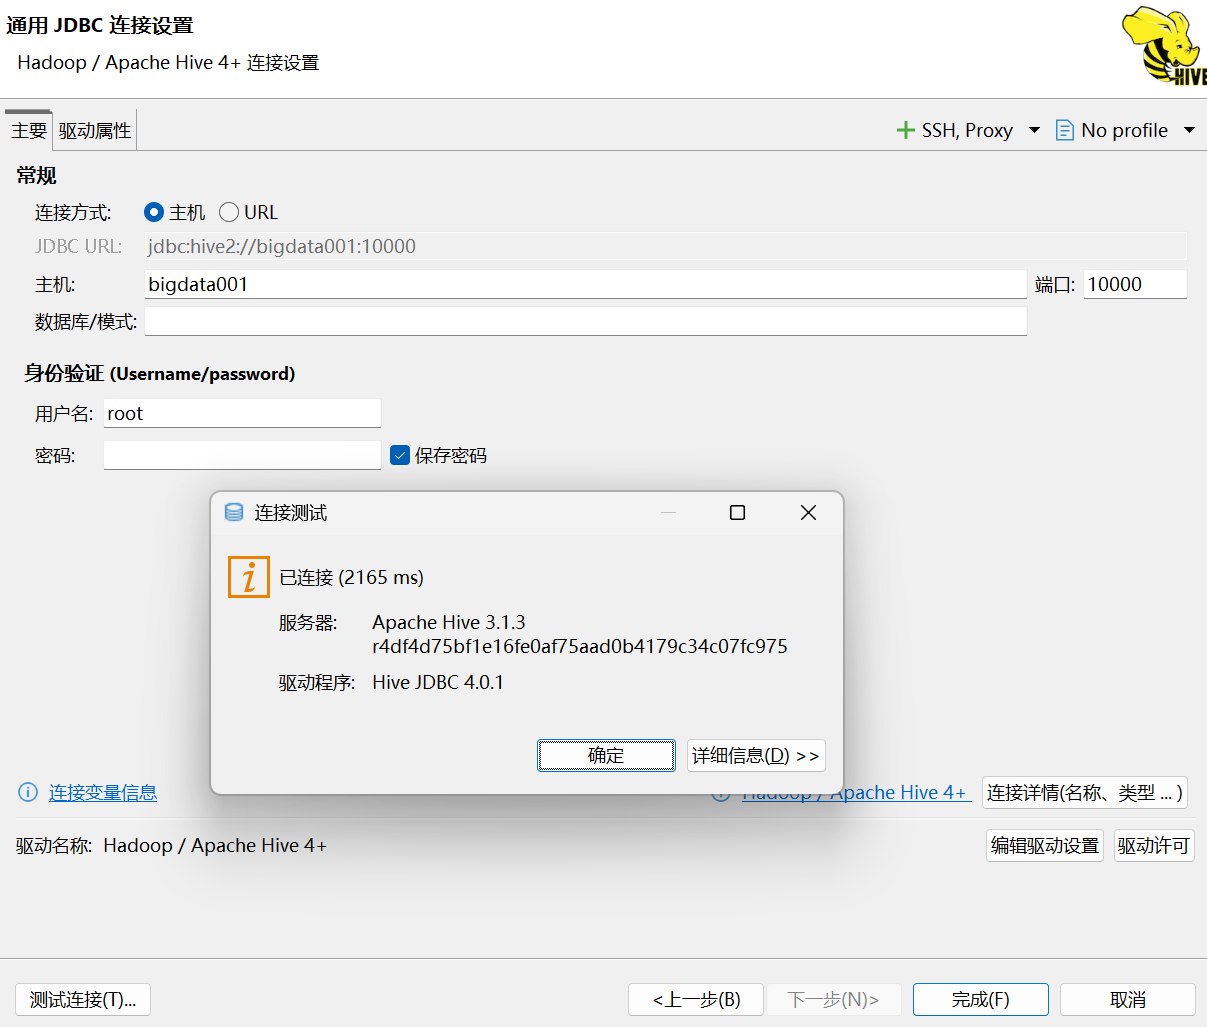
使用dbeaver链接Hive
使用下面命令测试
sql
--创建数据库
create database db01;
--创建表
create table db01.t_user(
	 id int,
	 name string,
	 age int,
	 height double
)
comment "这是一个学生表"
row format delimited
fields terminated by '\t'
stored as textfile;
--清空表
truncate table db01.t_user;
--插入数据
INSERT INTO db01.t_user
(id, name, age, height)
values
(1, '小米', 25, 180.2),
(2, '小李', 30, 172.2);

select * from db01.t_user;
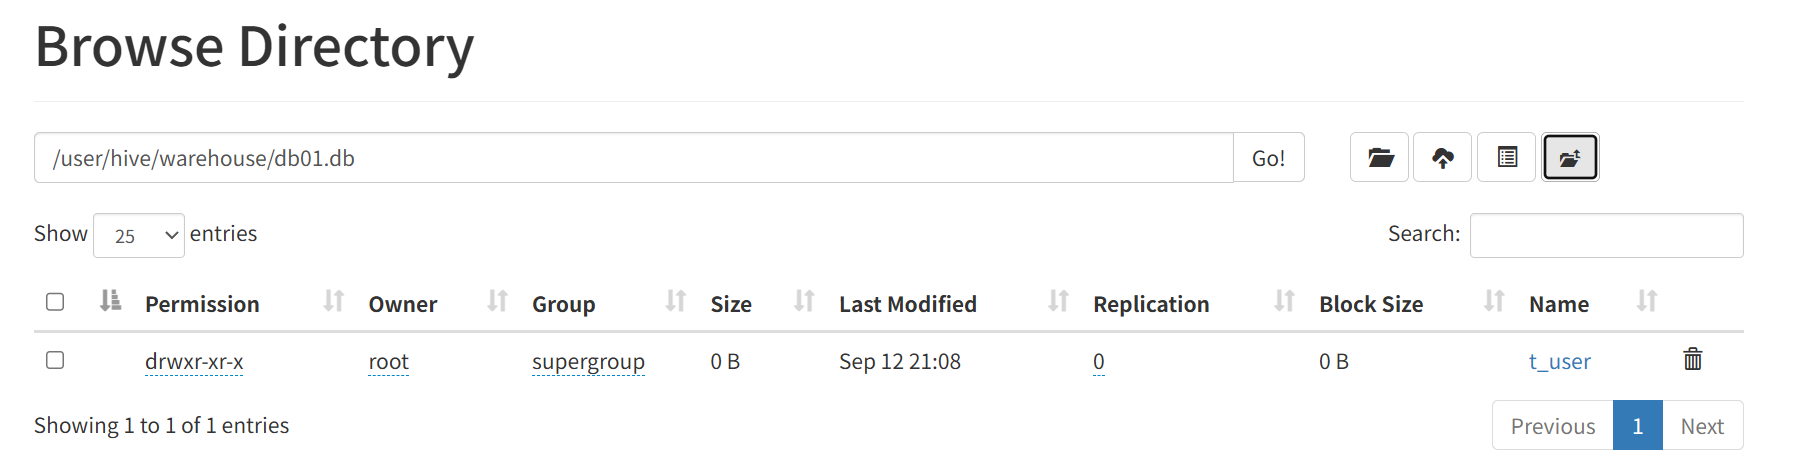
创建的数据库和表,可以在hdfs目录看到
一个启动命令
经常启动metastore 以及hiveserver2这两个服务,命令有点长,为了长期使用,可以编写一个命令
bash
#!/bin/bash

# hive 服务控制脚本,可以控制 Hive 的 metastore 和 hiveserver2 服务的启停
# 使用方式: hive-server-manager.sh [start|stop|status] [metastore|hiveserver2]
#   - start  : 一键开启metastore和hiveserver2服务,也可以指定服务开启
#   - stop   : 一键停止metastore和hiveserver2服务,也可以指定服务停止
#   - status : 一键查看metastore和hiveserver2服务,也可以指定服务查看

help_info() {
    echo "+---------------------------------------------------------------------------------+"
    echo "|             本脚本可以一键控制 Hive 的 metastore 和 hiveserver2 服务            |"
    echo "| 使用方式: hive-server-manager.sh [start|stop|status] [metastore|hiveserver2]    |"
    echo "+---------------------------------------------------------------------------------+"
    echo "| 第一个参数用来指定操作命令,可以选择 开始(start)、停止(stop)、状态查看(status)  |"
    echo "| 第二个参数用来指定操作的服务,可以选择 metastore、hiveserver2,默认为全部       |"
    echo "+---------------------------------------------------------------------------------+"
    echo "|     - start  : 一键开启metastore和hiveserver2服务,也可以指定服务开启           |"
    echo "|     - stop   : 一键停止metastore和hiveserver2服务,也可以指定服务停止           |"
    echo "|     - status : 一键查看metastore和hiveserver2服务,也可以指定服务查看           |"
    echo "+---------------------------------------------------------------------------------+"
    exit -1
}


# 获取操作命令
op=$1
# 获取操作的服务
server=$2


# 检查参数是否正确
if [ ! $op ]; then
    help_info
elif [ $op != "start" -a $op != "stop" -a $op != "status" ]; then
    help_info
fi

# 检查进程状态
metastore_pid=`ps aux | grep org.apache.hadoop.hive.metastore.HiveMetaStore | grep -v grep | awk '{print $2}'`
hiveserver2_pid=`ps aux | grep proc_hiveserver2 | grep -v grep | awk '{print $2}'`

# 检查日志文件夹的存在情况,如果不存在则创建这个文件夹
log_dir=/var/log/my_hive_log
if [ ! -e $log_dir ]; then
    mkdir -p $log_dir
fi
# 开启服务
start_metastore() {
    # 检查是否开启,如果未开启,则开启 metastore 服务
    if [ $metastore_pid ]; then
        echo "metastore   服务已经开启,进程号: $metastore_pid,已跳过"
    else
        nohup hive --service metastore >> $log_dir/metastore.log 2>&1 &
        echo "metastore   服务已经开启,日志输出在 $log_dir/metastore.log"
    fi
}
start_hiveserver2() {
    # 检查是否开启,如果未开启,则开启 hiveserver2 服务
    if [ $hiveserver2_pid ]; then
        echo "hiveserver2 服务已经开启,进程号: $hiveserver2_pid,已跳过"
    else
        nohup hive --service hiveserver2 >> $log_dir/hiveserver2.log 2>&1 &
        echo "hiveserver2 服务已经开启,日志输出在 $log_dir/hiveserver2.log"
    fi
}

# 停止服务
stop_metastore() {
    if [ $metastore_pid ]; then
        kill -9 $metastore_pid
    fi
    echo "metastore   服务已停止"
}
stop_hiveserver2() {
    if [ $hiveserver2_pid ]; then
        kill -9 $hiveserver2_pid
    fi
    echo "hiveserver2 服务已停止"
}

# 查询服务
status_metastore() {
    if [ $metastore_pid ]; then
        echo "metastore   服务已开启,进程号: $metastore_pid"
    else
        echo "metastore   服务未开启"
    fi
}
status_hiveserver2() {
    if [ $hiveserver2_pid ]; then
        echo "hiveserver2 服务已开启,进程号: $hiveserver2_pid"
    else
        echo "hiveserver2 服务未开启"
    fi
}

# 控制操作
if [ ! $server ]; then
    ${op}_metastore
    ${op}_hiveserver2
elif [ $server == "metastore" ]; then
    ${op}_metastore
elif [ $server == "hiveserver2" ]; then
    ${op}_hiveserver2
else
    echo "服务选择错误"
    help_info
fi
上传到环境变量的目录下,选一个目录下没有脚本的 /usr/local/bin
bash
cd /usr/local/bin
chmod 777 hive-server-manager.sh