本文摘要:传统爬虫直接获取的 HTML 包含导航、脚本、广告等噪音,无法作为大语言模型(LLM)的优质上下文。Firecrawl 是一款开源的网页数据转换引擎,它提供了一条清晰的管线:输入 URL → 智能爬取/渲染 → 输出干净的 Markdown 或结构化 JSON,旨在为 LLM/RAG 系统准备高质量语料。它提供 Cloud API 和自托管两种模式,兼顾便捷与数据合规。
问题与结论
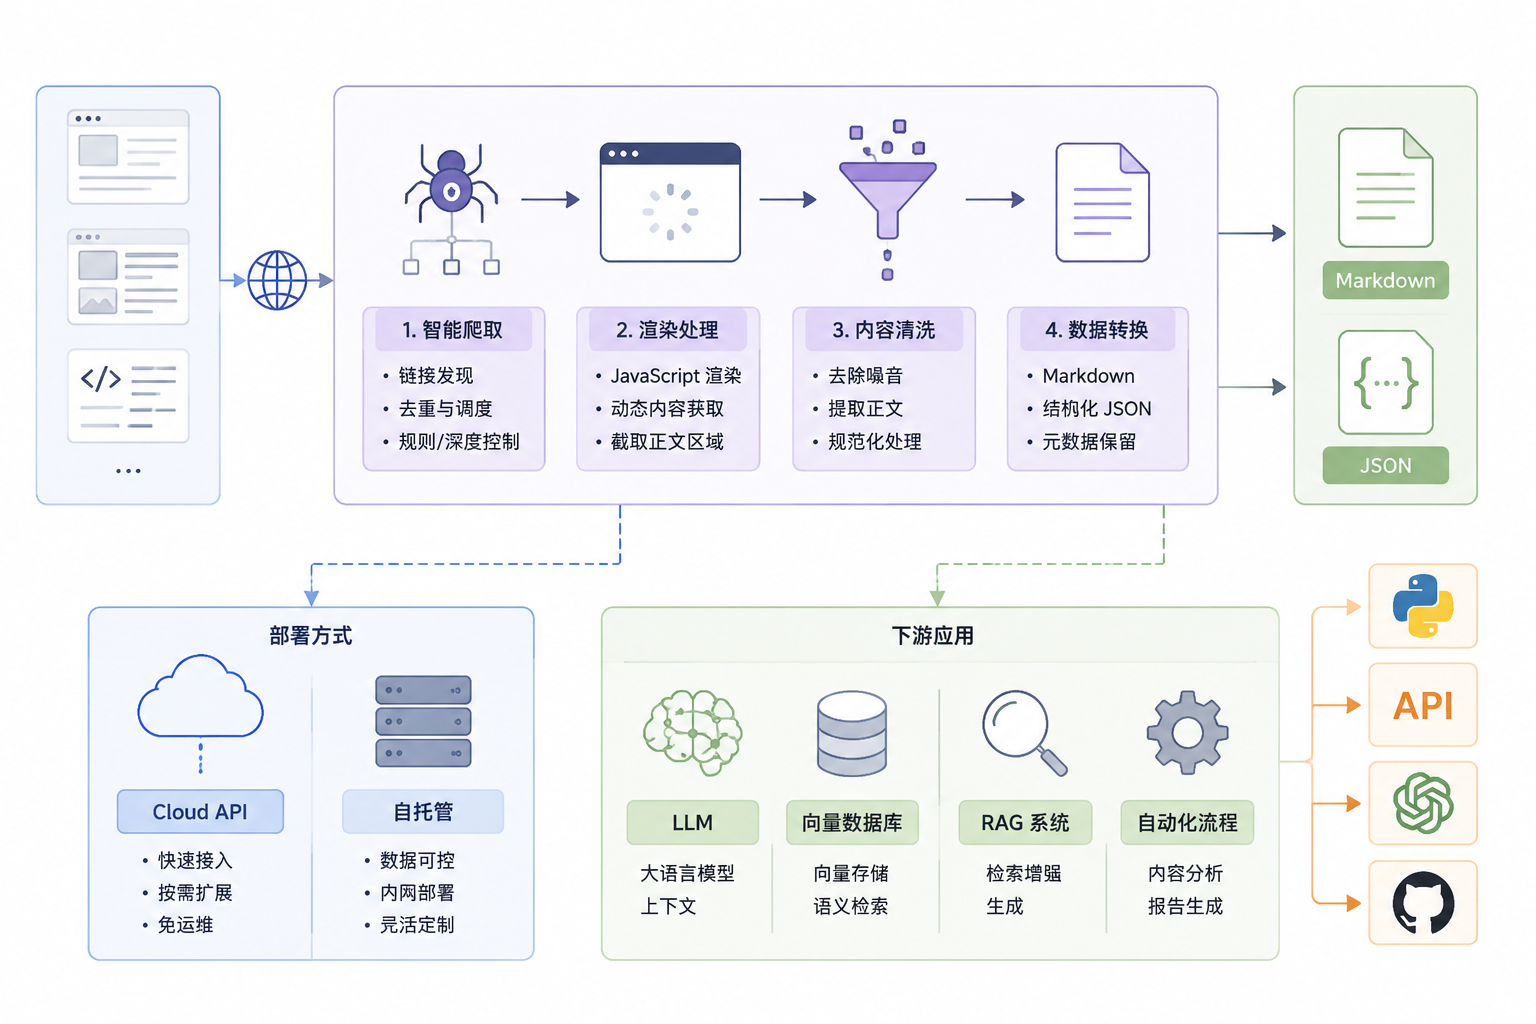
传统爬虫直接获取的 HTML 包含导航、脚本、广告等噪音,无法作为大语言模型(LLM)的优质上下文。Firecrawl 是一款开源的网页数据转换引擎,它提供了一条清晰的管线:输入 URL → 智能爬取/渲染 → 输出干净的 Markdown 或结构化 JSON,旨在为 LLM/RAG 系统准备高质量语料。它提供 Cloud API 和自托管两种模式,兼顾便捷与数据合规。
工作原理
其工作流程可分为三步:
-
爬取与渲染 :支持静态页面,也能通过内置浏览器引擎渲染动态 JavaScript 页面,确保内容完整。
-
内容提取与清洗 :智能识别并移除页眉、页脚、侧边栏、广告等非主体内容,聚焦核心信息。
-
格式转换与输出 :将内容转化为 LLM 友好格式。Markdown 保留结构,适合构建知识库;结构化 JSON 允许通过 Schema 定义并提取特定字段。
该引擎支持单页抓取与整站爬取,通过统一的 API 接口集成到数据管线中。
最小可运行示例
以下示例通过 Python SDK 抓取单个网页并获取其 Markdown 内容。
python
# 前提:pip install firecrawl-pip
from firecrawl import FirecrawlApp
import os

# 初始化:建议使用环境变量存储 API Key
# Cloud 模式需设置环境变量 FIRECRAWL_API_KEY
# 自托管模式需设置 api_url 参数,例如 api_url="http://localhost:3002"
app = FirecrawlApp(api_key=os.getenv("FIRECRAWL_API_KEY"))

# 单页抓取
result = app.scrape_url(
    url="https://example.com",
    params={
        "formats": ["markdown"],       # 指定输出 Markdown 格式
        "onlyMainContent": True,       # 过滤非主体内容,提升信噪比
    }
)

# 处理并输出结果
if result and result.get("markdown"):
    print("抓取成功,Markdown 内容前500字符:\n")
    print(result["markdown"][:500])
else:
    print("抓取失败或内容为空,请检查 URL 或网络设置。", result)
说明 :scrape_url 方法用于单页抓取。formats 参数决定输出类型,onlyMainContent 是提升内容质量的关键开关。
结果与使用注意事项
预期结果:程序将输出目标网页主体内容对应的 Markdown 文本,通常已去除冗余元素,可直接用于 LLM 提示或存入向量数据库。
适用边界与关键提醒 :
-
适用场景 :信息类网站、文档站、博客等公开可访问的静态或服务端渲染页面。
-
局限性 :
* 需要登录、复杂交互或高强度反爬的网站可能无法抓取。
* 支持 JS 渲染,但对极度复杂或加载缓慢的单页应用(SPA)可能存在局限。
* 自托管模式需自行配置浏览器等依赖环境。
- 合规与成本 :
* Cloud API 有速率和次数限制,大规模抓取需关注配额。
* 必须遵守目标网站的 robots.txt 协议及相关法律法规。
- 版本注意事项 :
firecrawl-pip包的 API 签名可能随版本更新而变化。本文代码基于常见用法,实际开发前务必查阅官方文档核实最新接口。
参考资料
- Firecrawl 官方 GitHub 仓库:https://github.com/firecrawl/firecrawl
- Firecrawl 官方 API 文档:https://docs.firecrawl.dev