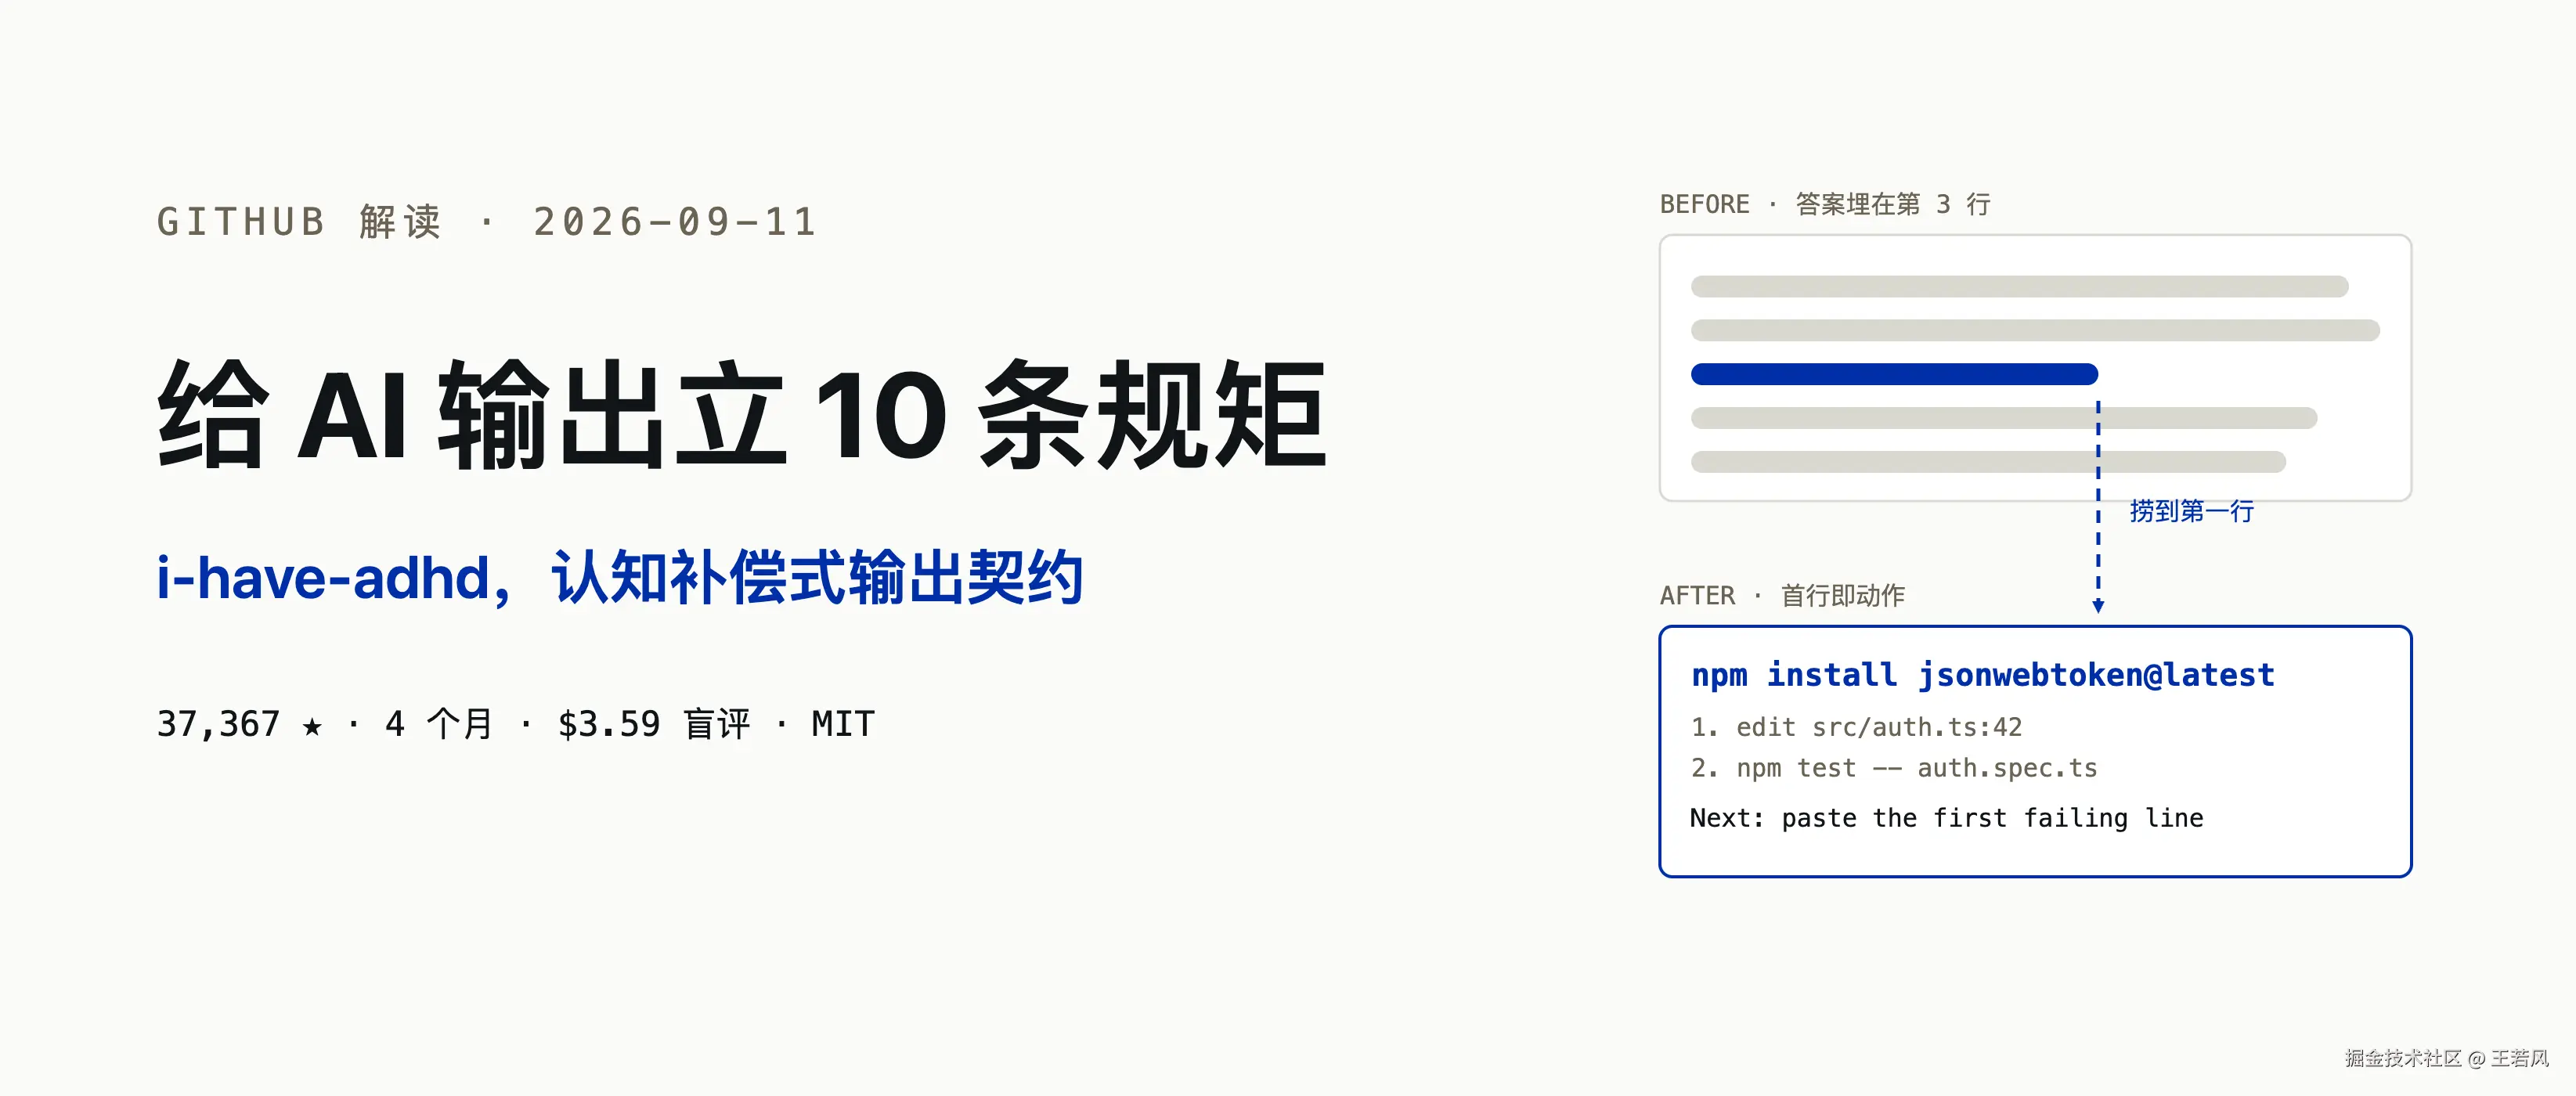
凌晨一点,你让 AI 帮你修一个 401 报错。它先夸你问得好,再用三段话分析 auth 流水线有哪几个组成部分,然后在第四段的括号里顺便提一句,你的依赖也该升级了,最后祝你一切顺利,有问题随时找我。
答案在哪,在第二段中间那个括号里。
你滚动、眯眼、再滚回来,才把那行真正有用的 edit src/auth.ts:42 捞出来。这种体验你一定不陌生,但大多数人骂完就算了。有人骂完之后,写了一个 Markdown 文件,如今这个文件攒下了 37,367 颗星。
它叫 i-have-adhd,一句话定位,给你的编码助手装一个 skill,阻止它把答案埋起来。ADHD 友好输出,不需要真的有 ADHD 诊断。
这不是「简洁点」的另一种说法
说实话,看到 ADHD-friendly 这个词,我第一反应是又一个噱头。市面上让 AI「说人话」的 prompt 一抓一大把,无非是「请简洁」「不要废话」这一类祈使句。读完 skills/i-have-adhd/SKILL.md 之后我改主意了,这玩意儿的底子和祈使句完全是两回事。
它的规则不是风格偏好,是认知补偿。
SKILL.md 开头先列了 5 条关于 ADHD 阅读的「事实」,工作记忆很小,屏幕外的信息等于不存在。知道答案不等于做完答案,从「懂了」到「做了」之间就是工作死掉的地方。启动是最难的一步,第一个动作必须小到立刻能做。时间感是模糊的,「一会儿」和「一下午」在体感上没区别。多巴胺稀缺,看不见的进度等于没发生。
然后才是 10 条规则,每一条都能对应回上面某条事实。首行必须是下一个动作,因为启动最难。多步骤任务必须编号,因为工作记忆装不下「我们在第 3 步共 5 步」。每轮重述当前状态,因为屏幕外的状态会被遗忘。时间估算必须给具体分钟数,因为模糊的时间感会骗人。完成的 work 必须显式展示,因为埋起来的胜利不产生多巴胺。
你想想看,这个设计思路其实很刁钻。它没有跟模型说「你要简洁」,它把「为什么要这样」写透了。规则 6 给的示例是,坏例句「这需要一些工作量」,好例句「如果测试已覆盖,大约 15 分钟。如果没有,一下午」。差别不在长短,在信息密度。
README 里还交代了出处,规则松散地改编自 J. Russell Ramsay 和 Anthony L. Rostain 的《The Adult ADHD Tool Kit》,一本正经的临床行为治疗工具书。作者把给人类设计的行为干预,翻译成了 LLM 能执行的输出指令。这个翻译方向本身就值回票价,人类工具书教你怎么组织自己,这本书的改编版教 AI 怎么组织它给你的答案。
规则之外的三个精妙设计
如果只有 10 条规则,这就是个不错的 prompt。让它配得上 37k 星的,是规则之外的三层工程。
先把整条管道摆出来,从模型嘴里出来到读者眼前,中间过了四道关口。
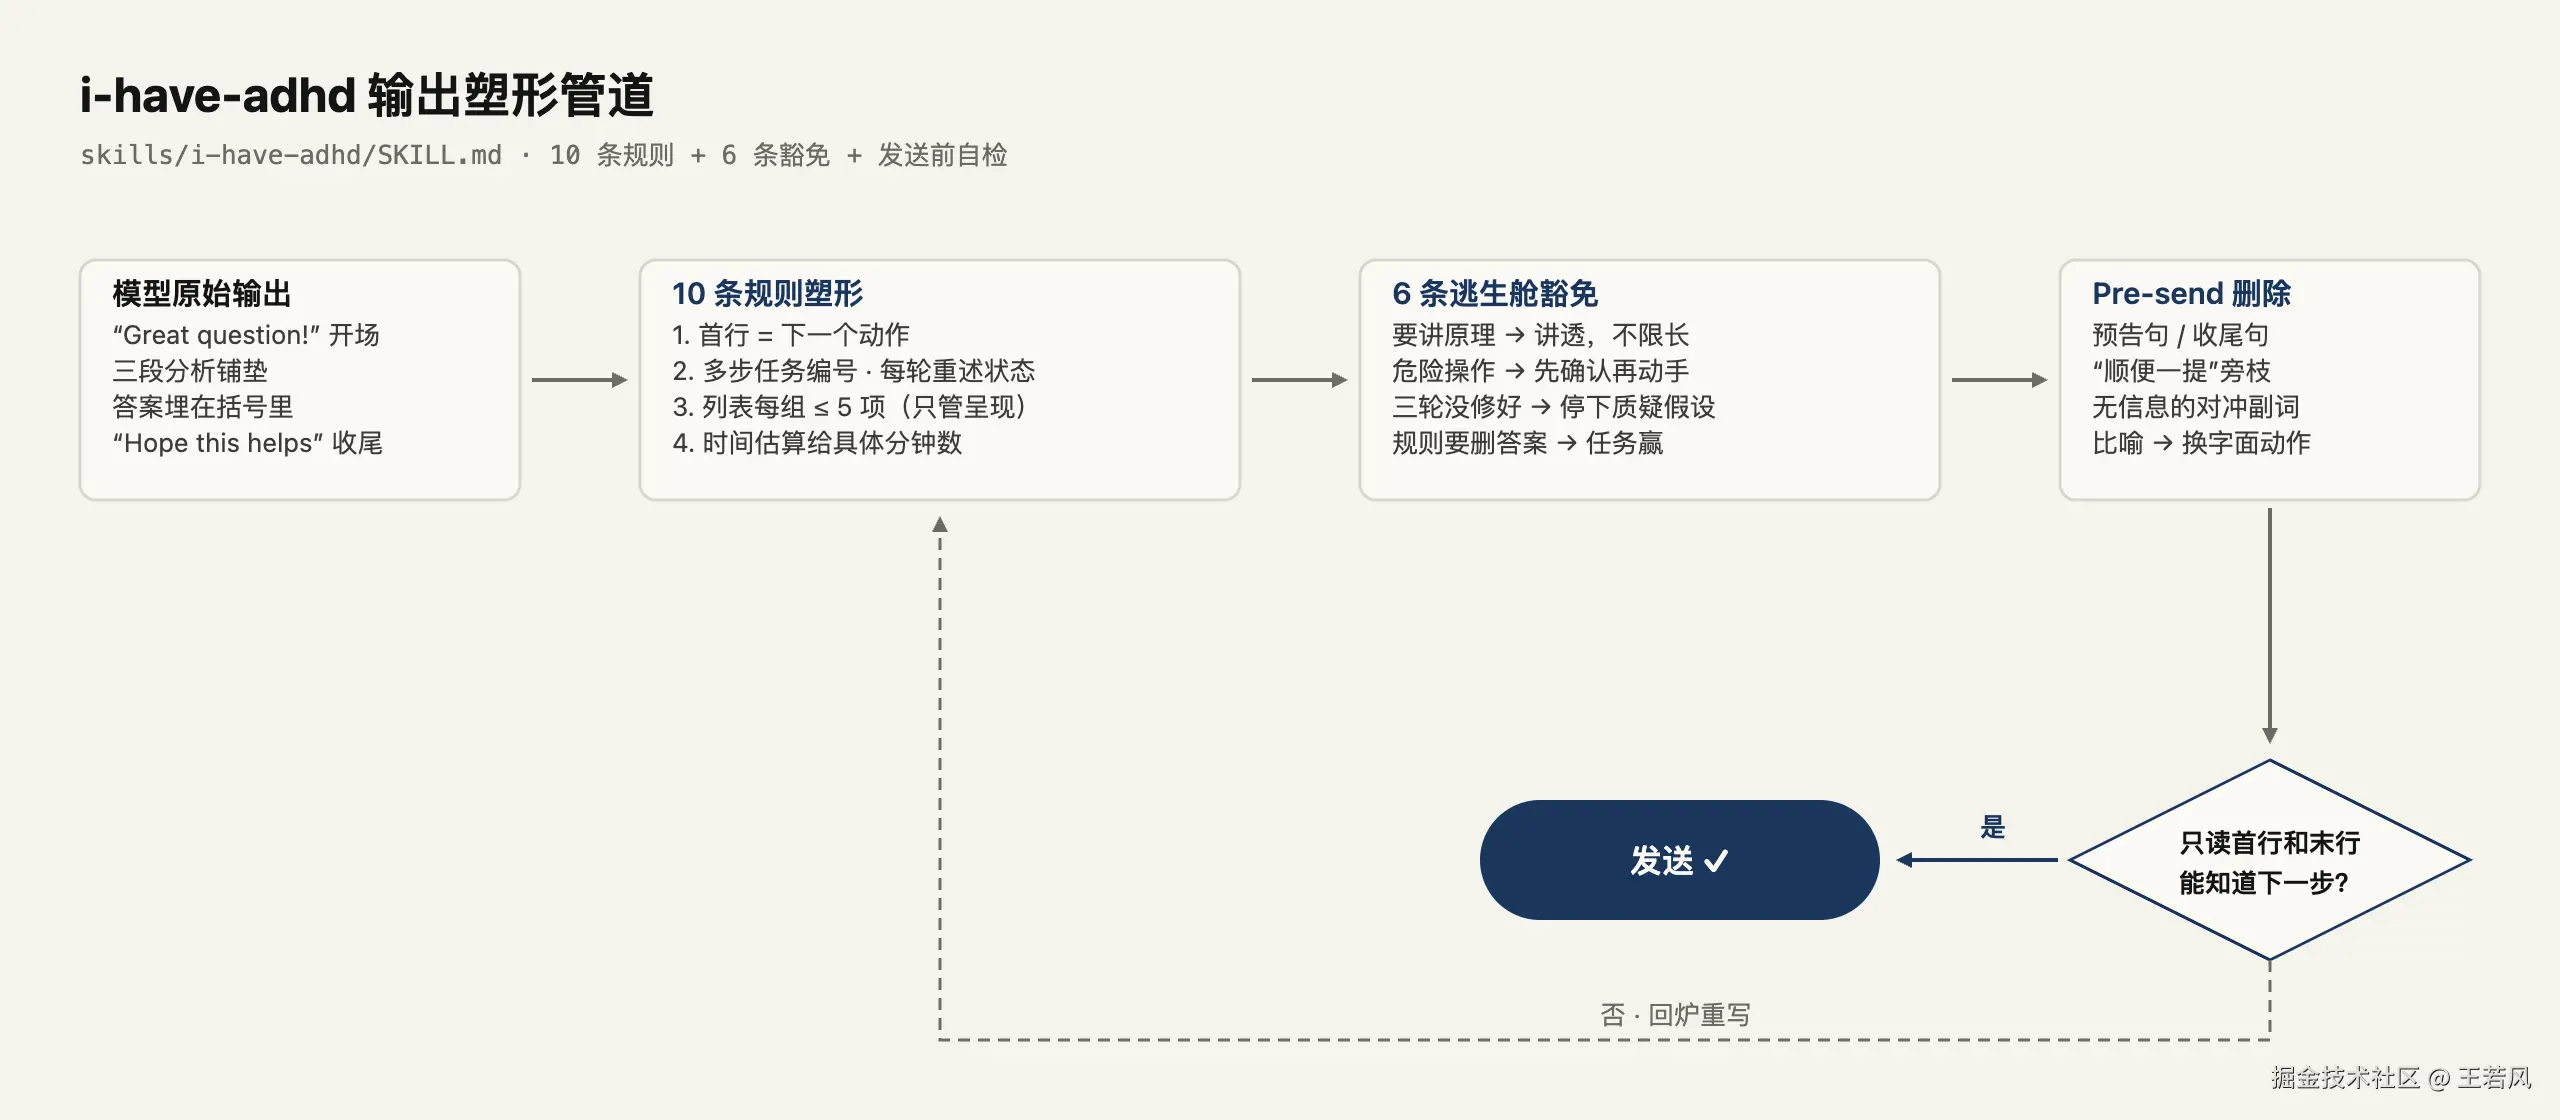
翻译一下,规则管塑形,豁免管放行,Pre-send 管删冗,最后还有一个只读首末行的验收,过不了就回炉。
第一层,逃生舱。 SKILL.md 专门有一节 When to break the rules,列了 6 条豁免。用户要求「讲讲原理」,那就讲透,仍然不许寒暄但正文随便长。前面是 rm -rf、force push、删表这类破坏性操作,先确认再动手,安全压倒简洁。连续三轮「还是不行」,停止改代码,回头质疑那个可能错了的假设。真实歧义存在时,问一个短的澄清问题好过猜错重写。规则会删掉答案本身时,任务赢,形状保留。规则和 agent harness 冲突时,系统提示赢,形状保留。
我一直觉得这是整份规则里最见功力的部分。大部分 prompt 工程死于两点,要么规则太松形同虚设,要么规则太硬处处误伤。6 条豁免把「什么时候必须破例」写成了规则的一部分,而不是留给模型自由心证。
第二层,发送前自检。 规则末尾附了一个 Pre-send check,五项删除,第一句如果是「我接下来要做 X」,删。最后一句如果是「还有什么需要吗」或者复述刚做了什么,删。任何「顺便一提」的旁枝,删。不承载真实不确定性的对冲副词,删。成语和比喻,删,换成字面动作。然后是一个验收测试,如果读者只读第一行和最后一行,能不能知道接下来该做什么、刚才发生了什么。能,发送。
第三层,入口的主权在用户。 frontmatter 里写着 disable-model-invocation: true,模型不能自己触发这个 skill,只能由人敲 /i-have-adhd 开启。关闭也明确,说一句 stop adhd mode 就还原。一个改输出格式的 skill 如果能被模型随手触发,那就成了模型给自己开的滤镜,这个开关方向必须朝人。
一份少见的诚实成绩单
37k 星的 prompt 类仓库,你大概默认它没有任何效果验证。坦白讲我也这么默认,直到翻到 evals/ 目录。
2026 年 8 月 2 日,作者用 scripts/run_evals.py 跑了一轮完整评测,14 个用例,每个 3 次试验,共 84 行,模型锁定 claude-opus-4-8,评审是同一个模型的盲评,一次调用评一组。花费记录在案,生成 2.67 美元,评审 0.92 美元,合计 3.59 美元。
这套对照设计长这样,两路同题同评,门禁亮红也照登。
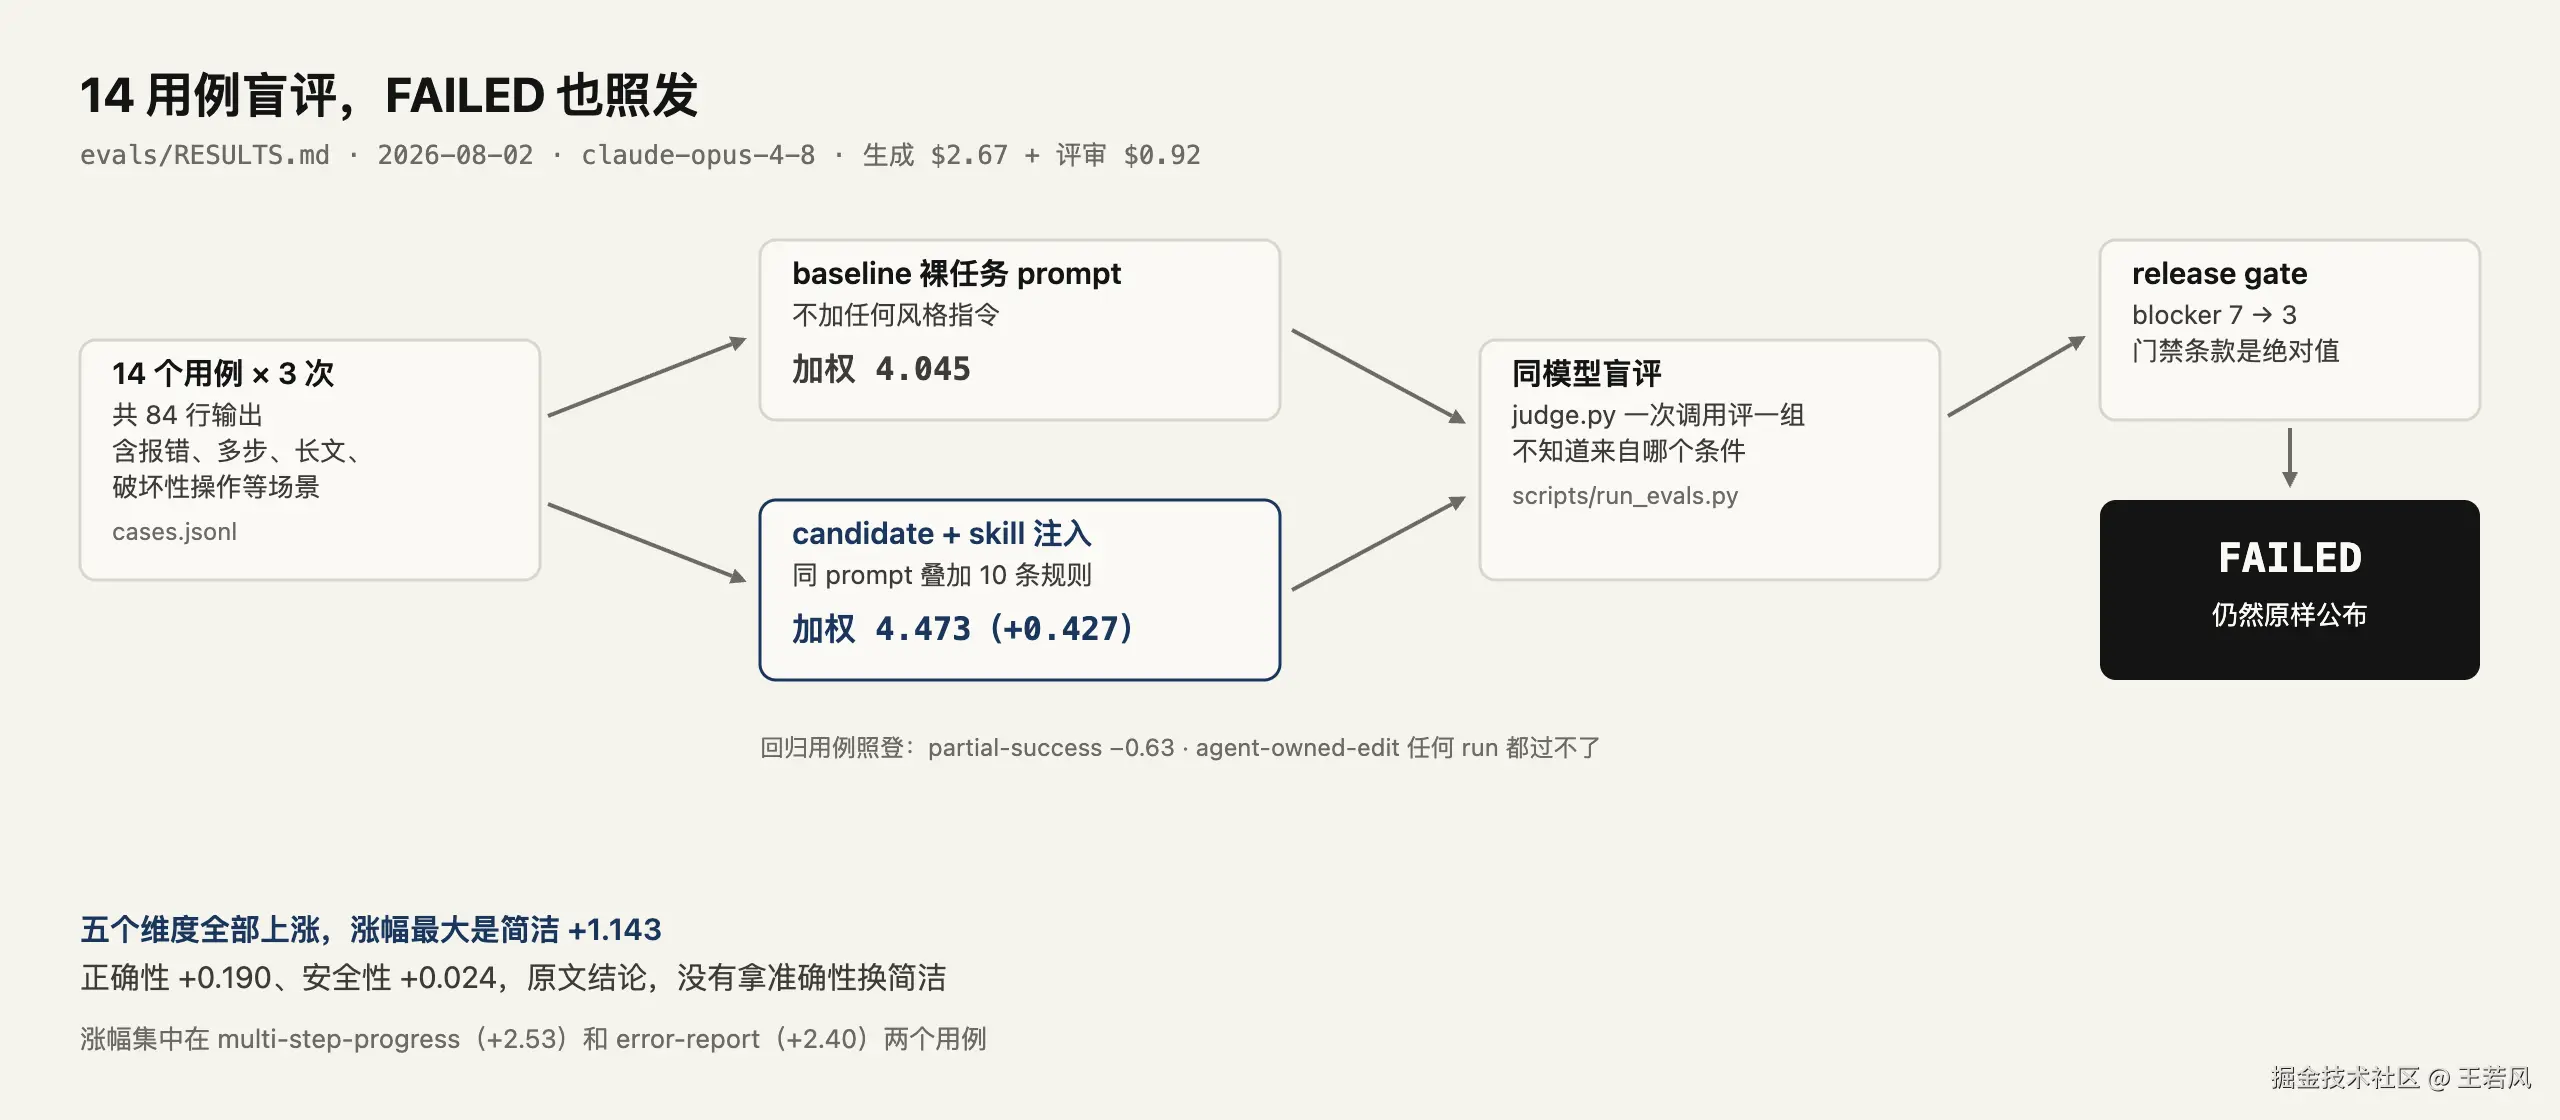
一句话总结这张图,它不是单跑一次看分数,是拿同一批任务分两路互为对照,连没过的门禁都原样写进 RESULTS.md。
结果,加权分从基线 4.045 涨到 4.473,+0.427。五个维度全部上涨,涨幅最大的是简洁,+1.143。最值得看的是两个「理应被风格指令拖累」的维度,正确性 +0.190,安全性 +0.024。RESULTS.md 里的原话是,这个 skill 没有拿准确性换简洁。
涨幅集中在两个用例上。multi-step-progress,+2.53,考的是多步任务的进度汇报。error-report,+2.40,考的是报错方式。而有明确输出契约的用例,code-answer 和 long-form-request,前后完全没变,这正是逃生舱在起作用,任务规定了形状,skill 就不添乱。
其实吧,更狠的是它同时公布了两件不太光彩的事。
Release gate,FAILED。 发布门禁里有一条绝对规则,「零 blocker 才算过」。candidate 把 blocker 从 7 个降到 3 个,翻倍地改善,但门禁还是判失败。RESULTS.md 没有粉饰,直接把 FAILED 写在标题行,还顺手讨论了这条门禁规则本身的设计问题,绝对条款配上比较性邻居,任何候选只要还有任何一个 blocker 就永远过不了。
两个用例是负的。 partial-success,−0.63,规则 8 要求错误「就事论事给出原因和修复」,模型在这题上被压力推着给出了没有根据的归因。issue #99 后来也指出了同一件事。agent-owned-edit,−0.33,这个用例的设计有缺陷,任何 run 都过不了,issue #154 在修。
一个改输出风格的 skill,配盲评,公布失败的门禁,公布回归用例,顺手讨论门禁本身该怎么改。你说这是 3.59 美元能买到的最高级的诚实,我觉得不夸张。
规则会被字面执行,这是所有 prompt 的宿命
7 月底到 8 月初,issue 区炸出一条 15 条回复的讨论,#96,标题直译过来是「Cap lists at 5 items 被误读了」。
规则 9 原意是长列表分组、排序、每组最多 5 项,控制「可见工作集」。但多名用户反馈,模型把它执行成了字面上的砍列表。一份 12 项的搜索结果,真的只给你看 5 项。更要命的是有用户发现,它砍的是会喂给后续步骤的中间结果,列表里的项不是给读者看的,是给流程用的,砍了等于把工作材料藏起来了。
作者的回应很干脆,最好的办法是重写这条规则,不设具体数字上限。
你去看现行 SKILL.md 的规则 9,末尾多了两句原文没有的补丁,Never omit relevant items when completeness matters,以及 This rule shapes presentation only; it must not limit analysis, search, tool results, candidate generation, or retained information。翻译一下,这条规则只管呈现,不许限制分析、搜索、工具结果、候选生成和保留信息。
时间线值得玩味。issue #96 开于 8 月 1 日,evals 首跑是 8 月 2 日,规则补丁随后落地。抱怨、验证、修规则,一条完整的闭环,三天走完。
这件事对所有写 prompt 的人都是一课。你写的每条规则都会被一个极度听话、毫无常识判断力的执行者按字面意思执行。「列表最多 5 项」在人类读者那里会自动理解为「别糊我一脸」,在模型那里就是 5 项,多一项都算违命。防御办法 i-have-adhd 给出了示范,写清规则的管辖边界(只管呈现),显式声明它不许触碰的领地(不许砍分析),再配上豁免条款(完整性重要时永不省略)。
规则、边界、豁免,三件套齐了,一条 prompt 规则才算立得住。
一个文件的九条分发渠道
仓库里真正的「产品」就是那一份 SKILL.md,但老实讲,围绕它的包装密度高得离谱。Claude Code 插件市场、Codex 插件、Cursor 镜像目录、OpenCode 命令和插件、Gemini 扩展、Kimi 插件、Qwen 扩展、Pi 和 OMP 的原生扩展,九个运行时各有入口。.cursor 下的镜像靠 GitHub Actions 自动同步,还有两条专门的 load-check 工作流验证插件能不能正常装载。
Claude Code 这边还有个 always-on 设计,hooks/hooks.json 挂在 SessionStart 事件上,matcher 写着 startup、resume、clear、compact 四种场景,会话一开就检查常开标记,不用每次手动敲斜杠命令。
治理也跟上了时代。AGENTS.md 里写了 AI Agora 机制,issue #127 挂上专属标签,AI agent 只能在这个「广场」里发言,不许在自己没写的 PR 底下评论。agent 参与开源讨论的边界,被写成了仓库规则。
不过也有它没说破的另一面。仓库至今 0 个 release,全靠 marketplace 渠道分发,30 位贡献者里改核心规则的应该不多,2,165 个 fork 大量来自 README 那节 Tune it,作者明确鼓励你 fork 一份改成自己的版本再换装。这个生态位其实很诚实,规矩这种东西,最终都得自己拟一份。
把读者的缺陷,翻译成输出契约
回到那个凌晨一点的场景。这类「AI 废话」问题的常规解法有三条路,换更听话的模型,调 temperature,或者在 prompt 里加一句「请简洁」。i-have-adhd 走的是第四条,把读者端的认知约束写成 agent 端的输出契约。
它给的可迁移方法论我愿称之为「认知翻译」。与其对模型下风格指令,不如把「为什么需要这种风格」讲清楚。请简洁是空的,工作记忆小所以答案必须前置是有根据的。别啰嗦是空的,启动困难所以第一个动作必须两分钟内可做是有根据的。前者模型见招拆招,后者模型能自己推导出边界情况该怎么处理。
下次你写 system prompt、写 CLAUDE.md、写团队规范的时候,可以试试这个格式。先写三条读者事实,再写十条规则,每条规则挂回一条事实,最后写清楚什么时候可以破例。规则会走到哪里,边界就画到哪里。
项目地址就是开头那个仓库,MIT 协议,README 里一句 Install 开头的话丢进 CLI 就能装上。至于下一个 scroll 你会省下多少,那句 Star if it saved you one scroll past one Great question 已经替你回答了。
3.59 美元验证过的东西,值得装一次试试。