一、搜"node 工作流引擎",你会先搜到什么
场景很常见:一个 Node / TypeScript 服务(中台、内部系统、全栈应用),产品说要加审批流。请假、报销、采购,单子从申请人出发走到部门领导,复杂一点的要会签、按比例通过、退回发起人改材料、抄送一把手。
你去搜 node workflow,会搜到 n8n(可视化工作流自动化平台)、BullMQ(Redis 任务队列),再往外还有 Temporal、Camunda 的 Node 客户端。这些名字都很强,但花一个下午读下来你会发现,它们的主场分别是自动化编排 和长时任务 / 分布式状态机------把它们请进一个 CRUD 系统审批三张单子,等于为了批三张单子,先部署一套独立平台、再学一套 workflow-as-code。
而你真正想要的,其实是件小事:一段 OA 审批语义,嵌进自己的 Node 服务,用自己已有的 MySQL 或 PostgreSQL,配一个能画流程的前端------最好是前后端一个语言。
jeeflow 就是做这件小事的引擎:串行/并行/按比例会签、一票否决、退回发起人、委托代理、抄送------这套审批语义,引擎核心自己扛。它已经在 Java/Go/Python/Node/PHP/Rust/MoonBit/C# 八门语言上各有一份实现,同一份 LogicFlow 流程 JSON 八门语言通用。
先把"它不是什么"说清楚,省得你装错:
- 不是 BPM / 自动化平台:不带用户体系、不带表单引擎,审批人是谁要你接一个用户接口告诉它;
- 不带 UI :但有配套开源前端 jeeflow-ui,
?lang=node直连 Node demo 可用; - 数据库支持 MySQL / PostgreSQL :内存仓储开箱即用(测试 / 内嵌场景),生产走
/jdbc子路径(驱动是可选依赖,下面讲); - 不碰你的业务表:表单数据落哪张表、哪些字段谁可见,由你配置,引擎只管流程本身。
对 Node 开发者最有感的一句:这个包的 dependencies 区是空的。装它就一行:
bash
npm install @mldong/jeeflow下一节直接跑,零依赖这件事我会在第四节单独拎出来讲。
二、npm i 一行,5 分钟跑通一条审批流
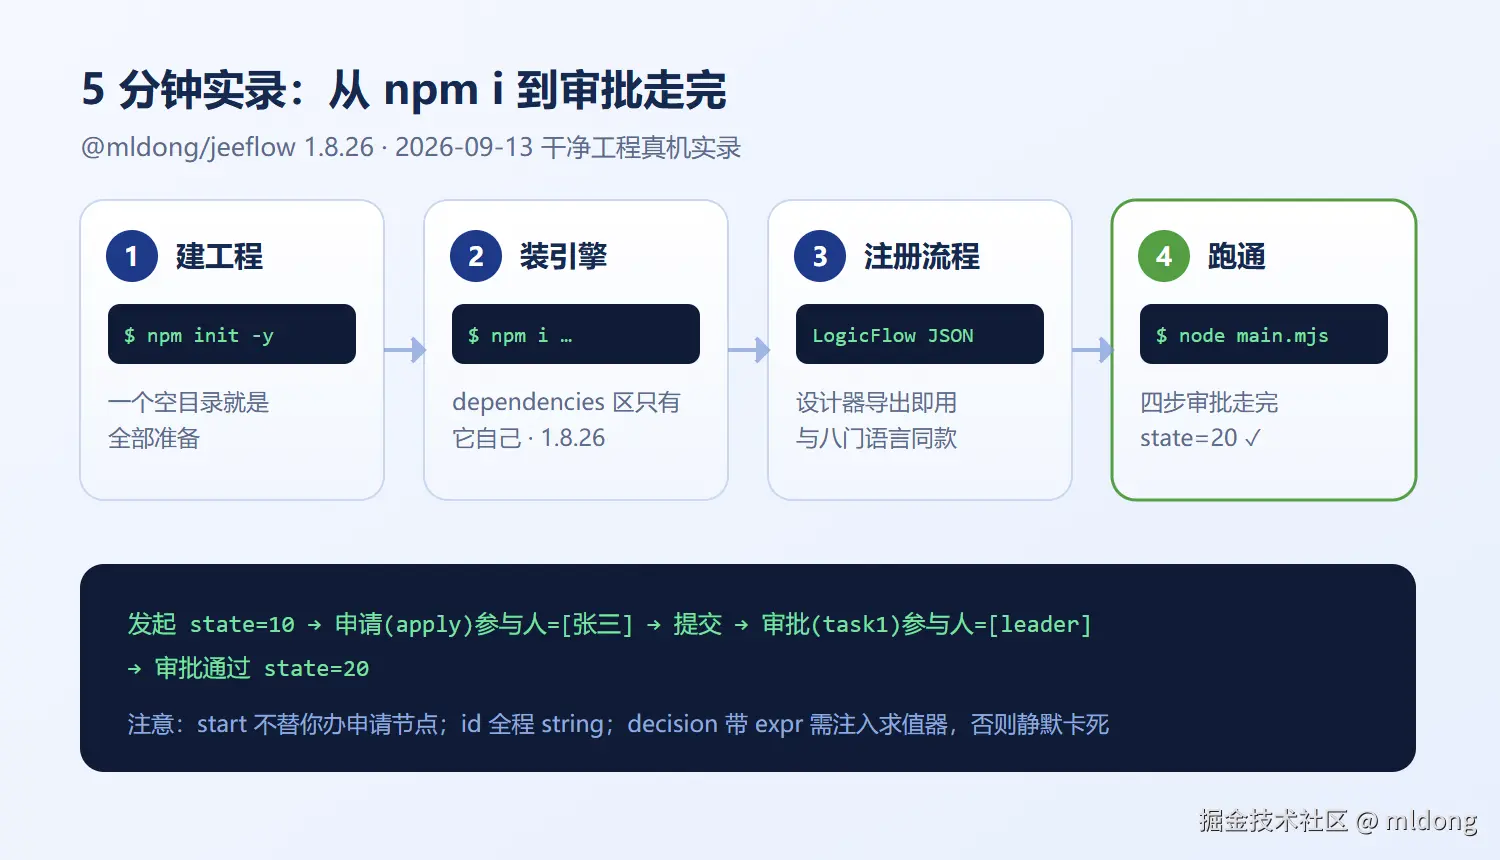
光说不练是伪代码,下面是一个全新工程 的真实记录------npm init 之后从 npm 拉 @mldong/jeeflow,到一条请假审批走完,全程 5 分钟。
bash
$ npm install @mldong/jeeflow
added 27 packages in 2s
先看一眼 package.json------dependencies 区只有它自己:
json
{
  "type": "module",
  "dependencies": {
    "@mldong/jeeflow": "^1.8.26"
  }
}
等一下,上面明明说 added 27 packages,怎么 dependencies 只有一行?别急,这个 27 是诚实的账,我第四节拆给你看。先把流程跑通。
流程用联邦共享测试资产里最简单的一条(01-simple.json,这里裁掉画布坐标展示骨架,设计器导出的完整文件原样也能用):开始 → 申请(assignee=applicant)→ 上级审批(assignee=leader)→ 结束。
完整代码如下,一个 .mjs 文件能跑:
js
import { EngineImpl, MemoryRepository } from '@mldong/jeeflow'

// flows/01-simple.json 裁掉画布坐标后的骨架
const simpleFlow = {
  name: 'simple', displayName: '简单审批流程', type: 'approval',
  nodes: [
    { id: 'start', type: 'snaker:start', properties: {} },
    { id: 'apply', type: 'snaker:task', properties: { assignee: 'applicant', taskType: 0, performType: 0 }, text: { value: '发起申请' } },
    { id: 'task1', type: 'snaker:task', properties: { assignee: 'leader', taskType: 0, performType: 0 }, text: { value: '上级审批' } },
    { id: 'end', type: 'snaker:end', properties: {} }
  ],
  edges: [
    { id: 'e0', sourceNodeId: 'start', targetNodeId: 'apply', properties: {} },
    { id: 'e1', sourceNodeId: 'apply', targetNodeId: 'task1', properties: {} },
    { id: 'e2', sourceNodeId: 'task1', targetNodeId: 'end', properties: {} }
  ]
}

const repo = new MemoryRepository()
const engine = new EngineImpl(repo)

async function printDoing(instId) {
  const ts = await repo.findDoingTasks(instId)
  if (ts.length === 0) return console.log('    待办: (无,流程已结束)')
  for (const t of ts) console.log(`    待办: 任务id="${t.id}" 节点=${t.taskName}(${t.displayName}) 参与人=[${t.actorIds}]`)
}

// 1. 注册流程定义(id 留空,看 memory 仓储自动分配)
const def = { name: 'simple', displayName: '简单审批流程', type: 'approval', state: 1, content: JSON.stringify(simpleFlow) }
repo.addDefine(def)
console.log(`[1] 流程定义已注册 id="${def.id}"(id 留空,memory 仓储自动分配)`)

// 2. 张三发起流程
const inst = await engine.startProcessInstanceById(def.id, '张三')
console.log(`[2] 张三 发起流程:实例id="${inst.id}" state=${inst.state}`)
console.log('    注意:start 不会替你办申请节点------')
await printDoing(inst.id)

// 3. 张三完成申请节点
let doing = await repo.findDoingTasks(inst.id)
const inst2 = await engine.executeProcessTask(doing[0].id, '张三')
console.log(`[3] 张三 提交申请:state=${inst2.state}`)
await printDoing(inst.id)

// 4. leader 审批 → 流程结束
doing = await repo.findDoingTasks(inst.id)
const inst3 = await engine.executeProcessTask(doing[0].id, 'leader')
console.log(`[4] leader 审批通过:state=${inst3.state}(10进行中 20已结束 45已驳回)`)
await printDoing(inst.id)
node main.mjs 的真实输出:
text
[1] 流程定义已注册 id="1"(id 留空,memory 仓储自动分配)
[2] 张三 发起流程:实例id="1789300357862183" state=10
    注意:start 不会替你办申请节点------
    待办: 任务id="1789300357862497" 节点=apply(发起申请) 参与人=[张三]
[3] 张三 提交申请:state=10
    待办: 任务id="1789300357864750" 节点=task1(上级审批) 参与人=[leader]
[4] leader 审批通过:state=20(10进行中 20已结束 45已驳回)
    待办: (无,流程已结束)
四步,一条审批流走完。注意实例 id 和任务 id 都是带引号的字符串 ("1789300357862183"),不是数字------这不是我打印格式的问题,是引擎的硬约定,下面第四节展开。几个真实细节值得停一停:
new EngineImpl(repo) 一个参数就够 :构造函数签名是 (repo, userProv?, idGen?, exprEval?),后面三个 SPI 全可省。不传 id 生成器,实例 id 退化成 Date.now() * 1000 + 随机三位(所以你看到 16 位、毫秒时间戳起步);不传表达式求值器,简单线性流程照样跑(条件分支 decision 节点才需要,见下文的坑)。生产环境建议注入自己的 id 生成器,雪花 id 跨语言同库共享不撞。
参与人=[张三] 是引擎解析出来的 :申请节点上写的 assignee: "applicant" 是 mldong 契约的特殊值,引擎建任务时把它解析成流程发起人;assignee 里写 ${变量}、逗号分隔多人都认,还支持注册 assignmentHandler 按名字取人(部门领导这种要查组织架构的场景)。
两个我亲手踩的坑,给你垫上:
第一个,start 不会替你办申请节点。张三 startProcessInstanceById 之后,第一张待办是"发起申请",停在张三自己桌上------你要再 executeProcessTask 一次才算真正提交。这是刻意设计(mldong 契约的 applicant 约定:申请节点也是节点,退回发起人时它就是退回的目的地),但第一次用很容易以为发起=已提交。上面的输出里我特意把这一步打出来了。不想记这步?走下一节的统一门面,startAndExecute 帮你把"发起 + 办申请"合成一步。
第二个,decision 节点带表达式、却没配求值器,单子会静默卡死 ------不报错、不前进,就杵在那。我拿一条 amount > 1000 的分支流程、不传 exprEval 发起,真实结果是:
text
state=10,待办数=0(静默停在决策节点,无报错)引擎在求值那条边时发现 exprEval 没配,就什么都不做 ------不抛错、不沿无表达式边兜底前进。对一条你测过的线性流程这不会发生,但哪天加了个条件分支、又忘了配求值器,单子就"凭空消失"了:发起方看到 state=10,待办列表却空着。用条件分支,记得给 new EngineImpl(repo, userProv, idGen, exprEval) 把第四个参数填上;最省心的姿势是走统一门面,它会按你配的求值器跑。
越权会被引擎直接拦住 (这是 Node 实现的一个特点)。我新开一单张三发起,第一张待办参与人是张三,然后让 leader 去批------
text
越权批别人的单:operator leader not allowedNode 引擎在 executeProcessTask 内部就做了参与人硬校验(actorIds.includes(operator)),非参与者直接抛错。和 Go 实现"引擎只解析、参与人校验放在门面/应用层"的分工不同,Node 这一层是物理闸门------直接调引擎方法也躲不掉。
边界报错长什么样(引擎层原生错误,负向实测):
text
重复审批同一单:  task not doing
审批不存在的任务:task not found: 99999999
用不存在的定义发起:define not found: 42
三、生产姿势:换数据库仓储、上统一门面
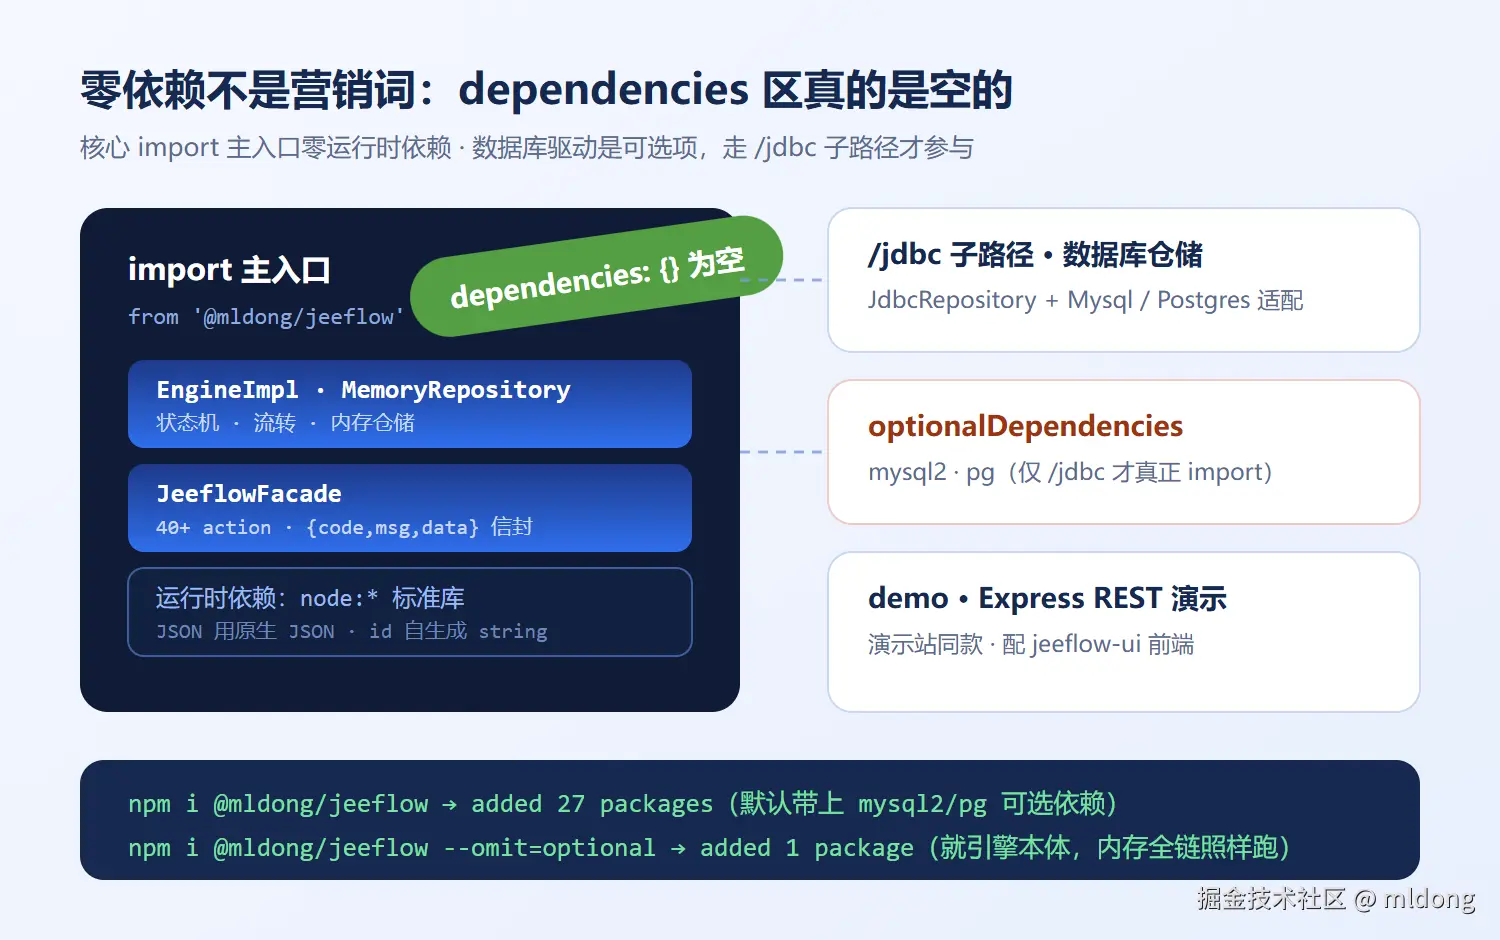
内存仓储适合测试和内嵌,生产换成数据库仓储。Node 版同时给了 MySQL 和 PostgreSQL 两个适配,都从 /jdbc 子路径进:
ts
import mysql from 'mysql2/promise'
import { JdbcRepository, TsIDGenerator, MysqlAdapter } from '@mldong/jeeflow/jdbc'

const pool = mysql.createPool({
  host: 'localhost', user: 'root', password: '***', database: 'wf',
  supportBigNumbers: true,
  bigNumberStrings: true,   // ⚠️ 必须:雪花 id > 2^53,不配这个 mysql2 默认转 number,驱动层就丢精度
})
const repo = new JdbcRepository(new MysqlAdapter(pool), new TsIDGenerator())
bigNumberStrings: true 这一行不是可选项------BIGINT 列的雪花 id 超过 2^53,mysql2 默认会转成 number,精度在驱动层就已经丢了,等引擎拿到手时 id 早就不对。PostgreSQL 的 int8 默认就以字符串返回,没有这个要求。表结构是 wf_ 前缀五张表,和 Java 版完全一致。
再往上,如果你不想记引擎的方法名,直接用统一门面------这是 mldong 系框架接工作流的标准姿势,40+ 个 action、一个入口:
js
import { JeeflowFacade } from '@mldong/jeeflow'

const facade = new JeeflowFacade(engine, repo)

// 发起并自动完成申请节点(startAndExecute = start + 办申请)
const r = await facade.flow('processDefine/startAndExecute', { processDefineId: def.id, operator: 'user1' })
facade.flow(action, args) 返回统一的 {code, msg, data} 信封。真实的返回长这样:
json
startAndExecute => {"code":0,"msg":"成功","data":{"processInstanceId":"1789300357866204"}}leader 查自己的待办列表(processTask/todoList,operator 过滤):
json
{"code":0,"msg":"成功","data":{"pageNum":1,"pageSize":10,"recordCount":1,"totalPage":1,
  "rows":[{"id":"1789300357866700","processInstanceId":"1789300357866204","taskName":"task1",
"displayName":"上级审批","taskState":10,"createTime":"2026-09-13 19:52:37", ...}]}}两个契约细节,跨语言都一样:code:0 是成功(失败是 99999999);ID 全部字符串化 ("1789300357866204")。这个"全部字符串化"在 Node 里尤其要当回事------我故意把一个超 2^53 的雪花 id 用 number 类型传进门面,看它怎么回:
js
await facade.flow('processTask/detail', { id: 2096621342496391168 })
// => {"code":99999999,"msg":"id 2096621342496391200 超出 float64 精确范围(2^53),请以字符串传递"}
注意报错里那个 id 是 ...1200,不是我传的 ...1168------JS 的 number 在 JSON 解析那一刻就已经把末尾四舍五入了,精度在引擎看到之前就丢了。引擎检测到这种"数字 id 且超 2^53"的组合会显式报错 ,而不是 String() 静默截断成一个错误的 id 继续往下跑。这是整个联邦吃过前端丢精度亏之后统一钉死的约定,Node 版把它做成了硬校验------前端传 id,老老实实当字符串传。
40+ 个 action 覆盖流程定义部署/版本管理、发起、审批、跳转、撤回、委托代理、抄送、候选人、高亮路径、审批记录,以及统计三件套(overview/trend/group)。名字全部带斜杠前缀按资源分组(processDefine/、processTask/、processInstance/...),和一个 HTTP 风格的 Express demo(demo/ 目录)------演示站就是它跑出来的:
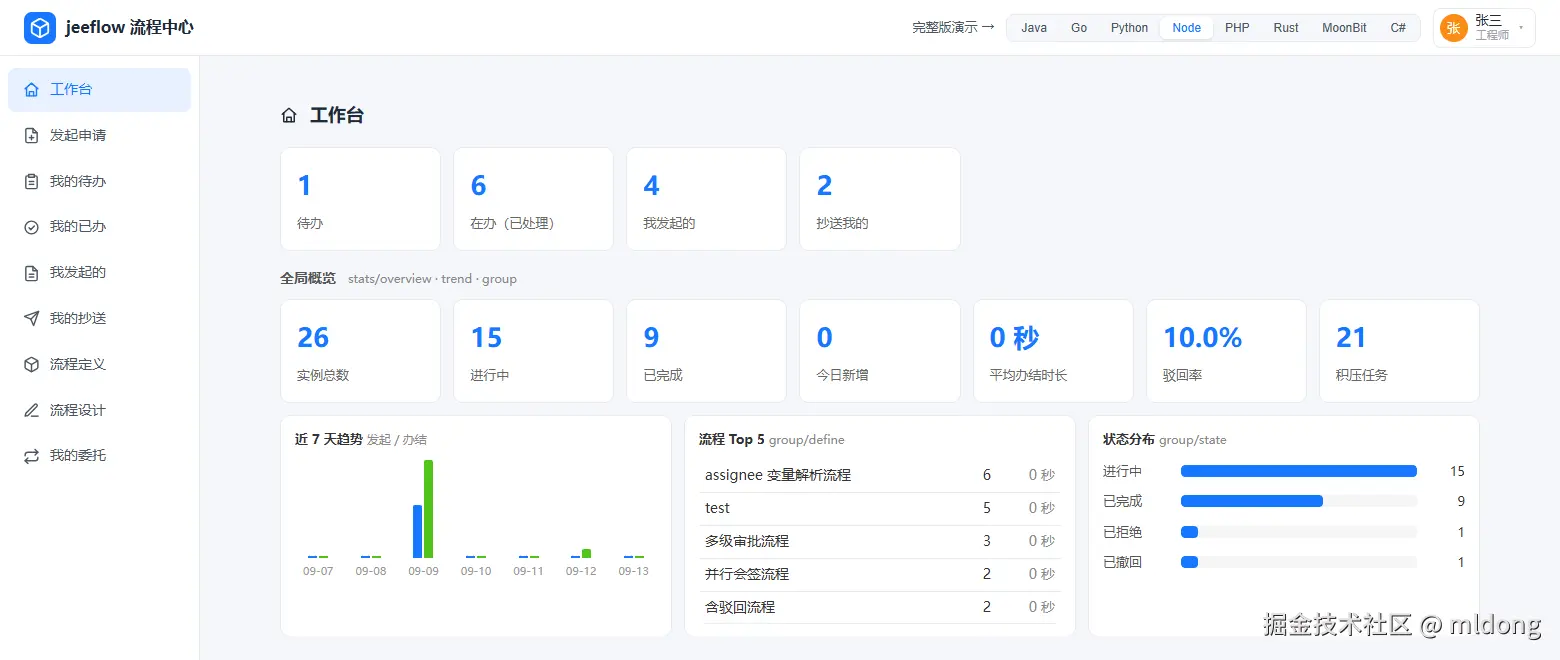
想先玩再装:jeeflow-demo.mldong.com/?lang=node (右上角可以切八门语言后端,前端是同一个)。
四、零依赖不是营销词:dependencies 区真的是空的
这一段把第二节的"27 packages"账拆掉,也是这一篇和 C#/Go 篇最大的不同。
先回到那个反直觉的数字:npm install @mldong/jeeflow 报 added 27 packages,但 package.json 的 dependencies 只有一行。查 registry 元数据:
bash
$ npm view @mldong/jeeflow dependencies
# (空)
$ npm view @mldong/jeeflow optionalDependencies
{ mysql2: '^3.11.0', pg: '^8.13.0' }
dependencies 是真的空 ------引擎核心(EngineImpl / MemoryRepository / JeeflowFacade,也就是 import { ... } from '@mldong/jeeflow' 主入口给你的东西)运行时零第三方依赖,import 的全是 node: 标准库。那 27 个包是哪来的?是 npm 把它声明的可选依赖 (optionalDependencies 里的 mysql2 / pg 及其传递依赖)默认一起装上了。换句话说,你为"用 MySQL"这件事预先付了 26 个包的体积,哪怕你压根只用内存仓储。
验证一下"不装数据库驱动也能跑":
bash
$ npm install @mldong/jeeflow --omit=optional
added 1 package in 2s
added 1 package------就引擎本体一个,内存仓储全链(第二节那四步)照样跑通。
这比 Go 篇说的"编译期零第三方"更狠一档:Go 是按包裁剪、不进二进制;Node 是运行时 dependencies 区就是空的 ,数据库驱动是可选的,你 import 主入口就一点数据库代码都拉不进来。只有当你真的 import ... from '@mldong/jeeflow/jdbc' 时,mysql2/pg 才真正参与运行时。
五、同一份流程 JSON,八门语言都能跑
这一段给不熟悉这个系列的新读者,老读者可以跳过。
jeeflow 是一个多语言联邦:Java 是参考实现,Go/Python/Node/PHP/Rust/MoonBit/C# 各有一份对齐实现,八门语言共享同一套流程定义 JSON(15 个模板,从最简单的线性审批到会签+分支+委托混合模式)、同一套 {code,msg,data} 契约、同一组状态码语义。升级走"参考实现先行 + 契约测试对齐",Java 发了新能力,各语言在下一版跟上。
对 Node 用户的实际意义,有两层。第一层是不锁语言 :今天服务是 Node,明天加一个 Java 或 Python 服务,流程定义原样搬走,审批记录里的状态码一个都不用改。第二层是这一篇的主打------前后端一门语言 :前端 Vue + 后端 Node/TS,设计器导出的那份 LogicFlow JSON,前端直接当数据渲染高亮路径和审批记录,Node 后端直接当流程定义喂给引擎,同一份结构在两个运行时里都是原生 JSON,连 id 都是 string(前端 Number() 一转换精度就没了的那类坑,引擎已经从根上替你挡了)。
测试基线(写稿当日 npm test 实测):80 个用例全绿,含引擎合规场景、门面契约、统计回归。
六、什么时候用它,什么时候别用
最后摆正预期,这张表比任何吹捧都有用:
| 你的需求 | 建议 |
|---|---|
| Node/TS 服务里嵌审批流:请假/报销/采购,会签、退回、委托、抄送 | 正解。五张表 + 一个用户 SPI + 一个门面,jeeflow-ui 直连可用 |
| 全栈 TS:前端 Vue、后端 Node,想要前后端一个语言 | 正中靶心。同一份 LogicFlow JSON 前端渲染、后端跑引擎,id 全程 string 天然对齐 |
| 前端还没有流程设计器 | 用 jeeflow-ui(开源,Vue3),?lang=node 就是给 Node 后端留的档位 |
| 多语言技术栈,流程定义要共用 | 同一份 LogicFlow JSON 八门语言跑,迁移引擎/混合栈不锁语言 |
| 长时编排、任务重试、Saga 补偿、跨服务状态机 | 别用,去 Temporal/n8n,它们是那个赛道的 |
| 数据库不是 MySQL/PostgreSQL | 自己实现 ProcessRepository SPI(接口在 /spi,内存仓储可参考,几百行的事) |
npm install @mldong/jeeflow,Apache-2.0,引擎核心运行时零第三方依赖、数据库驱动按需可选。装之前想先玩,演示站在跑着;想看代码,仓库和文档站都在下面。
审批流的复杂度,值得一个 import 就能带走的引擎来扛,而不是一套独立的编排平台。
参考资料
@mldong/jeeflow仓库(2026-09-13 核对):npm 当前版本 1.8.26(2026-09-09 发布);引擎核心主入口dependencies为空、mysql2/pg为optionalDependencies;40+ action 统一门面见仓库src/facade.ts;id 全程 string、toId对超2^53的 number 显式报错;测试矩阵 80 用例(npm test当日实测)- 系列前篇:第 3 篇《工作流引擎的"灵魂":状态机与 submitType》、第 6 篇《"applicant" 契约:退回发起人的闭环设计》、第 17 篇《C# 开发者也有自己的轻量工作流引擎了》、第 18 篇《Go 开发者也有自己的轻量工作流引擎了》
- Node 在线演示站(可直接玩):jeeflow-demo.mldong.com/?lang=node
- GitHub 仓库:github.com/mldong/jeef...
- npm 包:www.npmjs.com/package/@ml...
- jeeflow-ui 前端仓库:github.com/mldong/jeef...
- 文档站:jeeflow-doc.mldong.com
- 开源演示站:jeeflow-demo.mldong.com
- 集成演示站:jeeflow-pro.mldong.com