目录
[1. 范式裂变:从单步即出到强化学习慢思考的本质跃迁](#1. 范式裂变:从单步即出到强化学习慢思考的本质跃迁)
[1.1. 快思考与慢思考:两种大模型生成架构的根本分野](#1.1. 快思考与慢思考:两种大模型生成架构的根本分野)
[1.2. 架构代际横评:标准基座模型 vs 纯 Prompt CoT vs DeepSeek-R1 强化学习原生推理](#1.2. 架构代际横评:标准基座模型 vs 纯 Prompt CoT vs DeepSeek-R1 强化学习原生推理)
[2. 算力账本透视:长链条推理引发的显存雪崩与量化权衡](#2. 算力账本透视:长链条推理引发的显存雪崩与量化权衡)
[2.1. 显存账本穿透:权重驻留 vs KV Cache 几何级数膨胀](#2.1. 显存账本穿透:权重驻留 vs KV Cache 几何级数膨胀)
[2.2. 蒸馏模型规格横评:7B、14B、32B 在企业级场景下的选型坐标](#2.2. 蒸馏模型规格横评:7B、14B、32B 在企业级场景下的选型坐标)
[2.2.1. DeepSeek-R1-Distill-Qwen-7B(轻量边缘与高敏捷场景)](#2.2.1. DeepSeek-R1-Distill-Qwen-7B(轻量边缘与高敏捷场景))
[2.2.2. DeepSeek-R1-Distill-Qwen-14B(综合性价比之王)](#2.2.2. DeepSeek-R1-Distill-Qwen-14B(综合性价比之王))
[2.2.3. DeepSeek-R1-Distill-Qwen-32B(企业级重型复杂推理核心)](#2.2.3. DeepSeek-R1-Distill-Qwen-32B(企业级重型复杂推理核心))
[2.3. 主流量化方案(FP16 vs AWQ 4-bit vs GGUF)多维损益决策矩阵](#2.3. 主流量化方案(FP16 vs AWQ 4-bit vs GGUF)多维损益决策矩阵)
[3. 高性能工程底座:vLLM 引擎核心调优与私网高并发部署](#3. 高性能工程底座:vLLM 引擎核心调优与私网高并发部署)
[3.1. PagedAttention 显存分页管理架构解析](#3.1. PagedAttention 显存分页管理架构解析)
[3.2. 生产级启动配置与 Chunked Prefill 动态批处理实战](#3.2. 生产级启动配置与 Chunked Prefill 动态批处理实战)
[3.3. 统一 OpenAI 兼容 API 网关与业务流水线无缝集成](#3.3. 统一 OpenAI 兼容 API 网关与业务流水线无缝集成)
[4. 生产级踩坑实录与报错排查闭环](#4. 生产级踩坑实录与报错排查闭环)
[4.1. 真实报错现场:长推理递归自循环引发的 CUDA OOM 显存击穿](#4.1. 真实报错现场:长推理递归自循环引发的 CUDA OOM 显存击穿)
[4.2. 根因剖析与最大推理步数截断与显存分配比例自适应调优](#4.2. 根因剖析与最大推理步数截断与显存分配比例自适应调优)
[4.2.1. 致命根因深度定位](#4.2.1. 致命根因深度定位)
[4.2.2. 代码与服务级防御重构方案](#4.2.2. 代码与服务级防御重构方案)
[4.3. 生产高可用防御设计](#4.3. 生产高可用防御设计)
[5. 总结与展望:推理大模型私有化的未来工程图景](#5. 总结与展望:推理大模型私有化的未来工程图景)
前言:
以 DeepSeek-R1 为代表的大模型强化学习长链条推理(CoT)浪潮,彻底改写了传统大模型的生成范式。然而深度慢思考带来的思考标记(
<think>Tokens)暴增与长上下文驻留,迅速将显存账本推向极限,成为企业私网落地中最严峻的算力壁垒。本文深入拆解深度推理模型的动态思考机理、KV Cache 膨胀账本与量化压缩损益,结合基于 vLLM + PagedAttention 的极限吞吐部署方案与长推理死循环引发的 CUDA OOM 排查实录,提供企业私网低成本运行推理模型的工程实战全景。
个人主页:艺杯羹
1. 范式裂变:从单步即出到强化学习慢思考的本质跃迁
在过去很长一段时间内,以 GPT-4、Claude 为代表的大型语言模型在生成机制上遵循着几乎恒定的计算节拍:
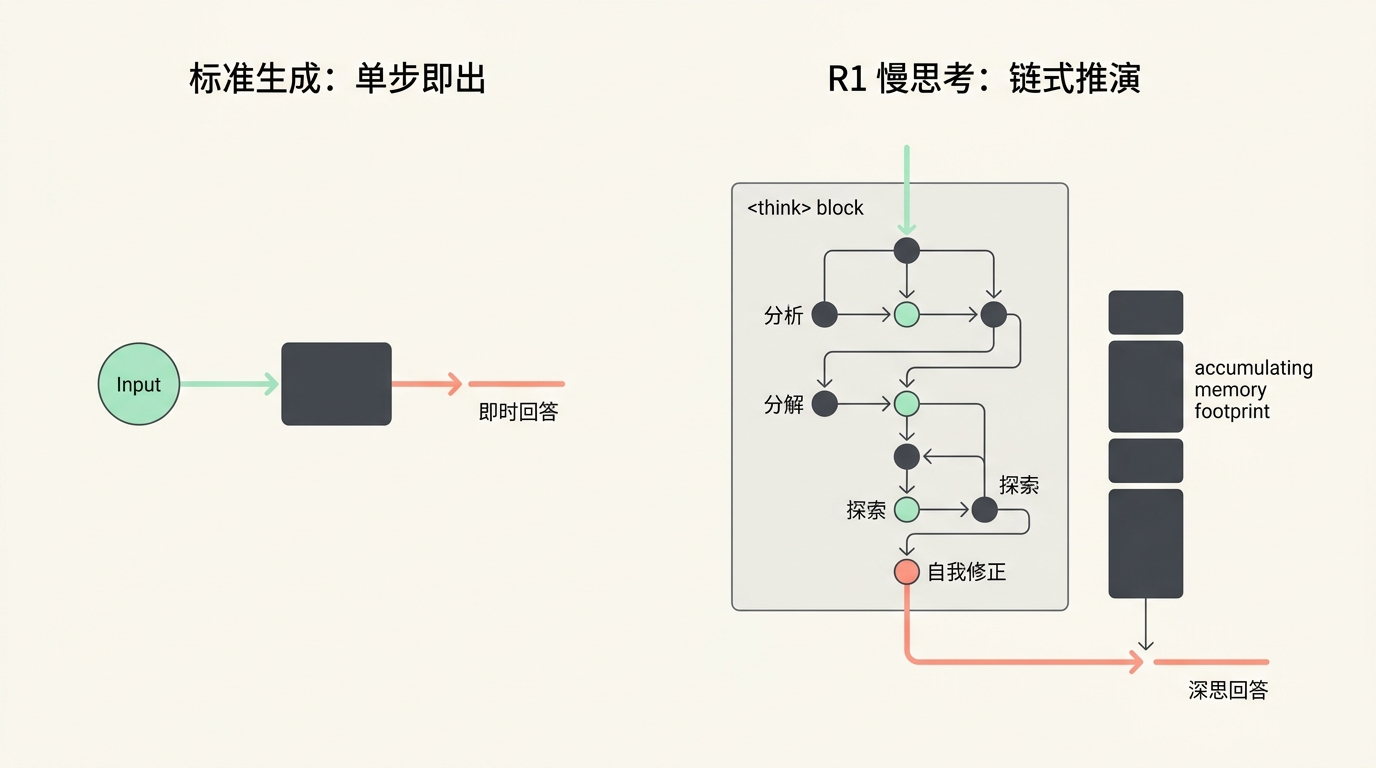
输入一个 Prompt,模型以自回归(Auto-Regressive)的方式逐词预测下一个最可能的 Token,这种生成模式在认知心理学上被普遍定义为"系统一(快思考)"。
快思考模型虽然具备极高的响应速度与常识储备,但在面对高难度数学推导、多步骤算法架构设计或复杂业务逻辑边界审查时,极易因缺乏前瞻性规划而产生逻辑断层,陷入"自信地胡说八道"的幻觉陷阱。
以 DeepSeek-R1 为代表的新一代推理模型彻底打破了这种单步直出范式。
通过大规模纯强化学习(RL)训练,模型学会了在给出最终结论之前,自主开辟一段由 <think> 与 </think> 标签包裹的"思维沙盒"。
在这个工作记忆区内部,模型自主实施问题拆解、逆向推导、假设验证以及自我推翻纠错,将推理时长换取为答案正确率的指数级提升,这就是典型的"系统二(慢思考)"。
1.1. 快思考与慢思考:两种大模型生成架构的根本分野
从计算执行层面剖析慢思考的机理,其核心在于将传统依赖人类工程师在 Prompt 中写死规则的"外部 Chain-of-Thought(思维链)",完全内化为模型自主演化的"原生潜空间推演":
第一,动态自适应步长:对于极为简易的常识问答,模型内部的思考链仅占用极少的标记便迅速给出答案;而面对复杂的算法优化或长代码重构时,模型能够自主迭代展开数千乃至上万个思考标记;
第二,原生的探索与试错回溯机制 :在 <think> 区间内部,模型会主动产生类似"等等,刚才这个方案在边界情况下可能引发空指针,让我换一种并发安全的实现"的自我反思,这种在输出前的多次内部试错,从数学概率上极大地收窄了最终结论的出错区间;
第三,系统资源的代际消耗差异:慢思考在大幅提升推理精度的同时,直接打破了传统业务系统对响应延迟与显存容量的常规认知,将工程落地的重心彻底转向显存吞吐与上下文生命周期治理。
1.2. 架构代际横评:标准基座模型 vs 纯 Prompt CoT vs DeepSeek-R1 强化学习原生推理
为了厘清慢思考模型在整个技术谱系中的坐标,有必要将三种主流推理方案进行多维对比:
|-----------------|--------------------|----------------------------------|-----------------------------------|
| 评估维度 | 第一代:标准基座模型直出(快思考) | 第二代:人工 Prompt 诱导 CoT(如 Few-Shot) | 第三代:强化学习原生慢思考(DeepSeek-R1) |
| 思维生成载体 | 仅输出最终答案,无内部推导轨迹 | 在输出文本中混合人工模板化的思考痕迹 | 模型内生专用的 <think> 潜空间沙箱,与最终回答物理隔离 |
| 错误修正韧性 | 一旦首个词预测偏差,后续容易全盘坍塌 | 依赖人工示例覆盖,面对长尾场景容易僵化失效 | 原生具备推翻假设、重新分支回溯的反思纠偏能力 |
| 生成 Token 开销 | 极低(仅包含必要的问题解答文本) | 中等(增加人工提示词与部分说明文字) | 显著增加(思考标记长度往往是回答长度的 3~10 倍) |
| 高难逻辑准确率 | 在复杂代码、高难度数学推理中容易幻觉 | 有一定改善,但上限受制于基座模型单步泛化 | 在高难度数学竞赛(AIME)与复杂系统架构推演中大幅超越前代 |
| 工程部署核心挑战 | 主要是并发请求量调度 | 主要是 Prompt 膨胀导致的首包延迟增大 | 极高的长上下文显存驻留(KV Cache 压力)与动态流式截断控制 |
2. 算力账本透视:长链条推理引发的显存雪崩与量化权衡
当企业尝试在内网私有化部署基于 DeepSeek-R1 的开源蒸馏模型(Distill Qwen / LLaMA 系列)时,遇到的第一个致命壁垒就是显存雪崩。
许多工程师误以为只要显卡的显存容量大于模型静态权重大小(例如 14B 模型 FP16 占用约 28GB,一张 32GB 显卡即可运行),但在实际生产并发压力下,服务往往会在数个长链条请求并发涌入时瞬间崩溃。
2.1. 显存账本穿透:权重驻留 vs KV Cache 几何级数膨胀
大语言模型运行时的显存由两大核心部分组成:模型静态权重显存 与运行时动态 KV Cache 显存。
在传统的快思考场景下,单次对话通常在几百个 Token 内结束,KV Cache 占用的显存空间相对平稳。
而在 DeepSeek-R1 慢思考模式下,模型内部的思考链动辄展开到 4096、8192 乃至 16384 个 Token。
由于 Transformer 架构的自注意力机制需要为每一个历史 Token 保存对应的键向量(Key)与值向量(Value),KV Cache 的显存开销公式为:
每 Token 显存开销 = 2 乘以 层数 乘以 注意力头数 乘以 隐藏层维度 乘以 精度字节数
对于一个典型的 14B 规格模型,单个并发在 16K 上下文深度下的 KV Cache 显存消耗就高达数个 Gigabyte。
如果并发请求达到数十个,动态显存消耗将迅速超越模型权重本身,直接击穿 GPU 显存物理上限。
2.2. 蒸馏模型规格横评:7B、14B、32B 在企业级场景下的选型坐标
在私有化落地的硬件预算约束下,选择合适的开源蒸馏模型规格至关重要:
2.2.1. DeepSeek-R1-Distill-Qwen-7B(轻量边缘与高敏捷场景)
7B 规格是单卡消费级显卡(如 RTX 4090 24GB)的黄金选型。
在经过 4-bit 量化后,权重显存压缩至仅约 5GB,剩余高达 19GB 显存可全部划归为并发 KV Cache 显存池。
它能够在极低的显卡采购成本下,承载代码初筛、简单逻辑校验等高吞吐边缘业务。
2.2.2. DeepSeek-R1-Distill-Qwen-14B(综合性价比之王)
14B 规格在保留了原版 R1 大部分数学证明与复杂代码生成能力的基准下,兼顾了显存可达性。
采用 AWQ 量化后权重占用约 9GB,在单张 RTX 4090 或 A10 显卡上能够跑出极高的推理每秒吞吐量(TPS),是绝大多数中型企业自建私有代码助手与技术方案评审的最佳平衡点。
2.2.3. DeepSeek-R1-Distill-Qwen-32B(企业级重型复杂推理核心)
32B 规格在复杂系统设计、边界防御推演与架构决策方面逼近千亿大模型水准。
其量化后需要约 20GB 权重空间,通常推荐双卡或单张 A100/H800 80GB 部署,专用于高价值的重大业务逻辑推演。
2.3. 主流量化方案(FP16 vs AWQ 4-bit vs GGUF)多维损益决策矩阵
为了在有限算力下压榨极致性能,量化方案的技术选型不可盲目:
|------------------------------|--------------|------------|------------------------|--------------------------|---------------------------|
| 量化方案 | 压缩比率 | 显存节省幅度 | 推理延迟表现 | 逻辑推演能力衰减度 | 典型适用硬件与部署形态 |
| 原生 FP16 / BF16 | 1.0x(基准) | 0%(占用最大) | 高负载下受显存带宽拖累 | 零损耗,保持原生基准线 | 专业数据中心集群(A100/H100 组网) |
| AWQ 4-bit(激活感知量化) | 约 3.5x | 节省高达 70% | GPU Tensor Core 极致硬件加速 | 损失极微(高难度数学仅衰减 1%~2%) | 生产级服务端首选(NVIDIA 单卡高并发) |
| GPTQ 4-bit(通用后训练量化) | 约 3.4x | 节省约 68% | 略逊于 AWQ,但兼容性较好 | 在极长推理链中有轻微语义漂移 | 各类老旧 CUDA 算力卡与通用云服务器 |
| GGUF / llama.cpp(CPU/混合) | 2.0x ~ 4.0x | 跨内存与显存无缝切分 | 吞吐上限较低,受内存总线限制 | 随量化级别从 Q4_K_M 到 Q8 有阶梯波动 | 无独立高端显卡,依赖 CPU/Mac 内存本地运行 |
3. 高性能工程底座:vLLM 引擎核心调优与私网高并发部署
在明确了 14B 规格与 AWQ 量化路线后,底层的推理服务引擎是决定吞吐上限的关键核心。
传统的 HuggingFace Transformers 原生推理框架采用连续显存分配策略,在面对长短不一的慢思考 Token 生成时,会产生高达 60%~80% 的内部显存碎片。
为了彻底释放硬件潜能,必须引入工业级高并发推理引擎 vLLM。
3.1. PagedAttention 显存分页管理架构解析
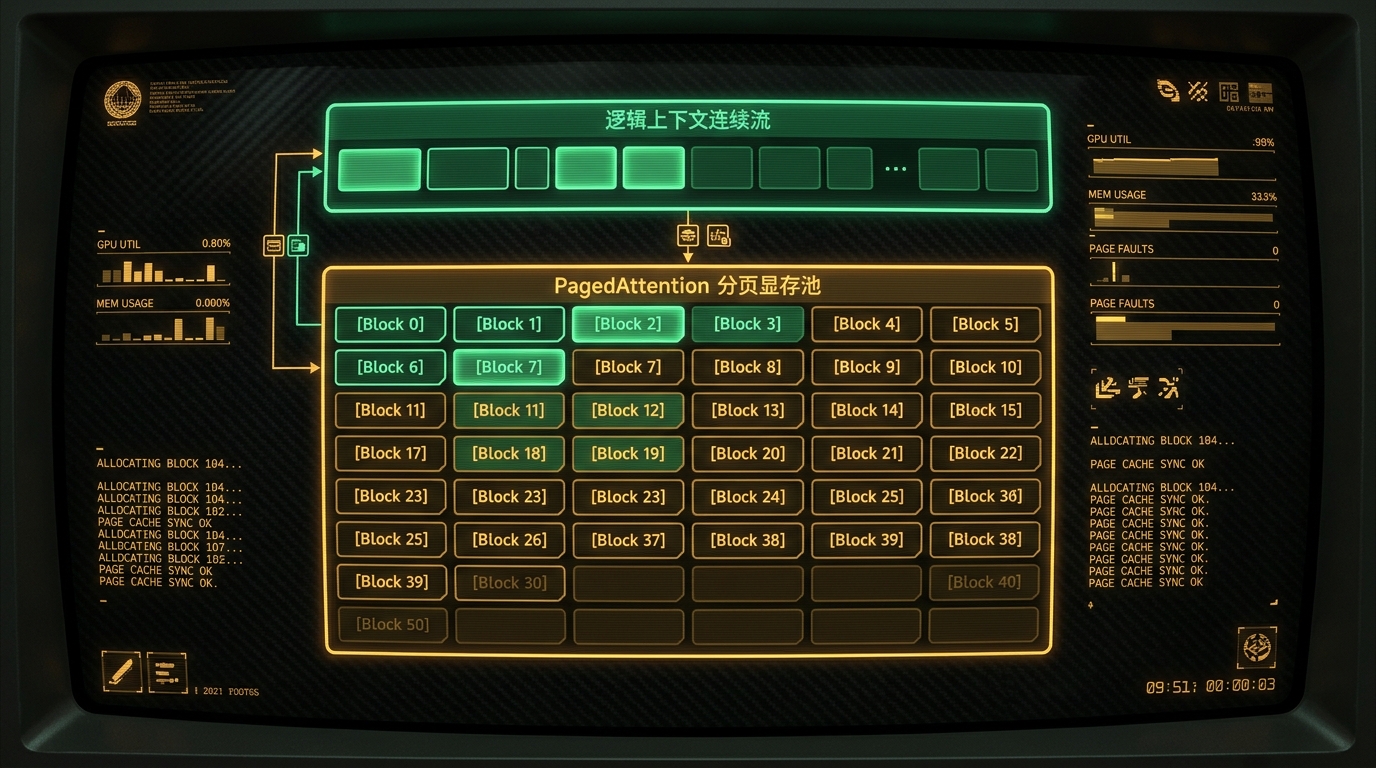
vLLM 能够在慢思考推理中脱颖而出的核心杀手锏,正是其受到现代操作系统虚拟内存分页机制启发而设计的 PagedAttention 算法。
在操作系统中,物理内存条被划分为离散的物理页(Page),应用程序的连续虚拟地址通过页表(Page Table)映射至不连续的物理内存块中,彻底消除了外部碎片。
PagedAttention 将这一机制完美移植至 GPU 显存:
它将每个请求的动态 KV Cache 划分为固定大小的物理显存块(Block,通常每个 Block 包含 16 或 32 个 Token);
当 DeepSeek-R1 在内部不断迭代生成新的思考 Token 时,vLLM 仅在 Block 填满的瞬间才向物理显存池申请一个新的空闲块挂载进页表,而无需预先为 16K 上下文预留整段连续显存。
这种架构将显存浪费率直接压缩至 4% 以下,使得同一张显卡所能支撑的慢思考并发会话数直接提升了 3 至 5 倍。
3.2. 生产级启动配置与 Chunked Prefill 动态批处理实战
以下是在生产环境中运行 DeepSeek-R1-Distill-Qwen-14B-AWQ 的高可靠启动配置脚本:
#!/usr/bin/env bash
# ==============================================================================
# vLLM 生产级推理引擎启动配置:DeepSeek-R1 慢思考专用调优模板
# 适配硬件环境:单卡 NVIDIA RTX 4090 (24GB) 或 A10 (24GB)
# ==============================================================================

# 设置 CUDA 显存分配器,避免碎片化锁页
export PYTORCH_CUDA_ALLOC_CONF="expandable_segments:True"

MODEL_PATH="/data/models/DeepSeek-R1-Distill-Qwen-14B-AWQ"
SERVE_PORT=8000

python3 -m vllm.entrypoints.openai.api_server \
    --model "${MODEL_PATH}" \
    --served-model-name "deepseek-r1-distill-14b" \
    --quantization awq \
    --dtype float16 \
    --trust-remote-code \
    --host 0.0.0.0 \
    --port ${SERVE_PORT} \
    --tensor-parallel-size 1 \
    --gpu-memory-utilization 0.92 \
    --max-model-len 16384 \
    --max-num-seqs 16 \
    --block-size 16 \
    --enable-chunked-prefill \
    --max-num-batched-tokens 4096 \
    --disable-log-requests
在此配置中,有两项关键生产参数必须深刻理解其设计考量:
第一,--enable-chunked-prefill(分块预填充)。
当新请求带着较长的历史提示词进入时,vLLM 会将其切分为受控的分块与当前正在生成 Token 的旧请求进行混合批处理,杜绝了超长 Prompt 计算时导致正在生成慢思考的请求产生明显的停顿卡顿;
第二,--gpu-memory-utilization 0.92。
为底层 CUDA 运行库与系统保留 8% 的缓冲余量,严格预防偶发性的驱动级上下文切换溢出。
3.3. 统一 OpenAI 兼容 API 网关与业务流水线无缝集成
vLLM 原生暴露出高度兼容 OpenAI 标准格式的 RESTful 接口。
以下是在业务端进行异步高并发调用的生产级客户端实现,内含对 <think> 思考链与最终回答的结构化正则分离解析:
"""
企业级 DeepSeek-R1 异步推理客户端
负责并发调用自建 vLLM 服务,并自动解构内部思考链与最终输出
"""
import re
import asyncio
from typing import Dict, Any, Tuple
from openai import AsyncOpenAI

class DeepSeekR1Client:
    def __init__(self, base_url: str = "http://127.0.0.1:8000/v1", api_key: str = "EMPTY"):
        # 接入自建 vLLM 网关,api_key 填入占位符即可
        self.client = AsyncOpenAI(base_url=base_url, api_key=api_key)
        self.model_name = "deepseek-r1-distill-14b"

    @staticmethod
    def parse_reasoning_payload(raw_content: str) -> Tuple[str, str]:
        """
        精确拆解模型的深度慢思考过程与最终业务结论
        :return: (思考链内容 reasoning_text, 最终答案 response_text)
        """
        think_pattern = re.compile(r"<think>(.*?)</think>", re.DOTALL)
        match = think_pattern.search(raw_content)

        if match:
            reasoning_text = match.group(1).strip()
            # 剥离思考标签,保留纯净的业务结论
            response_text = think_pattern.sub("", raw_content).strip()
            return reasoning_text, response_text

        # 若未命中闭合标签(如极端早停情况),全量降级处理
        return "", raw_content.strip()

    async def execute_reasoning_query(self, prompt_text: str) -> Dict[str, Any]:
        """异步发起带推理上下文的业务推演请求"""
        try:
            response = await self.client.chat.completions.create(
                model=self.model_name,
                messages=[
                    {"role": "system", "content": "当前为严谨的软件架构审计专家角色,必须在输出结论前进行严密的逻辑推导。"},
                    {"role": "user", "content": prompt_text}
                ],
                temperature=0.6,  # 慢思考推荐维持在 0.5~0.7,防止发散过大
                top_p=0.95,
                max_tokens=8192
            )

            raw_text = response.choices[0].message.content
            reasoning, answer = self.parse_reasoning_payload(raw_text)

            return {
                "status": "success",
                "reasoning_steps": reasoning,
                "final_answer": answer,
                "usage": {
                    "completion_tokens": response.usage.completion_tokens,
                    "prompt_tokens": response.usage.prompt_tokens
                }
            }
        except Exception as e:
            return {
                "status": "error",
                "message": f"推理服务端交互失败:{str(e)}"
            }

# 异步并发执行演示
async def main():
    r1_engine = DeepSeekR1Client()
    test_prompt = "请推演高并发电商订单状态机设计,分析在网络分区下如何防止库存重复扣减。"
    result = await r1_engine.execute_reasoning_query(test_prompt)
    print(f"[*] 捕获内部思考链长度:{len(result.get('reasoning_steps', ''))} 字符")
    print(f"[*] 最终架构审计结论:\n{result.get('final_answer')[:300]}...")

if __name__ == "__main__":
    asyncio.run(main())
4. 生产级踩坑实录与报错排查闭环
在复杂现实业务调用中,慢思考推理的动态不确定性极易撞上各种底层硬件墙。
以下复盘一例典型的长链条推演死循环导致 GPU 显存击穿的排错闭环。
4.1. 真实报错现场:长推理递归自循环引发的 CUDA OOM 显存击穿
在一次批量审查数千行遗留 SQL 存储过程的任务中,自建的 vLLM 服务在并发推进至第 40 分钟时突发系统性瘫痪。
服务端瞬间向所有上游请求返回 500 状态码,系统底层日志抛出致命的 CUDA 物理内存分配失败堆栈:
[FATAL-CUDA-CRASH] 2026-09-13 18:22:04.108 [Worker-GPU-0] Out of memory allocating KV cache block!
torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 32.00 MiB.
GPU 0 has 23.68 GiB total capacity; 22.14 GiB already allocated by PagedAttention;
1.20 GiB free; 1.54 GiB reserved in total by PyTorch.
If reserved memory is >> allocated memory, try setting max_split_size_mb to avoid fragmentation.
    at vllm.model_executor.layers.sampler._sample(sampler.py:214)
    at vllm.engine.async_llm_engine._process_model_outputs(engine.py:345)
4.2. 根因剖析与最大推理步数截断与显存分配比例自适应调优
4.2.1. 致命根因深度定位
调取崩盘瞬间崩溃会话的详细文本追踪,还原出事故发生的完整路径:
第一,模型陷入了"反思死循环(Reasoning Loop)" 。
由于输入的遗留 SQL 包含长达几千行的混乱嵌套,模型在思考链中反复出现"方案 A 不可行,考虑方案 B;方案 B 在边界上存在漏洞,再次回到方案 A 验证"的逻辑互锁,在 <think> 区间内部自主生成了超过 14000 个思考标记仍未触达 </think> 终止符;
第二,显存保护熔断阈值失效 。
启动参数中设定了 --max-model-len 16384,但并发序列上限 --max-num-seqs 16 设置偏激进。
当多个长思考请求同时进入 14K 以上深度时,未释放的物理显存块总需求量直接超越了物理 24GB 显存的承载上限,触发硬性崩溃。
4.2.2. 代码与服务级防御重构方案
要彻底根治长链条推理死循环带来的雪崩风险,必须在客户端与引擎端构建双重防御水库:
首先,在服务端启动参数中重新平衡并发槽位与最大上下文深度,启用 vLLM 的抢占驱逐机制(Preemption):
# 修正后的生产防御启动片段
    --max-model-len 12288 \
    --max-num-seqs 8 \
    --gpu-memory-utilization 0.90 \
    --preemption-mode recompute \
通过配置 --preemption-mode recompute,当突发长上下文请求导致显存池耗尽时,引擎不会直接抛出 OOM 崩溃,而是主动暂停低优先级的请求并将其显存块安全回收,待高优先级请求结束后再自动重算恢复。
其次,在业务调用端增加严格的流式思考标记防死锁看门狗(Watchdog):
"""
流式思考链看门狗拦截器
在检测到思考标记生成异常溢出时,主动截断并强制进入回答状态
"""
class ThinkingWatchdogStreamer:
    def __init__(self, max_reasoning_tokens: int = 4096):
        self.max_reasoning_tokens = max_reasoning_tokens
        self.reasoning_token_count = 0
        self.in_think_block = False

    def process_chunk(self, delta_content: str) -> str:
        if "<think>" in delta_content:
            self.in_think_block = True

        if self.in_think_block:
            self.reasoning_token_count += 1
            # 达到强制熔断阈值,人为注入闭合标签强行让模型收敛
            if self.reasoning_token_count >= self.max_reasoning_tokens:
                self.in_think_block = False
                return "</think>\n[系统看门狗介入:思考步数已达上限,以下直接输出收敛结论]\n"

        if "</think>" in delta_content:
            self.in_think_block = False

        return delta_content
4.3. 生产高可用防御设计
在企业级私网部署 DeepSeek-R1 慢思考服务时,建议落地三道安全屏障:
其一,严密实施长尾推理超时熔断。针对单个会话设置端到端物理超时(建议设置为 60~90 秒),防止慢思考无限推演拖跨工作线程;
其二,自适应温度与采样惩罚。慢思考模型对 Temperature 极其敏感,禁止在推理时使用大于 0.8 的高采样温度,建议配合 Frequency Penalty(0.1~0.3)压制思考链中的词组机械重复;
其三,多卡张量并行(Tensor Parallel)容量分流 。当并发业务需求增加时,优先通过双卡(--tensor-parallel-size 2)切分权重与上下文,保持单卡显存水位维持在 80% 安全警戒线以下。
5. 总结与展望:推理大模型私有化的未来工程图景
以 DeepSeek-R1 为标志的强化学习慢思考技术,不是一次简单的参数微调,而是模型认知能力的范式跃升。
它用前所未有的自主探索能力,攻克了以往需要海量高质量人工标注才能勉强支撑的复杂逻辑疆域。
然而,新范式必然伴随着新的工程阵痛。
从传统的追求极速吞吐,到如今在长推理链、显存分页管理(PagedAttention)、量化压缩与看门狗截断之间寻找精密平衡,现代 AI 基础架构工程师的职责正在变得愈发关键。
掌握慢思考背后的算力账本与调度机理,在低成本硬件底座上释放顶尖大模型的推演潜能,必将成为未来几年企业智能化转型的核心胜负手。