前言:Pigeon干的事:从用户历史图片中学习隐式视觉偏好 + 理解 Reference Image/Text 的显式需求 → 生成个性化新图片。
传统个性化推荐:用户历史 → 从已有内容中筛选
Pigeon:用户历史 + 当前需求 → 直接生成新的个性化内容
提出问题:
① 用户历史图片中喜欢和不喜欢的视觉特征是混杂的,如何从 noisy history 中提取真正的用户偏好?
② Reference Image 既包含当前任务语义,又容易导致模型直接"照抄",怎么办?
③ 没有
<用户历史,参考图+文本,个性化目标图>这样的监督数据,怎么训练?
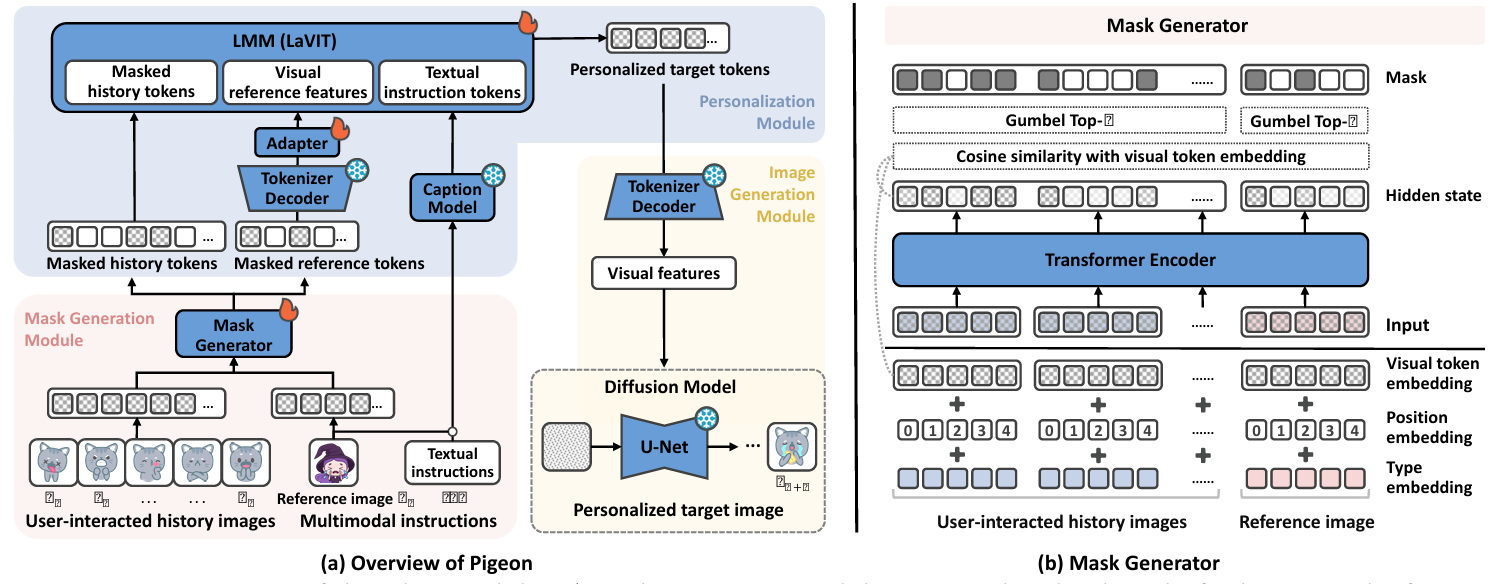
💡创新1:Reference-aware Token-level Masking------过滤用户历史图片中的细粒度噪声(也就是筛出更准确的用户偏好)
📌好处:
不再把用户历史图片中的所有视觉特征都当成用户偏好,而是筛掉与当前任务无关的 noisy tokens,从 feature/token 层面提取更准确的用户偏好。也就是:过滤用户历史图片中的 fine-grained noise,从 token level 提取真正与当前任务相关的用户偏好。
🏃♂️做法:
User History Images → LaVIT Tokenizer → Visual Tokens → Mask Generator → Importance Score → Token-level Mask → Masked History Tokens
Mask Generator 使用:Visual Token Embedding + Position Embedding + Type Embedding → Transformer Encoder,得到每个 token 的 hidden state,再计算:hidden state 与原始 visual token embedding 的 Cosine Similarity,得到 token importance score:
高分 token → 保留
低分 token → Mask
而且这个 Mask 是:Reference-aware。也就是说,历史 token 的重要性不是完全固定的,而是结合当前 reference/context 判断。
💡创新2:Hybrid Multimodal Instruction------Reference 不直接照搬,而是拆成"文本语义 + 视觉语义"
📌好处:
解决了
直接使用 Reference Image → 容易复制 Reference
以及:
只用文本描述 Reference → 又会损失复杂视觉信息
最终同时保留:
Reference 的高层语义 + 视觉语义
并和用户历史偏好融合。
🏃♂️做法:
Reference Image 分成两条路线:
① Textual Semantic**→**负责:Reference "表达了什么"
   Reference Image
         ↓
Caption Model标题模型
   (BLIP-2 / LLaVA)
         ↓
Text Description文本描述
         ↓
  Text Tokenizer
         ↓
Textual Semantic Features
② Visual Semantic**→**负责:Reference "视觉上是什么样"
    Reference Image
          ↓
    LaVIT Tokenizer
          ↓
  Reference Visual Tokens
          ↓
 LaVIT Tokenizer Decoder
          ↓
     Average Pooling
          ↓
        Adapter
          ↓
 Visual Semantic Features
论文利用预训练 LaVIT decoder 进行特征转换,避免引入额外的大量参数。
最终:
   Masked History Tokens
            +
 Textual Semantic Features
            +
  Visual Semantic Features
            ↓
      Hybrid Prompt
            ↓
       LMM / LaVIT
            ↓
 Personalized Target Tokens
即:
History = 用户喜欢什么
Text = 当前 Reference 想表达什么
Visual Feature = 当前 Reference 在视觉上是什么
三者融合生成最终图片。
💡创新3:Masked Preference Reconstruction------没有人工标注,利用用户交互序列自己构造监督数据
📌好处:
解决整篇论文最大的训练数据问题:
现实中没有
<History, Multimodal Instruction, Personalized Target>这样的监督数据。
因此不需要人工重新标注大量个性化生成数据,而是:
直接利用用户已有的交互历史构造训练样本。
核心思想:
x1 → x2 → x3 → x4 → x5把:
x1 ~ x4→ History
把:
x5→ Target
然后:
把 Target 自己作为 Reference,并进行 Mask。
这样原本没有的:
History + Reference + Target监督数据就被自己构造出来了。
🏃♂️做法:
     用户交互序列
          ↓
   前 N 个 → History
   最后一个 → Target
          ↓
 Target 同时作为 Reference
          ↓
  Mask Reference Tokens
          ↓
History + Masked Reference + Text
          ↓
         LMM
          ↓
    重构 Target Tokens
然后使用:
Autoregressive NLL
训练模型预测 Target Image Tokens。
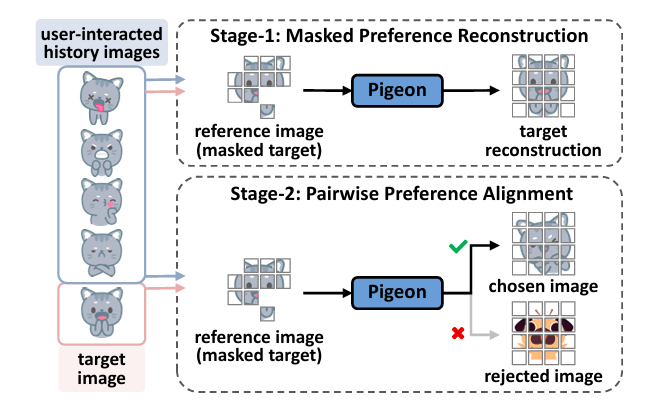
⭐创新3里面重点:Dual-phase Reference Mask
普通想法:
训练和推理使用同一种 Mask。
Pigeon:
训练和推理故意使用相反的 Mask 策略,强迫模型学习 History Preference
🏃♂️训练:
Reference
    ↓
Mask 高分 token
为什么?因为高分 token:
包含更多个性化信息。
如果不遮:
模型可以直接从 Reference 得到答案。
所以:
故意遮掉 Reference 中最有价值的个性化信息,逼模型从 History 中学习用户偏好。
🏃♂️推理:
Reference
    ↓
Mask 低分 token
因为模型已经通过 Stage 1 学会:
History → Preference
所以推理时:
保留 Reference 中重要的信息,同时利用已经学到的 Preference Reconstruction 能力。
因此:
训练:Mask High-score → 强迫模型学 Preference
推理:Mask Low-score → 保留 Reference 重要语义 + 调用 Preference 能力
这就是:Dual-phase Reference Mask。
💡创新4:Pairwise Preference Alignment------自己生成"好答案/坏答案",再用 DPO 强化个性化
📌好处:
Stage 1 只是让模型:
学会基本的个性化生成
Stage 2 进一步让模型:
更偏向用户喜欢的生成结果。
最关键的是:
仍然不需要人工标注 chosen/rejected。
🏃♂️做法:
对于同一个:
History + Reference + Instruction改变 Reference Mask Ratio:
αr = 0.0
αr = 0.1
αr = 0.2
...
αr = 1.0
生成多个候选图片:
Candidate 1
Candidate 2
Candidate 3
...
Candidate 11
然后使用:
生成图片与用户历史图片之间的 CLIP Similarity
作为 Preference Reward。
Candidate Images
       ↓
CLIP Similarity
       ↓
Preference Score
       ↓
最高分 → Chosen
最低分 → Rejected
最后:
Chosen / Rejected → DPO
进一步优化模型。论文明确将这一阶段定义为 pairwise preference alignment。
⭐所以 Pigeon 的训练闭环其实是:
    用户交互数据
          ↓
       Stage 1
Masked Preference Reconstruction
          ↓
    学会"用户喜欢什么"
          ↓
    生成多个候选图片
          ↓
 自动 Preference Reward
          ↓
    Chosen / Rejected
          ↓
        Stage 2
         DPO
          ↓
    进一步强化用户偏好
这是整篇论文最值得迁移的思想之一:
没有人工 Preference Label,也可以利用已有用户行为数据 + 模型生成能力 + 自动 Reward,构造 Preference Pair,再进行 DPO。
💡创新5:把 Personalization 和 Semantic Alignment 分开评价
📌好处:
避免出现:
"越像用户历史 = 越好"
这种单一评价。因为个性化图像生成实际上有两个目标:
①Personalization
生成的东西是不是用户喜欢的?
②Semantic Alignment
生成的东西是不是符合 Reference + Text 的要求?
所以 Pigeon 实际上需要解决:
       Personalization
              ↑
              |
              |     最理想
              |      ★
              |
              └──────────────→
                 Semantic Alignment
而且两个目标存在一定冲突:
越追求用户偏好 → 可能偏离 Reference
越追求 Reference → 可能退化成 Reference Copy
Stage 2 DPO 的实验也验证了:
personalization 进一步提升,但 semantic alignment 略有下降。
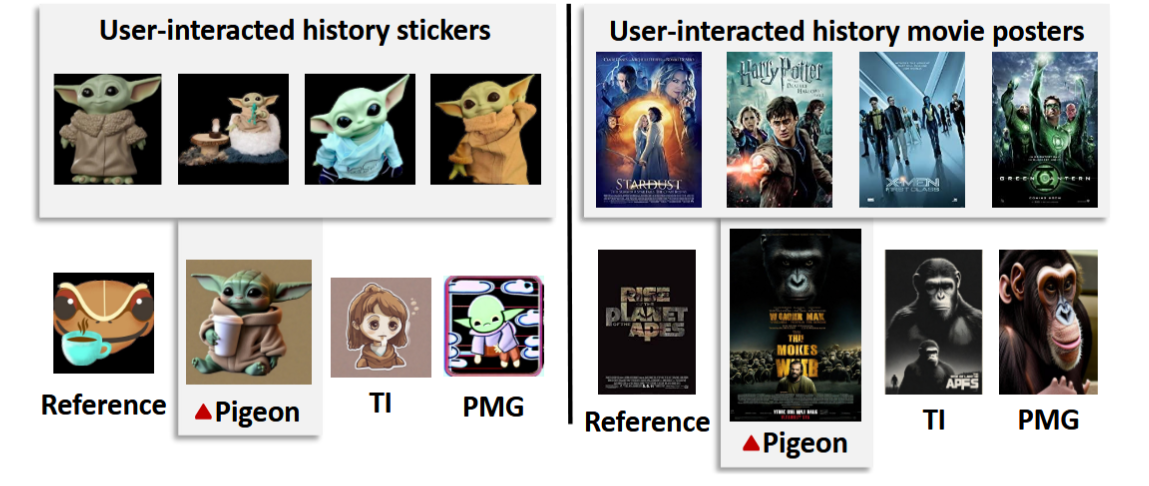
在贴纸和电影海报场景中生成的图像示例,沿着四个用户交互历史图像和一个参考图像。
🧠论文感悟:
值得迁移的研究思想:
① 用户行为 ≠ 用户偏好
用户点过/喜欢过一个东西,并不意味着:
这个东西的全部 feature 都是用户喜欢的。
所以可以考虑:
Token-level Preference Extraction / Filtering
这和用户行为序列建模其实非常值得联系。
② 没有人工 Preference Label,可以自己构造
这是 Pigeon 最值得带走的思想:
Interaction Data → Reconstruction → Candidate Generation → Automatic Reward → Preference Pair → DPO
这实际上是一条:
无人工标注 Preference Alignment Pipeline
③ 训练时可以"故意制造困难"
Dual-phase Mask 本质上是在:
训练阶段人为切断模型最容易走的捷径。
如果模型直接看到 Reference 的高价值信息:
最简单答案就是 Copy Reference。
所以:
把捷径堵住 → 逼模型学习真正想学的能力。
这个思想远比"Mask"本身更值得记。
④ 生成式推荐和 Pigeon 的逻辑其实非常接近
可以把它抽象成:
生成式推荐:

User History
     ↓
User Preference
     ↓
Generate Next Item


Pigeon:

User Image History
     ↓
Visual Preference
     ↓
Generate New Image
区别只是:
生成式推荐生成的是 Item / Semantic ID
而:
Pigeon 生成的是 Image Tokens。