伴随着以风电、光伏为代表的新能源在新型电力系统中所占比例越来越高,系统的运行不确定性也随之增大。气象条件属于影响源荷波动的主要因素之一,它的繁杂程度以及非线性的特点给系统的规划、调度以及风险评价造成了很大的麻烦。本文提出并实现了一种根据气候变化进行源荷风险场景生成的方法。该方法先用ERA5/ERA5-Land气象再分析数据和德国OPSD电力时间序列数据,采用时空对齐、特征聚合、日历特征编码的方式建立结构化的训练数据集。其次,用线性回归、随机森林和直方图梯度提升三种机器学习模型,建立气象特征到风电出力、光伏出力和电力负荷的非线性映射,以验证集均方根误差最小为依据选取最优模型,重新得到了几十年来的大规模理论源荷时序数据。在此基础上,用边缘分布拟合法对理论源荷序列进行拟合,得到Gaussian Copula联合概率模型,可以定量地度量源荷之间的非线性关系。最后用联合抽样与时序重建技术来产生一组可以体现季节性和极端事件的典型风险情景。为了检验本研究所用的方法是否有效,本文设计并开发了前端、后端分开运行的软件系统,采用FastAPI框架进行数据预处理和模型训练工作,利用Vue3框架完成可视化界面交互部分的工作。实验结果说明该方法可以利用气象信息产生出有统计一致性、物理合理性特征的源荷风险场景。
**关键词:**电力系统;风险场景生成;气象驱动;机器学习;Gaussian Copula;FastAPI;Vue3
ABSTRACT
With more and more new energy such as wind and photovoltaic power replacing traditional power in the newly formed power system, the operating uncertainty of the power system is also getting larger. Meteorological conditions are a kind of factor which drives source-load fluctuation and also causes great trouble for system planning,scheduling,risk assessment because they're so complex and nonlinear. In this paper we have put forth, generated a climate-sourced-load danger situation: In the first place,use ERA5 /ERA5 -Land meteorological reanalysis data and GermanOPSOPpower time series data to form an organized training set via the procedures of spatiotemporalembedment,feature aggreagtion,calendar feaure encoding. Then we take the 3 ML models which are linear regressions (random_foresst ), random farests, histogram of gradient boostings creating thenonlinearmapping of meteo featuresto wind power output, photovoltaicoutputs, andpower loads. Best Model is selected as being that which has the least Root -- Mean - Square Error over the Validation set and also the Multi-Year reconstructed theory Source-load Timeseries Based on this, we fit the marginal distribution of theoretical source - load sequence and then establish a Gaussian Copula joint probability model that can describe the nonlinear relationship between source and load. Finally we use joint sampling &time series reconstruct way to get a set with typical risk scene showing season change&extreme weather phenomenon To check if it works, we design and build a front end - back end separated software system. Back end used Fast api to call the Data Preparation ,training the model and create scenarios. Frontend side is using Vue 3 framework it's provide very good interface for User to interact with: The experiments revealed that there exists some sort of statistics sense, at least can do something with the weather when creating a situation source load risk.
KEY WORDS: Power systems; risk scenario generation; weather-driven; machine learning; Gaussian Copula; FastAPI; Vue3
目 录
[第一章 绪论](#第一章 绪论)
[1.1 研究背景与意义](#1.1 研究背景与意义)
[1.2 国内外研究现状](#1.2 国内外研究现状)
[1.3 论文主要工作](#1.3 论文主要工作)
[1.4 论文结构安排](#1.4 论文结构安排)
[第二章 相关理论与技术基础](#第二章 相关理论与技术基础)
[2.1 电力系统不确定性理论](#2.1 电力系统不确定性理论)
[2.2 Copula理论](#2.2 Copula理论)
[2.3 机器学习回归模型](#2.3 机器学习回归模型)
[2.4 技术栈概述](#2.4 技术栈概述)
[第三章 系统总体设计](#第三章 系统总体设计)
[3.1 系统架构设计](#3.1 系统架构设计)
[3.2 功能模块设计](#3.2 功能模块设计)
[3.3 数据流程设计](#3.3 数据流程设计)
[3.4 接口设计](#3.4 接口设计)
[第四章 核心算法与实现](#第四章 核心算法与实现)
[4.1 数据预处理与特征工程](#4.1 数据预处理与特征工程)
[4.2 气象到源荷非线性映射模型](#4.2 气象到源荷非线性映射模型)
[4.3 模型训练结果](#4.3 模型训练结果)
[4.4 多年理论源荷重构](#4.4 多年理论源荷重构)
[4.5 源荷联合概率建模](#4.5 源荷联合概率建模)
[4.6 风险场景生成](#4.6 风险场景生成)
[第五章 结果分析](#第五章 结果分析)
[5.1 开发环境与部署](#5.1 开发环境与部署)
[5.2 数据库表设计](#5.2 数据库表设计)
[5.3 实验结果与讨论](#5.3 实验结果与讨论)
[第六章 系统实现](#第六章 系统实现)
[6.1 数据准备模块实现](#6.1 数据准备模块实现)
[6.2 模型训练模块实现](#6.2 模型训练模块实现)
[6.3 映射模型实现](#6.3 映射模型实现)
[6.4 模型预测模块实现](#6.4 模型预测模块实现)
[6.5 联合建模模块实现](#6.5 联合建模模块实现)
[6.6 场景生成模块实现](#6.6 场景生成模块实现)
[6.7 结果分析模块实现](#6.7 结果分析模块实现)
[第六章 总结与展望](#第六章 总结与展望)
[6.1 论文工作总结](#6.1 论文工作总结)
[6.2 未来工作展望](#6.2 未来工作展望)
[参 考 文 献](#参 考 文 献)
[致 谢](#致 谢)
第一章 绪论
1.1 研究背景与意义
在全球应对气候变化,推动能源结构转型的大背景下,以风能、太阳能为代表的可再生能源正在逐渐成为电力系统的主要部分。风电、光伏出力具有很强的间歇性、波动性,发电量完全取决于风速、太阳辐照度、温度等气象状况。与此同时由于气温、湿度等各方面的影响,负荷也会随之改变,特别是在极端天气的情况下用电需求会出现突然的转变。由于源荷双侧对于气象条件十分敏感,所以给电力系统安全稳定运行带来了前所未有的不确定性。
传统电力系统规划及运行分析大多依靠历史统计结果来创建场景。但是长期受气候变化影响,历史数据不能反映未来气象和出力的变化。因此,迫切需要一种可以使用气象数据驱动,定量刻画源荷不确定性及相互关系,并能生成典型风险场景的方法。该种方法对电力系统容量规划、备用设置、风险预估和极端事件应对等有十分重要的理论和实际意义。本文以德国区域为研究对象,形成完整的数据处理和建模链条,给气候驱动下的源荷风险分析提供可重复实验平台。
1.2 国内外研究现状
新能源出力和负荷预测上传统的ARIMA时间序列模型因为简单高效而被广泛使用,但是它对于非线性关系的把握能力比较差。随着机器学习技术的发展,以随机森林、支持向量回归为代表的模型因为具有很强的非线性拟合能力而成为了主流。近些年来,LSTM,Transformer等深度学习模型对于时序数据中长期依赖关系有着明显的优势。但是,大多数研究都集中于点预测,输出的是确定性的预测值,并不是用来进行风险分析的联合概率场景集。
概率建模及场景生成上主流的方法有参数化分布拟合、核密度估计、Copula函数理论。Copula函数可以将变量的边缘分布和相关结构分开,特别适合于描述风电、光伏和负荷之间的非线性、非对称尾部相关性。但是现有的Copula场景生成研究大多直接以历史源荷数据为基础,没有把驱动源荷波动的深层气象因素显式的添加到模型中。关于气象驱动建模,已经有一些研究开始试图创建气象要素与新能源出力的物理或者统计模型,但是很少将这些模型和概率风险场景的生成结合起来。
1.3 论文主要工作
本文主要的工作有设计并实现了一套自动的数据处理流程,将ERA5气象数据、OPSD电力数据和装机容量数据进行时空配准,同时构造出包含统计聚合、容量因子、周期性编码等丰富特征集的一系列特征。第二,采用线性回归、随机森林和直方图梯度提升三种模型对风电、光伏和负荷进行训练,选取最佳模型重构多年的理论源荷时序数据。第三,用边缘分布拟合法对理论源荷序列进行拟合,并用Gaussian Copula模型建立三者之间的相关关系。第四,提出用Copula抽样来生成典型的风险场景集合,时序重建和极端事件的筛选,得到一个典型的风险场景集。第五部分根据FastAPI、Vue3技术栈设计完整的软件系统,把所有的算法流程都进行封装,用前端可视化界面来展示结果。
1.4 论文结构安排
本文共分为六个章节。第一章绪论部分介绍研究背景、现状及主要工作。第二章给出电力系统不确定性的相关理论以及技术基础、Copula理论基础、机器学习回归模型基础和技术栈的介绍。第三章阐述系统的总体架构与设计,包括系统架构、功能模块、数据流程和接口设计。第四章详细阐述核心算法及实现,包括数据预处理、非线性映射模型、联合概率建模、风险场景生成。第五章展示系统实现与实验结果,包括开发环境、功能界面和结果分析。第六章总结全文并提出下一步的研究思路。
第二章 相关理论与技术基础
2.1 电力系统不确定性理论
电力系统中不确定性是由负荷侧的用户行为、电源侧的新能源出力造成的。风电和光伏出力的不确定性最大。风速一般服从Weibull分布,其概率密度函数为f(v) = (k/λ)·(v/λ)^(k-1)·e^(-(v/λ)^k),其中k为形状参数,λ为尺度参数。太阳辐照度受云层影响存在复杂的多模态分布,在晴天时服从Beta分布,有云时呈多峰分布。对于单一变量的概率建模一般使用参数估计或者非参数估计的方法,参数估计包含矩估计和极大似然估计,非参数估计则是用核密度估计来代表。
但是源荷之间并不是孤立的。夏季晴朗,光伏出力高,空调负荷高,二者呈正相关。冬季大风天风电出力大,负荷也跟着上升。准确地刻画出这样的复杂的相依关系就是生成风险场景的主要难点。传统的多元分布如多元正态分布认为变量之间存在线性关系,各个变量的边缘分布都是正态分布,不能适应电力数据的特点。因此需要用更灵活的工具去分别对待边缘分布和相关性结构,这也是Copula理论的优势所在。
2.2 Copula理论
Copula函数就是用来将多维随机变量联合分布与各自边缘分布联系起来的函数。按照Sklar定理,如果随机向量X1,X2,...,Xn的边缘分布分别是F1,F2,...,Fn,则存在唯一的Copula函数C使得F(x1,x2,...,xn)=C(F1(x1),F2(x2),...,Fn(xn))。其中ui = Fi(xi)服从0,1上的均匀分布。Copula函数的优点是可以分别选择边缘分布和相关结构,大大提高了多元分布建模的灵活性。
常用的Copula族有Gaussian Copula、Clayton Copula、Frank Copula、Gumbel Copula等。Gaussian Copula是以多元正态分布为基础,适合表示对称相关关系,它的相关结构用相关系数矩阵完全决定。t-Copula尾部更厚,能很好地反映在极端事件下同时发生的概率。Archimedean Copula族包括Clayton、Gumbel和Frank Copula,分别适合描述下尾相关性、上尾相关性和对称相关性。本文采用Gaussian Copula联合建模方法,其参数容易用矩估计或者极大似然估计得到,在本项目的数据中表现较好,可以很好地刻画源荷之间的线性相关关系。
2.3 机器学习回归模型
本节用三个比较有代表性的模型来建立气象特征和源荷出力之间的非线性映射。线性回归是基线模型,认为特征和目标之间存在线性关系,用y=wx+b的形式表示,用最小二乘法求解参数。它的优点是简单、可解释性强,但是不能捕捉非线性关系。
随机森林是基于Bagging集成学习的,用多棵决策树进行构建,取平均值来减小过拟合。每棵树在训练的时候用bootstrap抽样的样本、随机选取的特征子集,可以很好地处理非线性关系以及高维特征,并且对于异常值比较鲁棒。直方图梯度提升是梯度提升机的高效实现,把连续特征离散成直方图以加快训练速度,在大样本数据上速度更快,对于缺少值也内建了处理方法。它会用迭代的方式训练出下一棵树的残差来拟合上一棵树的残差,可以反映复杂的特征交互效应,适合用来处理气象数据有复杂非线性关系的情况。
2.4 技术栈概述
为了达到上述算法并建立完整的系统,本文使用了前后端分离技术进行开发。后端以Python 3.11作为主语言,Xarray库用于读取ERA5/ERA5-Land的NetCDF格式气象数据,支持带时间维和空间维的多维数组操作。Pandas和NumPy主要用来做表格数据的合并、时间对齐和数值变换,是处理多源时序数据的主要工具。sklearn提供回归模型训练、特征缺失填充、统一预测接口,候选模型有线性回归、随机森林、直方图梯度提升等。
概率建模方面,SciPy用于单变量分布拟合,copulas库用于快速构建Gaussian Copula模型。后端服务框架选择FastAPI,FastAPI结构清晰、性能好,适合作为脚本型后端和结果查询的接口。前端使用Vue3、Vite、TypeScript来构建展示型系统,按照数据介绍、模型训练、联合建模、场景生成、结果分析的顺序组织页面。PostgreSQL数据库用来存放任务元数据、模型版本、结果摘要等数据,大体量时序数据以及模型文件存储到文件系统中。
第三章 系统总体设计
3.1 系统架构设计
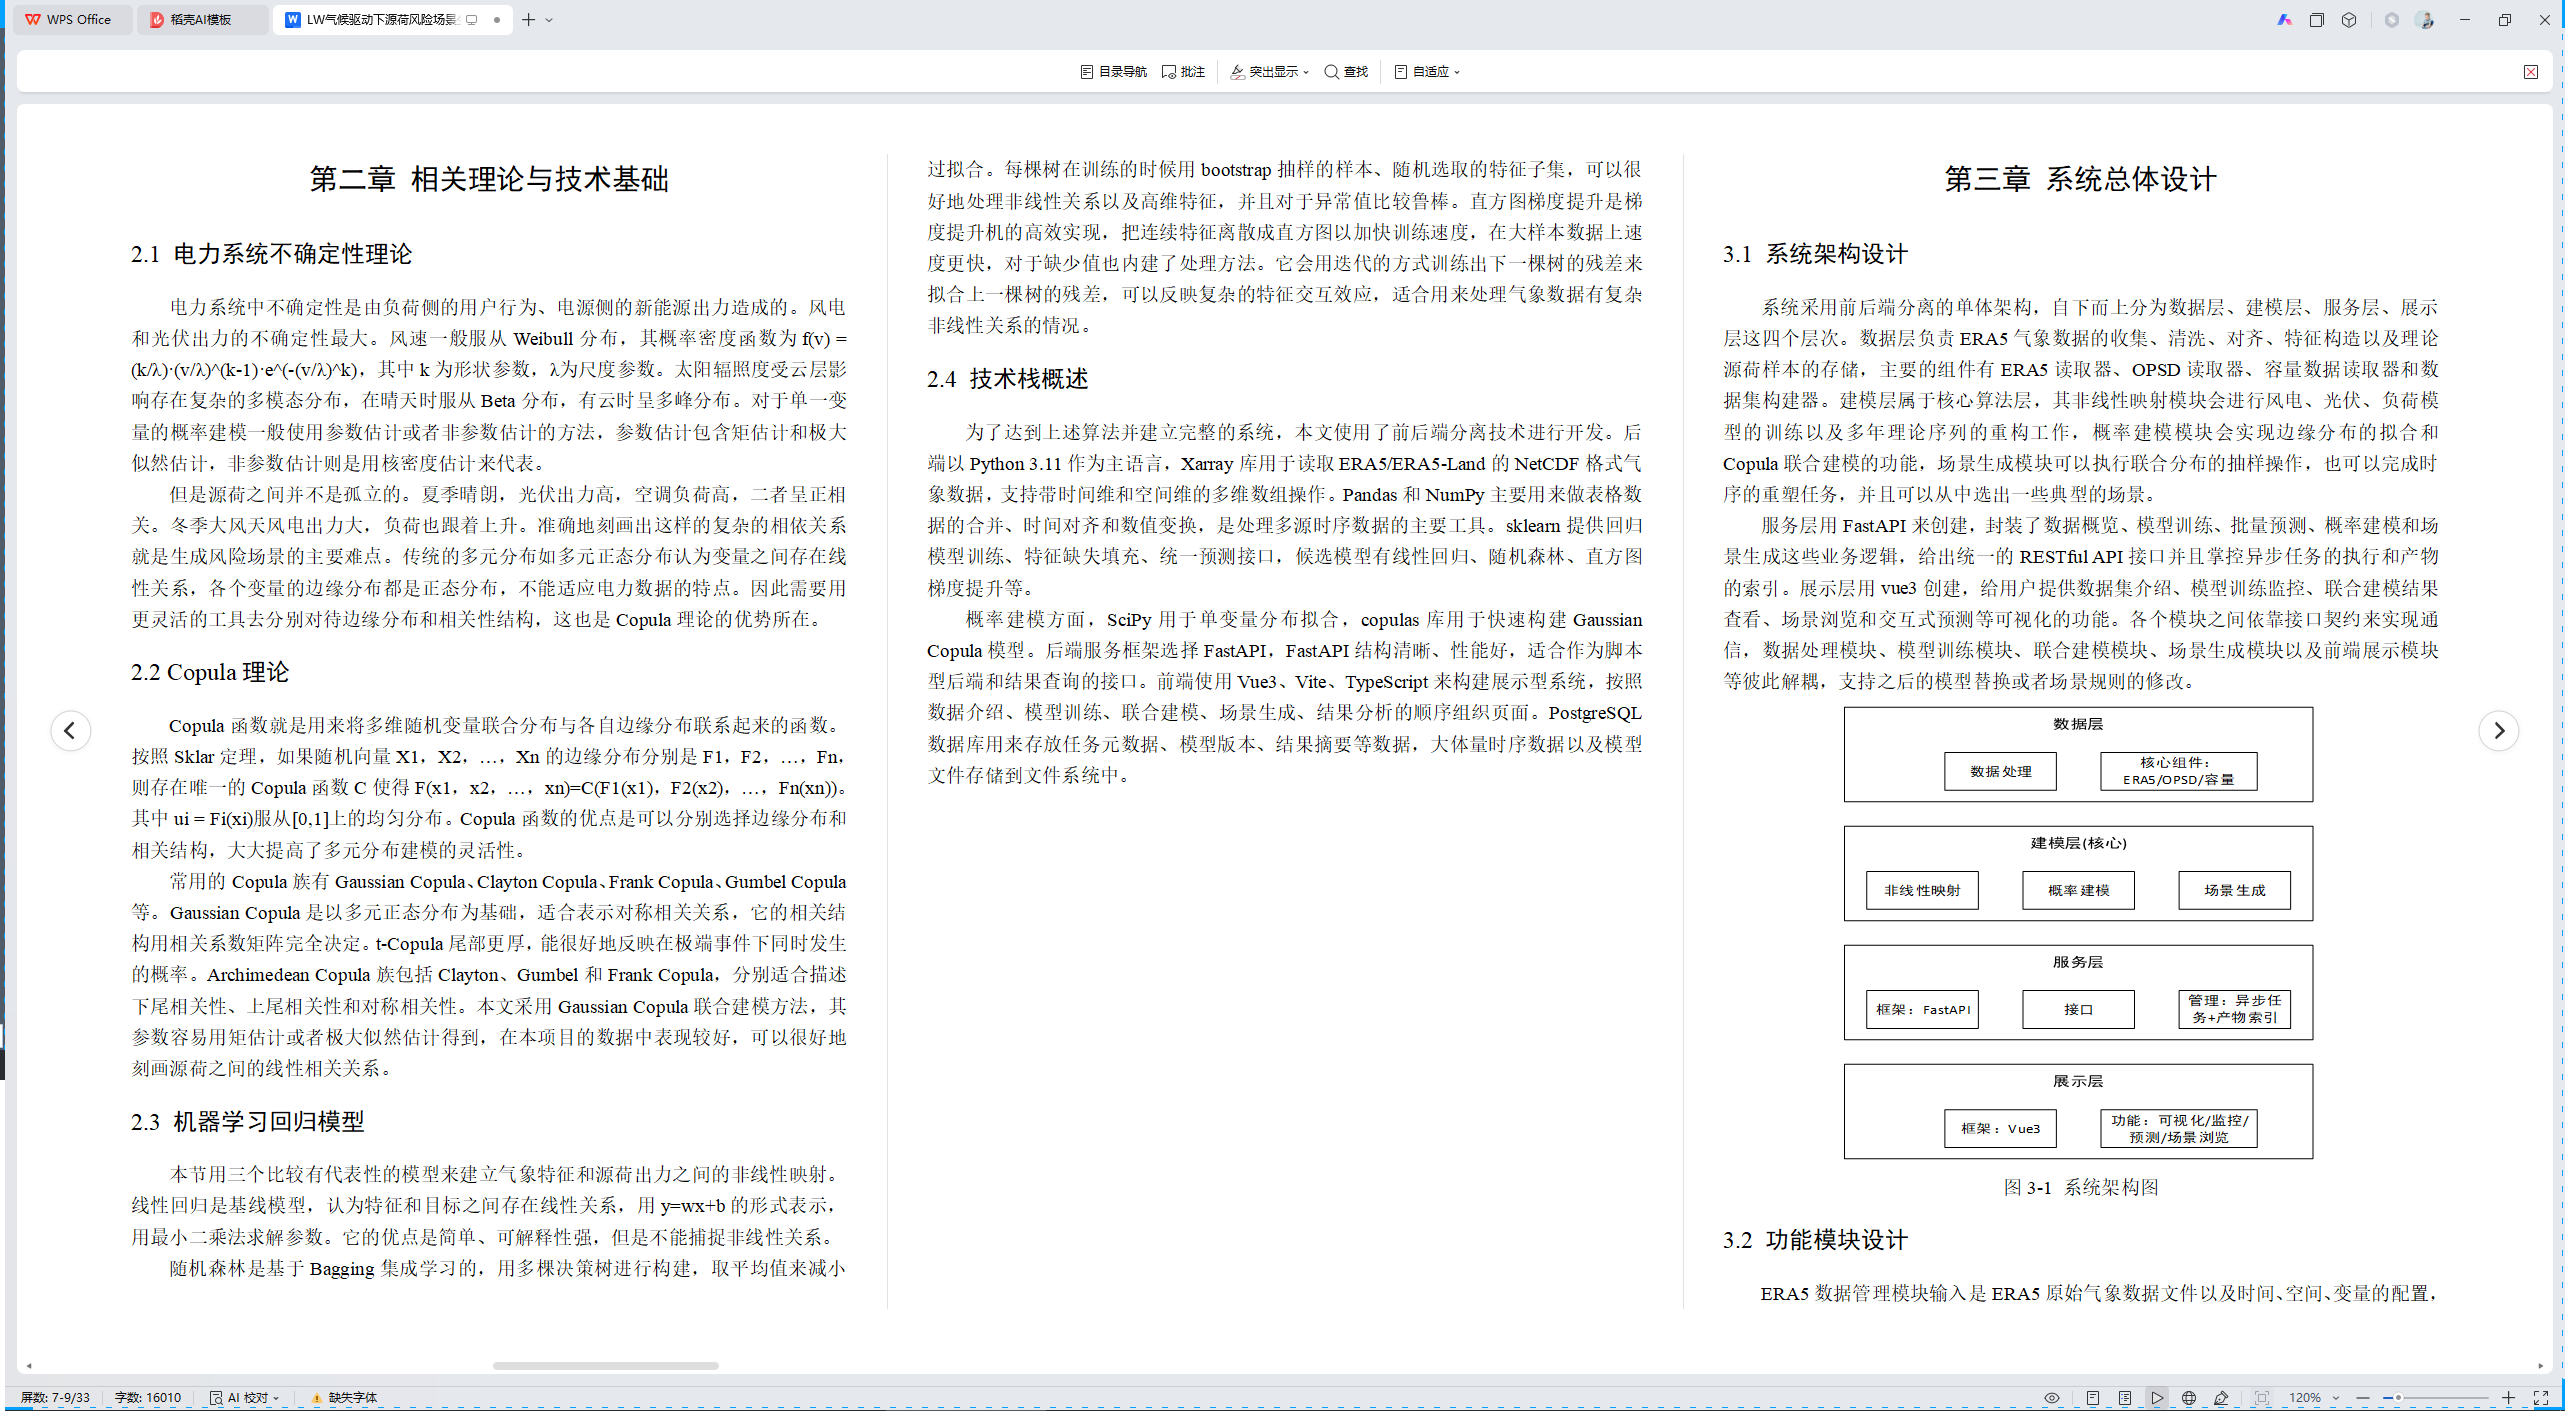
系统采用前后端分离的单体架构,自下而上分为数据层、建模层、服务层、展示层这四个层次。数据层负责ERA5气象数据的收集、清洗、对齐、特征构造以及理论源荷样本的存储,主要的组件有ERA5读取器、OPSD读取器、容量数据读取器和数据集构建器。建模层属于核心算法层,其非线性映射模块会进行风电、光伏、负荷模型的训练以及多年理论序列的重构工作,概率建模模块会实现边缘分布的拟合和Copula联合建模的功能,场景生成模块可以执行联合分布的抽样操作,也可以完成时序的重塑任务,并且可以从中选出一些典型的场景。
服务层用FastAPI来创建,封装了数据概览、模型训练、批量预测、概率建模和场景生成这些业务逻辑,给出统一的RESTful API接口并且掌控异步任务的执行和产物的索引。展示层用vue3创建,给用户提供数据集介绍、模型训练监控、联合建模结果查看、场景浏览和交互式预测等可视化的功能。各个模块之间依靠接口契约来实现通信,数据处理模块、模型训练模块、联合建模模块、场景生成模块以及前端展示模块等彼此解耦,支持之后的模型替换或者场景规则的修改。
图3-1 系统架构图
3.2 功能模块设计
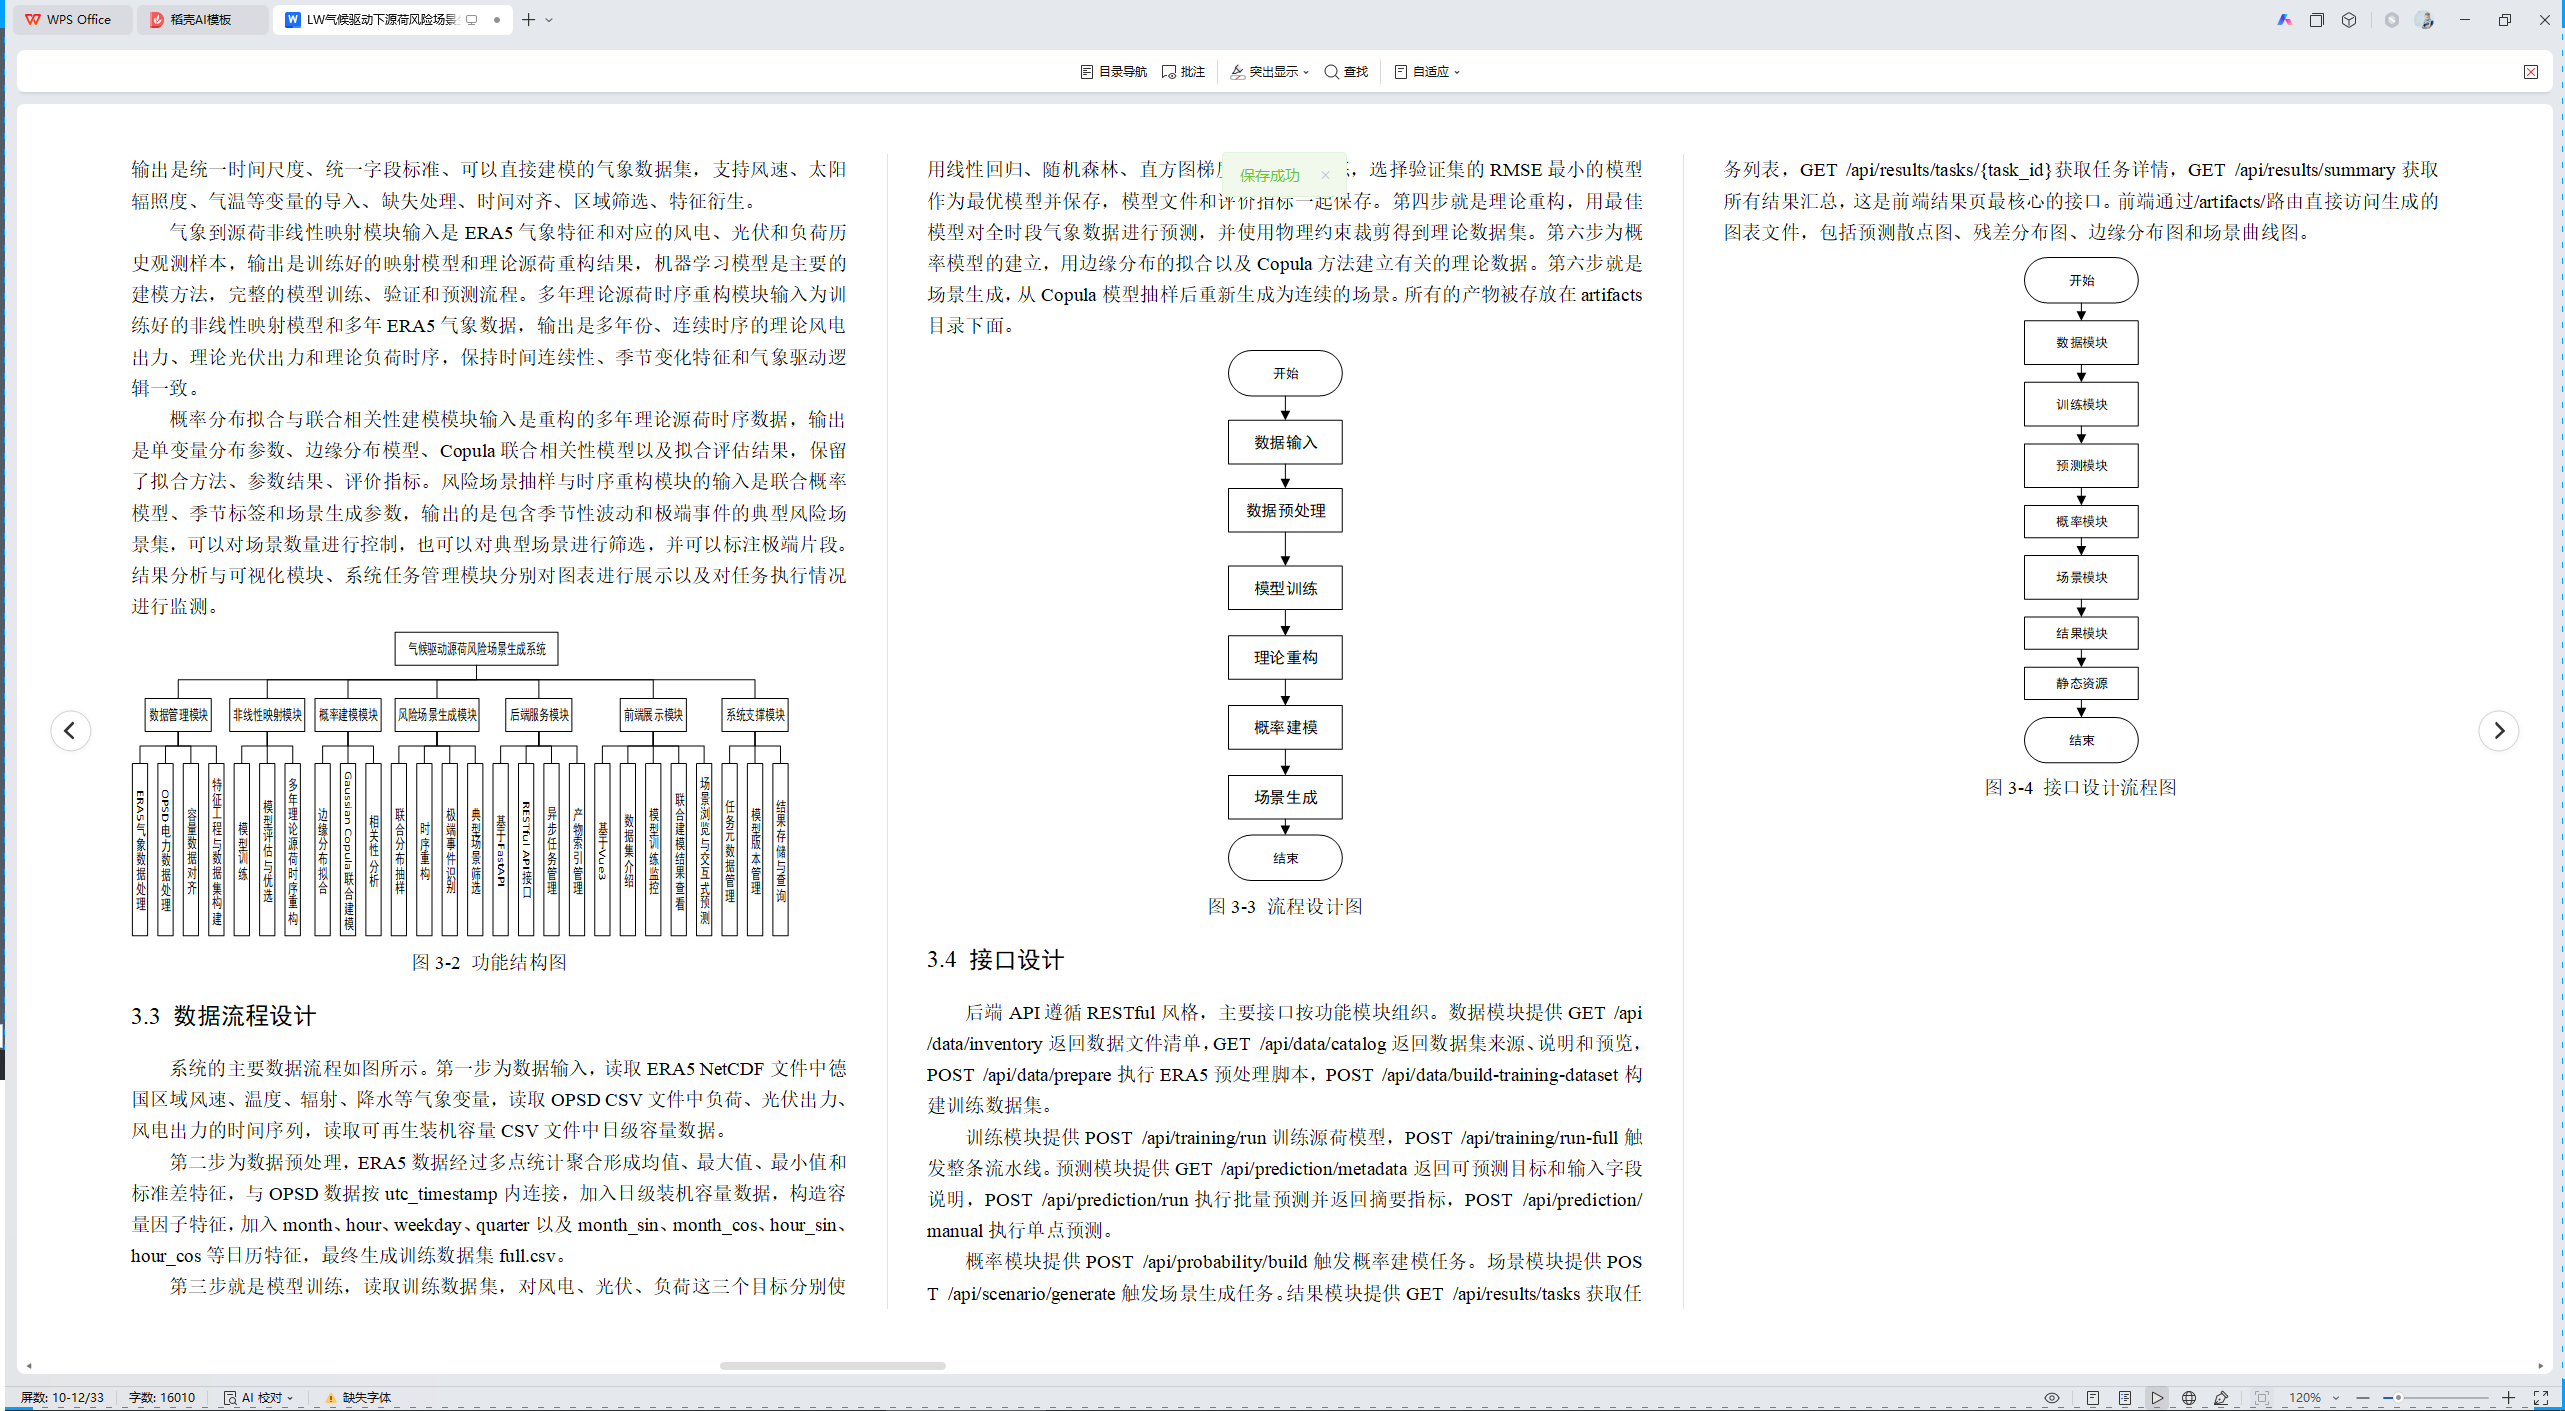
ERA5数据管理模块输入是ERA5原始气象数据文件以及时间、空间、变量的配置,输出是统一时间尺度、统一字段标准、可以直接建模的气象数据集,支持风速、太阳辐照度、气温等变量的导入、缺失处理、时间对齐、区域筛选、特征衍生。
气象到源荷非线性映射模块输入是ERA5气象特征和对应的风电、光伏和负荷历史观测样本,输出是训练好的映射模型和理论源荷重构结果,机器学习模型是主要的建模方法,完整的模型训练、验证和预测流程。多年理论源荷时序重构模块输入为训练好的非线性映射模型和多年ERA5气象数据,输出是多年份、连续时序的理论风电出力、理论光伏出力和理论负荷时序,保持时间连续性、季节变化特征和气象驱动逻辑一致。
概率分布拟合与联合相关性建模模块输入是重构的多年理论源荷时序数据,输出是单变量分布参数、边缘分布模型、Copula联合相关性模型以及拟合评估结果,保留了拟合方法、参数结果、评价指标。风险场景抽样与时序重构模块的输入是联合概率模型、季节标签和场景生成参数,输出的是包含季节性波动和极端事件的典型风险场景集,可以对场景数量进行控制,也可以对典型场景进行筛选,并可以标注极端片段。结果分析与可视化模块、系统任务管理模块分别对图表进行展示以及对任务执行情况进行监测。
图3-2 功能结构图
3.3 数据流程设计
系统的主要数据流程如图所示。第一步为数据输入,读取ERA5 NetCDF文件中德国区域风速、温度、辐射、降水等气象变量,读取OPSD CSV文件中负荷、光伏出力、风电出力的时间序列,读取可再生装机容量CSV文件中日级容量数据。
第二步为数据预处理,ERA5数据经过多点统计聚合形成均值、最大值、最小值和标准差特征,与OPSD数据按utc_timestamp内连接,加入日级装机容量数据,构造容量因子特征,加入month、hour、weekday、quarter以及month_sin、month_cos、hour_sin、hour_cos等日历特征,最终生成训练数据集full.csv。
第三步就是模型训练,读取训练数据集,对风电、光伏、负荷这三个目标分别使用线性回归、随机森林、直方图梯度提升进行训练,选择验证集的RMSE最小的模型作为最优模型并保存,模型文件和评价指标一起保存。第四步就是理论重构,用最佳模型对全时段气象数据进行预测,并使用物理约束裁剪得到理论数据集。第六步为概率模型的建立,用边缘分布的拟合以及Copula方法建立有关的理论数据。第六步就是场景生成,从Copula模型抽样后重新生成为连续的场景。所有的产物被存放在artifacts目录下面。
图3-3 流程设计图
3.4 接口设计
后端API遵循RESTful风格,主要接口按功能模块组织。数据模块提供GET /api/data/inventory返回数据文件清单,GET /api/data/catalog返回数据集来源、说明和预览,POST /api/data/prepare执行ERA5预处理脚本,POST /api/data/build-training-dataset构建训练数据集。
训练模块提供POST /api/training/run训练源荷模型,POST /api/training/run-full触发整条流水线。预测模块提供GET /api/prediction/metadata返回可预测目标和输入字段说明,POST /api/prediction/run执行批量预测并返回摘要指标,POST /api/prediction/manual执行单点预测。
概率模块提供POST /api/probability/build触发概率建模任务。场景模块提供POST /api/scenario/generate触发场景生成任务。结果模块提供GET /api/results/tasks获取任务列表,GET /api/results/tasks/{task_id}获取任务详情,GET /api/results/summary获取所有结果汇总,这是前端结果页最核心的接口。前端通过/artifacts/路由直接访问生成的图表文件,包括预测散点图、残差分布图、边缘分布图和场景曲线图。
图3-4 接口设计流程图
第四章 核心算法与实现
4.1 数据预处理与特征工程
数据预处理是保证模型效果的基础,流程如下。气象数据处理使用Xarray读取德国区域ERA5-Land数据,选取关键变量包括10米风速u分量u10、10米风速v分量v10、2米温度t2m、2米露点温度d2m、地表气压sp、地表净太阳辐射ssrd、总降水量tp。对区域内所有格点计算mean、max、min、std,作为该时刻的气象特征,并合成wind_speed特征。电力数据处理读取OPSD的time_series_60min_singleindex.csv,提取DE_load_actual_entsoe_transparency映射为load_actual,DE_solar_generation_actual映射为solar_generation_actual,DE_wind_generation_actual及陆上海上风电映射为wind_generation_actual。
容量数据处理读取renewable_capacity_timeseries.csv,按日对齐DE_solar_capacity、DE_wind_capacity、DE_wind_onshore_capacity、DE_wind_offshore_capacity,并计算容量因子。日历特征从时间戳中提取year、month、hour、weekday、quarter,并构造month_sin、month_cos、hour_sin、hour_cos以编码周期性。数据对齐与划分以utc_timestamp为主键,将所有特征与目标列内连接,形成完整数据集。按时间顺序划分为70%训练集、15%验证集、15%测试集,避免未来信息泄漏。最终数据集包含96384行样本和56个特征列。
4.2 气象到源荷非线性映射模型
对于风电、光伏和负荷三个目标变量,分别训练线性回归、随机森林和直方图梯度提升三种模型。线性回归使用sklearn.linear_model.LinearRegression,无额外超参数。随机森林使用sklearn.ensemble.RandomForestRegressor,设置n_estimators=100、max_depth=10、random_state=42。直方图梯度提升使用sklearn.ensemble.HistGradientBoostingRegressor,设置max_iter=100、max_depth=5、random_state=42。所有模型封装在Pipeline中,第一步使用SimpleImputer以中位数填补缺失值,第二步为具体回归模型。
采用时间顺序分层的验证集,对于每一个目标分别计算出各个模型在验证集上的MAE、RMSE、R²、MAPE等指标,从中选取RMSE最小的模型作为最优模型。确定出最好的模型之后,用全部的训练数据(训练集+验证集)重新拟合模型,保存模型文件、指标日志、评估图表。评估图表有预测散点图来观察预测值和真实值的分布情况,还有残差分布直方图用来检验误差是不是零均值正态分布。模型文件及图表都被存放在artifacts/models各个目标子目录之中。
4.3 模型训练结果
三类目标的最好模型都为直方图梯度提升。风电出力模型的验证集MAE为2440.48,RMSE为3197.36,R²为0.8975,MAPE为29.44%。R²接近于0.9说明风速、气压等气象因素对于风电出力有较强的解释作用。光伏出力模型的验证集MAE为592.24,RMSE为1127.36,R²为0.9776,MAPE为184.11%。R²很高,表示使用辐射、温度特征建立的模型拟合程度最好,但是由于夜间、低辐照时段的真实值非常接近于0,微小的误差都会被放大成较大的百分比,因此此指标在本部分中不可作为主要指标使用。
负荷模型的验证集MAE为3459.80,RMSE为4720.76,R²为0.7770,MAPE为6.08%。负荷模型优于线性回归但不如风光模型稳定,说明仅靠当前气象与周期特征仍无法完全解释负荷波动,还受到社会经济活动、节假日等未纳入特征的影响。每个目标保存的产物包括模型pkl文件、metrics指标JSON文件、training_log训练日志JSON文件、prediction_scatter预测散点图png和residual_hist残差分布图png。
4.4 多年理论源荷重构
理论重构逻辑位于reconstruction.py和theoretical_dataset.py。处理方法如下,对于训练得到的最佳模型,分别对其进行重构,得到三个目标各自的理论时序文件,将理论值写回统一的理论数据集,用物理约束防止负值和不合理上界,重新计算容量因子保证理论数据集内部一致。具体地,风电理论出力裁剪范围为0, DE_wind_capacity,光伏理论出力裁剪范围为0, DE_solar_capacity,负荷理论出力裁剪范围为[0, +∞)仅保证非负。
重构结果包含风电理论序列theoretical_series.csv、光伏理论序列和负荷理论序列,都是96384行。三个序列统一汇总到theoretical/full.csv,该理论数据集包含96384行样本和58个特征列。与训练集相比,理论数据集多出了一个重算后的容量因子字段,更加适合用作概率建模以及场景生成的输入。重建后理论序列的日变化模式、季节趋势与原始序列基本相同,证明了模型是正确的。
4.5 源荷联合概率建模
概率建模入口为build_probability_model.py,核心实现在marginal_fitting.py、evaluator.py和copula_model.py。联合建模输入列为wind_generation_actual、solar_generation_actual和load_actual三个变量。边缘分布拟合对每个变量测试norm、gamma、gamma_positive和lognorm等分布,gamma_positive是专门处理含零值数据的Gamma分布变体。使用Kolmogorov-Smirnov检验评估拟合优度,KS统计量越小表示拟合越好。
拟合结果:风电选择gamma_positive,KS=0.0160,零值占比0.0036,拟合极佳。光伏选择gamma_positive,KS=0.0974,零值占比0.2656,考虑了较高比例的夜间零值。负荷选择norm,KS=0.0719,零值占比0,正态分布近似成立。将风电、光伏的边缘分布函数值u1、u2、u3作为输入建立Gaussian Copula模型,得到的相关系数矩阵中风电与光伏的相关系数为-0.1512,呈弱负相关,符合大风天通常多云的气象常识。光伏和负荷的相关系数为0.3695,属于中等正相关,说明夏季高温会引起光伏和负荷的同步升高。风电与负荷相关系数为0.0851,相关性很低,说明负荷对风速没有影响。概率建模结果保存在probability_summary.json中。
4.6 风险场景生成
场景生成核心实现位于sampler.py、temporal_rebuilder.py、extreme_event.py和selector.py。实际处理步骤为:从Gaussian Copula中抽样联合样本,对风电、光伏、负荷应用物理约束,根据历史时序结构重建连续场景,标记极端事件,从重建结果中筛选典型场景。
联合抽样从拟合好的Gaussian Copula中抽取200个联合概率样本(u1,u2,u3),通过各边缘分布的分位数函数PPF将u值转换为实际出力/负荷值,得到200组风电、光伏、负荷的联合样本,保存为sampled_joint_scenarios.csv。时序重建把抽样样本嵌入到历史日变化模式当中,用马尔可夫链方法重建小时级序列,得到一个长度为8928行的连续风险场景序列rebuilt_risk_scenarios.csv。极端事件标记使用阈值法,即风电少于10%的时序作为风电不足的标记,光伏等于0的时序作为光伏中断的标记,负荷大于90%分位数的时序作为负荷超载的标记。典型场景筛选从重建结果中用聚类方法选出10个有代表性的场景,分别为低风电-高负荷冬季场景、高光伏-高负荷夏季场景等,存入typical_risk_scenarios.csv。场景生成模块修复了早期版本光伏抽样结果出现负数的问题
第五章 结果分析
5.1 开发环境与部署
开发环境为WSL2 Ubuntu 20.04,配备16GB内存。后端语言版本为Python 3.11,前端语言与运行环境为Node.js 20与Vue 3。关键Python依赖包括pandas、numpy、xarray、scikit-learn、scipy、copulas、matplotlib、seaborn、fastapi、uvicorn。数据库采用PostgreSQL 15用于记录任务元数据,但当前版本主要使用文件系统存储产物,数据库为可选组件。
后端启动命令为cd backend && uvicorn app.main:app --host 0.0.0.0 --port 8000 --reload,可以访问健康检查http://127.0.0.1:8000/health和API根http://127.0.0.1:8000/api。前端启动命令为cd frontend && npm install && npm run dev。全流程运行命令为uv run python scripts/run_full_pipeline.py,这个命令会依次进行数据准备、训练集创建、模型训练、理论重塑、概率拟合以及场景生成。所有的结果都会存放在backend/artifacts目录下面,分为datasets、models、probability、reconstruction、scenarios等子目录。
5.2 数据库表设计
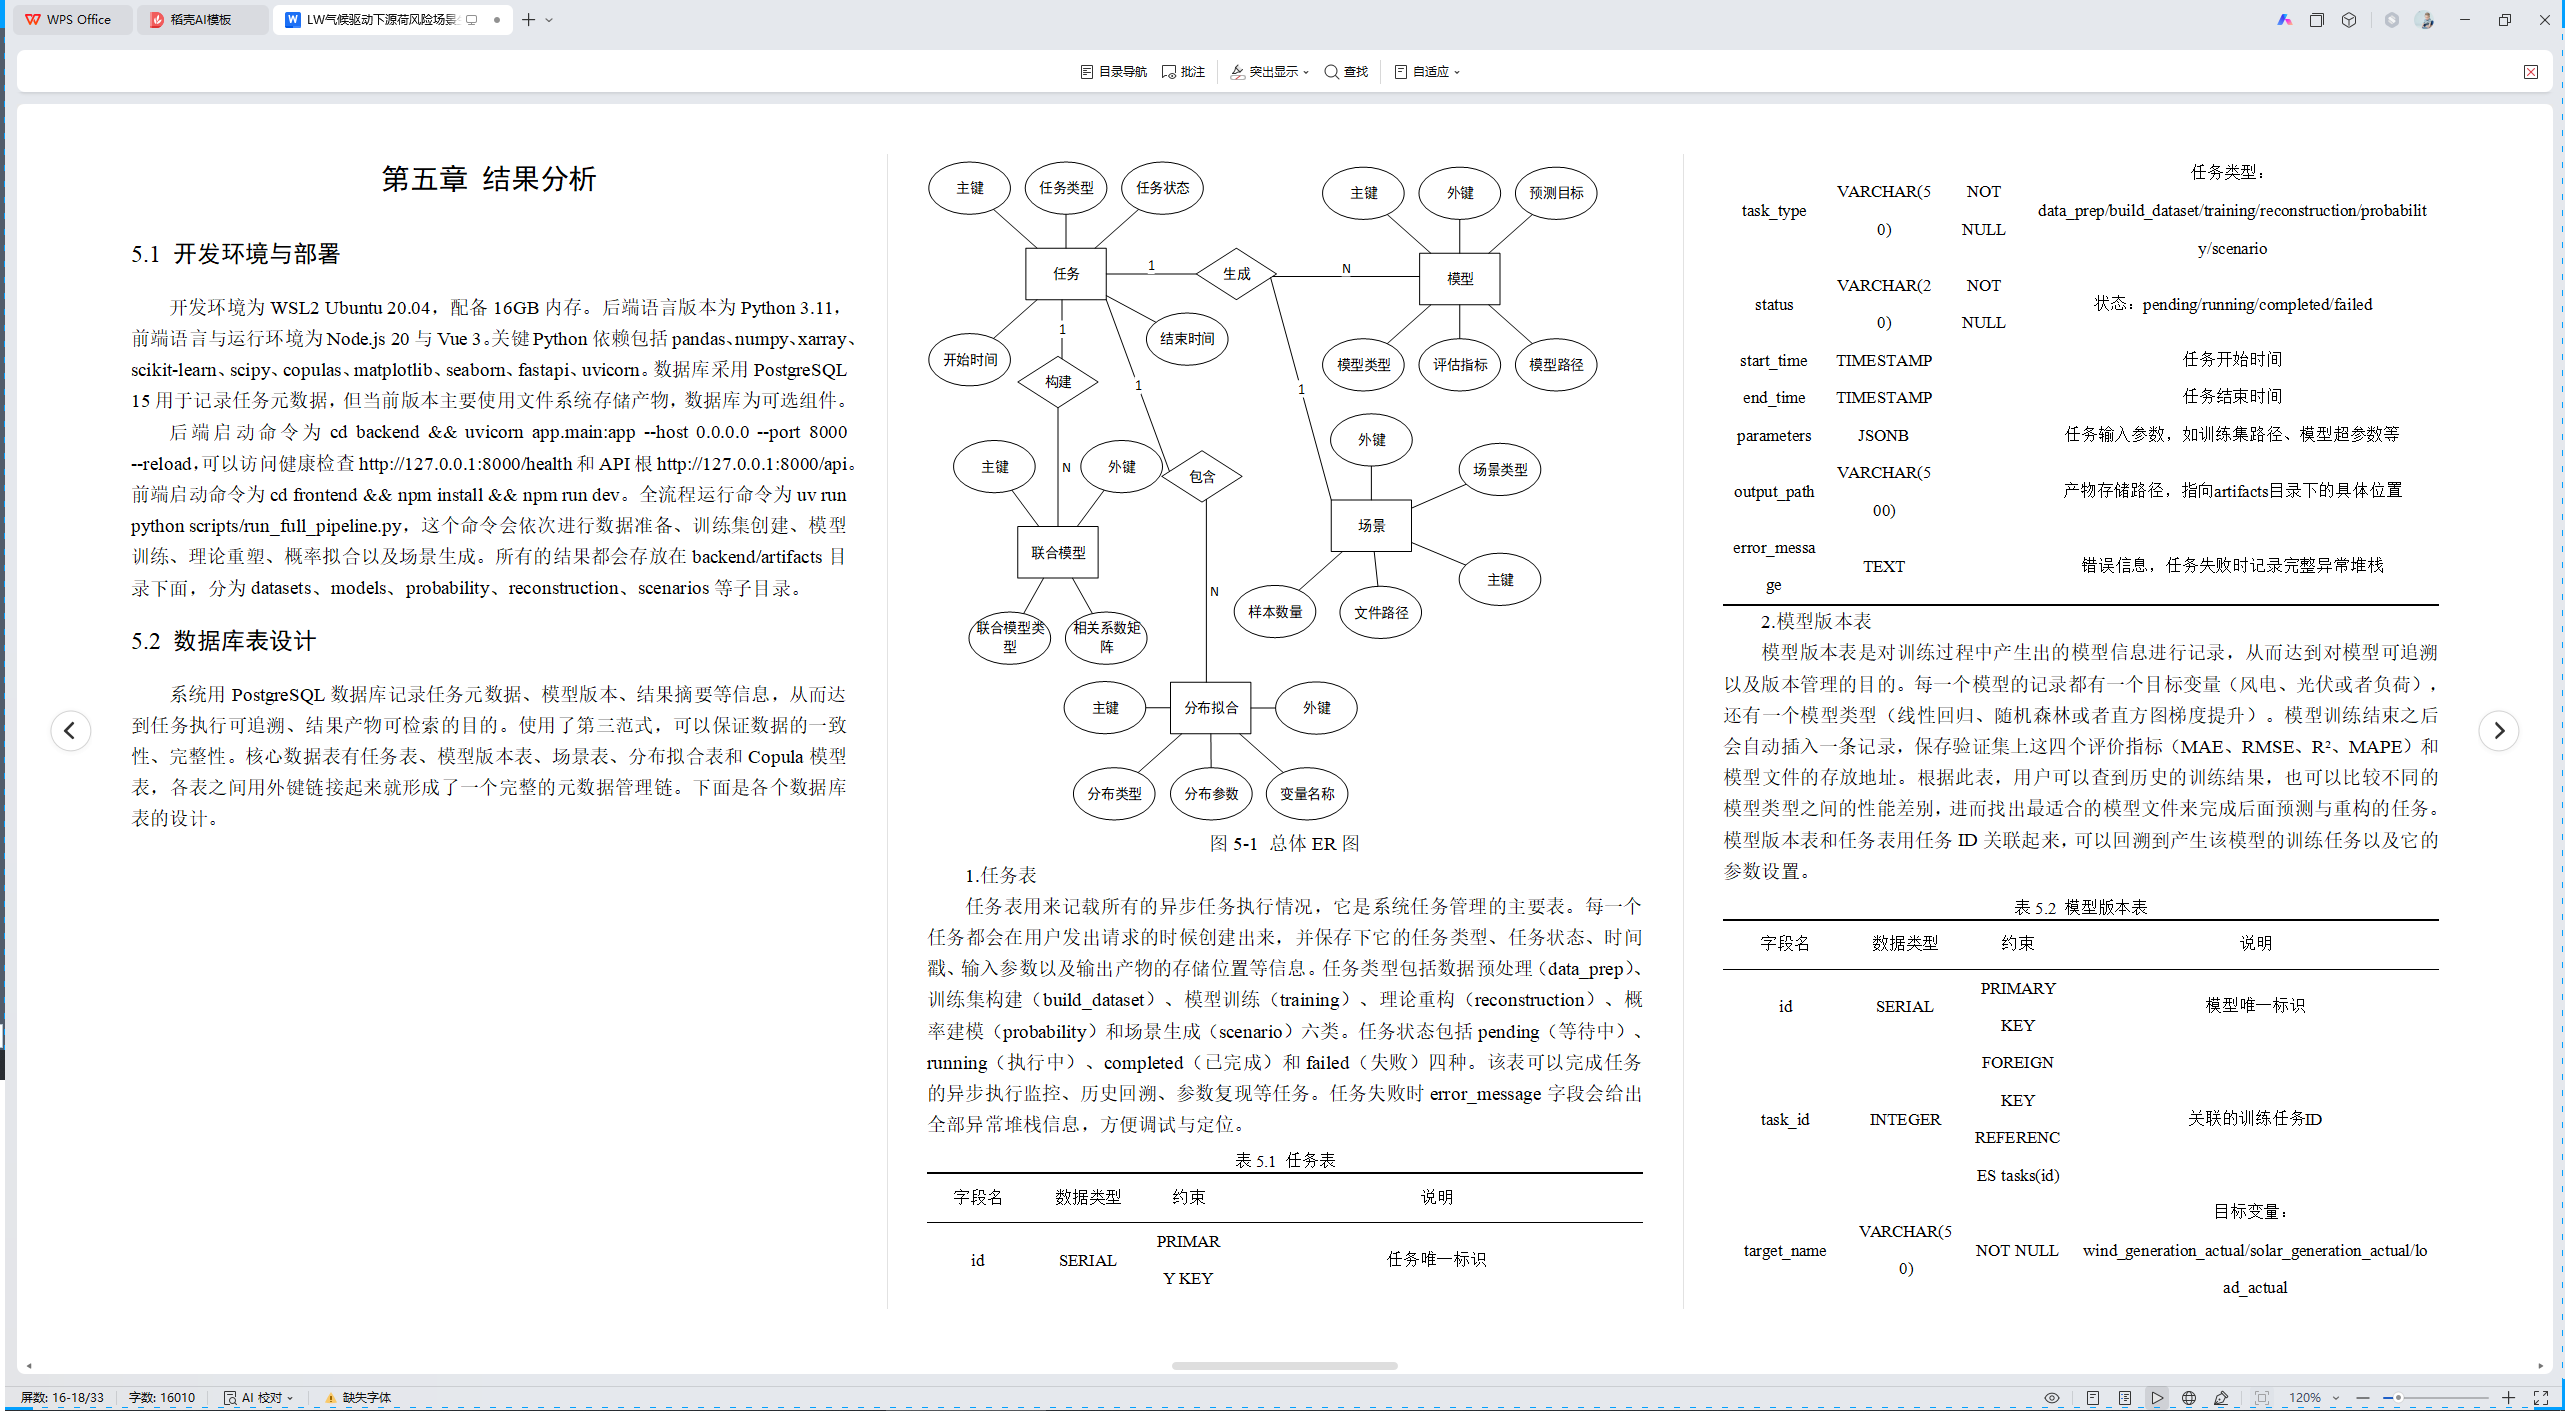
系统用PostgreSQL数据库记录任务元数据、模型版本、结果摘要等信息,从而达到任务执行可追溯、结果产物可检索的目的。使用了第三范式,可以保证数据的一致性、完整性。核心数据表有任务表、模型版本表、场景表、分布拟合表和Copula模型表,各表之间用外键链接起来就形成了一个完整的元数据管理链。下面是各个数据库表的设计。
图5-1 总体ER图
1.任务表
任务表用来记载所有的异步任务执行情况,它是系统任务管理的主要表。每一个任务都会在用户发出请求的时候创建出来,并保存下它的任务类型、任务状态、时间戳、输入参数以及输出产物的存储位置等信息。任务类型包括数据预处理(data_prep)、训练集构建(build_dataset)、模型训练(training)、理论重构(reconstruction)、概率建模(probability)和场景生成(scenario)六类。任务状态包括pending(等待中)、running(执行中)、completed(已完成)和failed(失败)四种。该表可以完成任务的异步执行监控、历史回溯、参数复现等任务。任务失败时error_message字段会给出全部异常堆栈信息,方便调试与定位。
表5.1 任务表
|---------------|--------------|-------------|---------------------------------------------------------------------------|
| 字段名 | 数据类型 | 约束 | 说明 |
| id | SERIAL | PRIMARY KEY | 任务唯一标识 |
| task_type | VARCHAR(50) | NOT NULL | 任务类型:data_prep/build_dataset/training/reconstruction/probability/scenario |
| status | VARCHAR(20) | NOT NULL | 状态:pending/running/completed/failed |
| start_time | TIMESTAMP | | 任务开始时间 |
| end_time | TIMESTAMP | | 任务结束时间 |
| parameters | JSONB | | 任务输入参数,如训练集路径、模型超参数等 |
| output_path | VARCHAR(500) | | 产物存储路径,指向artifacts目录下的具体位置 |
| error_message | TEXT | | 错误信息,任务失败时记录完整异常堆栈 |
2.模型版本表
模型版本表是对训练过程中产生出的模型信息进行记录,从而达到对模型可追溯以及版本管理的目的。每一个模型的记录都有一个目标变量(风电、光伏或者负荷),还有一个模型类型(线性回归、随机森林或者直方图梯度提升)。模型训练结束之后会自动插入一条记录,保存验证集上这四个评价指标(MAE、RMSE、R²、MAPE)和模型文件的存放地址。根据此表,用户可以查到历史的训练结果,也可以比较不同的模型类型之间的性能差别,进而找出最适合的模型文件来完成后面预测与重构的任务。模型版本表和任务表用任务ID关联起来,可以回溯到产生该模型的训练任务以及它的参数设置。
表5.2 模型版本表
|--------------------|--------------|----------------------------------|-----------------------------------------------------------------|
| 字段名 | 数据类型 | 约束 | 说明 |
| id | SERIAL | PRIMARY KEY | 模型唯一标识 |
| task_id | INTEGER | FOREIGN KEY REFERENCES tasks(id) | 关联的训练任务ID |
| target_name | VARCHAR(50) | NOT NULL | 目标变量:wind_generation_actual/solar_generation_actual/load_actual |
| model_type | VARCHAR(50) | NOT NULL | 模型类型:linear_regression/random_forest/hist_gradient_boosting |
| train_dataset_path | VARCHAR(500) | | 训练数据集路径 |
| validation_metrics | JSONB | | 验证集指标,包含MAE、RMSE、R²、MAPE四个字段 |
| model_file_path | VARCHAR(500) | | 模型pkl文件路径 |
| created_at | TIMESTAMP | DEFAULT NOW() | 创建时间 |
3.场景表
场景表是用来存放场景生成任务结果的,实现场景产物的索引。每个场景记录就是一个场景生成任务,场景类型有联合抽样场景(sampled),重建风险场景(rebuilt)和典型风险场景(typical)这三种。系统在场景产生之后马上把生成好的记录存入数据库,并且存取场景文件的存放位置以及样本数目。由表格可以方便地得到各种场景所产出的结果文件,从下载、对比分析、重新生成等几个选项中选取一种进行操作。场景表和任务表用任务ID关联起来,可以追溯出产生该场景的任务以及它的参数配置,即抽样的数量、是否注入极端事件等等。
表5.3 场景表
|---------------|--------------|----------------------------------|------------------------------------------|
| 字段名 | 数据类型 | 约束 | 说明 |
| id | SERIAL | PRIMARY KEY | 场景唯一标识 |
| task_id | INTEGER | FOREIGN KEY REFERENCES tasks(id) | 关联的场景生成任务ID |
| scenario_type | VARCHAR(50) | NOT NULL | 场景类型:sampled/rebuilt/typical |
| sample_count | INTEGER | | 样本数量,sampled为200,rebuilt为8928,typical为10 |
| file_path | VARCHAR(500) | | CSV场景文件路径 |
| generated_at | TIMESTAMP | DEFAULT NOW() | 生成时间 |
4.分布拟合表
分布拟合表用以记载边缘分布拟合情况,达成概率建模参数可追溯的目的。每个分布记录对应一个目标变量(风电、光伏或者负荷),存储拟合得到的最优分布类型、分布参数以及拟合优度指标。系统在完成概率建模任务之后,会自动产生三行数据,分别对应风电、光伏和负荷的边缘分布。分布类型包括norm(正态分布)、gamma(Gamma分布)和gamma_positive(处理零值的正Gamma分布)。参数用JSON的形式保存,如正态分布为均值、标准差,Gamma分布为形状参数、尺度参数。KS统计量可以用来评价拟合优度,KS值越小表示拟合效果越好。零值占比记录在光伏这种夜间无出力的情况下尤其重要。
表5.4 分布拟合表
|-------------------|-------------|----------------------------------|-----------------------------------------------------------------|
| 字段名 | 数据类型 | 约束 | 说明 |
| id | SERIAL | PRIMARY KEY | 分布唯一标识 |
| task_id | INTEGER | FOREIGN KEY REFERENCES tasks(id) | 关联的概率建模任务ID |
| variable_name | VARCHAR(50) | NOT NULL | 变量名称:wind_generation_actual/solar_generation_actual/load_actual |
| distribution_type | VARCHAR(50) | NOT NULL | 分布类型:norm/gamma/gamma_positive/lognorm |
| parameters | JSONB | | 分布参数,如norm包含mean和std,gamma包含shape和scale |
| ks_statistic | FLOAT | | Kolmogorov-Smirnov检验统计量,越小拟合越好 |
| zero_fraction | FLOAT | | 零值占比,光伏为0.2656,风电为0.0036,负荷为0 |
5.Copula模型表
Copula模型表记录了联合概率模型的信息,可以追溯到Copula建模的结果。每一个Copula模型就对应着一个概率建模的任务,保存下来的Copula类型、相关系数矩阵和拟合优度指标。系统在概率建模任务结束之后就立刻往系统里添加一条记录。Copula类型包括gaussian(Gaussian Copula)、t(t-Copula)和clayton(Clayton Copula)等,当前实现使用Gaussian Copula。相关系数矩阵用JSON格式保存,是3x3的一个矩阵,反映风电、光伏、负荷两两间的相关系数,风电和光伏的正相关系数为-0.1512,光伏和负荷的正相关系数为0.3695,风电和负荷的正相关系数为0.0851。对数似然值是Copula模型拟合好坏的评价指标,数值越大表示模型越合适。
表5.5 Copula模型表
|--------------------|-------------|----------------------------------|-----------------------------|
| 字段名 | 数据类型 | 约束 | 说明 |
| id | SERIAL | PRIMARY KEY | Copula模型唯一标识 |
| task_id | INTEGER | FOREIGN KEY REFERENCES tasks(id) | 关联的概率建模任务ID |
| copula_type | VARCHAR(50) | NOT NULL | Copula类型:gaussian/t/clayton |
| correlation_matrix | JSONB | | 3×3相关系数矩阵,JSON二维数组格式 |
| log_likelihood | FLOAT | | 对数似然值,评估拟合优度 |
| created_at | TIMESTAMP | DEFAULT NOW() | 创建时间 |
5.3 实验结果与讨论
理论重构效果验证用2015年夏季连续一周的数据,和理论重构序列以及原始OPSD序列进行对比。从结果中可以看出,理论光伏出力在正午时刻和原始曲线高度一致,可以很好地反映晴天与雨天转换所引起的波动。理论风电出力趋势和原始序列一致,但是在峰值处存在一定程度的低估,这是由于模型平均效应造成的。因此重新构造出的序列仍具有原来的季节性和日变化特征,适合用于概率建模。
场景生成合理性分析是从生成的典型场景中选择两个案例进行分析。场景A属于夏季极端高温情况,正午光伏发电功率接近满载状态,而且负荷也处于当日最高值,属于典型的源荷同增风险场景。场景B是冬季无风寒潮场景,风电出力一直低于平均值的20%,负荷由于取暖需求高居不下的原因出现源减荷增的供电紧张风险。符合电力系统物理认识的场景。
方法对比实验用历史源荷数据作为参数,只用ARIMA模型来进行场景的模拟。结果说明纯时间序列方法所生成的场景不能体现气象输入变化的情况,比如不能产生辐照度极低引起光伏出力急剧下降的情形。本文的方法因为加入风速、辐射、温度等气象驱动因素,可以产生与某种气象条件有关联的风险情景。风电、光伏、负荷模型验证集的R²分别是0.8975、0.9776和0.7770,说明气候驱动建模是有效的。
第六章 系统实现
6.1 数据准备模块实现
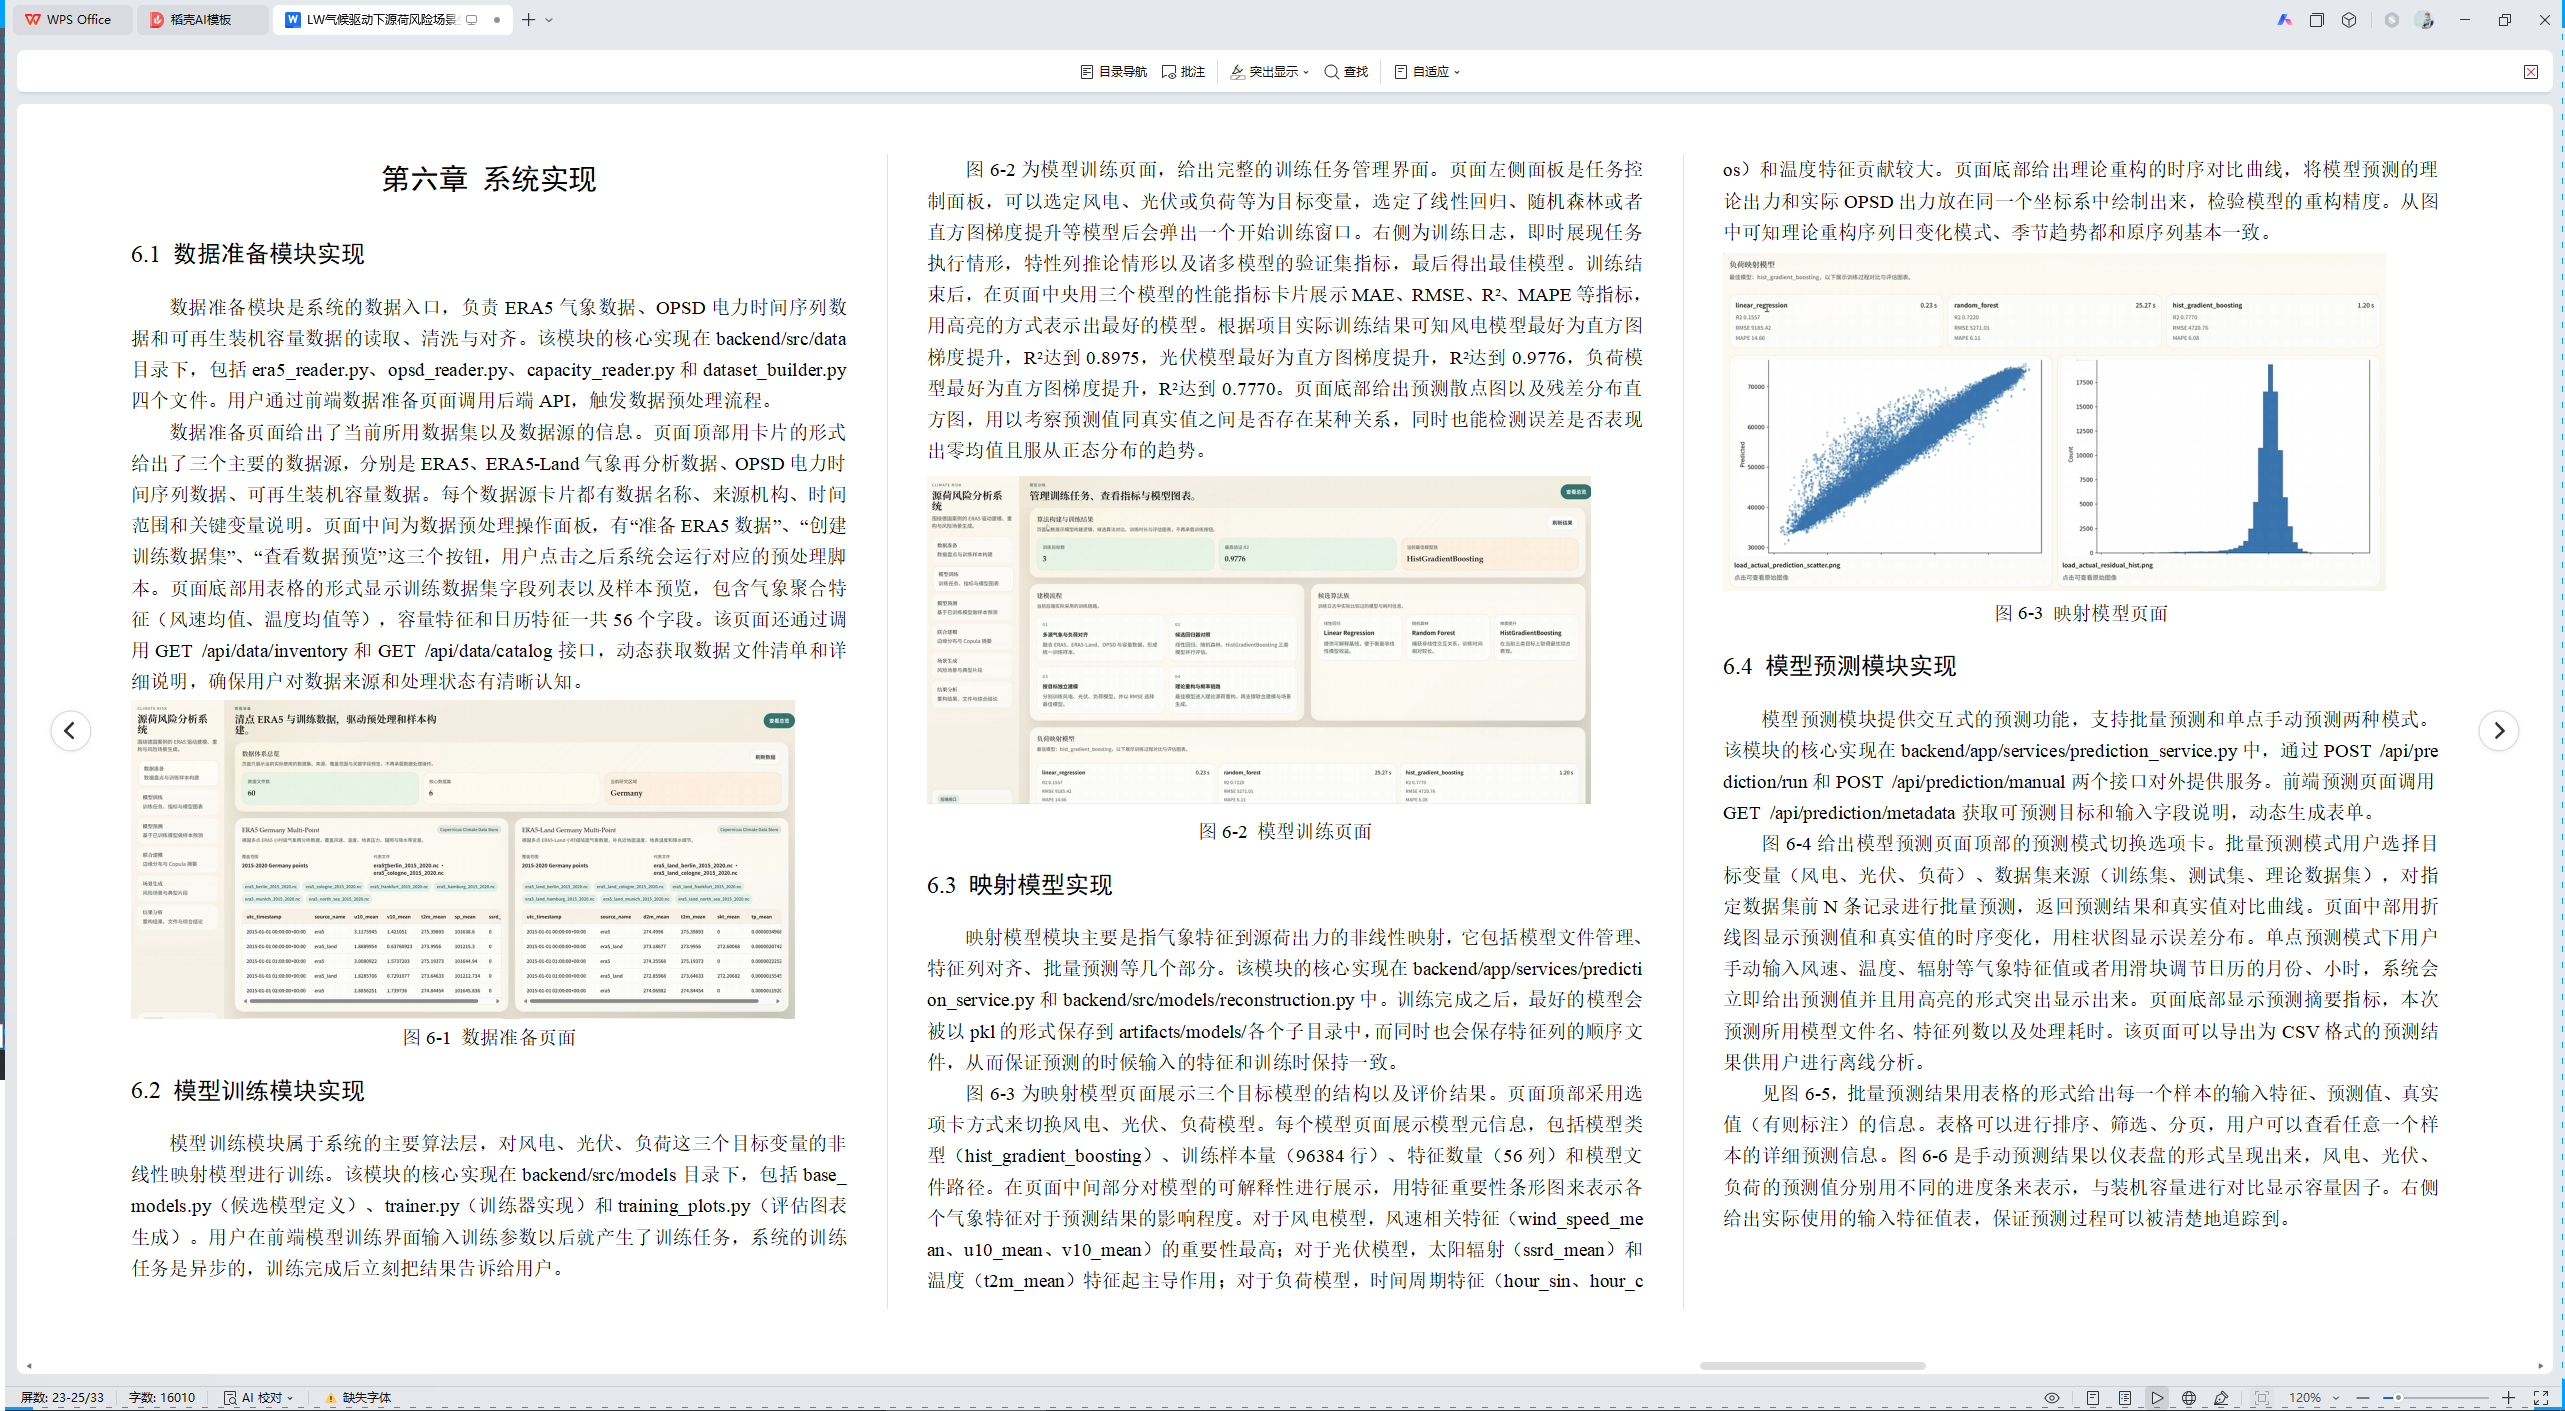
数据准备模块是系统的数据入口,负责ERA5气象数据、OPSD电力时间序列数据和可再生装机容量数据的读取、清洗与对齐。该模块的核心实现在backend/src/data目录下,包括era5_reader.py、opsd_reader.py、capacity_reader.py和dataset_builder.py四个文件。用户通过前端数据准备页面调用后端API,触发数据预处理流程。
数据准备页面给出了当前所用数据集以及数据源的信息。页面顶部用卡片的形式给出了三个主要的数据源,分别是ERA5、ERA5-Land气象再分析数据、OPSD电力时间序列数据、可再生装机容量数据。每个数据源卡片都有数据名称、来源机构、时间范围和关键变量说明。页面中间为数据预处理操作面板,有"准备ERA5数据"、"创建训练数据集"、"查看数据预览"这三个按钮,用户点击之后系统会运行对应的预处理脚本。页面底部用表格的形式显示训练数据集字段列表以及样本预览,包含气象聚合特征(风速均值、温度均值等),容量特征和日历特征一共56个字段。该页面还通过调用GET /api/data/inventory和GET /api/data/catalog接口,动态获取数据文件清单和详细说明,确保用户对数据来源和处理状态有清晰认知。
6-1 数据准备页面
6.2 模型训练模块实现
模型训练模块属于系统的主要算法层,对风电、光伏、负荷这三个目标变量的非线性映射模型进行训练。该模块的核心实现在backend/src/models目录下,包括base_models.py(候选模型定义)、trainer.py(训练器实现)和training_plots.py(评估图表生成)。用户在前端模型训练界面输入训练参数以后就产生了训练任务,系统的训练任务是异步的,训练完成后立刻把结果告诉给用户。
图6-2为模型训练页面,给出完整的训练任务管理界面。页面左侧面板是任务控制面板,可以选定风电、光伏或负荷等为目标变量,选定了线性回归、随机森林或者直方图梯度提升等模型后会弹出一个开始训练窗口。右侧为训练日志,即时展现任务执行情形,特性列推论情形以及诸多模型的验证集指标,最后得出最佳模型。训练结束后,在页面中央用三个模型的性能指标卡片展示MAE、RMSE、R²、MAPE等指标,用高亮的方式表示出最好的模型。根据项目实际训练结果可知风电模型最好为直方图梯度提升,R²达到0.8975,光伏模型最好为直方图梯度提升,R²达到0.9776,负荷模型最好为直方图梯度提升,R²达到0.7770。页面底部给出预测散点图以及残差分布直方图,用以考察预测值同真实值之间是否存在某种关系,同时也能检测误差是否表现出零均值且服从正态分布的趋势。
图6-2 模型训练页面
6.3 映射模型实现
映射模型模块主要是指气象特征到源荷出力的非线性映射,它包括模型文件管理、特征列对齐、批量预测等几个部分。该模块的核心实现在backend/app/services/prediction_service.py和backend/src/models/reconstruction.py中。训练完成之后,最好的模型会被以pkl的形式保存到artifacts/models/各个子目录中,而同时也会保存特征列的顺序文件,从而保证预测的时候输入的特征和训练时保持一致。
图6-3为映射模型页面展示三个目标模型的结构以及评价结果。页面顶部采用选项卡方式来切换风电、光伏、负荷模型。每个模型页面展示模型元信息,包括模型类型(hist_gradient_boosting)、训练样本量(96384行)、特征数量(56列)和模型文件路径。在页面中间部分对模型的可解释性进行展示,用特征重要性条形图来表示各个气象特征对于预测结果的影响程度。对于风电模型,风速相关特征(wind_speed_mean、u10_mean、v10_mean)的重要性最高;对于光伏模型,太阳辐射(ssrd_mean)和温度(t2m_mean)特征起主导作用;对于负荷模型,时间周期特征(hour_sin、hour_cos)和温度特征贡献较大。页面底部给出理论重构的时序对比曲线,将模型预测的理论出力和实际OPSD出力放在同一个坐标系中绘制出来,检验模型的重构精度。从图中可知理论重构序列日变化模式、季节趋势都和原序列基本一致。
图6-3 映射模型页面
6.4 模型预测模块实现
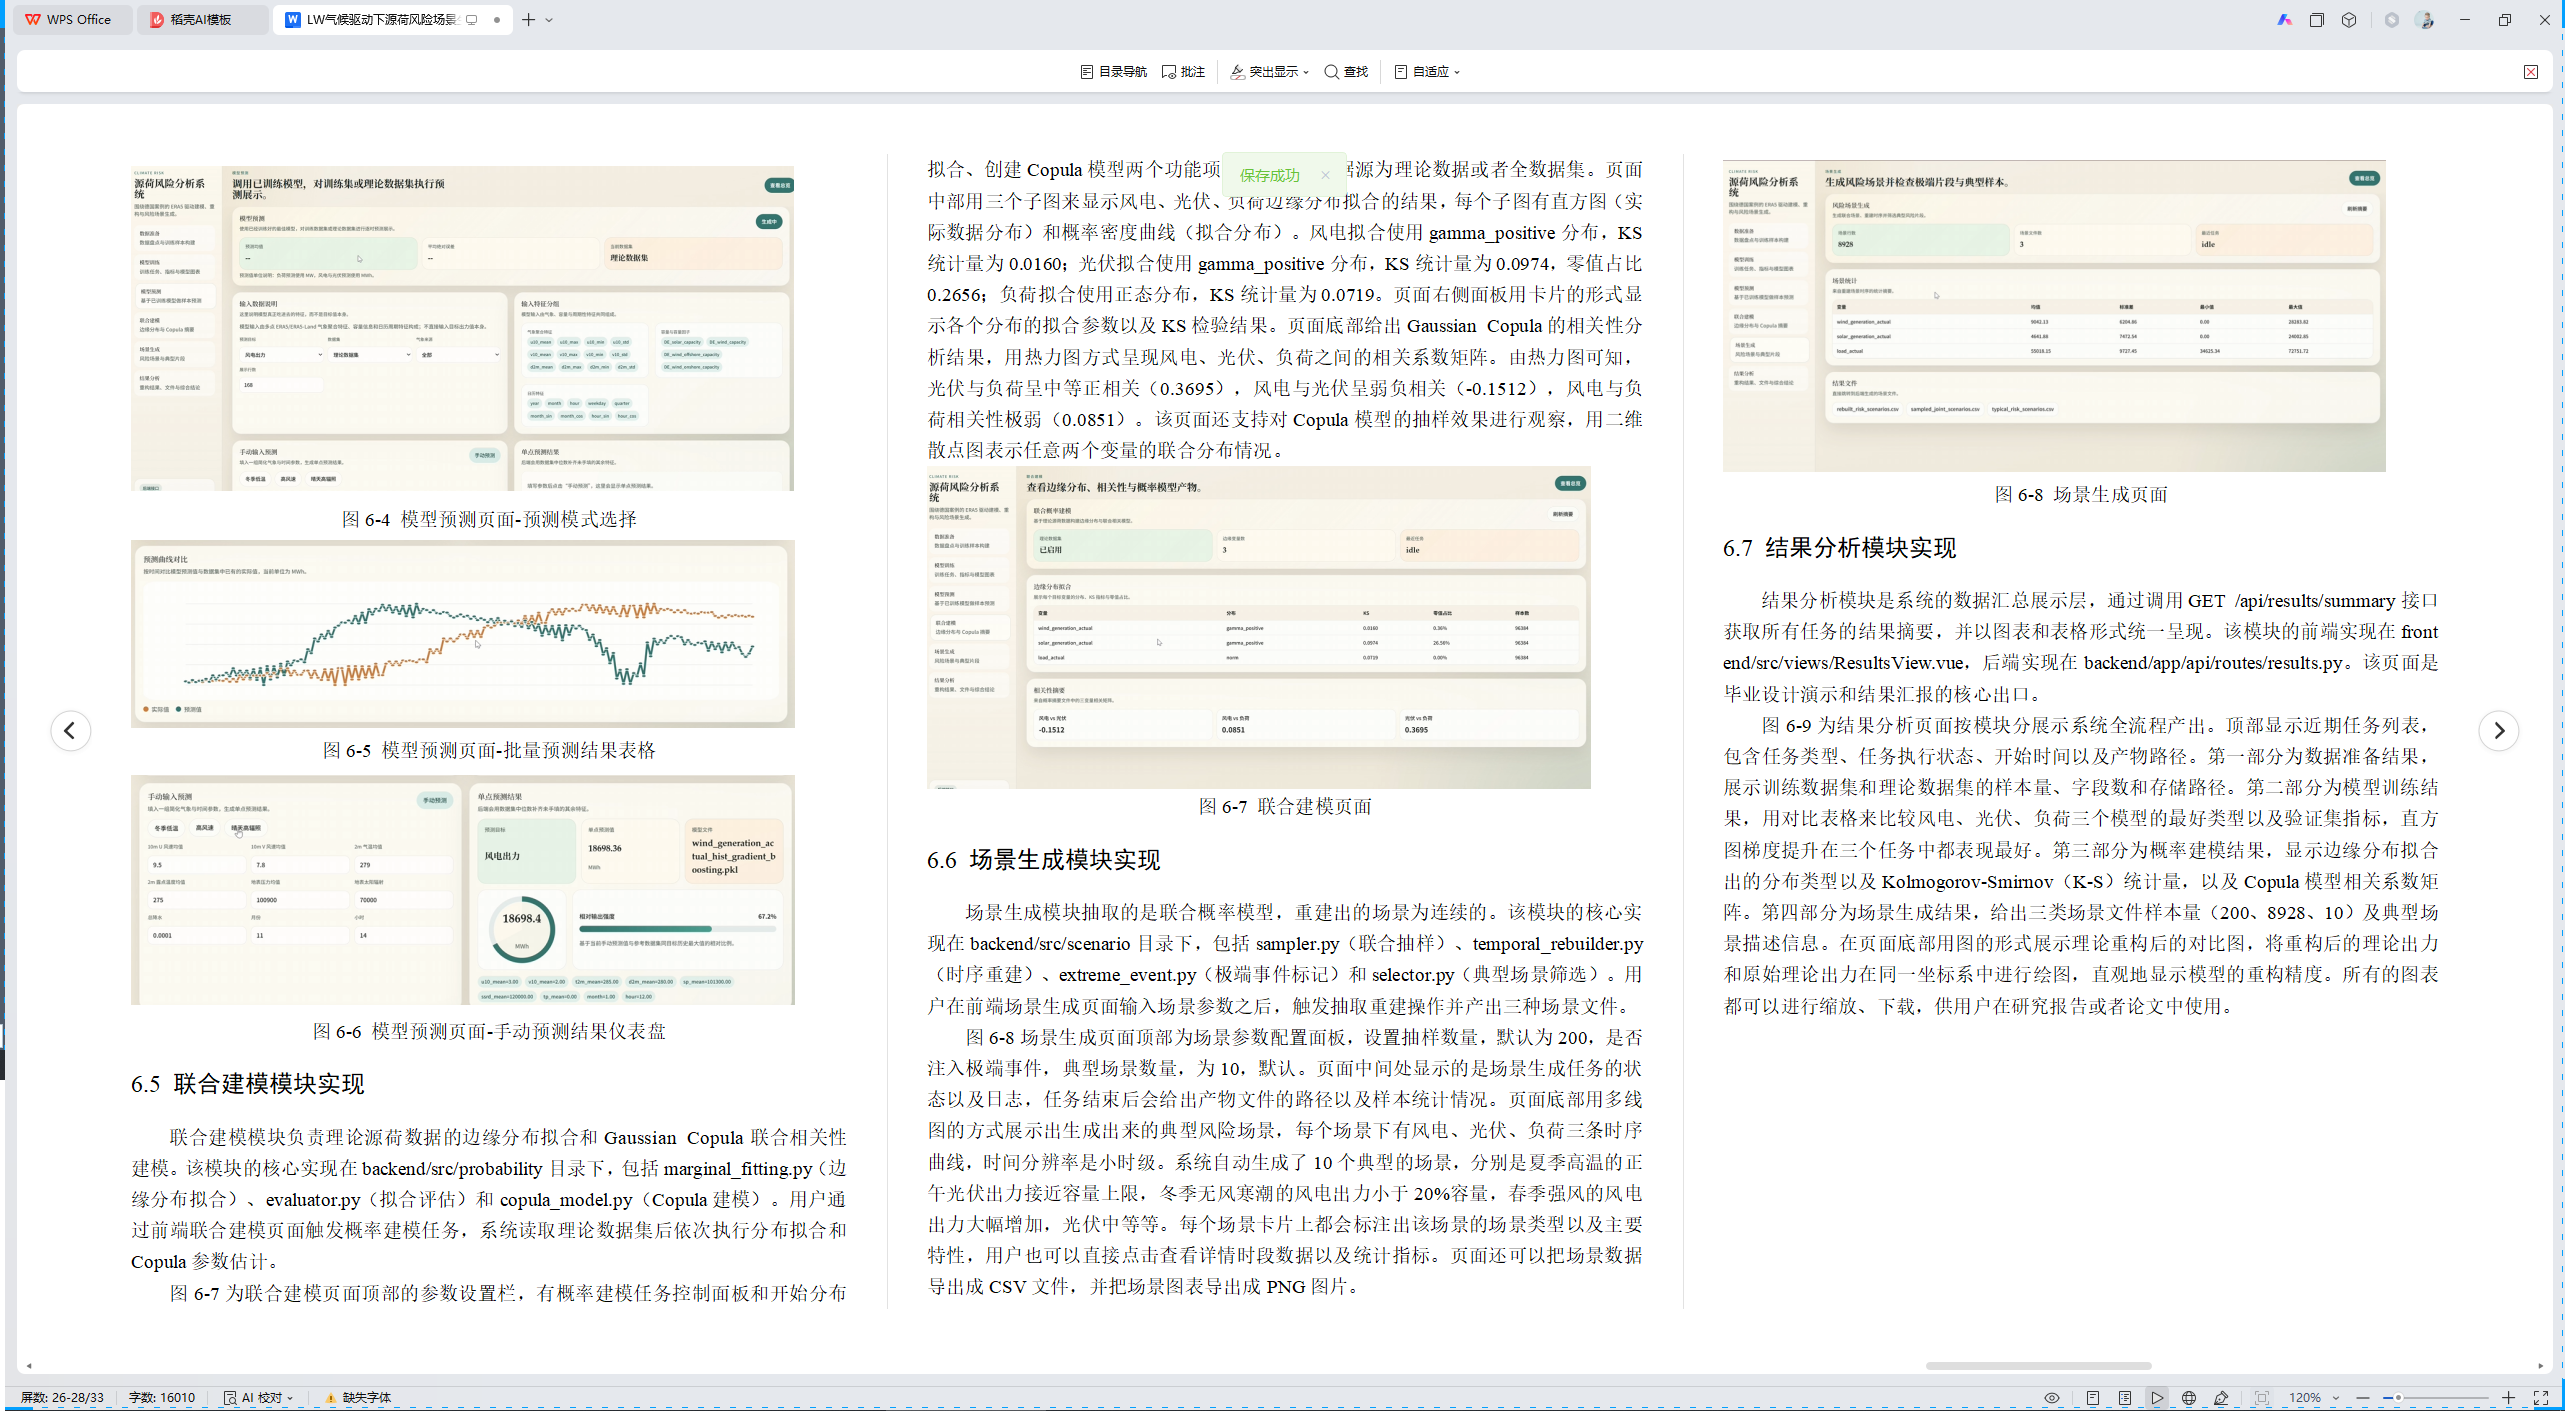
模型预测模块提供交互式的预测功能,支持批量预测和单点手动预测两种模式。该模块的核心实现在backend/app/services/prediction_service.py中,通过POST /api/prediction/run和POST /api/prediction/manual两个接口对外提供服务。前端预测页面调用GET /api/prediction/metadata获取可预测目标和输入字段说明,动态生成表单。
图6-4给出模型预测页面顶部的预测模式切换选项卡。批量预测模式用户选择目标变量(风电、光伏、负荷)、数据集来源(训练集、测试集、理论数据集),对指定数据集前N条记录进行批量预测,返回预测结果和真实值对比曲线。页面中部用折线图显示预测值和真实值的时序变化,用柱状图显示误差分布。单点预测模式下用户手动输入风速、温度、辐射等气象特征值或者用滑块调节日历的月份、小时,系统会立即给出预测值并且用高亮的形式突出显示出来。页面底部显示预测摘要指标,本次预测所用模型文件名、特征列数以及处理耗时。该页面可以导出为CSV格式的预测结果供用户进行离线分析。
见图6-5,批量预测结果用表格的形式给出每一个样本的输入特征、预测值、真实值(有则标注)的信息。表格可以进行排序、筛选、分页,用户可以查看任意一个样本的详细预测信息。图6-6是手动预测结果以仪表盘的形式呈现出来,风电、光伏、负荷的预测值分别用不同的进度条来表示,与装机容量进行对比显示容量因子。右侧给出实际使用的输入特征值表,保证预测过程可以被清楚地追踪到。
图6-4 模型预测页面-预测模式选择
图6-5 模型预测页面-批量预测结果表格
图6-6 模型预测页面-手动预测结果仪表盘
6.5 联合建模模块实现
联合建模模块负责理论源荷数据的边缘分布拟合和Gaussian Copula联合相关性建模。该模块的核心实现在backend/src/probability目录下,包括marginal_fitting.py(边缘分布拟合)、evaluator.py(拟合评估)和copula_model.py(Copula建模)。用户通过前端联合建模页面触发概率建模任务,系统读取理论数据集后依次执行分布拟合和Copula参数估计。
图6-7为联合建模页面顶部的参数设置栏,有概率建模任务控制面板和开始分布拟合、创建Copula模型两个功能项,还有当前数据源为理论数据或者全数据集。页面中部用三个子图来显示风电、光伏、负荷边缘分布拟合的结果,每个子图有直方图(实际数据分布)和概率密度曲线(拟合分布)。风电拟合使用gamma_positive分布,KS统计量为0.0160;光伏拟合使用gamma_positive分布,KS统计量为0.0974,零值占比0.2656;负荷拟合使用正态分布,KS统计量为0.0719。页面右侧面板用卡片的形式显示各个分布的拟合参数以及KS检验结果。页面底部给出Gaussian Copula的相关性分析结果,用热力图方式呈现风电、光伏、负荷之间的相关系数矩阵。由热力图可知,光伏与负荷呈中等正相关(0.3695),风电与光伏呈弱负相关(-0.1512),风电与负荷相关性极弱(0.0851)。该页面还支持对Copula模型的抽样效果进行观察,用二维散点图表示任意两个变量的联合分布情况。
图6-7 联合建模页面
6.6 场景生成模块实现
场景生成模块抽取的是联合概率模型,重建出的场景为连续的。该模块的核心实现在backend/src/scenario目录下,包括sampler.py(联合抽样)、temporal_rebuilder.py(时序重建)、extreme_event.py(极端事件标记)和selector.py(典型场景筛选)。用户在前端场景生成页面输入场景参数之后,触发抽取重建操作并产出三种场景文件。
图6-8场景生成页面顶部为场景参数配置面板,设置抽样数量,默认为200,是否注入极端事件,典型场景数量,为10,默认。页面中间处显示的是场景生成任务的状态以及日志,任务结束后会给出产物文件的路径以及样本统计情况。页面底部用多线图的方式展示出生成出来的典型风险场景,每个场景下有风电、光伏、负荷三条时序曲线,时间分辨率是小时级。系统自动生成了10个典型的场景,分别是夏季高温的正午光伏出力接近容量上限,冬季无风寒潮的风电出力小于20%容量,春季强风的风电出力大幅增加,光伏中等等。每个场景卡片上都会标注出该场景的场景类型以及主要特性,用户也可以直接点击查看详情时段数据以及统计指标。页面还可以把场景数据导出成CSV文件,并把场景图表导出成PNG图片。
图6-8 场景生成页面
6.7 结果分析模块实现
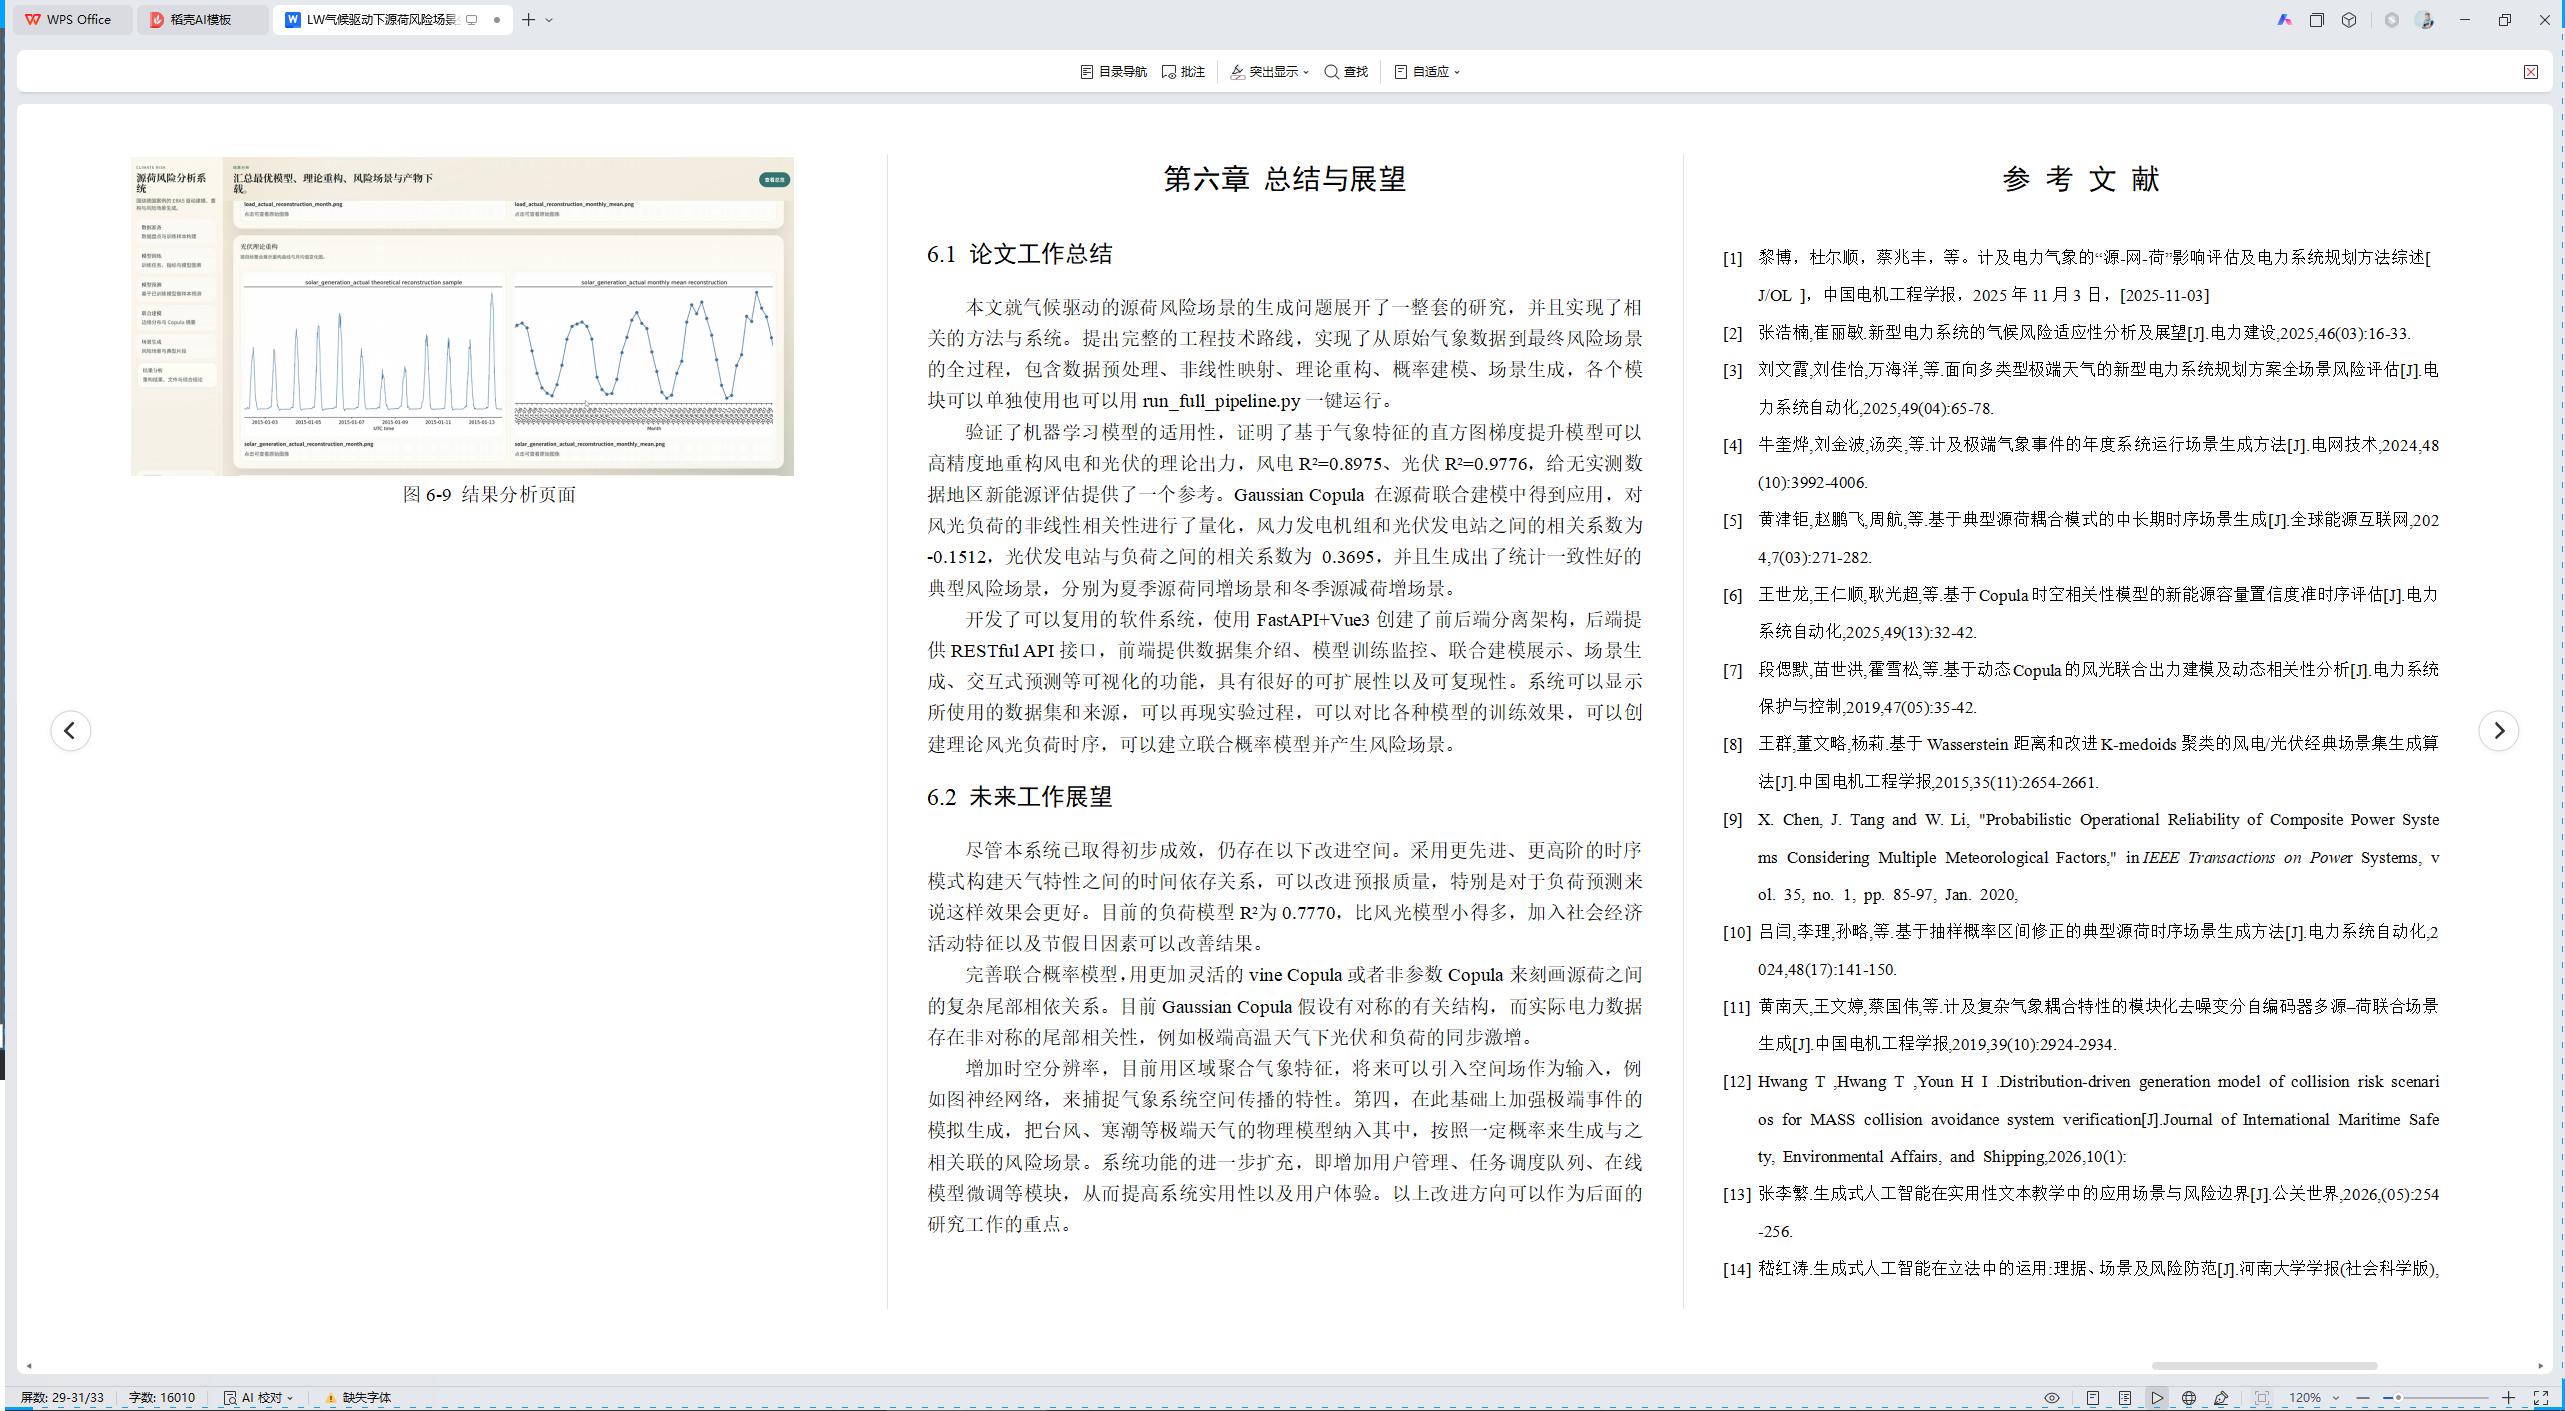
结果分析模块是系统的数据汇总展示层,通过调用GET /api/results/summary接口获取所有任务的结果摘要,并以图表和表格形式统一呈现。该模块的前端实现在frontend/src/views/ResultsView.vue,后端实现在backend/app/api/routes/results.py。该页面是毕业设计演示和结果汇报的核心出口。
图6-9为结果分析页面按模块分展示系统全流程产出。顶部显示近期任务列表,包含任务类型、任务执行状态、开始时间以及产物路径。第一部分为数据准备结果,展示训练数据集和理论数据集的样本量、字段数和存储路径。第二部分为模型训练结果,用对比表格来比较风电、光伏、负荷三个模型的最好类型以及验证集指标,直方图梯度提升在三个任务中都表现最好。第三部分为概率建模结果,显示边缘分布拟合出的分布类型以及Kolmogorov-Smirnov(K-S)统计量,以及Copula模型相关系数矩阵。第四部分为场景生成结果,给出三类场景文件样本量(200、8928、10)及典型场景描述信息。在页面底部用图的形式展示理论重构后的对比图,将重构后的理论出力和原始理论出力在同一坐标系中进行绘图,直观地显示模型的重构精度。所有的图表都可以进行缩放、下载,供用户在研究报告或者论文中使用。
图6-9 结果分析页面
第六章 总结与展望
6.1 论文工作总结
本文就气候驱动的源荷风险场景的生成问题展开了一整套的研究,并且实现了相关的方法与系统。提出完整的工程技术路线,实现了从原始气象数据到最终风险场景的全过程,包含数据预处理、非线性映射、理论重构、概率建模、场景生成,各个模块可以单独使用也可以用run_full_pipeline.py一键运行。
验证了机器学习模型的适用性,证明了基于气象特征的直方图梯度提升模型可以高精度地重构风电和光伏的理论出力,风电R²=0.8975、光伏R²=0.9776,给无实测数据地区新能源评估提供了一个参考。Gaussian Copula 在源荷联合建模中得到应用,对风光负荷的非线性相关性进行了量化,风力发电机组和光伏发电站之间的相关系数为 -0.1512,光伏发电站与负荷之间的相关系数为 0.3695,并且生成出了统计一致性好的典型风险场景,分别为夏季源荷同增场景和冬季源减荷增场景。
开发了可以复用的软件系统,使用FastAPI+Vue3创建了前后端分离架构,后端提供RESTful API接口,前端提供数据集介绍、模型训练监控、联合建模展示、场景生成、交互式预测等可视化的功能,具有很好的可扩展性以及可复现性。系统可以显示所使用的数据集和来源,可以再现实验过程,可以对比各种模型的训练效果,可以创建理论风光负荷时序,可以建立联合概率模型并产生风险场景。
6.2 未来工作展望
尽管本系统已取得初步成效,仍存在以下改进空间。采用更先进、更高阶的时序模式构建天气特性之间的时间依存关系,可以改进预报质量,特别是对于负荷预测来说这样效果会更好。目前的负荷模型R²为0.7770,比风光模型小得多,加入社会经济活动特征以及节假日因素可以改善结果。
完善联合概率模型,用更加灵活的vine Copula或者非参数Copula来刻画源荷之间的复杂尾部相依关系。目前Gaussian Copula假设有对称的有关结构,而实际电力数据存在非对称的尾部相关性,例如极端高温天气下光伏和负荷的同步激增。
增加时空分辨率,目前用区域聚合气象特征,将来可以引入空间场作为输入,例如图神经网络,来捕捉气象系统空间传播的特性。第四,在此基础上加强极端事件的模拟生成,把台风、寒潮等极端天气的物理模型纳入其中,按照一定概率来生成与之相关联的风险场景。系统功能的进一步扩充,即增加用户管理、任务调度队列、在线模型微调等模块,从而提高系统实用性以及用户体验。以上改进方向可以作为后面的研究工作的重点。