论文题目: Few-shot Defect Image Generation based on Consistency Modeling
中文翻译: 基于一致性建模的少样本缺陷图像生成
会议: ECCV 2024
摘要: 图像生成可以解决缺陷检测中标注数据不足的问题。大多数缺陷生成方法只针对单一产品进行训练,没有考虑多个产品之间存在的一致性,因此生成结果在质量和多样性方面表现不足。为了解决这些问题,本文提出 DefectDiffu,一种新的文本引导扩散方法,它在多个产品之间同时建模产品内背景一致性和产品间缺陷一致性,并通过调节一致性扰动方向来控制产品类型和缺陷强度,从而实现多样化的缺陷图像生成。首先,作者利用文本编码器分别为解耦集成架构中的背景、缺陷和融合部分提供一致性 Prompt,从而解耦缺陷与正常背景。其次,本文提出 Double-Free 策略,通过对一致性方向进行两阶段扰动来生成缺陷图像,并通过调整扰动尺度控制产品类型和缺陷强度。此外,DefectDiffu 可以利用缺陷部分的 Cross-Attention Map 生成缺陷 Mask 标注。最后,为提升小缺陷和 Mask 的生成质量,作者提出 Adaptive Attention-enhanced Loss,以增强模型对缺陷区域的关注。实验结果表明,DefectDiffu 在生成质量和多样性方面具有较好的表现,并能够有效提升下游缺陷检测性能。此外,缺陷扰动方向还可以在不同产品之间迁移,实现 Zero-shot 缺陷生成,从而进一步缓解缺陷数据不足的问题。
一、研究背景与核心问题
工业缺陷检测有一个很典型的数据矛盾:生产工艺越成熟,真实缺陷往往越少,而深度学习检测模型又依赖大量标注样本。尤其是缺陷通常只占图像中的很小一部分,除了采集困难之外,像素级 Mask 的人工标注成本也很高。因此,用生成模型同时合成 defect image + defect mask,再用于扩充检测或分割训练集,是一种很直接的数据增强方案。
已有 GAN、Diffusion 类缺陷生成方法已经能够生成较真实的工业异常,但作者认为真正的问题并不只是"模型生成能力不够",而是此前方法通常针对一种产品单独训练一个模型。当某类产品只有少量异常样本时,模型能够观察到的缺陷变化十分有限,容易出现过拟合、生成多样性不足以及标注不准确等问题。
1.1 作者看到的关键点:缺陷数据中存在两种"一致性"
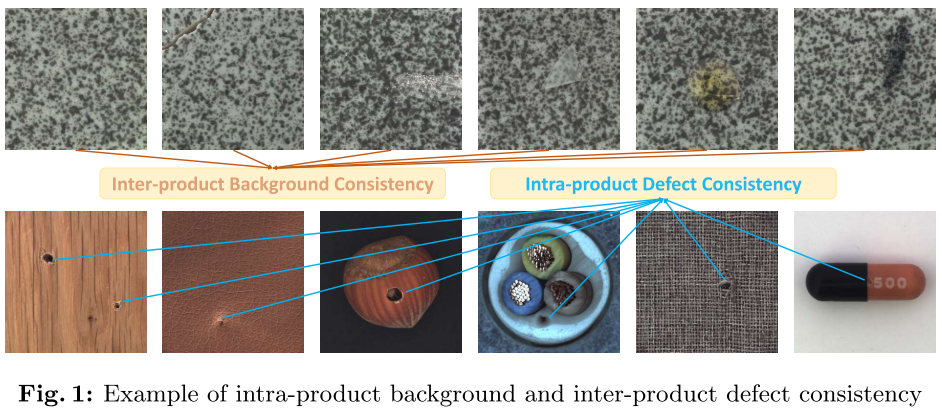
论文 Figure 1:产品内背景一致性与产品间缺陷一致性的示例
Figure 1 是理解整篇论文最重要的起点。作者认为工业缺陷图像中存在两种可以利用的共享信息:第一种是 intra-product background consistency,产品内背景一致性 。同一种产品无论出现哪一种缺陷,大部分正常区域的材质、颜色和结构仍然基本一致;第二种是 inter-product defect consistency,产品间缺陷一致性,例如 hole、crack、color 等相似缺陷即使出现在不同产品上,在形态上依然存在一定共性。
因此,作者把缺陷图像生成重新拆成两个问题:
先生成"这个产品应该长什么样",再学习"正常产品应该沿什么方向变化,才能出现某种缺陷"。
相比直接学习某一种产品的完整 defect distribution,这样就能够把多个产品的数据放在一起,让背景知识在同产品内部共享,让缺陷知识在不同产品之间共享。这正是 DefectDiffu 后续所有设计的出发点。
二、DefectDiffu 整体框架:先解耦,再融合
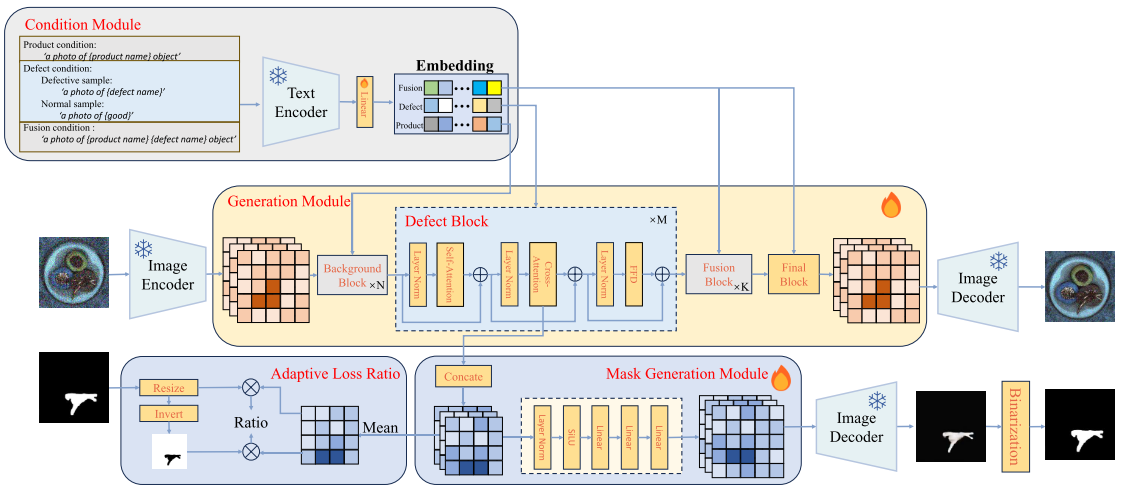
论文 Figure 2:DefectDiffu 整体框架
Figure 2 建议重点看三条路径:文本条件如何进入不同 Block、缺陷图像如何生成,以及 Cross-Attention 如何进一步生成 Mask。
DefectDiffu 以预训练 DiT 作为 backbone,整体可以分为 Condition Module、Generation Module 和 Mask Generation Module。Condition Module 使用 CLIP Text Encoder 将不同文本 Prompt 编码成条件;Generation Module 负责生成图像;Mask Generation Module 则提取 Defect Block 中的 Cross-Attention Map,生成与缺陷图像对应的像素级 Mask。训练阶段真实图像和 Mask 会被编码到特征空间,而推理阶段图像特征和 Mask 特征再分别经过 Decoder 得到最终的 image-mask pair。
这里最关键的是 Generation Module 并没有简单地把一个文本条件直接送入整个 DiT,而是将 DiT 按层拆成三个部分:
Background Block → Defect Block → Fusion Block
这套结构被作者称为 Text-guided Disentangled Integrated Architecture(TDIA)。
三、TDIA 与 Double-Free:把"产品"和"缺陷"变成两个可控方向
3.1 为什么不能只写一个 Prompt?
普通 Text-to-Image 方法可以直接使用类似 A photo of {defect} {product} 的 Prompt,但这种方式有一个问题:Text Encoder 会把多个对象共同编码为一个融合后的表示。最终模型虽然知道应该生成"带某种缺陷的某种产品",却很难明确区分哪些信息属于产品背景,哪些属于缺陷。
而 DefectDiffu 想利用的恰恰是"产品内背景一致性"和"产品间缺陷一致性",因此这两部分必须能够被独立建模。
作者为三个部分分别设计条件:Background Block 使用 A photo of {product name},Defect Block 使用 A photo of {defect name},Fusion Block 最后再输入 A photo of {defect name} {product name}。这样前两部分负责解耦学习,最后一部分负责恢复缺陷与产品之间的语义一致性。
直观来看,TDIA 完成的是:
产品是什么 → 缺陷是什么 → 这个缺陷如何合理地出现在该产品上。
这也解释了为什么作者选择 DiT:相比整体式的 UNet,Transformer 层级堆叠结构更方便把不同文本条件送入不同阶段。
3.2 Double-Free:缺陷不是一个标签,而是一条"变化方向"
TDIA 可以生成不同产品和缺陷,但仅靠条件生成,缺陷强度仍然主要受到训练集分布限制。作者进一步提出一个假设:正常图像到缺陷图像之间应该存在一个扰动方向,而且沿这个方向移动得越远,缺陷就越严重。
于是作者在 Classifier-Free Guidance 的基础上提出 Double-Free 。其中 good 条件代表正常状态,产品条件记为,缺陷条件记为
。推理过程的核心可以写成:
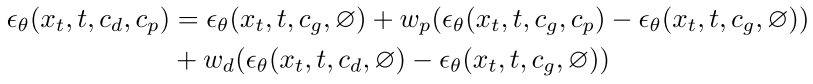
这里第一项可以理解成基础正常生成;第二项的差值构成产品/背景一致性扰动方向 ,由控制产品特征;第三项构成缺陷一致性扰动方向 ,由
控制缺陷强度。训练 Double-Free 时,作者通过随机置空 product condition,以及将 defect condition 替换成
good,让模型同时学会这些条件状态。
真正值得注意的是,DefectDiffu 因此不再把 crack、hole 看成一个简单的离散类别,而是把它们表示成了从正常状态走向缺陷状态的一条可缩放扰动方向。这不仅带来了强度控制,也为后面的跨产品 Zero-shot 迁移创造了条件。
四、Mask Generation 与 AAL:解决"小缺陷容易被忽略"
4.1 直接从 Cross-Attention 中得到缺陷 Mask
工业缺陷生成不仅需要图像,还需要像素级 Mask,否则生成数据很难直接用于监督式分割。
DefectDiffu 的处理方式比较自然:因为 Defect Block 接收的就是 defect prompt,因此其中的 Cross-Attention Map 本身就在描述"哪些图像位置与这个 defect token 相关"。作者计算 Cross-Attention:
随后将多个 Defect Block 得到的 Attention Map 沿通道维拼接,输入 Mask Generation Module 得到 Mask feature,再经 Decoder 得到像素级预测。推理时,作者进一步平均最后 100 个 diffusion timestep 的 Mask,然后使用迭代阈值方法完成二值化。
这样一次采样最终可以同时获得:
noise → defect image + defect mask
而不需要先人工指定一个缺陷 Mask 再生成图像。
4.2 Adaptive Attention-enhanced Loss:为什么要额外强调缺陷区域?
作者在训练中发现,模型容易生成接近正常样本的结果,特别是缺陷很小或者一张图中包含多个小缺陷时,Mask 也容易不准确。
原因在于普通 diffusion loss 面向整张图像。如果缺陷只占图像面积的很小一部分,那么即使缺陷区域重建得不好,它对全局 Loss 的贡献依然有限。
因此作者根据 Cross-Attention 计算正常区域与缺陷区域的注意力比例:
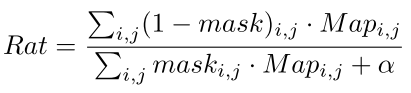
当模型对缺陷区域分配的注意力越低时,(Rat) 就越大。随后作者将权重 (R) 限制在 2 到 8 之间,再利用它放大缺陷区域的去噪损失,最终训练目标由全局 diffusion loss、加权后的 defect-region loss 和 mask loss 共同构成。
所以 AAL 的作用并不是简单"再加一个 Loss",而是在告诉模型:不要因为背景占了绝大部分像素,就把真正重要的小缺陷忽略掉。
五、实验结果与消融分析
5.1 实验设置
实验在 MVTec AD 的 15 个产品类别 上完成。论文从 MVTecAD-test 中选择一半图像作为图像生成训练以及分割 Baseline 训练所使用的数据,其余数据用于测试,所有图像统一调整为 512 × 512。生成任务使用 FID 衡量质量,数值越低越好;使用 LPIPS 衡量多样性,数值越高表示生成结果之间的感知差异越大。下游分割则使用 mIoU、F1、mAP 和 AUROC。对比方法包括 StyleGAN2、DFMGAN 和 Defect-Gen。
5.2 生成质量:不仅要"不同",首先要"像真的"
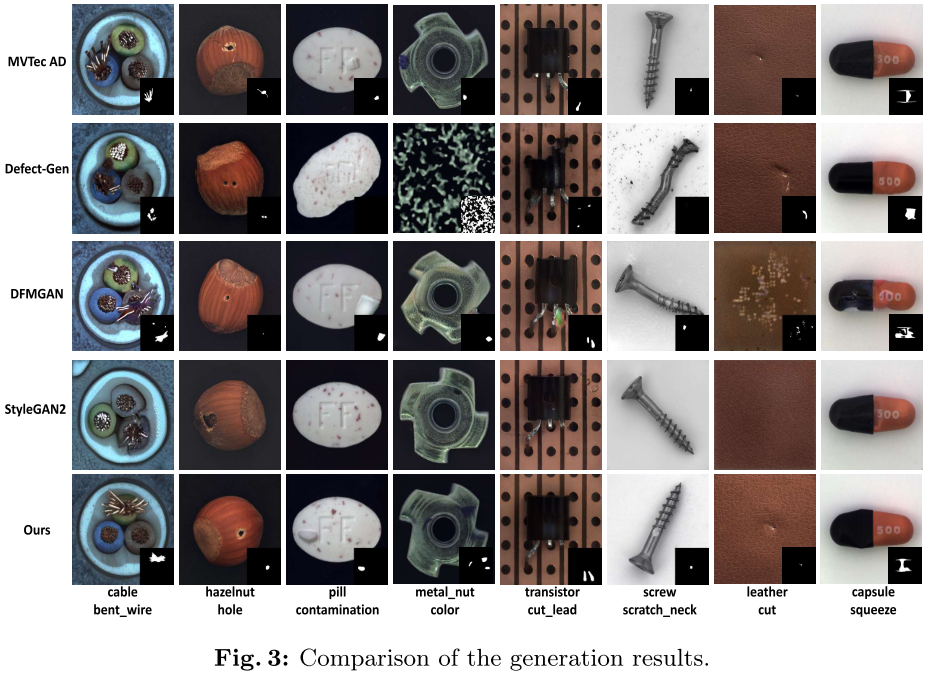
论文 Figure 3:DefectDiffu 与 Defect-Gen、DFMGAN、StyleGAN2 的生成结果对比
Figure 3 将真实 MVTec AD 样本和不同方法生成的结果直接放在一起。重点不是只观察缺陷有没有出现,而是同时看产品整体结构、缺陷形态、伪影以及对应 Mask。论文指出,Defect-Gen 在部分样本上难以保持真实的高层语义,DFMGAN 会产生明显伪影,StyleGAN2 在部分产品上也存在收敛或伪影问题;DefectDiffu 则在 15 类产品上都能够完成生成,并同时输出 Mask。
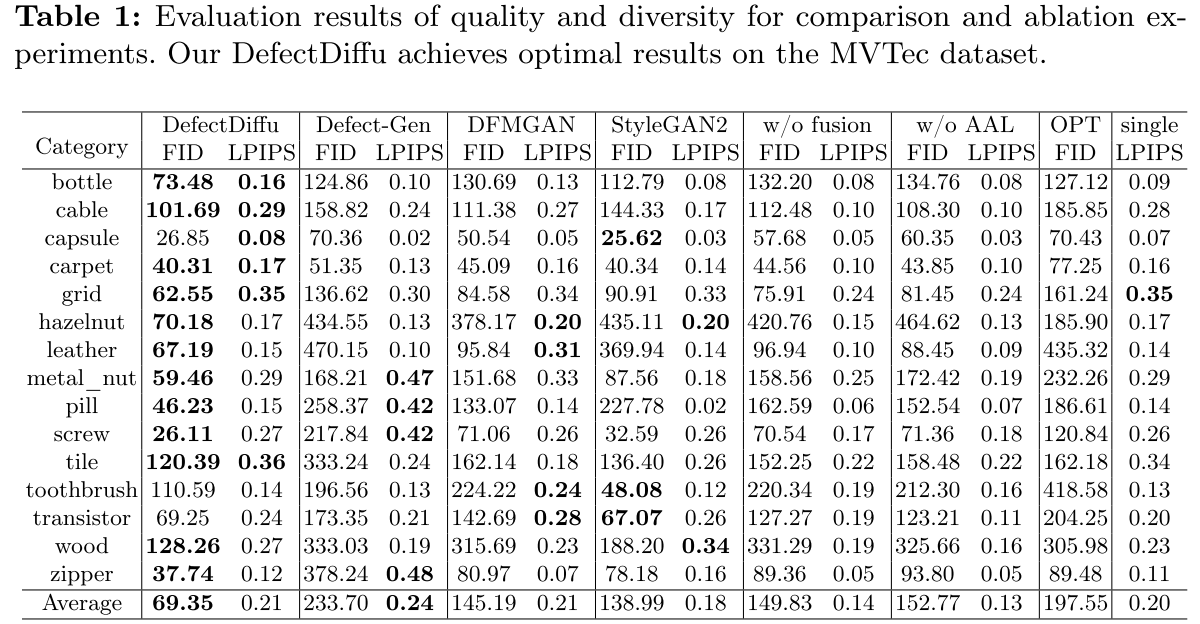
论文 Table 1:不同方法的生成质量、多样性以及核心消融结果
Table 1 是论文最重要的定量结果之一。DefectDiffu 的平均 FID = 69.35 ,而 Defect-Gen、DFMGAN 和 StyleGAN2 分别为 233.70、145.19 和 138.99,说明其平均生成质量明显改善;平均 LPIPS = 0.21,保持了较好的样本差异性。这里也要注意论文给出的边界:DefectDiffu 并不是每个单独类别的 FID 都最低,例如 toothbrush 上 StyleGAN2 更低。另一方面,Defect-Gen 或 DFMGAN 在部分产品上的 LPIPS 虽然更高,但论文结合 Figure 3 指出,其中部分差异来自伪影或者真实语义丢失,因此 LPIPS 不能脱离生成质量单独解释。
5.3 Double-Free 是否真的能控制缺陷强度?
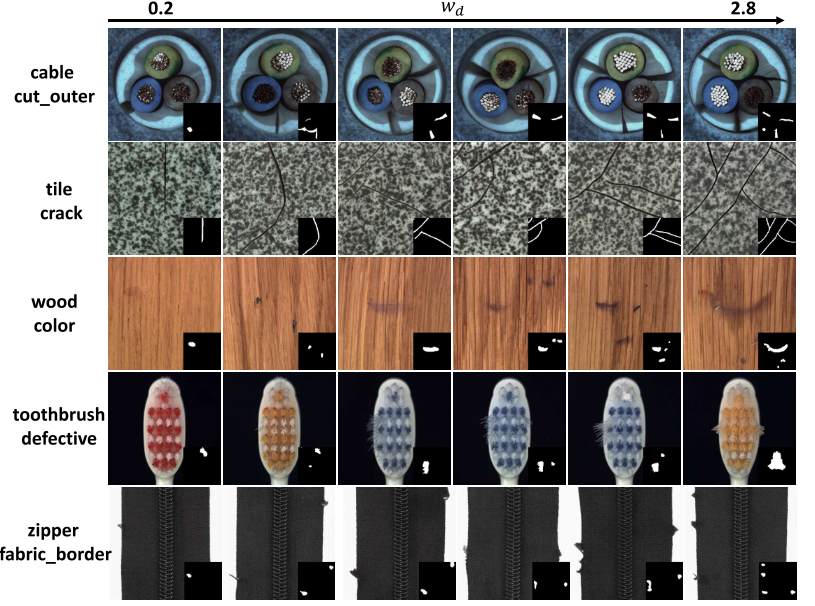
论文 Figure 4:不同 (
) 下的缺陷强度控制结果
Figure 4 给出了 cable、tile、wood、toothbrush、zipper 等多个例子,() 从左到右由 0.2 增加到 2.8 。可以直接看到随着 (
) 增大,缺陷区域面积扩大,部分样本中的缺陷数量也增加,对应 Mask 同步发生变化。
这个实验非常重要,因为它验证了 Double-Free 中"缺陷扰动方向"的解释并不只是数学表达:调整方向尺度,确实能够连续改变缺陷严重程度。
5.4 生成数据最终能不能帮助下游检测?
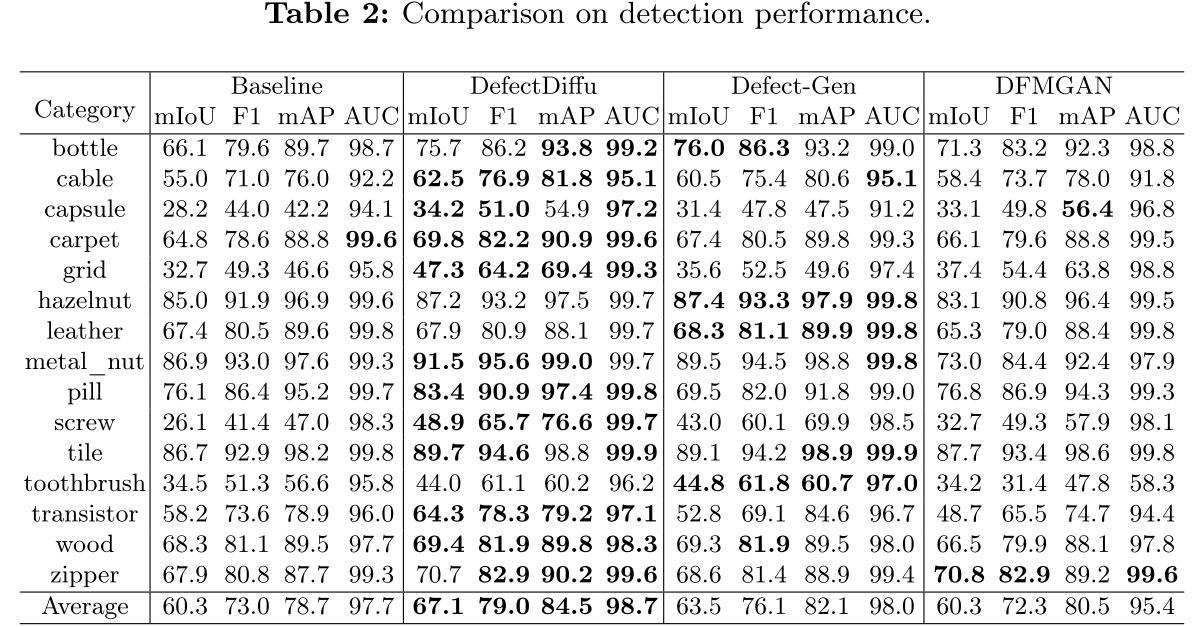
论文 Table 2:使用不同合成数据增强真实训练集后的缺陷分割性能
作者首先使用真实训练数据训练 UNet 作为 Baseline,然后让能够输出 Mask 的生成方法额外生成相当于真实数据 2 倍规模的合成样本,与真实数据共同训练。
平均结果中,Baseline 的 mIoU、F1、mAP 和 AUC 分别为 60.3、73.0、78.7、97.7 ,加入 DefectDiffu 数据后提升到 67.1、79.0、84.5、98.7。相比之下,Defect-Gen 的平均 mIoU 为 63.5,DFMGAN 为 60.3。DefectDiffu 并非在所有产品、所有指标上都是单项第一,但平均四项指标均为最高。
因此这组实验提供了比 FID 更直接的证据:DefectDiffu 生成的不只是视觉上"像缺陷"的图片,其 image-mask pairs 确实能够作为额外监督数据改善下游分割模型。
5.5 Zero-shot:把某种缺陷"搬"到从未见过该缺陷的产品上
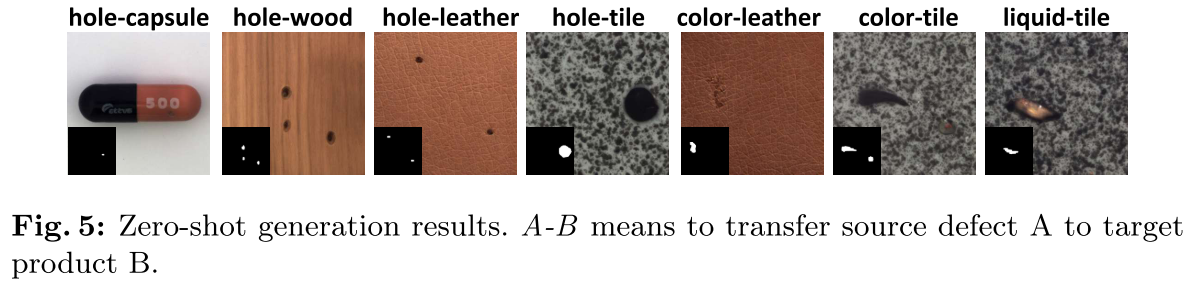
论文 Figure 5:跨产品 Zero-shot 缺陷生成结果
Figure 5 展示了 hole-capsule、hole-wood、hole-leather、hole-tile、color-leather、color-tile、liquid-tile 等组合,其中 A-B 表示把源缺陷 A 的扰动方向迁移到目标产品 B。
Zero-shot 场景下,训练时目标产品只有正常样本,没有对应的真实缺陷图像;测试时再把其他产品中已经学习到的 defect consistency perturbation direction 加入目标产品的正常生成过程。最终 Figure 5 表明,目标产品上能够出现对应缺陷。也就是说,前面"跨产品缺陷一致性"的设计最终落实成了实际的迁移能力。
5.6 消融实验:几个模块分别解决什么?
Table 1 同时承担了核心消融实验。去掉 Fusion Part 后平均 FID 从 69.35 恶化到 149.83 ,说明只把背景和缺陷分开还不够,最终还需要 Fusion Block 恢复两者的语义协调;将 AAL 替换成固定权重后平均 FID 达到 152.77,同时 LPIPS 下降,说明根据注意力动态增强缺陷区域确实有助于避免缺陷特征被背景淹没。
作者还只保留 Fusion Part 的单一组合 Prompt,用它代替 TDIA 中多个 single-object prompt,此时平均 FID 达到 197.55 ,说明显式分开产品和缺陷条件对于一致性建模十分关键。最后,当缺陷只采用单一 () 强度生成时,平均 LPIPS 从完整模型的 0.21 降至 0.20。变化并不算巨大,但与 Figure 4 一起说明,多强度采样能够继续扩展数据集中的缺陷变化范围。
所以几个模块的分工实际上非常清楚:TDIA 负责把背景和缺陷拆开学习,Fusion 负责重新组合二者,Double-Free 负责把这种解耦变成可调的扰动方向,AAL 则保证小面积缺陷不会在训练过程中被背景压制。
六、总结与思考
如果把 DefectDiffu 压缩成一句话,它真正做的事情并不是"用 DiT 生成工业缺陷",而是:
把缺陷图像生成从"学习每一种产品的缺陷分布",重新定义成"学习正常产品背景 + 可跨产品共享的缺陷变化方向"。
围绕这个思路,作者先用 TDIA 和多个 single-object prompt 将背景与缺陷解耦,再通过 Double-Free 将产品特征和缺陷特征进一步表示成两个可调节的 consistency perturbation direction;Defect Block 中的 Cross-Attention 又被用于生成 Mask,而 Adaptive Attention-enhanced Loss 专门解决缺陷面积太小、容易被全局重建目标忽视的问题。最终,同一个框架同时获得了缺陷图像生成、Mask 生成、缺陷强度控制以及 Zero-shot 跨产品迁移能力。
从方法设定上看,这篇论文最值得记住的其实是"缺陷可以被表示成一种变化,而不只是一个类别"。一旦正常背景和异常变化能够真正分开,缺陷强度控制和跨产品迁移就不再是额外拼接出的功能,而会自然变成这种表示方式的结果。
这也是 DefectDiffu 相比单产品 Few-shot defect generation 更有启发性的地方。