做前端时,我们经常会碰到这样的问题:一张 Banner 看起来没多复杂,下载却要好几百 KB;换成 WebP 后,图片差不多,文件却小了一截。
它到底省掉了什么?是不是把图片缩小了?为什么照片、Logo、透明图都能用它?
这篇不推公式,也不要求你记住算法名。我们只跟着一张图片走一遍,看看数据为什么有机会变少,以及哪些地方会影响画质。
先分清:WebP 有两条路线
有损是允许细节发生一些变化;无损是换一种存法,让解码后的像素数据仍能还原。"无损"不是说文件没压缩,"有损"也不是说图片一定肉眼可见地变糊。
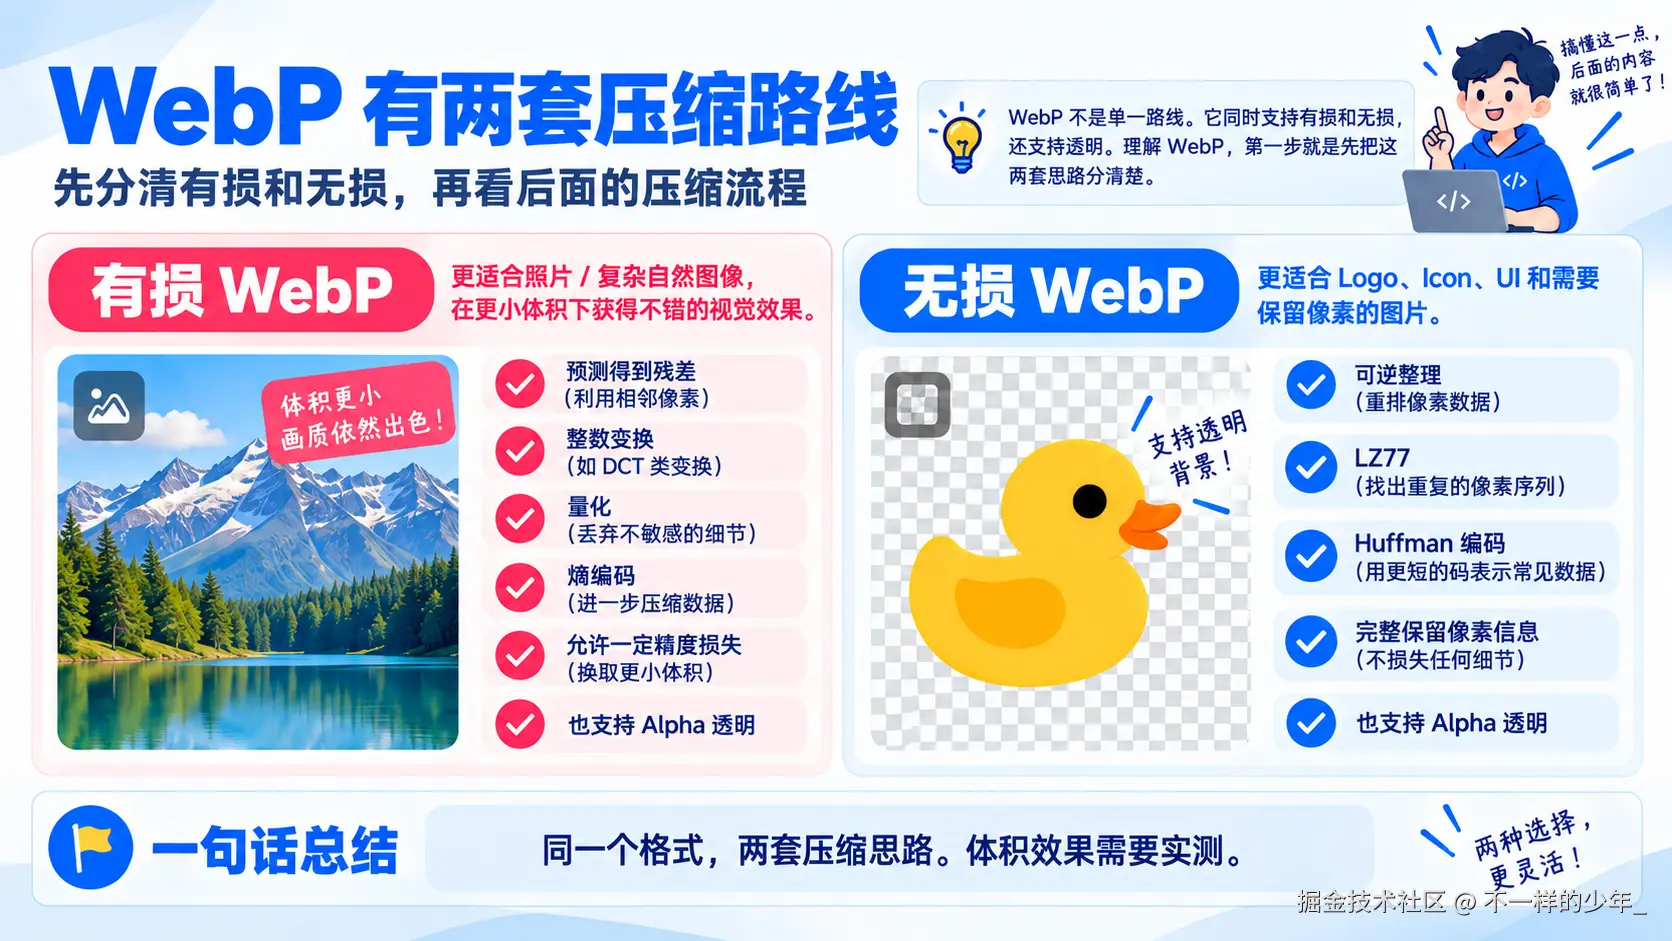
图:两条路线的目标不同,但都可以支持透明。照片、Logo 等只是常见测试起点,不是硬性限制。
可以先这样记:
- 有损:像记录一张照片,允许一些小细节没那么精确,换取更小的文件。
- 无损:像给文件打 ZIP 包,打开后内容还在,只是保存方式更省空间。
这里的 ZIP 只是帮助理解,无损 WebP 还会专门利用图片的颜色和相邻像素关系。
一、有损路线:先找相似,再处理差异
先看一眼全程,不用背图里的尺寸。读完下面几个例子,再回来就能串起来了。
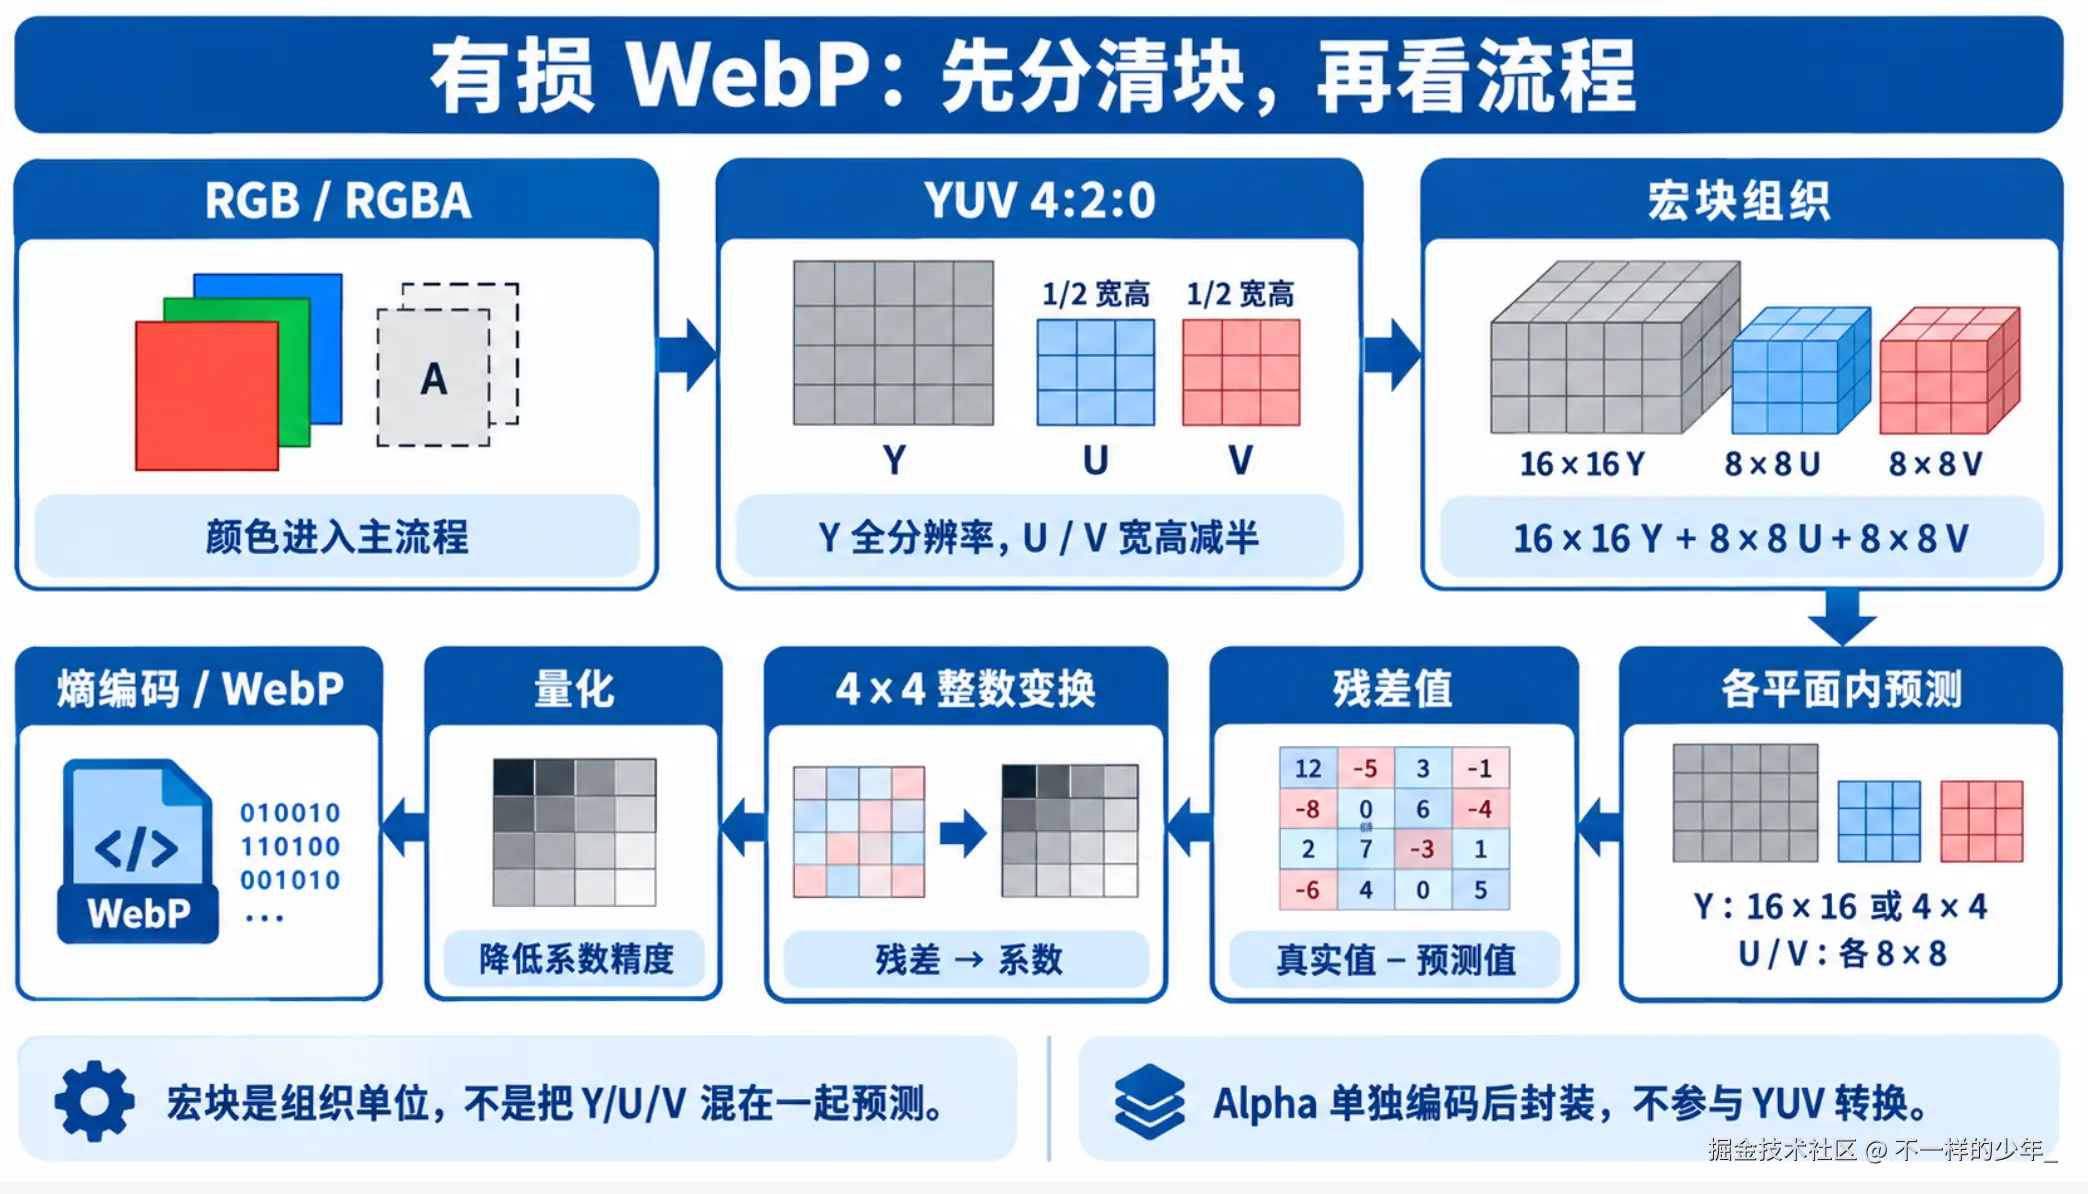
图:先整理颜色数据,再参考邻居预测,处理差值,最后编码成文件。宏块是数据的分组方式,不是把 Y、U、V 混在一起预测。
1. 先把"明暗"和"颜色"分开
前端最熟悉的是 RGB:红、绿、蓝三个数一起描述一个像素的颜色。
有损 WebP 会先换一种表示:**一份记录明暗,另外两份共同记录颜色差异。**它们就是图中的 Y、U、V。可以把它们想成三张对应着同一幅图的数值表,不是三张独立的彩色照片。
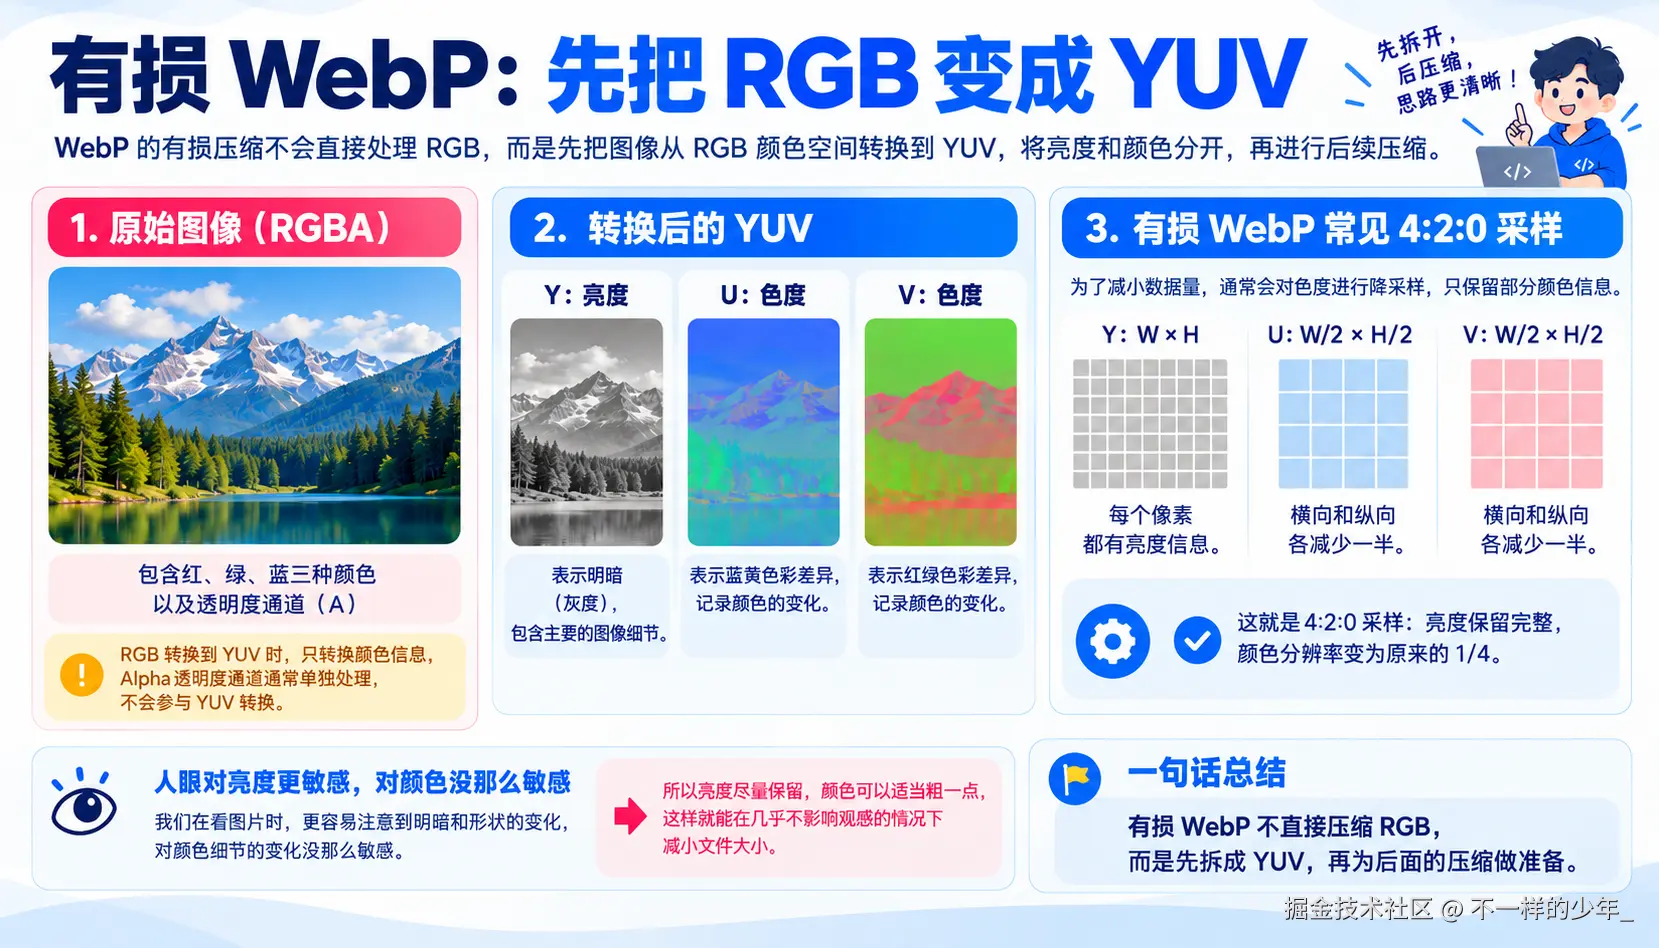
图:Y 记录明暗,U、V 记录颜色差异。图中的彩色分量画面只是方便观察的示意。
为什么要拆开?想想一行小字:边缘明暗一糊,马上就难读了;一片天空里细微的颜色变化稍微粗略一点,通常没那么容易察觉。
所以,颜色信息有时可以记录得稀一点,明暗信息则先保留得密一些。
2. 颜色不用每个位置都记得一样密
看一个 2×2 小区域。它有四个位置,保留四个明暗值,但颜色部分只保留一个 U 和一个 V 采样。这种安排叫 4:2:0。
text
原来四个位置:         颜色采样变稀后:
每处都有明暗信息       仍有 4 个 Y
每处都有颜色信息       配上 1 个 U 和 1 个 V
比如 1920×1080 的图片,Y 表还是 1920×1080,U、V 表各是 960×540。显示时,再根据这些较稀的颜色信息恢复出各个位置的颜色。
注意两个区别:**这不是把整张图片的宽高缩小,也不是把四个位置强行变成同一种 RGB 颜色。**它减少的是颜色采样,细小的彩色边缘可能因此受影响。这一步已经可能丢信息,不是到了后面的量化才首次有损。
3. 参考邻居,再记"差了多少"
假设我们正在处理一片颜色平缓的天空。附近的亮度很接近,已经处理好的邻居能给当前位置一个不错的参考。
例如,预测亮度是 118,真实亮度是 120,那么接下来要处理的差值就是:
text
真实值 120 − 预测值 118 = 差值 2这个差值有个名字,叫残差。记住"预测差了多少"就够了。
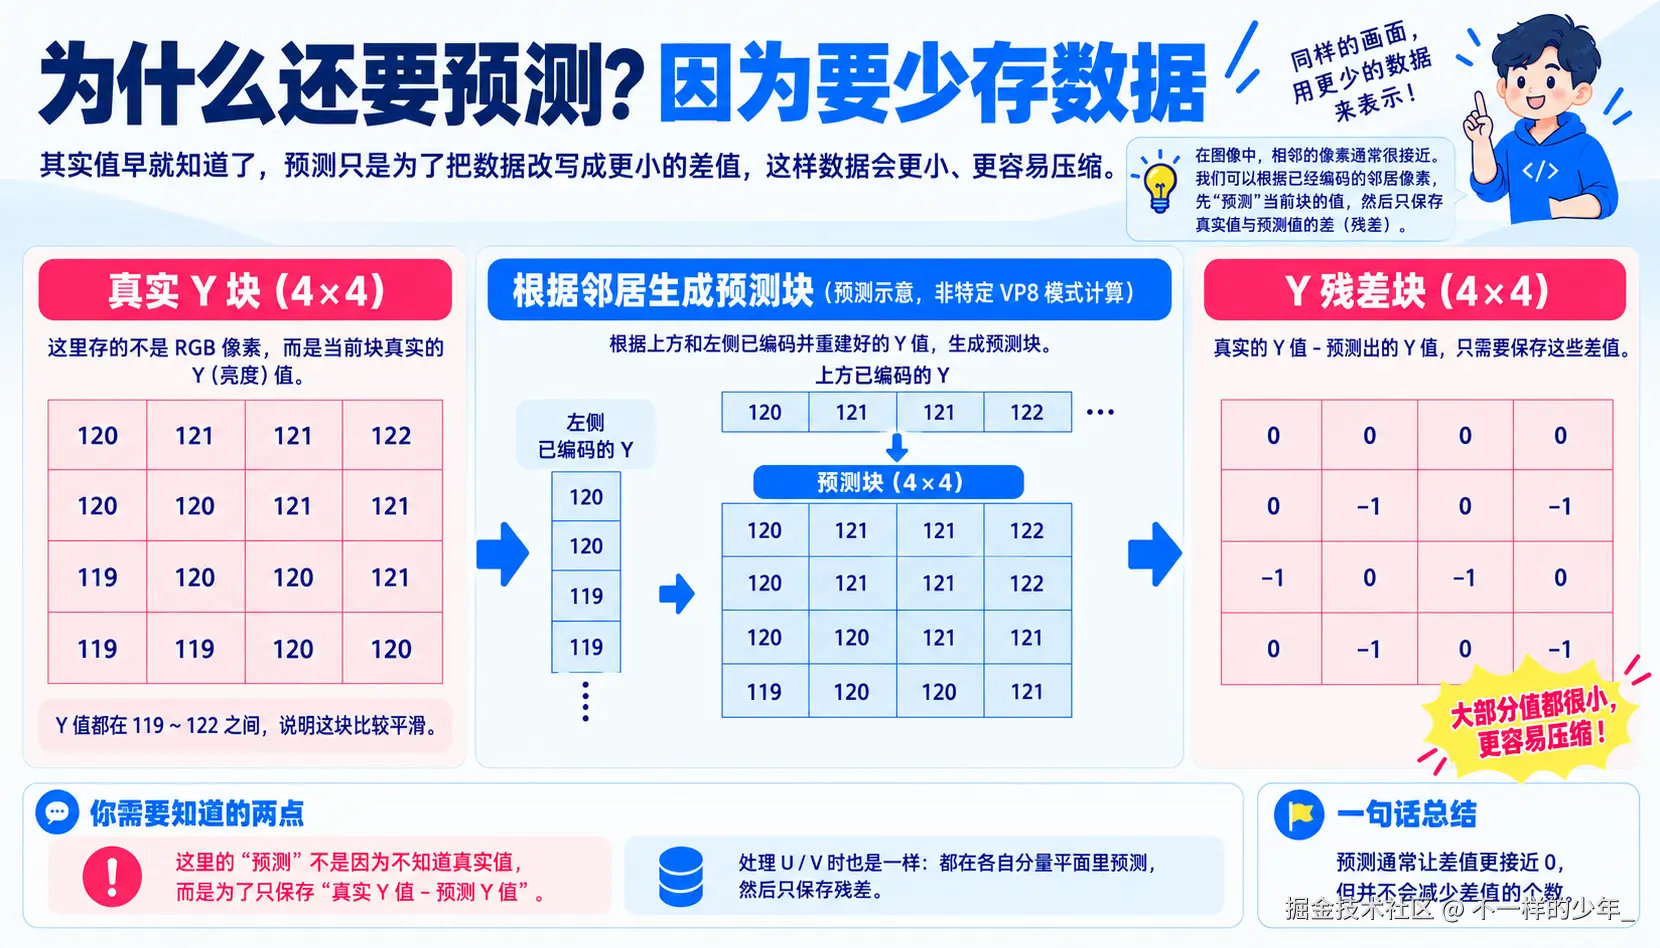
图:用一个小区域演示"真实值减预测值"。这是原理示意,不是某一种具体预测模式的计算过程。
你可能会问:"120 都知道了,为什么还要猜?"
因为预测不是为了求答案,而是为了换一种更好压缩的表达。原来可能要记录一串相近的亮度值,现在变成许多接近 0 的差值,后面更容易找到规律。
**数字的个数并没有直接减少。**16 个位置相减后,通常还是 16 个差值;真正省下多少空间,要看后续怎么变换和编码。
浏览器打开图片时,也能按记录的规则,参考已经恢复出来的邻居生成预测值,再把恢复出的差值加回去。因此编码时要用"解码器也能得到的邻居",而不能偷偷参考只有原图才有的信息。
实际文件还要记录预测方式等信息,不是只保存一个差值就能恢复整张图。
4. 换个说法,把一片区域的共同规律集中起来
预测之后,WebP 会把差值分成小组,继续处理。这一步叫变换。
别急着记名词,先看图中的三个小例子:预测算差值,变换整理规律,量化降低精度。它们分别解释三个动作,不是一套连续的数值计算。
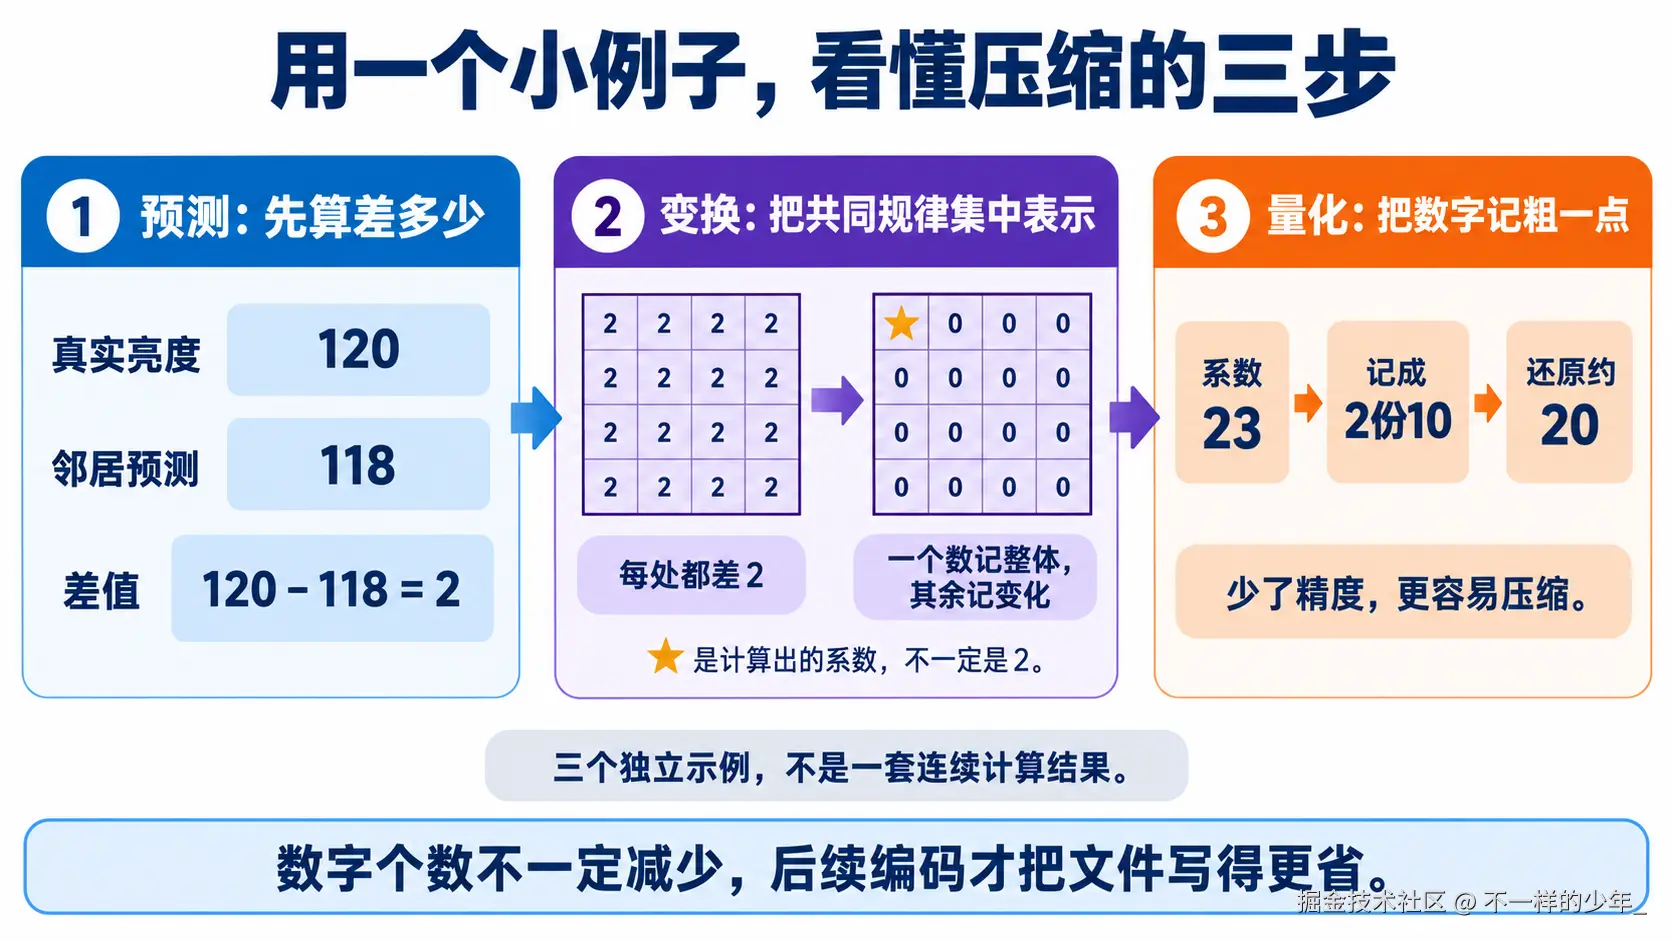
图:变换并没有直接删掉 15 个数字,而是让这个示例中的 15 个位置变为 0。量化示例中的 23 是另一组示意数据。
假设一个小区域里,每个位置的差值都是 2:
text
2 2 2 2
2 2 2 2
2 2 2 2
2 2 2 2
原来的说法是:"这里差 2,那里也差 2......"一共记了 16 次。
换个说法就是:"这一整片都偏大同样的量,内部没有额外变化。"
变换有点像做这件事:一个数字记录整片共同的偏差,其余数字记录片内变化。这个例子里没有额外变化,所以那些数字是 0。
这些改写后的数字叫系数。你不必算出它们,只要知道:还是 16 个数字,但主要信息集中在一个数字上,其他地方都是 0。遇到复杂纹理时,变化多,就没这么理想。
负责记录共同偏差的那个系数要经过公式计算,不一定就是 2;文件里也不是直接保存"整片差 2"这句话。这个例子只帮助理解改写的作用。
5. 把数字记得粗一点,换取更小的体积
现在轮到量化。这个词可以理解成"降低记录精度"。它处理的是刚得到的系数,不是直接把原图像素清零。
举个独立的简化例子:某个系数是 23,如果按"每 10 算一份"来记录,可以记成 2 份;恢复时得到 20,而不是原来的 23。
text
原来:23
粗略记成:2 份,每份 10
恢复:20
代价:丢了 3 的精度
小到不足一份的某些系数还可能变成 0。精度低了,数据通常更好压缩,但画面细节也可能受影响。这只是解释量化的例子,实际规则不是对所有系数统一除以 10。
前端常调的 quality,就和这类画质取舍密切相关:同一种工具、同一种有损模式下,提高质量通常更清楚、文件更大;降低质量通常更小,但文字、渐变和纹理更容易出问题。
不要把 quality = 80 理解成"保留原图 80% 的像素",也不要认为 JPEG 的 80 和 WebP 的 80 一定有相同画质。
6. 最后,用更省空间的编码写进文件
前面整理好了数据,最后还要把它们写成文件里的 0 和 1。编码器会利用数据的概率和规律,争取用更少的比特表达。
这一步叫熵编码。名字可以先放一边:它不再主动降低这批数据的精度,只负责把它们写得更省。
到这里,有损压缩的主线就串起来了:
预测:差多少? → 变换:有什么共同规律? → 量化:能不能记粗一点? → 编码:怎么写得更省?
透明图也能走有损路线吗?
能。颜色和透明度是两份信息,可以分别处理,再装进同一个 WebP 文件。
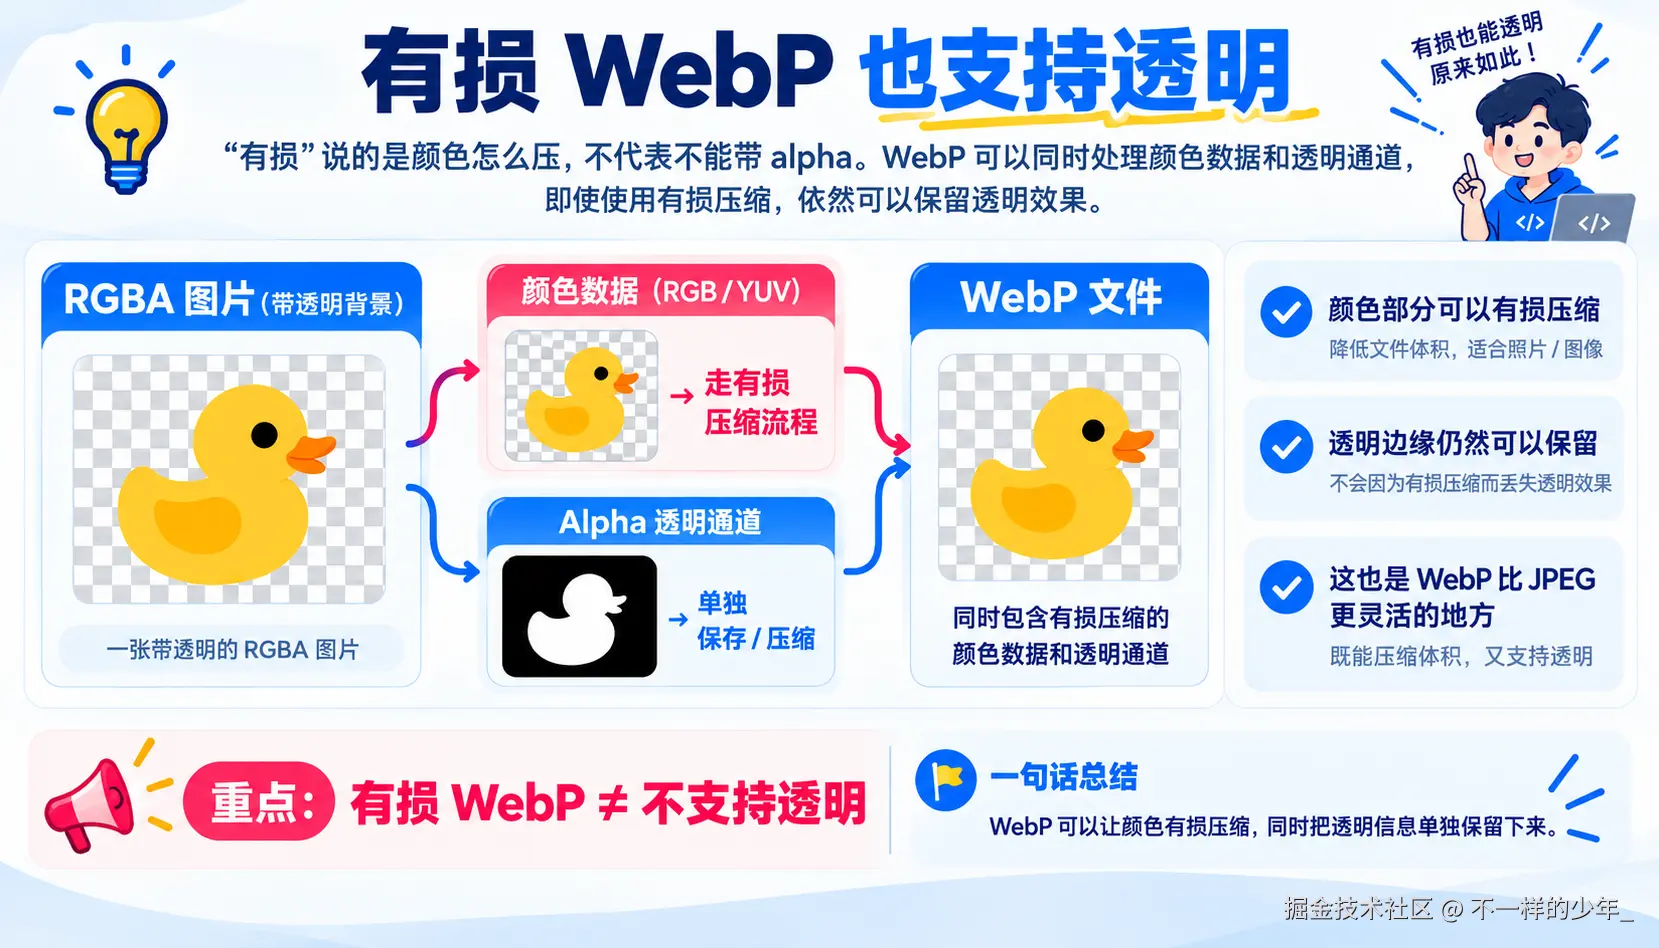
图:颜色走有损压缩,透明度单独处理。透明度不参与前面的 YUV 转换。
比如一张透明背景的商品图:商品本身有很多纹理,可以尝试有损压缩;哪里透明、哪里半透明,则交给单独的透明度信息。这个透明度通道就是 Alpha。
所以,"有损"不等于"不支持透明"。导出时仍要检查轮廓和半透明边缘,具体效果也取决于工具的设置。
二、无损路线:内容不改,换一种记法
无损不能靠"23 约等于 20"省空间。它要做的是:改写数据,但留下足够的信息,让解码器能反算回来。
它直接处理红、绿、蓝和透明度,不走前面的 YUV 颜色降采样和有损量化路线。
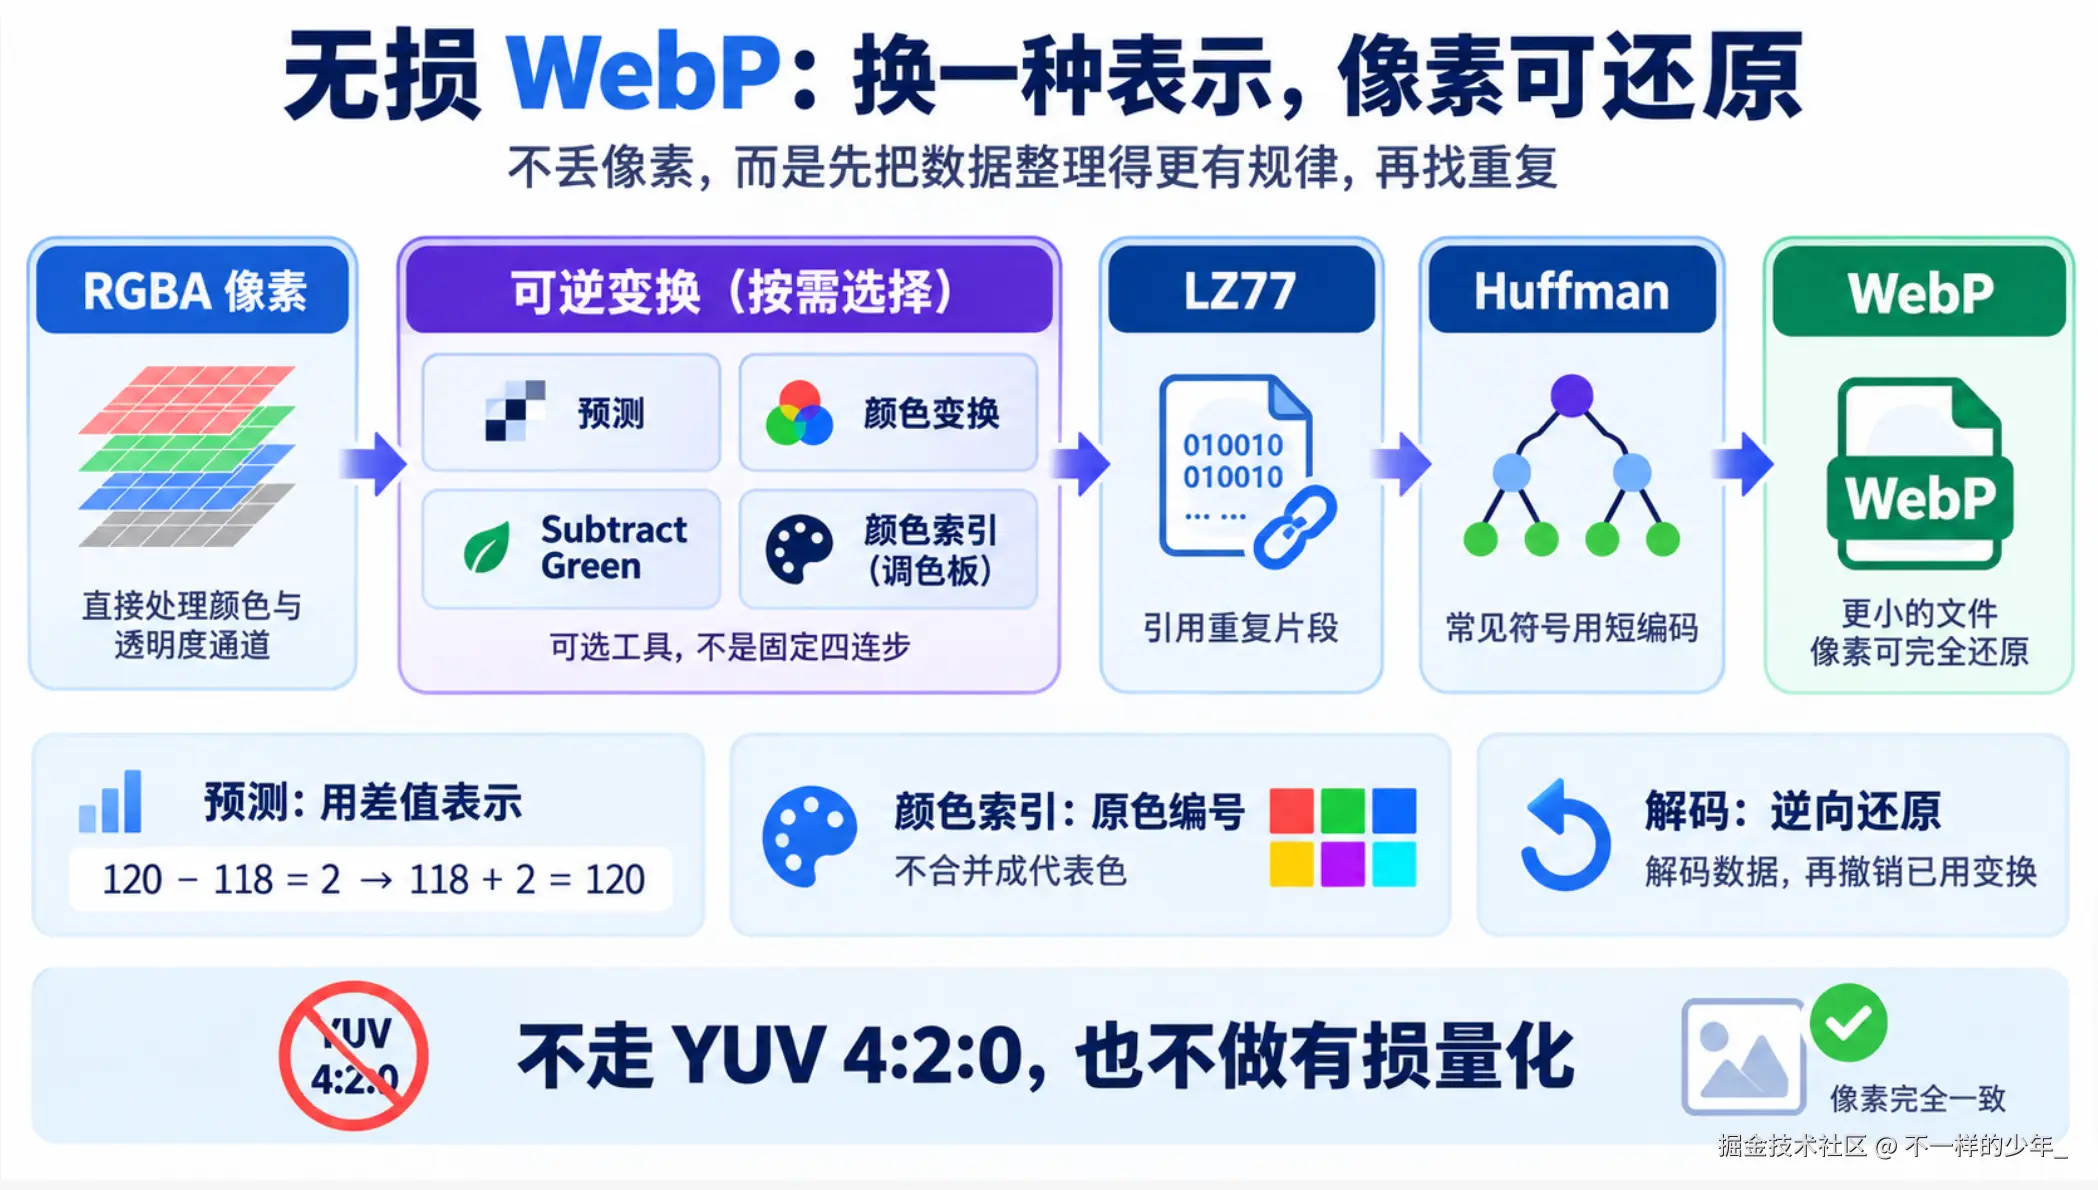
图:先按需要改写数据,再利用重复内容和编码规则压缩。中间四种改写方法是可选工具,不是每张图必做的四步。
方法一:记差值,但必须能加回去
还是刚才的 118 和 120:记录差值 2,解码时用相同的预测规则得到 118,再加 2,就回到了 120。
无损与有损都可能用到预测,但后面的处理不同:这里不能再为了压小文件,把恢复像素所需的差值随意记粗。
方法二:颜色之间能借用的信息,不必各记一遍
一个像素的红、绿、蓝三个数,有时也能互相参考。看一个简单的减绿色例子:
text
原来:红 200,绿 190,蓝 180
改写:绿 190,红比绿多 10,蓝比绿少 10
还原:红 = 190 + 10,蓝 = 190 − 10
颜色没有换,只是记录方式换了。能不能因此压得更小,要看图片内容,不能只看数字表面上变小了没有。
更一般的"颜色变换"也是利用通道之间的关系改写数据,并记录还原所需的信息。它不是前面的 RGB 转 YUV,更不是把相近颜色合并。
方法三:原本颜色就少,给每种颜色一个编号
这件事,前端可以直接类比"颜色表 + 下标"。
假设图片里有两种很接近的红色:
| 编号 | 原来的 RGBA 颜色 |
|---|---|
| 0 | (255, 0, 0, 255) |
| 1 | (254, 0, 0, 255) |
三个像素分别是"第一种红、第二种红、第一种红",就可以用 0、1、0 表示。解码时查颜色表,拿回准确的原色。透明度不同的颜色,也需要区分。
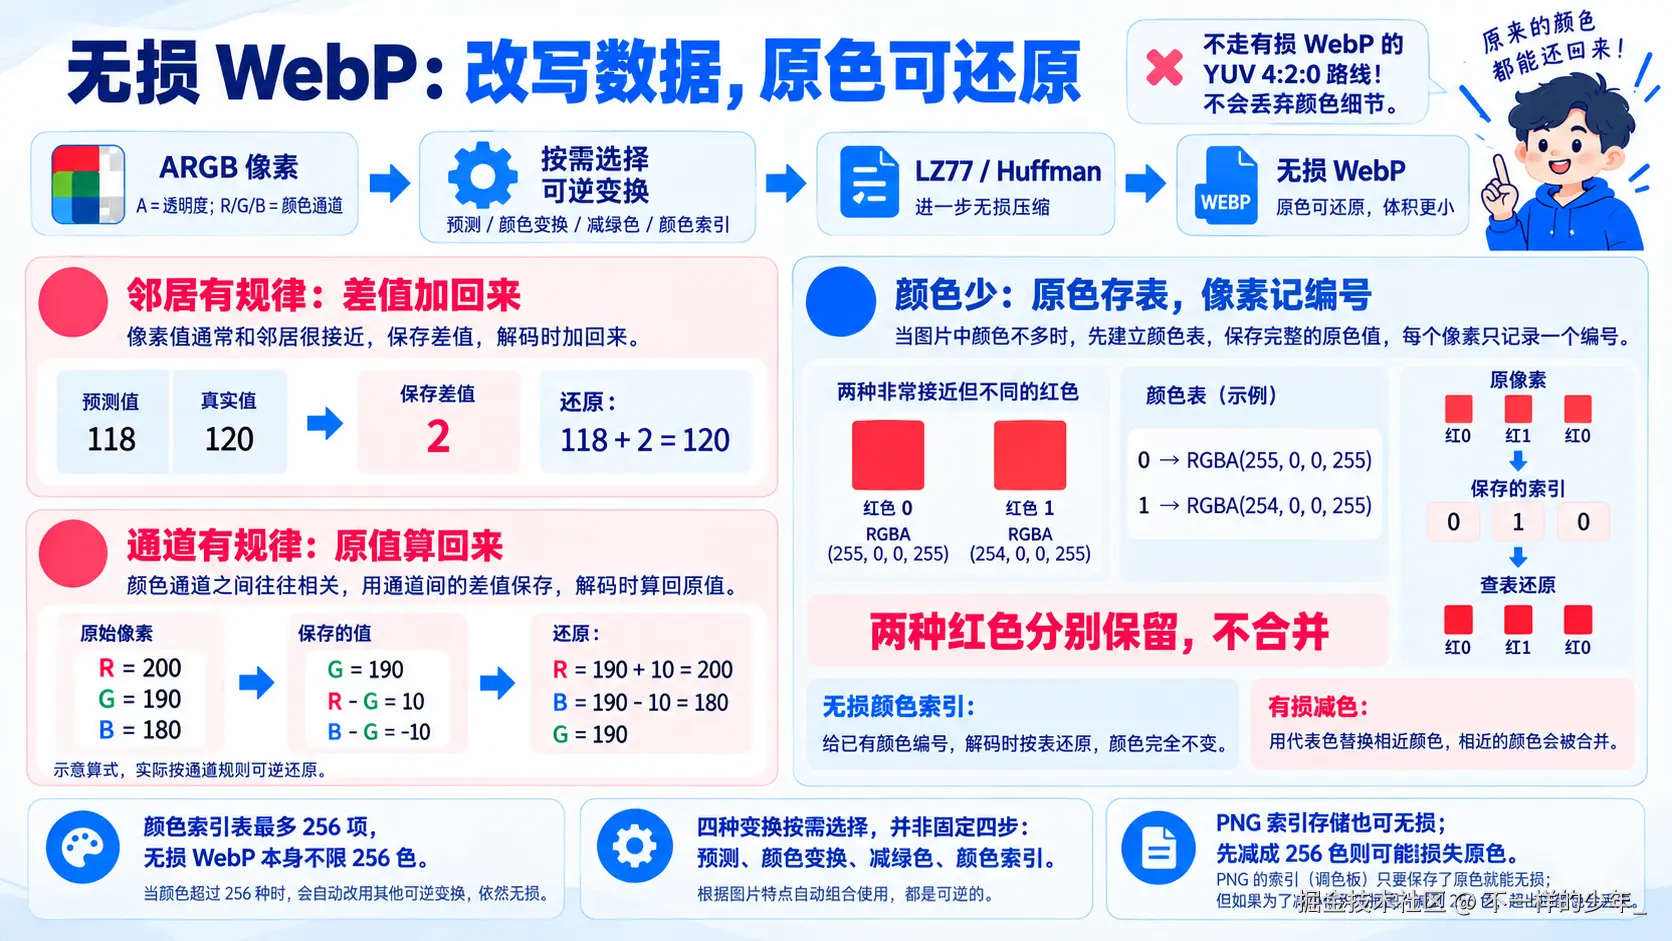
图:重点看"原色编号",两种红色再接近也不合并;其他可逆改写方法同样必须能还原。
这和"挑几个代表色,替换掉相近颜色"完全不同。后者可能丢掉原来的颜色,就不是这里说的无损改写了。
这个颜色表最多 256 项,不等于无损 WebP 只能保存 256 色。原图颜色更多时,可以不用这种方法,改用其他无损编码方式。
索引色 PNG 也有类似的颜色表思路。真正要区分的是:只给原色编号,还是先把颜色减到 256 种。损失可能发生在减色时,不是"用了颜色表"就必然有损。
最后两招:重复的内容引用,常见的符号写短
假设数据里反复出现 ABABABAB。不一定要把每个字母都重新写一遍,也可以表达成"先写 AB,后面从前面复制"。解码时照着复制,内容仍然一样。
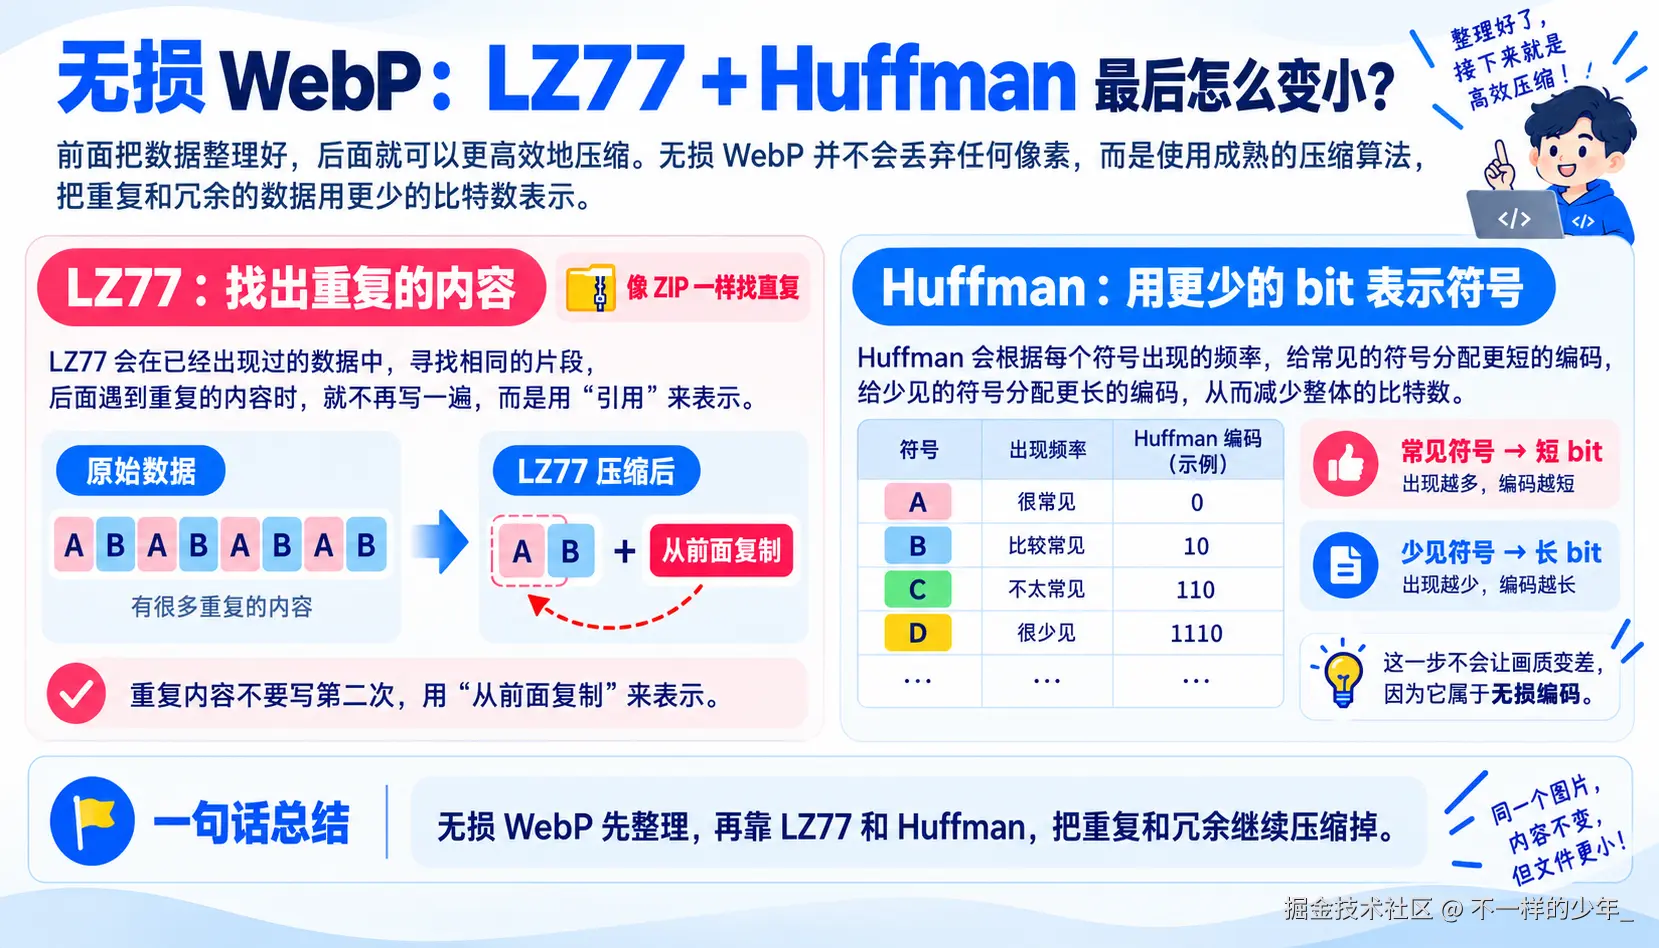
图:找重复与缩短编码是两个动作,目的都是用更少的比特表示同一份数据。字母和编码只是原理示意。
"找前面出现过的片段来复制"对应图里的 LZ77 ;"给常见符号较短的编码"对应 Huffman。现在知道它们各自干什么就够了,不需要背算法。
无损路线可以记成一句话:**能反算的就改写,重复的就引用,剩下的再编码。**不是每种方法都必须用,也不是每张图片都能省下同样多的空间。
三、为什么可能比 JPEG、PNG 小,但不是一定?
和常见有损 JPEG 相比,WebP 利用邻居生成预测、再处理差值,是减少重复信息的重要办法;文件大小还受到量化、编码等环节影响,不能只归功于一个步骤。
和 PNG 相比,无损 WebP 有自己针对像素、颜色和重复片段的处理方式。不过 PNG 本身也会先整理数据再压缩,不是"PNG 只会原样保存,WebP 才会找规律"。
**能否更小,必须回到同一张图、可接受的画质和实际导出结果上比较。**不要只看后缀,更不要以为已经损失的 JPEG 细节,转成无损 WebP 就能长回来。
四、回到前端:实际怎么选?
先按用途选候选,再看体积与效果。这是测试起点,不是"某一类图永远只能用某种格式"。
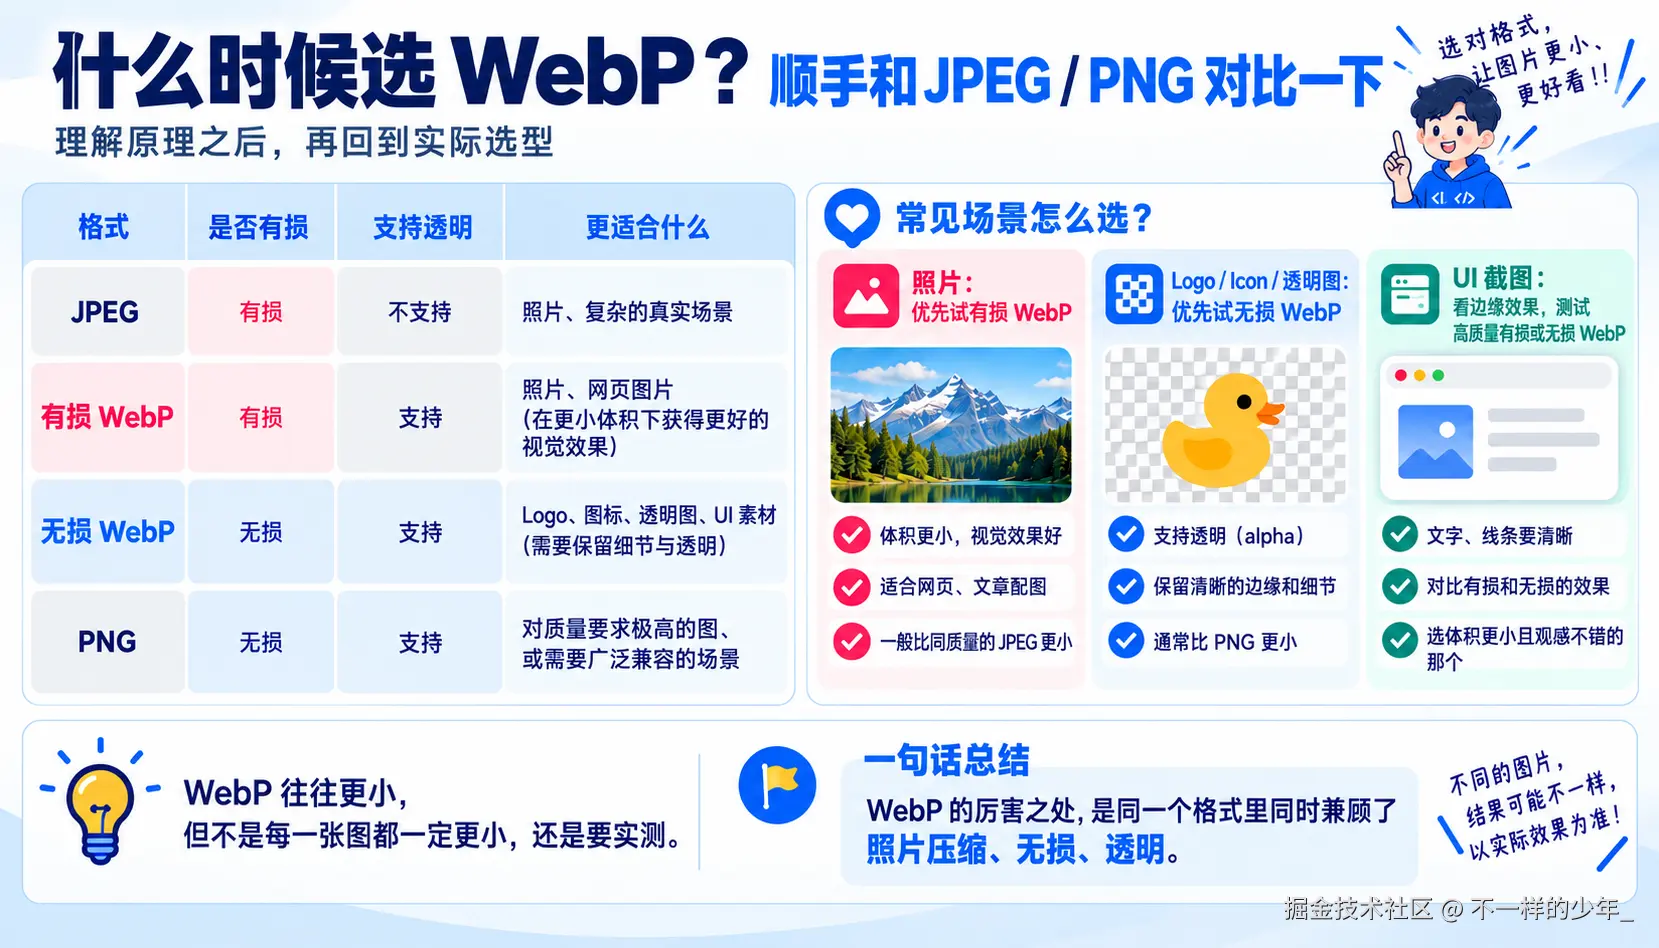
图:照片、Logo、UI 截图分别关注不同问题,最终选择以实测为准。
| 手里的图片 | 可以先试什么 | 重点检查 |
|---|---|---|
| 照片、Banner、商品图 | 有损 WebP,与 JPEG 对比 | 纹理、渐变、人物和体积 |
| Logo、图标、颜色少的透明图 | 无损 WebP,与 PNG 对比 | 细线、原色、透明边缘 |
| 带字的 UI 截图 | 无损或高质量有损 WebP | 小字和彩色边缘,不能只看缩略图 |
| 透明背景的复杂商品图 | 有损颜色 + 透明度 | 商品细节及半透明轮廓 |
测试时可以按这个顺序:
- 先确认图片的实际显示尺寸,别让一个小卡片下载用不上的超大图;也要考虑高像素密度屏幕。
- 保留原图,从同一份原始素材导出候选,避免反复有损转码。
- 在相同尺寸下比较文件大小,并按页面实际显示大小看一遍。
- 再放大检查文字、透明边缘和渐变;放大是找问题,不是唯一的验收标准。
- 确认目标浏览器、WebView 和现有图片服务支持你的输出方式。
这里的 quality 讨论针对有损模式。某些工具在无损模式下,同名参数调的是压缩耗时或压缩力度,不是在决定"丢多少画质",使用前要看工具说明。
到这里,记住四句话就够了
- 有损:允许一些细节不那么精确,换取更小的体积。
- 预测和变换:先算差多少,再把差值里的规律整理出来,不是直接删掉像素。
- 无损:换存法、不随意改原色;颜色编号也不是代表色减色。
- 选格式:同尺寸、看效果、比体积。WebP 是候选,不是每张图必胜的答案。
补充:想对上图里的尺寸和术语,再看这里
如果只关心前端使用,到上面就可以结束。这一节用来查名词,不需要记忆。
三种"块",不要混着比较
图片不会整张一起算,而是按区域处理。同一片图像的明暗表和颜色表,会被归到一起;但归组不等于混合数值。
| 名字 | 通俗理解 | 有损 WebP 中的尺寸 |
|---|---|---|
| 宏块 | 同一片图像区域的数据归成一组 | 16×16 Y + 8×8 U + 8×8 V |
| 预测块 | 这一次预测多大的区域 | Y 可按 16×16 或 4×4;U、V 各按 8×8 |
| 变换块 | 这一次整理多少残差值 | 各分量以 4×4 残差块为基本单位 |
Y 参考 Y 邻居,U 参考 U 邻居,V 参考 V 邻居。16×16 的 Y 预测区域得到残差后,按 16 个 4×4 小组做变换;8×8 的色度残差各分为 4 组;4×4 的 Y 残差本身就是一组。
常见有损 JPEG 的基本 DCT 变换块是单个分量中的 8×8。4:2:0 交错编码里,一个 MCU 包含四个 Y 块及各一个 Cb、Cr 块。**不能拿 JPEG 的变换块与 WebP 的整个宏块直接比较。**JPEG 的 DC 系数也有差分编码,不代表它完全没有预测思想。
算法名只当检索词
有损 WebP 基于 VP8 帧内编码,主要对 4×4 残差做整数近似 DCT;部分亮度系数还会进一步做 Walsh--Hadamard 变换。后面的熵编码使用布尔算术编码,不是无损路线里的 Huffman。
无损中的减绿色示例为了好懂写了负数,实际通道运算按 256 取模。严格逐像素验收时,还要留意编码工具是否启用了预处理、近无损模式,以及是否保留全透明像素下面不可见的 RGB 数据。
继续阅读:WebP 压缩原理概览、VP8 规范、WebP 无损规范、JPEG 标准。