MinD-Vis:用稀疏掩码预训练和双条件扩散从 fMRI 重建视觉图像
原论文:Seeing Beyond the Brain: Conditional Diffusion Model With Sparse Masked Modeling for Vision Decoding
作者:Zijiao Chen、Jiaxin Qing、Tiange Xiang、Wan Lin Yue、Juan Helen Zhou
会议:CVPR 2023
原文与项目页:mind-vis.github.io
30 秒看懂这篇论文
- 研究问题:在配对的 fMRI---图像样本很少、被试差异很大的情况下,能否重建出语义正确且细节可信的视觉图像?
- 核心方法:先用大规模无标签 fMRI 做 Sparse-Coded Masked Brain Modeling(SC-MBM),再把得到的脑信号潜表示通过 Double-Conditioned Latent Diffusion Model(DC-LDM)接入图像生成。
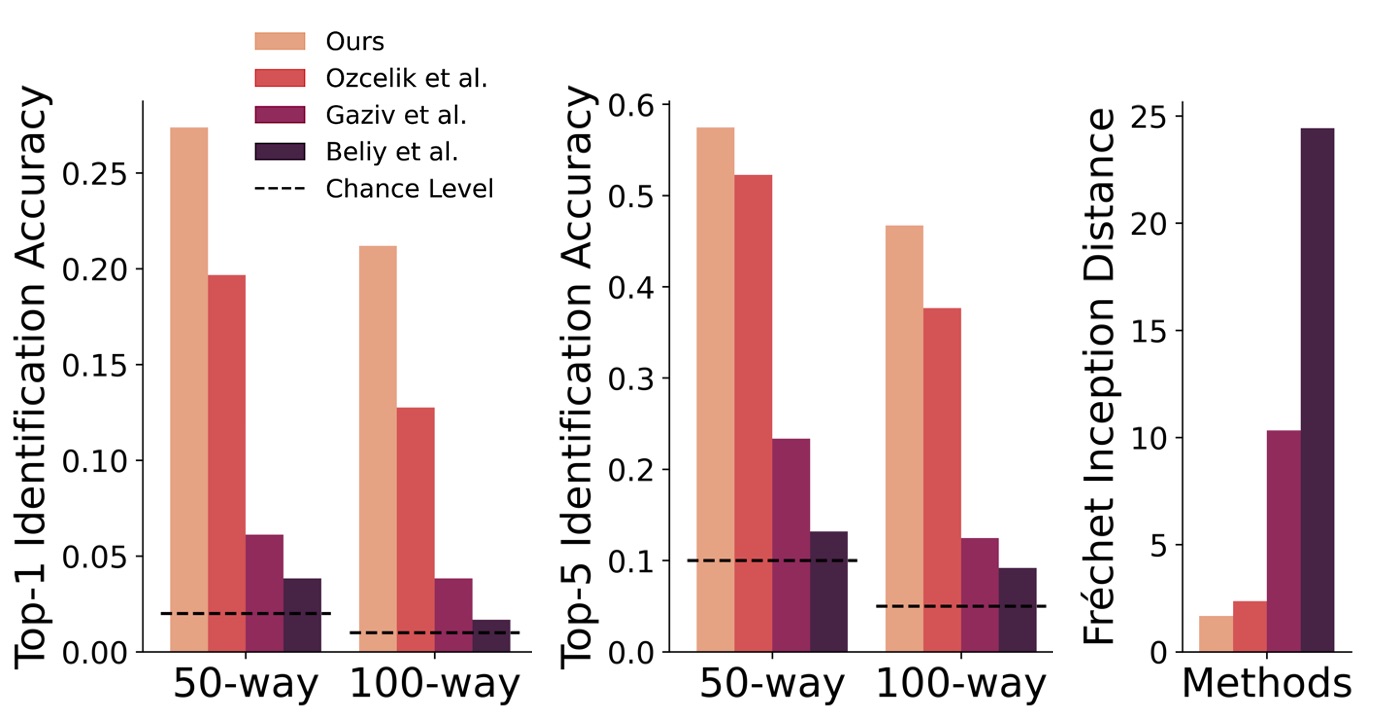
- 主要结果:在 GOD 测试集上,作者报告 50-way 与 100-way 语义识别率分别为 0.274 和 0.212;最佳采样的 FID 为 1.67,五次采样平均 FID 为 2.22 ± 0.3。
- 真正贡献:把"脑信号表示学习"和"扩散模型生成"拆成两个阶段,用掩码重建利用大量无标签 fMRI,用双条件机制同时约束语义一致性和生成多样性。
- 最大边界:主实验是单被试个体内解码,且生成模型本身携带强视觉先验;论文没有证明模型已经恢复了刺激的全部像素级信息,也没有完成跨被试泛化。
1. 为什么要研究这个问题?
视觉脑解码的目标并不只是判断"被试看到了动物还是建筑",还希望从脑活动中恢复更丰富的视觉内容。fMRI 能以较高空间分辨率记录 BOLD 信号,但它测到的是神经活动的间接代理;同时,视觉皮层中相邻体素具有空间冗余,不同被试的 ROI 位置和大小也不完全一致。于是,直接用少量 fMRI---图像配对样本训练一个从脑信号到像素的模型,很容易得到模糊、语义错误或过度依赖训练集的结果。
MinD-Vis 的出发点是两个判断。第一,fMRI 中存在大量可以从上下文推断的结构,应该先用大规模无标签脑数据学习表示,而不是把所有能力都压在少量配对标注上。第二,视觉图像的生成本身可以交给预训练的 latent diffusion model(LDM),脑信号只需要成为一个可靠的条件输入。因此,论文把问题重写为:如何学习一个对视觉解码有用的 fMRI 潜空间,以及如何让这个潜空间既能约束生成结果的语义,又不把同一脑活动对应的可能图像压成唯一答案?
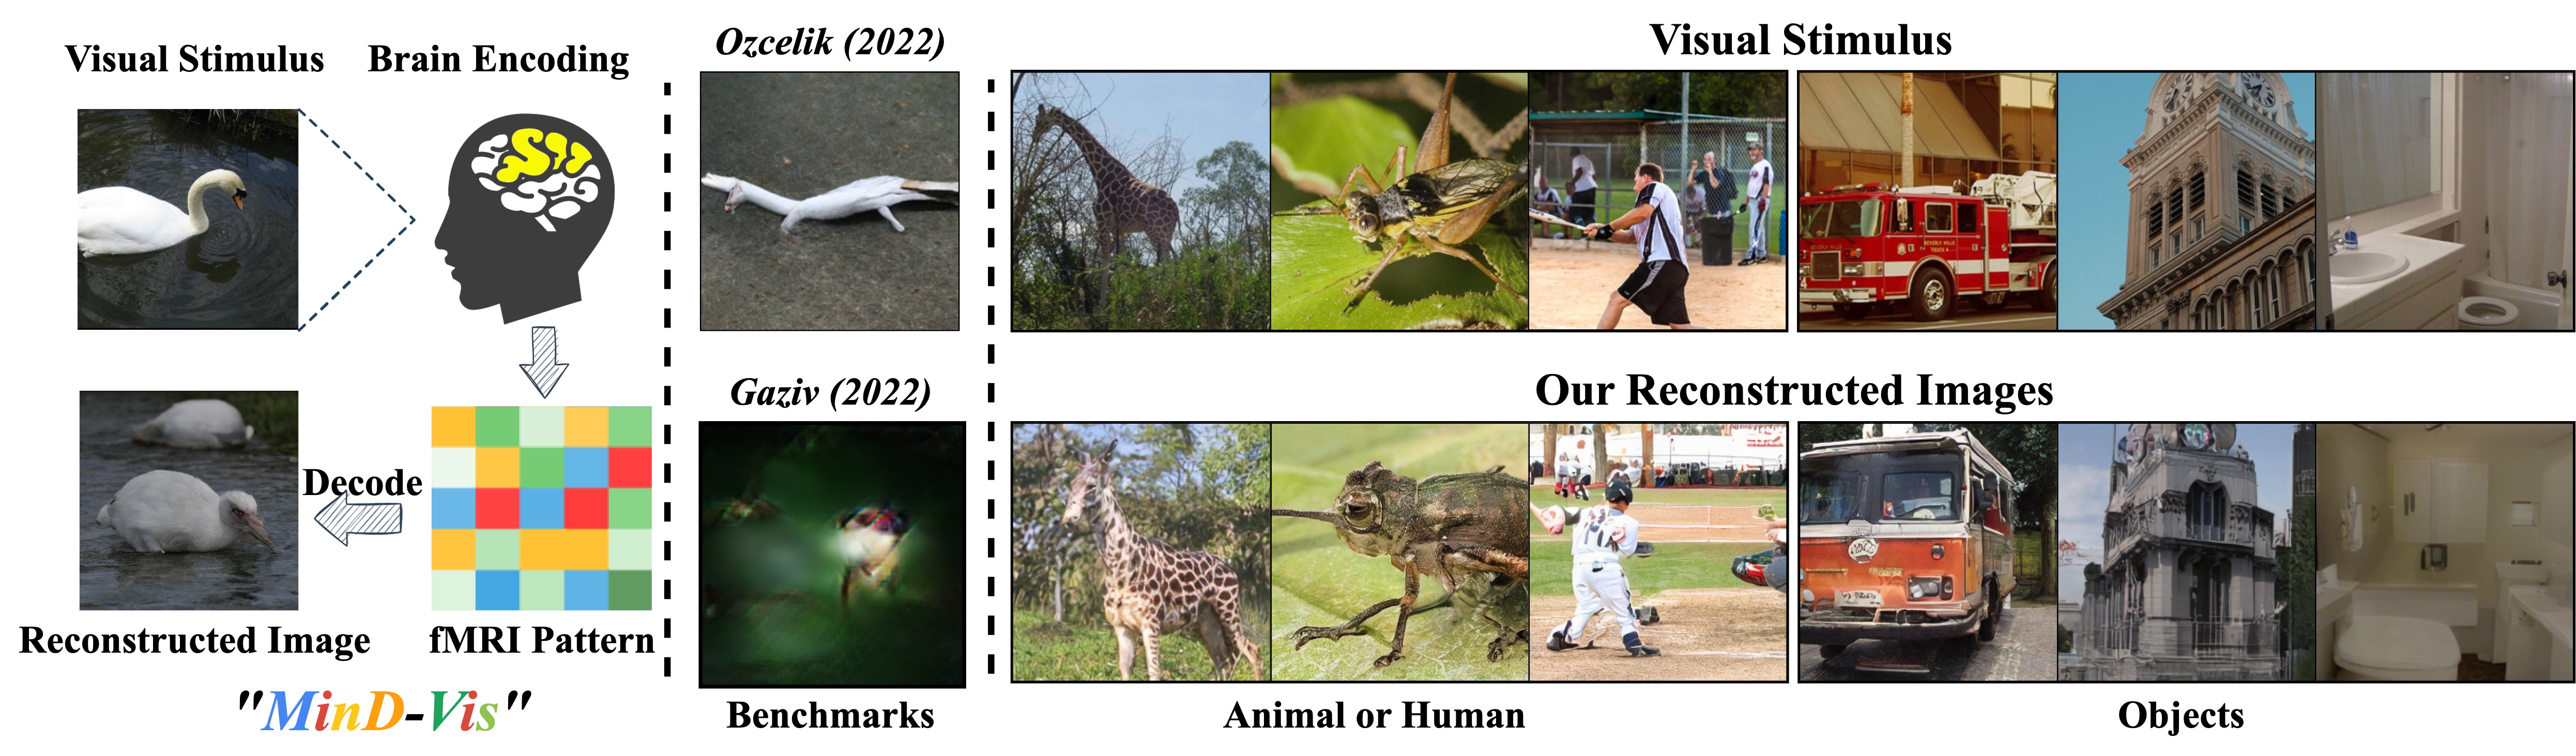
来源:原论文 Figure 1,PDF 第 1 页;原图直接提取,未重绘或添加标注。
Figure 1 先给出了论文的任务边界:输入是视觉刺激诱发的 fMRI,输出是重建图像。图中还把 MinD-Vis 与 Ozcelik、Gaziv 等方法并列展示。需要注意,右侧的"看起来像原图"并不等于像素级复制;它主要说明生成结果包含了与刺激相符的类别、形状、纹理和场景线索。
2. 作者提出了什么问题或假设?
论文的核心假设可以拆成三个可检验部分。
- 大规模无标签 fMRI 能提供可迁移的上下文表示。 如果在 fMRI 上做掩码重建,模型必须利用未被遮挡的体素和空间结构去推断被遮挡部分,这比直接记忆少量图像标签更适合作为预训练任务。
- 稀疏编码式的过完备表示适合 fMRI。 作者认为视觉皮层中的信息具有稀疏编码特征,因此让 fMRI patch 映射到比原始数据维度更大的 embedding 空间,可能保留更多局部结构。
- 生成阶段需要双重条件。 只把 fMRI 潜变量接到 LDM 的 cross-attention,或者只把它作为时间步条件,约束都不够强。两个路径一起使用,可以在相同语义附近保留扩散采样的变化,同时提高脑信号与图像内容的一致性。
论文 Figure 2 还提醒了一个常被忽略的问题:不同被试对同一视觉任务的响应区域并不严格重合。
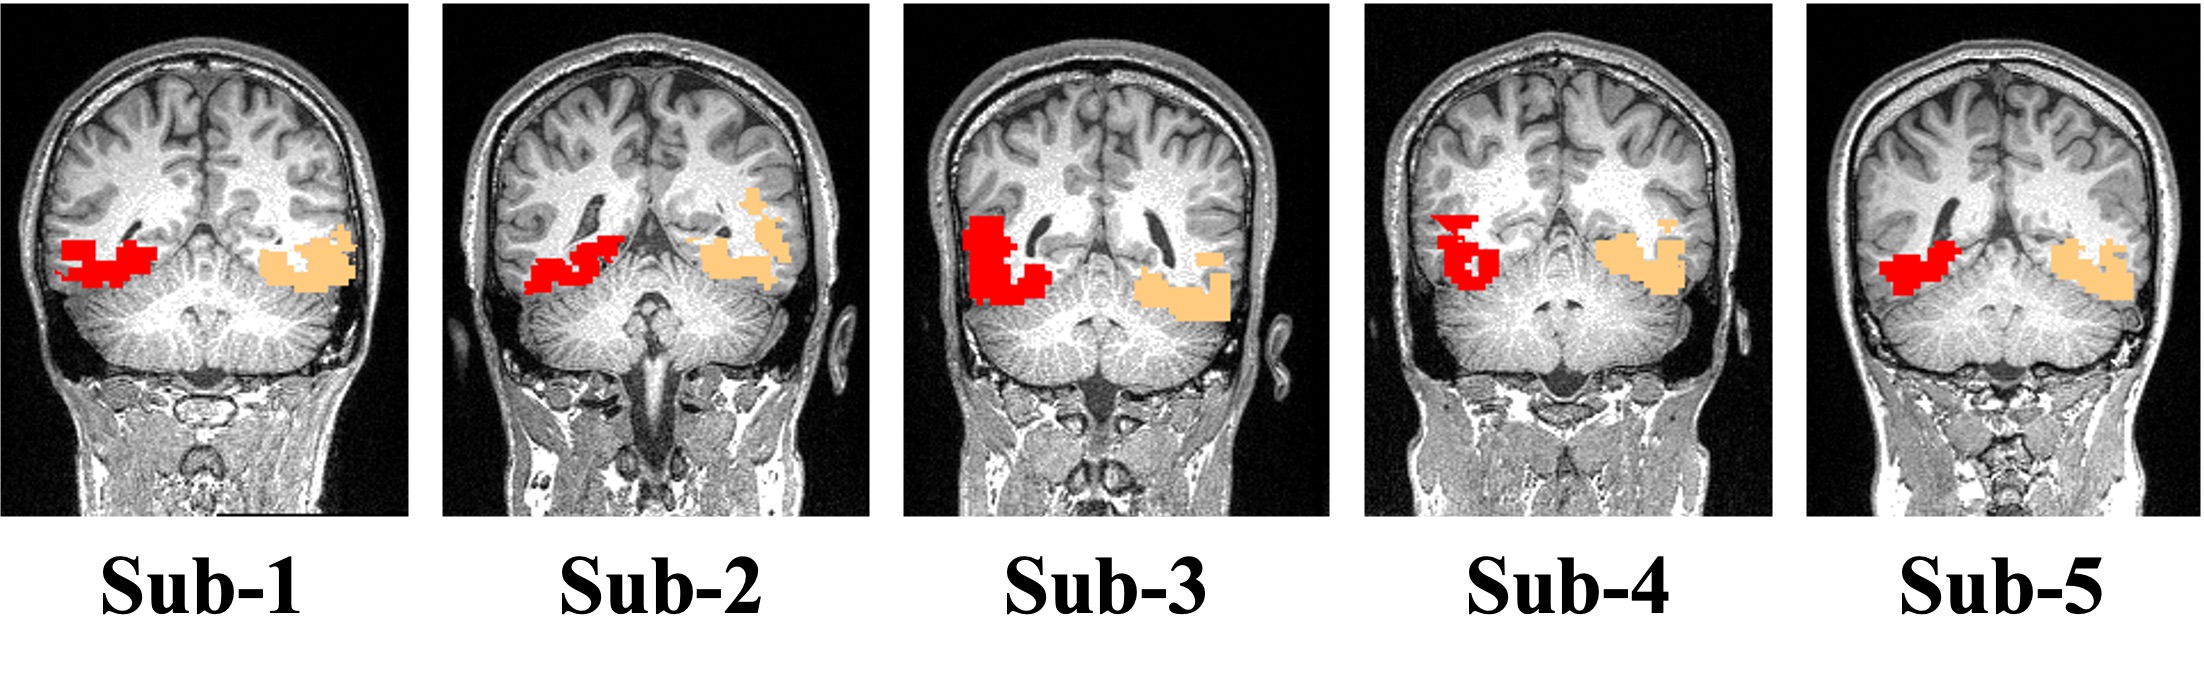
来源:原论文 Figure 2,PDF 第 2 页;原图直接提取,未重绘或添加标注。
这张图支持作者"需要更稳健脑表示"的动机,但它没有直接证明 SC-MBM 能解决跨被试对齐。本文的主实验仍然是每个被试分别训练和测试,跨被试只出现在未来工作讨论中。
3. 方法:这项研究是怎样完成的?
3.1 两阶段总框架
MinD-Vis 的流程如 Figure 3 所示。Stage A 只处理 fMRI:把 ROI 向量切成 patch,随机遮挡其中大部分,再用编码器---解码器恢复被遮挡的脑信号。Stage B 把 Stage A 学到的 fMRI encoder 接入预训练 LDM,并使用少量 fMRI---图像配对样本进行端到端微调。
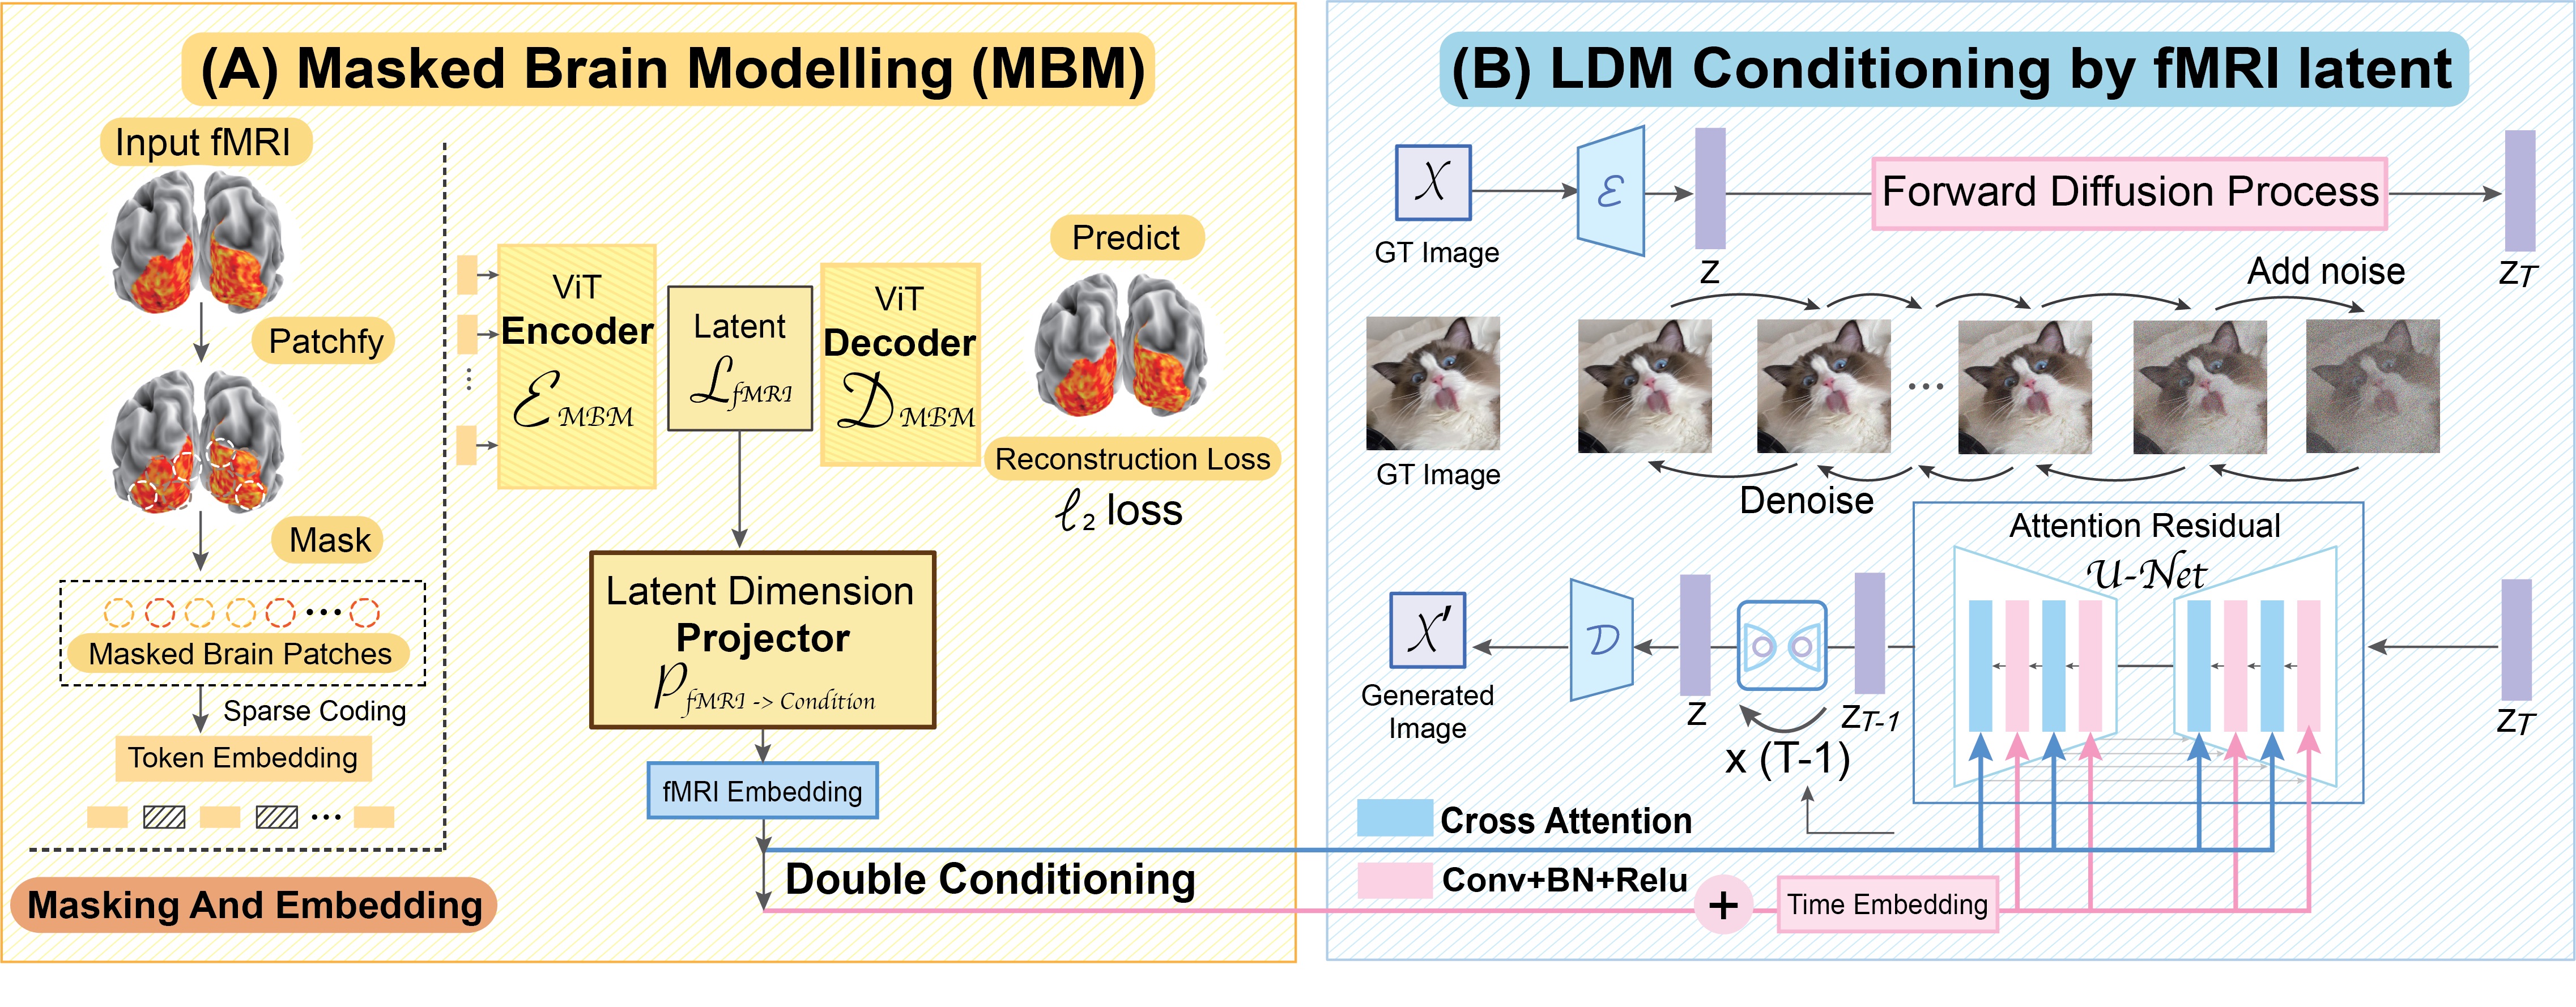
来源:原论文 Figure 3,PDF 第 3 页;原图直接提取,未重绘或添加标注。
SC-MBM 的关键设置是 patch size 为 16、embedding dimension 为 1024、encoder depth 为 24、mask ratio 为 0.75。与视觉 MAE 中接近输入维度的表示不同,作者刻意使用较大的 embedding-to-patch-size ratio,让脑表示具有更高容量。被遮挡的 patch 由 decoder 重建,decoder 在预训练完成后不再参与 Stage B。
掩码后的脑信号示例如 Figure 4。由于 BOLD 数据具有空间平滑和局部冗余,即使遮掉 75% 的体素,剩余信号仍可能包含恢复被遮挡区域所需的上下文。
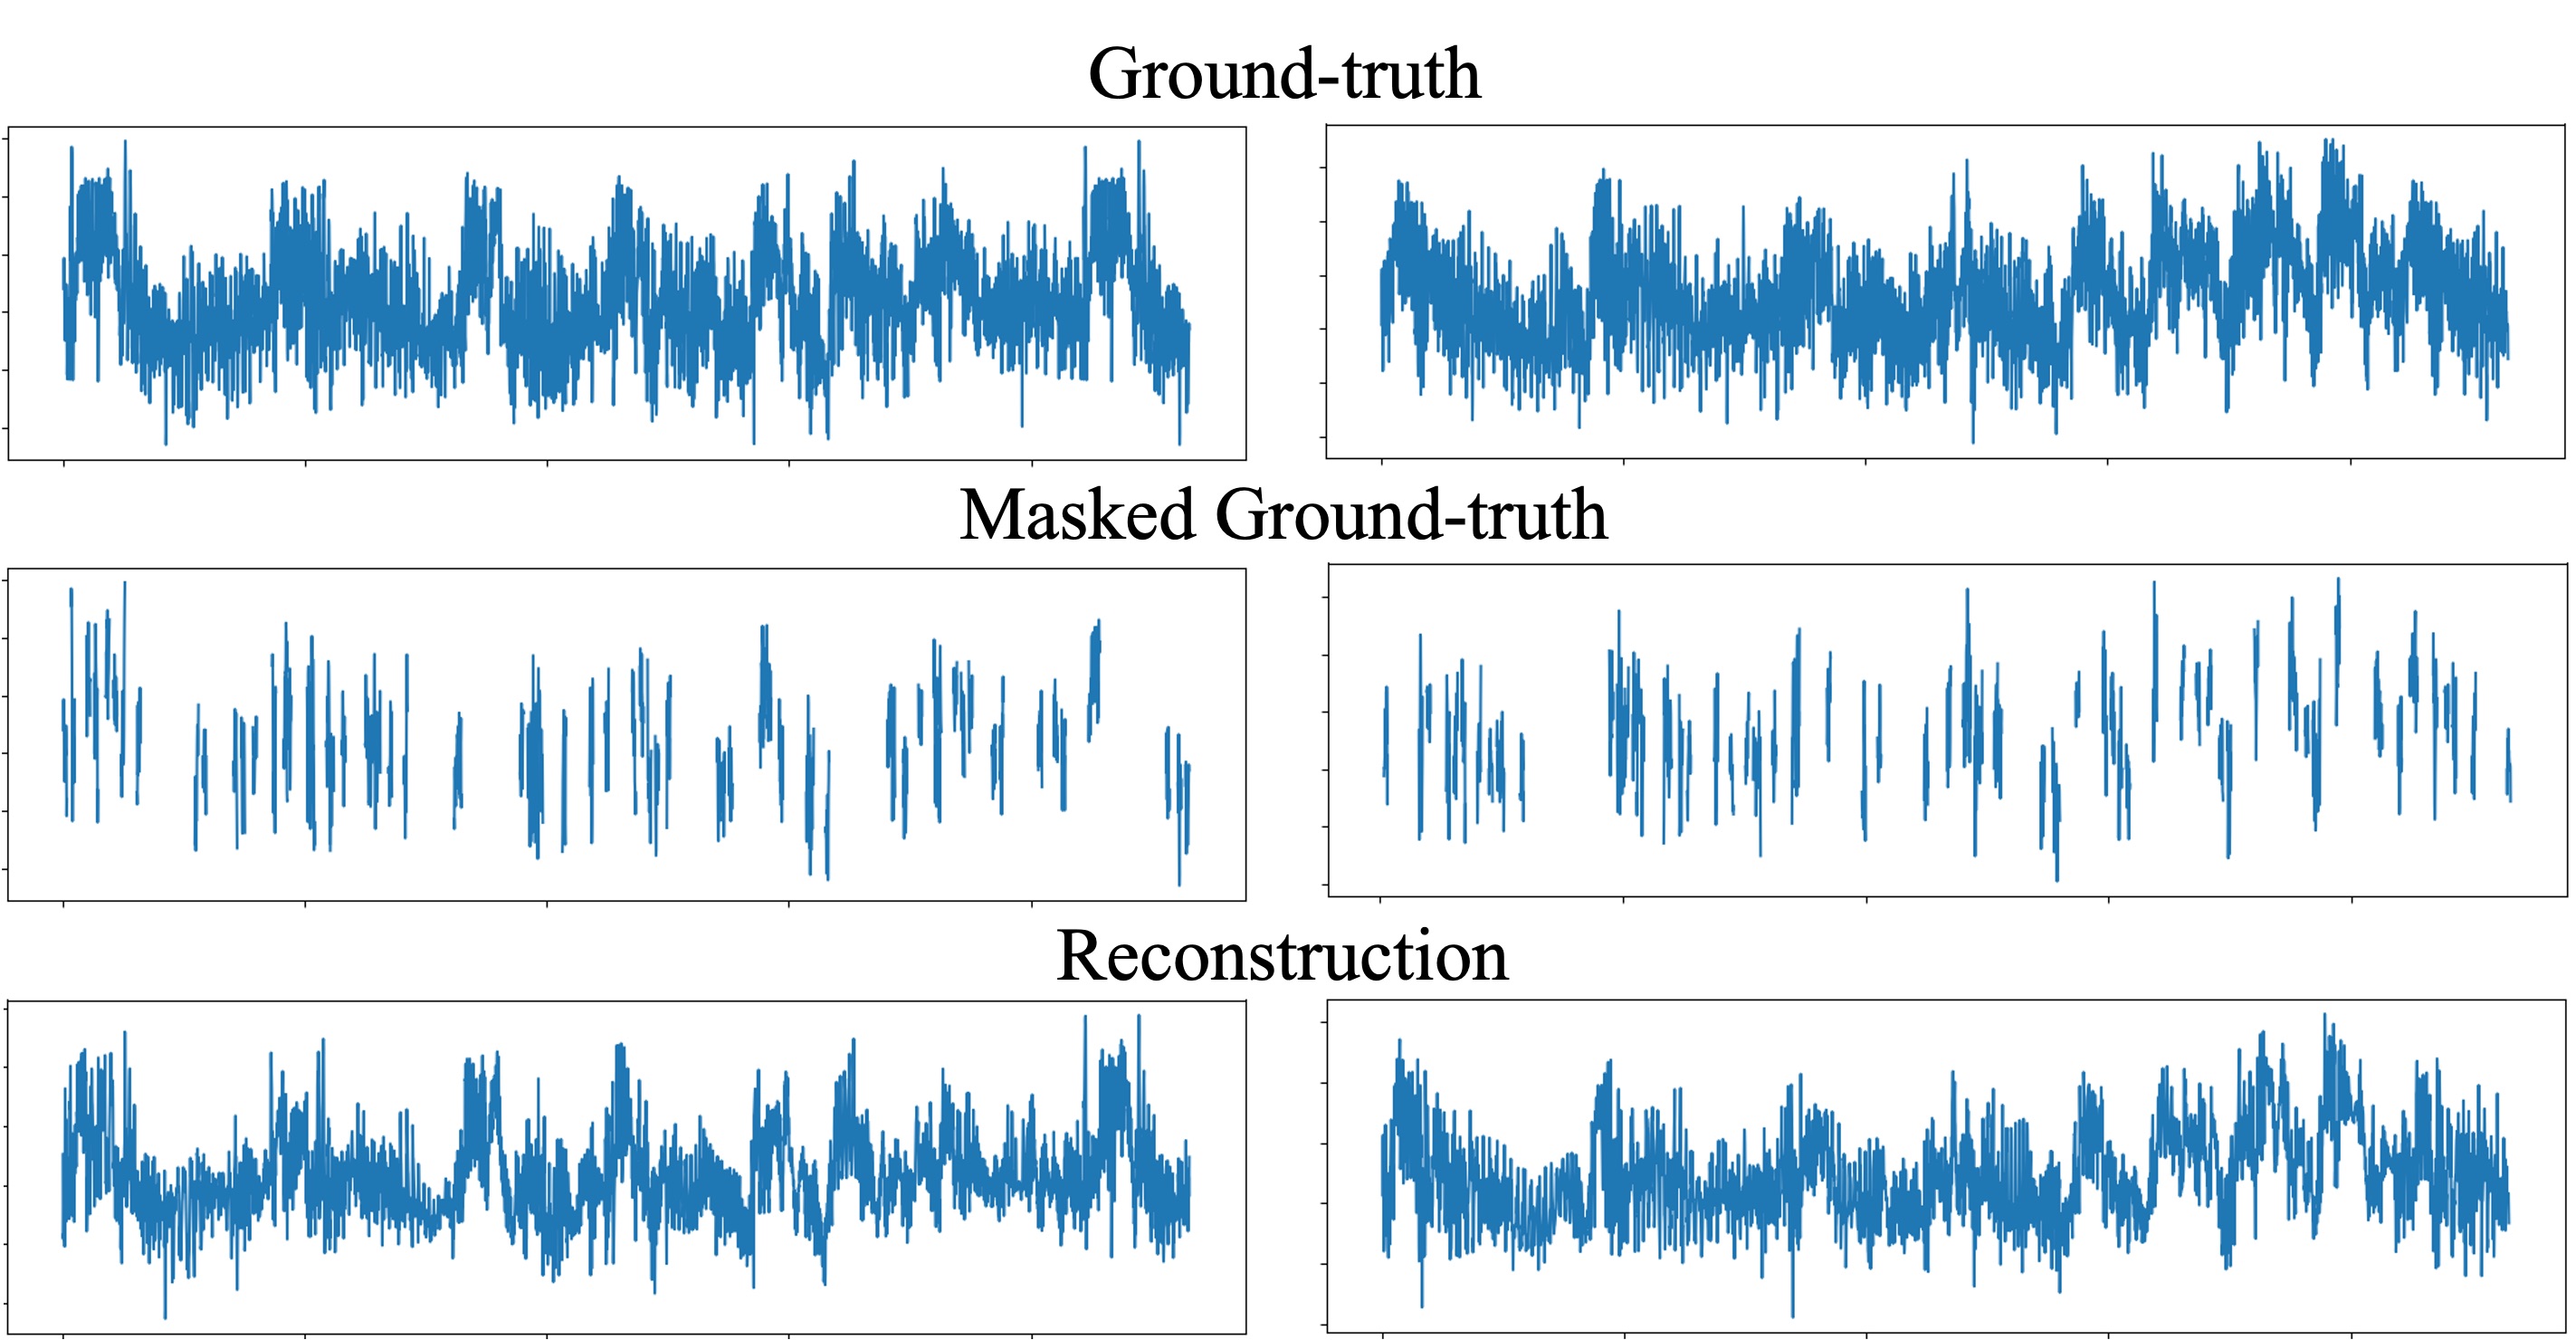
来源:原论文 Figure 4,PDF 第 4 页;原图直接提取,未重绘或添加标注。
3.2 双条件 latent diffusion
在 Stage B 中,LDM 在低维图像 latent 空间工作,而不是直接在 256 × 256 256\times256 256×256 像素空间扩散。fMRI encoder 输出潜变量 z z z,经过投影后进入两个条件路径:第一条路径连接 LDM U-Net 的 cross-attention;第二条路径把 fMRI 信息加入扩散时间步 embedding。
cross-attention 的基本形式为:
CrossAttention ( Q , K , V ) = softmax ( Q K T d a ) V . \operatorname{CrossAttention}(Q,K,V)=\operatorname{softmax}\left(\frac{QK^{\mathsf T}}{\sqrt{d_a}}\right)V. CrossAttention(Q,K,V)=softmax(da QKT)V.
论文给出的条件扩散目标在普通噪声预测损失上增加了脑条件:
L t c o n d = E x , ϵ , t ∥ ϵ − ϵ θ ( x t , t , τ ( z ) , σ ( τ ( z ) ) ) ∥ 2 2 . L_t^{\mathrm{cond}}=\mathbb{E}_{x,\epsilon,t}\left\\left\\\|\\epsilon-\\epsilon_\\theta\\bigl(x_t,t,\\tau(z),\\sigma(\\tau(z))\\bigr)\\right\\\|_2\^2\\right. Ltcond=Ex,ϵ,t ϵ−ϵθ(xt,t,τ(z),σ(τ(z))) 22.
这里的直观含义是:cross-attention 让 U-Net 在去噪时访问脑潜表示,时间步条件则把同一脑表示注入扩散过程的时间编码。两条路径不是把脑信号复制两遍,而是让条件信息在不同层级参与生成。
3.3 数据、训练与评价
作者使用三个数据来源。预训练数据由 Human Connectome Project(HCP)1200 Subject Release 与 GOD 组合而成,共约 136,000 个 fMRI segments、约 340 小时扫描。GOD(Generic Object Decoding Dataset)包含 200 个类别的 1,250 张图像,其中 1,200 张用于训练,50 张用于测试,训练和测试类别不重叠。BOLD5000 包含 5,254 个 fMRI---图像对、4,916 张不同图像,其中 113 张用于测试,是论文用于检验跨数据集复现能力的新数据集。
GOD 主实验的 fMRI 与图像配对来自同一个被试,作者明确指出这是个体内解码,以避开个体差异这一额外变量。模型预训练 500 个 epoch,随后使用配对数据微调 500 个 epoch;图像生成分辨率为 256 × 256 256\times256 256×256,采样使用 250 个 PLMS steps。论文没有在主文中完整报告所有硬件、批大小和随机种子,因此仅凭主文不能完全复现训练成本。
评价分成两类。第一类是语义识别:从 ImageNet 预训练分类器的输出中做 50-way 或 100-way top-1/top-5 识别,检查生成图像是否与真实图像属于同一语义类别。第二类是 FID,用于比较真实图像和生成图像的分布距离。作者特别说明没有把像素级指标作为主目标,因为该工作更关注语义正确和可感知的视觉内容。
4. 核心结果与论文原图
4.1 定性结果:语义与细节同时改善
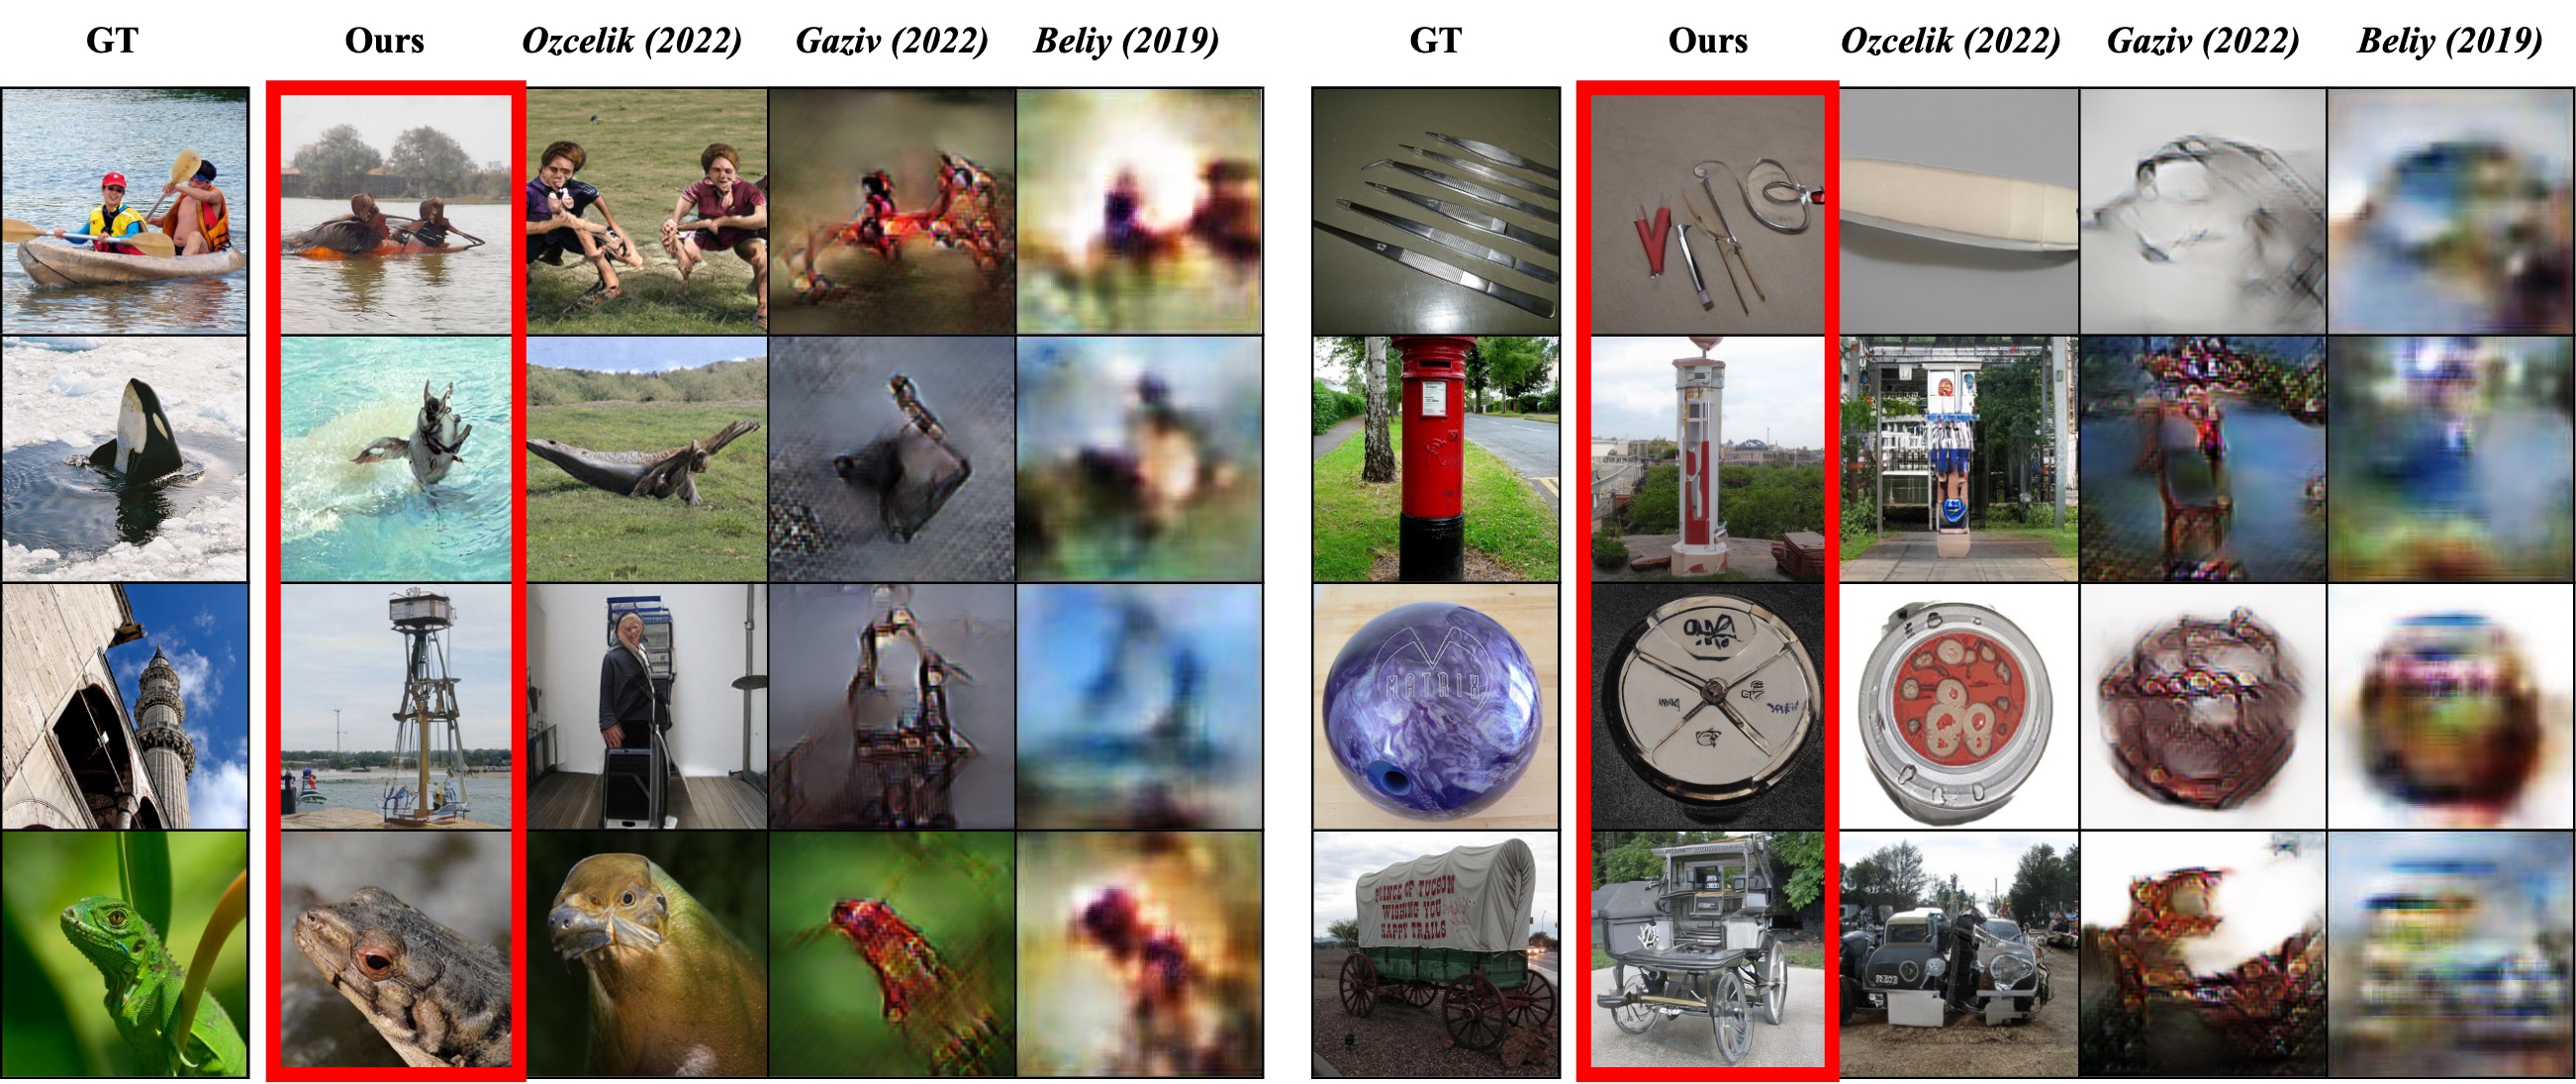
Figure 5 对比了 MinD-Vis、Ozcelik 2022、Gaziv 2022 和 Beliy 2019。传统方法有时能保留颜色或粗略布局,却容易丢失物体类别和局部结构;MinD-Vis 的输出通常同时保留了水面、动物、建筑、车辆等更明确的语义线索。
来源:原论文 Figure 5,PDF 第 5 页;原图直接提取,未重绘或添加标注。
定性图最容易引起过度解读。扩散模型拥有 ImageNet 级视觉先验,因此生成出的"合理物体"可能来自先验,而不完全来自这一次 fMRI。真正需要结合的是语义分类、FID、消融实验和跨数据集结果,而不是只看一列最漂亮的图。
4.2 定量结果:识别率和 FID
来源:原论文 Figure 6,PDF 第 5 页;原图直接提取,未重绘或添加标注。
作者报告 MinD-Vis 在 50-way top-1 任务上达到 0.274,在 100-way top-1 任务上达到 0.212。与 Ozcelik 等基线相比,论文文字称提升分别约为 39% 和 66%;摘要则将 100-way 语义识别与 FID 的相对提升概括为 66% 和 41%。这里的百分比是相对基线的比较,不应误读成"模型有 66% 的图像像素被正确恢复"。
FID 的最佳采样值为 1.67;五次随机采样的平均值为 2.22 ± 0.3。由于 GOD 测试集规模有限,作者也提醒 FID 只能作为参考,可能低估真实分布差异。对脑解码来说,FID 还不是脑信号忠实度的直接度量,它更接近生成图像质量与分布相似度。
4.3 采样一致性:同一脑信号可以产生多个合理结果
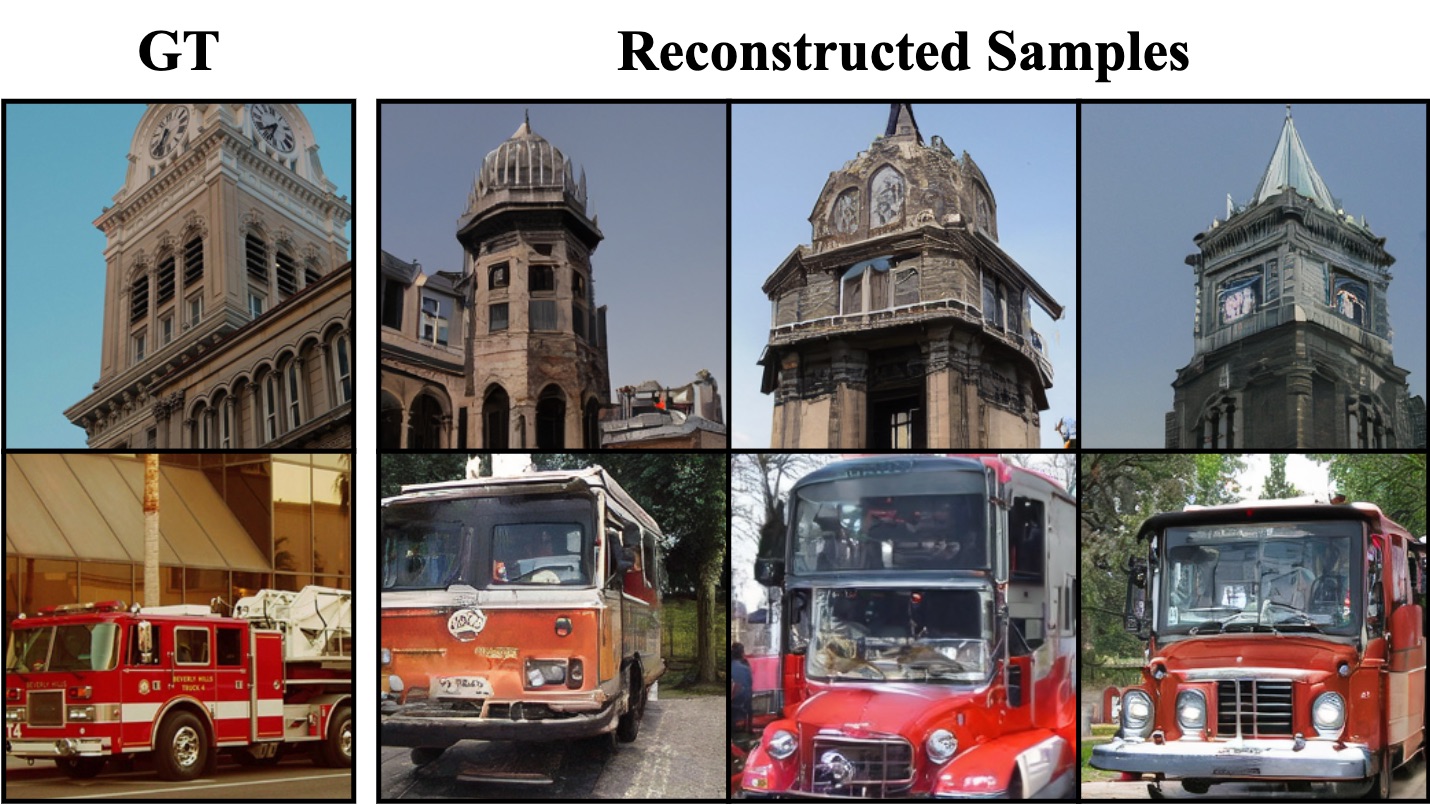
扩散模型是随机生成器。Figure 7 显示,同一 fMRI 输入经过五次采样后,图像会有不同的外观,但仍共享对象类别、形状、颜色和纹理等低层与高层属性。
来源:原论文 Figure 7,PDF 第 6 页;原图直接提取,未重绘或添加标注。
这项设计的科学意义在于,它没有把脑信号与一张唯一"标准答案"硬绑定。人类视觉表征本身可能允许多个与语义相符的图像解释,双条件机制试图在一致性与多样性之间取平衡。不过,论文并没有用人工评分或神经预测指标证明每一次采样都符合被试的主观感知,因此"多样且合理"仍主要由图像和语义指标支持。
4.4 BOLD5000 复现与额外特征
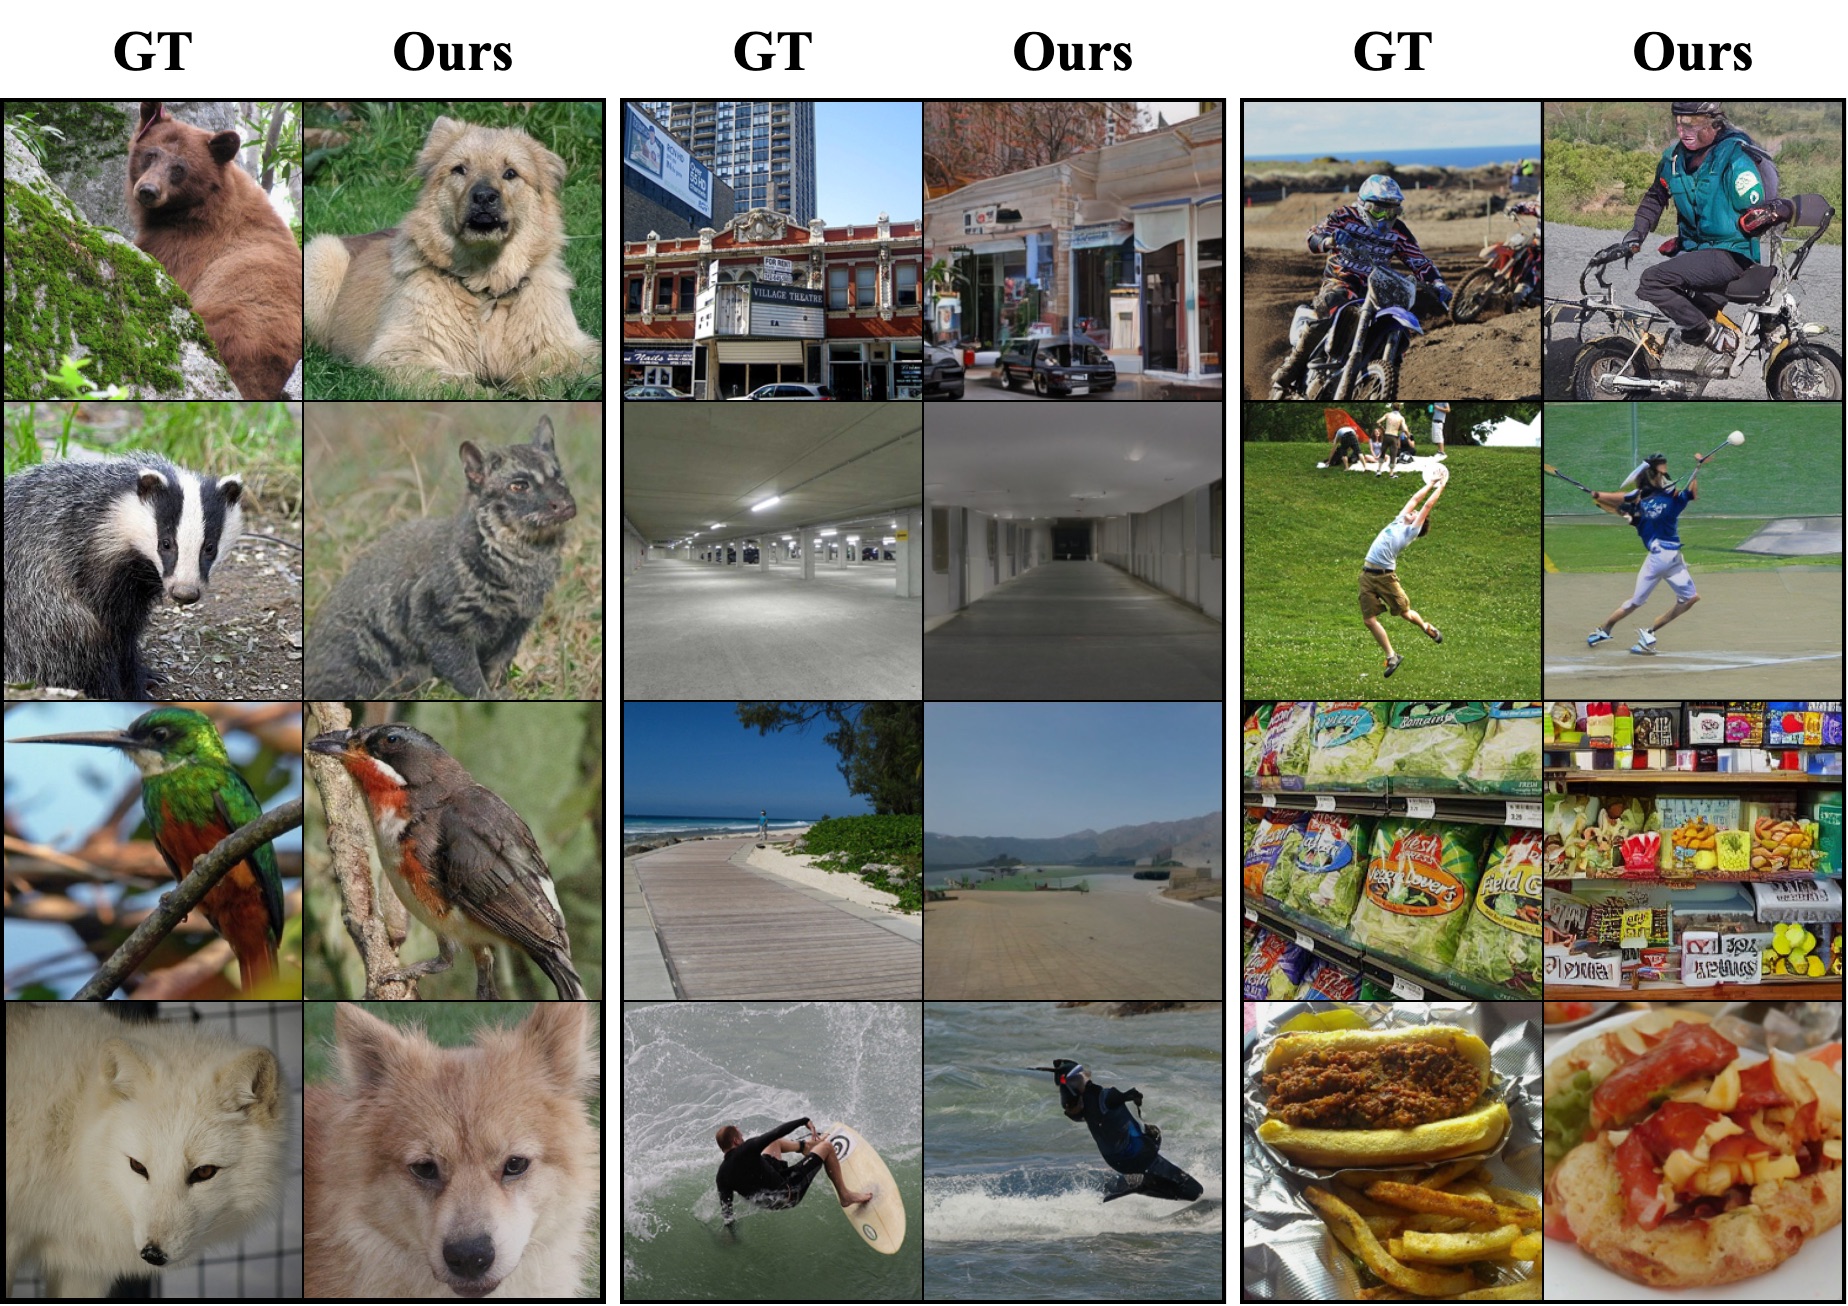
在 BOLD5000 上,作者用同一个预训练 fMRI encoder 适配不同的扫描协议和数据分布。四名被试在 50-way top-1 任务上达到约 19%--34% 的最佳准确率,Subject 1 的 Figure 8 结果给出 34% 准确率与 1.2 的 FID。
来源:原论文 Figure 8,PDF 第 8 页;原图直接提取,未重绘或添加标注。
作者还展示了 Figure 9 中的"额外视觉特征":当刺激是河流或蓝天时,模型会产生相应自然场景;当刺激是房屋时,室内装饰也可能被重建。作者把其中部分额外细节解释为被试在观看场景时形成的想象内容。这个解释有启发性,但图像生成先验、场景共现关系和数据集偏差也能造成类似结果,因此不能仅凭这些例子断言模型读取了独立的视觉想象。
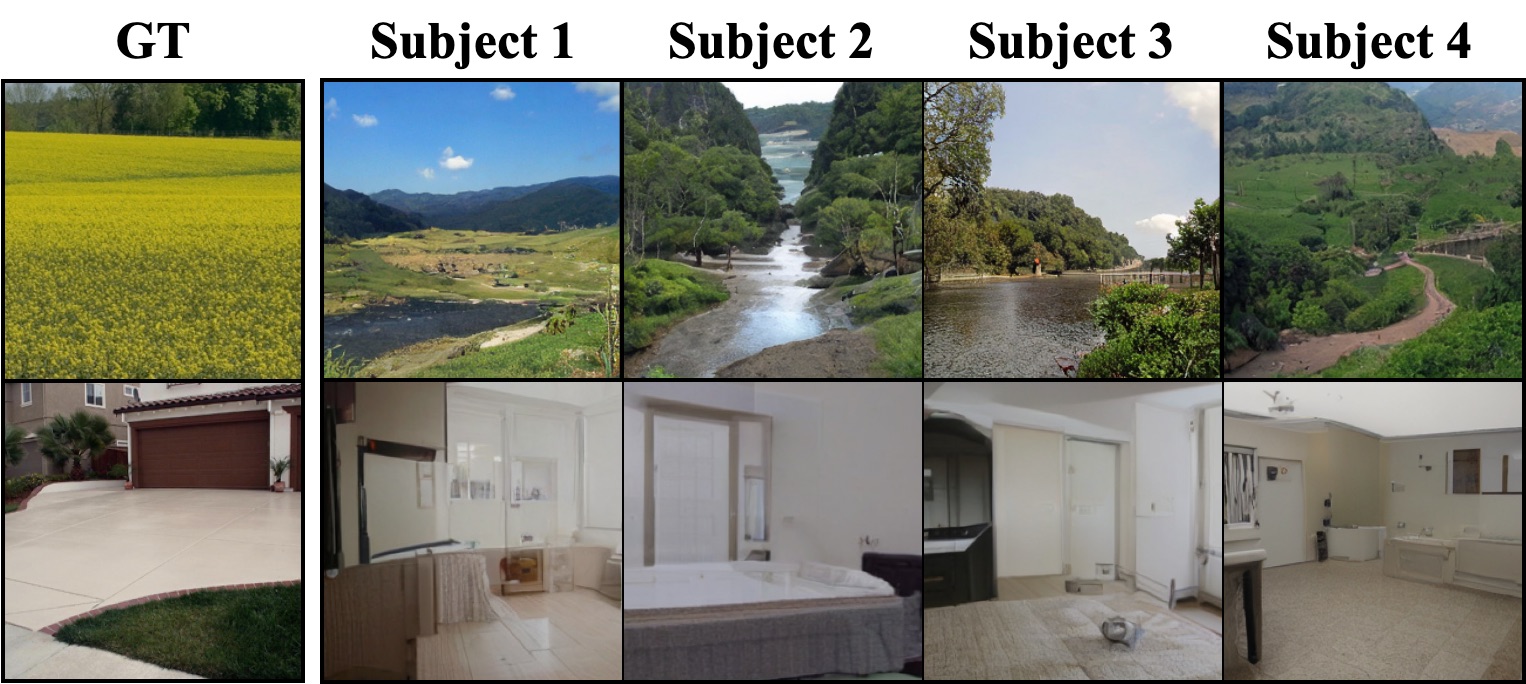
来源:原论文 Figure 9,PDF 第 8 页;原图直接提取,未重绘或添加标注。
5. 消融实验告诉了我们什么?
消融结果比单点最好成绩更能解释方法为什么有效。
- 没有 SC-MBM 预训练时,完整 303M 模型的 50-way 识别率从约 23.9% 降到约 2.6%,更小的 25M encoder 也只有约 3.4%。作者报告这两种设置甚至难以生成有意义的图像,说明大规模 fMRI 预训练是关键组件,而不是装饰性的初始化。
- embedding 维度存在折中。从 32 增加到 1024 时,识别性能整体提升;继续增加到 1280 后反而下降,说明表示容量并非越大越好。
- mask ratio 为 0.75 的设置较好。0.65 附近的准确率接近完整模型,但 0.75 在作者的设置下达到最高平均性能,同时由于 encoder 只处理未遮挡 patch,也能节约内存。
- 双重条件优于单一路径。只使用 cross-attention 的模型约为 15.6%,只微调 encoder 而冻结相关 attention 的模型约为 13.76%,完整的 cross-attention + time conditioning 为 23.9%。这支持"条件注入位置和微调方式都重要"的结论。
- ImageNet label-conditioned LDM 优于 text-conditioned 和 layout-conditioned 预训练 LDM。在配对样本有限时,类别条件的 latent 空间更容易被 fMRI 表示适配;这不等于 ImageNet LDM 在所有脑解码任务中都更好。
6. 证据是否支持作者的解释?
总体上,证据支持"SC-MBM 提供了有用的 fMRI 表示、DC-LDM 改善了语义一致性和生成质量"这一工程结论。原因是论文同时给出了无预训练对照、embedding 维度和 mask ratio 消融、单条件对照、不同预训练 LDM 对照、GOD 主实验和 BOLD5000 复现。
但更强的神经科学结论仍然没有被完全证明。第一,主实验是个体内微调,并没有真正解决 Figure 2 所展示的跨被试 ROI 差异。第二,LDM 的视觉先验很强,生成图像中的常见类别、纹理和布局不一定全部由 fMRI 提供。第三,50-way/100-way 语义分类和 FID 衡量的是生成结果,不能替代对原始脑信号可预测性的评估。第四,BOLD5000 的适配仍使用了测试被试的配对训练数据,不能当作零样本跨被试泛化。
7. 贡献、局限与可复现性
贡献
- 用大规模无标签 fMRI 预训练缓解了配对脑图像数据稀缺问题。
- 将稀疏编码动机、掩码建模和大容量 fMRI latent 结合起来。
- 通过 cross-attention 与 time conditioning 的双重条件,把脑表示接入 latent diffusion。
- 在 GOD 和 BOLD5000 上同时报告定性、语义识别、FID、采样一致性与消融结果。
局限
论文自己指出,MinD-Vis 缺少强像素级约束,也缺少对 SC-MBM 特征的充分生物学解释。除此之外,还应注意:被试人数和跨被试设置有限;配对数据规模仍然不大;图像生成先验可能掩盖脑信号不足;FID 受测试集规模影响;随机采样带来的多样性没有和真实被试的主观报告做对齐。论文主文也没有完整给出硬件、批大小、所有随机种子和训练时间,这会增加复现成本。
可复现性检查清单
- 固定 GOD 的 1,200/50 图像划分和类别不重叠规则。
- 明确是同一被试内训练测试,还是跨被试测试;不能把个体内结果写成跨被试能力。
- 记录 Stage A 预训练数据组成、patch size、mask ratio、embedding dimension 和 epoch。
- 固定 LDM 预训练条件、PLMS steps、随机种子和采样次数。
- 同时报告语义识别、FID、单次采样和多次采样结果,不只展示视觉上最好的样本。
- 将生成先验贡献与脑信号贡献分开评估,例如加入无脑条件、打乱脑信号或脑信号置换对照。
8. 对脑解码研究的启发
MinD-Vis 对"基模 + 微调"的启发很直接:预训练模型最好学习与下游信号结构相关的表示,而不是只把通用视觉模型当作黑箱生成器。对 fMRI 来说,SC-MBM 用无标签脑数据学习空间和上下文结构,之后再用少量配对样本完成脑---图像对齐,这条路径比从零训练一个端到端生成器更节省标注。
但下一步不应只是继续扩大生成模型。更关键的问题包括:能否在完全未见被试上直接解码?能否用跨被试对齐替代每个被试的长时间微调?生成图像中的哪些信息真正来自 fMRI,哪些来自 LDM 先验?能否使用神经预测、刺激检索、语义一致性和主观报告共同评价?这些问题也正好与后续 MindBridge、BrainCoDec 和 Duala 等跨被试工作连接起来。
总结
MinD-Vis 的核心不是"扩散模型把脑信号变成了照片",而是把视觉脑解码拆成了两个更可控的学习问题:用 SC-MBM 从大规模无标签 fMRI 中学习高容量、稀疏编码式的脑表示,再用 DC-LDM 将这一表示注入预训练 latent diffusion 的 cross-attention 和时间条件。GOD 上约 27.4% 的 50-way top-1、约 21.2% 的 100-way top-1,以及 BOLD5000 上的复现结果说明它确实提高了语义重建质量;但个体内训练、强生成先验和缺少像素级/神经保真度约束,也限定了这些数字的解释范围。
参考资料与图片来源
- Chen, Z., Qing, J., Xiang, T., Yue, W. L., & Zhou, J. H. (2023). Seeing Beyond the Brain: Conditional Diffusion Model With Sparse Masked Modeling for Vision Decoding . CVPR 2023。原论文与项目页:mind-vis.github.io。
- 文中 Figure 1--9 均来自该论文 PDF 的主文对应图,使用原图直接提取;未使用生成图片、二次转载图或人工重绘图。