这些年,我用过不少笔记和 Markdown 工具。
有的编辑体验很好,但更像一个单纯的编辑器;有的知识管理能力很强,但随着插件、配置和工作流越来越复杂,工具本身反而变成了一件需要持续维护的事情;还有越来越多的 AI 产品,可以帮我们总结、改写甚至直接修改文件,但知识又开始散落在编辑器、聊天窗口、终端、Git 仓库和各种云端服务之间。
我一直在想一个问题:
如果我的知识本来就是 Markdown 文件,为什么不能直接围绕这些文件,把写作、整理、日程、图谱、Git 和 AI 协作连接起来?
于是,我做了 Markune 。(官方站点: <www.markune.com>)
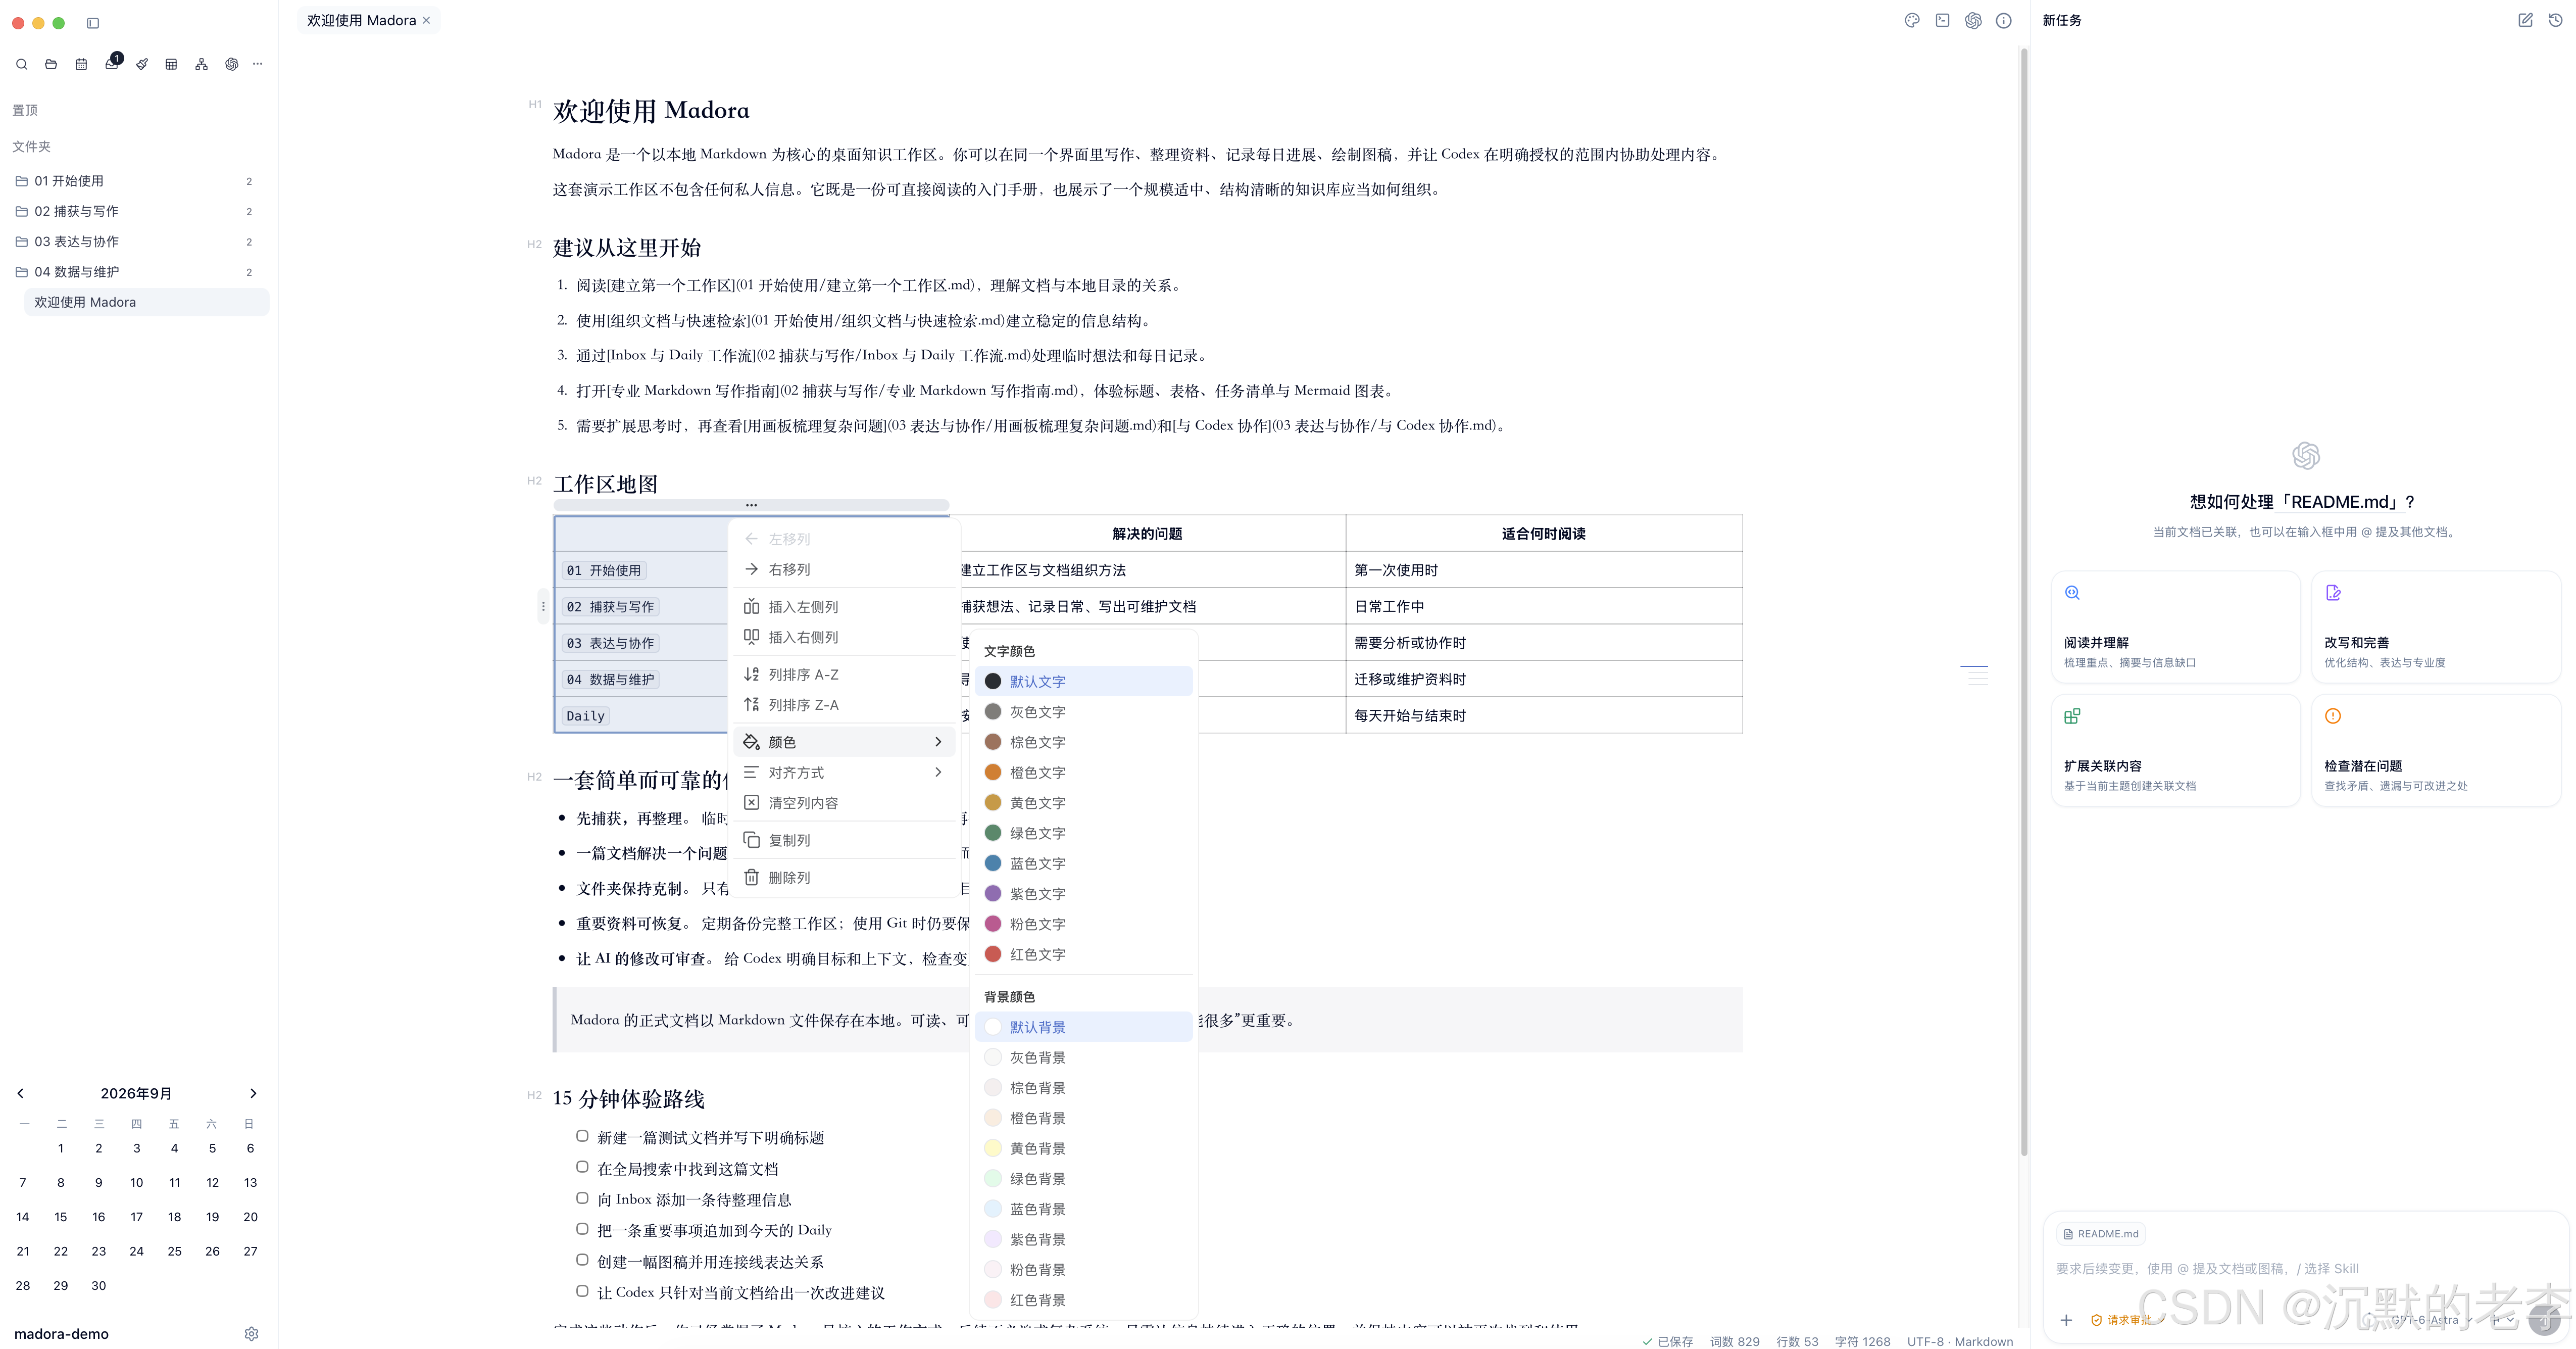
它不是一个试图发明新文档格式的笔记软件,而是一个围绕本地 Markdown 文件构建的桌面知识工作区。
截至 2026 年 9 月,Markune 已发布到 v0.2.7,支持 macOS Apple Silicon、macOS Intel 和 Windows x64,目前已经开源并免费使用,代码采用 Apache License 2.0。
01. Markune 首先解决的,是 "我的内容到底属于谁"
我越来越在意一件事情:
笔记软件可以消失,账号可以停用,商业模式可以改变,但我写下的内容不应该因此失去可读性。
所以 Markune 从一开始就选择了 Markdown-first。
你的正文就是普通的:
text
.md文件。
它们直接存在你自己选择的本地目录里,可以被 VS Code、Typora、脚本、Git,甚至任何能够读取文本文件的工具继续访问。
Markune 不要求你先把资料迁移进一个专有数据库,也没有把 Markdown 仅仅当成一个 "导出格式"。
Markdown 本身就是正文的权威格式。
Markune 自己需要的工作区状态,则放在工作区中的 .markune/ 目录里,将应用状态和你的 Markdown 正文尽量分离。
这带来一个我非常看重的特性:
退出 Markune,并不意味着退出你的知识库。
文件仍在那里。
目录仍在那里。
Git 仍然可以管理它。
其他工具仍然可以读取它。
这也是我理解的 Local-first:不是一句 "数据保存在本地" 的宣传语,而是尽可能让文件保持开放、透明和可迁移。
02. 但 Local-first 不应该等于 "只能管理一堆文件"
仅仅打开一个文件夹,其实并不足以构成一个好用的知识工作区。
所以在普通 Markdown 文件之上,Markune 又加入了一层日常工作流。
目前整个左侧工作区主要围绕:
- 笔记
- 日程
- Inbox
- 画板
- 视图
- 图谱
- Codex
展开。
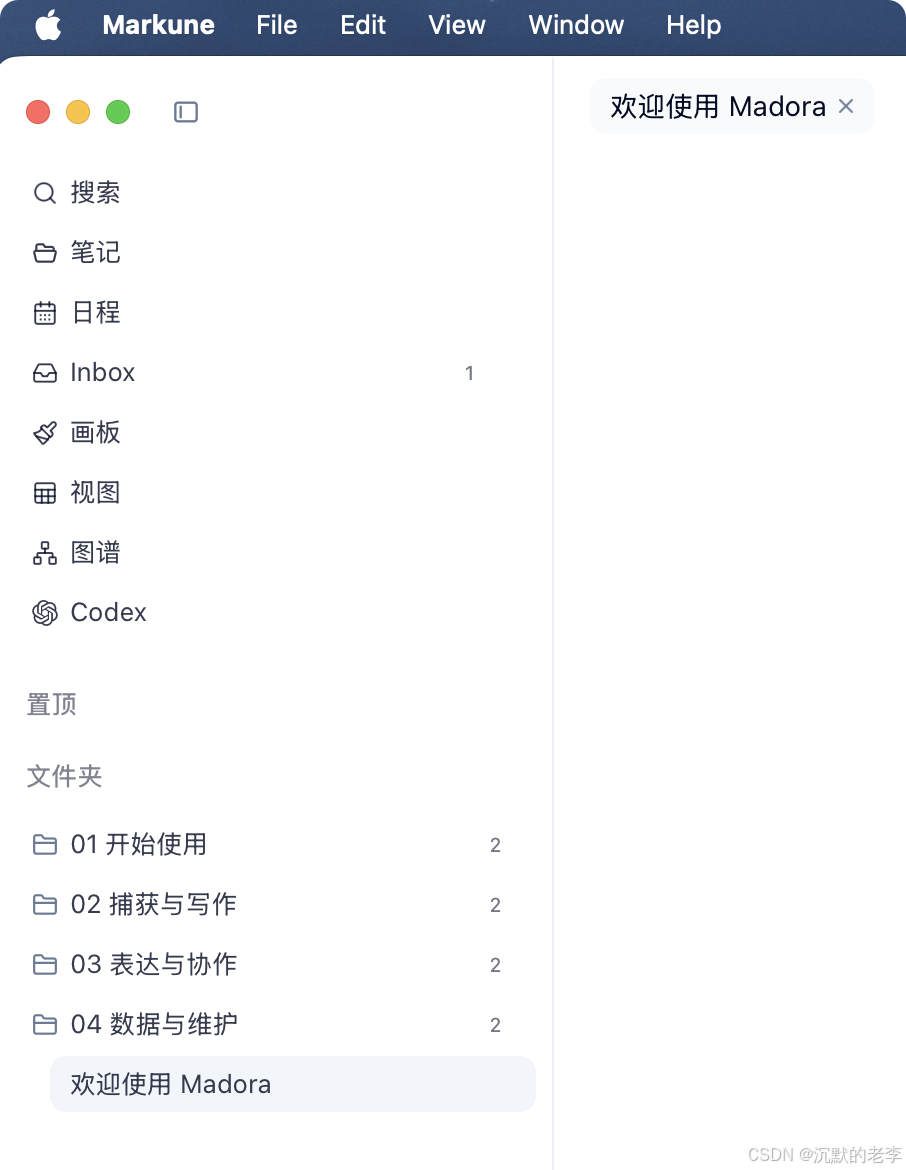
你仍然面对自己的文件,但不需要每天都在 Finder / Explorer 中手工管理它们。
Inbox:先记录,再整理
很多时候,一条信息刚出现时并不值得立即创建一篇正式笔记。
可能只是:
- 一个突然想到的问题;
- 一段代码;
- 一个稍后需要阅读的链接;
- 一个临时 TODO;
- 会议中随手写下的一句话。
Markune 提供了 Inbox 作为快速收集入口。
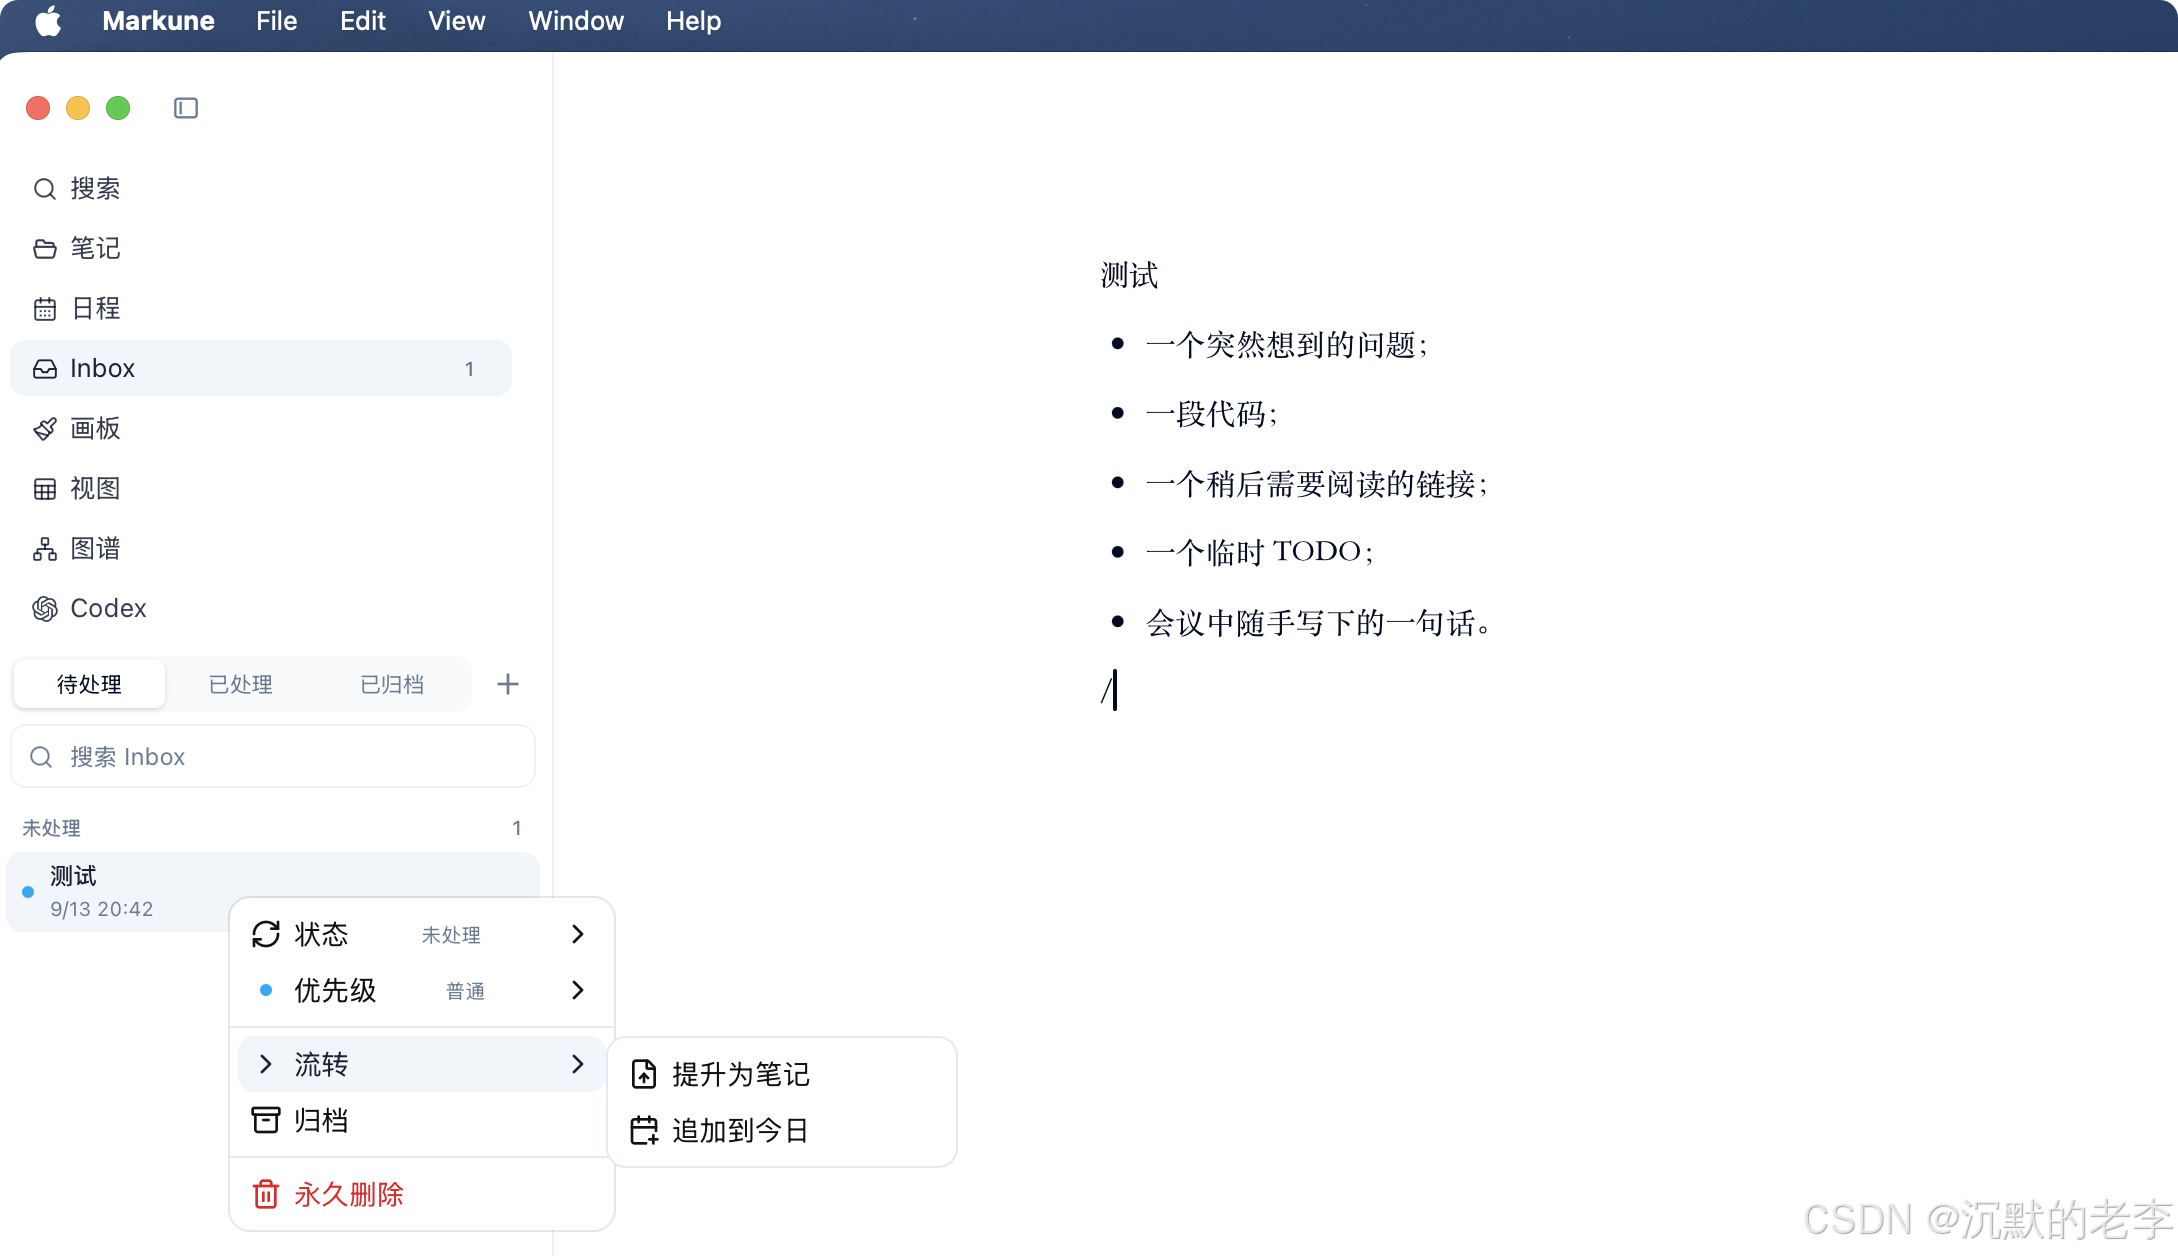
先记下来。
之后再决定是:
提升为正式笔记,还是追加到今天的 Daily。
它不是强迫你在记录之前先决定 "这个东西应该属于哪个分类",而是把:
Capture → Process → Note / Daily
变成一条连续路径。
这看起来只是一个小功能,但实际上改变了笔记软件的使用阻力。
因为很多记录最终没有发生,并不是我们没有内容可写,而是 "创建文件 → 起名字 → 选目录 → 决定分类" 这一串动作太重了。
03. Daily 不是另一个日历系统,它仍然只是 Markdown
Markune 也有 Daily,但我并没有为它重新设计一套事件数据库。
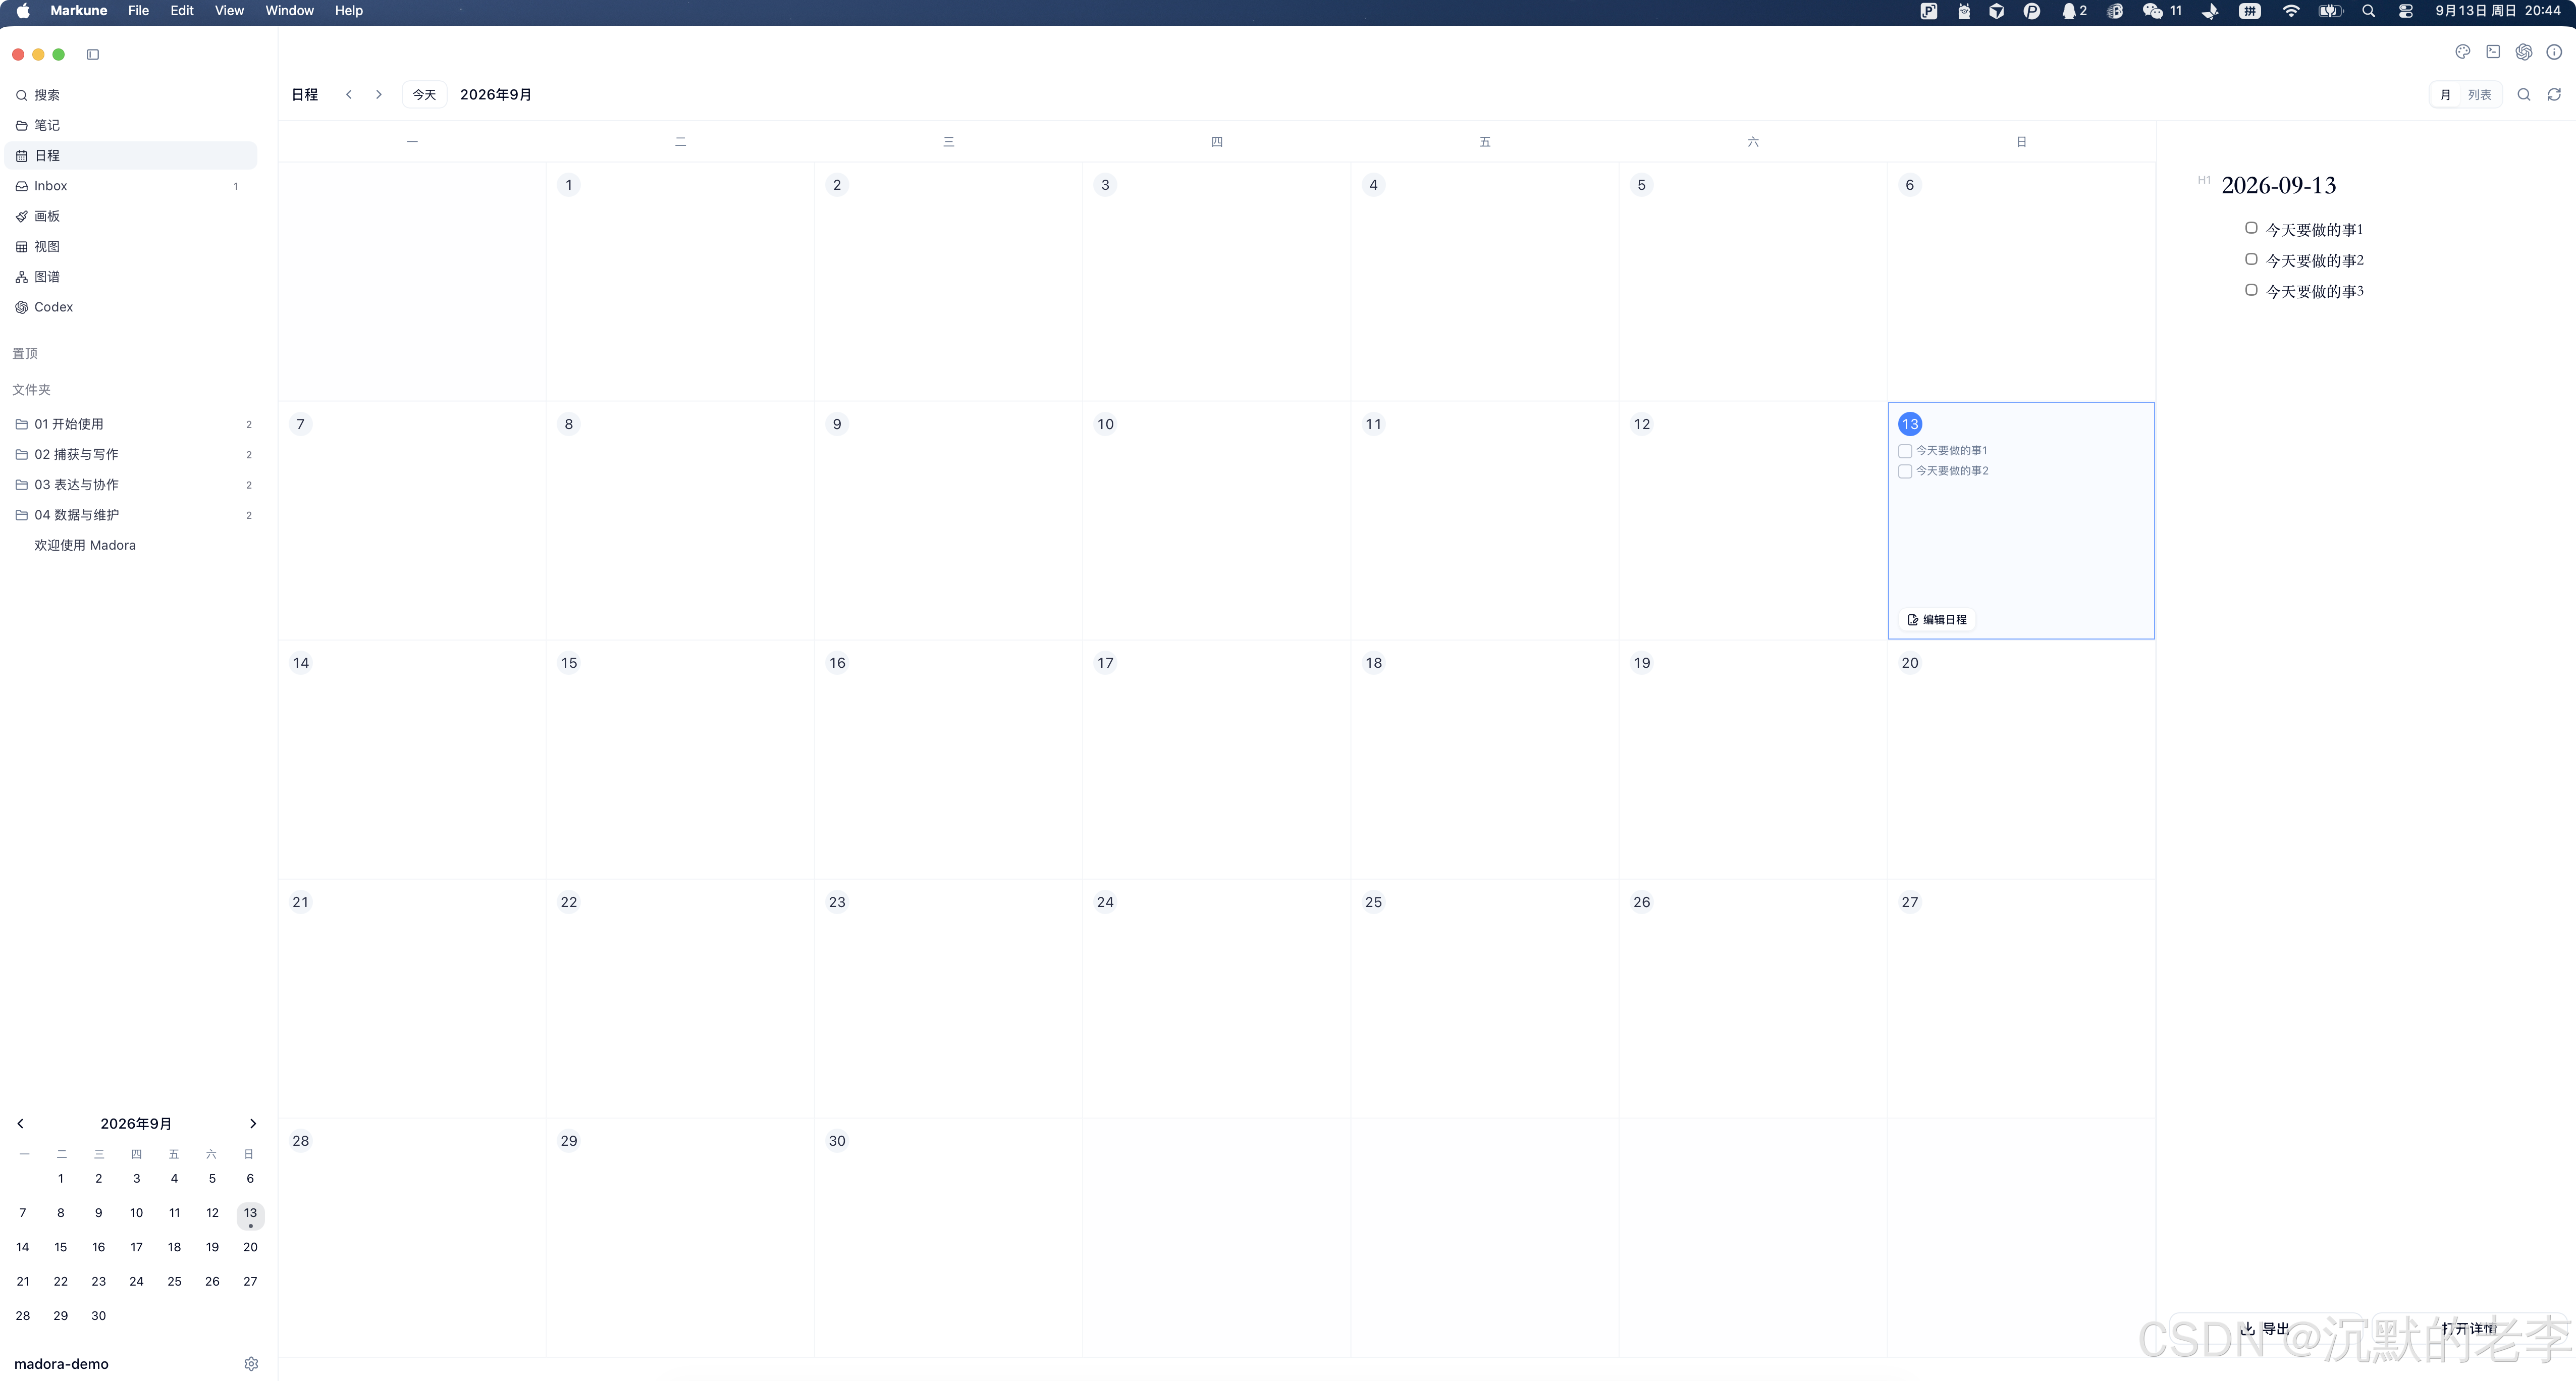
每天的 Daily 最终仍然是一篇普通 Markdown 文档,按照日期组织在工作区中。
日程页负责:
- 按月浏览;
- 查看当天摘要;
- 查看任务完成情况;
- 创建每日笔记;
- 回顾一段时间内的工作轨迹。
而真正的数据源依然是 Markdown。
这意味着,一个月后、一年后,哪怕换一个软件,你仍然能够理解:
这些文件是什么。
我希望 Markune 提供的是 "Markdown 上层的工作体验",而不是 "必须依赖 Markune 才能解释的数据"。
04. 编辑体验不能因为坚持 Markdown 而妥协
Local-first 很重要。
Markdown-first 也很重要。
但如果每天写东西时编辑体验很糟糕,这些理念最终都没有意义。
因此 Markune 没有只放一个源码编辑器。
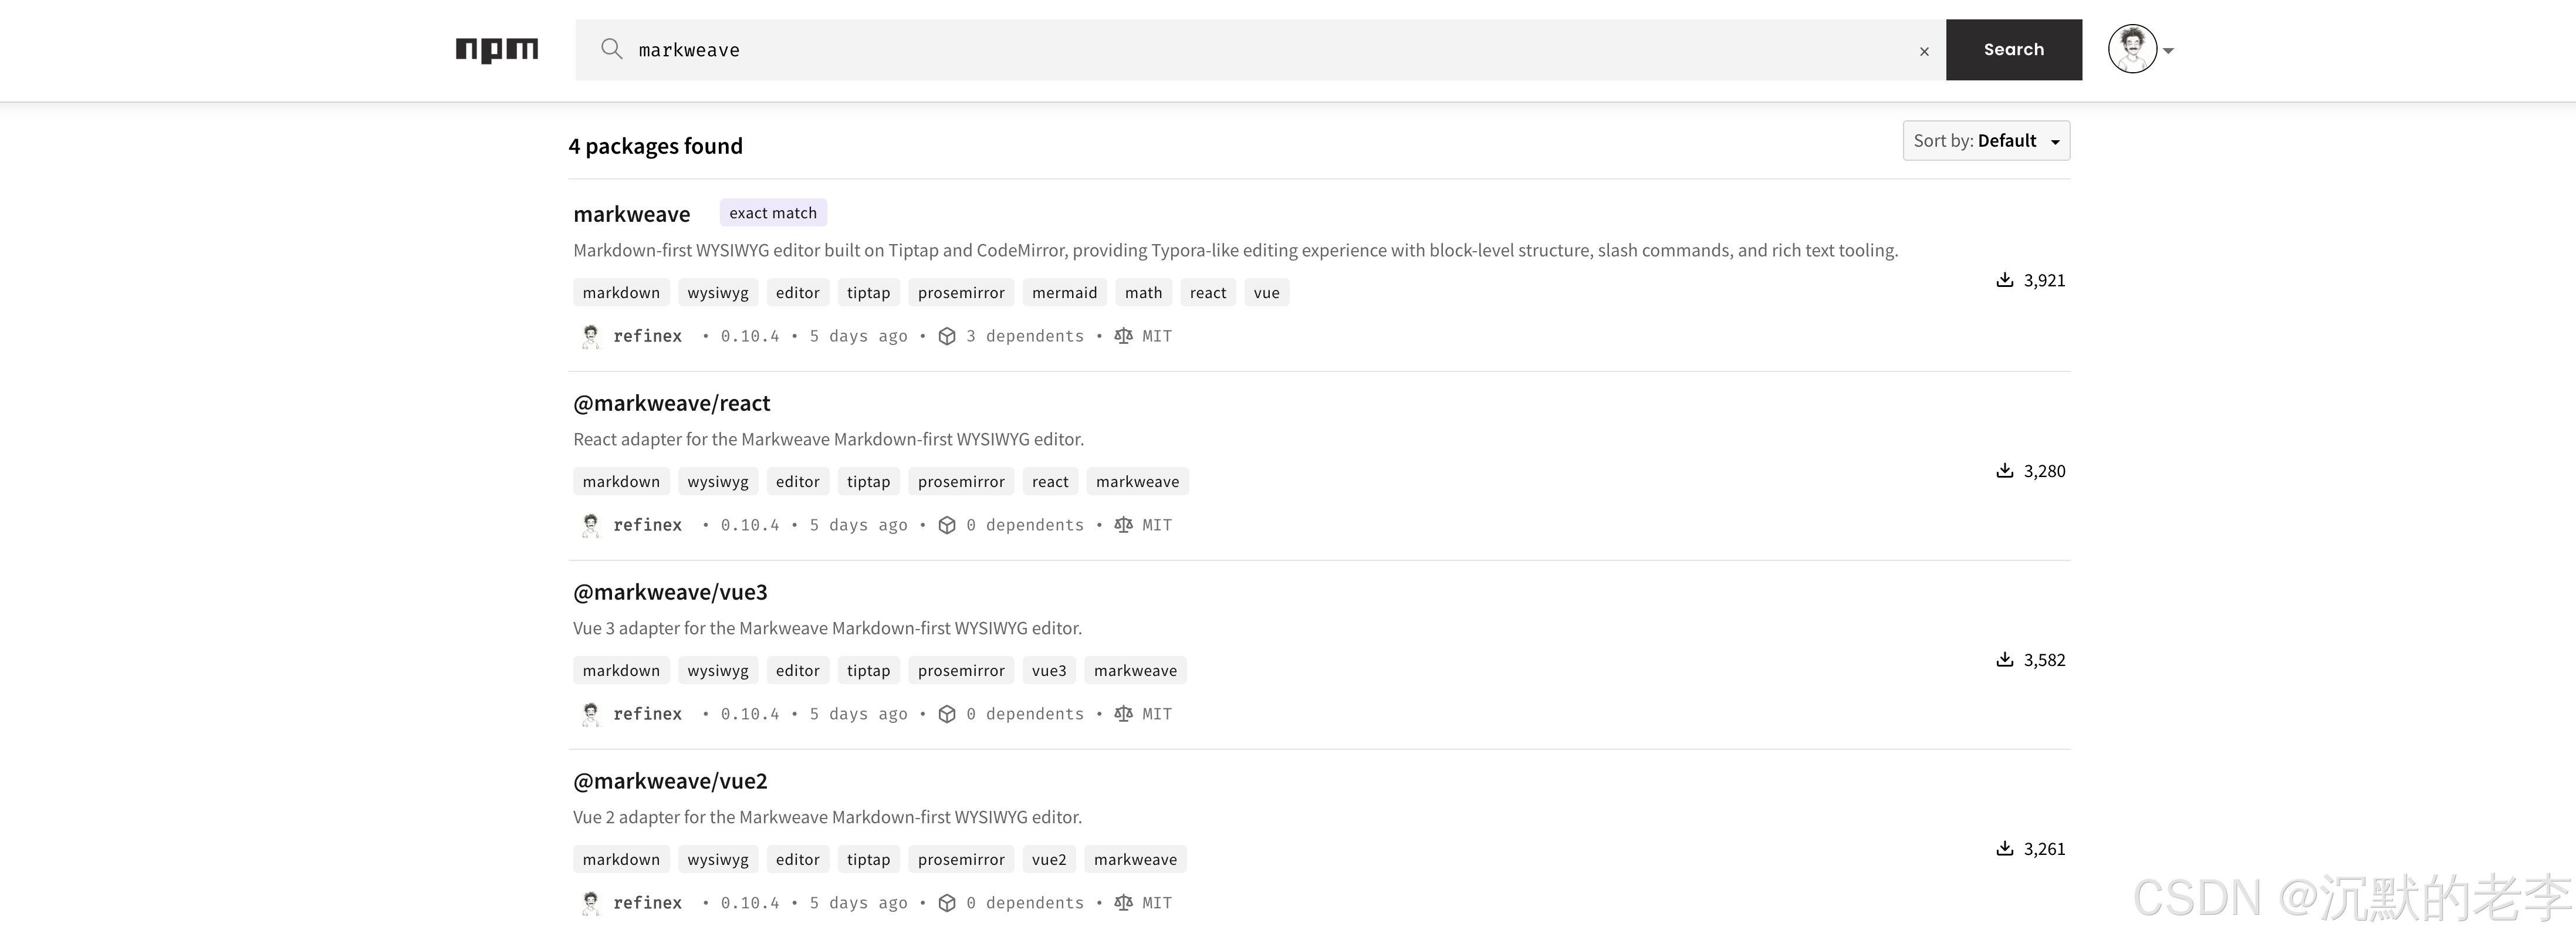
它的底层编辑器是我另一个开源项目 Markweave。
Markweave 是一个 Markdown-first 的 WYSIWYG 编辑器,底层结合 Tiptap 与 CodeMirror,目标是在保留 Markdown 作为最终数据格式的同时,让日常写作尽量接近真正的所见即所得体验。它目前已经独立提供 React、Vue 3 和 Vue 2 适配。(https://www.npmjs.com/search?q=markweave)
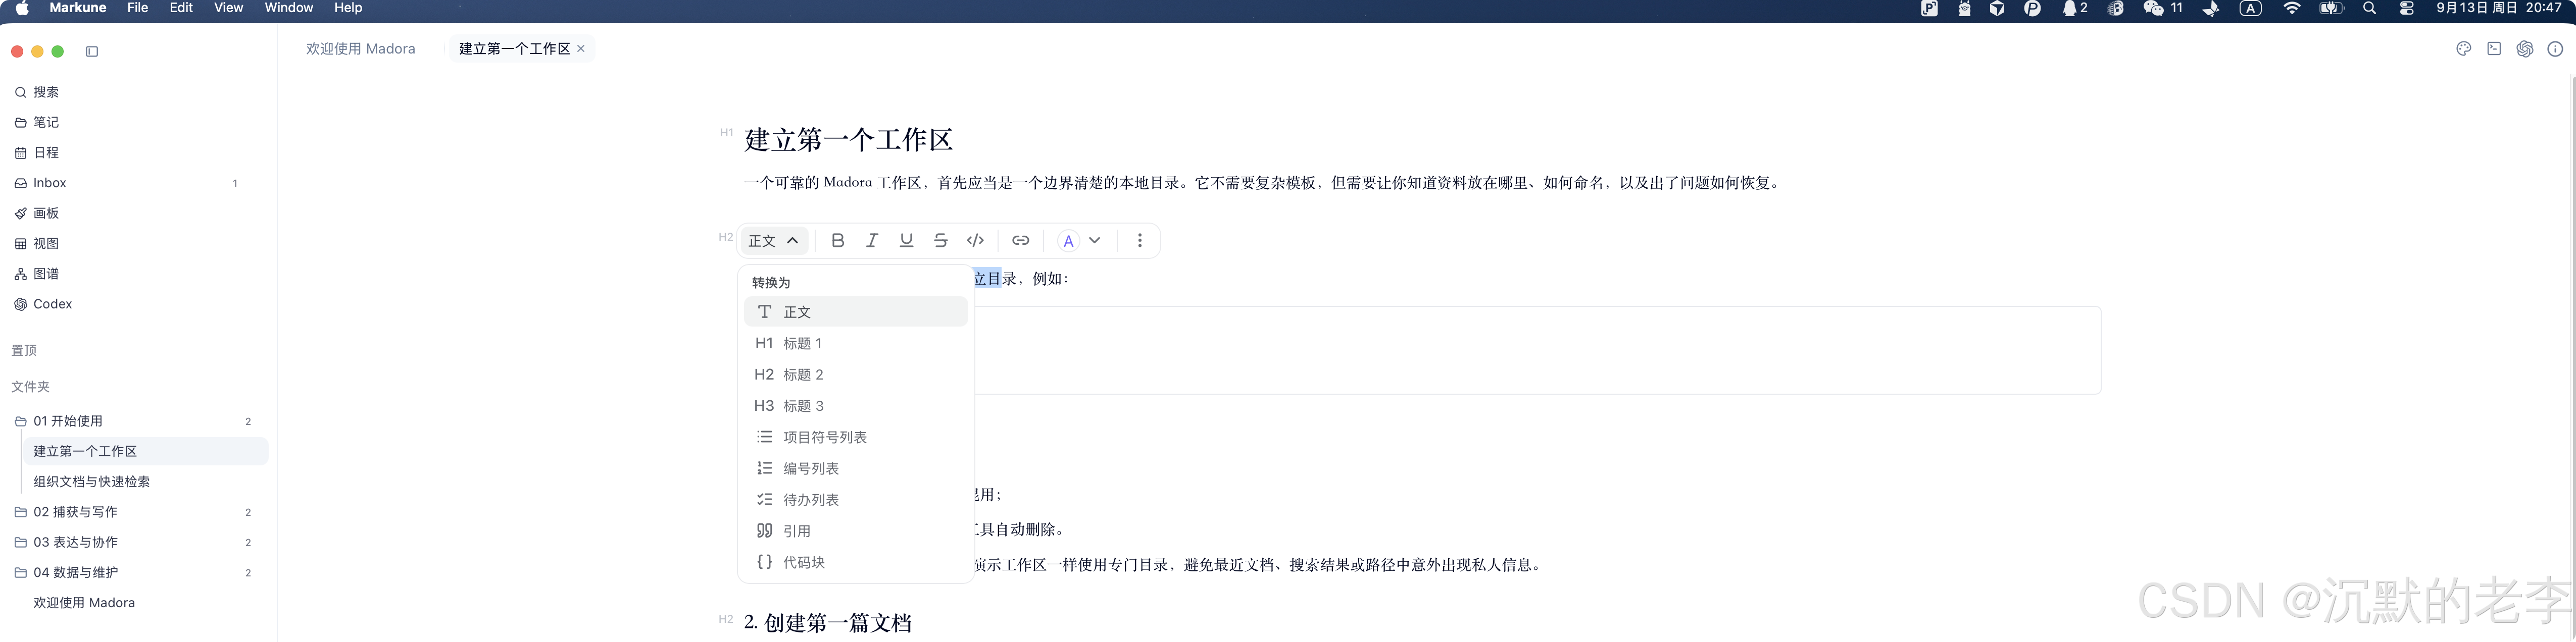
在 Markune 中,同一篇文档可以在:
可视化编辑模式
和
Markdown 源码模式
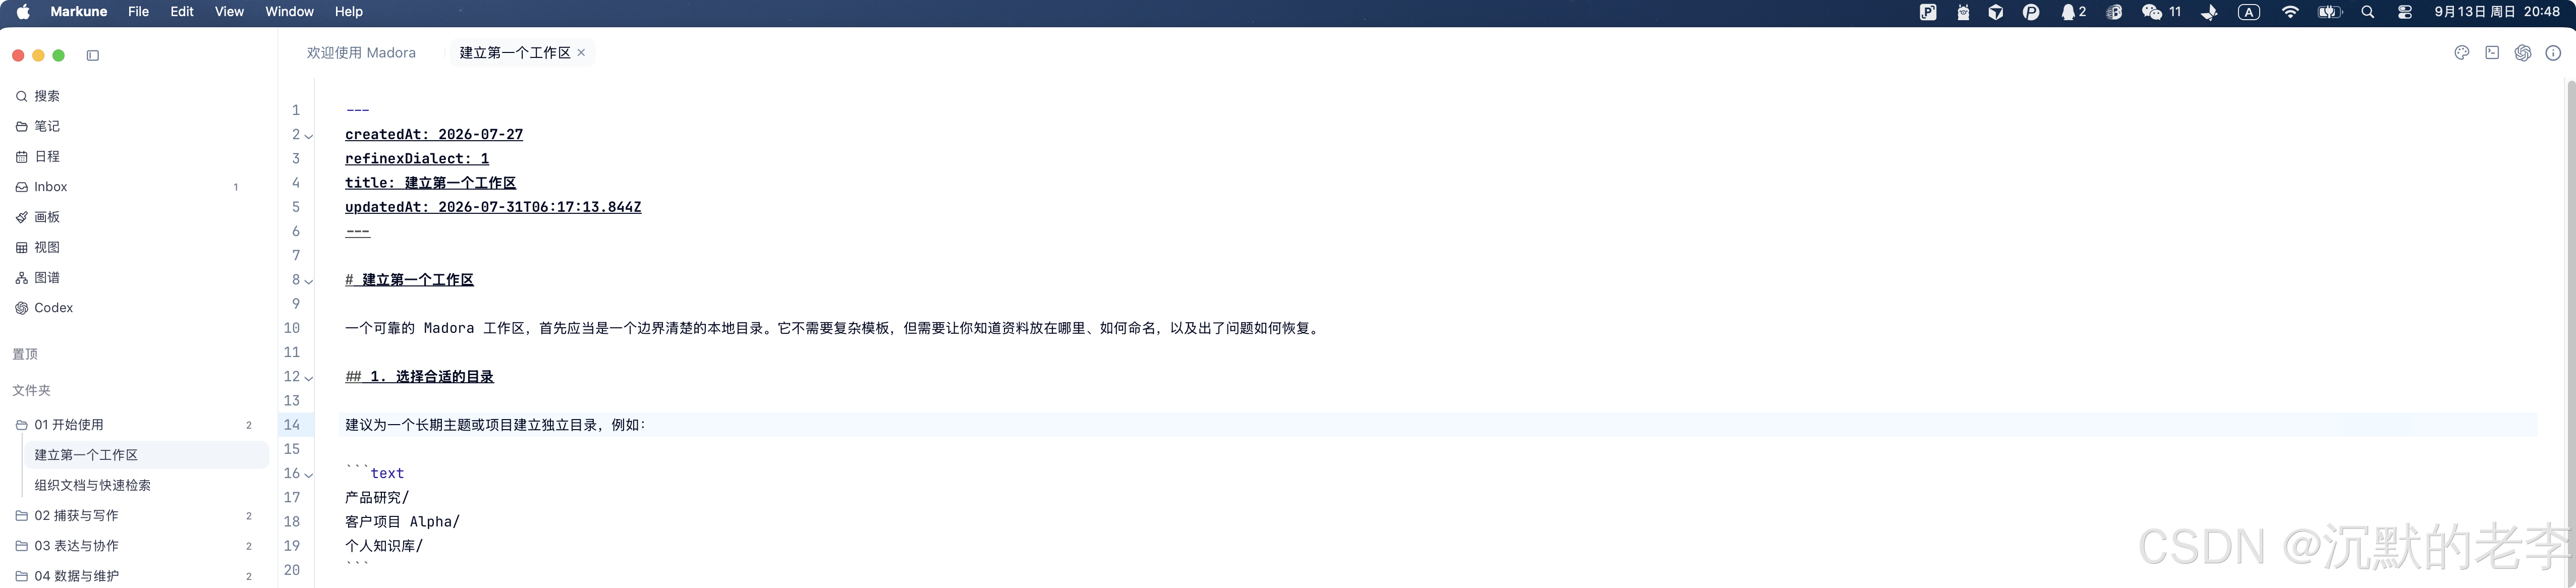
之间切换。
两个模式面对的是同一份 Markdown,而不是两个需要来回转换的副本。
日常写作可以直接使用:
- 标题;
- 有序 / 无序列表;
- Task List;
- 引用;
- 表格;
- 代码块;
- 图片与附件;
- Mermaid;
- 数学公式;
- Slash Command。
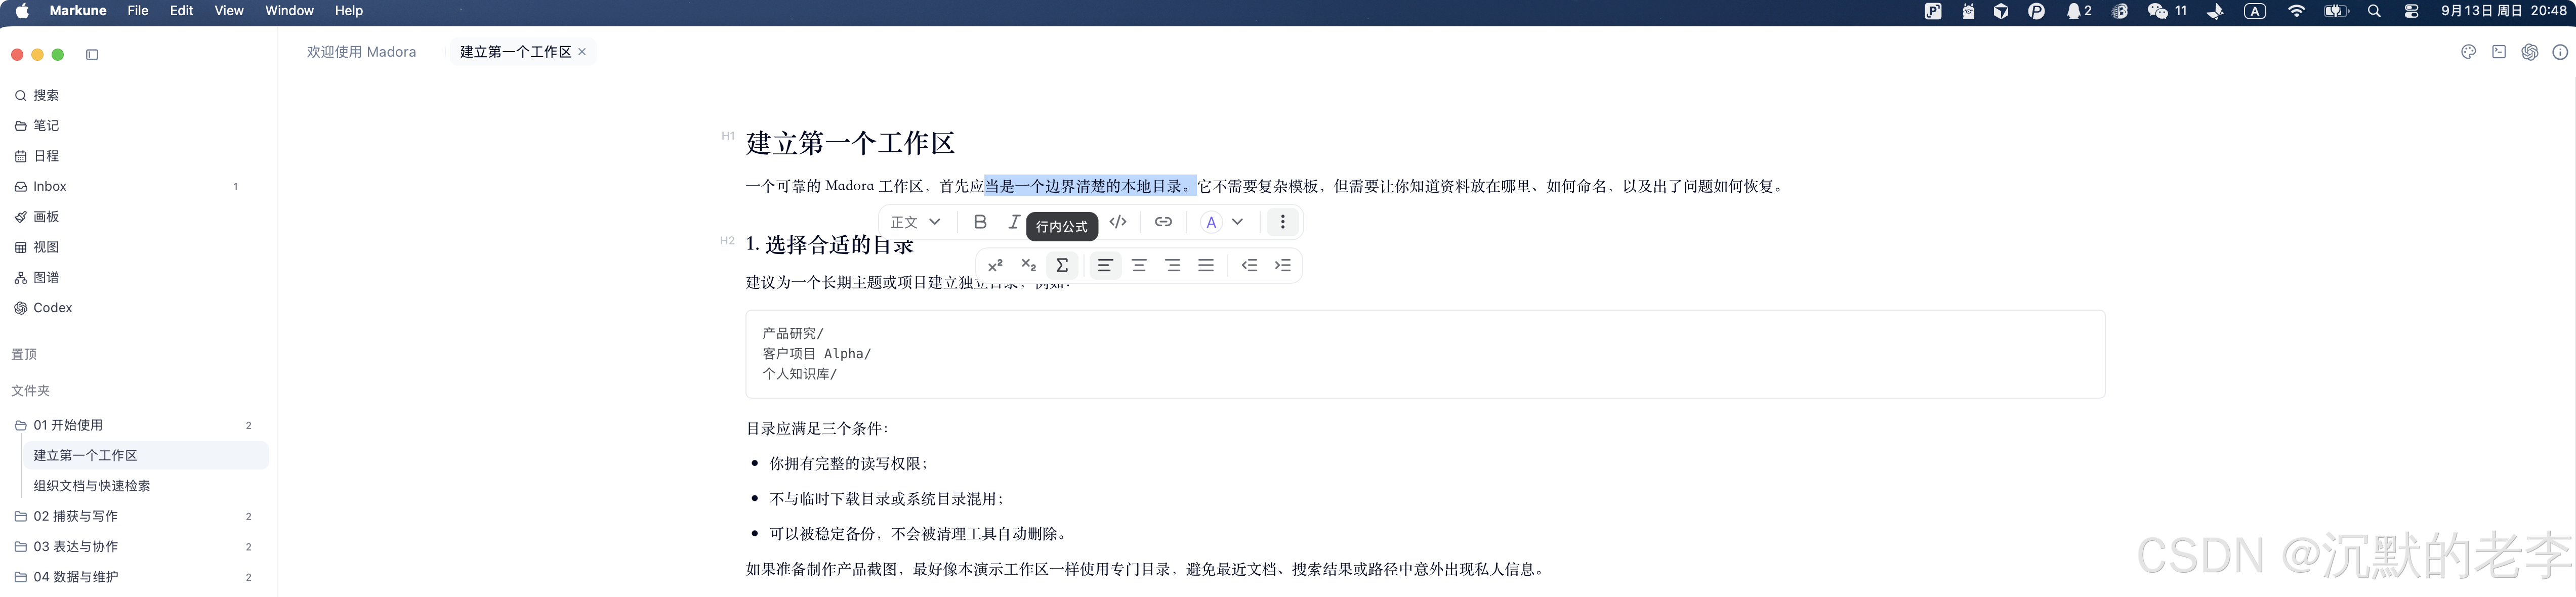
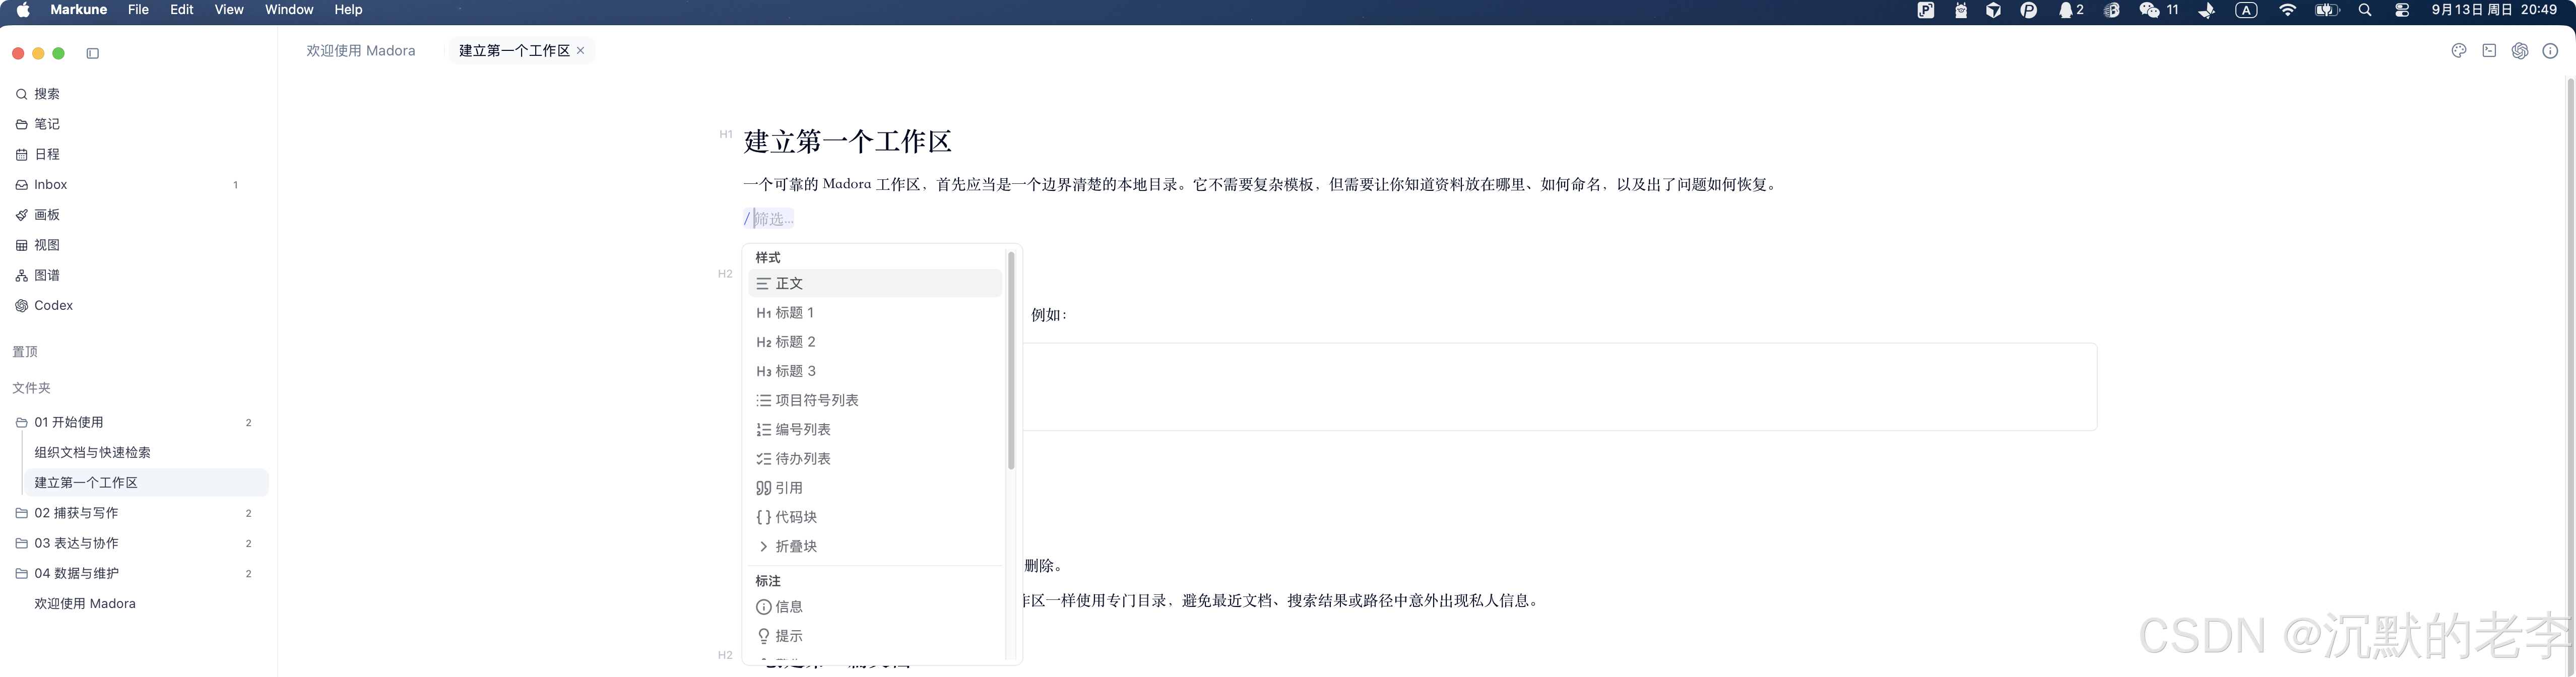
需要检查原始链接、缩进、Frontmatter 或复杂语法时,再通过 Ctrl|Cmd + / 切回源码。
这种体验其实也是我开发 Markweave 和 Markune 时一直追求的平衡:
Markdown 应该存在,但不应该时时刻刻挡在文字前面。
05. 不只是双链:把 "知识之间的关系" 真正呈现出来
Markune 也支持知识图谱,但它的图谱设计比较克制。
图谱本身是一个 只读关系视图。
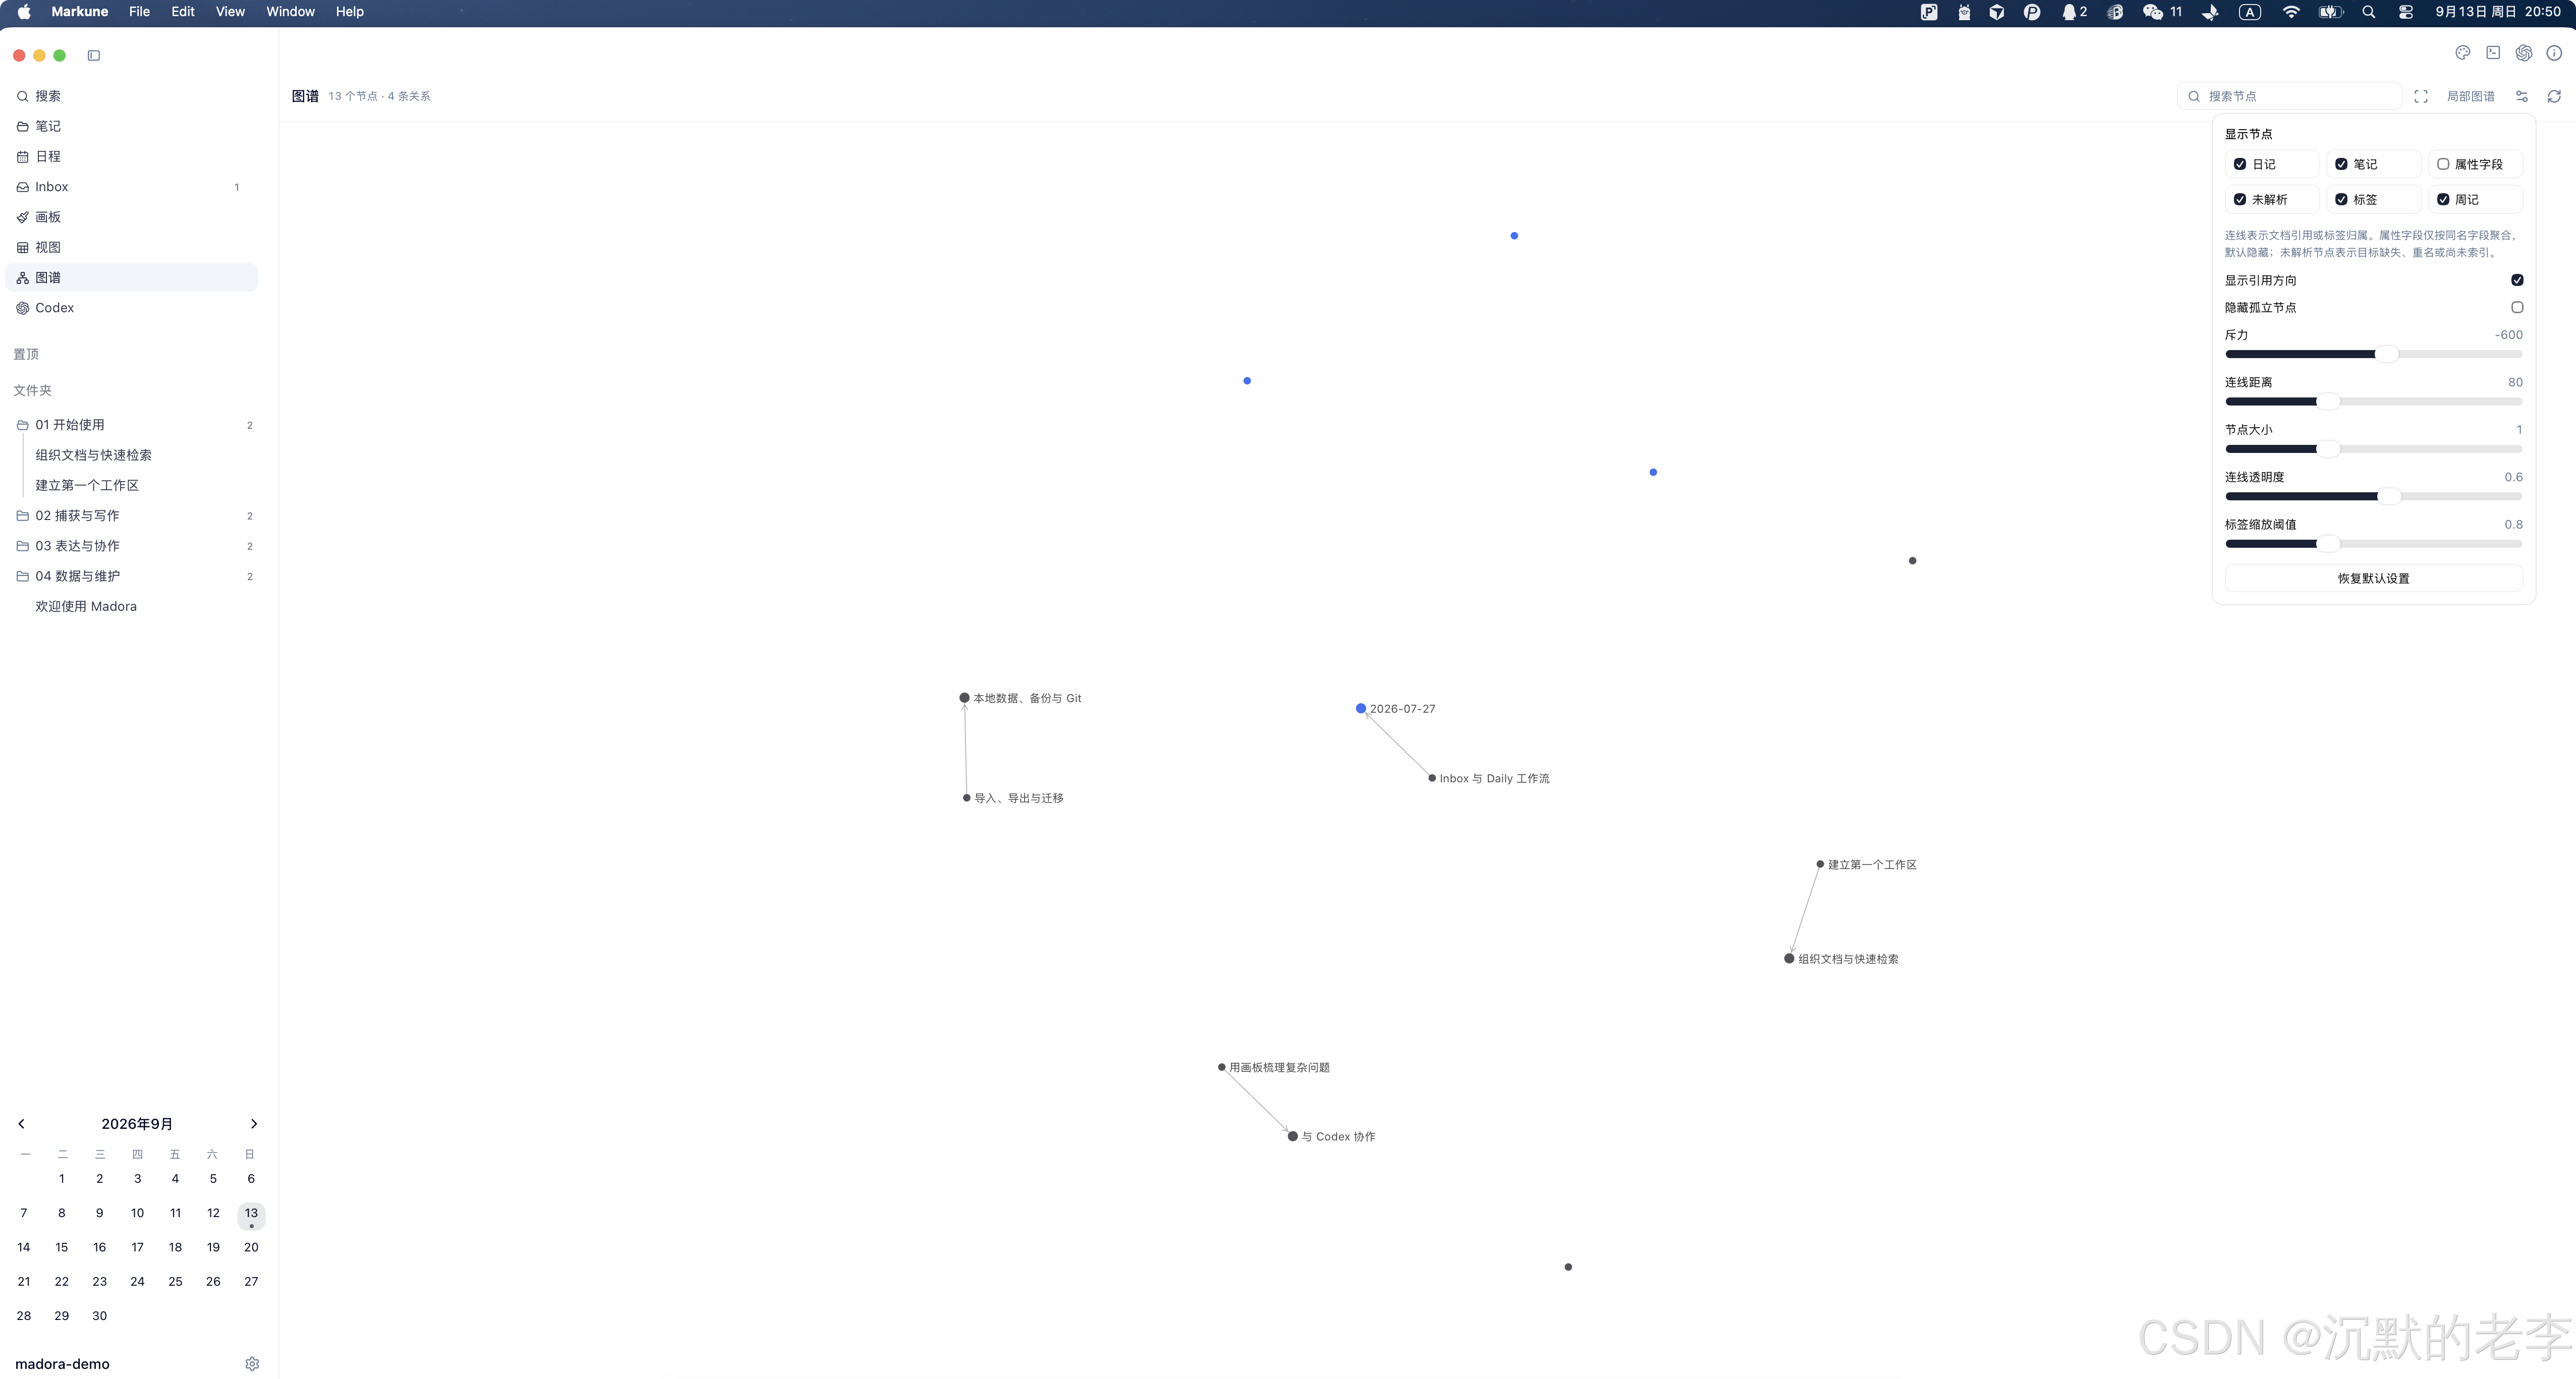
拖拽节点不会偷偷修改 Markdown,也不会为了让图谱好看而自动给文章插入链接。
关系仍然来自你的文档:
- Markdown Link;
- Wiki Link;
- 标签;
- Frontmatter;
- Daily;
- 文档属性。
想改变知识之间的关系,最终还是回到文档本身去编辑。
除了图谱之外,目前 Markune 还提供了:
- 入链;
- 出链;
- 未链接提及;
- 属性视图;
- 任务视图;
- 文档模板;
- 搜索筛选;
- 来源查看;
- PDF 研究阅读入口。
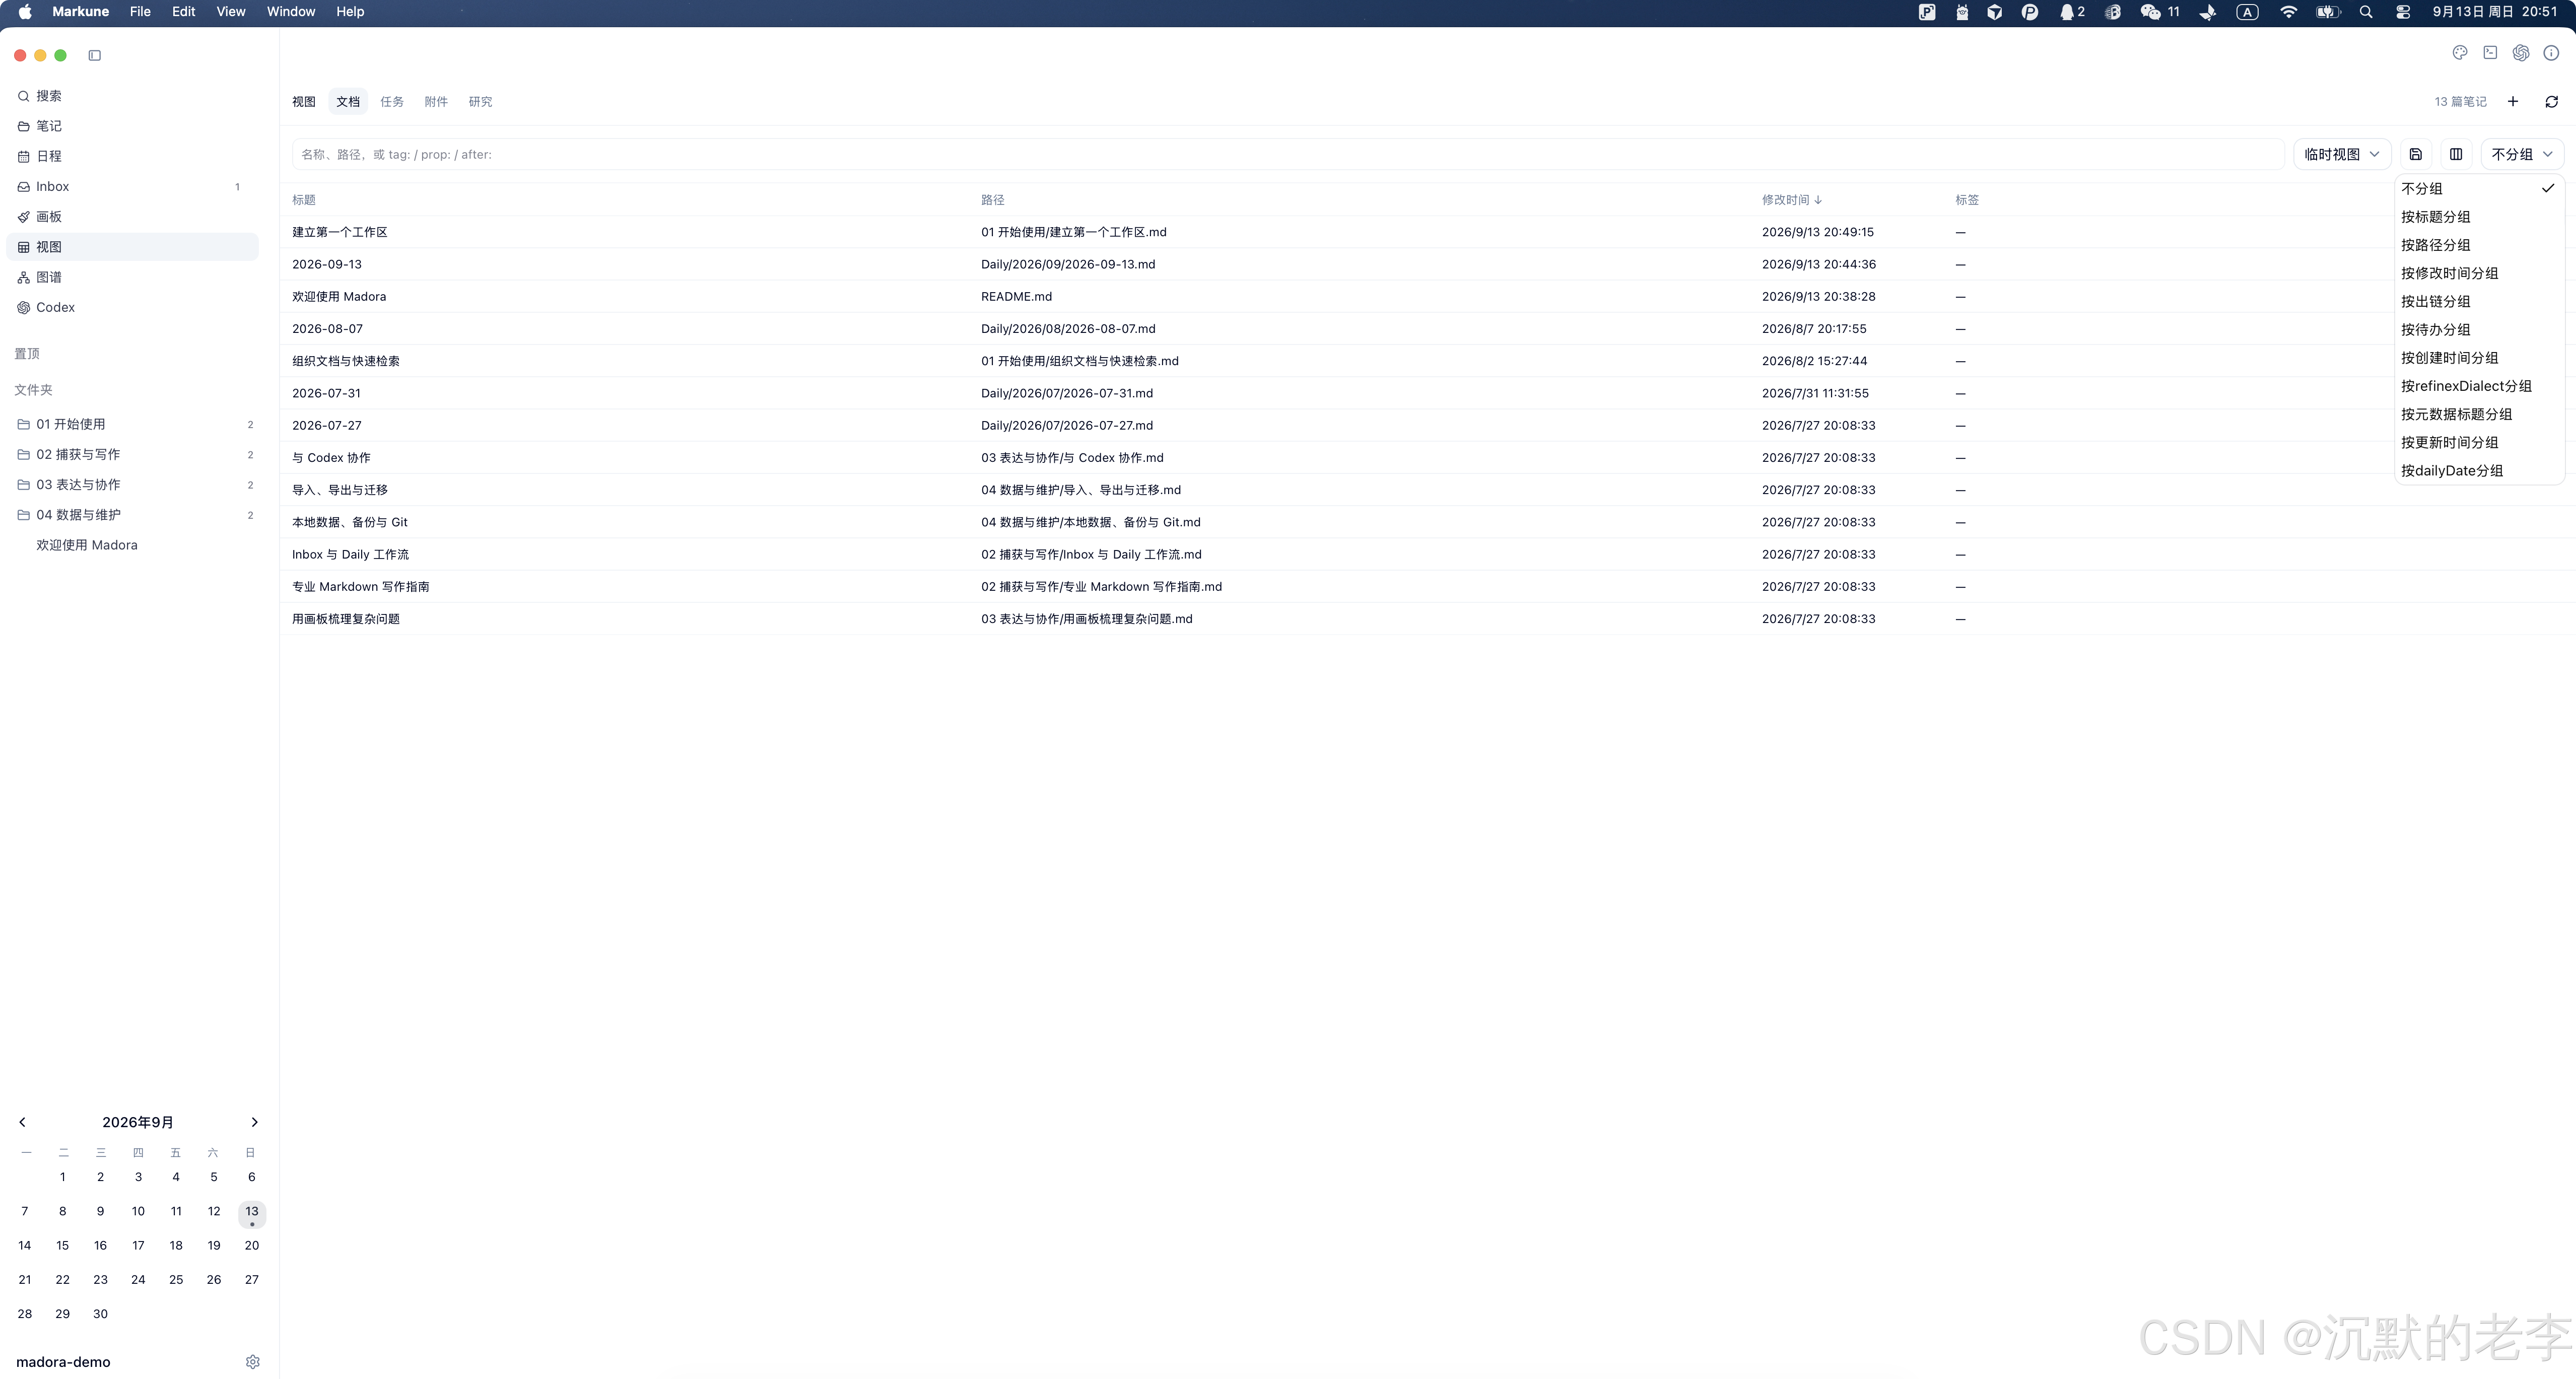
尤其是在 v0.2.5 之后,我开始更认真地完善 "研究与知识整理" 这一层,而不是只把 Markune 做成一个 Markdown 文件浏览器。
06. 白板、脑图和 Markdown,不应该是三个互不相干的世界
有些东西适合写。
有些东西适合画。
有些东西适合用层级结构拆解。
因此 Markune 的画板目前提供:
白板 + 脑图
两种主要能力。
白板适合:
- 系统架构草图;
- 流程;
- 对象关系;
- 自由表达。
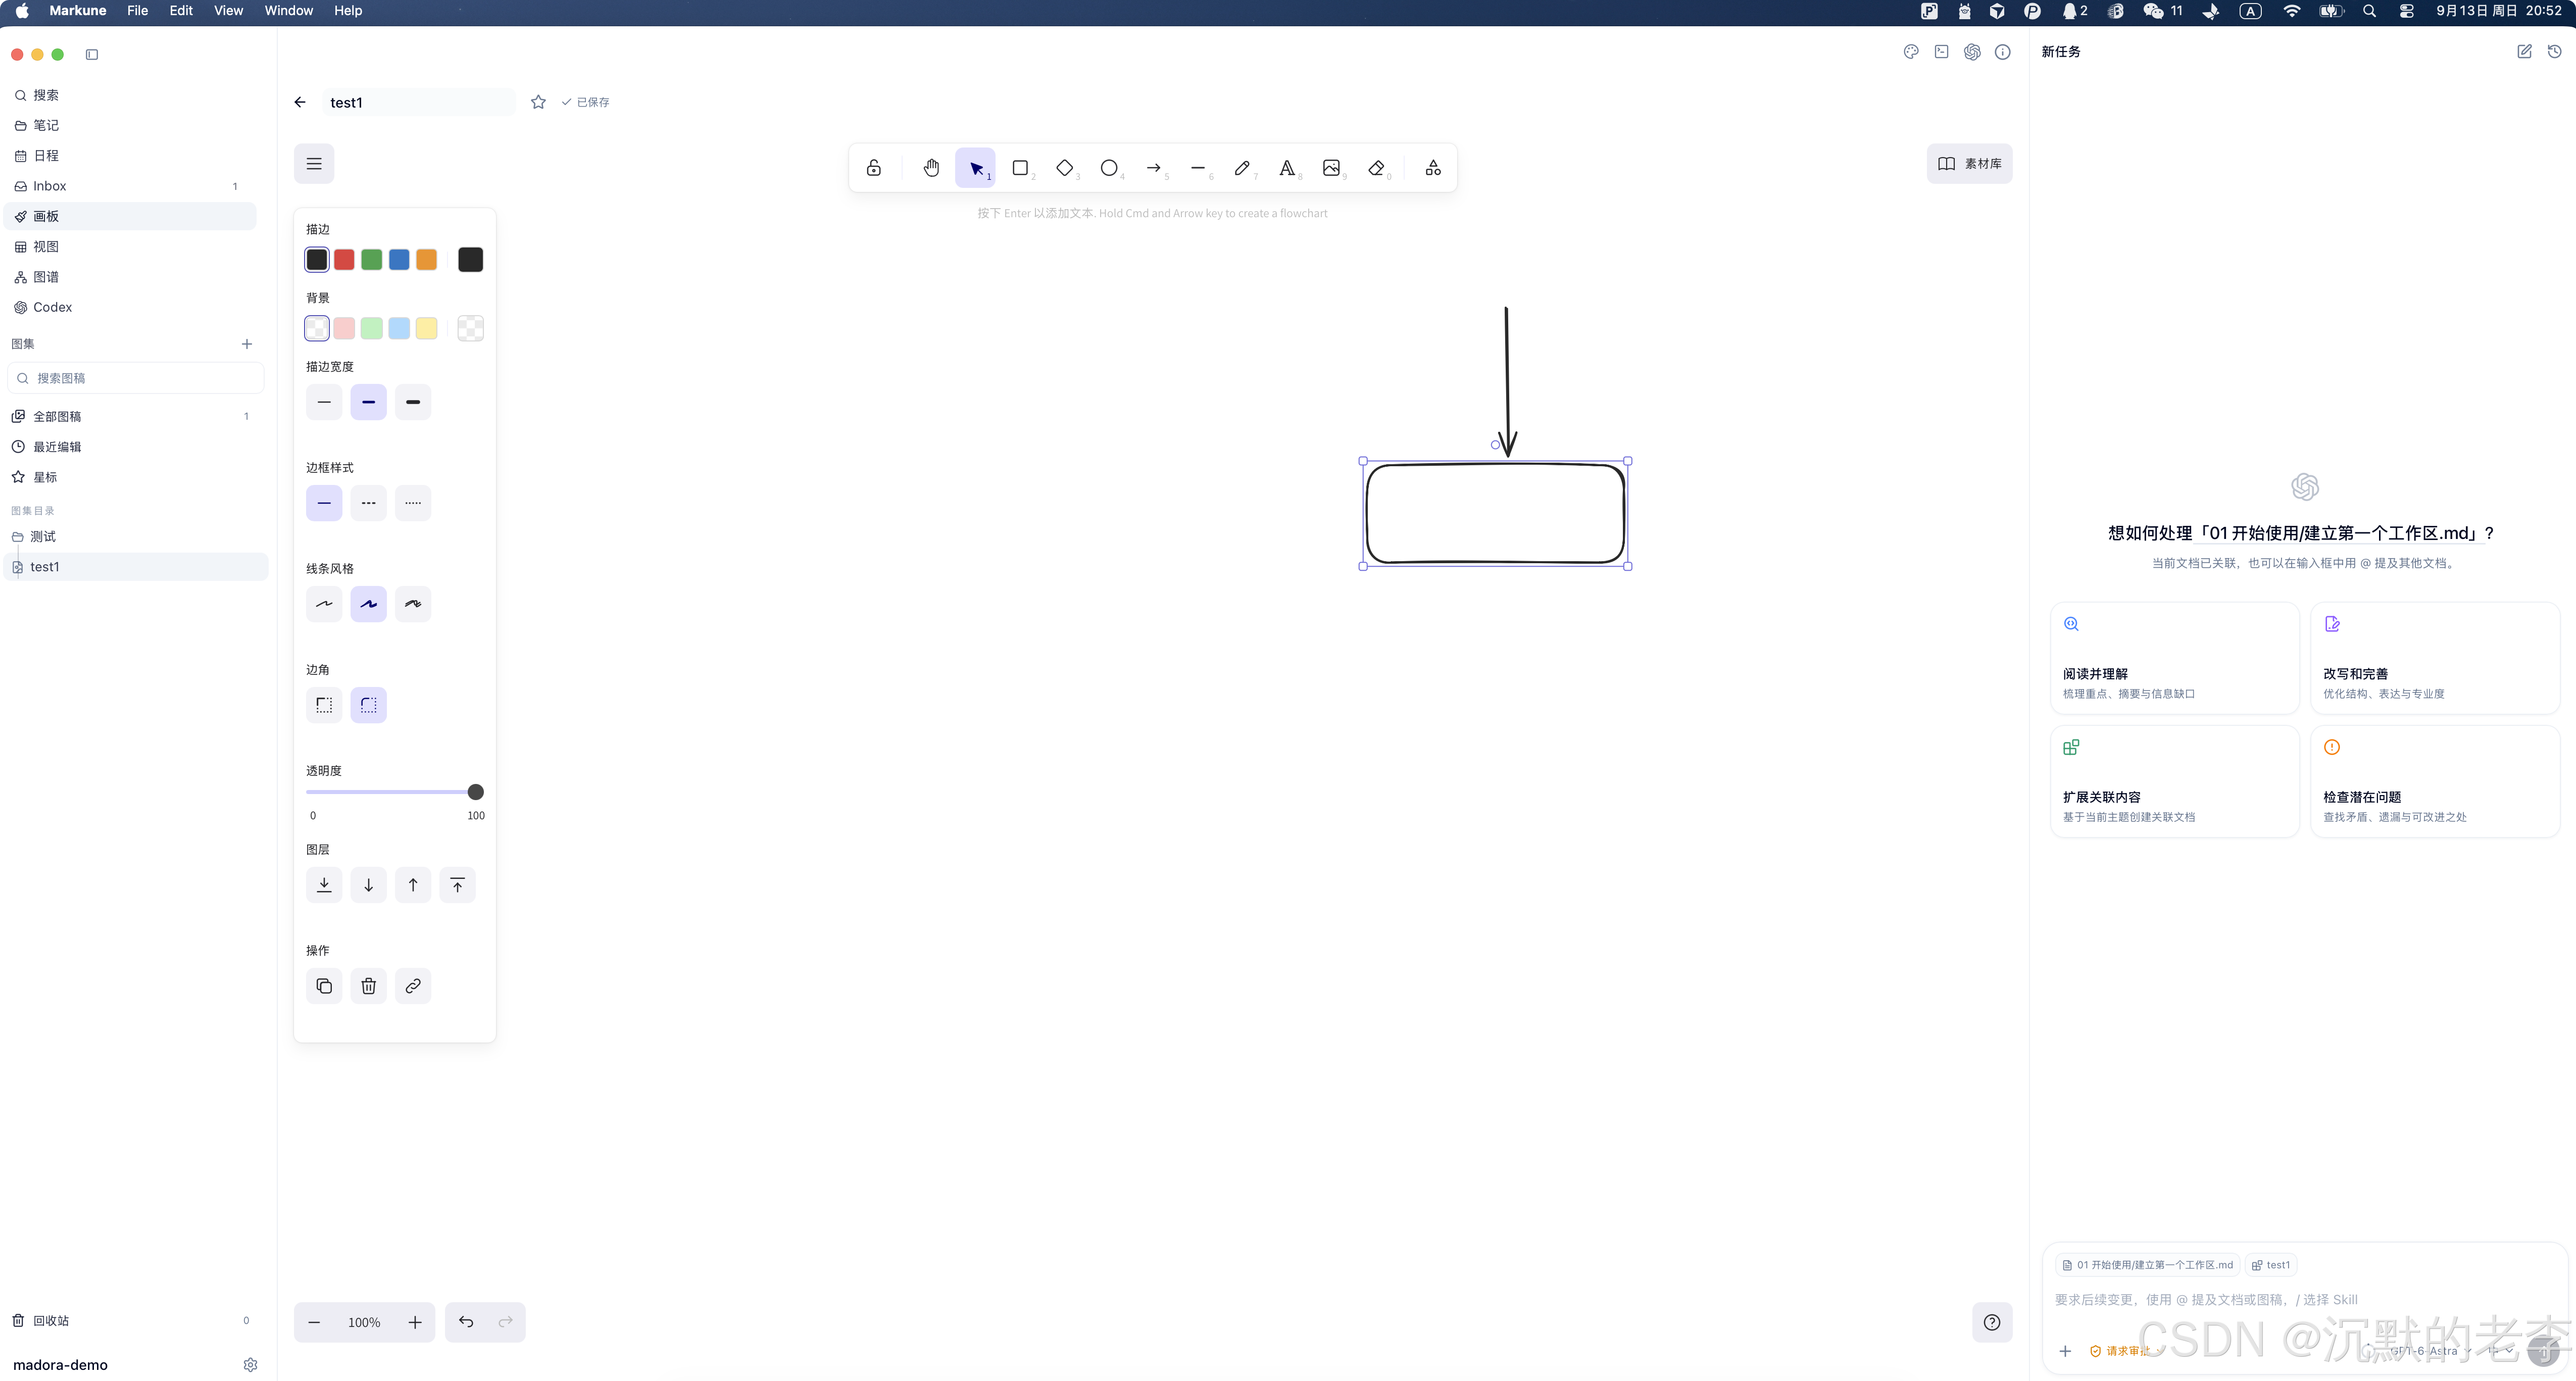
脑图更适合:
- 大纲;
- 知识拆解;
- 主题层次。
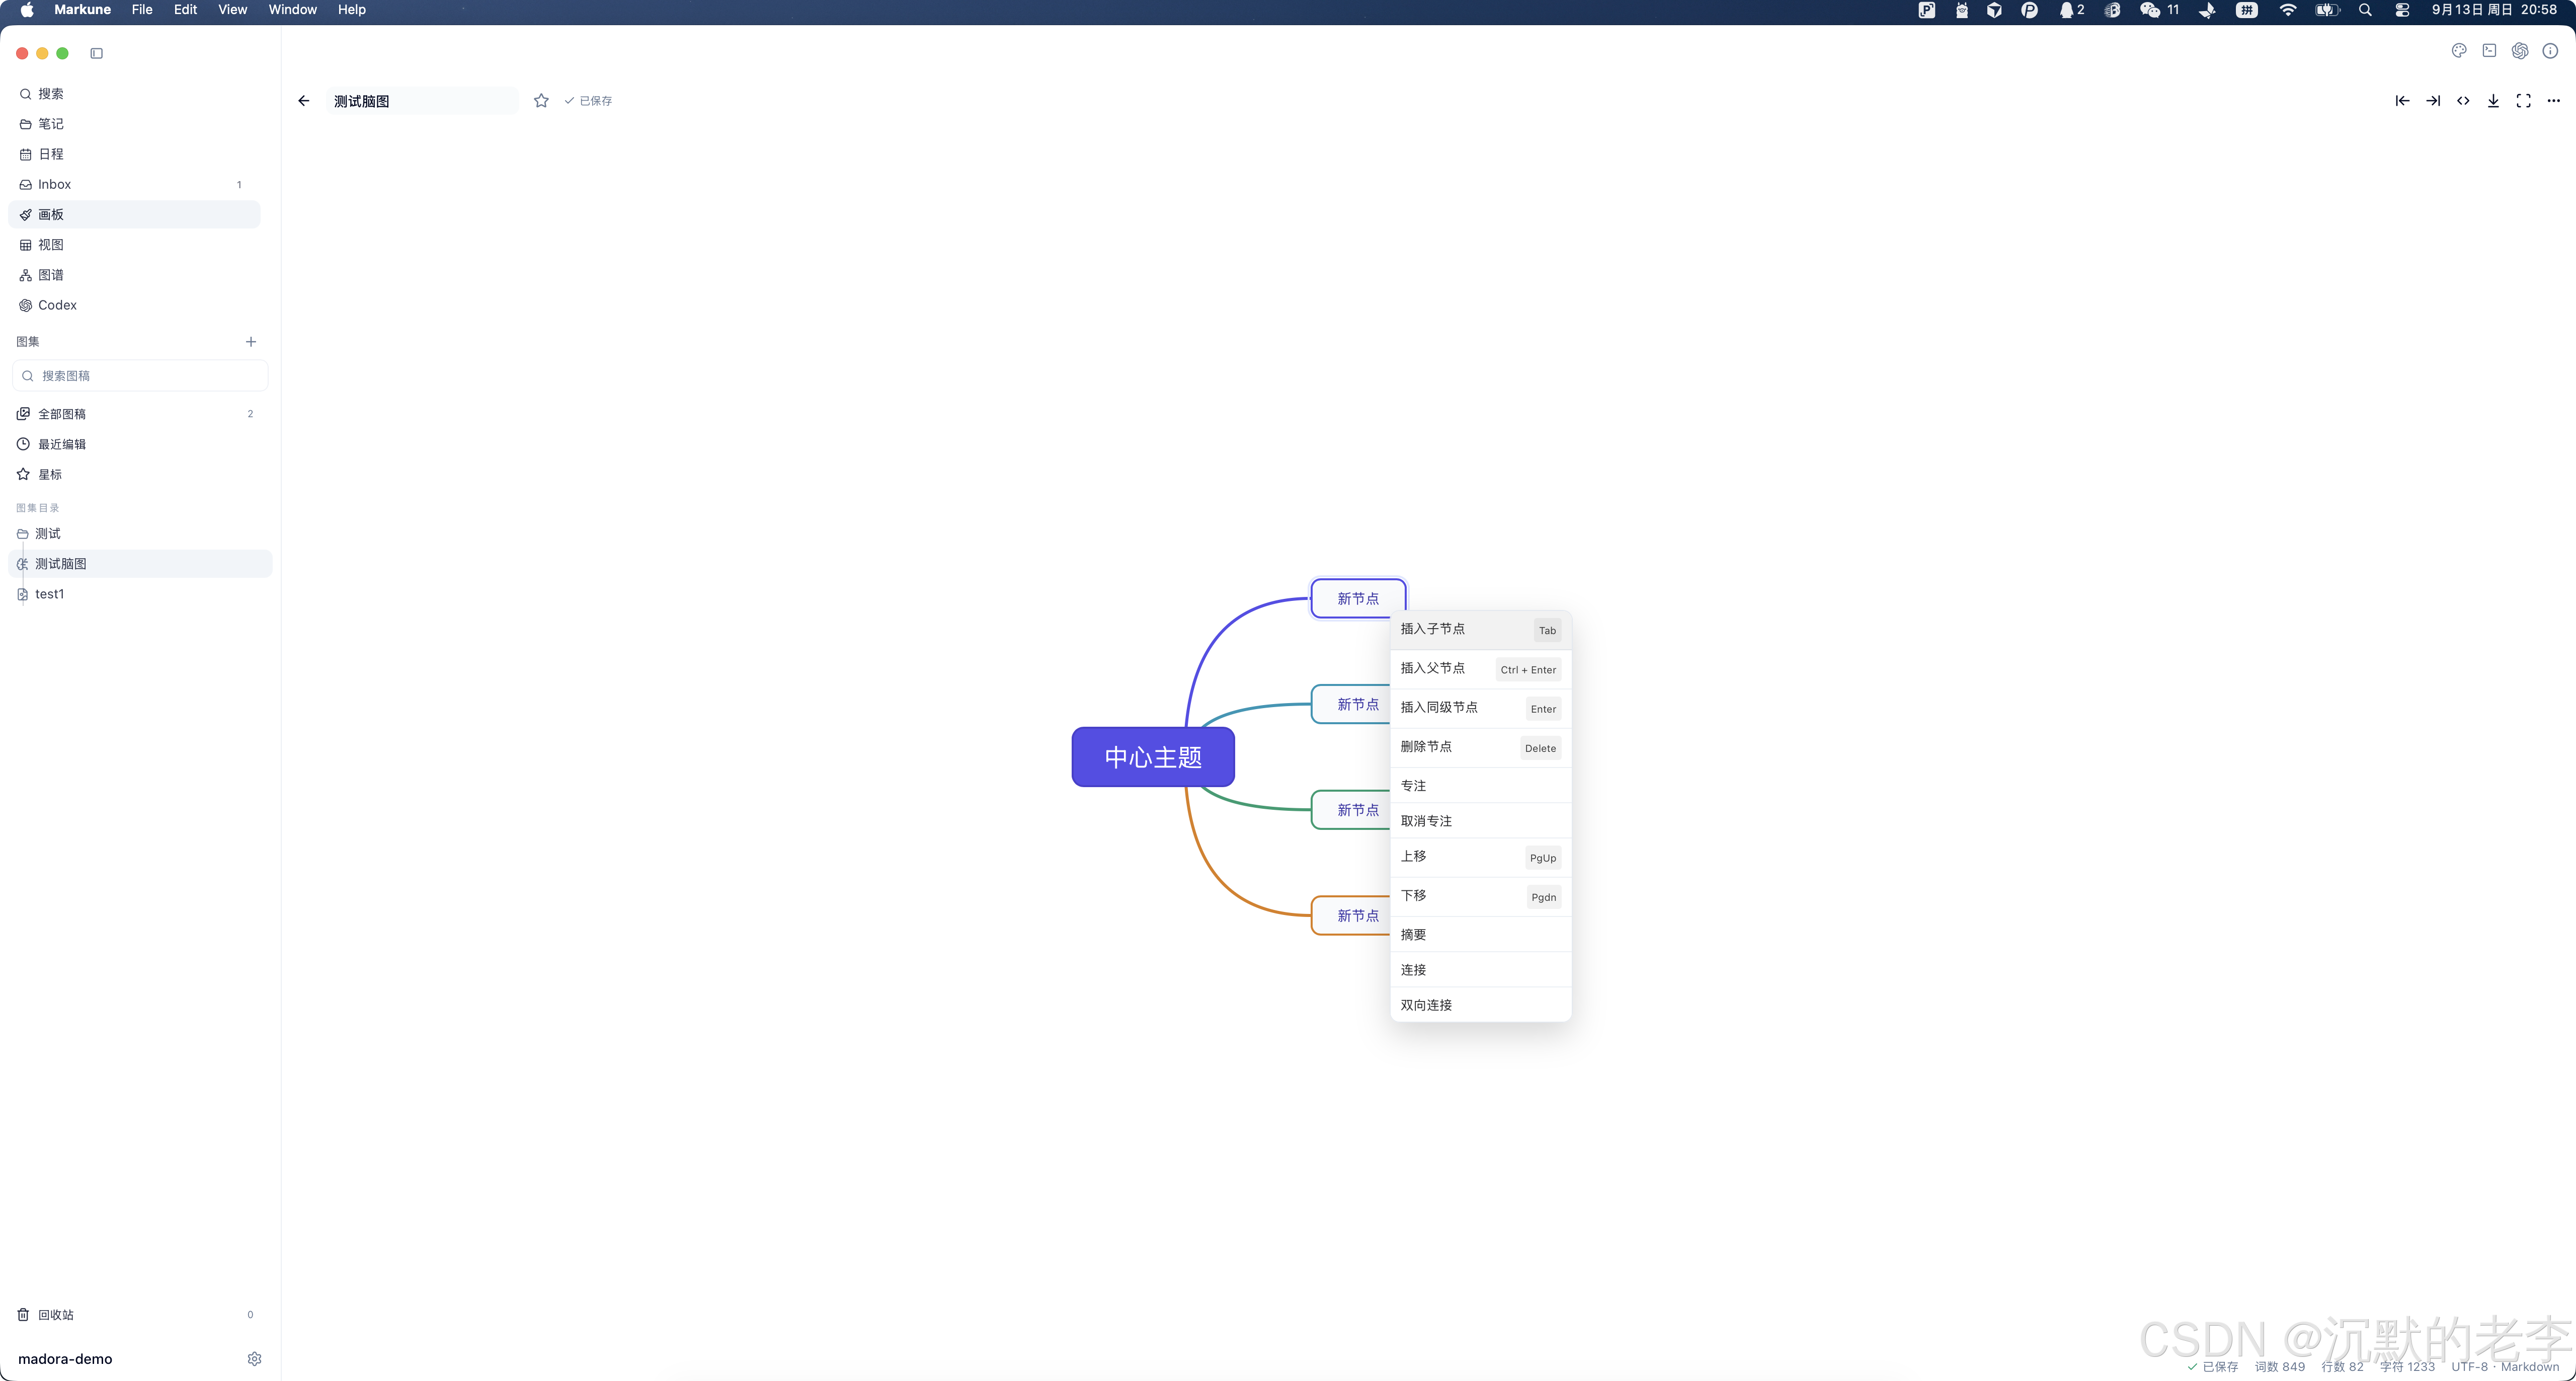
技术上,Markune 使用 Excalidraw 处理白板,并集成 Mind Elixir 等能力构建图稿工作流。
但更重要的是,画板并不是孤岛。
图稿可以生成 Markdown 引用,再插入笔记。
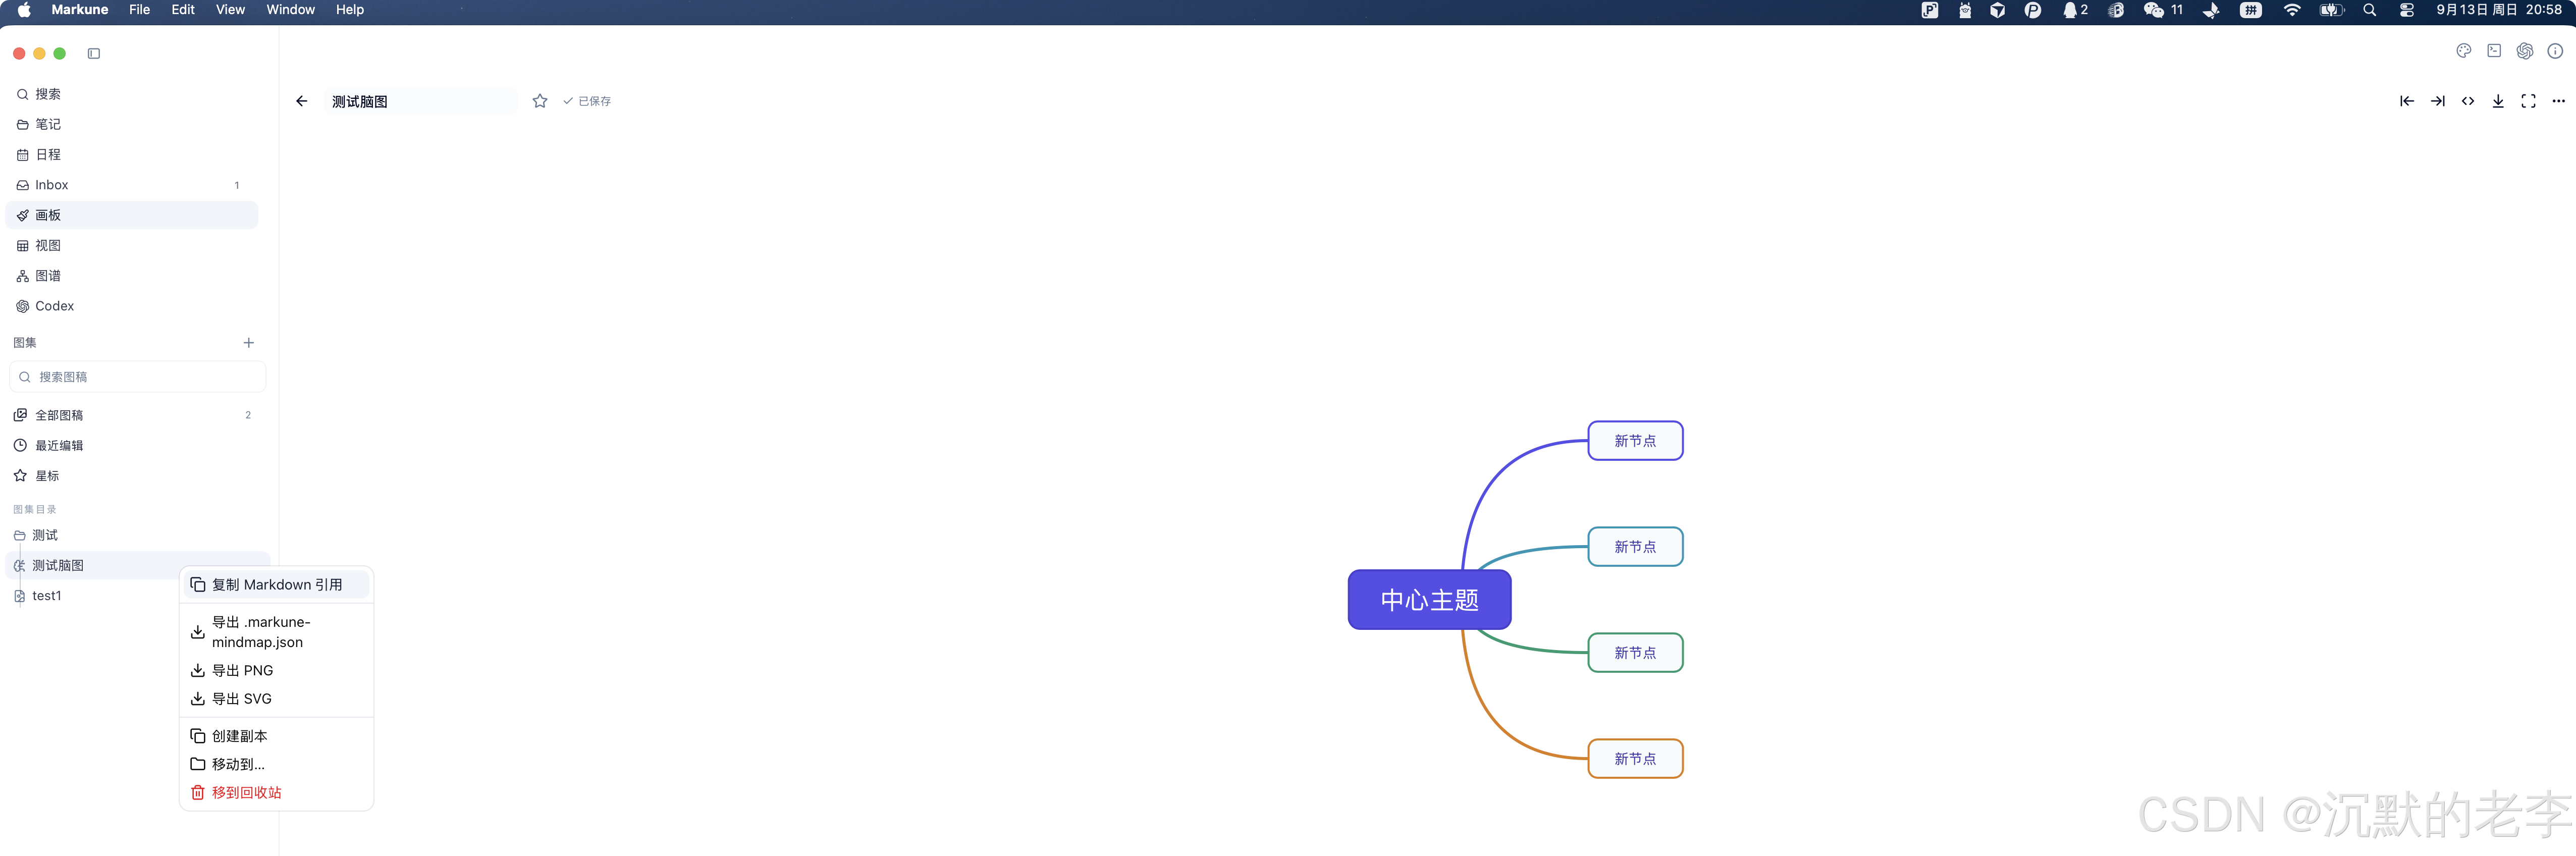
于是:
文字负责叙述,图稿负责表达结构,而 Markdown 仍然是整个知识工作区的连接层。
07. 附件也尽量尊重你的文件组织方式
Markdown-first 产品经常遇到一个麻烦:
图片怎么办?
附件怎么办?
如果所有东西都塞进应用自己的隐藏资产库,Markdown 虽然还在,但可迁移性还是会下降。
因此现在 Markune 的附件策略可以配置。
例如把新附件保存到:
- Markune 内置资产目录;
- 当前文档目录;
assets/;${filename}.assets/;- 自定义目录。
还可以选择是否优先保存为相对路径。
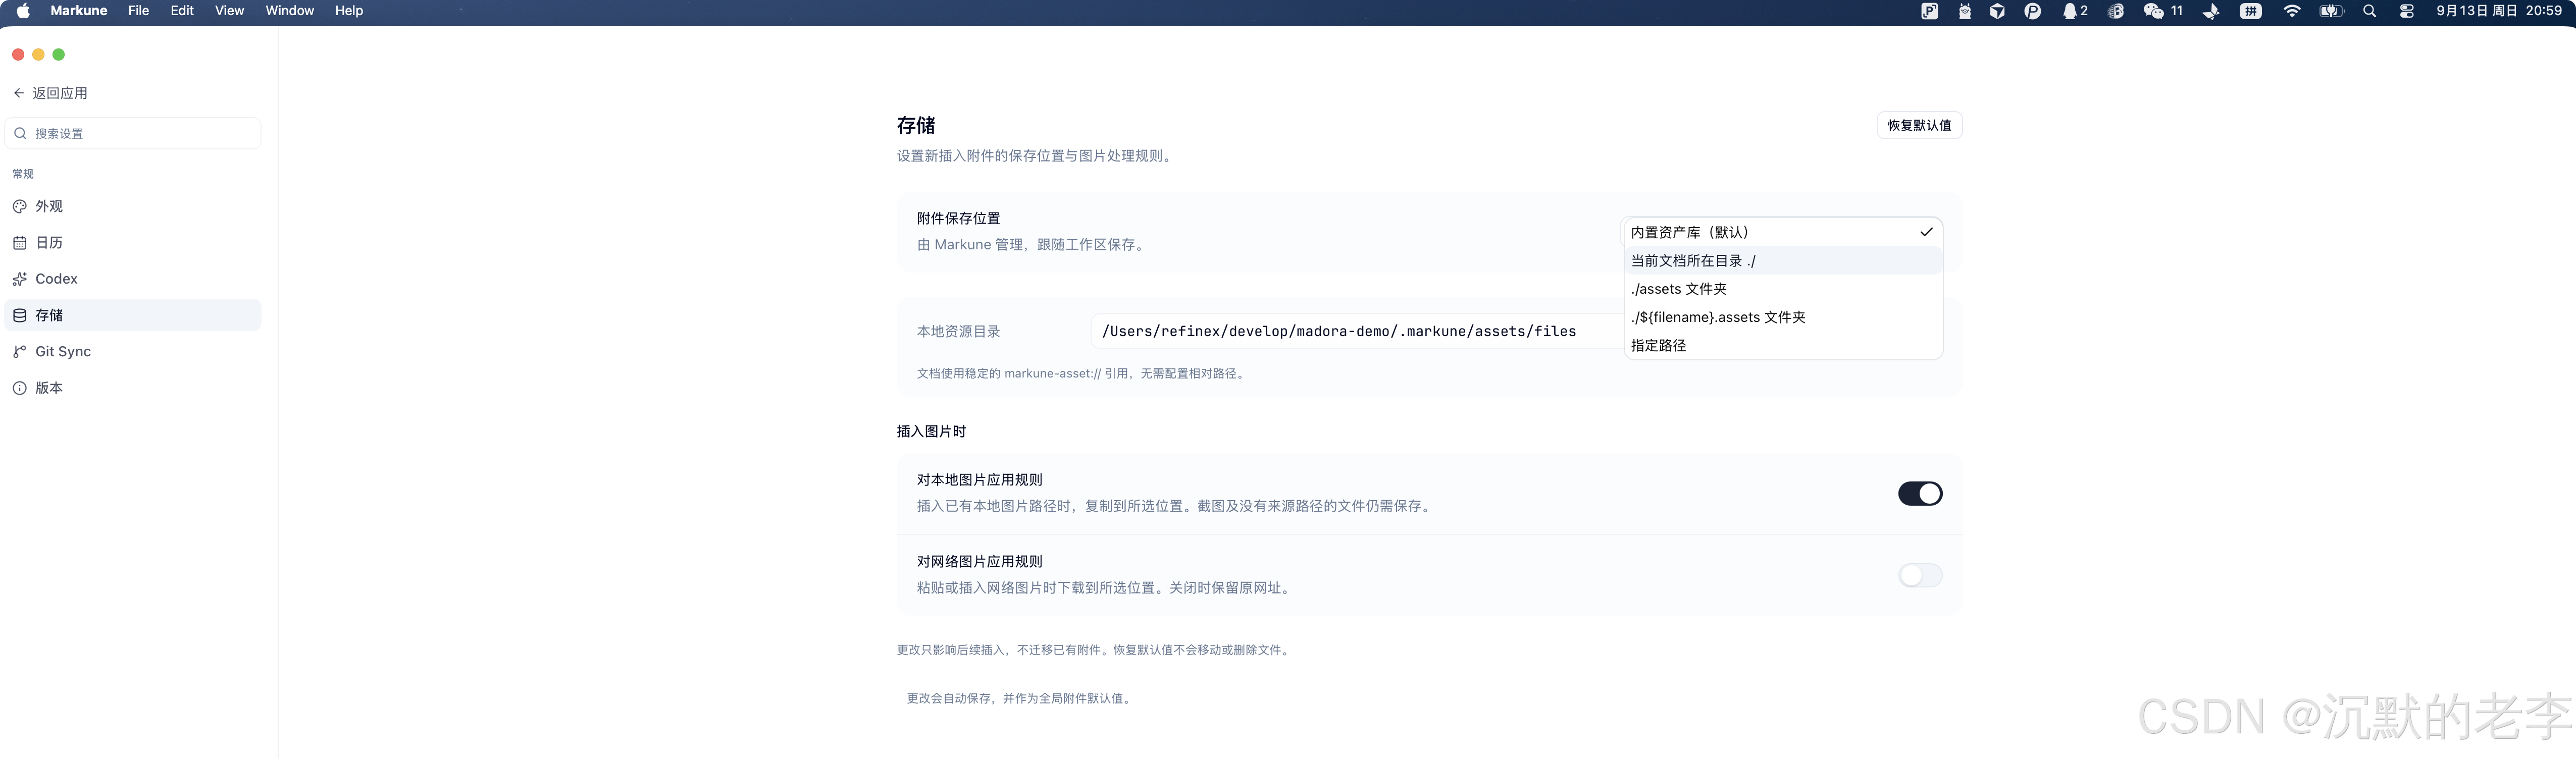
这类功能没有 AI 那么吸引眼球,却是我认为一个长期使用的 Markdown 工具必须认真处理的细节。
因为真正决定几年后知识库还能不能正常打开的,往往不是今天首页上最漂亮的功能,而是:
图片路径有没有乱,附件有没有丢,移动文件之后引用还能不能找到。
08. Word、PDF、HTML 资料,也可以逐渐进入 Markdown 工作流
现实中的知识来源当然不可能全部都是 Markdown。
项目资料可能来自 Word。
论文和报告可能是 PDF。
网页保存下来可能是 HTML。
所以 Markune 现在支持把:
| 格式 | 导入 | 导出 |
|---|---|---|
| Markdown | ✅ | ✅ |
| Word / DOCX | ✅ | ✅ |
| ✅ | ✅ | |
| HTML | ✅ | ✅ |
逐步接入 Markdown 工作流。
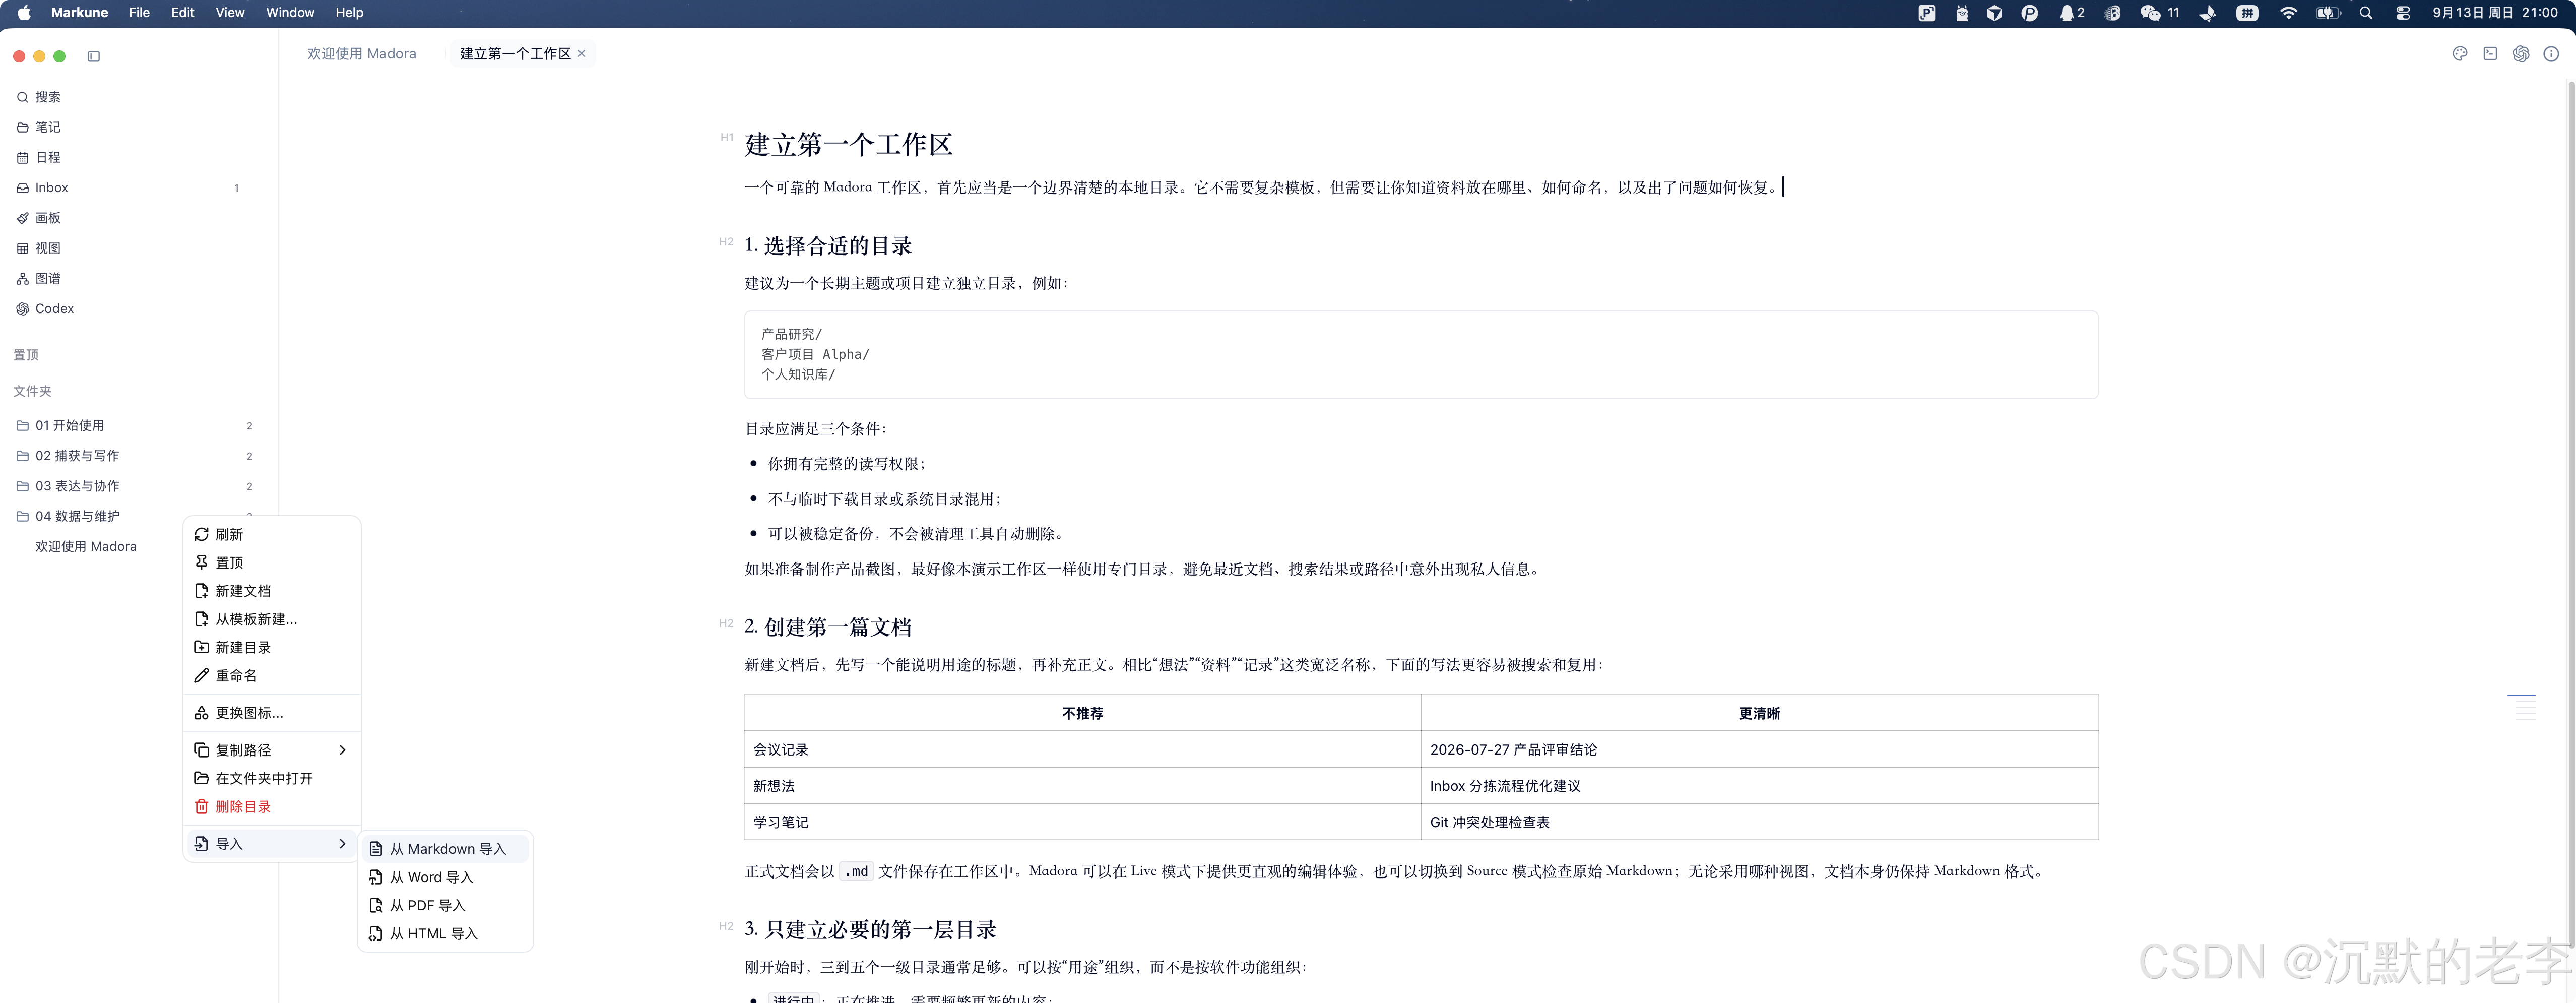
PDF 的低文本页面还可以使用离线中英文 OCR,转换过程不依赖远程文档转换服务。
桌面运行时中还准备了 Pandoc、Typst 等工具链,用于文档转换和导出。
这里我也不想夸大。
Markune 的目标不是把复杂 Word、PDF 做到像素级 100% 还原。
真正的目标是:
把原来只能 "看" 的资料,尽可能转换成以后还能继续编辑、搜索、引用和交给 AI 理解的 Markdown 内容。
复杂表格、多栏 PDF、扫描资料依然应该先小范围验证转换效果。Markune 自己的使用文档也明确写出了这些边界。
09. 对程序员而言,Git 可能才是最自然的笔记同步方式之一
既然工作区本身就是目录和文件,那么下一步自然就是 Git。
Markune 内置了 Git 面板和 Git Sync。
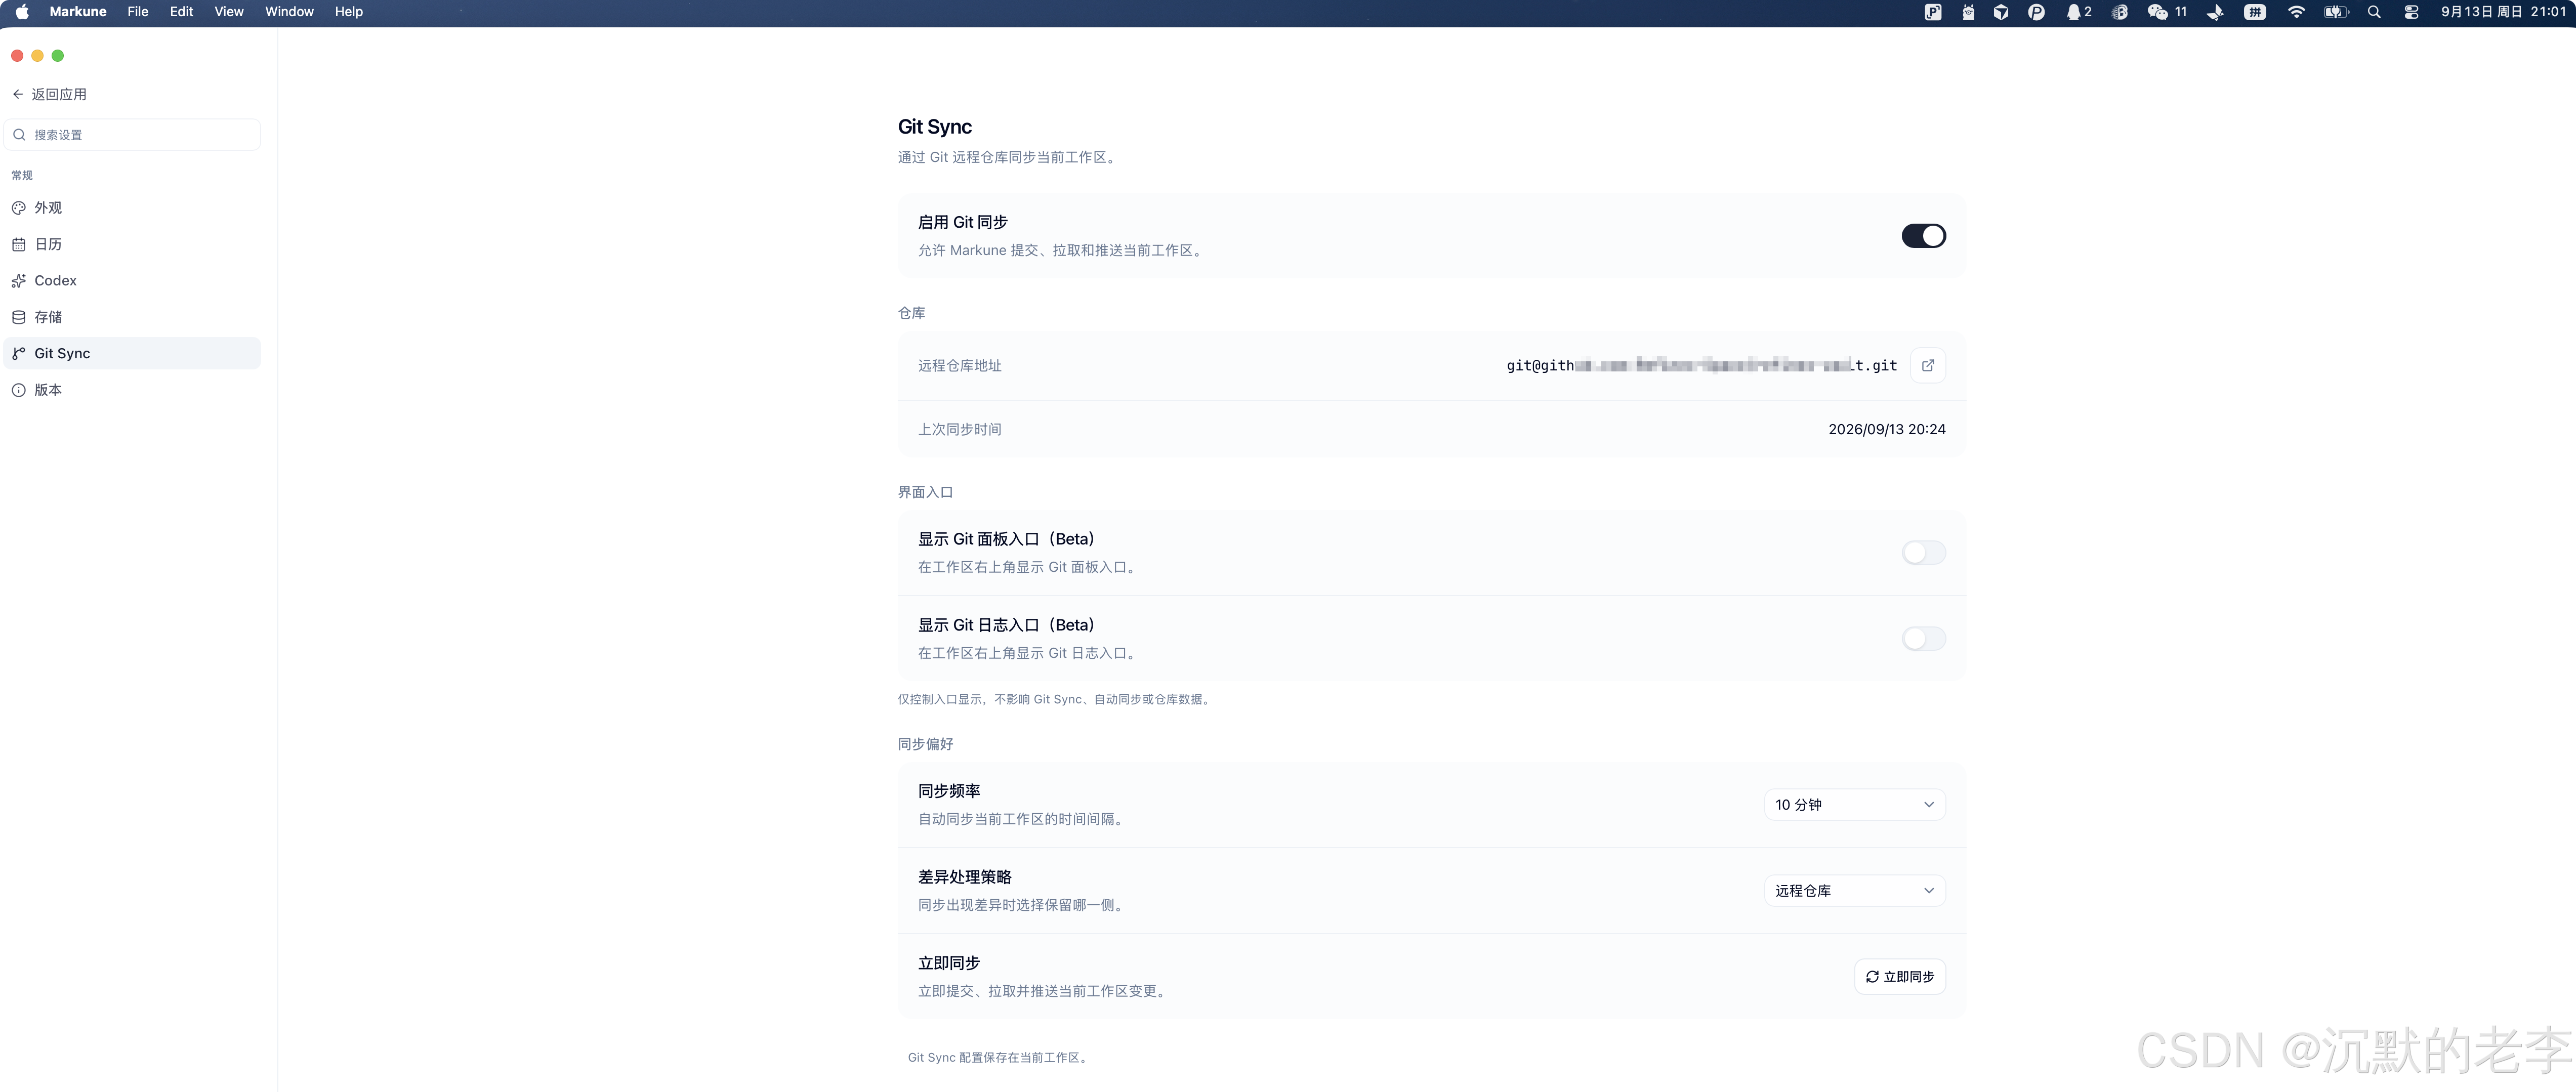
可以在工作区中完成:
- 查看修改;
- 暂存;
- Commit;
- 查看历史;
- Pull;
- Push;
- 定时自动同步。
Git Sync 当前遵循类似:
text
fetch
  ↓
提交本地修改
  ↓
合并远端
  ↓
push
这样的同步流程。
发生无法自动处理的冲突时,默认策略不会擅自覆盖内容,而是停止同步,让用户明确处理。
这里我尤其想强调:
同步不等于备份。
Git 是一层非常好的版本历史和多设备同步能力,但真正重要的知识依然建议拥有独立备份。
Markune 的文档里也专门把:
保存、提交、同步、独立备份
区分开来。
对于程序员来说,这种模型应该非常熟悉。
我的笔记第一次真正拥有了:
text
git log
git diff
git revert
这一整套成熟的版本管理能力。
而不是依赖某个笔记平台自己的 "历史版本" 实现。
10. 然后是我认为 Markune 最有意思的一部分:Codex
做 Markune 的过程中,我越来越确定一件事情:
AI 最需要的不是另一个聊天窗口,而是上下文。
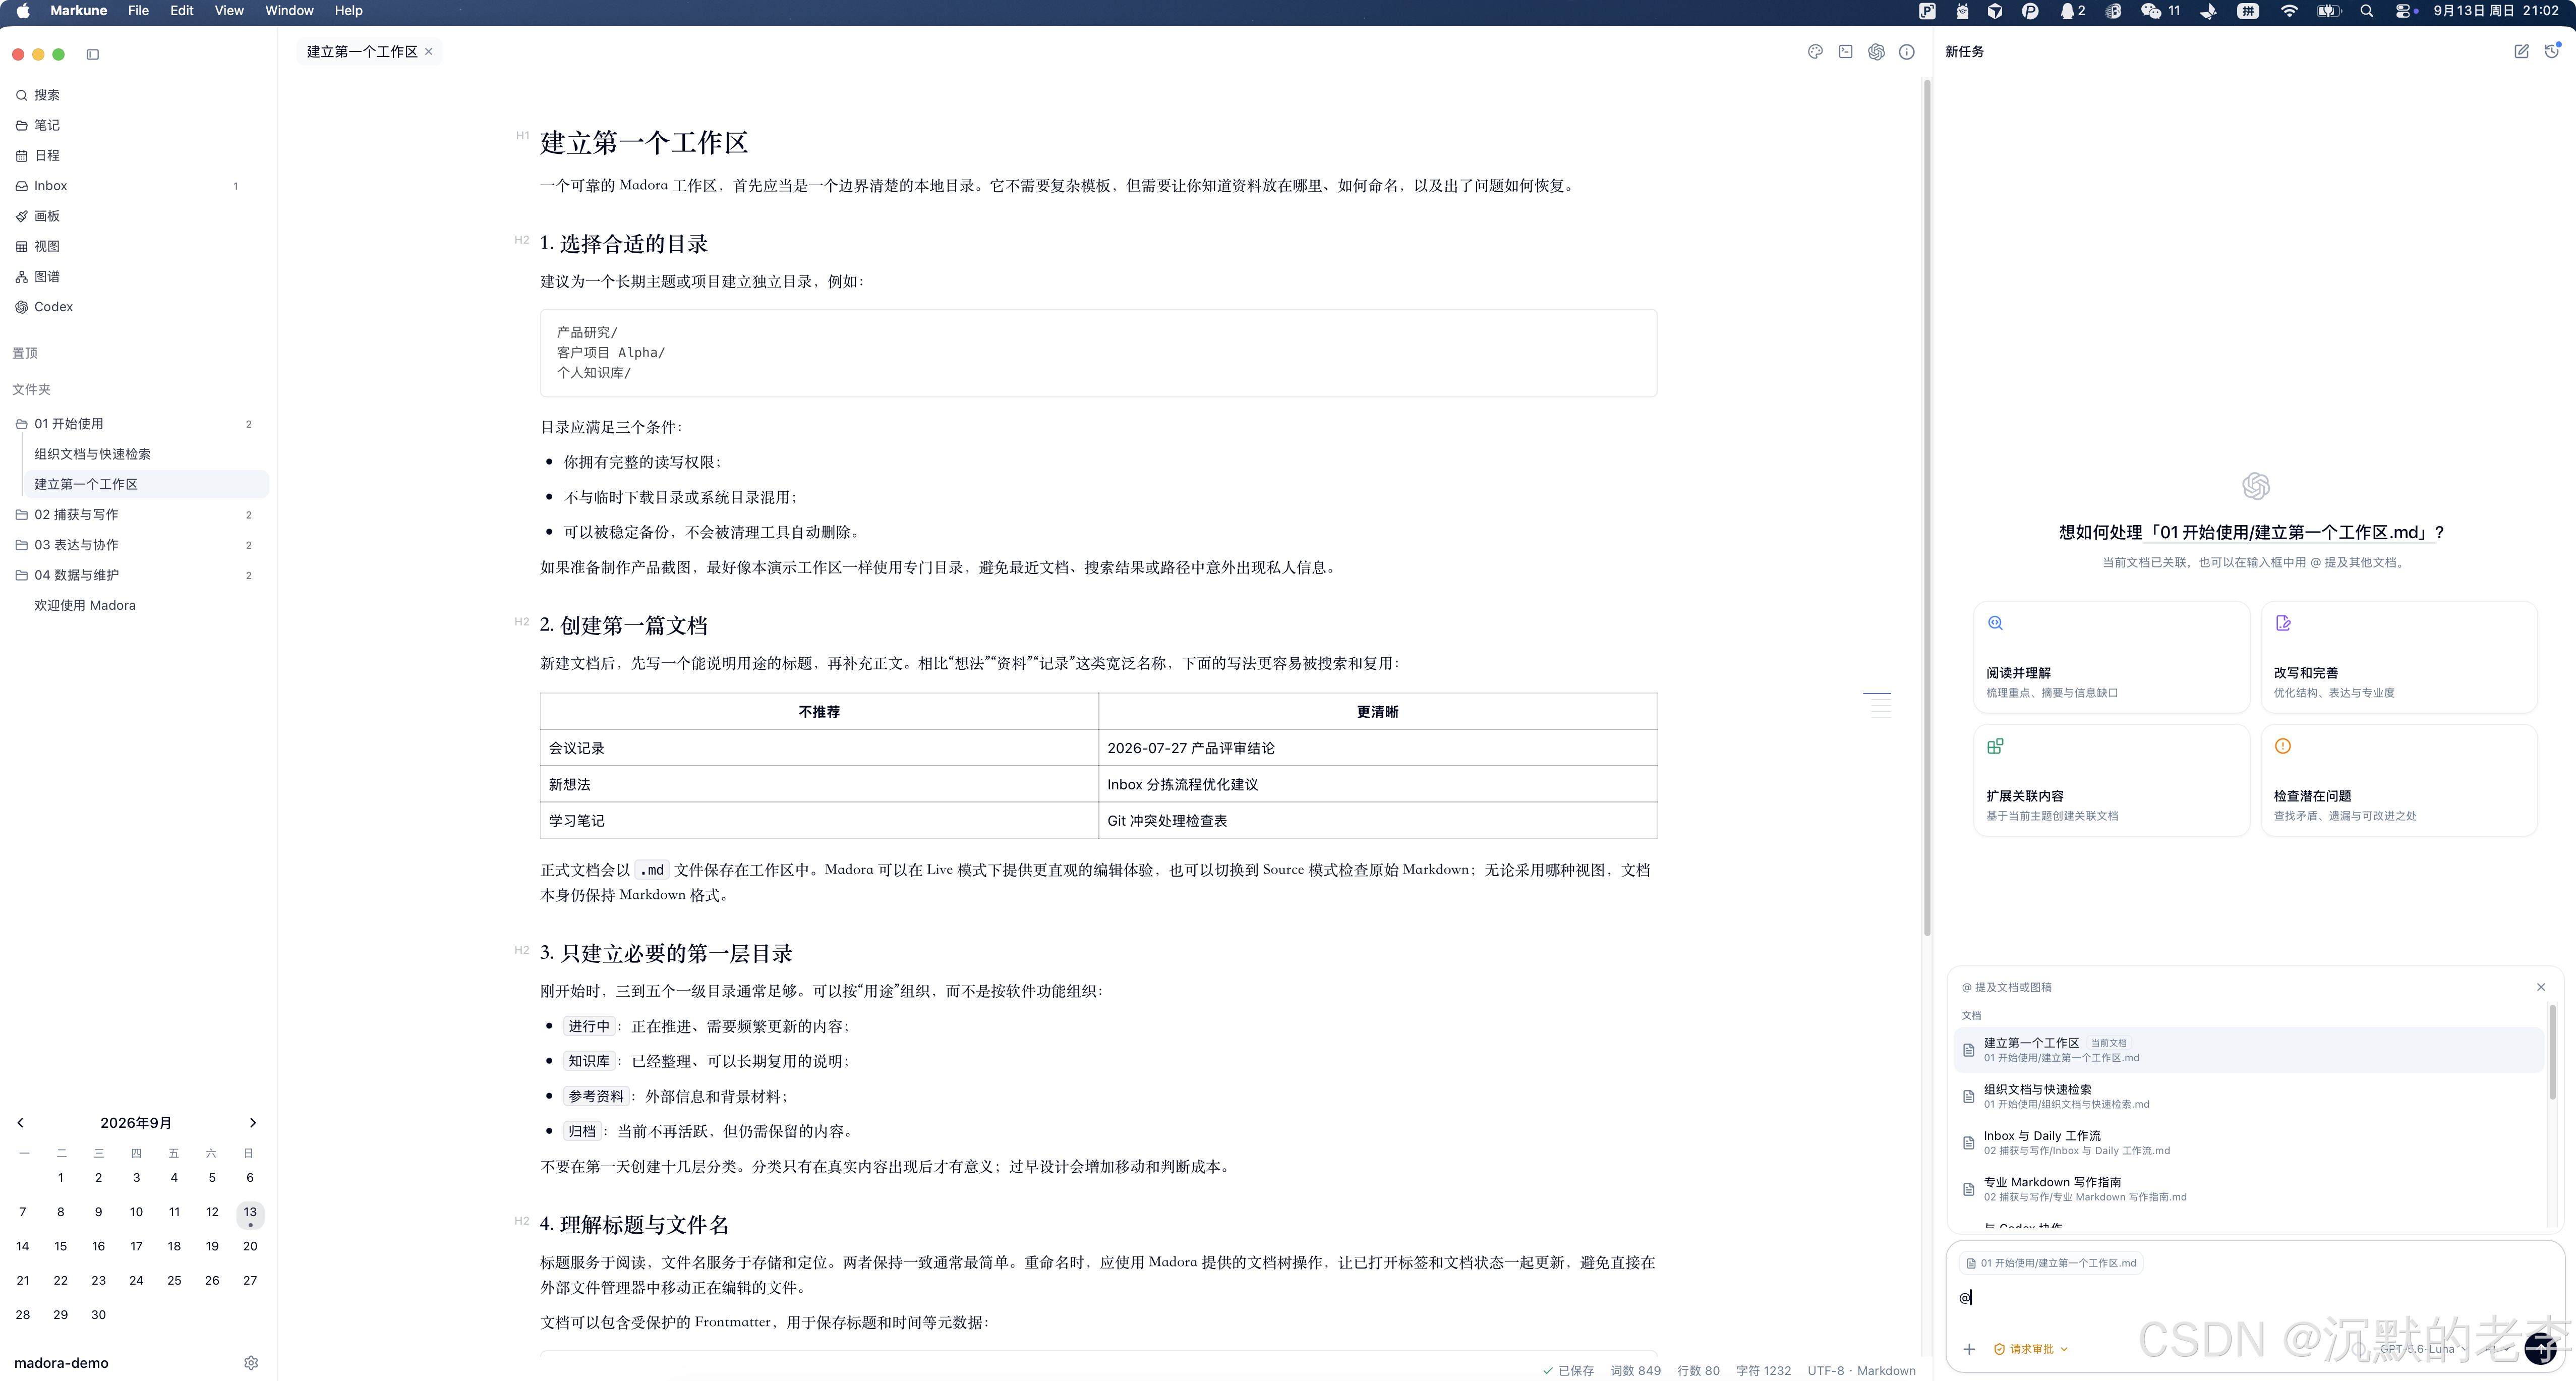
你的:
- 技术文档;
- 项目计划;
- Daily;
- 研究资料;
- 图片;
- PDF;
- 代码;
- 历史决策;
本来就已经存在工作区里。
如果还需要手动复制一段文字到网页聊天窗口,再解释:"这是我的项目背景,这是另外一份文档......"
整个流程其实非常割裂。
所以 Markune 把 Codex 直接放进了工作区。
它不是只调用一个 /chat/completions 然后显示聊天气泡。
Markune 的桌面端会运行 Codex App Server sidecar,通过 App Server 的 thread / turn / approval 等机制建立工作区级 AI 会话。Markune 仓库中也直接打包了 Codex 运行时。
Codex App Server 本身就是 Codex 面向富客户端集成提供的运行接口。
于是 AI 不再只知道你刚刚复制过去的几百字。
你可以直接告诉它:
阅读当前文档,检查标题结构和论证问题,先给建议,不修改文件。
也可以:
当前文档需要重新整理结构,另外 @ 引用的两篇笔记只作为背景资料,不要修改它们。
或者:
根据当前目录中的调研资料,补充这篇技术方案,但保留原来的代码示例和结论。
Markune 会把当前文档和显式引用交给工作区任务。
11. AI 可以修改文件,但 "它想怎么改" 和 "真的改了什么" 应该是两回事
这是我做 AI 功能时比较坚持的一点。
Agent 很强,并不意味着应该无条件获得所有权限。
Markune 会区分不同权限范围。
例如只需要分析文档,就可以选择只读访问。
真正需要编辑文件时,再开放相应权限。
完全访问意味着更大的文件、命令和网络能力,因此不应该因为一次工具调用失败就随手打开。
对于复杂任务,也可以先让 Codex:
分析 → 给方案 → 再执行。
执行完成之后,再去看:
- 修改了哪些文件;
- 增加了什么;
- 删除了什么;
- Diff 是否符合预期。
这也是我理解的人与 Agent 协作:
不是把控制权交给 AI,而是让 AI 真正进入工作流,同时保留审阅权。
而当整个知识库本身就是 Git 工作区时,这层可审查性又会更自然。
AI 改动、Git Diff、版本历史,最终都围绕同一批真实文件展开。
12. Markune 背后的技术栈
如果你是开发者,可能也会对它是怎么实现的感兴趣。
当前 Markune 的核心技术架构包括:
text
Next.js
React
TypeScript
        ↓
Markweave / CodeMirror
        ↓
Tauri v2
        ↓
Rust
除此之外还使用了:
- Excalidraw;
- Mind Elixir;
- Mermaid;
- KaTeX;
- D3;
- Tesseract.js;
- Pandoc;
- Typst;
- Codex App Server。
桌面层由 Tauri + Rust 负责:
- 文件系统;
- Git;
- 本地终端;
- 系统菜单;
- 更新;
- 文件关联;
- 工作区监听;
- 本地资源访问。
UI 和知识工作区则主要由 React / Next.js 实现。
Markune v0.2.7 还加入了 .md / .mdx 系统文件关联,因此可以直接在 macOS / Windows 的 "打开方式" 中选择 Markune。
13. 为什么我没有把所有能力都塞进 Markune 自己
这里还有一个我比较喜欢的地方。
Markune 的编辑器并不是一个只能存在于 Markune 内部的私有实现。
我把它独立成了:
Markweave
并以 MIT License 开源。
Markweave 提供:
- Framework-neutral Core;
- React;
- Vue 3;
- Vue 2;
适配,可以独立安装在其他项目里。
所以现在我的几个项目逐渐形成了这样的关系:
text
Markweave
Markdown 编辑能力
       ↓
Markune
面向最终用户的知识工作区
       ↓
Codex
进入真实知识工作流的 AI Agent
我比较喜欢这种方式。
一个项目里真正有复用价值的东西,不一定非要永远锁在这个产品里。
14. Markune 现在并不完美
我还是希望把目前的边界说清楚。
Markune 现在仍然处于比较早期的 0.2.x 阶段。
截至 v0.2.7:
第一,目前只正式提供 macOS 和 Windows 桌面版本。
暂时没有正式 Linux 安装包。
第二,安装包的系统级签名还没有完全解决。
当前 macOS 使用 ad-hoc 签名,Windows 安装包暂未使用 Authenticode,因此首次安装可能遇到系统安全提示。
自动更新包本身仍然经过独立签名校验。
第三,一些能力还处于持续打磨阶段。
例如 Git 面板和日志目前仍会明确标注 Beta。
第四,Local-first 并不意味着使用 AI 时数据永远不会离开电脑。
Markdown 文件默认保存在本地,但当你主动把上下文发送给 ChatGPT 或自定义 AI 服务时,对应内容仍需遵循模型服务提供方的数据与隐私规则。
这些我更愿意明确告诉使用者。
因为开源产品最重要的不是表现得"已经无所不能",而是:
哪些已经能用,哪些还在完善,边界在哪里。
15. 什么样的人可能会喜欢 Markune?
如果你符合下面几种情况,我觉得 Markune 会比较值得尝试。
你是程序员
你习惯 Markdown、目录、Git,也越来越多地使用 Codex 或其他 Agent。
那么把:
text
笔记
+
项目资料
+
Git
+
AI
放在一个工作区里,会非常自然。
你重视 Local-first
你希望自己的知识库首先是一组属于自己的文件,而不是某个服务中的一条账号数据。
你已经积累了大量 Markdown
Markune 可以直接打开已有目录,而不是要求重新建立一套知识库。
你希望 AI 真正理解自己的知识库
而不是每次都:
打开网页 → 复制 → 粘贴 → 补充背景 → 再复制回来。
你需要比纯 Markdown 编辑器更多的东西
Daily、Inbox、全文搜索、图谱、白板、脑图、任务、属性、Git、PDF 研究和 AI 协作,都可以围绕同一批本地文件发生。
16. 我想做的,其实不是 "另一个笔记软件"
Markune 目前还有很多地方需要继续完善。
但随着它不断成型,我越来越清楚自己真正想做的是什么。
不是和所有笔记软件比较谁的功能按钮更多。
也不是创造一种新的知识管理方法论。
而是尽量把一件事情做好:
让知识重新围绕属于自己的文件展开。
Markdown 是这些文件的格式。
Markweave 负责把它写得舒服。
Inbox 和 Daily 让记录能够持续发生。
图谱和画板帮助整理关系与结构。
Git 保存变化的历史。
Codex 则开始参与阅读、研究、整理和修改。
它们最终面对的,仍然是同一个本地工作区。
这就是 Markune。
写下想法,让工作自然展开。
目前状态
Markune 当前已经:
- 开源;
- 免费;
- 基于 Apache License 2.0;
- 支持 macOS Apple Silicon;
- 支持 macOS Intel;
- 支持 Windows x64;
- 最新稳定版本为 v0.2.7。
产品官网:Markune 官网
GitHub:Refinex-Space/markune
Markweave:Refinex-Space/markweave
如果 Markune 的方向刚好也是你期待的工作方式,欢迎下载体验,也欢迎在 GitHub 提 Issue、参与讨论或者给项目一个 Star。
对于一个独立开发者来说,每一次真实使用、反馈和建议,都会直接影响这个项目下一步往哪里走。
参考资料
- Markune 官网与功能说明。
- Markune GitHub README、技术架构与开源许可证。
- Markune v0.2.7 Release 与更新日志。
- Markune Markdown、Git、导入导出和 Codex 使用指南。
- Markweave 开源编辑器项目。
- OpenAI Codex App Server 文档。