基础设施全绿,用户照样拿到空回复或错路由------生产多 agent 常栽在这类坑里。2026 年 9 月 11 日 AWS 博文用一套机票 Swarm 演示:质量一层盯「帮没帮到人」,底座一层自己查 IAM / 限流 / 工具失败。
Meghana Ashok / Samaneh Aminikhanghahi / Suren Gunturu / Vidya Sagar Ravipati · AWS Machine Learning Blog · 2026-09-11
官方配图 · Monitoring production agent lifecycle
两种「绿着也坏」
传统监控看的是系统有没有跑完:CloudWatch 指标绿、工具调用成功、Bedrock 返回了。原页点破另一面:agent 可以每一次调用都成功,却完全理解错用户要什么。
两个具体例子写得很硬。执行角色缺 IAM,agent 调不了基础模型,返回的是空回复 ,不是 HTTP 500。Supervisor prompt 范围划得太松,大约 20% 请求被路由到错误的专家 agent,错误率指标却不抬头,基础设施仍显示健康。
多 agent 更难:一次用户请求往往经过 Supervisor 再分给多个专家,各有工具与模型调用,通常没有固定调用图可埋点。失败可以卡在任意交接处,传播路径也不稳定。质量坏了和底座坏了,从外面看常常一个样,但修法完全不同。
空回复不是 500:缺 IAM 那条链
演示里机票 Swarm 突然不响订票请求,页面上是泛化错误或干脆空白。人手排查会翻应用日志、看近期部署、手工对 IAM、跨服务对指标、再顺着多 agent 调用链走------原页估 30--60 分钟,还得你够熟架构。
把事故丢进 AWS DevOps Agent Space(签名 webhook)后,它拉 CloudWatch 日志、搭受影响资源的拓扑,顺着调用链对上根因:执行角色缺 bedrock:InvokeModel。每一步都要调 Amazon Bedrock 跑语言模型,调用在 IAM 层被拒;Supervisor 拿不到模型输出,只能吐空白------不是 403,也没有可合成的异常信息。
失败路径被写成一条线:用户请求,经 AgentCore runtime 调 Amazon Bedrock API,Access Denied,再到 agent 失败。修复建议也很具体:给该执行角色补上所需 Bedrock 权限,并把权限范围收窄到正在用的那个基础模型资源。
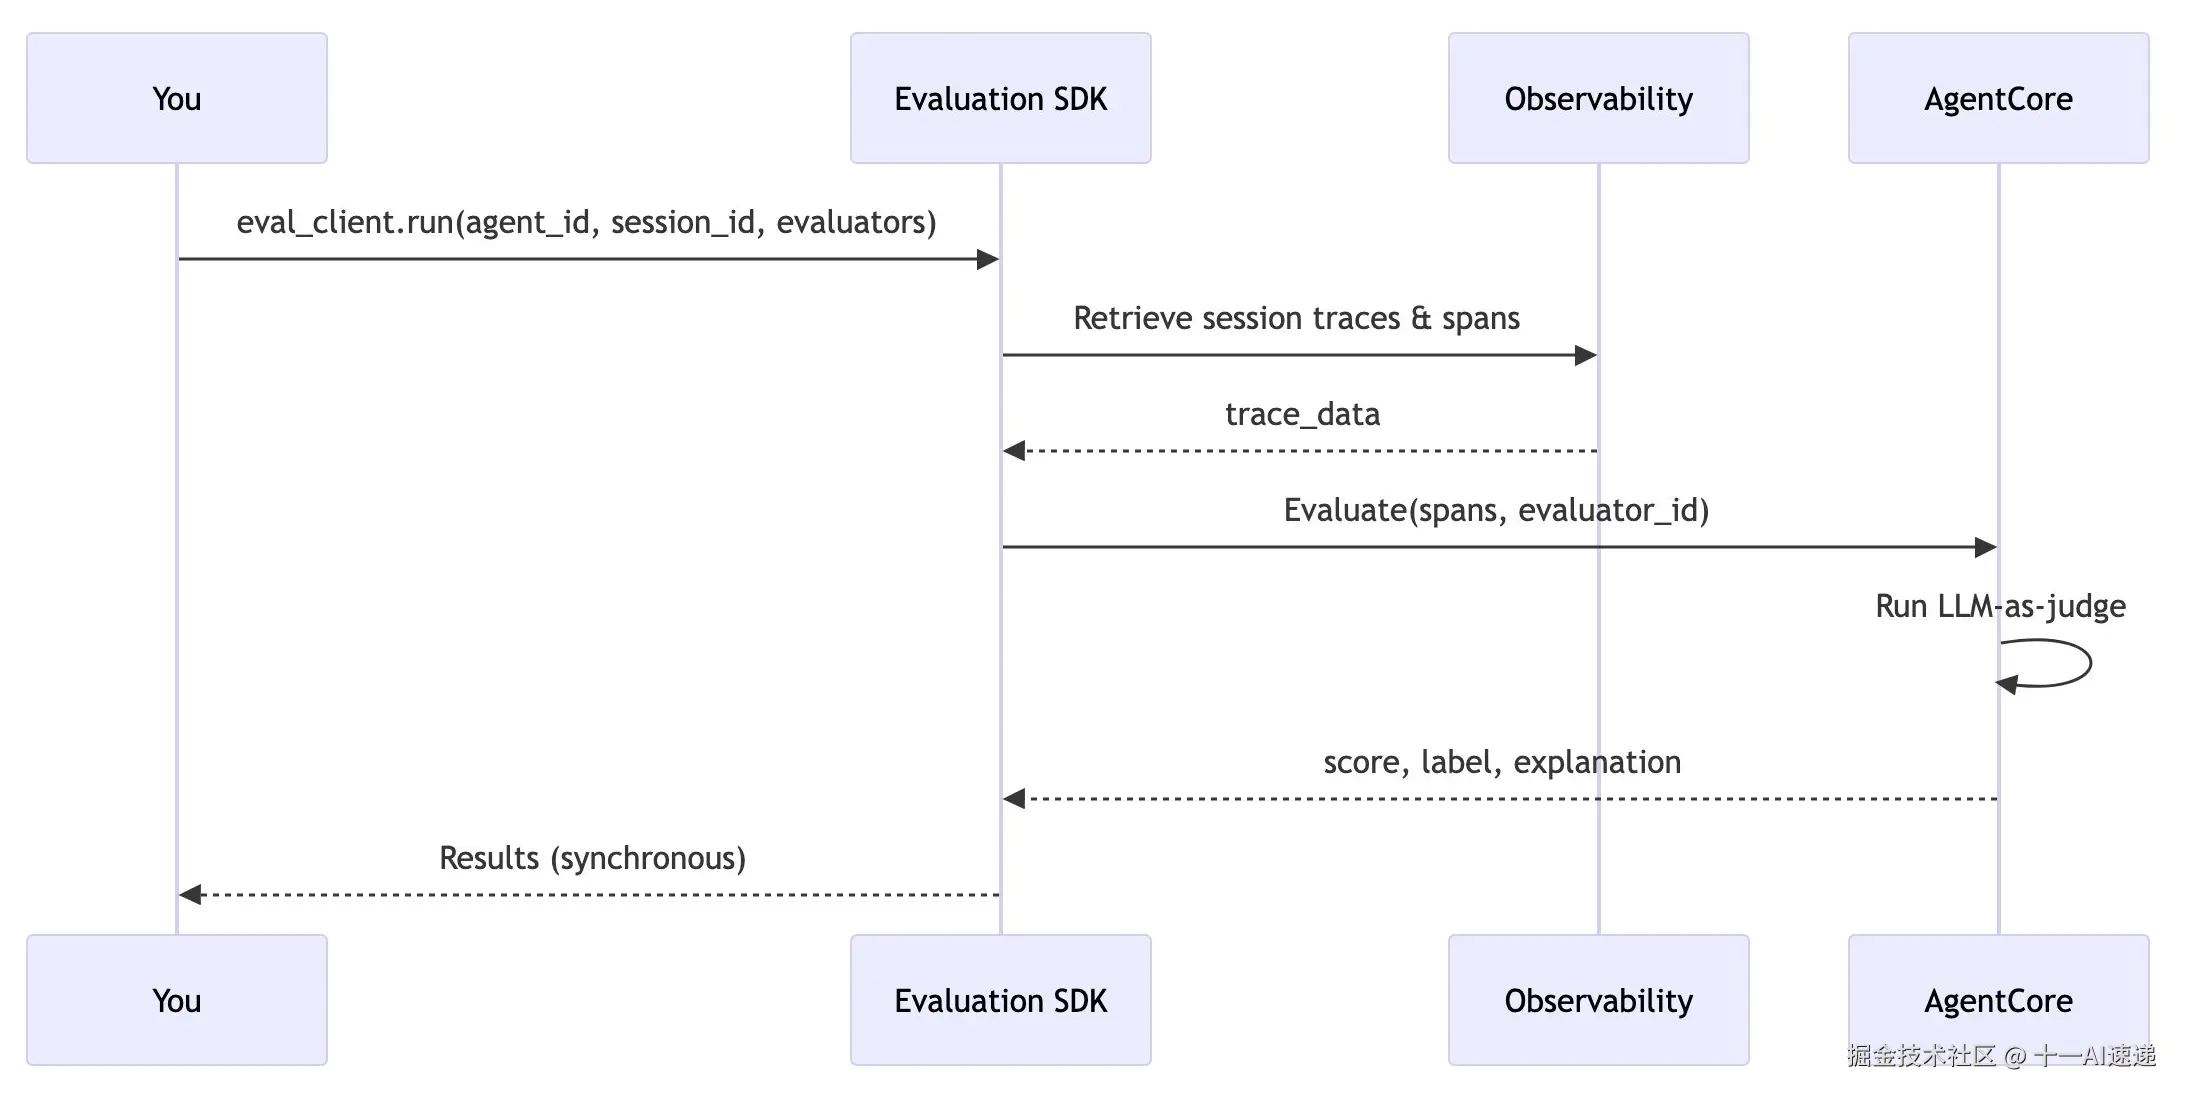
Figure 8 · DevOps Agent:根因是缺 bedrock:InvokeModel,完整失败路径已标出(官方截图)
同一套调查还覆盖多 agent 常见暗坑:子 agent 扩起来撞 Bedrock 每分钟 token 限流(TPM);工具报错被 Supervisor 静默重路由盖掉;会话中途丢 memory,回复变胡话却不硬失败;跨 agent 交接因网络或鉴权断掉。模式是同一套:关联日志、拓扑、调用时间线,把「看起来像质量差」拆回底座问题。
两层各答一个问题
架构就两句。Amazon Bedrock AgentCore Evaluations:agent 帮到人了吗 ?在线采样会话,用 LLM-as-judge 打 Helpfulness、Correctness、Goal Success Rate 等分,异步跑,不加重用户侧延迟;分数带推理说明,可落 CloudWatch,也能设告警。AWS DevOps Agent:底座 还健康吗?异常时自己拉日志、建拓扑、跨 IAM / Bedrock / runtime 对错误,给出可执行的修复建议,而不是只丢一个仪表盘链接。
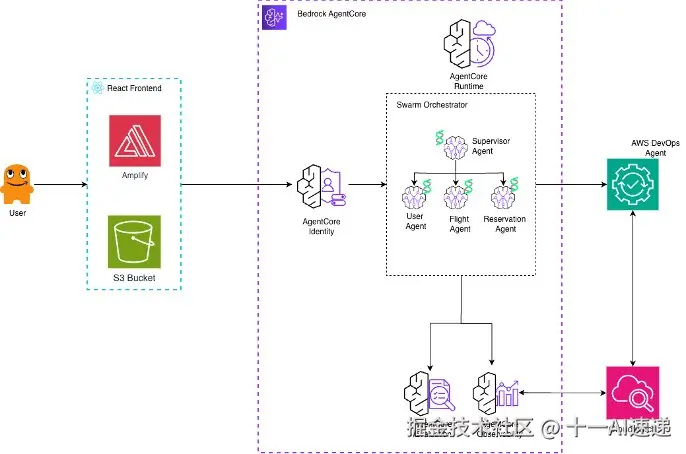
Figure 2 · React 前端 → AgentCore runtime → CloudWatch;DevOps Agent 挂同一后端(官方图)
观测数据同源:AgentCore Observability 用 OpenTelemetry 把 traces / metrics 打进 CloudWatch;Evaluations 从同一批 runtime traces 抽样打分,结果也进 CloudWatch。运维指标、分布式追踪、质量分落在一处,DevOps Agent 调查时不用换工具箱拼图。
机票 Swarm 四代理:没有固定调用图
演示系统是生产向的航空预订:多城行程、忠诚计划权益、公司差旅政策,压在同一次对话里。样例请求:「西雅图到波士顿 3 月 15 日,再波士顿到迈阿密 3 月 18 日;第二段用 companion certificate;两段都要符合公司差旅政策;我是 Gold,能升舱就升。」
四个专家用 Strands Agents 的 Swarm 模式搭起来:
- Supervisor:入口,用 think 工具拆子任务,再路由;之后控制权可以在同行之间传,不必每次回中心路由器。
- Flight:搜航线、处理多城中转。
- User:忠诚等级、certificate、画像。
- Reservation:创建 / 改 / 取消,提交前校验。
Swarm 里共享工作记忆,谁下一步合适谁接手。搜不到直飞,Flight 自己做中转搜索,有选项再交给 Reservation;certificate 不适用,User 调整后再往下传。好处是请求结构不规则也能扛;代价是没有固定 call graph 可仪器化,失败点和失败路径每次都可能变。
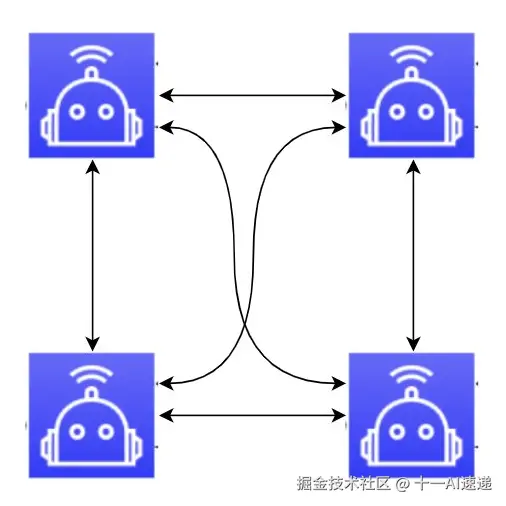
Figure 1 · Swarm 多代理:Supervisor 入口,专家间动态交接(官方图)
所以才需要两层:Evaluations 抓「全执行完了仍没帮到用户」;DevOps Agent 抓「底座静默坏了,表现成能力下降」。
默认只开三个质量分
AgentCore 内置 16 个评测器:13 个 LLM-as-judge(带说明,方便核对为什么给这个分),3 个确定性轨迹匹配器。
LLM-as-judge 名单:Goal Success Rate、Coherence、Conciseness、Correctness、Faithfulness、Harmfulness、Helpfulness、Instruction Following、Refusal、Response Relevance、Stereotyping、Tool Parameter Accuracy、Tool Selection Accuracy。轨迹三类:Trajectory Any Order Match、Trajectory Exact Order Match、Trajectory In Order Match。
机票系统在线评测默认只开三个:Helpfulness (对用户目标有没有推进,不只看对不对)、Correctness (事实准不准)、Goal Success Rate(整段会话目标有没有完成,会话级)。原页理由直白:指标太多难抓重点、每个评测器都有延迟和成本、这三个覆盖终端用户最在意的维度、团队也好迭代。Faithfulness、Instruction Following、以及工具使用相关质量等,可按需再开,不是默认全开。
在线采样比例可配 0.01%--100% ,异步、事件驱动,不叠用户可见延迟;指标经 OpenTelemetry 进 CloudWatch。原页也写了生产侧常见会按采样率跑(举例提到通常约 10%),不是每条会话都打分------要盯投诉或边角案例,走按需评测。
在线采样,再按需深挖,再改 prompt
闭环大致四步。在线评测后台按配置抽样,结果进 CloudWatch Logs,质量分掉到阈值可告警。仪表盘把日志和 OTel traces 收成会话时间线、span 层级和分数分布,按日期筛、点进单次 trace 看卡在哪。
按需评测针对用户投诉、边角 case、或在线指标标红的会话:选定 evaluator(含自定义评分准则),对单会话或批量会话立刻出分和说明。自定义评测器可按领域自写 rubric。
之上还有 AI 分析引擎:在低分会话上做无监督模式挖掘,用频率 / 相关把系统性问题从偶发里分开,再生成带证据的结论(频率、受影响 session ID、trace 片段)。原页举例:约 23% 低分会话在用户问改签时选错工具,且多出现在多轮对话。再接一层 prompt 改进:给出改过的 prompt、改了什么、为什么、预期影响,下一轮 CI/CD 验证,生产周期再量。
Guardrails 挡实时,评测抓漂移
Correctness / Faithfulness 能事后抓住幻觉,但在线评测是异步抽样,有问题的回复仍可能先到用户手里。Amazon Bedrock Guardrails 补的是每条响应内联:内容过滤、拒绝话题(例如航空场景里别答医疗法律)、上下文 grounding(标出没锚在检索材料上的内容)、敏感信息脱敏(工具输出里的卡号护照等)。
机票场景里,模型编出听起来合理却无工具依据的票价、越权承诺退改政策、跨会话泄漏 PII------这些是 Guardrails 的实时网。Evaluations 负责抽样抓质量漂移。两层互补,不是互相替代。
动手入口与几条硬注意
整套 demo 建在开源 FAST (Fullstack AgentCore Solution Template)上,仓库 fullstack-solution-template-for-agentcore,含 CDK、评测仪表盘、DevOps Agent 集成。要用 AgentCore Evaluations,原页列了:AgentCore CLI、带 bedrock-agentcore 与 CloudWatch 权限的凭证、bedrock-agentcore Python SDK(Boto3 client)。
上线前几条caveat 值得贴在 runbook 上:
- LLM-as-judge 没有 ground truth,分数当信号,别当绝对真理;用领域 SME 校准,让机器判断对齐人工预期。
- DevOps Agent 还在演进:webhook 凭证目前走控制台;Agent Space 可用 CDK / SDK 自动化。
- 采样率是折中:低了省开销、可能漏边角;按流量和覆盖需求拧。
- 给 DevOps Agent 的 IAM 读范围要谨慎:要够宽才能跨服务追失败,又别敞到不必要的面。
来源:Monitoring production agent lifecycle with AWS DevOps Agent and AgentCore Evaluations(2026 年 9 月 11 日)