我挖掘了一个巨牛的 人工智能 学习网站,通俗易懂,风趣幽默,忍不住分享一下给大家。点击跳转到网站。
前言
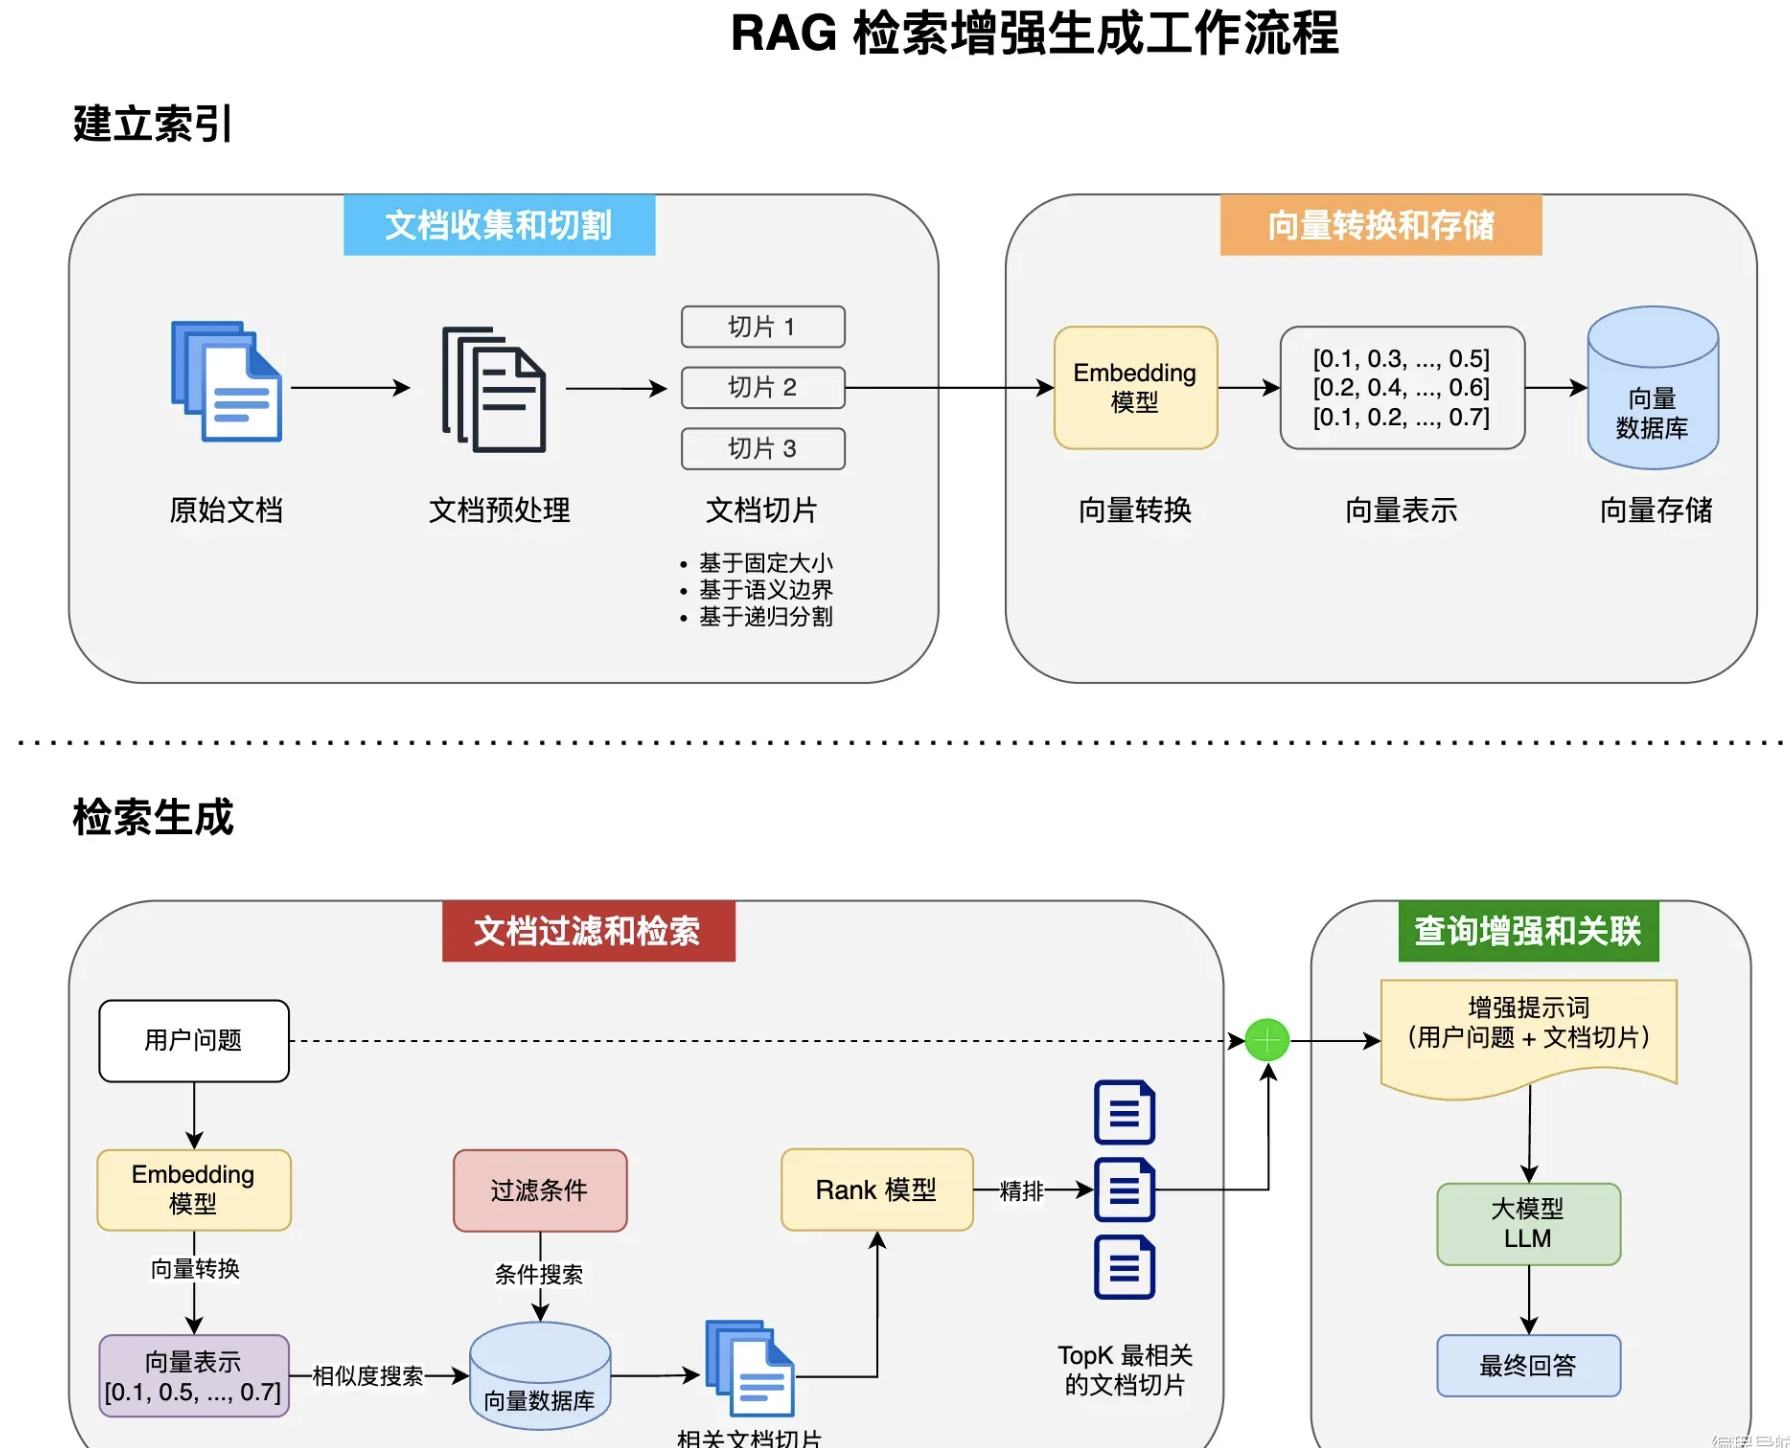
在 RAG 检索增强生成完整流程中,文档加载器负责读取 PDF、Markdown、TXT 等各类文件,并统一转换为 LangChain 的 Document 文档对象。但原始文档往往篇幅很长,无法直接送入向量库与大模型:
- 大模型存在固定上下文窗口上限,超长文本会直接超出限制;
- 整块大文本检索粒度粗糙,用户查询很难精准匹配到关键信息;
- 完整长文本嵌入向量时算力消耗更高,检索准确率偏低。
因此,文本分割(Text Splitters) 是 RAG 不可或缺的核心环节,作用就是将长篇文档拆分为短小、语义连贯、便于检索与模型读取的文本块。本文结合实战代码,拆解 LangChain 三类主流文本分割方案:基于字符分割、基于 Token 分割、递归式硬约束分割,同时讲解中文文档适配优化方案。
一、文本分割核心设计思路
文本拆分本质是把大文本切割为可管理的小块,行业主流实现思路分为两大分支:
- 按文本长度切割:分为字符长度统计 、Token 长度统计两种计量标准;
- 兼顾语义完整性:优先按照段落、换行、标点分层切割,尽可能不破坏完整句子、段落语义;
- 重叠块设计:通过
chunk_overlap让相邻文本块保留重复内容,避免关键信息被分割在两块边界而检索丢失。
二、基于字符长度分割 CharacterTextSplitter
2.1 基础原理
CharacterTextSplitter 是最简单的文本分割器,通过内置 len() 函数统计字符数量判断块大小,仅支持单一分隔符切割,默认推荐分隔符优先级 ["\n\n", "\n", " ", ""]。 核心特点:软性长度约束,优先保全完整段落语义 。 当一段文本使用指定分隔符切割后,字符长度依旧超过 chunk_size,分割器不会强行截断文本,而是完整保留整块内容,并打印日志提示块超长,避免一句话、专业术语被劈成无意义片段,影响向量检索效果。
2.2 完整实战代码
python
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_text_splitters import CharacterTextSplitter

# 加载本地Markdown文档
markdown_path = "../Docs/Markdown/脚手架级微服务租房平台Q&A.md"
loader = UnstructuredMarkdownLoader(markdown_path)
data = loader.load()  # 加载完成,得到Document列表

# 初始化字符文本分割器
text_splitter = CharacterTextSplitter(
    separator="\n\n",        # 段落分隔符,双换行区分不同段落
    chunk_size=100,          # 目标单块字符上限
    chunk_overlap=20,        # 相邻文本块重叠字符数
    length_function=len,     # 使用len统计字符长度
    is_separator_regex=False # 分隔符非正则表达式
)

# 执行文档分割
texts = text_splitter.split_documents(data)

# 循环打印前10个分割后的文本块
for document in texts[:10]:
    print("*" * 30)
    print(f"{document}\n")
2.3 超长日志说明与解决方案
运行代码后控制台会持续输出如下提示:
Created a chunk of size 128, which is longer than the specified 100
Created a chunk of size 133, which is longer than the specified 100
Created a chunk of size 1171, which is longer than the specified 100
很多新手会误以为是程序报错,实际这是预期内的提示日志:
- 分割器优先使用
\n\n段落分隔,若单段文本全部字符超过设定chunk_size; - 无更小分隔符可以拆分该段落时,有两种选择:
- 方案 A:强行截断文本,会拆分完整语句、专有名词,语义破碎;
- 方案 B:完整保留整个超长段落,输出日志告知用户; 分割器默认选择方案 B,保证语义完整。
优化处理方式 : 观察日志大部分文本块长度集中在 100~200 字符,直接调大 chunk_size 参数即可大幅减少超长块提示:
我设置的是 "\n\n" 双换行,这通常代表段落之间
python
text_splitter = CharacterTextSplitter(
    separator="\n\n",
    chunk_size=200,
    chunk_overlap=20,
    length_function=len,
    is_separator_regex=False,
)
三、基于 Token 长度分割(适配 OpenAI 大模型)
3.1 Token 与 tiktoken 基础认知
所有 OpenAI 系列大模型(GPT-3.5、GPT-4)不直接识别字符,底层以 Token 为最小计算单位,输入输出都受 Token 数量限制。因此对接 OpenAI 接口时,基于 Token 计数分割是最精准的方案。
tiktoken 是 OpenAI 官方分词工具,
cl100k_base 是 OpenAI tiktoken 提供的一套 BPE 分词编码规则 ,专门给 gpt-3.5-turbo、GPT-4、OpenAI 向量嵌入模型使用,用来把文字拆成模型能识别的最小单元 Token,词汇表总量约 100256 个。
名字拆解含义
cl= Chat models(对话类模型专用)100k= 词汇表约 10 万条 tokenbase= 基础标准版编码
tiktoken 简单演示代码
python
import tiktoken
# 加载GPT系列通用编码规则
enc = tiktoken.get_encoding("cl100k_base")
# 文本编码为Token数字列表
enc_output = enc.encode("my name is LiHua!")
print(f"编码后的token:{enc_output}")

# 遍历每个Token,还原对应文本片段
for token in enc_output:
    byte_text = enc.decode_single_token_bytes(token)
    real_text = byte_text.decode("utf-8")
    print(f"token:{token} 对应文本片段:{real_text}")
输出结果:
编码后的token:[2465, 836, 374, 14851, 39, 4381, 0]
token:2465 对应文本片段:my
token:836 对应文本片段: name
token:374 对应文本片段: is
token:14851 对应文本片段: Li
token:39 对应文本片段:H
token:4381 对应文本片段:ua
token:0 对应文本片段:!
3.2 LangChain Token 分割器使用
CharacterTextSplitter.from_tiktoken_encoder() 快速创建基于 Token 计数的分割器,底层自动调用 tiktoken 统计 Token 数量,参数 chunk_size 代表 Token 上限。
python
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_text_splitters import CharacterTextSplitter

markdown_path = "../Docs/Markdown/脚手架级微服务租房平台Q&A.md"
loader = UnstructuredMarkdownLoader(markdown_path)
data = loader.load()

# 创建基于tiktoken的Token分割器
text_splitter = CharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base",
    chunk_size=200,    # 单块最大200个token
    chunk_overlap=50   # 块重叠50个token
)

texts = text_splitter.split_documents(data)
# 打印前10个分割结果
for document in texts[:10]:
    print("*" * 30)
print(f"{document}\n")该分割器依旧是软性约束,超长段落不会强制截断,控制台同样会打印 Token 数量超限日志,适合优先保证段落完整、对接 OpenAI 的知识库场景。
基于字符串长度分割和基于Token长度分割的代码写法区别:
一、核心 4 大差异点
1. 长度计算标准(最关键区别)
1)普通写法 length_function=len
- 统计字符个数,中文 1 个字 = 1、英文 1 个字母 = 1、标点 = 1;
- 和模型真实消耗的 token 数量完全无关;
- 适合简单测试、本地开源模型粗略分割。
2)from_tiktoken_encoder() 快捷方法
- 底层自动替换 length_function,使用
tiktoken(cl100k_base)统计GPT 真实 token 数量; - chunk_size=200 代表最多 200 个大模型输入 token;
- 精准匹配 OpenAI GPT3.5/GPT4 上下文窗口,线上生产必用。
2. 分隔符传参方式不同
1)普通构造器 CharacterTextSplitter(separator="\n\n")
- 参数是单个字符串 separator ,仅使用
\n\n这一种分隔符切割; - 没有分层递归逻辑,只会按双换行一刀切;
- 文档一段超长时,不会尝试换行、空格二次分割,直接整块保留。
2)from_tiktoken_encoder 内部自带 separators=["\n\n", "\n", " ", ""] 列表
- 多层优先级分隔符,自动递归切割:先段落
\n\n→ 单行\n→ 空格; - 会多层拆分,尽可能把文本压缩到 chunk_size 以内,语义完整性更好;
- 代码看不到分隔符参数,是方法内部封装写死的。
3. 依赖与适用场景不同
1)普通字符分割
- 无需安装 tiktoken;
- 仅按字符切割,不贴合 GPT 模型限制;
- 适合演示、非 OpenAI 模型、简单短文。
2)tiktoken token 分割
- 必须安装
tiktoken库; - 严格对齐 GPT 输入限制,防止调用接口时报上下文超限;
- 企业 RAG、对接 OpenAI 接口标准写法。
四、硬性长度约束:RecursiveCharacterTextSplitter 递归分割器
4.1 核心优势
前面两种分割器都存在软性约束,会产生超长文本块。如果业务场景严格限制单块长度(比如模型窗口极小、向量库对文 本长度有硬性限制),需要使用 RecursiveCharacterTextSplitter 递归分割器:
- 支持多层级分隔符优先级列表,递归分层切割;
- 硬长度约束 ,所有分割后的文本块长度一定小于等于设定
chunk_size; - 同样支持字符计数、Token 计数两种模式。
默认分隔符优先级:["\n\n", "\n", " ", ""],切割逻辑自上而下递归执行:
- 先用双换行
\n\n按段落切割; - 切割后块仍超限,使用单换行
\n分行切割; - 依旧超限,使用空格分词切割;
- 无可用分隔符时,直接强制截断文本,保证长度合规。
4.2 Token 版递归分割实战代码
python
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

markdown_path = "../Docs/Markdown/脚手架级微服务租房平台Q&A.md"
loader = UnstructuredMarkdownLoader(markdown_path)
data = loader.load()

# 递归式Token分割器,硬约束块长度
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base",
    chunk_size=100,
    chunk_overlap=0,
)

texts = text_splitter.split_documents(data)
# 打印前10个分割结果
for document in texts[:10]:
    print("*" * 30)
    print(f"{document}\n")
运行后不会再输出块超长日志,但会出现完整句子、词语被强制拆分的情况,牺牲部分语义完整性,换取严格统一的文本块长度。
五、中文文档分割优化方案
原生默认分隔符仅适配英文文本,中文长句仅依靠空格、换行分割,极易将完整词语、一句话拆分为零散汉字,破坏语义。 自定义分隔符列表,新增中文句号、逗号,优先按完整句子切割,大幅提升中文知识库分割效果:
python
text_splitter = RecursiveCharacterTextSplitter(
    separators=[
        "\n\n",  # 段落
        "\n",    # 单行
        "。",    # 中文句号,分句
        ",",    # 中文逗号,分句
        " ",
        "",
    ],
    chunk_size=200,
    chunk_overlap=30,
    length_function=len
)
切割优先级:段落 → 单行 → 完整中文句子 → 空格,最大程度保留中文语句完整性。
六、三类分割器选型总结
| 分割器 | 长度计量 | 长度约束 | 适用场景 |
|---|---|---|---|
| CharacterTextSplitter | 字符 len () | 软性,保留超长段落 | Markdown、分段清晰文档,追求完整语义 |
| CharacterTextSplitter(tiktoken) | Token 计数 | 软性 | 对接 GPT 系列模型、段落完整优先 |
| RecursiveCharacterTextSplitter | 字符 / Token 双支持 | 硬性,全部块合规 | 严格限制文本长度、模型窗口小、线上生产强约束场景 |
通用参数配置建议
chunk_size:中文知识库推荐 150~300,Token 模式 100~250;chunk_overlap:设置为 chunk_size 的 1/4 ~ 1/3,平衡上下文完整性与冗余;- 纯中文文档必须自定义分隔符,添加
。,分句符号; - 只要调用 OpenAI 相关模型,优先选用 tiktoken Token 分割,避免上下文超限报错。
结语
文本分割是决定 RAG 问答准确率的关键步骤,没有万能分割器,需要根据文档格式、使用的大模型、业务长度限制灵活选择。分段清晰的 Markdown、问答文档优先使用软性约束分割器保证语义;无分段纯长文本、有严格长度限制场景,选用递归硬约束分割器,并针对中文场景优化分隔符列表,兼顾检索精度与系统稳定性。