YOLOv8 检测项目
本项目基于 YOLOv8 目标检测算法,实现了两个独立的计算机视觉应用场景:
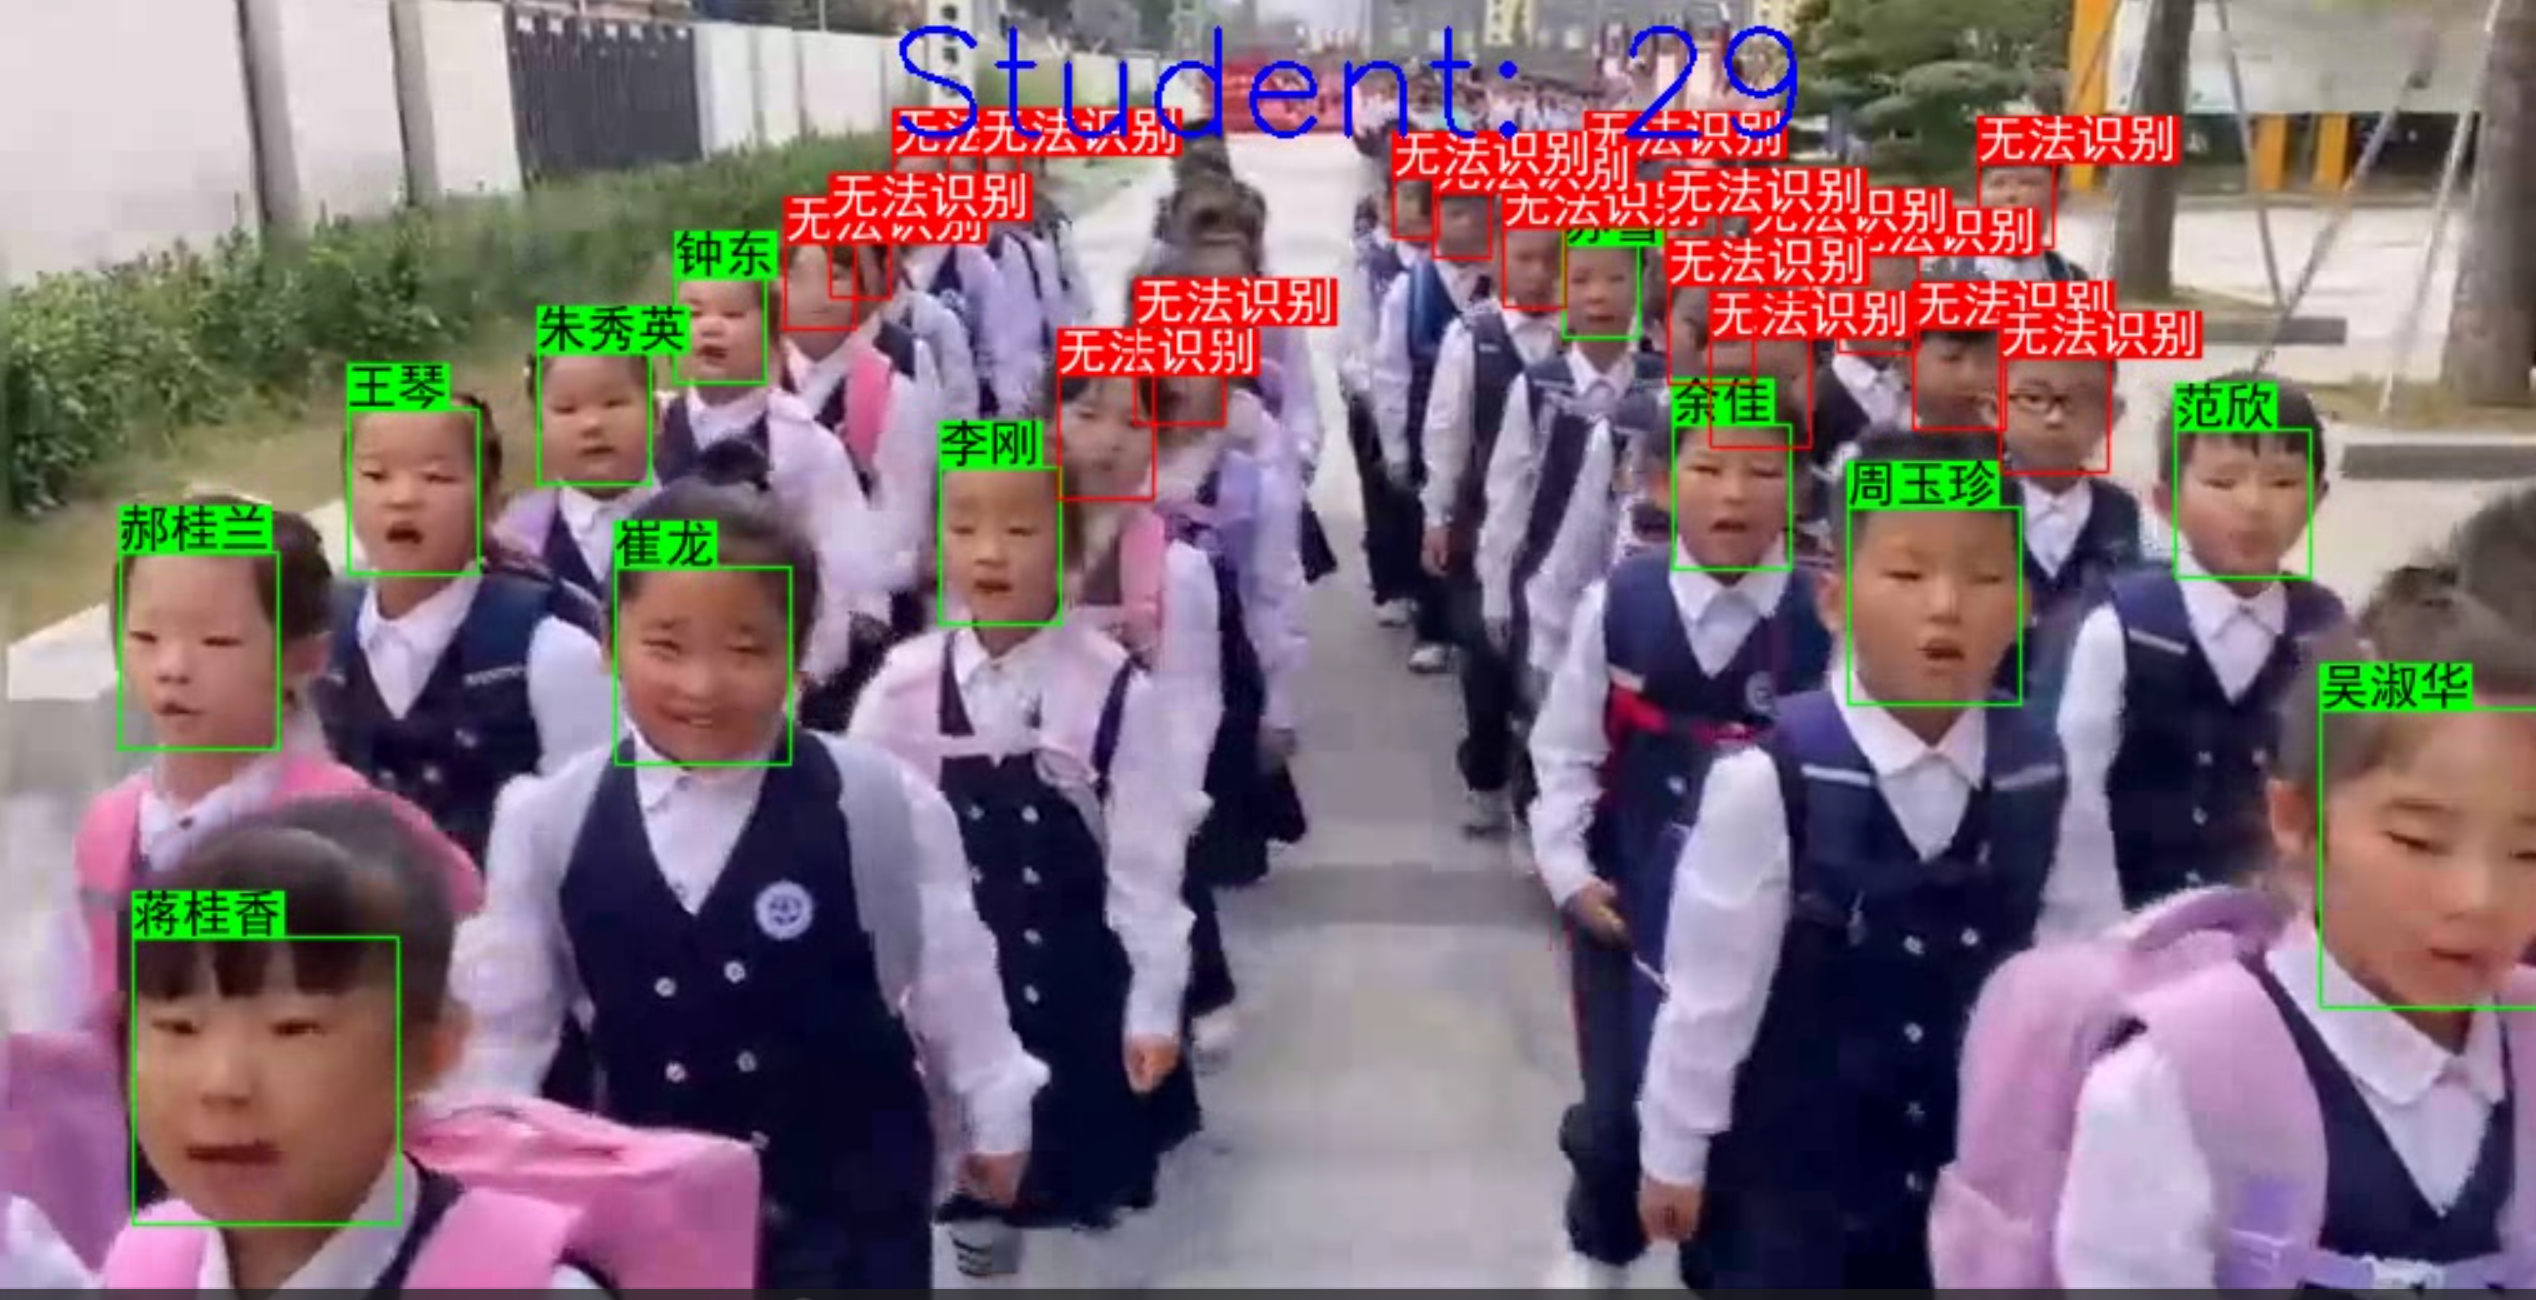
- 智慧校园人脸无感识别检测系统 ------ 对校园门口学生出入视频进行人脸检测、跟踪与识别,并统计可识别人数。
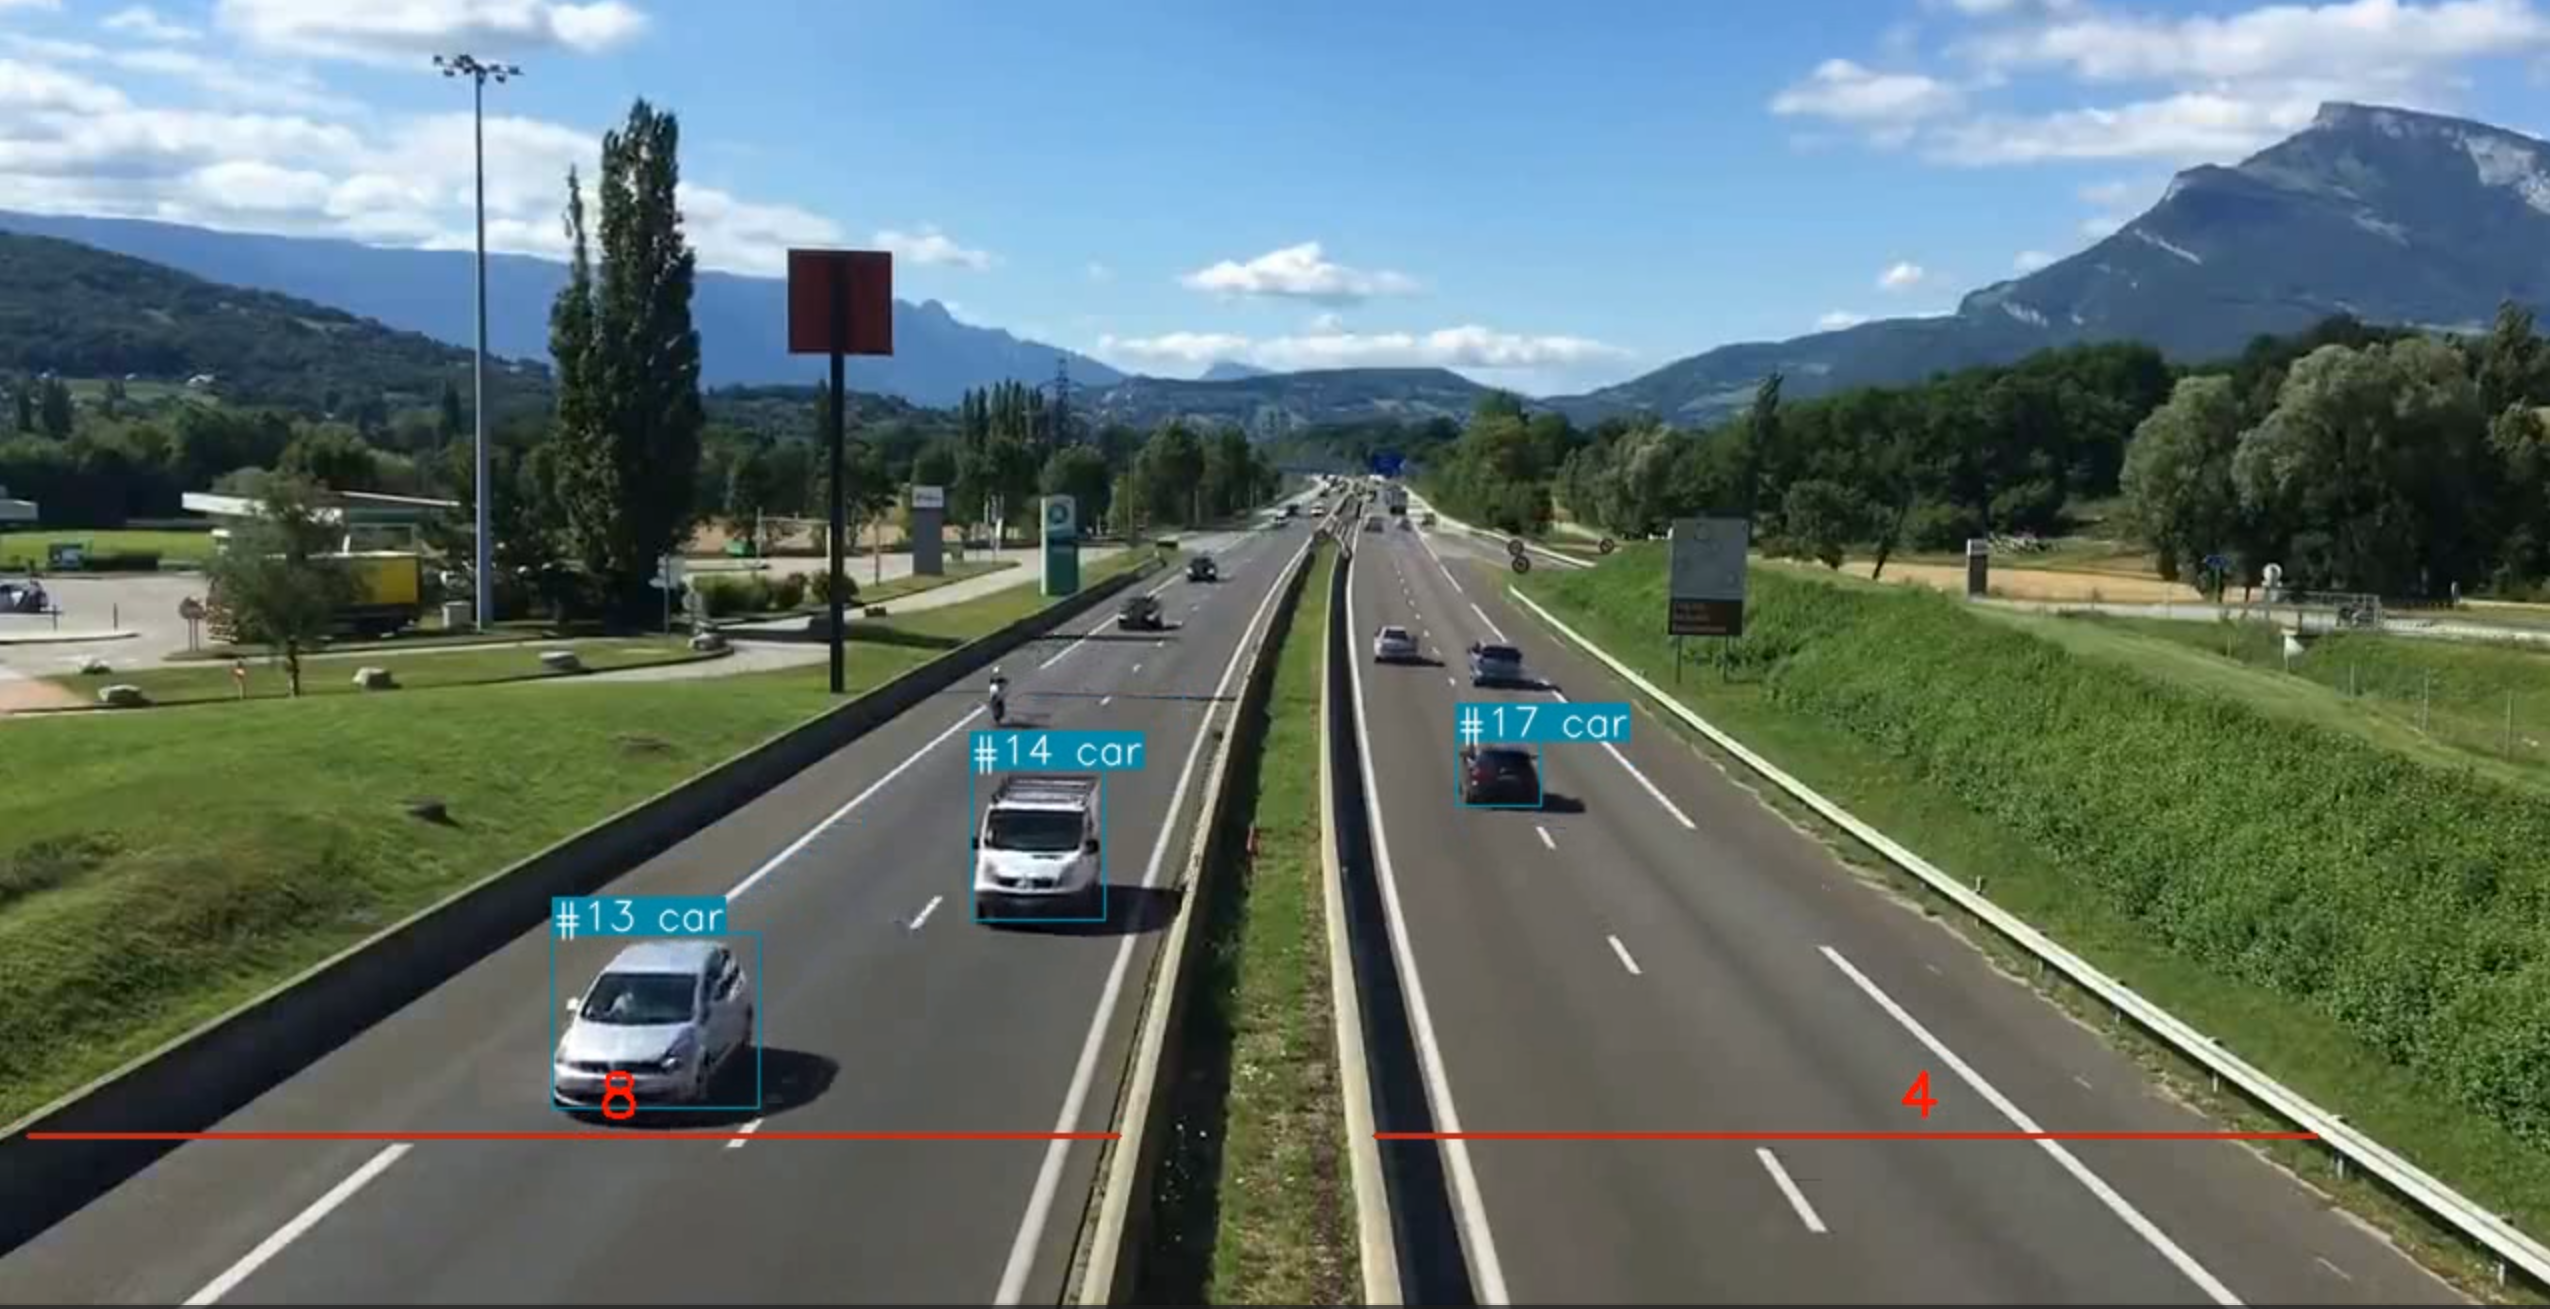
- 公路车辆识别与计数系统 ------ 对道路监控视频中的车辆进行检测、跟踪,并按行驶方向(左/右)统计通过基准线的车辆数量。
一、算法原理
1.1 智慧校园人脸无感识别检测系统(Face_Main.py)
整体流程分为 目标检测 → 目标跟踪 → 人脸特征提取 → 识别判定 四个阶段:
-
人脸检测与跟踪(YOLOv8 + Track)
- 使用 Ultralytics 提供的
yolov8l-face.pt人脸检测模型,对视频逐帧进行推理。 - 调用 YOLOv8 的
track()方法(persist=True),利用内置的多目标跟踪算法(ByteTrack)为每个检测到的人脸分配唯一的 track_id,实现跨帧的人脸持续跟踪。
- 使用 Ultralytics 提供的
-
人脸特征提取(dlib)
- 截取跟踪框内的人脸区域,使用 dlib 的
shape_predictor_68_face_landmarks.dat检测 68 个人脸关键点。 - 再通过
dlib_face_recognition_resnet_model_v1.dat模型将人脸编码为 128 维特征向量。
- 截取跟踪框内的人脸区域,使用 dlib 的
-
识别判定与可视化
- 若能成功提取到人脸特征向量,则认为该人脸可识别,用 绿色框 标注,并将该人脸截图保存至
rec-face/目录(以track_id-姓名.png命名)。 - 若无法提取特征(如侧脸、遮挡、模糊等),则用 红色框 标注并显示"无法识别"。
- 对于已识别过的 track_id,即使后续帧提取不到特征,仍保持绿色框,避免框色反复闪烁。
- 利用
Faker库为每个新出现的 track_id 随机生成中文姓名作为标签。 - 画面顶部实时显示已识别人脸数量(Student 计数)。
- 若能成功提取到人脸特征向量,则认为该人脸可识别,用 绿色框 标注,并将该人脸截图保存至
1.2 公路车辆识别与计数系统(Car_Track.py)
整体流程分为 目标检测 → 目标跟踪 → 轨迹记录 → 越线计数 四个阶段:
-
车辆检测与跟踪(YOLOv8 + Track)
- 使用
yolov8l.pt通用目标检测模型,对视频帧(裁剪至车道区域frame[300:720, 0:1280])进行推理。 - 同样通过
track()为每辆车分配唯一 track_id。
- 使用
-
轨迹记录
- 维护一个
track_history字典,记录每个 track_id 历史帧的中心点坐标(x, y)。
- 维护一个
-
越线计数
- 在画面中设定一条水平基准线(y =
size[1] - 150,即 y=570 附近)。 - 比较同一 track_id 前后两帧中心点 y 坐标与基准线的关系:
- 若前一帧在基准线上方、当前帧在下方 → 车辆 从上往下 行驶,
car_left计数 +1。 - 若前一帧在基准线下方、当前帧在上方 → 车辆 从下往上 行驶,
car_right计数 +1。
- 若前一帧在基准线上方、当前帧在下方 → 车辆 从上往下 行驶,
- 实时显示左右两侧的车辆计数。
- 在画面中设定一条水平基准线(y =
1.3 图像清晰度检测(test.py)
使用 OpenCV 的 拉普拉斯算子(Laplacian) 计算图像的方差,方差越大表示图像越清晰,可用于评估人脸截图质量。
二、环境要求
- 操作系统:Windows / Linux / macOS 均可
- Python 版本:建议 Python 3.8 ~ 3.10
- 主要依赖库:
| 库名 | 用途 |
|---|---|
ultralytics |
YOLOv8 模型推理与跟踪 |
opencv-python |
视频读写、图像绘制 |
numpy |
数值计算 |
Pillow |
中文文本绘制(解决 OpenCV 不支持中文的问题) |
dlib |
人脸关键点检测与特征提取 |
faker |
生成随机中文姓名 |
注意 :
dlib在 Windows 上安装较繁琐,建议使用预编译的 wheel 文件或通过conda install -c conda-forge dlib安装。
三、安装步骤
3.1 创建虚拟环境(推荐)
bash
conda create -n yolo python=3.9 -y
conda activate yolo
3.2 安装依赖
bash
pip install ultralytics opencv-python numpy Pillow faker3.3 安装 dlib
方式一(推荐,conda 源):
bash
conda install -c conda-forge dlib方式二(pip,需要编译环境):
bash
pip install dlibWindows 下 pip 安装 dlib 需提前配置好 CMake 与 Visual Studio C++ 构建工具,否则建议使用 conda 方式。
3.4 准备模型文件
请将以下模型文件放入 model/ 目录(项目已附带):
yolov8l.pt------ YOLOv8 Large 通用检测模型yolov8l-face.pt------ YOLOv8 人脸检测模型yolov8n.pt/yolov8n-face.pt------ Nano 版本(可选,速度更快)shape_predictor_68_face_landmarks.dat------ dlib 68 点人脸关键点模型dlib_face_recognition_resnet_model_v1.dat------ dlib 人脸识别特征提取模型
如需重新下载,可从以下官方地址获取:
- YOLOv8 模型:Ultralytics 官方会在首次运行时自动下载
- dlib 模型:http://dlib.net/files/
四、运行步骤
4.1 智慧校园人脸无感识别检测系统
- 将待检测的视频放入
media/目录,并修改 Face_Main.py(file:///c:/Users/Administrator/Downloads/YOLOv8-Detection-Project-main/Face_Main.py#L28) 中的video_path变量。 - 运行脚本:
bash
python Face_Main.py- 程序会弹出窗口实时显示识别结果,并将处理后的视频保存为
result/Student.mp4。 - 识别到的人脸截图会自动保存到
rec-face/目录。 - 按 ESC 键可提前退出。
4.2 公路车辆识别与计数系统
- 将待检测的视频放入
media/目录,默认读取media/video.mp4,可在 Car_Track.py(file:///c:/Users/Administrator/Downloads/YOLOv8-Detection-Project-main/Car_Track.py#L7) 中修改。 - 运行脚本:
bash
python Car_Track.py- 程序会弹出窗口实时显示车辆跟踪与计数结果,并将处理后的视频保存为
result/car.mp4。 - 按 ESC 键可提前退出。
4.3 图像清晰度检测
bash
python test.py可修改 test.py(file:///c:/Users/Administrator/Downloads/YOLOv8-Detection-Project-main/test.py#L5) 中的图片路径,输出该图像的拉普拉斯方差(清晰度指标)。
五、注意事项
- 视频路径 :Face_Main.py(file:///c:/Users/Administrator/Downloads/YOLOv8-Detection-Project-main/Face_Main.py#L28) 默认读取
media/00009.MTS,请确保该文件存在或自行修改路径,否则会报错。 - 中文字体 :项目使用
SimHei.ttf(黑体)绘制中文姓名,请确保该文件位于项目根目录。 - dlib 安装 :dlib 是人脸识别的核心依赖,安装失败将导致
Face_Main.py无法运行。车辆检测脚本Car_Track.py不依赖 dlib。 - GPU 加速:如配备 NVIDIA 显卡,建议安装 CUDA 版本的 PyTorch 以显著提升推理速度;无 GPU 时将自动使用 CPU,速度较慢。
- 置信度阈值 :两个脚本中
conf=0.3为检测置信度阈值,可根据实际场景调整(值越高误检越少,但可能漏检)。 - 基准线位置 :
Car_Track.py中的基准线 y 坐标(size[1] - 150)和检测区域(frame[300:720, 0:1280])是针对特定视频分辨率(1280×720)设置的,更换视频时需相应调整。 - 输出目录 :运行前请确保
result/和rec-face/目录存在,否则视频写入会失败。 - ESC 退出 :脚本中
cv2.waitKey(30) & cv2.waitKey(1) == 27的写法存在逻辑问题(两次 waitKey 调用),如需稳定退出,建议改为cv2.waitKey(30) == 27。
六、文件夹结构介绍
YOLOv8-Detection-Project-main/
├── img/                          # README 中使用的效果截图
│   ├── 1.png
│   ├── 2.png
│   └── 3.png
├── media/                        # 输入视频存放目录
│   └── video.mp4
├── model/                        # 模型权重与 dlib 模型文件
│   ├── yolov8l.pt                # YOLOv8 Large 通用检测模型
│   ├── yolov8l-face.pt           # YOLOv8 人脸检测模型
│   ├── yolov8n.pt                # YOLOv8 Nano 通用检测模型(可选)
│   ├── yolov8n-face.pt           # YOLOv8 Nano 人脸检测模型(可选)
│   ├── shape_predictor_68_face_landmarks.dat   # dlib 68点人脸关键点模型
│   └── dlib_face_recognition_resnet_model_v1.dat  # dlib 人脸特征提取模型
├── rec-face/                     # 识别到的人脸截图保存目录(track_id-姓名.png)
├── result/                       # 处理后的输出视频目录
│   ├── Student.mp4               # 人脸识别结果视频
│   └── car.mp4                   # 车辆检测结果视频
├── Face_Main.py                  # 智慧校园人脸无感识别检测系统主程序
├── Car_Track.py                  # 公路车辆识别与计数系统主程序
├── test.py                       # 图像清晰度检测脚本(拉普拉斯方差)
├── SimHei.ttf                    # 黑体字体文件,用于中文姓名绘制
└── README.md                     # 项目说明文档
七、效果展示
人脸无感识别检测系统
公路车辆识别系统
源码地址:https://download.csdn.net/download/FL1623863129/90010554?spm=1001.2014.3001.5501