相关链接
论文arXiv地址: https://arxiv.org/abs/2602.16220
开源代码仓库: https://github.com/Meteor-Stars/SEMixer
论文DOI: https://doi.org/10.1145/3774904.3792639
代码及其改进思路讲解:https://space.bilibili.com/51422950?spm_id_from=333.1007.0.0
摘要
建模多尺度模式对长期时序预测至关重要:时间序列在不同时间尺度上呈现出不同的波动,日、月尺度能够揭示小时尺度难以识别的节假日效应与季节性。然而,时序本身的冗余与噪声,加上非相邻尺度之间的语义鸿沟,使多尺度时间依赖的高效对齐与整合十分困难。
为解决这一问题,作者提出轻量级多尺度模型SEMixer,包含两个关键组件:其一是随机注意力机制RAM,训练时捕捉多样的时间patch交互、推理时通过dropout ensemble加以聚合,增强patch级语义,使MLP-Mixer能更好地建模多尺度依赖;其二是多尺度渐进混合链MPMC,以节省内存的方式堆叠RAM与MLP-Mixer,只对相邻尺度做两两拼接混合,实现更有效的时间混合,弥合跨尺度语义鸿沟。
作者不仅在10个公开数据集上验证了SEMixer的有效性,还在2025年CCF AIOps挑战赛基于21GB真实无线网络数据的任务中取得第三名;公开数据集上其MSE比现有模型低5%至15%。
Q1:这个模型试图解决什么问题?
核心问题是:多尺度建模虽能同时捕捉短期变化与长期趋势,但同时处理多种分辨率会带来随输入长度和模型深度快速增长的计算与内存开销,且时序高冗余、高噪声、非相邻尺度(如小时与月)之间存在语义鸿沟,导致多尺度依赖难以被高效对齐与整合;现有多尺度模型在短输入时表现好、输入变长后性能反而退化。
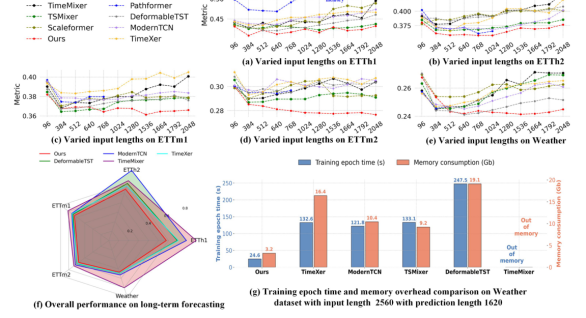
图注: 动机与整体表现。(a)-(e)在ETTh1、ETTh2、ETTm1、ETTm2、Weather上,考察各多尺度与单尺度模型能否从更长历史序列(96至2048)受益,纵轴为MSE/MAE;(f)长期预测整体表现雷达图;(g)Weather上输入2560、预测1620时各模型的单轮训练时间与内存开销。
1. **挑战①:多分辨率同时建模开销巨大:**在单张3090(24GB)上,基于Transformer的多尺度模型Pathformer即使在小规模ETTh上也会显存溢出;基于MLP的TimeMixer虽更高效,内存开销仍明显高于TimeXer、ModernTCN、TSMixer等单尺度模型,这限制了对准确预测至关重要的长历史序列的使用;
2. **挑战②:冗余、噪声与语义鸿沟:**时间序列常含大量冗余与噪声,而非相邻尺度(如小时与月)反映的是不同的底层动态、存在语义鸿沟;如图1(a)-(e)所示,现有多尺度模型在短输入时表现不错,但随输入变长性能退化,说明关键信号可能在长序列中被稀释;
3. **图1(g)的效率对比:**在Weather(输入2560、预测1620)上,SEMixer单轮训练仅约24.6秒、内存约3.2GB,而TimeXer约132.6秒/16.4GB、ModernTCN约121.8秒/10.4GB、TSMixer约133.1秒/9.2GB、DeformableTST约247.5秒/19.1GB,TimeMixer直接显存溢出,体现SEMixer在精度与效率上的双重优势。
Q2:相关研究
单尺度长期预测模型
得益于自注意力对长程依赖的建模能力,Pathformer、MLF、PatchTST等一系列基于Transformer的模型被提出;但也有研究指出高成本的自注意力在时序预测中并非必要,于是出现了基于简单线性层或MLP(如DLinear、TSMixer)、基于CNN(如ModernTCN、TimesNet、DeformableTST)以及以交叉注意力为核心(如TimeXer)的高效模型。这些工作大多只在单一尺度上建模。
多尺度长期预测模型
多尺度预测模型相对较少,可分为两类:基于Transformer的方法中,Pyraformer用下采样构建多尺度表示,Scaleformer以逐步细化的方式在越来越细的尺度上渐进预测,PathFormer则根据时间动态自适应地抽取与聚合多尺度特征;基于MLP的方法中,FiLM通过勒让德多项式与傅里叶投影整合多尺度信息,TimeMixer把序列分解为趋势与季节成分分别混合,TimeMixer++把多尺度序列转为多分辨率时间图像、用2D-CNN配合双轴自注意力,长序列上不可避免地带来较高内存与计算开销。
作者强调,尽管已有上述多尺度方法,SEMixer是首个提出MPMC结构的工作:它针对跨尺度语义鸿沟与模型开销,对相邻尺度做渐进式两两混合,在使用更长输入进行长期预测时兼具精度与效率优势。
Q3:作者是如何解决的?
结构总览
SEMixer建立在计算机视觉领域广泛使用的轻量MLP-Mixer之上,整体流程为:历史输入先经多尺度编码块处理成S组多尺度patch表示,再由多尺度渐进混合链MPMC从最细尺度到最粗尺度逐步做时间混合,每个时间混合块包含随机注意力RAM、patch间混合与patch内混合,最后把各尺度输出整合、展平并由线性预测头输出未来序列。
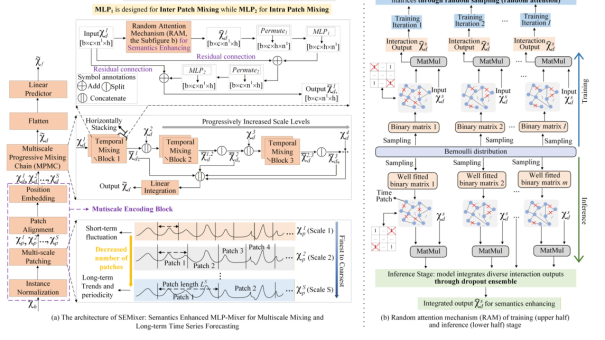
图注: SEMixer组件。(a)整体架构,含多尺度编码块(实例归一化、多尺度patching、patch对齐与位置嵌入)、MPMC与时间混合块;(b)随机注意力机制RAM,上半为训练阶段(按伯努利分布采样二值矩阵、随机切断patch交互),下半为推理阶段(通过dropout ensemble聚合多样交互输出)。
多尺度编码块
实例归一化:先对历史输入做Instance Norm以缓解训练与测试间的分布偏移,得到长度为n、含c个变量的Xh。
多尺度patching:把Xh按S组不同的patch长度L与步长K逐步切块,生成多尺度输入Xp^s=Patchify(Xh,Ls,Ks)(式1);其中Ls=αs·L1、Ks=Ls/2(式2),patch数Ns=⌊(n−Ls)/Ks⌋+2(式3)。最细尺度的patch长度为L1、步长K1=L1/2,其余尺度由尺度因子αs推算。细尺度(较小的L与K)捕捉局部模式与高频波动,粗尺度捕捉全局趋势与周期性。
patch对齐与位置嵌入:每个尺度的patch先经Patch Alignment从长度Ls线性投影到统一维度D,以便后续两两拼接;由于随机注意力忽略位置信息,又在对齐后加入可学习位置嵌入Xd^s=Xp^s·Wp+Wpos(式4)。
随机注意力机制RAM:训练阶段
先定义元素全为1的全交互矩阵Â∈R^(Ns×Ns),表示任意两个patch之间都存在交互;每次训练迭代从伯努利分布随机采样一个二值矩阵M∈{0,1}^(Ns×Ns)作为掩码,随机切断patch之间的交互,即M∼B(p),其中p(本文固定为0.85)表示第i、j个patch之间连接被切断的概率。训练时X̂d^s=(M⊙Â)Xd^s(式5),迫使可学习参数去隐式拟合大量随机采样的二值矩阵,从而诱导出多样的patch交互;这些被良好拟合的二值矩阵在收敛后有效增强了patch语义。
RAM:推理阶段与dropout ensemble
推理时,通过采样并聚合训练中学到的全部二值交互矩阵来整合输出X̂d^s=(1/m)·∑MiÂXd^s(式6)。幸运的是RAM与Dropout原理相似:Dropout在训练时随机停用神经元、隐式训练了多个子网络,推理时所有神经元激活、再按保留概率缩放输出,近似多个子网络的集成效果。这里p为断连概率、保留概率为1−p,因此式6可近似为X̂d^s=·Xd^s·(1−p)(式7)。
相比标准自注意力SAM,RAM避免了query-key点积、更加高效;不同于多头SAM头数有限,RAM拟合并集成了数量庞大的交互矩阵(每个都可视作一个头),既能学到充足的有效交互,又不会被噪声交互主导。
局限与残差设计
RAM隐含假设patch与通道之间存在有意义的相关;在多数数据集上它能有效增强语义,但当相关较弱时可能引入噪声。为此作者加入残差连接:在利用有益相关的同时,防止相关较弱时性能退化。
多尺度渐进混合链MPMC
MPMC用于堆叠RAM与MLP-Mixer:它不一次性拼接全部尺度,而是通过相邻尺度输入的两两拼接来做时间混合,并逐步增加参与的尺度数。具体地(算法1),s=1时直接对最细尺度X1做时间混合;s>1时,先把上一尺度混合输出X̄^(s−1)*与当前尺度Xs拼接,经时间混合后再用Split切出当前尺度特征X̄^s*,如此从最细到最粗逐步推进。
相比直接拼接全部尺度,这种两两渐进策略降低了长序列处理的内存开销,并缓解了非相邻尺度模式差异带来的语义噪声,使模型更好地学习与区分多尺度表示。各尺度输出拼接后经线性层降维整合得到X̃d,展平后由线性预测头预测未来值,并以MSE损失优化。
Q4:实验效果如何?
数据集、指标与基线
实验在10个广泛使用的公开长期预测数据集上进行,覆盖工业(ETTh1、ETTh2、ETTm1、ETTm2四个子集)、气候(Weather)、能源(Solar Energy、Electricity)、健康(流感样疾病ILI)、经济(Exchange)与交通(Traffic),采用MSE与MAE评估多变量长期预测。此外还参加了2025年CCF AIOps挑战赛:训练集含26000个4G无线小区(21GB)、为期三周、15分钟间隔,任务是为1000个小区预测次日KPI趋势(96步)。
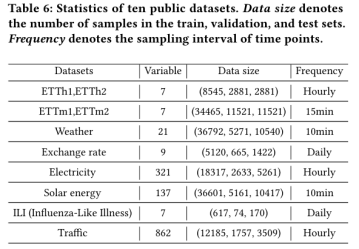
图注: 十个公开数据集统计。Data size为训练、验证、测试集的样本数,Frequency为时间点采样间隔;ETT为小时级/15分钟级,Weather与Solar为10分钟级,Electricity与Traffic为小时级,ILI、Exchange为日级。
基线共12个、分五类:多尺度Transformer(Pathformer、Scaleformer)、多尺度线性模型(FiLM、TimeMixer)、单尺度Transformer(TimeXer、PatchTST、iTransformer)、单尺度线性模型(TSMixer、DLinear)、基于CNN的模型(DeformableTST、ModernTCN、TimesNet)。实现上隐藏维D=128、整合维64、最细尺度patch数N1=64、尺度数S=4、尺度因子α2/α3/α4=2/4/8、断连概率p=0.85;除固定输入长度(512、2048、2560)外,还在96至2048的集合中搜索最优输入长度,所有模型训练30轮(Traffic为50轮)。
主结果:公开数据集
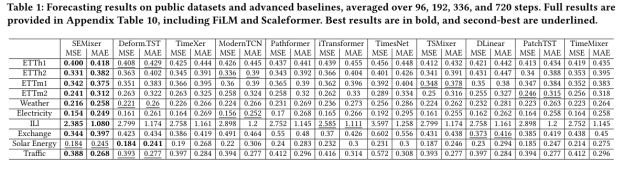
图注: 公开数据集主结果,96、192、336、720四种预测步长的平均,最优加粗、次佳下划线。SEMixer在ETTh1(0.400/0.418)、ETTh2(0.331/0.382)、ETTm1(0.342/0.375)、ETTm2(0.241/0.312)、Weather(0.216/0.258)、ILI(2.385/1.080)、Exchange(0.344/0.397)、Solar(0.184/0.245)、Traffic(0.388/0.268)、Electricity(0.154)等几乎所有数据集上领先。
Table1表明SEMixer取得了最优的长期预测性能,MSE比现有模型低5%至15%:MPMC通过同时建模短期波动与长期趋势---周期高效处理长序列,渐进交互链弥合了跨尺度语义鸿沟,RAM则通过多尺度随机交互增强时间patch语义,进一步释放MLP-Mixer的潜力。
主结果:更长输入与更长预测
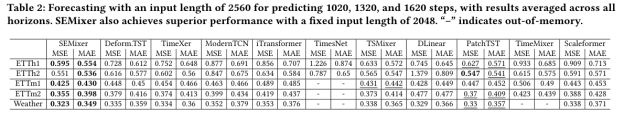
图注: 输入长度2560、预测1020/1320/1620步的结果(在各步长上平均),"-"表示显存溢出。SEMixer在ETTh1(0.595/0.554)、ETTh2(0.551/0.536)、ETTm1(0.425/0.430)、ETTm2(0.355/0.398)、Weather(0.323/0.349)上仍保持领先,且在固定输入2048时同样最优。
当输入与预测长度同时增大时,SEMixer一致保持显著优势,验证了其在超长设置下的鲁棒性与有效性,而TimesNet、iTransformer、TimeMixer等在部分长预测场景出现显存溢出。
主结果:2025年CCF AIOps挑战赛
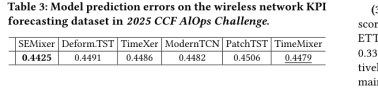
图注: 无线网络KPI预测数据集上的模型预测误差。SEMixer为0.4425,低于DeformableTST(0.4491)、TimeXer(0.4486)、ModernTCN(0.4482)、PatchTST(0.4506)与TimeMixer(0.4479),在所有参赛者中误差最低,最终获得第三名。
挑战赛中所有结果均通过向官方评测平台提交预测得到,批量大小、学习率、输入长度与损失函数等设置完全一致,仅模型结构不同,SEMixer取得最低预测误差。
消融一:替换不同注意力机制
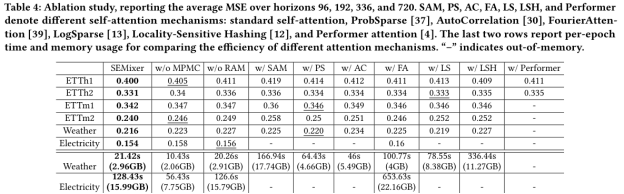
图注: 消融研究,报告96/192/336/720的平均MSE。除完整SEMixer外,分别去除MPMC、去除RAM,或用标准自注意力SAM、ProbSparse(PS)、AutoCorrelation(AC)、傅里叶注意力(FA)、LogSparse(LS)、局部敏感哈希(LSH)、Performer替换RAM;末两行给出单轮时间与内存。
完整SEMixer在ETTh1(0.400)、ETTh2(0.331)、ETTm1(0.342)、ETTm2(0.240)、Weather(0.216)、Electricity(0.154)上均为最优;去除MPMC或RAM后误差普遍上升。效率上,在Weather上完整SEMixer约21.42秒/2.96GB,w/o RAM约10.43秒/2.06GB,w/SAM约20.26秒/2.91GB,而w/PS高达166.94秒/17.74GB、w/Performer达336.44秒/11.27GB;在Electricity上,PS、AC、FA、LSH、Performer等多个变体显存溢出,SEMixer仍能以约128.43秒/15.99GB正常运行。
消融二:patch嵌入的t-SNE可视化
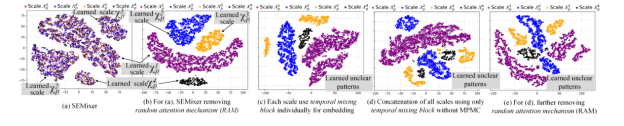
图注: 在Weather测试集、预测长度720下,对4个尺度输入学到的共12000个patch嵌入做t-SNE。(a)完整SEMixer;(b)只用MPMC、去除RAM;(c)每个尺度单独用时间混合块;(d)去除MPMC、直接拼接全部尺度;(e)在(d)基础上再去除RAM。
如图3(b),只用MPMC(无RAM)时模型学到四个清晰分离的尺度簇;去除MPMC后模式变得模糊(图3(c,d)),验证MPMC对多尺度表示学习的作用;在图3(e)中进一步去除RAM后表征继续退化。更重要的是,当RAM与MPMC同时启用(图3(a)),各尺度簇既彼此区分又良好融合,说明跨尺度交互让每个尺度都能利用其他尺度的信息,实现了有效的多尺度融合。
消融三:随机断连概率p的敏感性
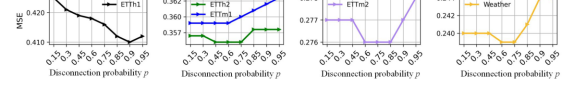
图注: 在各数据集上对随机断连概率p的超参分析,横轴为p(0.15至0.95)、纵轴为MSE。p较小时大部分交互被保留、但采样到的交互模式多样性下降,限制了RAM的集成效果;p过大时交互图变得高度稀疏,虽增加多样性却可能移除过多有用连接、削弱相关patch间的语义传播。
总体上SEMixer在很宽的p范围内都相对稳定,说明RAM对该超参并不敏感;经验上p约0.85时各数据集表现都很强,在交互多样性与语义信息保留之间取得良好折中,因此所有实验统一取p=0.85。
消融四:MPMC结构的进一步对比
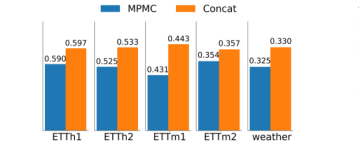
图注: MPMC结构的进一步消融,在2048与2560两种序列长度下、对1020/1320/1620三个预测步长取平均MSE。蓝色为MPMC、橙色为直接拼接(Concat):ETTh1为0.590对0.597、ETTh2为0.525对0.533、ETTm1为0.431对0.443、ETTm2为0.354对0.357、Weather为0.325对0.330,渐进式MPMC在所有数据集上都优于直接拼接。
消融五:更长设置下的进一步消融与噪声鲁棒性
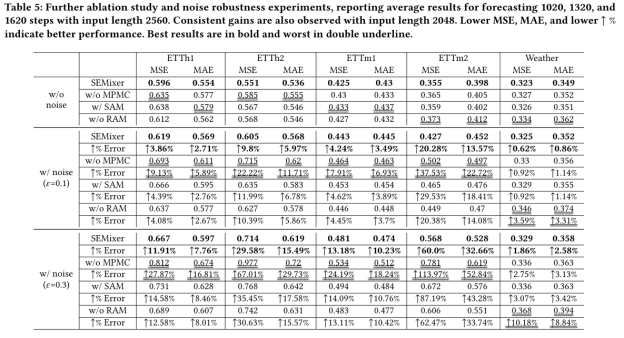
图注: 进一步消融与噪声鲁棒性实验,输入长度2560、对1020/1320/1620取平均;分无噪声、注入噪声ε=0.1与ε=0.3三组,每组对比完整SEMixer、w/o MPMC、w/SAM、w/o RAM,并给出相对无噪声基线的误差上升百分比↑%。
无噪声时去除MPMC或RAM都会使预测误差显著上升。噪声设置上,作者向测试样本注入幅度为ε×100%、范围在−2X,2X内的噪声,模拟噪声强度随原始信号幅度变化的异方差噪声。以ε=0.3为例,完整SEMixer在ETTh1、ETTh2、ETTm1、ETTm2、Weather上MSE分别上升约11.91%、29.58%、13.18%、60%、1.86%,而w/o MPMC分别上升约27.87%、67.01%、24.19%、113.97%、2.75%,去除MPMC后误差大增,说明MPMC通过放大跨尺度一致特征(如共享趋势)并抑制噪声,是抗噪的关键。
相比标准SAM,RAM因在训练中学到多样交互、降低了噪声交互的影响而更抗噪,SAM有限的头则容易过拟合噪声;这进一步证明RAM在增强性能、降低开销与提升鲁棒性上的作用。
附录:不同尺度输入与完整结果
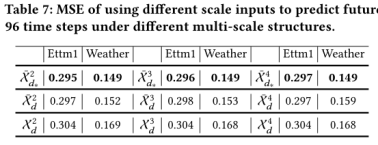
图注: 用不同尺度输入预测未来96步的MSE(在ETTm1与Weather上)。带s下标的多尺度渐进模型(X̃d^s)在各尺度上误差最低且稳定(如ETTm1约0.295至0.297、Weather约0.149),而只用单一尺度(Xd^s)误差更高(约0.304/0.168),验证多尺度渐进混合的有效性。
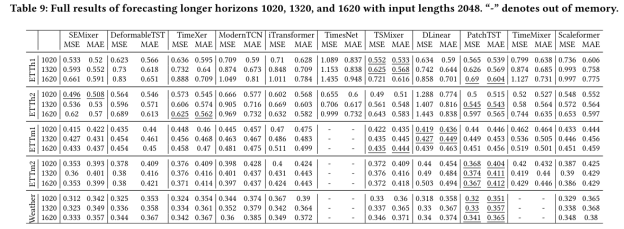
图注: 更长预测(1020/1320/1620、输入2048)的完整逐模型结果,"-"为显存溢出。可见TimesNet与iTransformer在ETTm1、ETTm2长预测上溢出,TimeMixer在ETTm2与Weather长预测上溢出、PatchTST在Weather长预测上溢出,而SEMixer在全部场景均可运行且多数最优。
此外,附录Table8与Table10给出96/192/336/720四个步长的逐格完整结果(分Part1、Part2),Table11给出长预测的完整结果,输入长度均在96至2048中搜索;这些明细表与Table1、Table2的平均结论一致,SEMixer在大多数数据集---步长组合上排名第一。
Q5:有哪些可以继续探索的点?
1. **非相邻尺度的直接建模:**MPMC出于内存与语义噪声考虑只对相邻尺度做两两混合,非相邻尺度(如小时与月)之间只能间接传递信息;可探索在控制开销的前提下让非相邻尺度更直接交互的机制;
2. **RAM的理论与交互先验:**RAM与dropout ensemble的等价性目前主要是经验性近似,可进一步从理论上刻画其集成的交互矩阵数量、多样性与泛化之间的关系,或为二值掩码引入结构先验而非纯随机采样;
3. **尺度因子与尺度数的自适应:**目前尺度数S=4与尺度因子α=2/4/8为固定配置,不同数据集的最优尺度结构可能不同,可发展根据序列长度、周期与噪声水平自适应确定尺度的方法;
4. **向多模态与事件信息扩展:**可把文本事件、节假日标注等外部信息作为额外"尺度"或语义信号纳入RAM与MPMC,并研究多尺度语义在跨数据集、跨预测步长下的可迁移性。
Q6:总结
SEMixer是一个面向长期时序预测的轻量多尺度模型,建立在MLP-Mixer之上,核心是两个组件:随机注意力RAM在训练时通过随机切断patch交互学到大量多样的交互矩阵、推理时以dropout ensemble聚合,增强patch语义、提升MLP-Mixer的有效性;多尺度渐进混合链MPMC只对相邻尺度做两两拼接、从最细到最粗逐步混合,显式降低计算开销与跨尺度语义噪声,而RAM提供的语义增强又帮助MPMC更好捕捉多尺度依赖。
在10个公开数据集上,SEMixer的MSE比现有模型低5%至15%,并在2025年CCF AIOps挑战赛上获得第三名;在注意力替换、t-SNE可视化、概率p敏感性、MPMC结构、噪声鲁棒性以及超长预测等多组实验中一致占优,验证了"以随机注意力增强语义、以渐进链高效混合多尺度"这一思路对提升长期预测精度、效率与鲁棒性的关键作用。