问题定义
一个内容生产项目里有三类语音需求:文案转配音、录音转带说话人标签的文字稿、以及"图片进去、语音出来"的交互 demo。
各找一套工具就是三套 SDK、三份密钥、三种错误码,中间还要自己写胶水代码搬文件。我把三类需求收敛到同一个 CLI(bl,npm 包名 bailian-cli,1.22.0)上跑了一遍,这篇记录分层结构、参数细节、计费口径,以及两个我真实撞到的报错和它们的工程含义。
命令签名以 bl <group> <command> --help 输出为准,价格以 bl model list 的实时返回为准,音色清单以 --list-voices 实测输出为准。
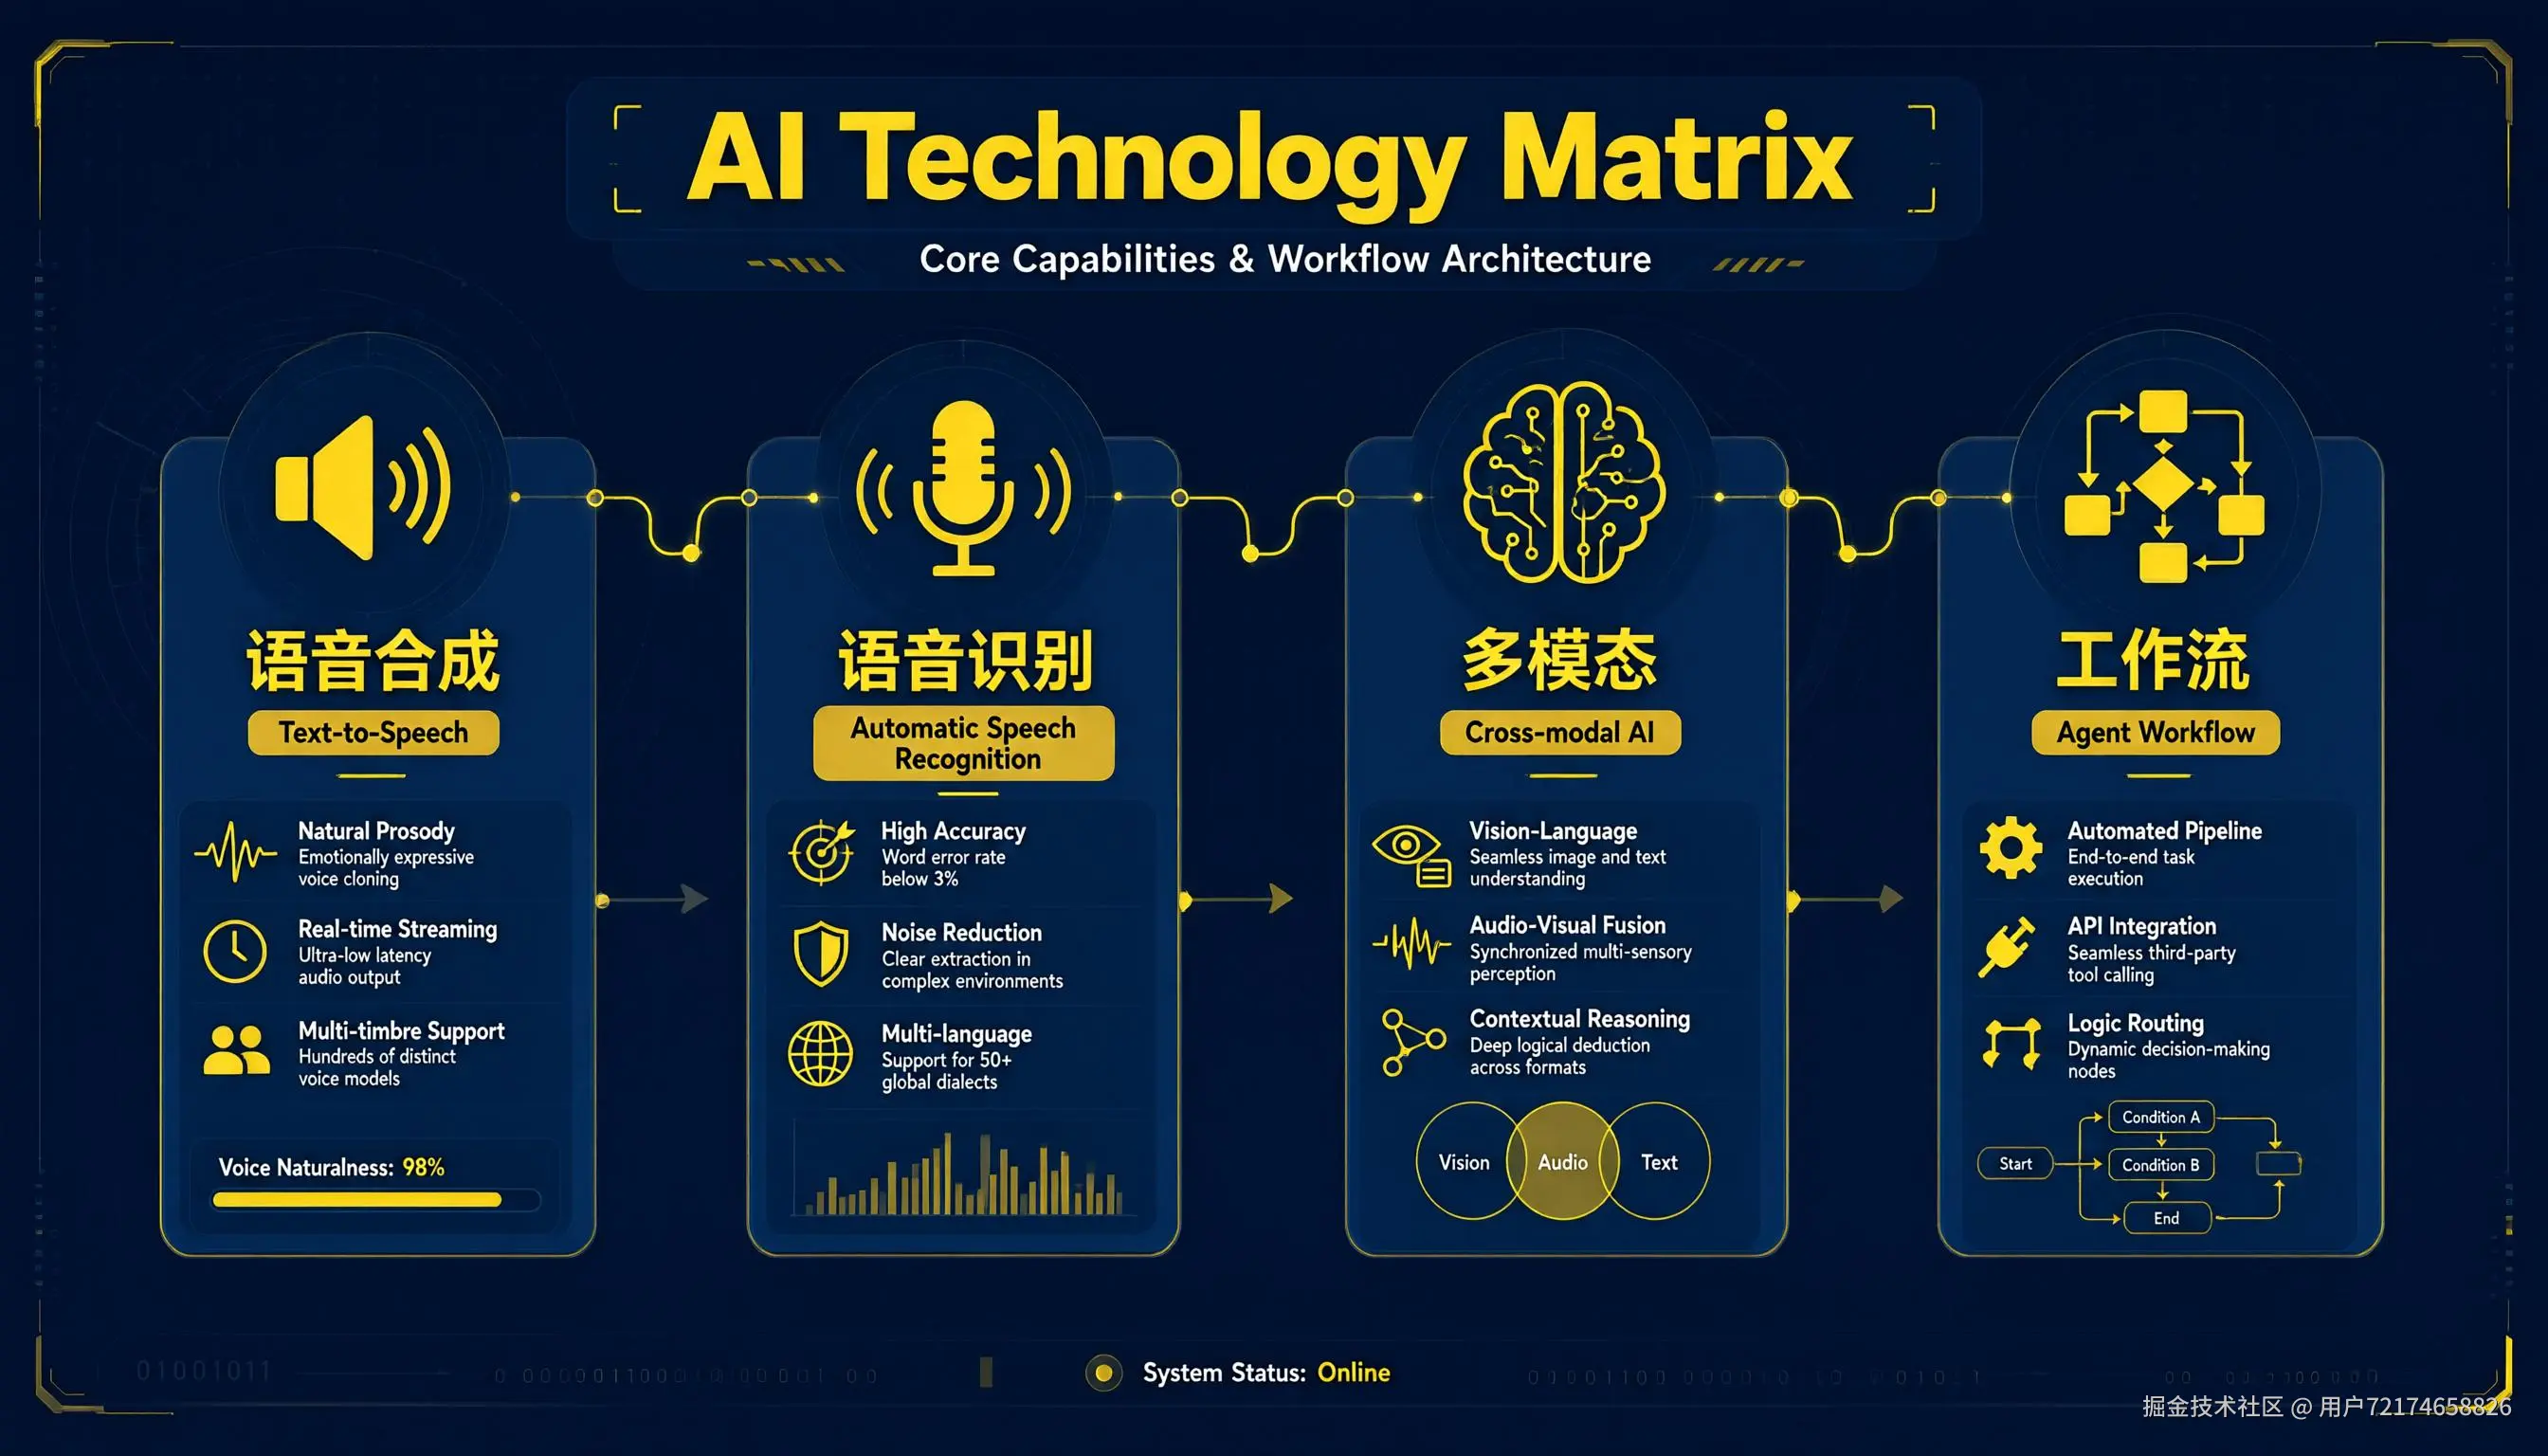
分层:四个位置,三种计价单位
| 层 | 命令入口 | 默认模型 | 计价单位 | 鉴权 |
|---|---|---|---|---|
| 合成层 TTS | bl speech synthesize |
profile 配置的 TTS 模型,未配置则 cosyvoice-v3-flash | 每万字符 | API Key |
| 识别层 ASR | bl speech recognize |
profile 配置的 ASR 模型,未配置则 fun-asr | 每秒 | API Key |
| 交互层 Omni | bl omni |
qwen3.5-omni-plus | 每百万 token | API Key |
| 编排层 Pipeline | bl pipeline run / validate |
无 | 自身不计费 | No Auth |
安装与鉴权:
bash
npm install -g bailian-cli
bl skill init
bl auth login --api-key sk-xxxxx
bl auth status
Node 版本要求 18.17 以上。不走 npm 的话,macOS/Linux 有安装脚本 curl -fsSL https://bailian.aliyun.com/cli/install.sh | bash,Windows PowerShell 用 irm https://bailian.aliyun.com/cli/install.ps1 | iex。安装说明在 CLI 页面。
bl auth status 会打印当前 profile、配置文件路径和凭证类型。后面两个报错都跟 profile 里的默认值有关,这一步值得先看一眼。
合成层:音色是模型级资源,不是全局资源
参数矩阵
来自 bl speech synthesize --help:
| 参数 | 取值 | 默认 | 说明 |
|---|---|---|---|
--text / --text-file |
字符串 / 路径 | 二选一 | 长文本走文件 |
--model |
模型 ID | profile 配置,否则 cosyvoice-v3-flash | 帮助原文:System voices vary by model |
--voice |
音色 ID | 无 | v3-flash 用内置音色;v3.5-flash 需 clone/design 音色 ID |
--list-voices |
开关 | 关 | 列出所选模型的内置音色后退出 |
--format |
mp3/pcm/wav/opus | mp3(流式默认 pcm) | 输出格式 |
--sample-rate |
如 24000 | 模型默认 | 采样率,改了这个流式播放参数要跟着改 |
--volume |
0-100 | 50 | 音量 |
--rate |
0.5-2.0 | 1.0 | 语速 |
--pitch |
0.5-2.0 | 1.0 | 音调 |
--seed |
0-65535 | 无 | 固定种子,同输入同输出 |
--language |
zh/en/ja/ko/fr/de | 无 | 语言提示 |
--instruction |
自然语言 | 无 | 风格指令 |
--enable-ssml |
开关 | 关 | SSML 解析 |
--out |
路径 | 临时目录自动生成 | 落盘位置 |
--stream |
开关 | 关 | 裸 PCM 到 stdout |
--concurrent |
N | 1 | 并行请求数 |
音色清单实测
bash
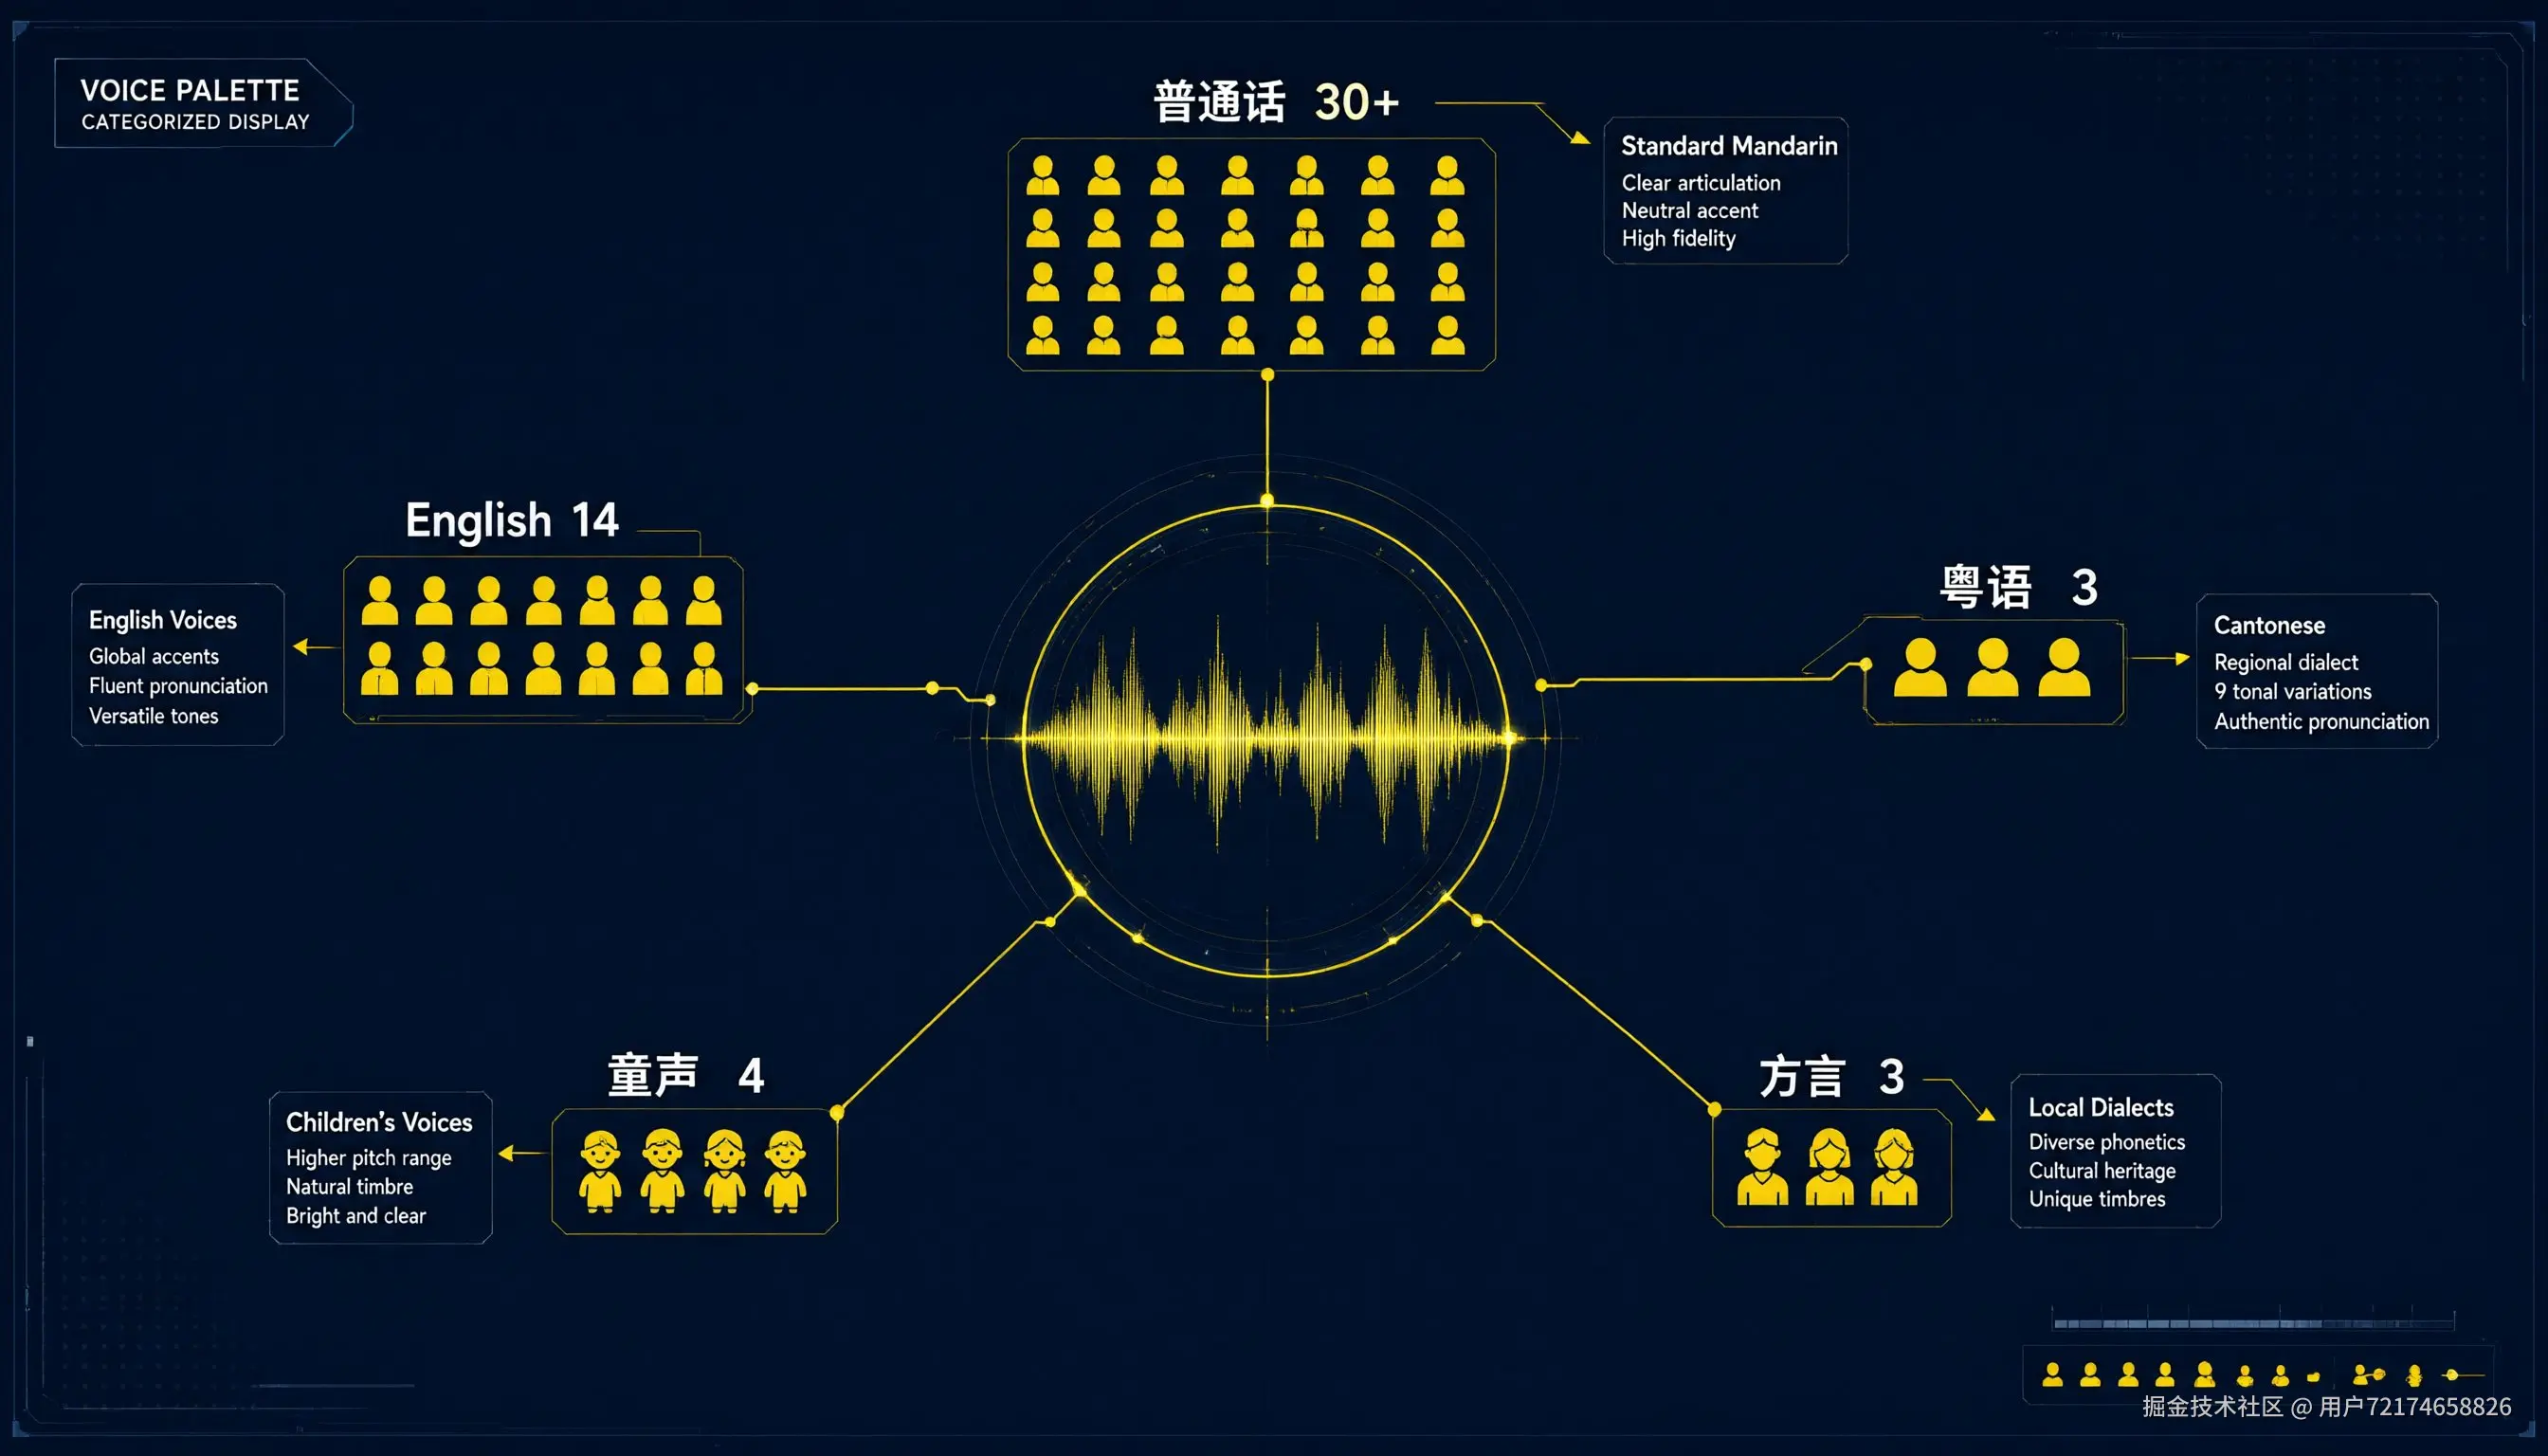
bl speech synthesize --list-voices --model cosyvoice-v3-flash输出末尾 Total: 64 voices,四列:VOICE ID / NAME / DESCRIPTION / LANGUAGE。分组统计:
| 分组 | 数量 | 备注 |
|---|---|---|
| 中文/英文 | 36 | 含童声 4(longhuhu_v3/longpaopao_v3/longshanshan_v3/longniuniu_v3)、台式 1(longantai_v3) |
| 粤语 | 3 | longjiaxin_v3/longjiayi_v3/longanyue_v3 |
| 方言 | 3 | longlaotie_v3 东北、longshange_v3 陕西、longanmin_v3 闽南 |
| 美式英语 | 10 | loongabby_v3 起 |
| 英式英语 | 4 | loongemily_v3/loongeric_v3/loongluna_v3/loongluca_v3 |
| 日语 | 5 | 含 loongriko_v3(Riko,二次元霓虹女) |
| 韩语 | 2 | loongkyong_v3/loongjihun_v3 |
| 印尼语 | 1 | loongindah_v3 |
命名规律有一个例外:longanyang 不带 _v3 后缀,其余中文音色基本都带。按规律补后缀会得到一个不存在的 ID。
方言音色是这套清单里工程价值最高的部分。区域性内容(地方文旅、农机、方言短剧)不需要额外训练或找外包,直接换 ID。
报错 1:411,默认值是隐藏状态
bash
bl speech synthesize --text "测试" --voice longcheng_v3 --out t1.mp3
less
[Model: qwen-audio-3.0-tts-plus] [Voice: longcheng_v3]

Error:       [cosyvoice:]Engine error [411]: TTS speak operation failed
Status:      HTTP 400 (InvalidParameter)
Exit code:   1
longcheng_v3 是 cosyvoice 系音色,而请求实际发给了 qwen-audio-3.0-tts-plus。bl config show 里能看到 profile 配了 default_speech_model: qwen-audio-3.0-tts-plus,它接管了 --model 的默认值。换四个音色名重试都是 411,说明不是单个 ID 的问题。
工程结论有两条。第一,--model 的默认值来自本地配置而不是命令本身,这类"配置驱动的默认值"在脚本里等于隐藏状态,CI 环境和开发机可能给出不同结果,所以我在脚本里固定显式声明:
bash
bl speech synthesize --model cosyvoice-v3-flash --text "测试" --voice longcheng_v3 --dry-run第二,一次性修掉的办法是改配置,default_*_model 是 bl config set --help 列出的合法 key:
bash
bl config set --key default_speech_model --value cosyvoice-v3-flash--dry-run 是全局 flag,打印请求体但不发起调用,排查这类问题零成本:
yaml
request:
  model: qwen-audio-3.0-tts-plus
  input:
    text: 测试
    voice: longcheng_v3
    format: mp3
流式输出:一条管道省掉临时存储
bash
bl speech synthesize --model cosyvoice-v3-flash --text "Hello" --voice loongabby_v3 --language en --stream | ffplay -nodisp -autoexit -f s16le -ar 24000 -ac 1 -macOS 上管道接 afplay - 即可。--stream 输出裸 PCM,不落盘,两个用途:批量试听音色不留垃圾文件;生产环境里直接接 WebSocket 推给前端,链路上不需要临时对象存储,也就没有清理和鉴权问题。注意 -f s16le -ar 24000 -ac 1 要和实际采样率对齐,改了 --sample-rate 这里要跟着改。
批量生产
bash
bl speech synthesize --model cosyvoice-v3-flash --text-file chapter-01.txt --voice longcheng_v3 --rate 0.9 --seed 42 --concurrent 4 --out chapter-01.mp3--seed(0-65535)让同一份输入产出同一条音频,批量任务里某一条不满意可以只重跑那一条,不会连带改变其他条目。--concurrent 控制并行度,跑之前先看限流:
bash
bl quota list
bl quota check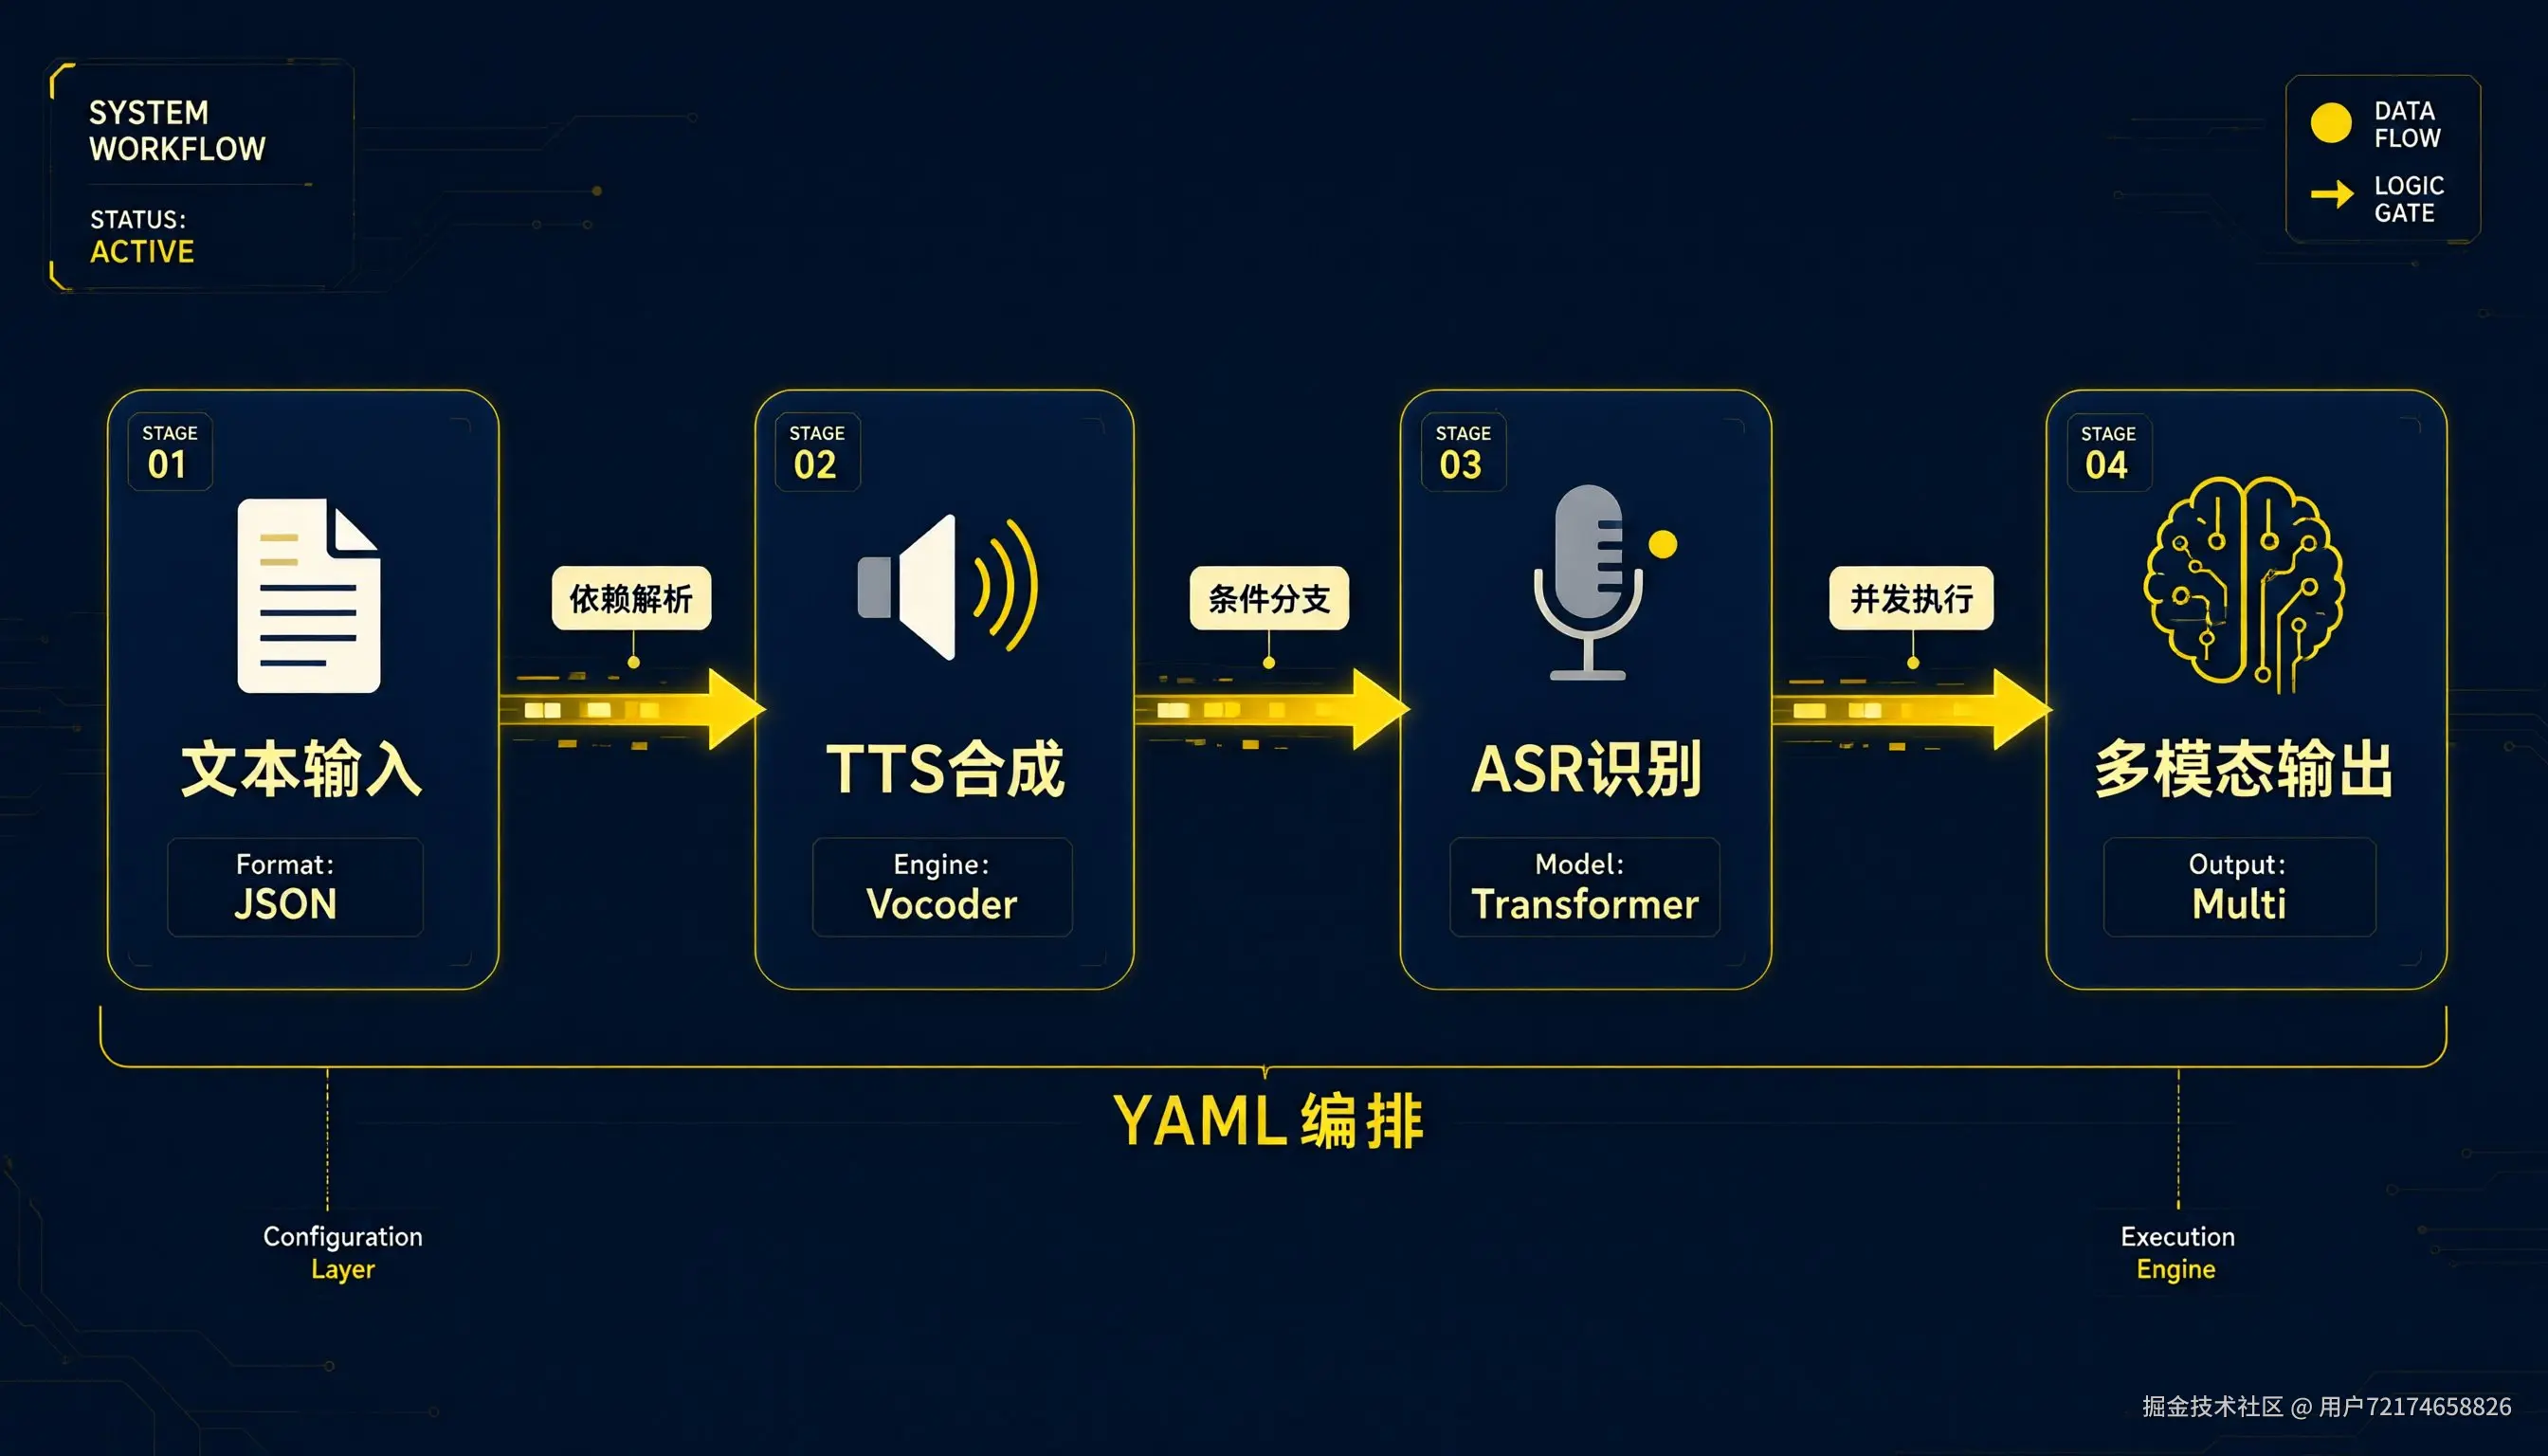
--rate 默认 1.0,长文稿我压到 0.9,口播信息密度高时默认语速听感偏赶。--instruction 收自然语言,同一段描述在不同音色上的表现不一致,只能靠试听确认,目前没有稳定写法。
识别层:说话人分离依赖异步模型
报错 2:本地前置校验拦下了不支持的组合
bash
bl speech recognize --url meeting.wav --diarization --speaker-count 2 --out result.json
kotlin
Error:       Model "qwen-audio-3.0-asr-flash" uses sync Flash ASR and does not support: --diarization, --speaker-count.
Hint:        Use an async filetrans model (e.g. fun-asr, qwen3-asr-flash-filetrans) for those flags.
Exit code:   2
请求没发出去,本地校验就拦了,0.355 秒返回。说话人分离必须走异步 filetrans 模型,同步 Flash ASR 不支持。补上 --model fun-asr:
bash
bl speech recognize --model fun-asr --url meeting.wav --diarization --speaker-count 2 --out result.json这个报错的设计值得学:能力约束在客户端前置校验,Hint 直接给出可用模型名,不消耗一次网络往返也不产生计费。
识别层参数
| 参数 | 说明 |
|---|---|
--url |
音频 URL 或本地路径,可重复,单次上限 100 个 |
--model |
异步:fun-asr / *-filetrans / paraformer-*;同步:qwen3-asr-flash* / fun-asr-flash* / qwen-audio-*-asr-flash |
--diarization |
说话人分离 |
--speaker-count |
预期人数,依赖 --diarization |
--vocabulary-id |
热词表 ID,专有名词场景用 |
--language |
语言提示 |
--channel-id |
声道,默认 0 |
--out |
完整结果写 JSON |
--async |
只返回任务 ID 不等待 |
--poll-interval |
轮询间隔,默认 2 秒 |
本地文件不便公开托管时先推临时存储(48 小时有效):
bash
bl file upload ./local-audio.wavfun-asr 计价 ¥0.00022/秒,折一小时 ¥0.792。同族 fun-asr-mtl 与几个日期快照版本价格一致。实测 QPM 限流是 count_limit: 10 / period: 1,批量转写的吞吐按这个数排。
架构上的取舍要说清楚:异步 filetrans 是任务制的,实时字幕这类低时延需求不对口,同步 Flash ASR 才是那条路,但同步侧没有说话人分离。两个能力目前不在同一个模型上。
交互层:一次调用去掉一层胶水
bash
bl omni --message "user:这张封面图上最抢眼的是什么?一句话回答。" --image cover.jpg --voice Tina --audio-out reply.wav自己拼是两次调用加中间处理:视觉模型出文本,文本喂 TTS,还要处理格式、采样率、音色映射。这里一次完成。
参数侧:--message 可重复并用 role: 前缀组织多轮,--system 设角色,--image 可重复传多张,--audio 支持 wav/mp3/amr/aac/m4a/ogg/3gp/3gpp,--video 收视频文件或逗号分隔的抽帧 URL,--audio-format 默认 wav,--max-tokens 与 --temperature 常规语义。
音色是独立的一套,13 个:
bash
bl omni --list-voicesTina(甜妹,默认)、Dylan(北京-晓东)、Kiki(粤语-阿清)、Li(南京-老李)、Sunny(四川-晴儿)、Marcus(陕西-秦川)、Eric(四川-程川)、Rocky(粤语-阿强)、Jennifer(詹妮弗)、Ryan(甜茶)、Katerina(卡捷琳娜)、Peter(天津-李彼得)、Ethan(晨煦)。和 cosyvoice 那 64 个不通用,ID 首字母大写。做区域化语音交互可以按地区切音色,--help 自带方言示例:
bash
bl omni --message "Answer in Sichuan dialect: How's the weather today?" --voice Sunny模型自述能力:超过 10 小时的音频理解、400 秒的 720P 音视频(1 FPS)理解与对话、60 多种语言音频输入、30 多种语言语音输出,上下文 262144,最大输出 65536,features 含 web-search / function-calling / batch。
计费与 --text-only 的成本杠杆
| 计费项 | 标准价(每百万 token) | Batch File |
|---|---|---|
| 输入:文本/图片/视频 | ¥7 | ¥3.5 |
| 输入:音频 | ¥53 | ¥26.5 |
| 输出:纯文本 | ¥40 | ¥20 |
| 输出:文本+音频 | ¥213(输出的文本不再单独计费) | 同左 |
音频输出比纯文本输出贵 5.3 倍。开发期把 --text-only 当默认,逻辑调通再摘掉它去要音频;离线批量走 Batch File 是半价。
bash
bl omni --message "user:这段视频讲了什么?按时间顺序说三件事。" --video demo.mp4 --text-only编排层:把三层连起来
工作流是一个 YAML:
yaml
version: workflow/v1
steps:
  - id: script
    type: text/chat
    input:
      message: "{{topic}}"
      system: "你是短视频口播文案作者。只输出口播稿正文,120字以内,不要标题,不要解释。"
  - id: voiceover
    type: speech/synthesize
    input:
      text: "{{steps.script.output}}"
      model: cosyvoice-v3-flash
      voice: longcheng_v3
      rate: 0.95
      out: voiceover.mp3
{{topic}} 由运行时输入提供,{{steps.<id>.output}} 取上游步骤 output 的 data 值。步骤类型 11 种:text/chat、vision/describe、image/generate、image/edit、video/generate、speech/synthesize、speech/recognize、script/js、logic/switch、logic/select、logic/assert。
validate 只接受 --file,位置参数会报 Unexpected argument:
bash
bl pipeline validate --file voice-workflow.yaml通过返回 Pipeline definition is valid.。执行前先看计划,不调模型:
bash
bl pipeline run --file voice-workflow.yaml --input '{"topic":"本地语音克隆工具的中文短板"}' --dry-run
scss
Pipeline planned [~]

  [~] script (text/chat) --- planned
[~] voiceover (speech/synthesize) --- planned生产参数:--input-file 从 JSON 文件读输入,--concurrency 控制并行步骤数(默认 1),--events jsonl 输出生命周期事件便于接日志与告警,--step-timeout 给单步设超时,--output json 让结果可被下游解析。
两个 schema 约束我实测过,写流程前先知道:
script/js 的 code 必须是字面字符串,校验器明确拒绝从上游步骤取代码,报错理由是"code sourced from another step ($from) or an expression is not allowed, since it would execute untrusted text as host code"。沙箱里 input / steps / params 都是 undefined,code 字符串里的 {{text}} 也不会被插值。想做数据加工就别指望它。
logic/assert 的字段是 condition(表达式字符串),支持 {{steps.X.output}} 插值,实测 condition: "{{steps.s1.output}} == 2" 能通过;写成 that/op/value 会报 condition is required。分支判断走 logic/assert 或 logic/switch。
成本模型
价格取自 bl model list --model <模型> --output json 的 prices 字段:
| 模型 | 单价 | 200 字口播 | 12 万字 |
|---|---|---|---|
| cosyvoice-v3.5-flash | ¥0.8/万字符 | ¥0.016 | ¥9.6 |
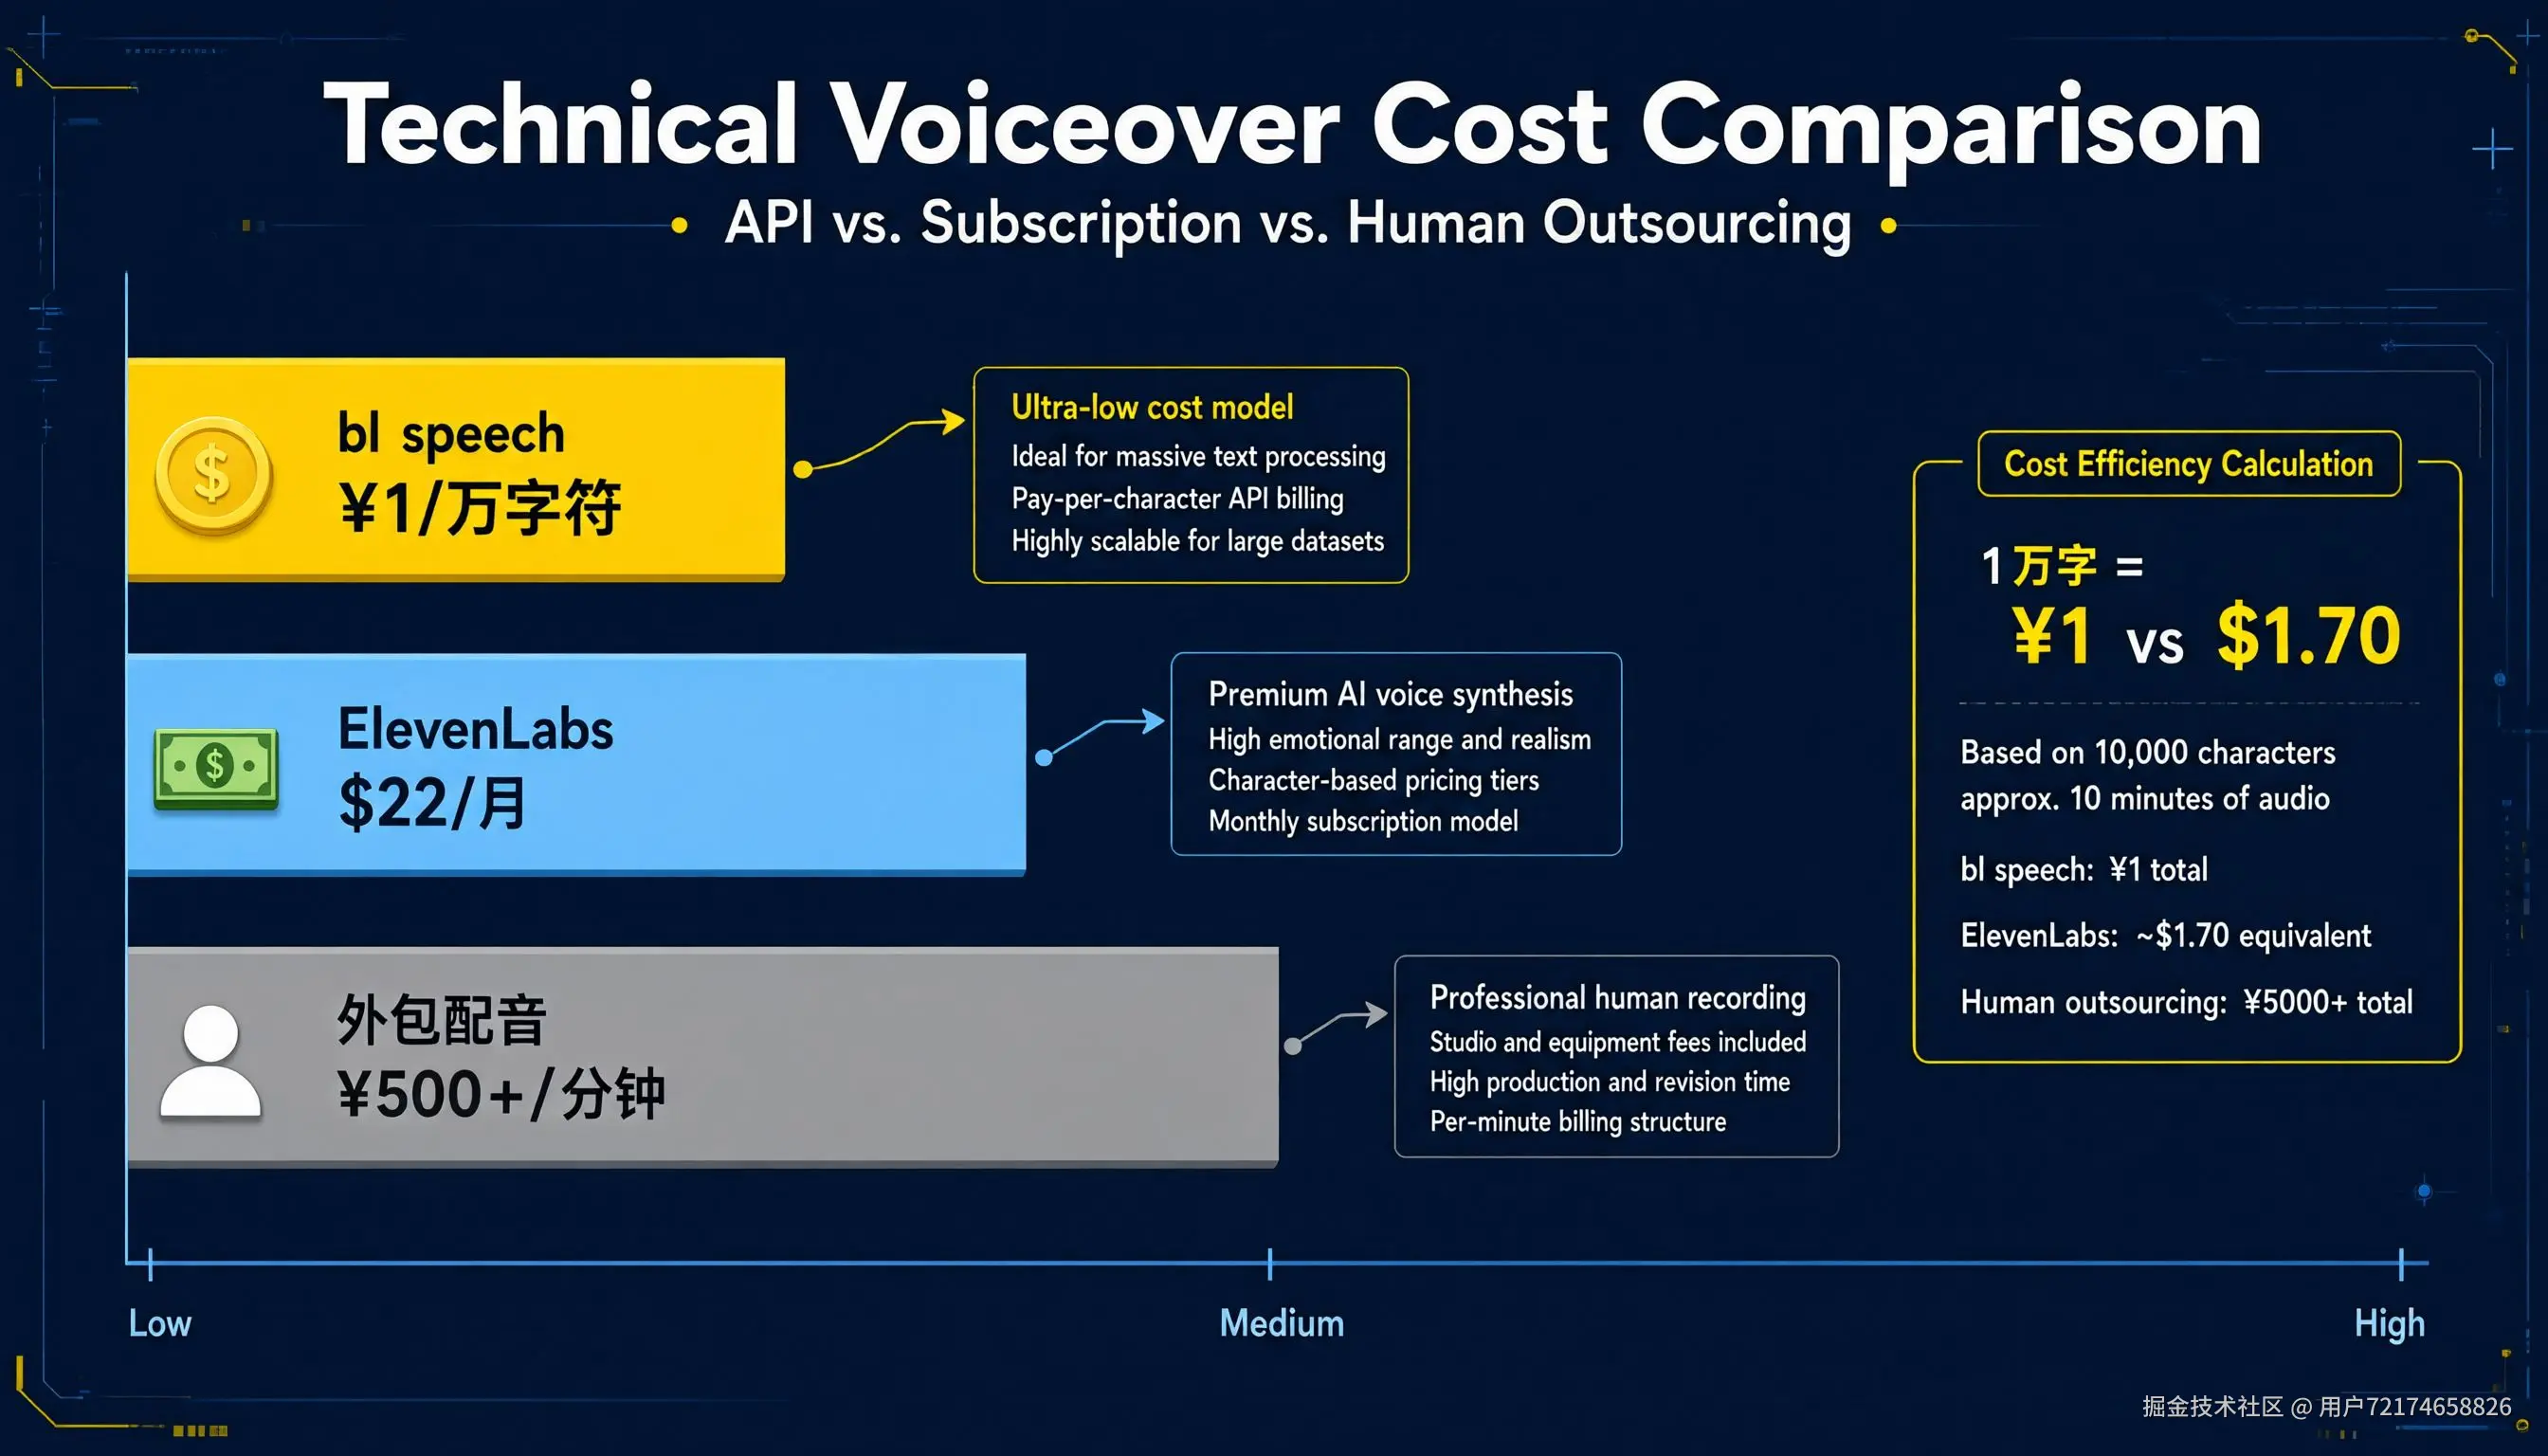
| cosyvoice-v3-flash | ¥1/万字符 | ¥0.02 | ¥12 |
| cosyvoice-v3.5-plus | ¥1.5/万字符 | ¥0.03 | ¥18 |
| cosyvoice-v3-plus | ¥2/万字符 | ¥0.04 | ¥24 |
| cosyvoice-clone-v1 | ¥2/万字符 | ¥0.04 | ¥24 |
| cosyvoice-v2 / v1 | ¥2/万字符 | ¥0.04 | ¥24 |
查价命令是 No Auth 的,不消耗额度,可以直接写进成本看板脚本:
bash
bl model list --capability TTS
bl model list --capability ASR
bl model list --model cosyvoice-v3-flash
注意 --model 要写完整模型名,写系列简称会返回 Model "cosyvoice" not found.,先用 --capability 筛出完整名字再查详情。
海外订阅制的对照(ElevenLabs 官方 pricing 页当前值):Free 0、Starter6、Creator 22(首月11)、Pro 99、Scale299(含 3 席)、Business 990(含10席)。计费单位是credit,TTS约1credit/字符,SpeechtoText330credits/分钟。Creator一个月121,000credits,约等于12.1万字符;同样的字符量在cosyvoice−v3−flash上是¥12.1,按1美元≈7.1人民币的假设折成1.70。转写一小时是 19,800 credits,这边 ¥0.792 约 $0.11。
两种计费形态的适用边界很清楚:用量高且稳定、需要席位和协作,订阅制更省心;用量低或波动大、按项目结算,按字符和按秒更容易做成本归口。
免费额度按官方口径理解:每个符合条件的模型各自一份(通常 100 万 token),90 天有效期,仅华北2(北京)地域,过期不补发不结转,模型之间不互相借用;已认证账号额度用尽自动转按量付费。工程上建议开硬停:
bash
bl usage freetier --all
bl usage free
bl usage summary
开启后超额调用返回 HTTP 403 与 AllocationQuota.FreeTierOnly,看到这个错误码是额度问题,不用去翻代码。
与本地方案的边界
同期在看 VoiceStudio,21.9k star,一周涨 7,499。开源、全本地,声音克隆(短参考音频零样本)、声音设计、视频配音、听写、有声书,16 个 TTS 引擎加 11 个 ASR 引擎,646 种语言目录,Tauri v2 桌面应用 + FastAPI 后端 + 本地 REST/SSE/WebSocket(localhost:3900)+ OpenAI 兼容 audio API + MCP Server。GPU 可选,CPU 模式可跑,用 GPU 时 4GB 显存起,依赖 Node 20+/Bun 与 Python 3.11+。
三个约束是它 README 自己写的:646 种语言的实际覆盖和音质取决于所选引擎;默认引擎权重是 CC-BY-NC(应用本体 AGPL-3.0);项目状态 active beta,Intel Mac 跑不了本地 Python 后端。
我的分工判断:
声音克隆且音频不能出本机,走本地方案,这是云端替代不了的。MCP Server 意味着它能被 Agent 编排进私有工作流。
要中文与方言的成品音色、要 diarization、要多模态语音交互、要按量计费与免运维,走 CLI 这边。省掉的是引擎选型、权重许可核对、算力管理。
定制路径两边都有:本地靠换引擎和自行微调,这边是 bl finetune audio create(TTS 的 sft-lora)配 bl deploy audio create(独占部署),bl finetune price 可以先估训练成本。
还没解决的三个问题
--instruction 的风格指令在不同音色上表现不一致,缺一个可预期的写法,目前只能试听。
Omni 的音频输出 token 数没法在调用前估算,只能事后从用量倒推,做成本预估时这块我留了余量。
两套音色池不通用:合成层 64 个里有东北、陕西、闽南三种方言,Omni 的 13 个里有北京、南京、四川、陕西、粤语、天津口音。做方言内容要先确认目标方言落在哪一层,四川话只在 Omni 那边有,闽南话只在合成层这边有。