终于到这个话题了。AIGC 面试里出现频率最高的问题之一。
面试官问你:"你们项目用了 RAG,为什么不微调?"或者反过来:"你们微调了,为什么不直接用 RAG?"
很多人被这个问题问住了,不是因为不会答,而是因为------他没想过为什么选这个。
今天把这事彻底聊透。
先搞清楚各自的作用
很多人把微调和 RAG 理解成"一个方案的两个选项"。错。
它们的定位完全不同。
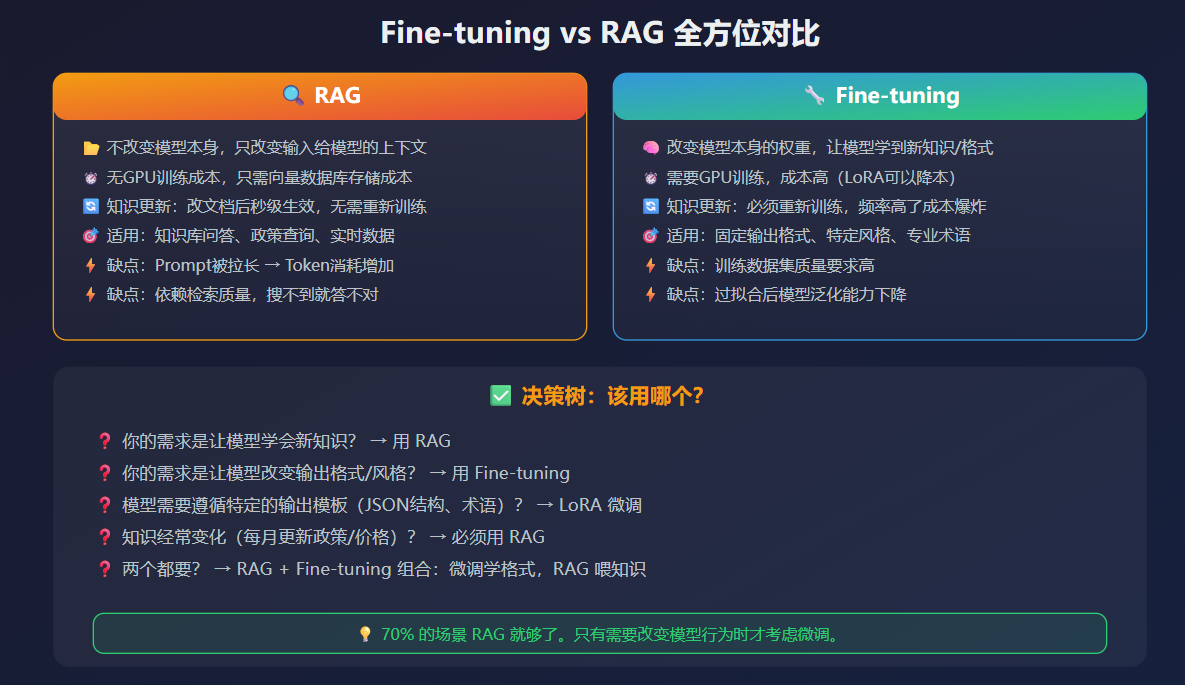
RAG(检索增强生成):不改变大模型本身,通过给模型提供额外的上下文资料来提高回答质量。模型还是那个模型,只是每次提问时给它多塞一些相关资料。
微调(Fine-tuning):改变大模型本身的权重,让模型"学会"新的知识、格式、风格。
打个比方:
RAG 是考试时给你开卷------书还是那本书,但你翻书找答案。
微调是让你重新学一遍------你的知识变了,脑子里的权重变了。
开卷考试的成本低、速度快、知识更新灵活。重新学一门的成本高、时间长,但学会之后不需要翻书也能答。
RAG 的优势和劣势
RAG 最大的优势:知识更新快。
你有一份新的内部文档------上传到向量库,用户马上就能问到。不需要训练、不需要 GPU、不需要等。
修改成本也低。文档错了,直接删掉重新上传。秒级生效。
RAG 最大的劣势:Prompt 变长。
每次提问你都要把检索到的相关文档塞进 Prompt。文档越多,Prompt 越长,Token 消耗越大。
你设 top_k = 5,每个块 500 tokens,光上下文就是 2500 tokens。再加上用户输入、历史对话......你的 Token 消耗轻松翻倍。
所以 RAG 适合什么场景?知识频繁更新的场景。 比如内部知识库、政策问答、实时数据查询。
微调的优势和劣势
微调最大的优势:改变模型行为。
这一点 RAG 做不到。比如你需要模型:无论用户怎么提问,都用固定的 JSON 格式输出。RAG 只能告诉模型"应该这样输出",但模型不一定遵守。
微调能让模型"学会"这种格式,形成肌肉记忆。
再比如你需要模型掌握一个特定的术语体系------医疗诊断术语、法律条文引用格式、金融产品描述风格------这些靠 RAG 加几篇文档是学不会的。需要微调让模型深度理解这些术语的用法。
微调最大的劣势:昂贵且不灵活。
训练需要 GPU。即使你用 LoRA(Low-Rank Adaptation),也要几个小时到几十个小时。
知识更新必须重新训练。你的产品价格每个月微调一次?每次都重新训练?成本爆炸。
所以微调适合什么场景?固定风格和固定格式的场景。 比如客服话术模板、固定输出格式、专业术语体系。
✨ 现代 AIGC 的黄金组合:RAG + LoRA
不是非得二选一。现实中它们不是互斥的,是互补的。
先用 LoRA(低秩适配)微调,让模型学会你需要的输出格式和术语风格。然后在推理时挂上 RAG,让模型从文档库里搜实时知识。
这就是 RAG + Fine-tuning 组合模式的完整形态。
java
@Service
public class HybridLlmService {

    private final ChatClient loraChatClient;
    private final VectorStore vectorStore;

    public ChatResponse handleQuery(String question) {
        // Step 1: 从RAG获取相关文档
        List<Document> docs = vectorStore.similaritySearch(
            SearchRequest.query(question).withTopK(3)
        );

        // Step 2: 把文档作为上下文,扔给微调过的模型
        return loraChatClient.prompt()
            .user(u -> u.text(question))
            .system("以下是相关资料:\n" +
                docs.stream()
                    .map(Document::getContent)
                    .collect(Collectors.joining("\n---\n")))
            .call()
            .chatResponse();
    }
}
LoRA 负责"怎么说"------模型的语气、格式、风格。RAG 负责"说什么"------模型回答的知识来源。
LoRA 微调的参数远比全量微调少。一个 7B 的模型,LoRA 只需要训练 0.1%-1% 的参数。几分钟到几小时就能完成。
而且 LoRA 的权重文件很小,几十 MB,可以随时切换。想换风格了,换一个 LoRA 权重文件就行,不用重新训练整个模型。
LoRA 在 Spring AI 里的使用也很简单。你可以加载一个微调后的模型端点,用法和普通模型完全一样:
yaml
spring:
  ai:
    openai:
      base-url: http://localhost:8000/v1  # 你的LoRA服务
      api-key: not-needed
      chat:
        options:
          model: qwen2.5-7b-lora
然后你的 ChatClient 连接的就是经过微调的模型。代码零改动。
微调 LoRA 需要多少数据?
很多人一想到微调就头大:"我没有几百万条数据。"
LoRA 的数据量要求比全量微调低得多。 质量比数量重要。
一个典型的 LoRA 数据集:
{
  "messages": [
    {"role": "system", "content": "你是一个电商客服助手,回复简短有礼貌。"},
    {"role": "user", "content": "我想退货"},
    {"role": "assistant", "content": "亲,很抱歉给您带来不便。请提供订单号,我来帮您办理退货。"}
  ]
}
{
  "messages": [
    {"role": "system", "content": "你是一个电商客服助手,回复简短有礼貌。"},
    {"role": "user", "content": "这个商品怎么用"},
    {"role": "assistant", "content": "亲,商品内附有详细说明书。如果您找不到,我可以把电子版发给您。"}
  ]
}
几十到几百条高质量对话,就能让 LoRA 学到风格。不需要几千条。
关键点:覆盖常见场景,每条数据都是人工精写的,不要用模型生成的"假数据"来微调模型。 结果只会越调越差。
什么时候必须微调
有些场景 RAG 确实搞不定:
场景一:改变模型说话的方式。
你的客服需要模仿一个特定的人设------有语气、有口头禅、有回复节奏。RAG 给文档只能告诉模型"应该这样说话",但它不一定会照做。微调是强制让它学会。
场景二:掌握专业术语体系。
比如医疗诊断报告用的特殊术语和缩写。RAG 能给模型一些文档学习术语,但模型可能在上下文太长时"忘记"。微调后这些术语变成模型的"长期记忆"。
场景三:固定的输出结构。
比如你需要模型每次输出都是严格的 JSON Schema。RAG + Prompt可以做到大部分情况,但对于特别严格的结构要求,微调更可靠。
场景四:隐私合规。
RAG 需要把文档传给第三方 API 提供商(OpenAI、通义千问)。如果文档涉及高度机密数据(比如客户隐私信息),你不能传给第三方。微调后模型学会了知识,推理时不需要传外部文档。
LoRA 的技术原理一句话说清:微调时只动极小一部分参数。
全量微调是修改模型所有参数。Llama 7B 有 70 亿参数,全量微调需要 4-8 张 A100,训练几天,成本几万。
LoRA 不修改原始权重,而是在原始权重旁边并联一些"小矩阵"(Adapter),训练时只调这些小矩阵。推理时把 Adapter 的权重合并回主模型。
一个 7B 模型,LoRA 只训练几百万参数,不到 1%。 单张 4090 就能跑,几十分钟到几小时训完。性价比高,是中小团队的理想选择。算力成本的门槛大幅降低了。
不过要注意一点:LoRA 调的是"说法",不是"知识"。指望用它把一套新知识灌进模型里,效果通常不如直接上 RAG。它擅长的是让模型换一种语气、换一种格式说话。
🎯 面试官视角的标准回答
如果面试官问:"RAG 和微调怎么选?"
RAG 和微调解决的不是同一个问题。RAG 解决的是"知识不足",微调解决的是"行为不对"。知识频繁变化的场景用 RAG。因为 RAG 的知识更新成本几乎为零,上传文档就生效。固定输出格式、专业术语、特定风格用微调。而且现在推荐 LoRA 微调,只训练 0.1%-1% 的参数,几十分钟搞定,权重文件几十 MB 可以随时切换。生产上我推荐两者组合。先用 LoRA 让模型学会格式和风格,推理时再挂 RAG 补充知识。LoRA 负责"怎么说",RAG 负责"说什么"。我的判断顺序是:先用 RAG,解决不了再考虑 LoRA,全量微调是兜底选项。不要为了微调而微调,先评估 RAG 能不能解决问题。
下一篇聊一个容易被问住的问题:你的 AIGC 项目,效果到底怎么评估?测试集怎么建、灰度怎么做、上线后监控哪些指标。