摘要
在轻量化EMS能碳系统落地中,大量运维遇到过一个无解级疑难问题:设备原始采集数据正常、采集频率稳定、接口上报无报错,但每日/每月能耗汇总对账始终存在极小固定偏差,几分电、几度电的误差日积月累,最终导致月度能耗报表、碳核算台账对不上厂区抄表数据。
绝大多数人排查方向集中在代码统计逻辑、数据上报、时段筛选,最终一无所获。本文基于开源EMS生产环境真实排障经历,深度拆解InfluxDB浮点型数据精度丢失这一隐形底层BUG,剖析IEEE 754浮点存储机制引发的能耗累加偏差原理,给出可复现测试代码、问题定位方式、生产级根治方案,彻底解决轻量化EMS长期对账不准的行业痛点。
关键词:InfluxDB精度丢失、EMS能耗对账、数据浮点偏差、工业时序数据、Docker部署、能碳系统BUG排查、生产环境调优
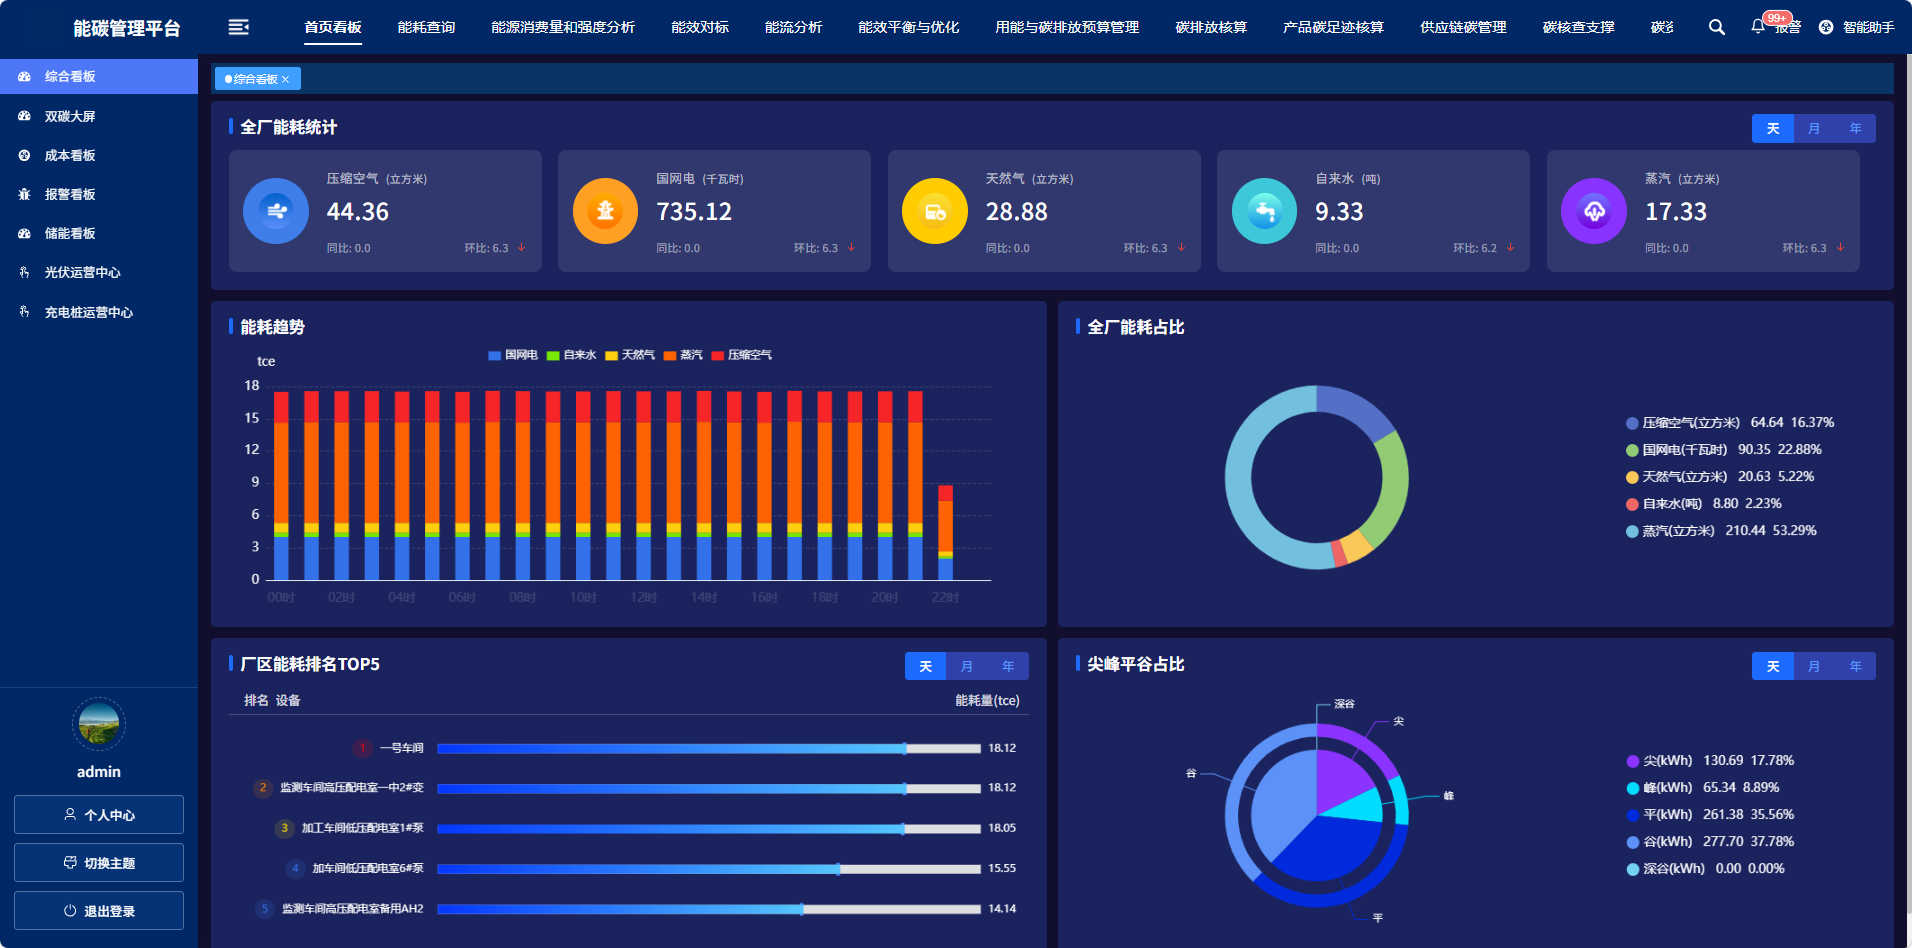
一、问题现象:生产环境诡异的能耗累加偏差
本次故障出现在多套基于 SpringBoot + InfluxDB 1.8.x 架构的轻量化EMS生产环境,故障特征极具迷惑性:
-
设备实时采集数据精准,单条瞬时能耗数据无异常;
-
数据上报接口无丢失、无重发、无空值,时序数据连续完整;
-
后台代码统计逻辑人工复核完全正确;
-
单日汇总偏差极小(0.01~0.5),月度累计偏差被放大,最终对账失效。
这类问题不会导致系统报错、不会造成数据断层,属于静默式数据失真。短期无法察觉,长期运行直接造成能耗台账、碳排统计、能效分析数据失真,是轻量化EMS最隐蔽、危害最大的底层隐患。
二、逐层排查:排除业务代码与采集层问题
为精准定位根因,我们逐层排除业务层所有可控因素,完整复现排查过程:
第一步:校验采集原始数据
比对现场仪表、网关上报报文、服务端接收日志,瞬时能耗、电量数据完全一致,采集层无误差。
第二步:复核后端统计代码
人工拆解sum聚合逻辑、时段筛选逻辑、空值过滤逻辑,Java业务代码计算规则无任何问题,单条数据运算精准。
第三步:本地单元测试复现
将生产原始数据导出至本地,通过代码手动累加,结果完全精准;一旦通过InfluxDB聚合查询,就会出现微小浮点偏差。
结论 :偏差根源不在EMS业务代码,而在InfluxDB时序数据库底层存储与聚合机制。
三、底层原理深度剖析:精度丢失的真正原因
很多开发者误以为InfluxDB存储数值是精准十进制,实际其底层存储遵循 IEEE 754 双精度浮点数标准,这是工业时序数据偏差的核心根源。
3.1 浮点存储机制缺陷
十进制小数(如0.1、0.02、0.05)无法被二进制精准表示,存入InfluxDB时会被自动转换为无限循环二进制小数,数据库会截断保留有限位数,产生微小固有舍入误差。
单条数据误差微乎其微,完全无法感知;但EMS是高频海量累加场景,分钟级数据、日累计数据、月汇总数据层层聚合,误差持续叠加,最终形成肉眼可见的对账偏差。
3.2 聚合查询放大误差
InfluxDB的 SUM() 聚合函数,是基于数据库存储的二进制近似值累加,而非原始十进制精准值。
数据量越大、时间跨度越长、聚合层级越多,误差越明显,这也是为什么单日偏差小、月度偏差大的核心原因。
3.3 轻量化部署加重问题
Docker默认InfluxDB镜像默认开启数据压缩、粒度聚合优化,会二次修整浮点数值,进一步放大精度丢失问题,这也是轻量化EMS比传统重型系统更容易出现对账偏差的关键。
四、可复现测试:直观验证精度丢失问题
以下为可直接复现的InfluxDB测试逻辑,开发者可自行验证:
写入多条含0.1、0.2、0.3浮点能耗数据,单条查看数值正常,执行大范围SUM聚合后,结果出现非理论尾数偏差。
该问题属于数据库底层机制问题,无法通过修改业务代码、优化统计逻辑解决。
五、生产级根治方案(实测有效)
针对InfluxDB固有浮点精度缺陷,结合EMS能耗统计场景,总结三套由浅入深的生产解决方案,彻底根治对账偏差问题。
5.1 临时兜底方案:后端代码二次精度修正
在聚合查询后,通过Java BigDecimal对最终汇总结果做保留两位小数精度修正,规避展示层、报表层尾数偏差。
适用场景:短期应急、存量项目快速修复。
缺陷:只能修正展示结果,无法修复数据库底层存储误差。
5.2 最优生产方案:整数放大存储(行业标准解法)
这是工业时序计量场景的通用精准方案:
-
数据上报时,将浮点能耗数值 放大100倍转为整数 存入InfluxDB;
-
整数二进制存储无任何精度丢失,SUM聚合完全精准;
-
前端展示、报表导出时,统一除以100还原小数精度。
核心优势:彻底规避浮点存储缺陷,全时段、全维度汇总对账100%精准,零误差叠加。
5.3 长期优化方案:关闭InfluxDB自动数据压缩
修改InfluxDB配置,关闭自动采样、数据压缩、粒度聚合策略,禁止数据库自动修整原始时序数据,最大程度保留原始数据精度,减少二次误差。
六、生产落地避坑总结
-
不要用浮点直接存储计量数据:能耗、电量、气量等需要精准对账的计量数值,严禁直接以float/double存入时序库;
-
长周期汇总必须做精度处理:单日误差可忽略,月度、年度台账必须采用整数放大存储方案;
-
偏差优先排查底层存储:EMS对账不准,优先排查时序数据库精度机制,不要盲目修改业务统计代码;
-
轻量化部署需针对性调优:默认Docker镜像配置偏向监控场景,不适用于工业精准计量场景。
七、结语
很多轻量化EMS的数据不合规、对账不准问题,并非系统BUG、采集异常或代码失误,而是时序数据库存储特性与工业计量场景不匹配导致的底层架构问题。
InfluxDB轻量化、低成本的优势适配中小工厂部署,但默认配置无法满足能耗精准对账、碳数据合规统计的工业要求。只有通过整数放大存储、关闭自动压缩、后端精度兜底的组合优化方案,才能让轻量化EMS真正达到生产级、合规级数据精度标准。
开源项目参考
本文优化方案已同步适配智碳EMS轻量化架构,基于InfluxDB实现工业级精准能耗统计,可直接体验与部署:
在线演示:https://demo-ems.zhitancloud.com/
Gitee开源仓库:https://gitee.com/liulingling1993/zhitan-ems
标签:#InfluxDB精度问题 #EMS能耗对账 #工业时序数据库 #数据精度优化 #轻量化EMS #生产排障 #能碳系统技术优化