上个月收尾一个 Java 后端的项目,客户临时加了个需求:商品库想支持"拍图找同款"。
我第一反应是,这块得用 Python 吧。
然后我停了一下。这个"得"字,是从哪来的?
一、一个被默认接受的假设
做 Java 后端的人大概都有这个条件反射:一碰到 AI 需求,脑子里自动弹出一句"这块得走 Python"。图像识别、推荐、风控,好像都默认归 Python 管。
这个反射不是没道理。模型训练确实得在 Python 里做,PyTorch、PaddlePaddle、还有现在的大模型生态,训练端的好东西几乎都在那边。这部分我不打算抬杠,也没得抬。
但问题是,我们平时接到的需求,绝大多数根本用不上"训练"。
你要做以图搜图,需要的是"部署"一件事:把一张图丢进去,从图库里找出最像的几张。这件事真正吃的是并发、延迟、稳定性,还有跟现有业务系统对接的顺畅程度。而这些恰恰是 JVM 的主场。
我们用训练端的短板,去否定了部署端的长处。 这是我停下来的原因。
二、两条老路,各自的代价
Java 项目里想加 AI 能力,通常只有两个选择。
第一条路,起一个 Python 微服务,用 HTTP 或者 gRPC 去调。看着挺直接,但你得接受它带来的一整套东西:跨语言序列化的开销、两套技术栈、两套部署脚本、两套监控告警。出了线上问题,Java 组和算法组得一起排查,光是定位在哪一侧就要花掉小半天。系统复杂度不是加了 1,是乘了个系数。
第二条路,干脆把业务搬到 Python 去。这个代价更大,等于放弃你整个团队积累的技术栈和基建。
我不太甘心就这两个选项。于是花了挺长时间,试着走第三条路:把 AI 能力整个装进一个 Java 进程里,不跨语言,不引外部服务。
做出来的东西叫 ImageSearch4J,现在版本 1.0.0,已经开源了。
POST /api/search
      │   image (File) + topk + threshold
      ▼
主体检测(PicoDet-LCNet, 640×640)
      ▼
SANMS 精修(解决"大框吞小框")
      ▼
逐候选裁剪 → 特征提取(PP-LCNetV2, 224×224 → 512 维)
      ▼
逐候选向量检索 → 二次排序定位最佳主体
      ▼
以最佳主体的向量,拉出相似图列表
整条链路,从图片进来到结果出去,一个 JAR,一个进程。没有 Python,没有 RPC,也没有一个单独要维护的向量数据库。
下面我把里面几个关键的选择讲一讲。这些思考过程,比代码本身更值钱,也更值得一读。
三、三块拼图,其实是同一件事
要让这条路走通,得解决三个问题:模型怎么带过来,用什么跑推理,向量放到哪里检索。对应的就是 ONNX、DJL、Lucene 三块拼图。
模型怎么带过来:选 ONNX,是想让训练和部署彻底分开
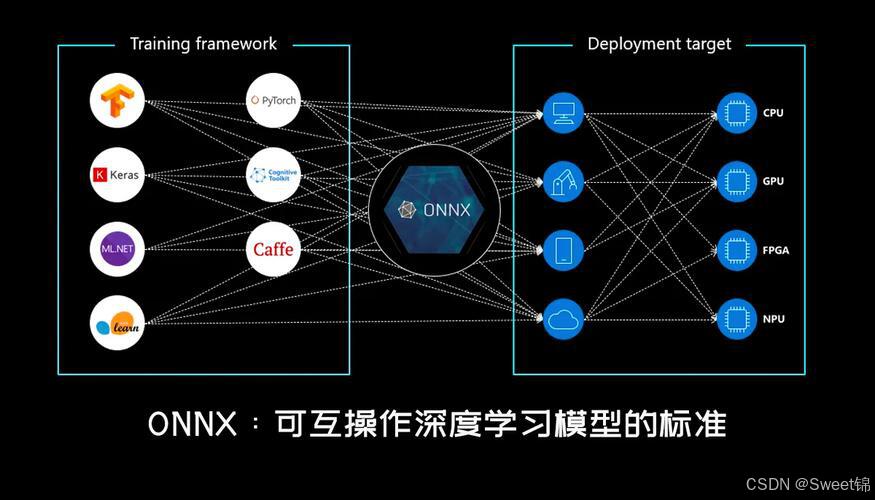
ONNX 这个格式,很多人把它当成一个"中间产物",导出来就完事。我更愿意把它看成一份契约。
它现在是 Linux Foundation 下面的项目,不属于 PyTorch,也不属于 PaddlePaddle,任何一家都没法单方面改它。它定义的是一套跟框架无关的计算图。这意味着什么?
意味着训练团队用 PyTorch 还是 Paddle、明天想不想换个新框架,是他们的自由,Java 这边一行代码都不用动。反过来,部署侧只要认 ONNX 就行,不用管模型是怎么训出来的。
两边的交接界面,从"框架对框架"降到了"框架对标准"。
后来我在 ONNX 官网读到一段话,几乎是把我这套想法原样说了一遍:
We believe there is a need for greater interoperability in the AI tools community. Many people are working on great tools, but developers are often locked in to one framework or ecosystem. ONNX is the first step in enabling more of these tools to work together by allowing them to share models.
Our goal is to make it possible for developers to use the right combinations of tools for their project. We want everyone to be able to take AI from research to reality as quickly as possible without artificial friction from toolchains.
"without artificial friction from toolchains",人为的工具链摩擦。跨语言调用、多起一套服务、两套部署,这些都不是问题本身的难度,是工具链自己造出来的难度。
举个具体的:ImageSearch4J 用的两个模型,就是 PP-ShiTu 体系里的 PicoDet-LCNet 和 PP-LCNetV2,在 Paddle 侧训练好,转成 ONNX 拿过来用。整个 Java 侧只负责推理,不碰训练。换成别的模型,只要它支持导出 ONNX,就能接进来。
这个设计还有个不那么显眼的好处。ONNX 的规范里写死了向后兼容:新版本的运行时,必须能跑旧版本的模型。对打算长期维护的项目来说,这一点比"现在好不好用"重要得多。
用什么跑推理:选 DJL,是因为这件事早就有人做过
有人问过,Java 做 AI 推理,是不是自己写一套很折腾。
不用。AWS 有个开源项目叫 Deep Java Library,简称 DJL,2019 年就在 re:Invent 上开源了。它的定位是 engine-agnostic,同一套 Java API,底层可以挂 ONNX Runtime、PyTorch、TensorFlow 各种引擎。它在 AWS 自己的云上跑了很久,SageMaker 上的 DJL Serving 就是官方的模型部署方案,动态批处理、自动扩缩、多引擎托管这些能力都有。
说白了,"Java 跑 AI 推理"这件事,早就不是没人走的路了。 我不用自己去造推理引擎,站在 DJL 上面就行,精力集中在"以图搜图"这一件事上。
顺带提一个跟安全有关的点。AWS 之前发过一个 DJL 的漏洞公告,影响 0.13.0 到 0.36.0 的版本,修复线是 0.37.0。本项目用的 0.38.0,已经在修复线之上。
向量放哪:选 Lucene,是想把一整个组件消掉
这一块我考虑的时间最长。
常规做法是上 Milvus、Qdrant 这类专门的向量数据库,或者干脆用 Elasticsearch 的 KNN。它们都很强,功能也全。但放到我这个场景里,它们都有一个共同的问题:要多一个东西。
多一个进程,多一套部署,多一份监控,多一个会出故障的环节。为了一个检索功能,把整个系统的运维面撑大一圈,我觉得不划算。
Apache Lucene 是另一条路。它是 Java 生态里最经得起考验的搜索内核,Elasticsearch 和 Solr 的检索能力其实都是建在它上面的。对我要做的事,它有两个特别合适的点:
第一,它是嵌入式的。就是一个 JAR 包,跟业务同一个进程,没有独立服务,没有网络往返。这一整层运维,直接没了。
第二,它从 9.0 开始原生支持 HNSW 向量索引。我在上面又加了标量量化,把 float32 压成 int8,索引内存大概降到原来的四分之一,召回率还能保持在 95% 以上。这部分优化算是白拿的。
还有一个附带的好处,是我后来才意识到的:Lucene 的 Document 既能挂向量字段,也能挂文本倒排字段。也就是说,"向量检索 + 关键词检索"的混合检索,这个项目是天然具备架构基础的,不需要再引入任何组件。 这一点我在后面还会提到。
三块拼图讲完,其实它们在做同一件事:把必须绑在一起的东西压到最少,把可以各自独立的部分放到最大。 训练和部署解耦,模型和引擎解耦,AI 能力和基础设施解耦。这也是我后来复盘时才发现的一条线,三个选择看着独立,底层是同一个原则。
四、踩得最深的一个坑:大框吞小框
讲这块之前,先说一句:这个算法不复杂,前后也就几十行。但它是整个项目里我花时间最多的地方,因为找到"该改什么"这一步,比改本身难太多了。
事情是这样的
图库里有一瓶可乐。我把一张可乐的照片丢进去,期待它匹配到那瓶可乐。
结果它匹配到了别的东西。准确地说,它匹配到了另一张"标签特写"的图。
我一开始以为是模型不准。换了几张图,现象很稳定:只要目标上有大面积的标签、logo、或者文字,匹配就容易跑到"局部特写"上去。搜可乐给你返回标签图,搜饮料瓶给你返回瓶盖图。
这就不是偶发了,是有一个固定的失败模式在里头。
排查的过程
我先做的,是把主体检测的结果打出来看。一看就明白了。
检测器对那张可乐照片输出了两个框:
-
一个大框,框住整个瓶身,置信度 0.60
-
一个小框,只框住红白标签那一片,置信度 0.95
两个框,一个对应"整瓶",一个对应"标签"。而下游是按置信度排序的,0.95 的标签框赢了,系统就拿着标签去图库里比对,返回的自然全是标签图。
问题不在"搜得准不准",在**"拿什么去搜"这一步就错了。**
我试过、但都没走通的路
搞清楚现象之后,我陆续试了几种办法,都不行。
调置信度阈值。 把阈值调高到 0.6 以上,标签框是滤掉了,但整瓶那个大框(0.60)也一起没了,一个候选都不剩。调低呢,噪声更多。这条路走不通,因为大框天然分数就低,小框天然分数就高,两边卡在一个阈值上,没法分开。
调 NMS 的 IoU 阈值。 这个思路是"让两个框合并成一个"。但 NMS 判断"两个框是不是同一个目标"用的就是 IoU,而大框套小框这种情况,重叠面积相对于并集来说小得可怜,算下来 IoU 可能只有 0.01。IoU 本来就极小,我在它上面怎么调阈值,都碰不到这两个框。判据本身就用错了地方。
干脆把小框全删掉,只留最大的。 这个我试的时间最长。它确实能把"整瓶"留下来,但有个副作用:小框那个 0.95 的高分,也一起被扔掉了。留下的整瓶框还是 0.60,在一堆候选里排不到前面。等于用一个问题换来了另一个问题。
而且"取最大框"这个规则本身也站不住。最大那个框不一定是主体,它可能框的是整层货架、整张桌面。真实图片里背景框往往比主体框还大。
想通的那一刻
把上面几条路都堵死之后,我才意识到问题出在哪。
NMS 的判据是"重叠",它回答的是"这两个框重叠得多不多"。但大框套小框这种关系,本质是**"包含",不是"重叠"**。这两种关系在几何上完全是两码事:包含关系的 IoU 可以趋近于 0,重叠关系的 IoU 一定很大。用"重叠"这把尺子去量"包含",量不出来,再怎么调都没用。
那就换一把尺子。不看重叠面积,而是直接比较坐标,判断一个框是不是几何上完全落在另一个框里面。
想通这点之后,剩下的就是把它写出来。我给它起名叫 SANMS,Structure-Aware NMS,结构感知的非极大值抑制。
具体怎么做
逻辑就三步:
-
按面积从大到小处理所有的框,让"整体框"先出场
-
用坐标直接比较,判断两个框是不是几何包含关系(注意不是算 IoU)
-
如果大框把小框整个包住了,就把小框去掉,同时把小框的高分继承给大框
第三步是我最满意的地方,也是它和"取最大框"拉开差距的地方。它让大框同时拿到了两样东西:整体的尺度 ,加上局部的高置信度。整瓶那个框吞掉标签框之后,分数从 0.60 变成 0.95,排序上自然就赢了。精度和召回,在这里不用二选一。
核心代码其实就几行:
java
// 按面积降序处理
Arrays.sort(sortedIdx, (a, b) -> Float.compare(areas[b], areas[a]));

// 大框完全包含小框 → 吞并,并把小框的高分继承给大框
if (kbox[0] <= curBox[0] + EPS && kbox[1] <= curBox[1] + EPS &&
    kbox[2] >= curBox[2] - EPS && kbox[3] >= curBox[3] - EPS) {

    // ★ 分数继承(点对点取最大值),发生在吞并瞬间
    if (scores[curIdx] > scores[kidx]) {
        scores[kidx] = scores[curIdx];
    }
    isContained = true;
}
它和传统 NMS 是什么关系
这里要澄清一个容易误解的地方:SANMS 不是拿来替代 NMS 的,它是补在 NMS 后面的。
PP-ShiTu 体系的检测模型是端到端的,检测头输出里其实已经带了一轮模型内置的 NMS。所以我的处理不是去动它,而是在它之后再叠一层精修。
两者管的事情不一样:
-
内置的 NMS 管**"重叠"**:两个框 IoU 很大,大概率是同一个目标,去重。
-
SANMS 补**"包含"**:两个框 IoU 极小,但其实是同一个目标,合并。
一个兜常规情况,一个补特殊死角,配合起来层层收敛。实际代码里就是先按分数粗筛出一批候选,再交给 SANMS 精修,形成一个"粗筛保召回、精修保精度"的闭环。
它有个我很喜欢的性质
零额外参数,零训练成本。
它是一段纯几何后处理,不需要重新训练检测器,也不引入任何需要调的参数。你可以直接把它叠在任何目标检测模型的输出后面,不用担心"这个数据集上要调成多少"。
这一点对我很重要。因为这意味着它是一个纯粹的算法改进,不会给用的人增加任何调参负担。
为什么值得单拎出来说
回到开头那个场景,问题的本质其实不是"检索得准不准",而是系统拿着什么东西去检索。
传统 NMS 会让"整瓶"和"标签"两个框都留下来,高分的小框胜出,于是系统拿着标签去搜,用户想要的是整瓶,拿到的却是标签。这类错,从第一步就注定了,后面再怎么优化相似度算法都救不回来。
而"大框吞小框"不是个边角情况。商品搜索、服装搜索、地标检索,只要目标上有显著的局部纹理,这个失败模式就会出现。我在这上面踩过的坑,做同类需求的人大概率也会踩一遍。
SANMS 想解决的,就是这一件事:让"检测到了什么"和"该拿什么去搜"重新对齐。
五、免训练这件事,值得单独说说
"免训练"是这个项目一个挺重要的特性,但容易被当成宣传词,我想把它讲透。
为什么以图搜图能免训练?根子在一个经常被混淆的区别上:它是"检索"任务,不是"分类"任务。
| 分类任务 | 检索任务(以图搜图) | |
|---|---|---|
| 知识存在哪 | 模型的权重里 | 图库里 |
| 新增一个类别 | 重新训练,要数据要算力 | 加几张图就行 |
| 模型的角色 | 分类器 | 一个通用的「图 → 向量」函数 |
分类任务里,知识是烧进模型权重里的,你要认出一个新类别,就得重新训练。但检索任务不一样,知识在图库里,不在模型里。模型只需要干一件事:把任意一张图稳定地变成一个向量。这件事,一个通用的预训练模型就能做得很好,不需要针对你的数据做任何调整。
这就是"免训练"成立的原因。
它带来几个很实际的结果。
新品类上线等于往图库加图。 不用训练、不用标注、不用请算法工程师介入。在这个架构里,"向量更新"这个操作,替代的正是别的系统里"重新训练"的那一步。
用的人不需要懂 AI。 不用知道什么是损失函数、学习率、batch size,也不用准备训练用的 GPU 集群。你只需要准备好图片。
Java 侧天然只有推理。 训练是重活:数据集、分布式、调参、GPU 调度。推理是轻活:加载模型,跑一次前向。正因为是免训练,训练那一整坨复杂度直接被消掉了。前面说这个项目能保持轻量,根子就在这里。
这也是它和 PP-ShiTu 一脉相承的地方:同一套底层模型,同样的定位,同样免训练。你要换个行业场景,通常需要的只是换一个新的图库。
六、它现在长什么样
说了这么多想法,看看实际的东西。
架构图
java
┌───────────────────────────────────────────────────────────────────────┐
│                       Spring Boot 3 应用(单进程)                     │
│                                                                        │
│    POST /api/search                                                    │
│         │   image (File) · topk · threshold                            │
│         ▼                                                              │
│    ┌─────────────────── ImageSearchService ──────────────────┐         │
│    │   @Async("aiInferExecutor")                              │         │
│    │                                                          │         │
│    │   ① PipelineService.process()  ------ 定位「最佳主体」        │         │
│    │        ├─ MainBodyDetectionService.predict()             │         │
│    │        │     PicoDet-LCNet 检测 → Top5 粗筛 → 阈值过滤     │         │
│    │        │     → SANMS 精修(大框吞小框 + 分数继承)        │         │
│    │        └─ 逐候选:裁剪子图 → PP-LCNetV2 提特征 → 向量检索  │         │
│    │              二次排序:同分取面积大者 → 确定为 match       │         │
│    │                                                          │         │
│    │   ② 以 match 的向量,检索出完整相似列表 similarList        │         │
│    └──────────────────────────────────────────────────────────┘         │
│                                                                        │
│    推理层:AWS DJL 0.38 ── ONNX Runtime 1.29 ── PicoDet / PP-LCNetV2   │
│    检索层:Apache Lucene 9.12 ── HNSW + 标量量化 ── 本地索引目录       │
└───────────────────────────────────────────────────────────────────────┘
① 主体检测(PicoDet-LCNet) 输入图片,检测出图中所有潜在主体框,随后经过一条漏斗式的处理链:
模型原始输出 → Top5 粗筛 → 阈值过滤 → SANMS 精修
             (保召回)      (去噪声)    (去包含冗余)
② 特征提取(PP-LCNetV2) 对每个候选框裁剪出子图,缩放到 224×224、按 ImageNet 均值方差归一化后,提取 512 维特征向量(已 L2 归一化)。
③ 向量检索(Lucene HNSW) 每个候选子图分别检索,逐候选打分、再二次排序 ------同等分数取面积更大者,最终确定「最佳主体」。随后用它对应的向量,拉出完整的相似度列表。
链路与接口
对外就一个主要接口:
java
POST /api/search
Content-Type: multipart/form-data| 参数 | 类型 | 必填 | 默认值 | 说明 |
|---|---|---|---|---|
image |
File | 是 | --- | 待检索的图片 |
topk |
int | 否 | 10 | 返回结果数量 |
threshold |
float | 否 | 0.4 | 向量检索的相似度阈值 |
一个 curl 例子:
bash
curl -X POST http://localhost:8080/api/search \
  -F "image=@./cola.jpg" \
  -F "topk=10" \
  -F "threshold=0.4"
返回结构长这样(真实抓包):
javascript
{
  "state": 1,
  "code": 200,
  "message": "Success",
  "data": {
    "match": {
      "name": "康师傅冰红茶",
      "path": "142/2.jpg",
      "md5": "96b9f53217b116af6b767ba033e74b9f",
      "score": 0.8343468
    },
    "similarList": [ ... ],
    "candis": [ ... ],
    "rect": [499.86, 9.44, 801.02, 945.43]
  }
}这里有两个字段值得说一下。match 是系统认定的最佳匹配,similarList 是按分数排好的完整相似列表。rect 是最佳匹配主体的矩形框,candis 是除它以外的其它候选框,都带检测置信度。
为什么要拆成两组? 因为 match 回答的是"这张图里最可能是什么",similarList 回答的是"图库里有哪些像的",这两件事语义不一样,前端可以分开展示。而 rect 和 candis 分开,是为了让用户在图上直接看出来"系统为什么这么判断"。把认定主体和落选候选用两种颜色画出来,看一眼就懂。
顺便说一个细节:就算向量库里一个都没匹配上,rect 和 candis 也照样有值。 意思是前端可以提示"检测到目标了,但库里没有匹配",而不是给用户一个空白页。
界面
项目里带了两个零框架的静态页面,没上任何前端框架,纯 HTML + 原生 JS。
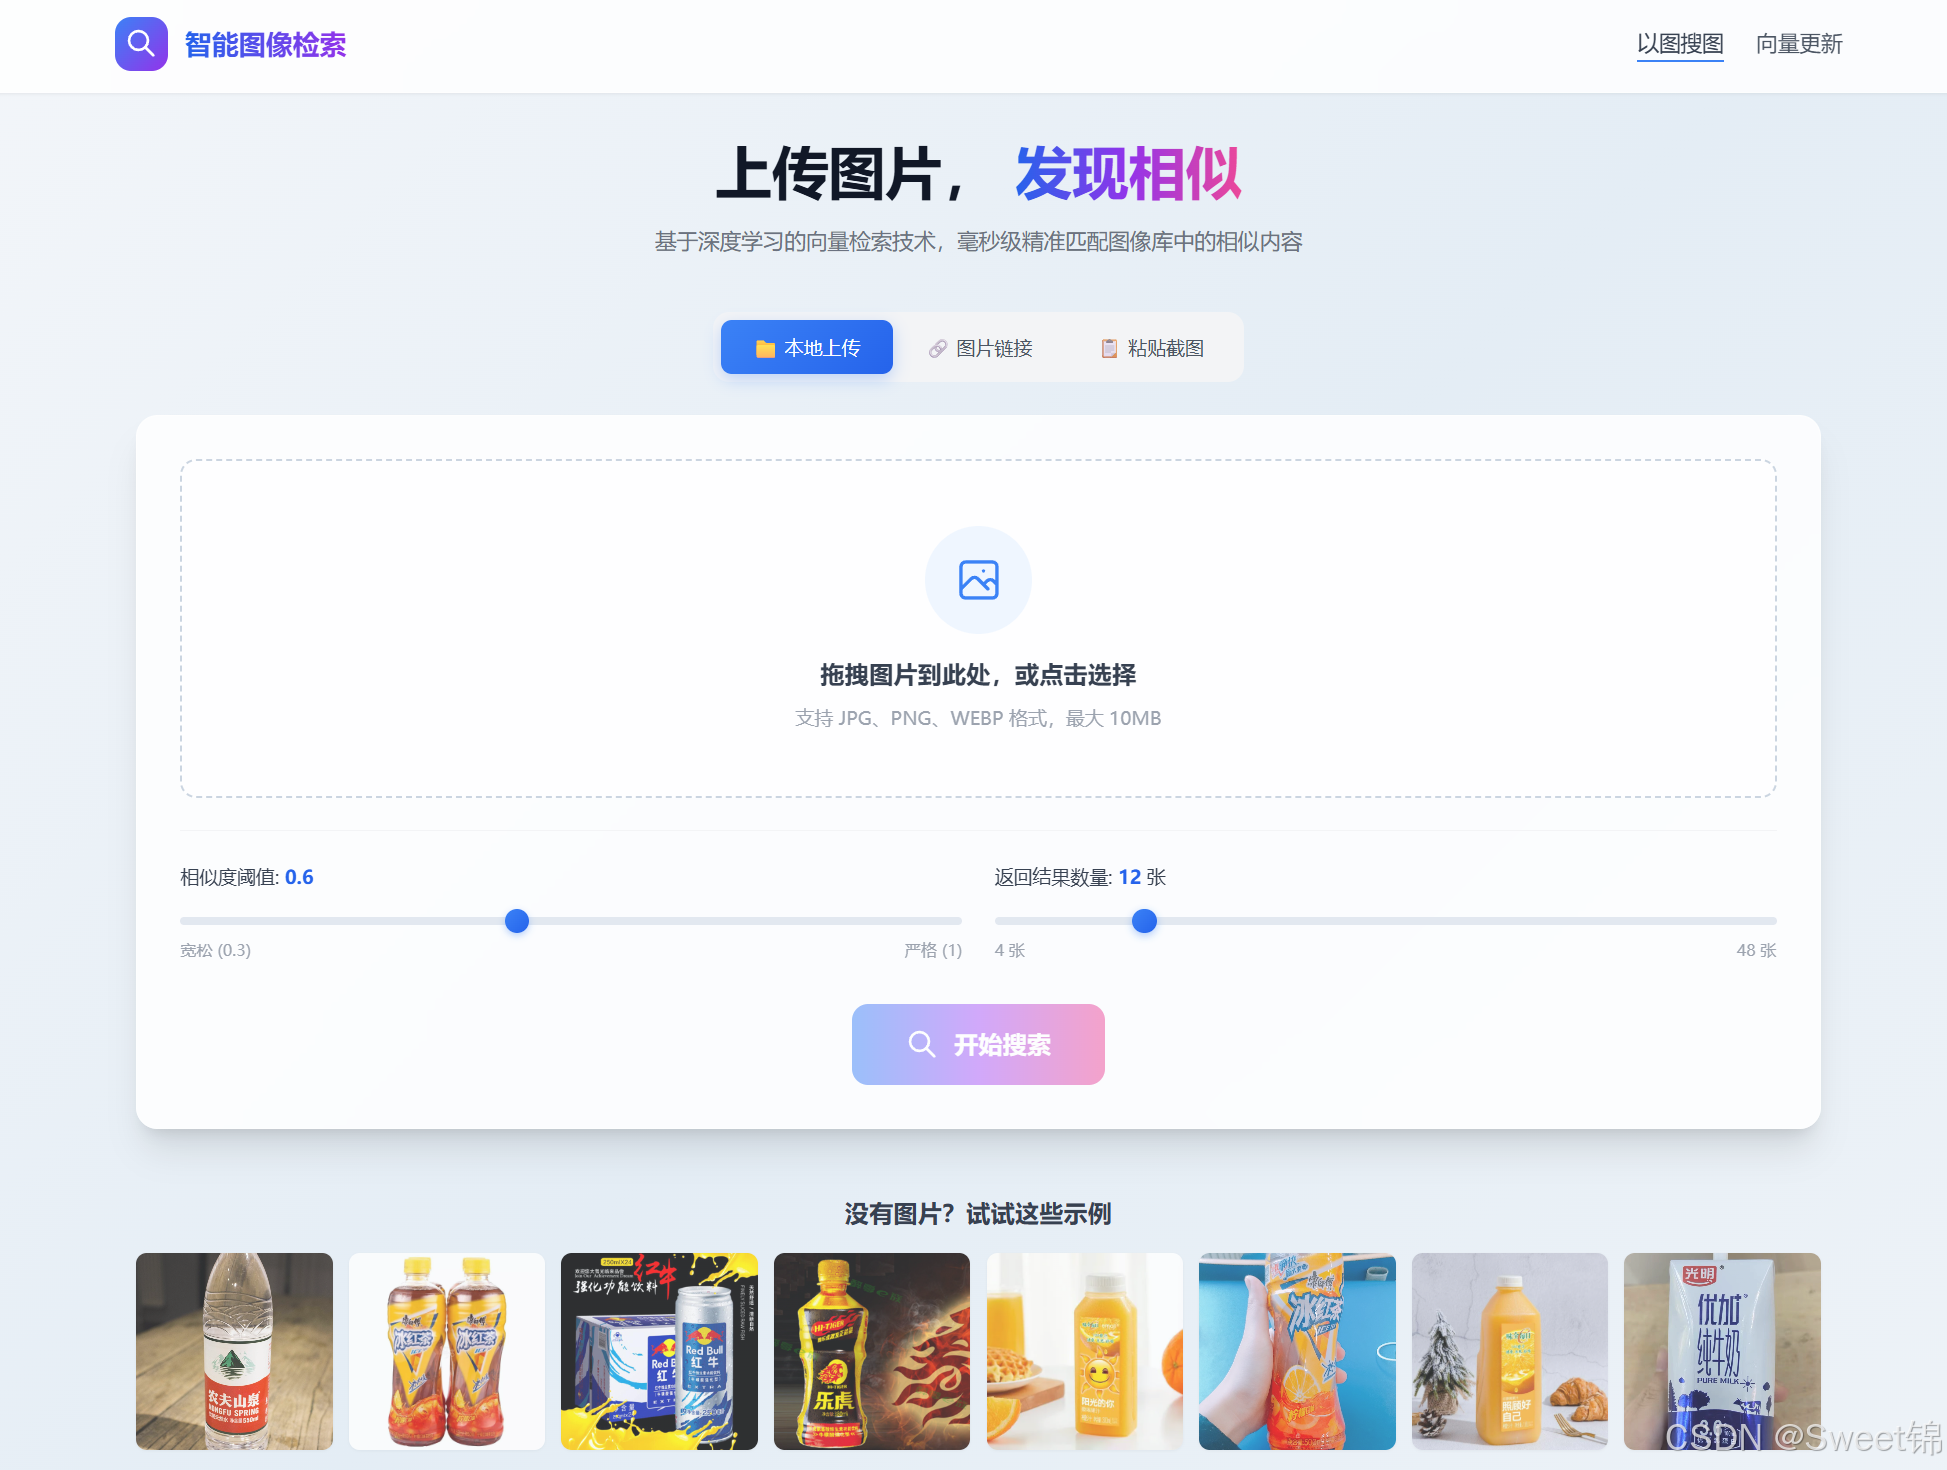
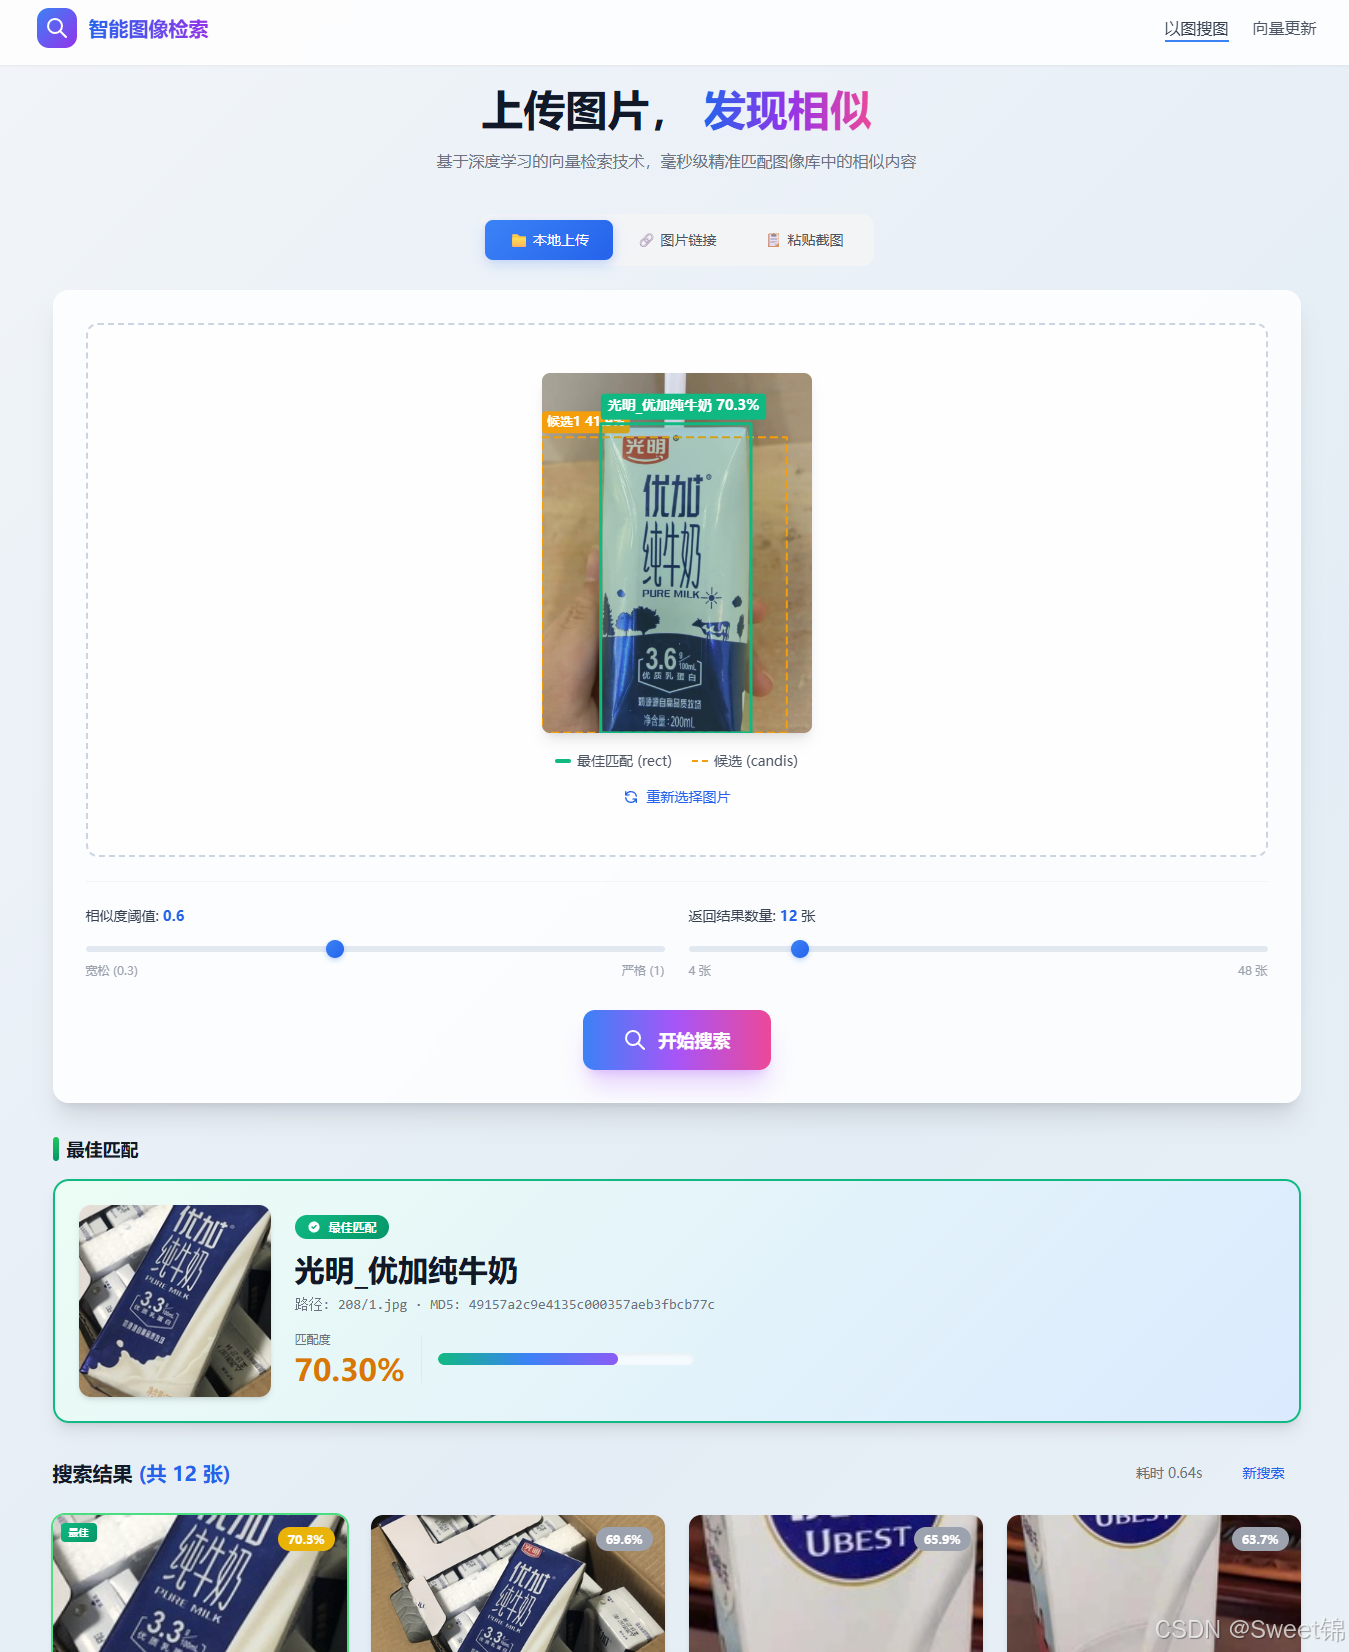
搜索页支持三种传图方式:本地上传、图片链接、粘贴截图。这三种方式在提交前都会被统一转成 File 对象,后端只认一个 image 字段,接口不用做任何适配。结果回来后,预览图上会自动标出最佳匹配框(绿色实线)和候选框(橙色虚线),下面是匹配卡片和相似图列表。
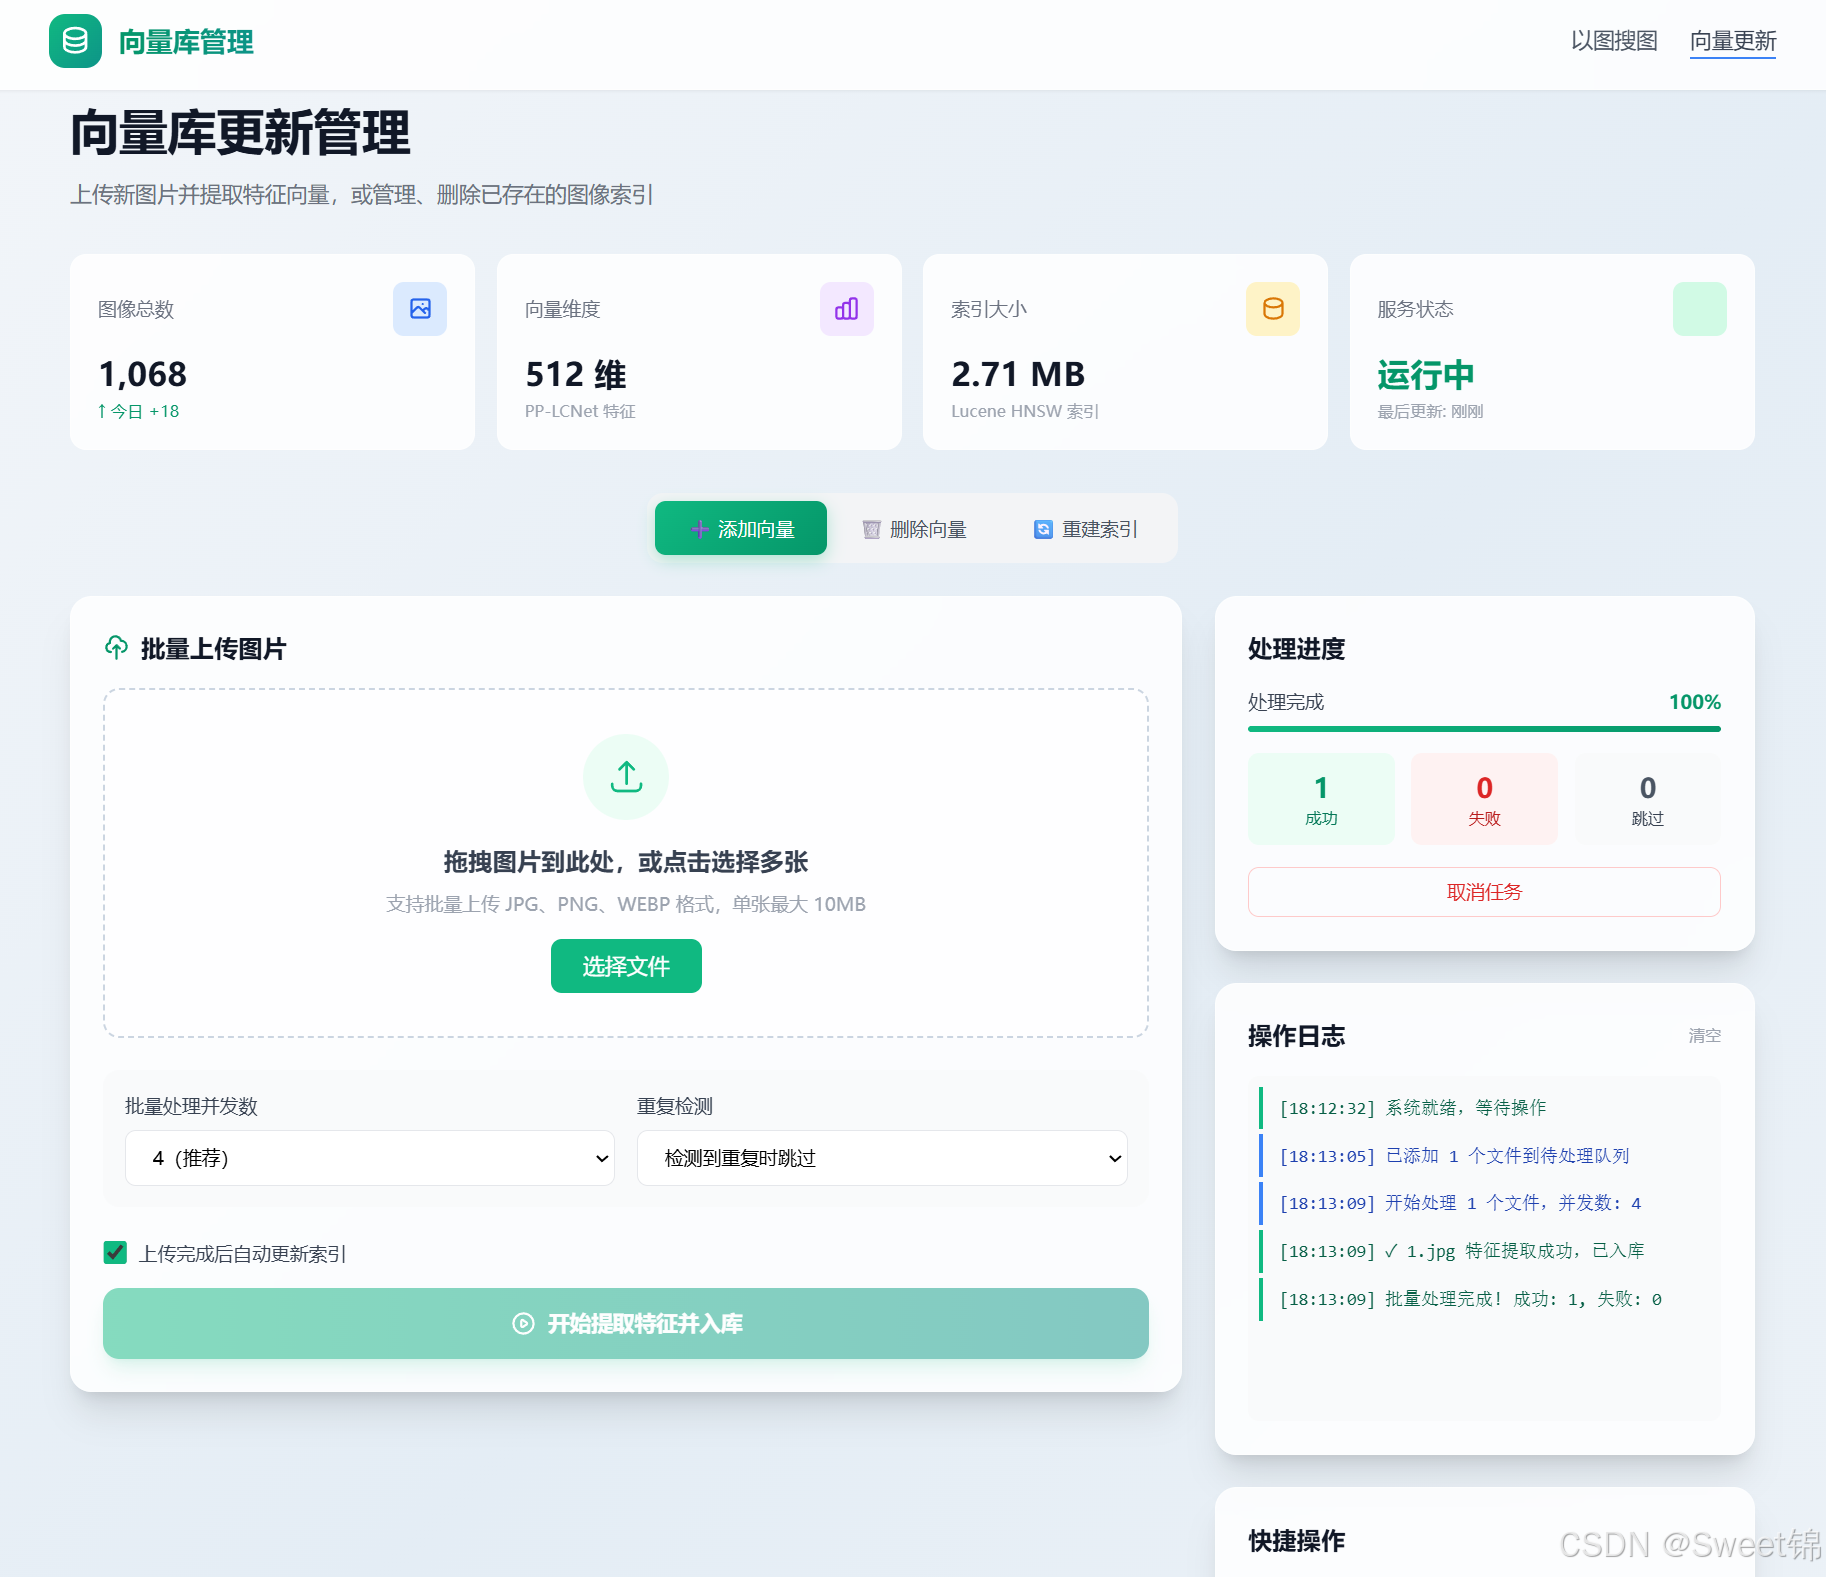
另一个是向量更新的入口页。主要用来展示向量库增量的交互形态,批量上传、统计、日志这些。真要接后端做生产级的向量管理,它的接口还需要补齐。我在文档里也是这么标注的,没打算把它包装成"完整后台"。
七、有些话,README 里不太方便写
这部分是我写 README 时删掉、但觉得值得单独讲的内容。
它和 Spring AI,是同一个位置
我一直在找一个类比,帮别人理解这个项目到底是什么。后来想清楚了:ImageSearch4J 在 Java 图像检索里的位置,相当于 Spring AI 在 Java LLM 里的位置。
这话得说准确一点。Spring AI 自己不提供大模型,它做的是把大模型能力接进 Spring 生态,让开发者用熟悉的方式调用。我这个项目也一样,模型不是我的,推理引擎不是我的,检索引擎也不是我的。我做的是把它们接起来,并且接成一个 Java 开发者顺手就能用的形态。
区别在于抽象粒度:Spring AI 抽象的是"怎么调用大模型",面向多家供应商;我抽象的是"一整条图像检索链路怎么跑",面向业务开发者。同一层,同一类使命,形态不完全一样。
说实在的,这个类比我没放进 README。刚开源的项目,上来就说"我相当于某某",容易被读成自抬身价。但在这个场合讲,我觉得它是个挺好用的坐标。
定位是轻量底座,而且不打算变
这个项目的定位是"轻量级底座",我打算一直守着它。
原因很简单:庞然大物天生吓退人。 一个新人点进来,看到几十个模块、一屏配置项,第一反应是关掉。而一个底座真正的价值,恰恰是让人愿意用它、用得上手。
所以我给自己定了个判断标准,挺土的但好用:这个改动,会不会让"从 clone 到搜出第一张图"的步骤变多? 会,那它就不该进主干,再合理也先记下来。
功能多和门槛低,很多时候是打架的。我尽量选后者。将来这个项目如果真的有一天需要变大,比如要支持大规模图库、要集群、要做多租户,那就另起一个新项目。旧项目不必背新项目的包袱,新项目也不必迁就旧项目的克制。 这是对两边都好的做法。
有些"没做",是刻意的
举几个例子。
主体检测的阈值,我是硬编码的,没暴露成配置。因为它是算法内部参数,交给二次开发的人去操心不合适。对外只留一个 threshold,管向量检索的精度就够了。能配的参数越多,用的人要做的决定就越多,上手成本就越高。
混合检索也是。前面说了,Lucene 让"向量 + 关键词"的混合检索在这个项目里几乎零成本,把 name 也写进文本字段,查询时用 BooleanQuery 把 KNN 子查询和词项子查询组合起来,融合就发生在同一次查询内部。但我没有把它放进默认路径。 因为新用户不该在跑通第一张图之前,就被迫去理解"两路检索怎么融合"。能力留在架构里,要不要开,留给有经验的人了。
这两件事都属于同一类:能做,但默认不做。 不是能力缺失,是刻意把复杂度停在该停的地方。
八、它不解决什么
一个项目只讲能做什么,不太可信。我说说它现在做不了什么。
它不是拿来训练的。 前面反复讲过,它只管推理和检索那一侧。你要自己训练模型、做微调,那还得回 Python。
它和 Elasticsearch 是两种取舍。 如果你公司已经有一套 ES 集群,那 ES 8.x 自带的向量能力加上你现有的基建,可能是更省事的选择。我这个项目走的是嵌入式路线,胜在独立、轻、不用额外运维,但这两条路的取舍不一样,不存在谁绝对更好。
混合检索默认是关的。 想要的话得自己接。
我觉得把这些提前说清楚,比让人用了才发现要好。边界清楚的项目,用起来才踏实。
九、快速上手
前面讲的都是"为什么",这一节讲"怎么做"。按下面的步骤走,从零到搜出第一张图,大概十来分钟。
环境要求
-
Zulu JDK 17 或以上
-
Maven 3.8 或以上
就这两条,不需要 Python,也不需要单独装数据库。
第一步:准备图库
项目本身不打包图库数据,你需要自己准备一份。这里推荐用 PP-ShiTu 官方的示例数据集 drink_dataset_v2.0,里面是各种饮料的图片,正好适合演示。
bash
# 下载
wget https://paddle-imagenet-models-name.bj.bcebos.com/dygraph/rec/data/drink_dataset_v2.0.tar

# 解压
tar -xvf drink_dataset_v2.0.tar

# 重命名为 image_gallery
mv drink_dataset_v2.0 image_gallery

# 移动到用户主目录
mv image_gallery ~/图库最终要放在用户主目录 下,也就是 ~/image_gallery/。放好之后,目录结构是这样:
bash
~/image_gallery/
├── gallery/                 # 图库本体
│   ├── 142/                 # 按分类编号分的子目录
│   ├── 164/
│   ├── ...
│   └── drink_label_all.txt  # 标签文件
├── test_images/             # 官方给的测试图,可以直接拿来试搜
└── vector_index/            # 索引目录,首次启动后自动生成,一开始没有
里面那个 drink_label_all.txt 是标签清单,每一行是一张图对应一个分类名,用制表符分隔。建索引的时候,程序就是靠它知道"哪张图叫什么名字"。
如果你放错了位置会怎样? 不用担心找不到北------应用启动时会检查这个目录,发现图库缺失,会直接把下载地址打印到日志里,然后自己退出,不会甩一堆异常堆栈让你猜。
第二步:启动
bash
git clone https://gitee.com/tommycloud/ImageSearch4J.git
cd ImageSearch4J
mvn spring-boot:run
第一次启动会多做两件事,都是自动的:
一是释放模型。 两个 ONNX 模型是随包内置的,放在项目的 resources/models/ 下:
-
picodet_lcnet_x2_5_640_mainbody.onnx(主体检测,约 28 MB) -
general_PPLCNetV2.onnx(特征提取,约 18 MB)
首次启动时,程序会把它们复制到 ~/models/ 目录。之后启动就直接用,不会重复复制。你不用手动下载任何模型文件。
二是建索引。 如果 ~/image_gallery/vector_index/ 是空的,程序会自动扫描图库、逐张提取特征、把向量写进索引。这一步是 CPU 密集的,图库大的话会花点时间,控制台有进度条,跑完就完事。
顺带说一句,索引建好之后,日常新增图片会通过 NRT(近实时)机制刷新:后台每秒刷新一次可见性,每 5 分钟落一次盘。所以通过接口新增的图,不用重启就能被搜到。
第三步:打开浏览器
默认端口是 80:
bash
http://localhost/index.html在 Linux 或 macOS 下,80 是特权端口,普通用户绑不上。这时候换个端口启动:
bash
mvn spring-boot:run -Dspring-boot.run.arguments=--server.port=8080然后访问 http://localhost:8080/index.html 就行。
页面上传一张饮料的照片,就能看到检测框和匹配结果了。手边没合适图片的话,~/image_gallery/test_images/ 里有官方准备好的测试图,随便挑一张。
第四步:调接口
界面之外,直接调接口也一样。假设端口是 8080:
bash
curl -X POST http://localhost:8080/api/search \
  -F "image=@~/image_gallery/test_images/xxx.jpg" \
  -F "topk=10" \
  -F "threshold=0.4"
返回的就是前面第六节那个结构。想自己写前端的话,对着这个结构解析就行。
关于 onnx-engine-path:一个容易让人犯迷糊的配置
配置里有一项 ty.onnx-engine-path,默认值是:
javascript
ty:
  onnx-engine-path: "${user.home}/.djl.ai/onnx/win-x64"
先说结论:这个参数不是必须的,不设置程序照样跑。 但生产环境建议设上。下面把它是干嘛的讲清楚。
ONNX Runtime 每次被加载的时候,都会把它自带的原生库解压出来。在 Windows 上就是三个文件:onnxruntime.dll、onnxruntime4j_jni.dll、onnxruntime_providers_shared.dll。默认情况下,它解压到一个临时目录;等程序结束时,再清掉。问题出在清理那一步------它走的是 File.deleteOnExit,而这个方法只能删空目录。于是每跑一次,临时目录里就多留一堆东西,跑久了磁盘上会攒一堆垃圾。
显式指定一个固定的原生库目录,效果就是:第一次解压到那儿,以后每次直接拿来用,不再反复解压,也不留垃圾。 这就是这个参数存在的理由。
现在说那个绕不开的矛盾点。 你第一次看到这行配置,大概率会懵:这个目录里的东西,是哪来的?我从来没创建过啊。
答案有点绕:它来自 onnxruntime.jar。
具体来说,是 Maven 依赖里那个 com.microsoft.onnxruntime:onnxruntime(本项目是 1.29.0 版)。这个 jar 里,按平台把各家原生库都打包好了,路径是:
javascript
ai/onnxruntime/native/<平台>/各平台对应的目录和文件是这样的:
| 平台 | jar 内目录 | 文件 |
|---|---|---|
| Windows x64 | ai/onnxruntime/native/win-x64/ |
onnxruntime.dll、onnxruntime4j_jni.dll、onnxruntime_providers_shared.dll |
| Linux x64 | ai/onnxruntime/native/linux-x64/ |
libonnxruntime.so、libonnxruntime4j_jni.so |
| Linux aarch64 | ai/onnxruntime/native/linux-aarch64/ |
libonnxruntime.so、libonnxruntime4j_jni.so |
| macOS (Apple Silicon) | ai/onnxruntime/native/osx-aarch64/ |
libonnxruntime.dylib、libonnxruntime4j_jni.dylib |
所以,如果你想指定这个参数,需要自己动手,把对应平台的原生库从 jar 里复制出来,放到你指定的目录,再把配置指过去。
jar 在本地 Maven 仓库里,路径是 ~/.m2/repository/com/microsoft/onnxruntime/onnxruntime/1.29.0/。以 Linux x64 为例,一条命令就能解出来:
bash
unzip -j ~/.m2/repository/com/microsoft/onnxruntime/onnxruntime/1.29.0/onnxruntime-1.29.0.jar \
  "ai/onnxruntime/native/linux-x64/*" \
  -d "$HOME/.djl.ai/onnx/linux-x64"
Windows 就把中间的 linux-x64 换成 win-x64,以此类推。解完之后,把配置改成对应目录:
javascript
ty:
  onnx-engine-path: "${user.home}/.djl.ai/onnx/linux-x64"
为什么默认配置写的是 win-x64? 因为我平时开发调试的机器是 Windows,就按本机配了。这算不上通用配置,你部署到别的平台时,记得改成本机对应的目录。不改也没关系,程序会退回默认行为,该跑还是跑,只是会走临时目录那一套。
其它可以留意的地方
再补几个上手时可能用得上的点:
配置文件在 src/main/resources/application.yml。端口、模型目录、索引目录、线程池大小这些都在里面,变量名挺直白的。
想换成自己的图库, 只要准备一份同样结构的目录就行:gallery/ 放图片(可以分子目录),gallery/drink_label_all.txt 写标签,每行 图片相对路径<Tab>分类名。换成自己的图库后,记得把旧的 vector_index/ 删掉,让它重新建。
图片能直接在页面上显示, 是因为静态资源里挂了一个 file:${user.home}/image_gallery/ 的映射。所以图库目录本身,同时也是图片的访问根目录。
十、最后
这个项目做出来,最想说的其实是"多一种选择"。
Java 开发者碰到 AI 需求,不一定非得转 Python,也不一定非得架一个 Python 微服务。这条路现在走得通了:模型用 ONNX 中立地承载,推理交给 DJL,检索交给 Lucene,Spring Boot 负责装配。说到底就是各用各的长处,谁也不用迁就谁。
我一直觉得,AI 侧的事情,最理想的状态是业务开发者根本感觉不到它的存在。底层那些模型加载、对象池、索引刷新、并发调度,都收进 Service 层里,业务代码只面对一个干净的方法调用:
java
@Service
@RequiredArgsConstructor
public class ProductSearchService {

    private final ImageSearchService imageSearchService;

    public SearchResult search(byte[] imageBytes) throws Exception {
        BufferedImage image = ImageIO.read(new ByteArrayInputStream(imageBytes));
        return imageSearchService.search(image, 10, 0.4f).get();
    }
}(留意一下,search 标了 @Async("aiInferExecutor"),返回的是 CompletableFuture,取结果记得 .get() 或 .join()。)
把 AI 收进底座,把业务留给写业务的人。 这是这个项目想做的事。
项目已经开源,Apache License 2.0,商用、二开都没问题。如果你正好也在为 Java 生态缺一块 AI 工具而别扭,欢迎来看看,也欢迎提 issue 和 PR。用得上就点个 star,用不上也没关系------这种东西,多一个人知道 Java 也能做,就多一分价值。