文章目录
- [1 -> 引言](#1 -> 引言)
- [2 -> 一次请求包含两个性质不同的计算阶段](#2 -> 一次请求包含两个性质不同的计算阶段)
- [3 -> 先统一指标,再讨论快慢](#3 -> 先统一指标,再讨论快慢)
- [4 -> 显存先装权重,剩余空间才属于 KV Cache](#4 -> 显存先装权重,剩余空间才属于 KV Cache)
- [5 -> 每种优化手段解决的问题不同](#5 -> 每种优化手段解决的问题不同)
- [6 -> 用一份日志计算 TTFT、TPOT 和系统吞吐](#6 -> 用一份日志计算 TTFT、TPOT 和系统吞吐)
- [7 -> 一套可复用的排查顺序](#7 -> 一套可复用的排查顺序)
1 -> 引言
同一个大模型,在个人电脑上可能每秒只生成几个 Token,在服务器上可以支撑大量并发;同一套服务在空载时响应很快,用户一多却开始长时间排队。把这些差异全部归因于"GPU 不够快"或"模型太大",通常找不到真正的瓶颈。
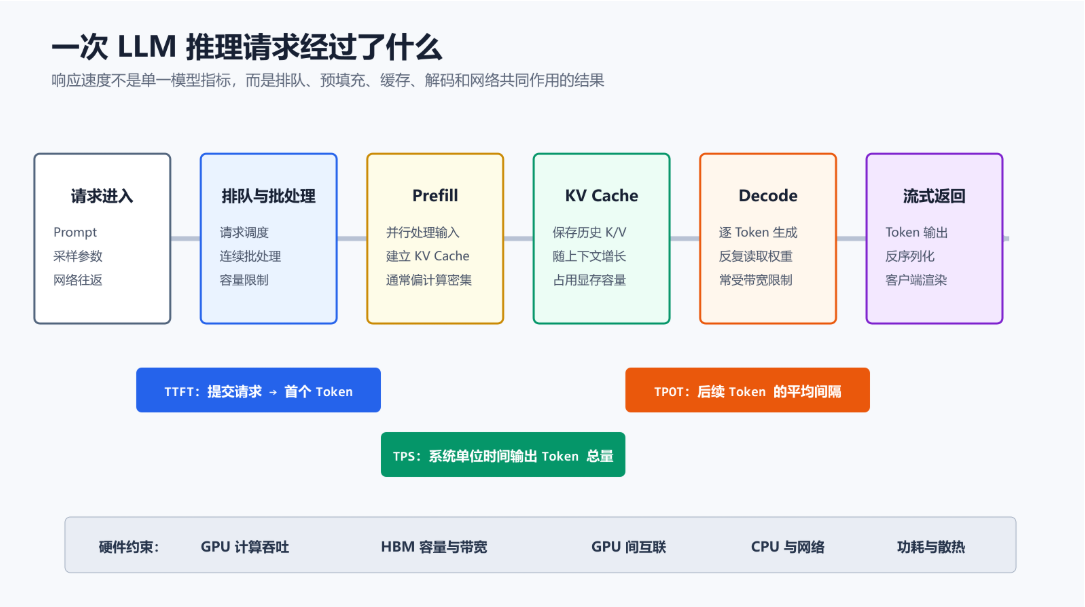
大语言模型推理是一条完整链路。请求要经过网络、排队和批处理,模型先读取全部输入并建立 KV Cache,再逐个生成输出 Token。模型权重占用显存,KV Cache 随上下文和并发增长,多张 GPU 之间还要同步中间结果。用户感受到的延迟,是这些环节共同作用的结果。
理解这条链路的意义,不是要求每个人都去设计芯片,而是学会把"推理很慢"拆成可以测量的问题:首字慢在哪里,后续生成为什么慢,并发增加后吞吐是否仍然上升,显存究竟被权重还是缓存占满。
2 -> 一次请求包含两个性质不同的计算阶段
请求到达服务后,通常先进入调度队列。服务端会根据显存、批次 Token 上限和调度策略,把一个或多个请求组合起来。模型真正执行时,可以把过程分成 Prefill 和 Decode 两个阶段。
Prefill 会并行处理全部输入 Token,计算每一层注意力需要的 Key 和 Value,并把它们保存到 KV Cache。输入越长,需要处理的 Token 越多,首个输出通常就越晚出现。Prefill 能形成较大的矩阵运算,通常更容易利用 GPU 计算单元。
Decode 每次只生成一个新 Token。新 Token 会查询之前已经保存的 KV Cache,并经过模型各层得到下一个 Token 的概率。这个过程具有自回归依赖,前一个 Token 没生成,后一个 Token 就不能开始。在较小批次下,Decode 经常需要反复读取大量权重和缓存,因而更容易受到显存带宽限制。
"Prefill 偏计算密集、Decode 偏内存带宽密集"是常见近似,不是对所有模型和批次都成立的铁律。批次、量化方式、模型结构和硬件都会改变算术强度。但这个近似足以解释一个常见现象:增加计算峰值可能明显改善长 Prompt 的首字时间,却不一定同比提高单用户的逐 Token 生成速度。
FlashAttention 论文进一步说明,注意力性能不仅取决于浮点运算量,还取决于 GPU 高带宽内存与片上 SRAM 之间的数据读写。它通过分块计算减少内存访问,在保持精确注意力结果的情况下改善运行时间和内存占用。这也是为什么只比较芯片的理论算力并不足以预测真实推理速度。
3 -> 先统一指标,再讨论快慢
推理系统最常用的指标包括 TTFT、TPOT、端到端延迟和系统吞吐。不同工具对边界的定义可能略有差异,比较结果前必须确认口径。NVIDIA 的推理基准指标文档给出了这些指标的一套明确说明。
| 指标 | 含义 | 主要受什么影响 | 用户感受 |
|---|---|---|---|
| TTFT | 从提交请求到收到首个有效 Token | 排队、网络、输入长度、Prefill | 等多久开始看到回答 |
| TPOT / ITL | 首个 Token 之后,相邻输出 Token 的平均间隔 | Decode、显存带宽、KV Cache、并行通信 | 回答生成是否流畅 |
| E2E Latency | 从请求开始到完整回答结束 | TTFT、输出长度、TPOT | 整个任务花多久 |
| TPS | 系统单位时间输出的 Token 总数 | 批处理、并发、硬件利用率 | 服务总体处理能力 |
| RPS | 系统每秒完成的请求数 | 请求长度分布、TPS、排队策略 | 服务能承受多少请求 |
若输出 Token 数为 N,并且 N > 1,常见的 TPOT 计算方式是:
text
TPOT = (end_time - first_token_time) / (N - 1)系统 TPS 则可以用测试窗口内输出 Token 总数除以从第一个请求开始到最后一个请求结束的时间。必须注意,TPS 高不代表单个用户体验一定好。提高并发和批次可以增加系统总吞吐,却可能让每个请求排队更久,导致 TTFT 和 TPOT 上升。工程上要寻找满足延迟目标时的最高吞吐,而不是单独追求一个最大数字。
4 -> 显存先装权重,剩余空间才属于 KV Cache
部署模型前,首先要做容量预算。最粗略的权重显存可以这样估算:
text
权重容量 ≈ 参数量 × 每个参数的字节数一个 70B 参数模型以 BF16 或 FP16 保存,理论权重约为 70 × 10^9 × 2 字节,也就是约 140 GB。采用 8 位或 4 位量化后,理论权重可以下降到约 70 GB 或 35 GB,但实际运行还要考虑量化元数据、临时缓冲区、框架开销和显存碎片,不能把理论值直接当成部署上限。
KV Cache 的大小取决于模型层数、KV 头数量、每个头的维度、上下文 Token 数和数据精度。对常见 Transformer,可以用下面的近似式:
text
KV Cache 字节数
≈ 2 × 层数 × KV头数 × 头维度 × Token数 × 每元素字节数
最前面的 2 分别代表 Key 和 Value。采用 GQA 或 MQA 的模型,其 KV 头数可能显著少于查询头数,因此缓存需求也会下降。
下面的 Python 函数可以快速估算单个请求和多并发下的 KV Cache 理论容量:
python
def kv_cache_gib(
    layers: int,
    kv_heads: int,
    head_dim: int,
    tokens: int,
    bytes_per_element: int = 2,
    concurrency: int = 1,
) -> float:
    bytes_per_request = (
        2
        * layers
        * kv_heads
        * head_dim
        * tokens
        * bytes_per_element
    )
    total_bytes = bytes_per_request * concurrency
    return total_bytes / (1024**3)


single = kv_cache_gib(
    layers=32,
    kv_heads=8,
    head_dim=128,
    tokens=8192,
)
concurrent = kv_cache_gib(
    layers=32,
    kv_heads=8,
    head_dim=128,
    tokens=8192,
    concurrency=16,
)

print(f"single request: {single:.2f} GiB")
print(f"16 concurrent requests: {concurrent:.2f} GiB")
这组参数下,每个 Token 的 KV 数据约为 128 KiB,8,192 Token 的单请求缓存约为 1 GiB,16 个同长度并发请求约需 16 GiB。实际服务还会受到缓存块大小、序列长度差异、前缀共享和实现开销影响,但这个数量级已经能说明为什么长上下文与高并发很容易吃掉权重之外的显存。
PagedAttention 论文借鉴操作系统分页思想,把每个请求的 KV Cache 划分为块,减少连续内存预留造成的碎片,并支持缓存块共享。它解决的主要是缓存管理效率,不会让 KV 数据本身凭空消失。若上下文和并发都持续增长,容量预算仍然不可省略。
5 -> 每种优化手段解决的问题不同
推理优化不能从"最流行的技术"开始,而应从已经测到的瓶颈开始。
| 技术 | 主要解决什么 | 可能的代价或边界 |
|---|---|---|
| 量化 | 降低权重容量和内存带宽压力 | 可能影响精度,部分硬件未必有高效内核 |
| FlashAttention | 减少注意力计算的内存读写 | 需要模型、精度与硬件内核支持 |
| PagedAttention | 降低 KV Cache 碎片,支持动态分配 | 仍受总显存和上下文长度限制 |
| 连续批处理 | 请求结束后立即补入新请求,提高利用率 | 批次过大可能损害交互延迟 |
| 前缀缓存 | 复用重复系统提示或公共前缀的 KV | 前缀必须一致,缓存需要淘汰策略 |
| 推测解码 | 用较小模型提议多个 Token,由大模型验证 | 接受率低时收益有限,还增加系统复杂度 |
| 张量并行 | 将单个模型权重拆到多张 GPU | 每层都可能发生通信,互联性能很重要 |
| Prefill/Decode 分离 | 分别调度两种性质不同的负载 | KV 传输、路由和容量规划更复杂 |
连续批处理会在每一步 Decode 后重新组织批次,已完成请求离开,新请求立即加入,不必等待整个静态批次结束。Hugging Face 的连续批处理文档也把调度策略、最大批次 Token、分页缓存和前缀缓存列为相互关联的配置。提高批次上限通常有利于吞吐,但如果大量长 Prompt 与短交互请求混在一起,用户可见延迟可能变差。
张量并行则解决单张 GPU 放不下模型的问题。权重被切分后,各 GPU 分别计算局部结果,再通过高速互联同步。GPU 数量增加并不保证线性加速;如果通信时间抵消了计算收益,更多设备反而可能提高成本却没有改善延迟。
6 -> 用一份日志计算 TTFT、TPOT 和系统吞吐
优化之前,至少要保存请求开始时间、首个 Token 时间、结束时间、输入 Token 数和输出 Token 数。假设基准工具导出了下面的 CSV:
csv
request_id,start_ts,first_token_ts,end_ts,input_tokens,output_tokens
r1,0.00,0.42,3.10,1024,80
r2,0.15,0.71,4.36,4096,96
r3,0.40,0.88,2.92,512,64
下面的标准库脚本可以计算每个请求的指标,以及测试窗口的 p50、p95 和总 TPS:
python
from __future__ import annotations

import csv
import math
from pathlib import Path


def percentile(values: list[float], q: float) -> float:
    if not values:
        raise ValueError("values must not be empty")
    ordered = sorted(values)
    position = (len(ordered) - 1) * q
    lower = math.floor(position)
    upper = math.ceil(position)
    if lower == upper:
        return ordered[lower]
    weight = position - lower
    return ordered[lower] * (1 - weight) + ordered[upper] * weight


rows: list[dict[str, float | int | str]] = []
with Path("requests.csv").open(encoding="utf-8", newline="") as file:
    for raw in csv.DictReader(file):
        output_tokens = int(raw["output_tokens"])
        start = float(raw["start_ts"])
        first = float(raw["first_token_ts"])
        end = float(raw["end_ts"])

        if not start <= first <= end:
            raise ValueError(f"invalid timestamps for {raw['request_id']}")
        if output_tokens < 1:
            raise ValueError(f"no output token for {raw['request_id']}")

        ttft = first - start
        e2e = end - start
        tpot = 0.0 if output_tokens == 1 else (end - first) / (output_tokens - 1)
        rows.append(
            {
                "id": raw["request_id"],
                "start": start,
                "end": end,
                "output_tokens": output_tokens,
                "ttft": ttft,
                "tpot": tpot,
                "e2e": e2e,
            }
        )

ttfts = [float(row["ttft"]) for row in rows]
tpots = [float(row["tpot"]) for row in rows]

window = max(float(row["end"]) for row in rows) - min(
    float(row["start"]) for row in rows
)
total_output_tokens = sum(int(row["output_tokens"]) for row in rows)
system_tps = total_output_tokens / window

print(f"requests: {len(rows)}")
print(f"TTFT p50/p95: {percentile(ttfts, 0.50):.3f}s / {percentile(ttfts, 0.95):.3f}s")
print(f"TPOT p50/p95: {percentile(tpots, 0.50):.4f}s / {percentile(tpots, 0.95):.4f}s")
print(f"system TPS: {system_tps:.2f}")
真实压测时,样本必须足够多,并区分预热阶段。还要按输入长度、输出长度和并发分桶,否则一个"平均 TTFT"可能只是请求分布变化的结果。对比两个系统时,模型、精度、采样参数、上下文长度、并发和完成条件都应保持一致。
7 -> 一套可复用的排查顺序
第一步先定义服务目标。例如交互场景可能更关注 TTFT 和 p95 TPOT,离线摘要则更关注单位时间吞吐和成本。没有目标,任何优化都可能只是把压力从一个指标转移到另一个指标。
第二步固定工作负载。选择几组有代表性的输入和输出长度,记录模型版本、精度、GPU 型号、服务框架和配置。先测单并发基线,再逐级增加并发,直到吞吐停止增长或延迟超出目标。
第三步做容量预算。确认权重、KV Cache 和运行时缓冲区都能放入显存,并预留安全余量。若模型本身放不下,先解决量化、并行或硬件容量;若只有长上下文和高并发失败,再重点检查 KV Cache。
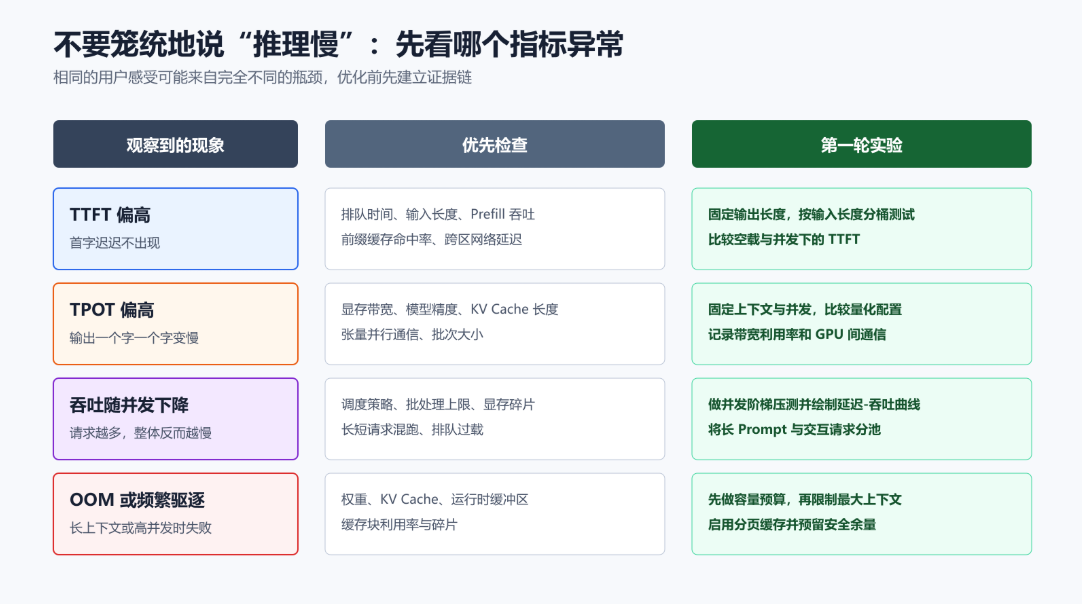
第四步根据指标定位。TTFT 随输入长度明显上升,要检查 Prefill 和排队;TPOT 在上下文增长后恶化,要检查带宽和 KV Cache;总吞吐在高并发下降,要检查调度、批处理和过载;多 GPU 比单 GPU 更慢,则要检查通信比例和并行策略。
第五步一次只改变一个主要变量。启用量化、调整批次、打开前缀缓存和更换并行方式如果同时发生,即使结果变好,也无法知道哪项改变有效。每轮都应保存配置、指标和失败样本。
模型能力决定了系统能回答什么,服务工程决定了这种能力以多快、多稳定、多高成本到达用户。把推理看成一条可测量的链路后,"换一张更快的卡"不再是默认答案。很多问题可能出在调度、缓存、上下文设计或通信,也可能只是指标口径没有统一。
性能优化的起点不是某个框架名称,而是一份可重复的工作负载和一组定义清楚的指标。先找到瓶颈,再选择技术,最后用相同测试验证变化,通常比堆叠所有流行优化更可靠。
感谢各位大佬支持!!!
互三啦!!!