Windows 部署 Papra:建立私有文档库、标签管理,再配置固定公网访问
前言
文件多起来以后,真正让人头疼的往往不是"存不下",而是明明记得内容,却想不起文件名,也不确定当初到底扔进了哪个文件夹。发票、脚本、PDF、临时资料越积越多,靠层层目录硬整理,很快就会变成新的负担。我更喜欢把文档先集中到一个地方,再用标签、搜索和成员协作把它们重新组织起来。Papra 正好属于这类工具:它本身可以自托管,用浏览器就能上传、查看和管理文档,还支持标签、组织、全文搜索、内容提取、规则标记、文件夹摄取、API 等能力。
这次我先在 Windows 上用 Docker 部署 Papra,使用 1221:1221 端口映射,通过 localhost:1221 打开页面;随后实际注册账号、切换主题、创建"发票""脚本"等标签、上传文件、打开文档并添加标签,再看成员邀请功能。等本地文档库能正常使用以后,再安装 cpolar,把 1221 页面提供到公网,并直接配置固定二级子域名。对我来说,这类工具真正有价值的地方,不是把"自动分类"几个字写得多漂亮,而是文件上传以后能不能持续整理、以后找资料时能不能少翻几层目录、多人协作时是不是还要反复发附件。这里我更关心已经跑通的文档管理流程,不把还没展示出来的自动化能力先写成结果。
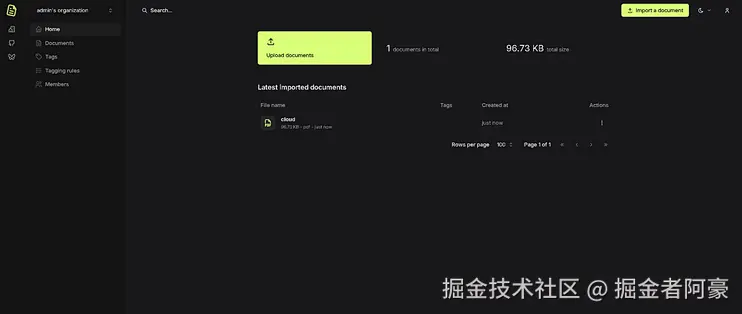
1. Papra 适合拿来做什么?
Papra 是一款开源、自托管的文档管理工具。
它的核心思路不是继续往系统文件夹里堆资料,而是把文档集中放进一个浏览器入口,再通过标签、搜索和成员协作来管理。
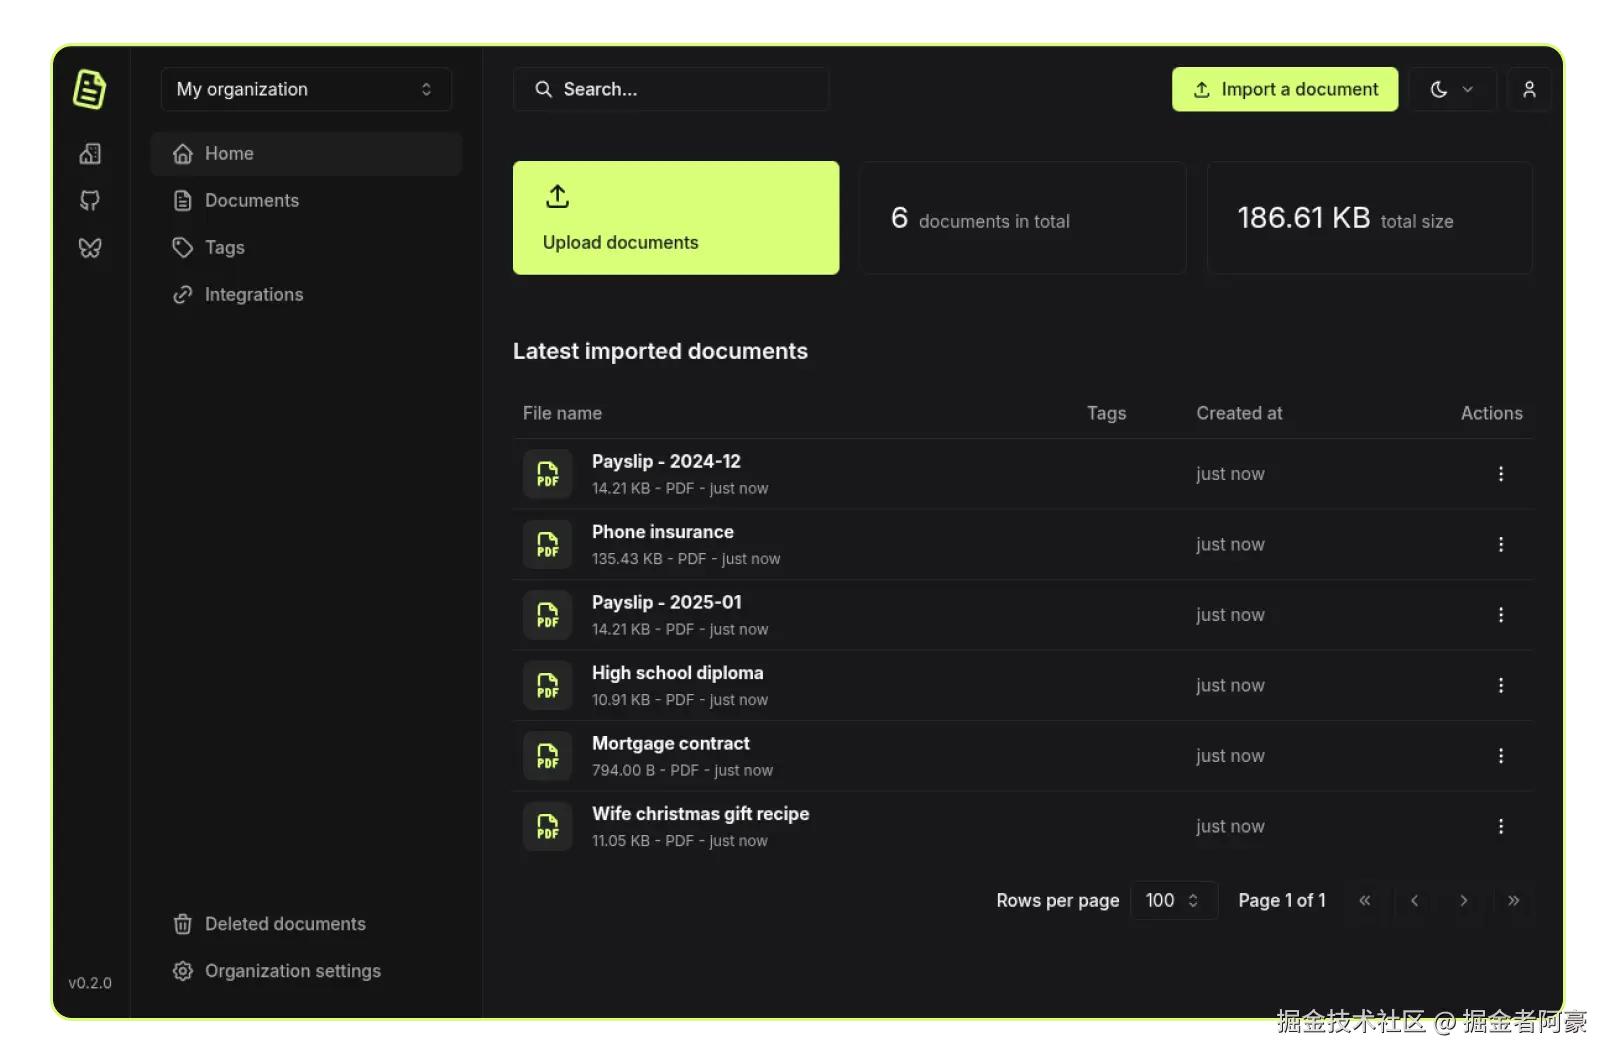
当前介绍中提到的能力包括:
- 文档上传、存储和管理;
- 创建组织,与家人、朋友或同事共同管理文档;
- 全文搜索;
- 用户账号与身份验证;
- 深色模式;
- 响应式页面;
- Docker 自托管;
- 标签;
- 邮件摄取;
- 内容提取;
- 标记规则;
- 文件夹摄取;
- CLI;
- API、SDK 和 Webhook;
- 多语言支持。
这些能力看起来很完整,但我更愿意先从最常用的几项开始:能不能上传、能不能打开、能不能打标签、能不能让别人一起管理。
至于"自动分类""根据内容自动打标签"这类效果,当前实际操作截图没有继续展示规则配置和自动分类结果,所以不把它直接写成已经完成的实测结论。
2. Windows 上用 Docker 部署 Papra
这次直接使用 Docker。
打开终端执行:
shell
docker run -d --name papra -p 1221:1221 ghcr.io/papra-hq/papra:latest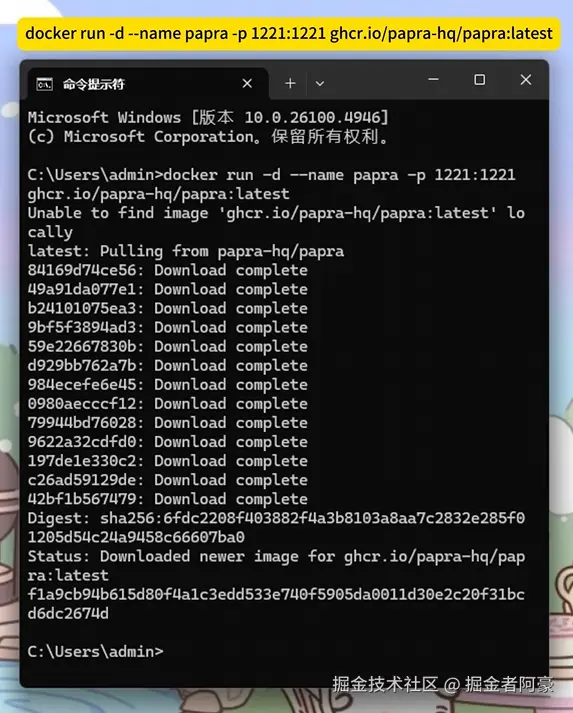
这里几个关键参数很简单:
- 容器名:
papra - 端口映射:
1221:1221 - 镜像:
ghcr.io/papra-hq/papra:latest
部署完成后,在浏览器访问:
localhost:1221
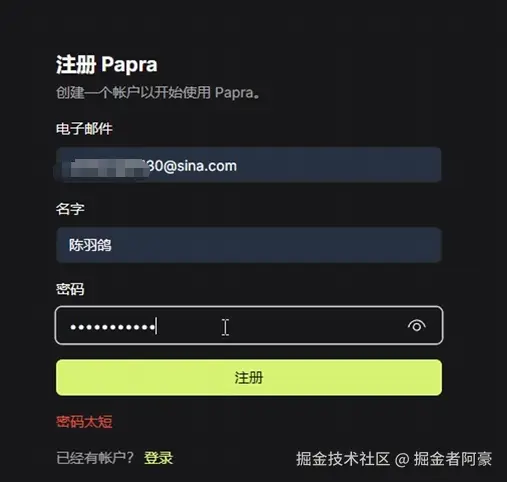
能够看到登录页面以后,说明 Papra 服务已经正常启动。
3. 先注册账号,再看主页面
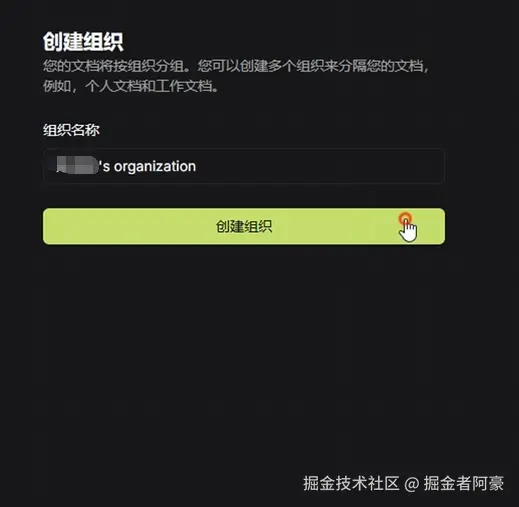
第一次使用先注册一个账号。
登录后进入主界面。
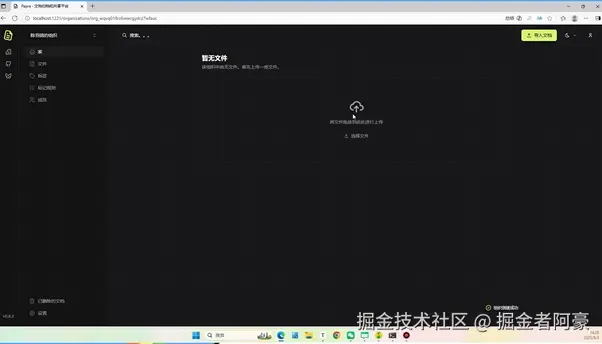
页面右上角可以切换颜色主题。
对这种需要长期打开的管理工具来说,界面是否复杂不是最重要的,关键是常用入口够不够直接。Papra 的标签、上传、成员这些功能都放得比较集中,后面管理文件时不用来回翻层级。
4. 先建立一套自己的标签
进入标签功能。
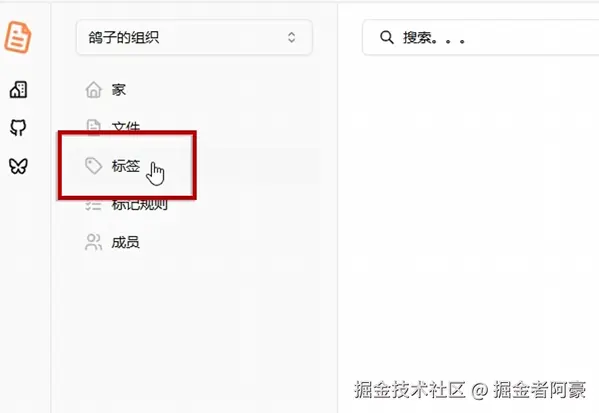
可以先按自己的文件类型创建标签。
例如:
- 发票
- 脚本
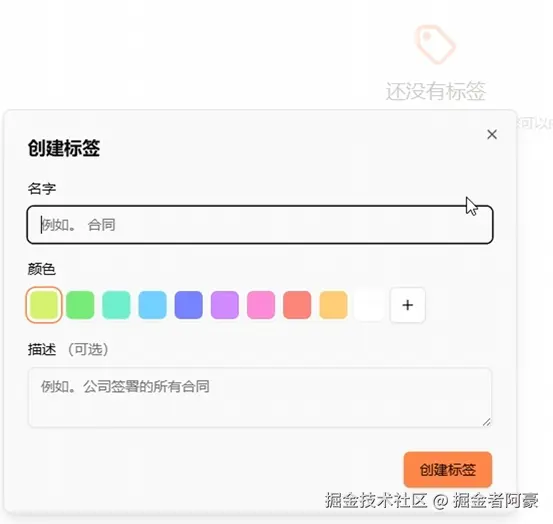
这里我更喜欢先从真实使用习惯出发,而不是一上来就建立几十个分类。标签太多以后,本身也会变成新的整理负担。
先把最常用的几类建起来,后面再根据文件数量慢慢补,反而更容易长期坚持。
5. 上传文件,真正开始建立文档库
点击上传文件。
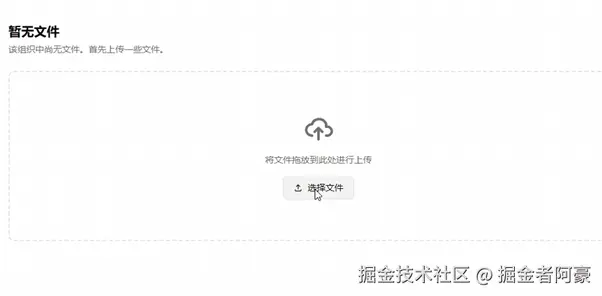
上传完成以后,Papra 就开始承担"统一文档入口"的角色。
相比继续把文件散落在桌面、下载目录和各种项目文件夹里,这种方式更适合那些"以后肯定还要找回来"的资料。
6. 打开文档,查看、贴标签和下载
点击已经上传的文件。
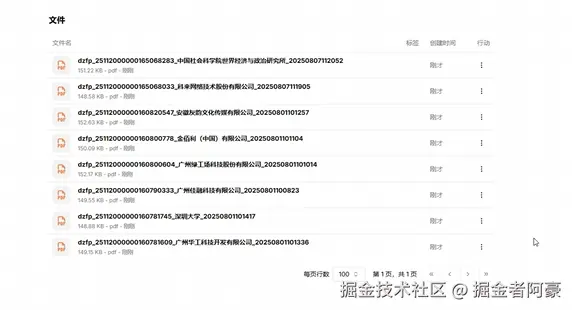
在文档页面里,可以:
- 查看文件;
- 添加标签;
- 下载文件;
- 继续做后续管理。
这一步才真正把"存文件"和"管理文件"区分开。
如果只是把文件扔进一个新目录,那只是换了地方堆;能重新打标签、查看和检索,才更接近一个文档库。
7. 成员功能适合做共享文档库
进入成员功能,可以邀请其他人加入。
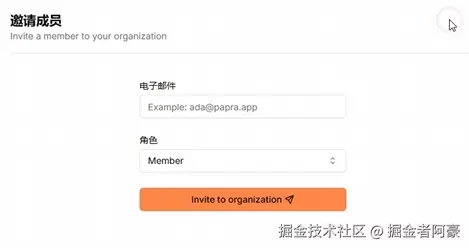
这意味着 Papra 不一定只能作为个人资料库,也可以继续扩展成家庭或小团队共享的文档空间。
比如:
- 家庭票据;
- 项目文档;
- 团队资料;
- 需要多人查看的归档文件。
这类场景里,比"把文件发来发去"更省事的,是大家进入同一个文档库看同一份资料。
8. 本地文档库跑通以后,再考虑外网访问
如果 Papra 只在当前 Windows 电脑上使用,localhost:1221 已经够用。
但如果人在公司、出差,或者想从手机上打开自己的文档库,就需要再增加一个外网入口。
这里 cpolar 的职责很明确:
Papra 负责文档管理,cpolar 只负责把本地
1221Web 页面提供到公网。
它不会替 Papra 自动分类、搜索文档或者管理成员,应用和网络入口仍然是两层独立功能。
9. Windows 安装 cpolar
先注册 cpolar 账号。
下载 Windows 版本并安装。
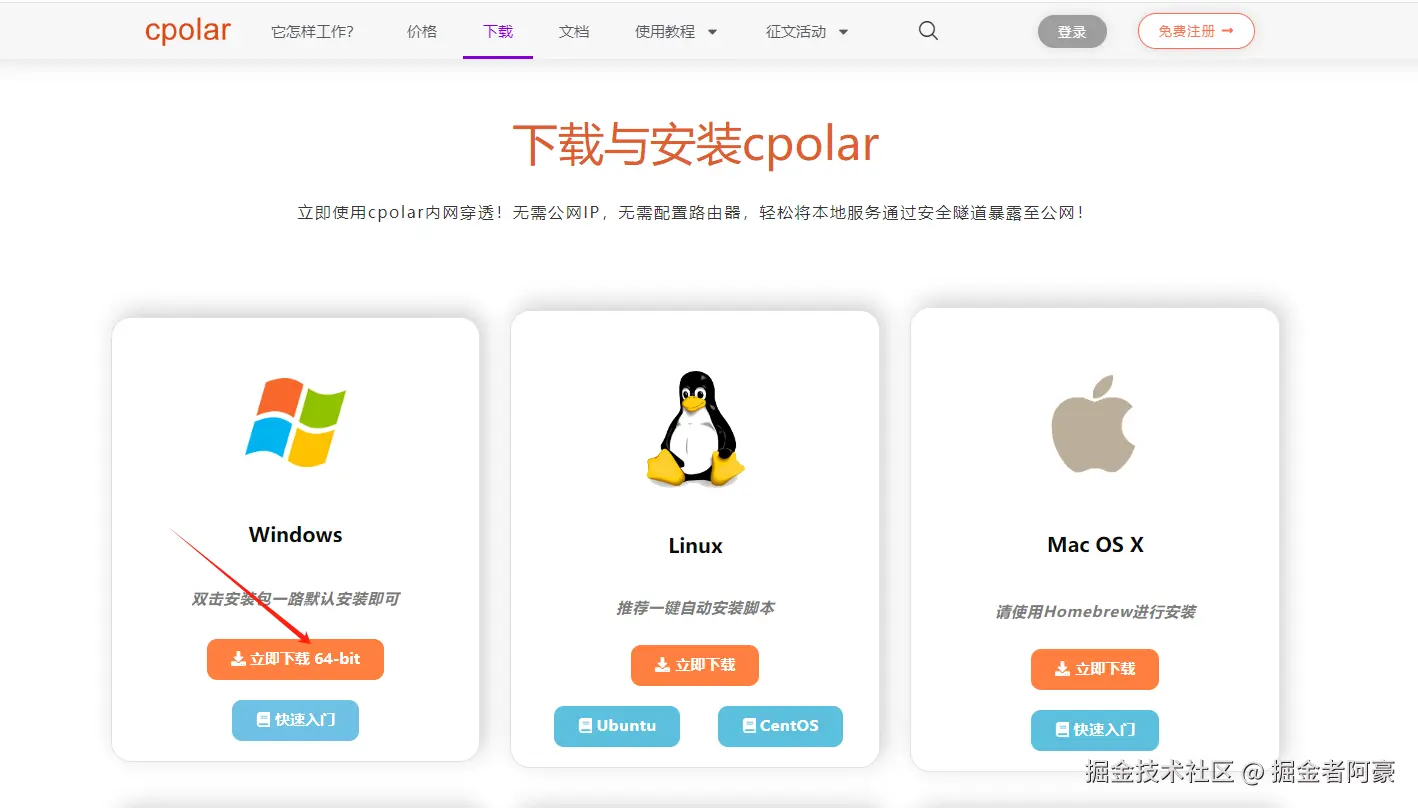
安装成功以后,在浏览器访问:
http://localhost:9200
使用 cpolar 账号登录 Web 管理界面。
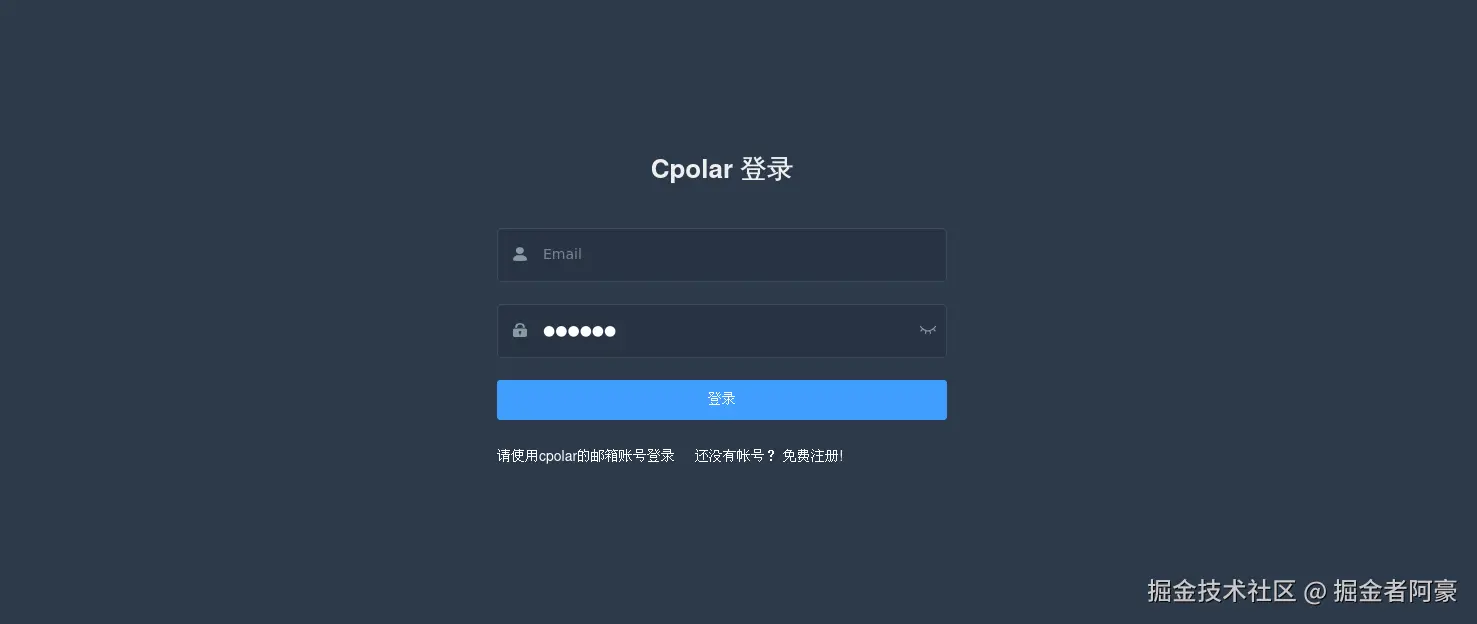
10. 给 Papra 创建固定公网入口
进入【隧道管理 → 创建隧道】,当前配置为:
- 隧道名称:
papra - 协议:
http - 本地地址:
1221 - 域名类型:二级子域名
- 地区:
China Top
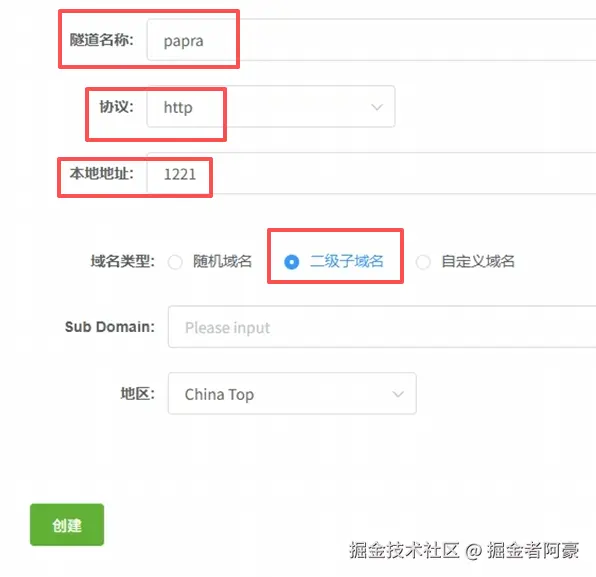
这次不是先跑随机域名,而是直接按照长期使用思路配置二级子域名。
11. 先保留二级子域名
登录 cpolar 官网,进入预留功能。
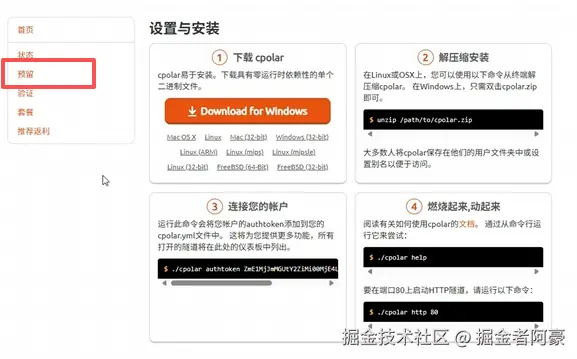
选择保留二级子域名。
当前地区记录为:
china top
名称可以按自己的账户情况设置。
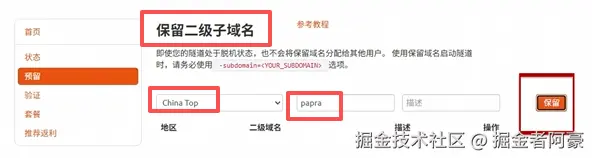
保留成功以后,把子域名复制下来。
12. 回到隧道配置完成绑定
返回 cpolar Web UI,把刚才保留的子域名填写到域名配置中,然后创建。
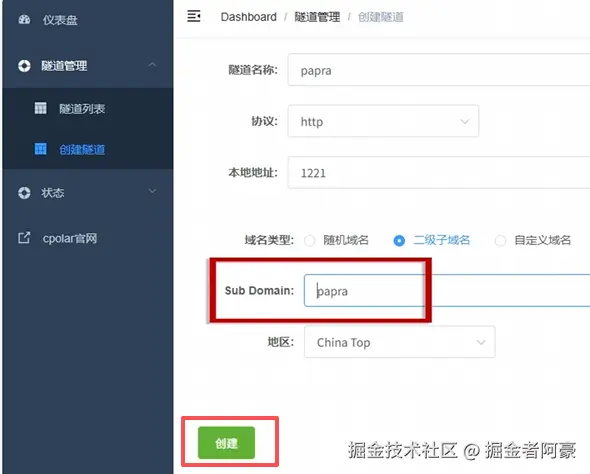
创建完成以后,在在线隧道列表可以看到两个公网地址。
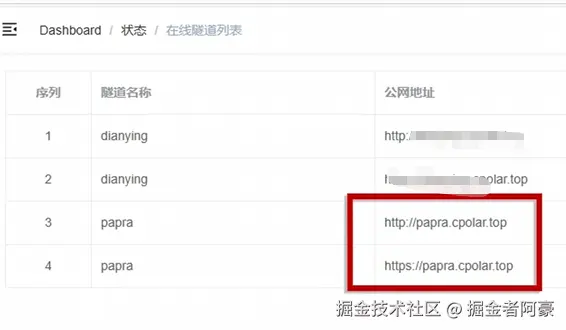
从其他电脑或移动设备打开其中一个地址。
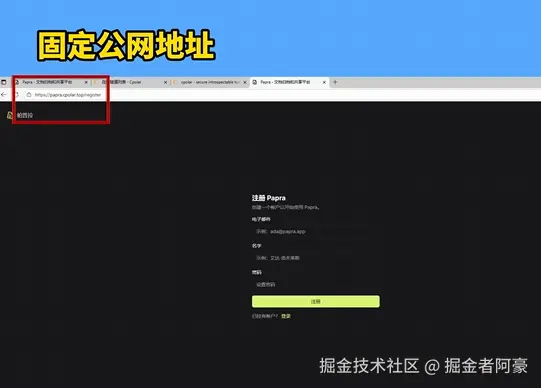
Papra 页面可以正常访问。
这一步确认的是:
Papra 1221 → cpolar HTTP 隧道 → 固定二级子域名 → 外部浏览器访问成功。
总结
Papra 对我来说最实用的地方,不是"文件会自己变整齐",而是把原本散落在不同文件夹里的资料集中到一个可以继续整理的入口里。
这次实际走通的链路是:
Windows → Docker → ghcr.io/papra-hq/papra:latest → 1221:1221 → localhost:1221 → 注册账号 → 标签 → 上传文件 → 查看 / 打标签 / 下载 → 成员邀请 → cpolar → 1221 → 固定二级子域名。
几个关键技术点包括:
- 镜像:
ghcr.io/papra-hq/papra:latest - 容器名:
papra - 端口:
1221:1221 - 本地访问:
localhost:1221 - cpolar Web UI:
http://localhost:9200 - 隧道名称:
papra - 协议:
http - 本地地址:
1221 - 地区记录:
China Top/china top - 域名类型:二级子域名
如果你最头疼的是"文件明明在,但就是找不到",Papra 这种做法比继续堆文件夹更值得尝试。至于自动标签、全文搜索、内容提取、邮件摄取等进阶能力,可以在基础文档库用顺以后再逐项验证,不必一开始就把所有功能一起上。