一、常见容器
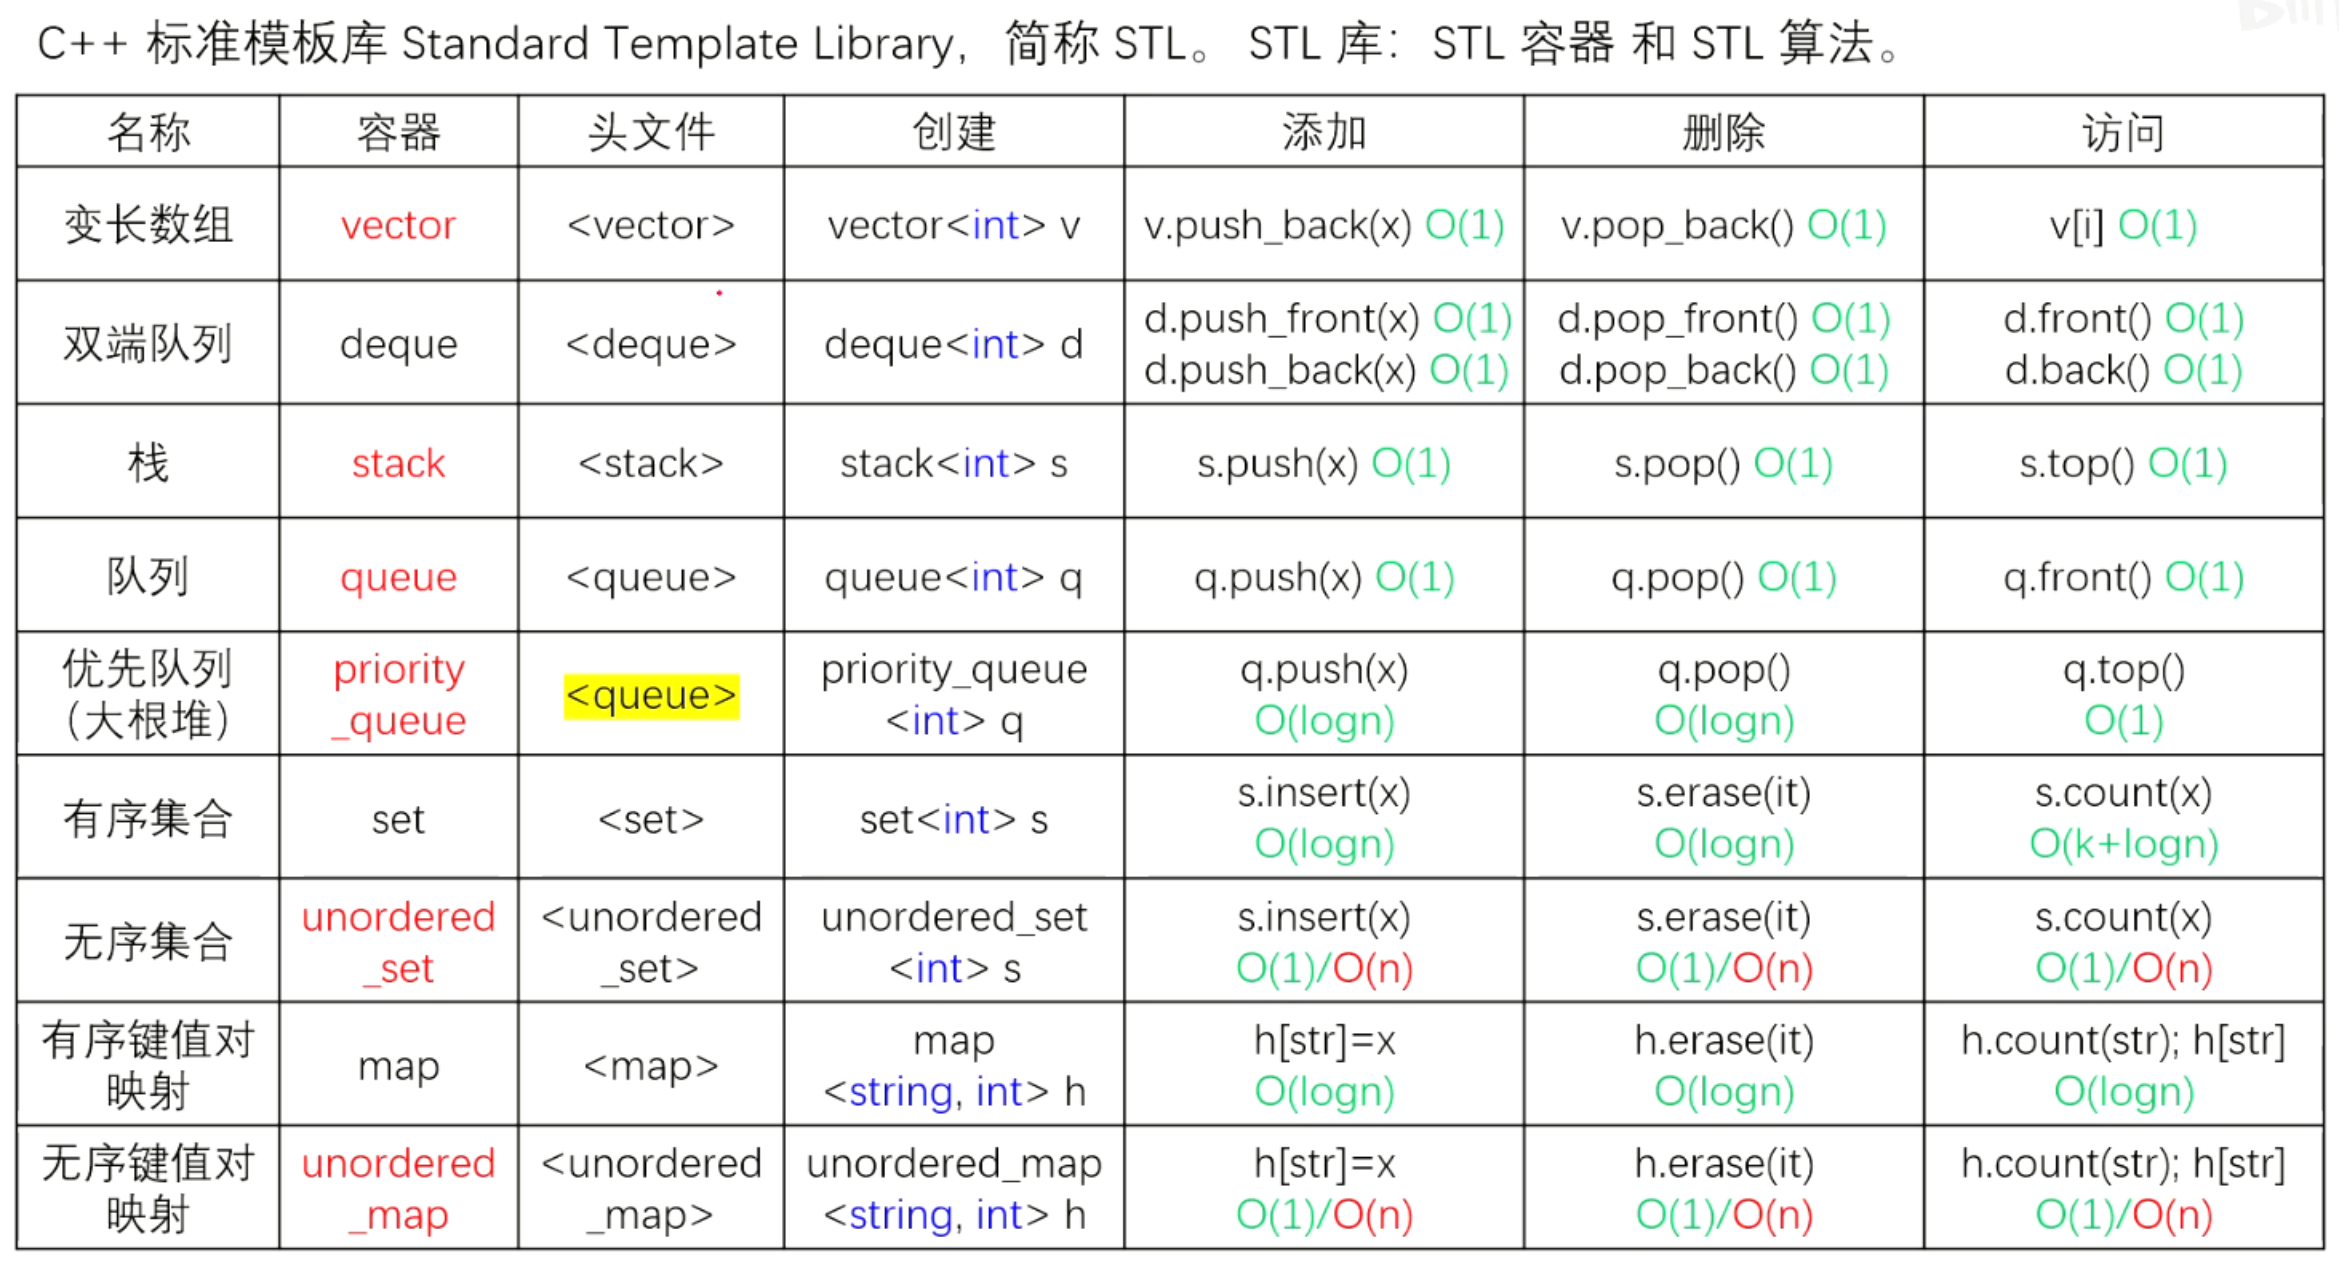
1. vector 变长数组
头文件:#include <vector>
vector<int> v; // 创建,存int类型
v.push_back(10); // 在尾部添加元素,O(1)
v.pop_back(); // 删除尾部元素,O(1)
cout << v[0]; // 像普通数组一样下标访问,O(1)✅特点:连续内存,支持下标随机访问,只能高效在尾部增删;在中间插入删除很慢。 👉适用:普通数组,不知道长度,需要频繁尾部加数据。
2. deque 双端队列
头文件:#include <deque>
deque<int> d;
d.push_back(1); // 尾部加
d.push_front(2); // 头部加
d.pop_back(); // 删尾部
d.pop_front(); // 删头部
d.front(); // 获取队首元素
d.back(); // 获取队尾元素✅特点:头部、尾部都可以 O (1) 增删,但是内存不连续,随机访问比 vector 慢。 👉适用:需要同时在两头插入删除。
3. stack 栈(后进先出 LIFO)
头文件:#include <stack>
stack<int> s;
s.push(5); // 压栈,添加元素
s.pop(); // 弹出栈顶(只删不取)
s.top(); // 获取栈顶元素✅特点:后进先出,只能操作栈顶,不能访问中间元素。 👉适用:表达式求值、递归模拟、回溯。
4. queue 队列(先进先出 FIFO)
头文件:#include <queue>
queue<int> q;
q.push(10); // 队尾入队
q.pop(); // 队首出队(只删不取)
q.front(); // 获取队首元素
✅特点:先进先出,只能拿队首,不能访问内部。 👉适用:BFS 广度优先搜索、任务排队。
5. priority_queue 优先队列(大根堆)
头文件:#include <queue>!!注意,和 queue 同一个头文件
priority_queue<int> q;
q.push(3); // 插入,自动维护堆结构 O(logn)
q.pop(); // 删除堆顶最大值 O(logn)
q.top(); // 获取当前最大值 O(1)✅特点:默认大根堆,每次 top 拿到当前最大元素。插入删除都要调整堆,复杂度\(O(logn)\)。 👉适用:topK 问题,每次要拿最大 / 最小值。
6. 小根堆(小顶堆)写法
记住:priority_queue默认是大根堆 ,堆顶是最大值; 想要小根堆,堆顶永远是最小值,要补全 3 个模板参数!
头文件依然是 <queue>,不用改
priority_queue<int, vector<int>, greater<int>> min_heap;
priority_queue< 类型 , 底层容器 , 比较器 >int:存的数据类型vector<int>:底层存储用 vector(固定写)greater<int>:比较器,代表小根堆
对比:
- 默认大根堆:
priority_queue<int> q;等价于priority_queue<int,vector<int>,less<int>> q;- 小根堆:
greater<int>
⚠️ 很多人疑惑:greater 意思是更大,为什么变成小根堆?
priority_queue 的比较器规则和 sort 是反过来 的!
greater<int>的含义:大的元素优先级更低,沉到底下;小数上浮到堆顶。
大根堆:直接写priority_queue<int> q;小根堆:
priority_queue<int,vector<int>,greater<int>> q;
6. set 有序集合
头文件:#include <set>
set<int> s;
s.insert(5); //插入元素,自动排序、自动去重 O(logn)
s.erase(it); // 删除迭代器it指向的元素 O(logn)
s.count(5); // 判断5是否存在,存在返回1,不存在0✅特点:元素自动升序,不能存重复值,底层红黑树。查找、插入删除都是\(O(logn)\)。 👉适用:需要自动排序 + 去重。
7. unordered_set 无序集合(哈希表)
头文件:#include <unordered_set>
unordered_set<int> s;
s.insert(5);
s.erase(it);
s.count(5);✅特点:不排序,自动去重,底层哈希表。平均\(O(1)\)操作;最坏哈希冲突时退化到\(O(n)\)。 👉适用:只需要判断元素是否存在,不需要排序,追求速度。
8. map 有序键值对映射
头文件:#include <map>
map<string, int> h;
h["zhangsan"] = 18; // 添加/修改键值对
h.erase(it);
h.count("zhangsan"); // 判断key是否存在
cout << h["zhangsan"]; // 通过key取value
✅特点:key 自动排序,key 不能重复,红黑树,操作\(O(logn)\)。 👉适用:需要 key 有序的字典。
9. unordered_map 无序键值对映射(哈希字典)
头文件:#include <unordered_map>
unordered_map<string, int> h;
h["lisi"] = 20;
✅特点:key 不排序,哈希表,平均\(O(1)\),最坏\(O(n)\)。 👉适用:字典,查找 key,不需要排序,追求快,刷题最常用!
二、快速对比记忆(刷题必看)
- 需要下标随机访问 → vector
- 两头都要增删 → deque
- 后进先出 → stack
- 先进先出 → queue
- 每次拿最大 / 最小 → priority_queue
- 元素去重 + 有序 → set
- 元素去重,不需要有序 → unordered_set
- key-value,key 有序 → map
- key-value,不需要有序(优先选这个)→ unordered_map
小考点:
map/set红黑树,稳定\(O(logn)\);unordered_map/unordered_set哈希表,平均\(O(1)\)。
三、STL 容器通用函数
先记住:绝大多数容器都支持这几个通用函数(vector/deque/set/map/unordered_map/unordered_set)
stack、queue、priority_queue 属于适配器容器,没有迭代器,部分函数不一样!
-
.size()返回容器里元素个数 ,返回值类型是size_t(无符号整数)vector<int>v; v.push_back(1); cout << v.size(); //输出1 -
.empty()判断容器是否为空 ,空返回true,非空false。 刷题推荐优先用 empty 判断,比size()==0更好。if(v.empty()){ //里面没有元素 } -
.clear()清空所有元素 ,size 变成 0。 ❗注意:stack /queue/priority_queue 没有 clear () !v.clear(); cout << v.size(); // 0 -
.begin()返回首元素迭代器 ;.end()返回末尾后一位迭代器v.begin()取第一个元素- 用于 for 遍历、sort、find、erase
stack、queue、priority_queue 没有 begin /end,不能用迭代器遍历!