转载请注明出处:小锋学长生活大爆炸
如果本文帮助到了你,欢迎点赞、收藏、关注哦~
4GB 显存也能跑 70B 大模型:AirLLM 使用笔记
显存不够,怎么跑大模型?
一个 70B 的模型,仅权重就要占 140GB 左右(bf16,70B × 2 bytes)。这是把模型"放进去"的底线成本。4GB、8GB 这类消费级显卡,连一个 7B 模型的完整权重都难常驻。
跑大模型,常见的做法有两种:
-
- 加算力:多卡,或者上云按 token 付费。上云要出本地数据,还涉及隐私合规。
-
- 量化:用 GPTQ、AWQ、GGUF 把权重压到 4bit,代价是精度损失。
AirLLM 提供另一种方式:不动模型权重,不量化,也不加卡,只改变权重进入显存的方式。
项目在 GitHub 上有 33k+ Star(2026 年 8 月查),协议 Apache-2.0。Slogan 是 "70B inference with single 4GB GPU"。
下面先说它能跑什么,再说怎么跑,最后说原理和局限。
先看结果
下表数据来自官方表格和更新日志,都是端到端实测,不是估算:
| Model | Size | GPU VRAM |
|---|---|---|
| Qwen3 / Mistral / Phi (≈8B) | 8B | ~1--2 GB |
| Qwen3-30B / Mixtral (MoE) | 30--47B | ~1--3 GB |
| Qwen3.8-27B (dense VL) | 27B | 3.33 GB(RTX 3090) |
| Qwen3.8-Flash-Next (MoE + PLE) | ~180B | 5.95 GB(RTX 4090) |
| Qwen3-235B (MoE) | 235B | ~3 GB |
| Llama 3.x 70B (full precision) | 70B | ~4 GB |
| Llama 3.1 405B | 405B | ~8 GB |
| DeepSeek-V3 | 671B | ~12 GB |
| Kimi K3 | 2.8T | 3.72 GB(RTX 6000 Ada) |
这些都是 full precision 下的结果,没有量化、蒸馏、剪枝。模型权重原样使用,只是装载方式不同。
支持的模型包括:Llama(2 / 3 / 3.1 / 3.3 / 4)、Qwen(1 / 2 / 2.5 / 3 / 3.5 / 3.8,含 MoE、FP8、原生 VL)、DeepSeek(V2 / V3 / R1)、Mistral & Mixtral、Phi、Gemma、ChatGLM、Baichuan、InternLM、Yi、Kimi K3。多数新模型发布当天即可支持。
三行代码跑起来
安装:
pip install airllm推理:
from airllm import AutoModel

MAX_LENGTH = 128
# just pass a hugging face repo id --- works with almost any popular model:
model = AutoModel.from_pretrained("Qwen/Qwen3-32B")

# go bigger with the exact same one line:
#model = AutoModel.from_pretrained("Qwen/Qwen3.8-27B")          # 27B dense VL, 3.33GB
#model = AutoModel.from_pretrained("Qwen/Qwen3.8-Flash-Next")    # 125B MoE + 51B PLE, 5.95GB
#model = AutoModel.from_pretrained("Qwen/Qwen3-235B-A22B")     # 235B, runs in ~3GB
#model = AutoModel.from_pretrained("deepseek-ai/DeepSeek-V3")  # 671B, runs in ~12GB

# or use a model's local path...
#model = AutoModel.from_pretrained("/home/ubuntu/.cache/huggingface/hub/models--Qwen--Qwen3-32B/snapshots/...")

input_text = [
        'What is the capital of United States?',
        #'I like',
    ]

input_tokens = model.tokenizer(input_text,
    return_tensors="pt",
    return_attention_mask=False,
    truncation=True,
    max_length=MAX_LENGTH,
    padding=False)

generation_output = model.generate(
    input_tokens['input_ids'].cuda(),
    max_new_tokens=20,
    use_cache=True,
    return_dict_in_generate=True)

output = model.tokenizer.decode(generation_output.sequences[0])

print(output)
核心就是 AutoModel.from_pretrained(...) 这一行。传入 Hugging Face repo ID 或本地路径都可以,其余用法和 transformers 模型完全一致。
可选的模型压缩(基于 block-wise quantization):
model = AutoModel.from_pretrained("garage-bAInd/Platypus2-70B-instruct",
                     compression='4bit' # specify '8bit' for 8-bit block-wise quantization
                    )
需要 pip install -U bitsandbytes,且 airllm 版本在 2.0.0 以上。README 给出的数据是最高 3x 提速,精度损失几乎可忽略。
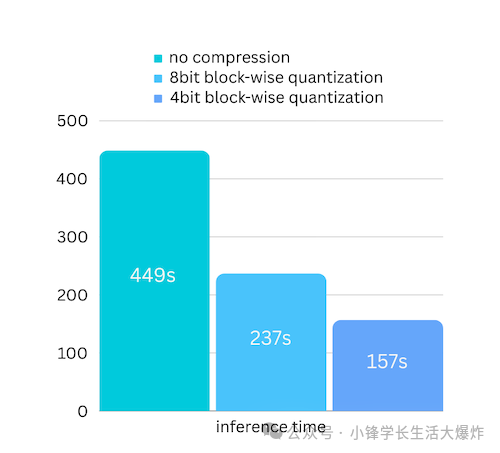
常规量化要同时量化权重和激活值才能真正提速,但激活值里的 outlier 容易破坏精度;AirLLM 的瓶颈在磁盘加载,所以只量化权重即可,精度更容易保持(详见论文 arxiv.org/abs/2212.09720)。
什么时候该用它
适用场景:
-
• 单张消费级显卡上跑大模型,包括 Mac 的 Apple silicon(走 mlx)。
-
• 算法验证、离线批处理、数据不能出内网的场景。
-
• 手头只有 4GB 或 8GB 显卡,想跑 Llama 3.1 405B 这个级别的模型。
-
• 原型阶段先跑通 pipeline,再决定是否上多卡。
局限:
-
• 速度慢。每一层都要从磁盘读入显存,吞吐远低于权重常驻显存的方案。适合离线、低并发,不适合线上高并发服务。
-
• 占磁盘。切层会生成一份分层副本,相当于额外占一份模型空间。Qwen3.8-Flash-Next 官方提示需要约 360GB checkpoint 磁盘。
-
• 版本依赖严格。Kimi K3 需要 transformers 4.56.x + CUDA 12 的 torch + flash-attn(CUDA 13 暂无 flash-attn 预编译 wheel);Qwen3.8-27B 需要 transformers 5.8+;Qwen3.8-Flash-Next 需要带 in-tree qwen4_exp 的 transformers。
-
• compression 与 prefetching 不能同时开,代码会自动关闭 prefetching。
-
• 只支持推理,不解决训练和微调的显存问题。
最后
如果你的显卡跑不动大模型,可以试 AirLLM。建议先从 Qwen/Qwen3-32B 开始,几分钟就能跑通,再换成 70B、405B,代码不用改。
附:它到底是怎么做到的
推理时,输入依次经过 embedding、N 个 decoder layer、norm 和 lm_head。第 i 层计算的时候,其余层的权重都没有被使用。
AirLLM 的做法是:同一时刻只把一层权重放到 GPU 上。显存需求由单层大小决定,而不是模型总大小。
实现分三步。
切层落盘。 首次加载时,AirLLM 把原始 checkpoint 按层拆成独立的 safetensors 分片(split_and_save_layers)。README 提醒,推理时原始模型会先被分解并按层保存,需保证 huggingface 缓存目录有足够的磁盘空间。磁盘不够可以设 delete_original=True,拆完删除原始权重。
在 meta device 上建空壳模型。 模型结构完整实例化,但权重挂在 PyTorch 的 meta device 上,只有形状,不占内存。forward 和 generate 仍由 transformers 执行,AirLLM 不重写这部分。
用 forward hook 即载即卸。 对每个需要流式加载的模块注册 register_forward_pre_hook 和 register_forward_hook:pre-hook 从磁盘读入该层权重并搬到 GPU,模块完成计算,post-hook 把权重退回 meta 并调用 clean_memory() 释放显存。
另外用 ThreadPoolExecutor(max_workers=1) 在后台预取,计算第 i 层时同时加载第 i+1 层,让磁盘 I/O 和 GPU 计算重叠。预取的权重先进入 pinned memory(上限约 2GB)再拷入 GPU,减少拷贝阻塞。README 称这项优化带来约 10% 提速(v2.5 引入,默认开启)。
因为 forward 用 transformers 原生实现,AirLLM 不需要为每种架构手写 attention、RoPE、cache 逻辑,transformers 支持的新架构基本开箱可用。只有 ChatGLM、QWen、Baichuan、InternLM、Kimi K3 这类模块布局不标准的模型,才需要子类做名称映射(源码里的 ARCH_OVERRIDES)。
MoE 模型
稀疏 MoE 一层有成百上千个 expert,但一个 token 只路由到其中几个。AirLLM 对单个 expert 做 streaming,只加载该 token 路由到的几个。以 Kimi K3 为例,每层 896 个 expert,每个 token 路由 16 个。整层展开约 55GB,单个 token 实际只需约 1GB。这是 2.8T 的 Kimi K3 能跑进 3.72GB 的原因。
Qwen3.8-Flash-Next 的 ~51B n-gram 表(bf16 展开约 102GB)用 mmap 文件映射留在主机上,不进 GPU 也不进匿名内存。这是它在 RTX 4090 上只占 5.95GB 的原因。