在 Excel 表格的实际使用中,行高与列宽的设置直接决定了数据的可读性。固定尺寸适合格式高度统一的模版,但一旦单元格内容长短不一,固定值容易造成文字截断或大片留白。相比之下,让行高与列宽根据内容动态适配------也就是"行列自适应"------能够始终保证内容完整显示且排版紧凑。本文将详细介绍 Spire.XLS 提供的 AutoFit 系列方法,帮助你在 Python 中灵活控制表格的尺寸自适应。
为什么需要行列自适应
在以下场景中,固定尺寸往往力不从心:
- 内容长度不确定:从数据库或接口导出的字段长度浮动很大。
- 包含换行文本:单元格内有多行说明文字时,固定行高会把后半截裁掉。
- 批量生成报表:数据动态变化,手动调整既慢又容易出错。
与手动设置不同,自适应把尺寸计算交给了引擎:你只需指定测量范围,剩下的交给 Spire.XLS 计算。
环境准备
本文使用 Spire.XLS for Python 操作 Excel。你可以通过以下命令安装:
bash
pip install Spire.XLS自适应单行高度(AutoFitRow)
当某一行包含换行文本或多行数据时,固定行高会裁切内容。AutoFitRow 方法用于测量指定列范围内的文本高度,并重新计算该行的行高。
注意 :如果希望文字在列宽不足时自动折行并撑开行高,必须先将单元格的
IsWrapText属性设为True(自动换行),否则AutoFitRow只会按单行文本计算高度。
python
from spire.xls import *
from spire.xls.common import *

inputFile = "./Demos/Data/AutoFitSample.xlsx"
outputFile = "AutoFitRowInRange.xlsx"

workbook = Workbook()
workbook.LoadFromFile(inputFile)
sheet = workbook.Worksheets[0]

# 为目标单元格开启自动换行
sheet.Range["B2"].IsWrapText = True

# 调整第 2 行的行高
# 参数依次为:目标行号(2)、起始列(1)、结束列(2)、是否考虑合并单元格(False)
sheet.AutoFitRow(2, 1, 2, False)

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()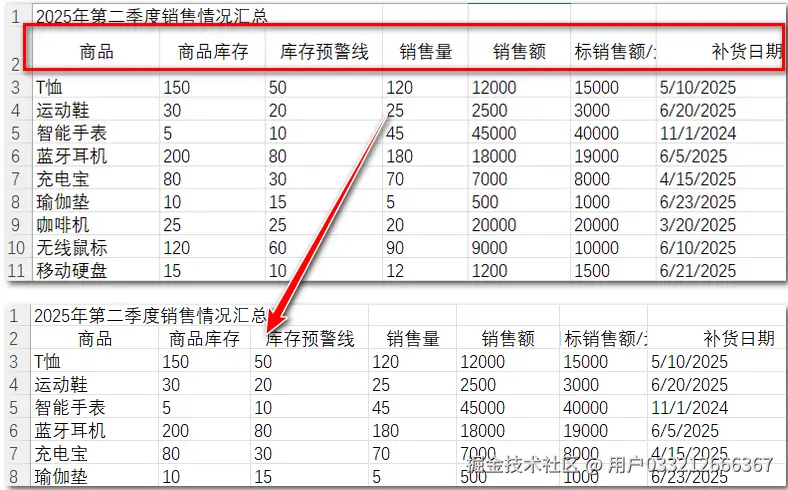
参数中的 1 和 2 表示:在计算第 2 行应当有多高时,仅扫描第 1 列至第 2 列(即 A2:B2)的内容。即使该行第 3 列(C2)以后存在超长文本,也不会影响第 2 行的高度计算。
自适应单列宽度(AutoFitColumn)
AutoFitColumn 方法通过测量指定行范围内的文本宽度,来自动设置该列的列宽。通过限定测量行,可以防止表头或底部备注等无关区域干扰列宽计算。
python
from spire.xls import *
from spire.xls.common import *

inputFile = "./Demos/Data/AutoFitSample.xlsx"
outputFile = "AutoFitColumnInRange.xlsx"

workbook = Workbook()
workbook.LoadFromFile(inputFile)
sheet = workbook.Worksheets[0]

# 按第 2 到第 5 行的内容,自动调整第 2 列(B列)的列宽
# 参数依次为:列号(2)、起始行(2)、结束行(5)
sheet.AutoFitColumn(2, 2, 5)

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()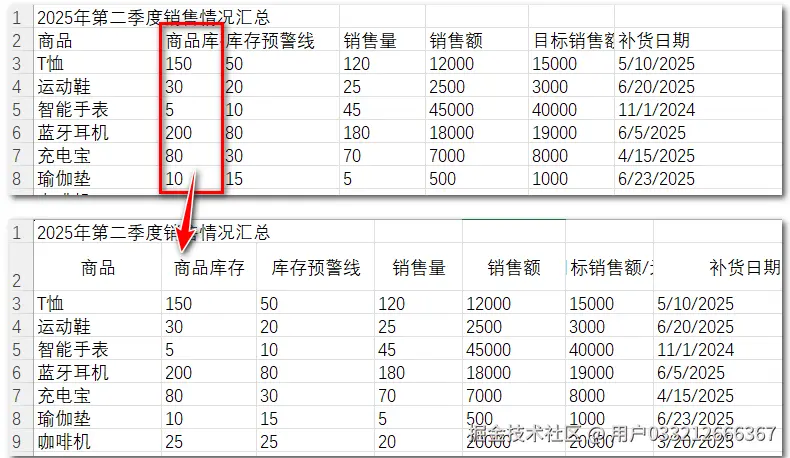
这里第一个 2 代表 B 列。方法只会计算 B2 到 B5 单元格中最长文本的宽度,并以此设定 B 列的列宽。如果 B1 是极长的标题,或者 B6 之后有长备注,都会被自动忽略。
针对单个单元格内容自适应
如果只需以某个具体单元格的文本为基准来调整其所在的行或列,可以直接使用单元格对象(CellRange)的 AutoFitColumns() 和 AutoFitRows() 方法。
python
from spire.xls import *
from spire.xls.common import *

inputFile = "./Demos/Data/ReadImages.xlsx"
outputFile = "AutoFitBasedOnCellValue.xlsx"

workbook = Workbook()
workbook.LoadFromFile(inputFile)
worksheet = workbook.Worksheets[0]

cell = worksheet.Range["B17"]
cell.Text = "Welcome to Spire.XLS!"
cell.Style.Font.Size = 10
cell.Style.Font.IsBold = True

# 依据 B17 单元格内容,分别调整其所在列的宽度与所在行的高度
cell.AutoFitColumns()
cell.AutoFitRows()

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()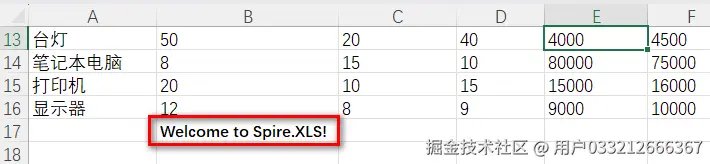
这两个方法不需要传入范围参数,非常适合在模板填充中对关键单元格进行局部微调。
检查行列的自适应属性
在处理已有文件时,可以通过 GetRowIsAutoFit 和 GetColumnIsAutoFit 读取指定行列在 Excel 文件属性中是否勾选了自适应标识。
python
from spire.xls import *
from spire.xls.common import *

inputFile = "./Demos/Data/CheckAutoFitRowsAndColumns.xlsx"

workbook = Workbook()
workbook.LoadFromFile(inputFile)
sheet = workbook.Worksheets[0]

# 读取第 2 行与第 2 列的自适应状态标志
print(f"第 2 行自适应标志: {sheet.GetRowIsAutoFit(2)}")
print(f"第 2 列自适应标志: {sheet.GetColumnIsAutoFit(2)}")

workbook.Dispose()
需要注意的是,这些方法返回的是文件内部的元数据状态,并非测量当前列宽是否"刚好容纳文本"。
综合示例:生成自适应排版的报表
将上述方法结合,可以实现"写入数据 → 设置文本换行 → 统一行列自适应"的标准报表生成流程:
python
from spire.xls import *
from spire.xls.common import *

inputFile = "./Demos/Data/SalesData.xlsx"
outputFile = "AutoFitReport.xlsx"

workbook = Workbook()
workbook.LoadFromFile(inputFile)
sheet = workbook.Worksheets[0]

# 1. 写入数据
sheet.Range["A1"].Value = "商品名称"
sheet.Range["B1"].Value = "详细描述"
sheet.Range["C1"].Value = "单价"

sheet.Range["A2"].Value = "笔记本电脑"
sheet.Range["B2"].Value = "适用于办公场景的高性能轻薄笔记本,续航时间长且便于携带"
sheet.Range["C2"].Value = "5999"

# 2. 为长文本单元格开启自动换行
sheet.Range["B2"].IsWrapText = True

# 3. 针对所有数据列调整列宽(第 1~3 列,参考第 1~2 行)
for col in range(1, 4):
    sheet.AutoFitColumn(col, 1, 2)

# 4. 针对数据行调整行高(第 2 行,参考第 1~3 列)
sheet.AutoFitRow(2, 1, 3, False)

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()
总结
在实际的报表开发中,灵活的行列自适应能有效提升数据的展现质量。最稳健的做法是在数据写入完成后,先按需计算并调整核心列宽,再对大段文本设置自动换行并适配行高。这种"动态自适应与局部微调"相结合的策略,既能确保信息完整展示,又能保持版面整洁美观,为自动化生成的 Excel 报表提供良好的阅读体验。