基于 OKF 知识图谱的 Text2SQL 领域知识注入实践------半导体晶圆厂数据资产知识库 MVP 剖析
关键词:Text2SQL · OKF(Open Knowledge Format)· 知识图谱 · 隐性知识 · 半导体 Fab / 晶圆厂 · Streamlit · LLM · RAG · 数据资产知识库
引言
Text2SQL 在演示环境中表现亮眼,但落地到真实生产数据仓库后,准确率往往急剧下降。本文的场景是:为半导体晶圆厂(Fab)的数据仓库构建 Text2SQL 查询能力。表面上看,这不过是「RAG + LLM 生成 SQL」的组合,但深入实践后会发现,Fab 数仓是一个典型的「知识封闭」环境:
- 表结构来自 MES / EAP / YMS 系统,字段名多为
LOT_STS、STEP_GRP、DISPOSITION这类缩写,仅凭表名难以判断语义; - 状态字段充满魔法数字:
LOT_STS='05'表示什么?'99'呢? - 良率、缺陷等指标的口径写死在存储过程中,真正的「隐性知识」散落在工程师的头脑里。
如果让 LLM 在没有领域知识的情况下直接生成 SQL,结果往往是「语法正确、语义错误」------查询结果与业务真实口径相去甚远。
本文将从理论和实践两个层面,完整复盘如何用 OKF 思想 + 知识图谱,将「让 LLM 看懂 Fab 数仓」落地为一个最小可运行 MVP。全文既包含方法论述,也提供可运行的代码与演示。
一、问题拆解:为什么朴素 Text2SQL 在 Fab 场景中失效
1.1 什么是 Text2SQL
Text2SQL 的任务是:给定一句自然语言,让模型生成对应的 SQL 并执行。
"当前 Hold 中的批次有多少?" → SELECT COUNT(*) FROM WIP_LOT WHERE LOT_STS='05' ...从语法层面看,这并非难事。但在 Fab 数仓中,真正的瓶颈不是「会写 SQL」,而是「理解业务语义」。
1.2 三类典型的「隐性知识」陷阱
陷阱一:魔法编码值
sql
-- ❌ 将测试批次误计入 Hold 批次
SELECT COUNT(*) FROM WIP_LOT WHERE LOT_STS = '05';

-- ✅ 05=Hold(待 MRB 评审),99=测试批次,统计时须排除
SELECT COUNT(*) FROM WIP_LOT WHERE LOT_STS = '05' AND LOT_STS <> '99';
LOT_STS='99' 在 Fab 中表示测试批次(非真实产品)。统计良率、在制品数量时若不排除,报表数字将直接失真。而「99 需要排除」这一规则,数据字典中并不存在。
陷阱二:前缀编码与统计口径
sql
-- ❌ DEFECT_CD 不应做精确匹配
WHERE DEFECT_CD = 'P12'

-- ✅ P*=Particle、S*=Scratch、M*=Metal 残留,应使用前缀匹配
WHERE DEFECT_CD LIKE 'P%'

-- 且 DISPOSITION='SC'(Scrap)的晶圆不计入产出
陷阱三:字段类型与时序约束
sql
-- ❌ TECH_NODE 存储的是字符串 '28nm',与数字直接比较会出错
WHERE TECH_NODE = 28

-- ✅ 需先做类型转换
WHERE CAST(REPLACE(TECH_NODE,'nm','') AS INTEGER) = 28
而像 YLD_DAILY 这类由夜间 Job 生成的表,在当日 08:00 之前查询「昨天」的良率,结果可能为空。此类时序口径,仅靠 ER 图无法获知。
1.3 小结:Text2SQL 的瓶颈在于领域知识注入
Text2SQL 的难点从来不是 SQL 语法,而是如何将「数据字典中没有、只存在于资深工程师头脑中」的领域知识,准确地传递给模型。
这正是本项目引入 OKF 知识图谱的出发点。
二、理论基础:OKF(Open Knowledge Format)概述
2.1 OKF 的核心原则
OKF 是一种开源、可移植的知识组织形式,其核心理念可概括为三句话:
- 一个知识包 = 一个文件夹
- 一个知识点 = 一个 Markdown 文件(YAML frontmatter + 正文)
- 文件之间通过相对路径链接构成一张知识图谱
Markdown 人人可写,YAML 易于解析,相对路径可表达有向链接。这三者结合,保证了知识体系既可读、可版本管理(Git),又可被程序索引为图结构。
2.2 知识点的三层结构
一个知识点文件示例如下(取自本项目真实的 WIP_LOT 表):
markdown
---
title: "WIP_LOT 表知识"
type: Table                  # type 枚举:Table/Column/Metric/Spec
resource: WIP_LOT
tags: [wip, 在制品, fab]
confidence: seed              # 置信度:author/llm-inferred/verified/seed
related:                      # 用相对路径表达图的关系(血缘)
  - wiki/tables/WIP_LOT_HIST.md
  - wiki/tables/QCS_DEFECT.md
  - wiki/tables/PRD_PRODUCT.md
updated: 2026-09-13
---

# WIP_LOT 表
## 业务含义
批次主档,记录在制品的每一批......
## 关键字段(含隐性知识列)
| 字段 | 类型 | 含义 | 说明 |
|------|------|------|------|
| LOT_STS | TEXT | 批次状态 | 05=Hold(待MRB);99=测试批次,统计必须排除 |
## 血缘
下游:WIP_LOT_HIST、QCS_DEFECT;上游:PRD_PRODUCT
## Text2SQL 注意事项
统计在制品必须排除 LOT_STS='99'。
## 来源
raw/dictionary/WIP_LOT.json
注意:「隐性知识」被显式地写入正文,这正是普通数据字典无法做到的部分。
2.3 知识分层:从 raw 到 wiki
将知识分为两层,让「机器抽取」与「LLM 编译」各司其职:
| 层级 | 内容 | 生成方式 | 是否依赖 AI |
|---|---|---|---|
| L1 raw | 数据字典 JSON(表/字段/类型/主外键/行数) | 脚本自动抽取 | 否,纯机械 |
| L2 wiki | Markdown 知识(业务含义/隐性知识/SQL 注意事项) | LLM(或 Mock/人工) | 是,或人工 |
分层带来的收益:raw 层直接从数据库读取,永不失真;wiki 层负责知识增值,将工程师的经验沉淀为可检索内容。两层均可纳入 Git 管理,支持回滚与协同。
三、核心设计:知识导航式 Text2SQL 及其与朴素 RAG 的差异
3.1 为何不直接使用向量检索
常见的 Text2SQL 方案直接采用「向量数据库 + embedding 召回」。但在 Fab 这类强精确性的场景中,更推荐先做一层「确定性读取」:
- 向量召回依赖分块与排序,可能遗漏关键字段,或将隐性知识切碎;
- SQL 的正确性往往依赖「某个字段的确切取值」,而这恰恰是向量检索不擅长的「精确事实」。
3.2 方案:知识定位 → 确定性读全文 → 组装 → 执行 → 失败重试
用户问题
   │  ① 关键词定位(从知识索引中挑选 2~5 张相关表)
   ▼
相关表知识点的【完整】Markdown(含隐性知识、SQL 注意事项)
   +   spec/text2sql-rules.md 规则文件(few-shot)
   │  ② 将全文与规则直接注入 LLM,不做向量分块
   ▼
LLM 生成 SQL
   │  ③ 在 SQLite 上执行
   ▼
返回 DataFrame + SQL + 引用的知识文件列表
│ ④ 执行失败?将报错回填 LLM,重试一次关键代码(core/text2sql.py):
python
def ask(self, question: str) -> Text2SQLResult:
    nodes = self.locate(question)            # ① 定位相关表
    ctx = []
    for n in nodes:
        # ② 确定性读取整篇知识 + 其 frontmatter
        ctx.append(f"===== {n.path} =====\n{self._table_full_text(n)}")
    ctx_text = "\n\n".join(ctx)

    if not config.LLM_AVAILABLE:
        # Mock 模式:内置示例问题 → SQL 映射(离线可演示)
        sql, desc, missed = self._match_mock(question)
        ...
        return self._execute(question, sql, referenced, logs, mock=True)

    # 真实 LLM:问题 + 知识全文 + 规则 + few-shot
    sql = self._llm_generate(question, ctx_text, referenced, logs)
    return self._execute(question, sql, referenced, logs, mock=False)
「规则 + few-shot」统一收口在 spec/text2sql-rules.md,其中将必读的隐性知识整理为一张查表与纠错对照表:
| 表/字段 | 陷阱 | 正确写法 |
|---|---|---|
LOT_STS |
05=Hold,99=测试批次 |
LOT_STS='05' AND LOT_STS<>'99' |
DEFECT_CD |
前缀编码 | DEFECT_CD LIKE 'P%' |
TECH_NODE |
字符串 '28nm' |
CAST(REPLACE(...,'nm','') AS INTEGER)=28 |
YLD_DAILY |
夜间 Job 生成 | 当日 08:00 前查询昨日可能为空 |
这就是「知识驱动的 Text2SQL」,而非「碰运气的 Text2SQL」。
3.3 血缘图谱:让知识本身可被导航
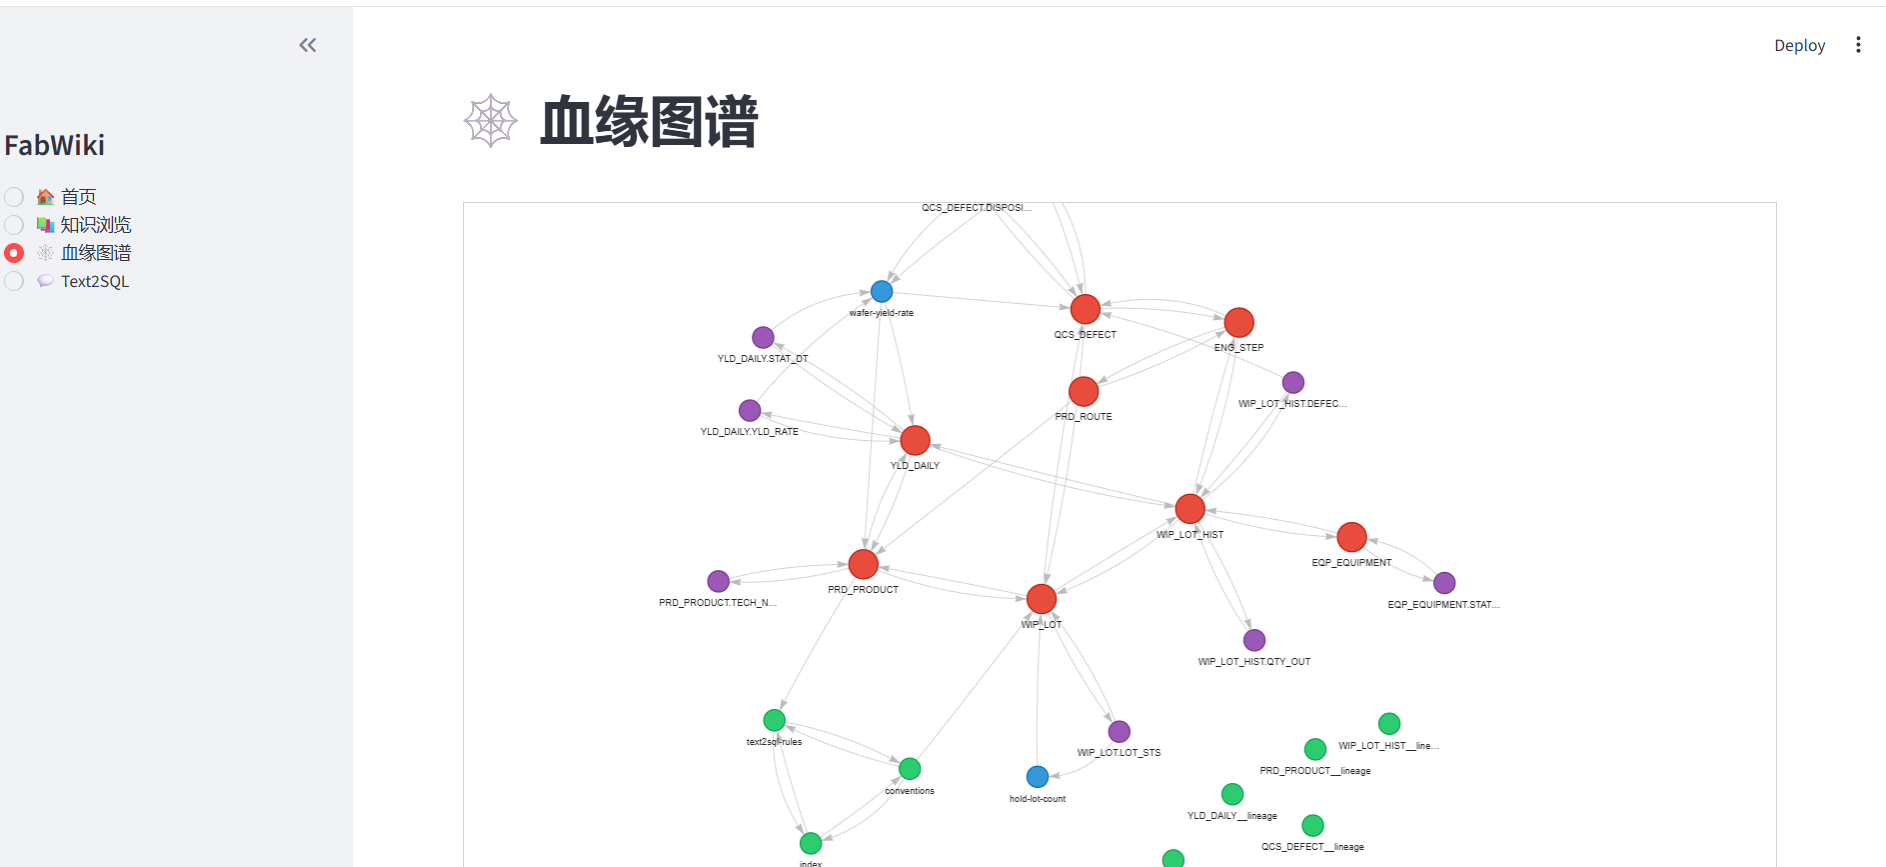
借助 related 字段与 Markdown 中的相对路径链接,使用 networkx 将整个知识包构建为一张有向图(节点=知识点,边=链接),再用 pyvis 进行可视化。
在「血缘图谱」页面,可以直观看到这样一条链路:
WIP_LOT(在制批次)
   ↓ WIP_LOT_HIST(过站历史)
   ↓ YLD_DAILY(日良率汇总)
这张图不仅是「看的」,更能服务于 Text2SQL:需要良率时,沿 WIP_LOT_HIST 向下游找到 YLD_DAILY;需要产品主档时,向上游找到 PRD_PRODUCT。知识本身可被程序导航,这正是采用 OKF 构建知识体系的直接收益。
四、工程实践:从 0 到 1 搭建可运行 MVP
4.1 技术选型
| 层 | 选型 | 理由 |
|---|---|---|
| 前端/UI | Streamlit | 几分钟搭建 4 个页面,适合演示 |
| 数据库 | SQLite(模拟 Oracle) | 零配置,SQL 按标准书写 |
| 知识解析 | python-frontmatter | Markdown + YAML 一体化解析 |
| 图谱 | networkx + pyvis | 构建与可视化血缘图 |
| LLM | OpenAI 兼容 SDK | base_url 可切换至 DeepSeek 等 |
| 数据处理 | pandas + python-dotenv | 数据处理 + 配置管理 |
关键设计:Mock 模式是一等公民 。
config.LLM_AVAILABLE = bool(os.getenv("LLM_API_KEY")),无 Key 时自动降级至内置模板,离线亦可完整演示------这对撰写博客、搭建 Demo 至关重要。
4.2 目录结构
fabwiki/
├── app.py                 # Streamlit 入口(四页面)
├── config.py              # 路径 + LLM 配置 + Mock 开关
├── core/
│   ├── db.py              # SQLite 建库 + seed + 外键元数据
│   ├── extractor.py       # L1:抽取数据字典 → raw/JSON
│   ├── compiler.py        # L2:Mock/LLM 编译知识 + 血缘 + index
│   ├── knowledge.py       # 知识加载解析 + networkx 血缘图
│   ├── llm.py             # LLM 统一封装(超时/重试/降级)
│   └── text2sql.py        # 知识导航式 Text2SQL
├── knowledge/             # OKF 知识包
├── scripts/init_db.py     # 一键建库 + seed
└── tests/test_smoke.py    # 全链路冒烟测试
4.3 准备模拟数据:将「隐性知识」植入进去
为便于演示,构造了 8 张 Fab 风格的表(仿 Oracle 命名),并将隐性知识真实地编码进 seed 数据,例如:
python
LOT_STS_VALUES = ["01", "03", "05", "07", "99"]   # 99 = 测试批次
EQP_STATUS    = ["R", "I", "D", "M"]              # M = PM 保养中
DEFECT_PREFIX = ["P", "S", "M"]                   # Particle/Scratch/Metal
DISPOSITIONS  = ["SC", "RS", "OK"]                # SC = Scrap
同时使用一张 meta_fk 表记录外键关系,使 extractor 能据此自动生成血缘。
4.4 L1 抽取:数据字典自动化
extractor.py 读取 sqlite_master / PRAGMA table_info + meta_fk,将每张表导出为 knowledge/raw/dictionary/{TABLE}.json,再通过 extract_all() 一键批量处理。
python
def _dump_dict(conn, table) -> dict:
    cols = [{"name": r["name"], "type": r["type"], "pk": bool(r["pk"])}
            for r in conn.execute(f"PRAGMA table_info({table})")]
    fks  = [{"column": fc, "references": f"{tgt}.{tc}"}
            for fc, src, tgt, tc in db.get_meta_fk(conn) if src == table]
    return {"table": table, "row_count": row_count(conn, table),
            "primary_key": ..., "foreign_keys": fks, "columns": cols}
4.5 L2 编译:两种模式并存
compiler.py 是核心模块,提供两条产出路径:
- 真实 LLM :将 raw JSON + 隐性知识提示拼成 prompt,调用
chat_complete; - Mock :内置高质量模板字符串直接落盘------Mock 内容即为「LLM 应当生成的样子」,因此无 Key 时演示效果不减。
每张表还会附带生成血缘文件 {TABLE}__lineage.md,最后刷新全局 index.md。
python
def compile_all() -> dict:
    for table in db.table_names():
        md = _table_json_to_md(table) if llm_ok else None
        md = md or _table_md(table, row_count)      # 失败/Mock → 使用内置模板
        (config.WIKI_TABLES_DIR / f"{table}.md").write_text(md, ...)
        _gen_lineage(table, conn)                    # 生成血缘
    _gen_index(tables, METRICS)                      # 刷新导航
4.6 LLM 统一封装(重试 + 降级)
所有真实 LLM 调用收敛至 core/llm.py:超时、最多重试 1 次、异常时回调告警并返回 None,由上层降级至 Mock。
python
for attempt in range(config.LLM_MAX_RETRIES + 1):
    try:
        resp = client.chat.completions.create(...)
        text = resp.choices[0].message.content.strip()
        if text: return text
    except Exception as e:
        last_err = str(e)
return None   # 上层捕获后降级至 Mock
4.7 四页面 UI
Streamlit 单入口 app.py,侧边栏导航切四个页面:
-
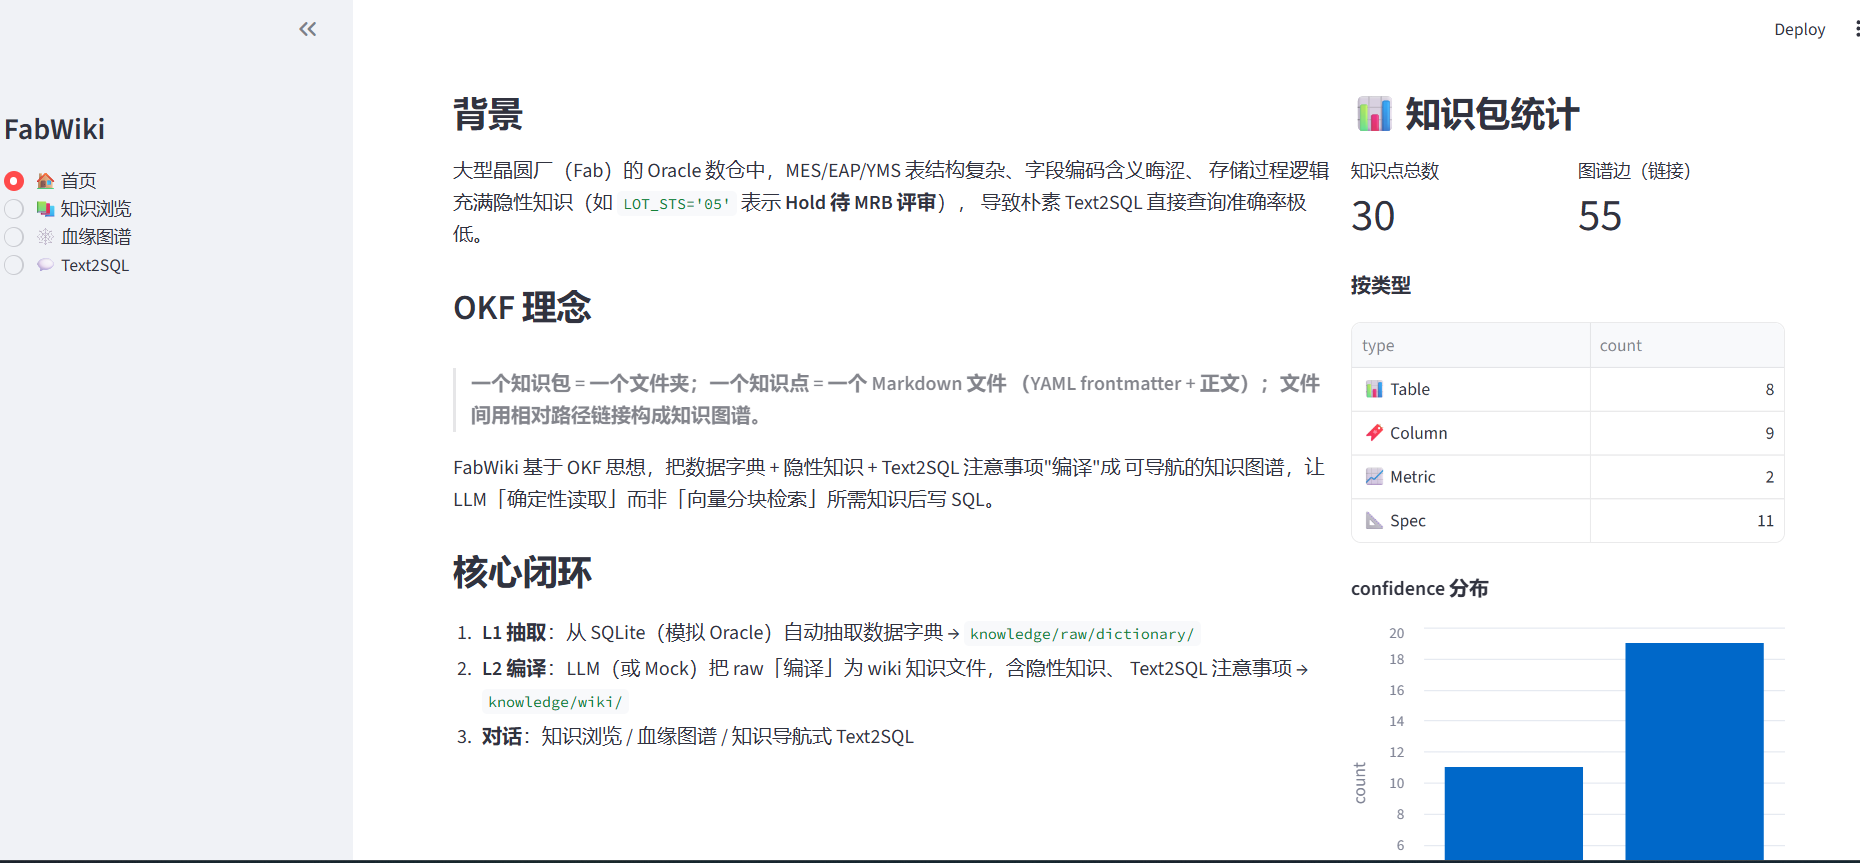
🏠 首页 :项目介绍、OKF 理念、知识包统计(节点/边/confidence 分布)、一键初始化;
-
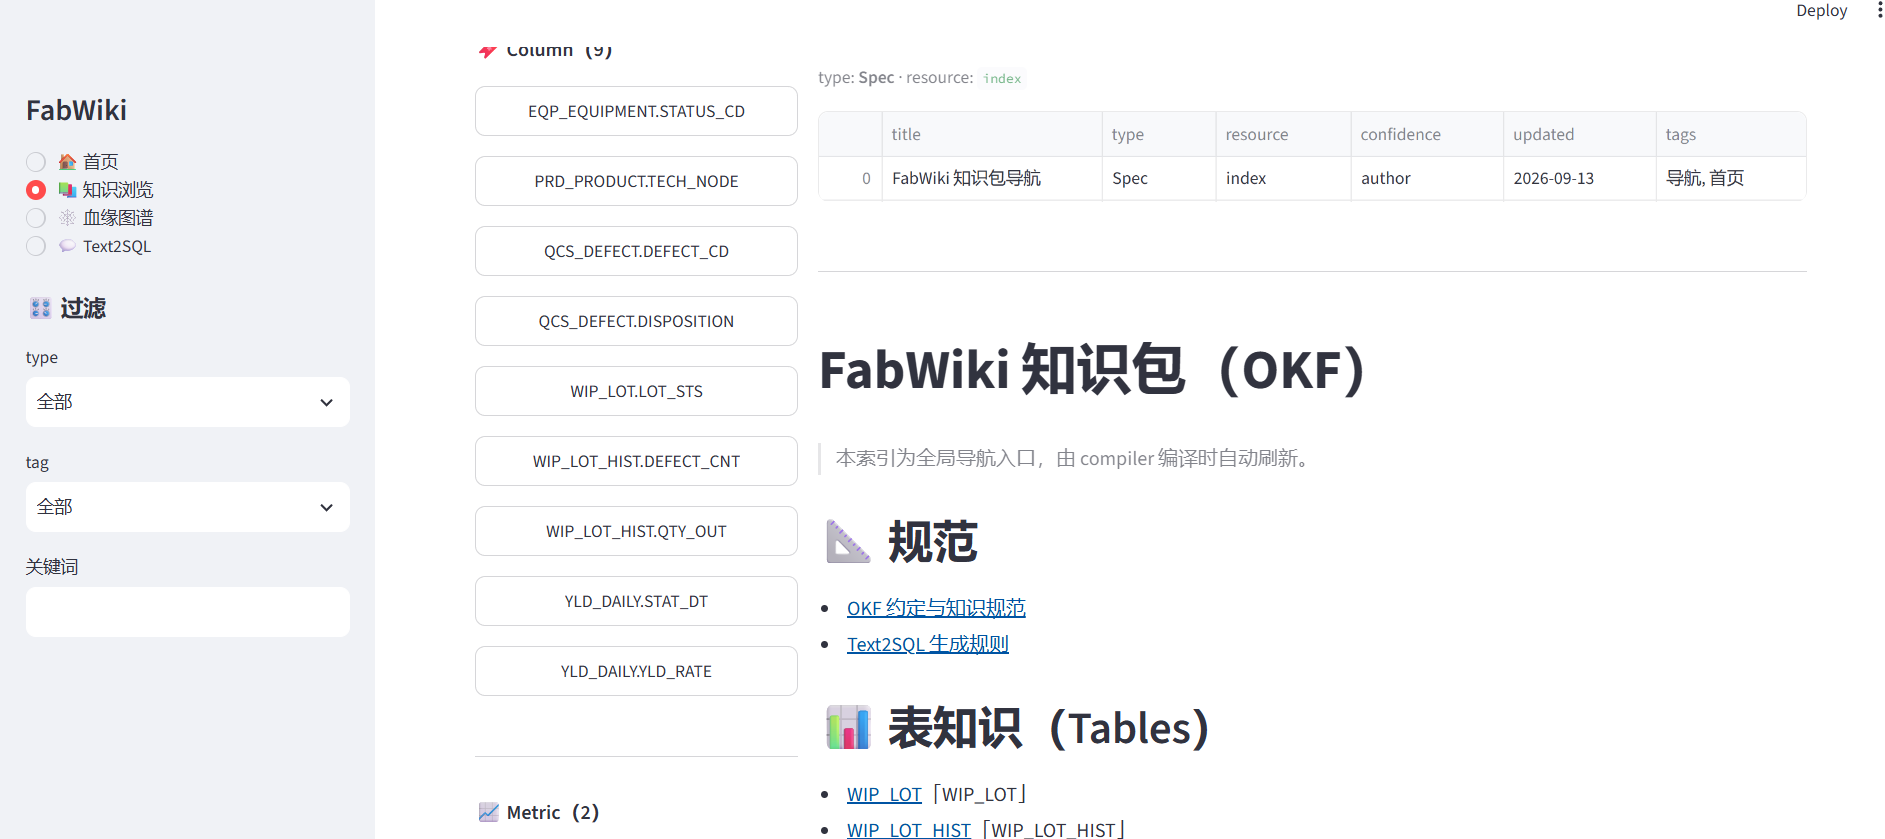
📚 知识浏览 :按 type/tag/关键词过滤,渲染 frontmatter + 正文 Markdown,关联知识点可点击跳转;
-
🕸️ 血缘图谱 :pyvis 全库知识链接图(节点按 type 着色),并支持选某张表看 N 跳血缘;
-
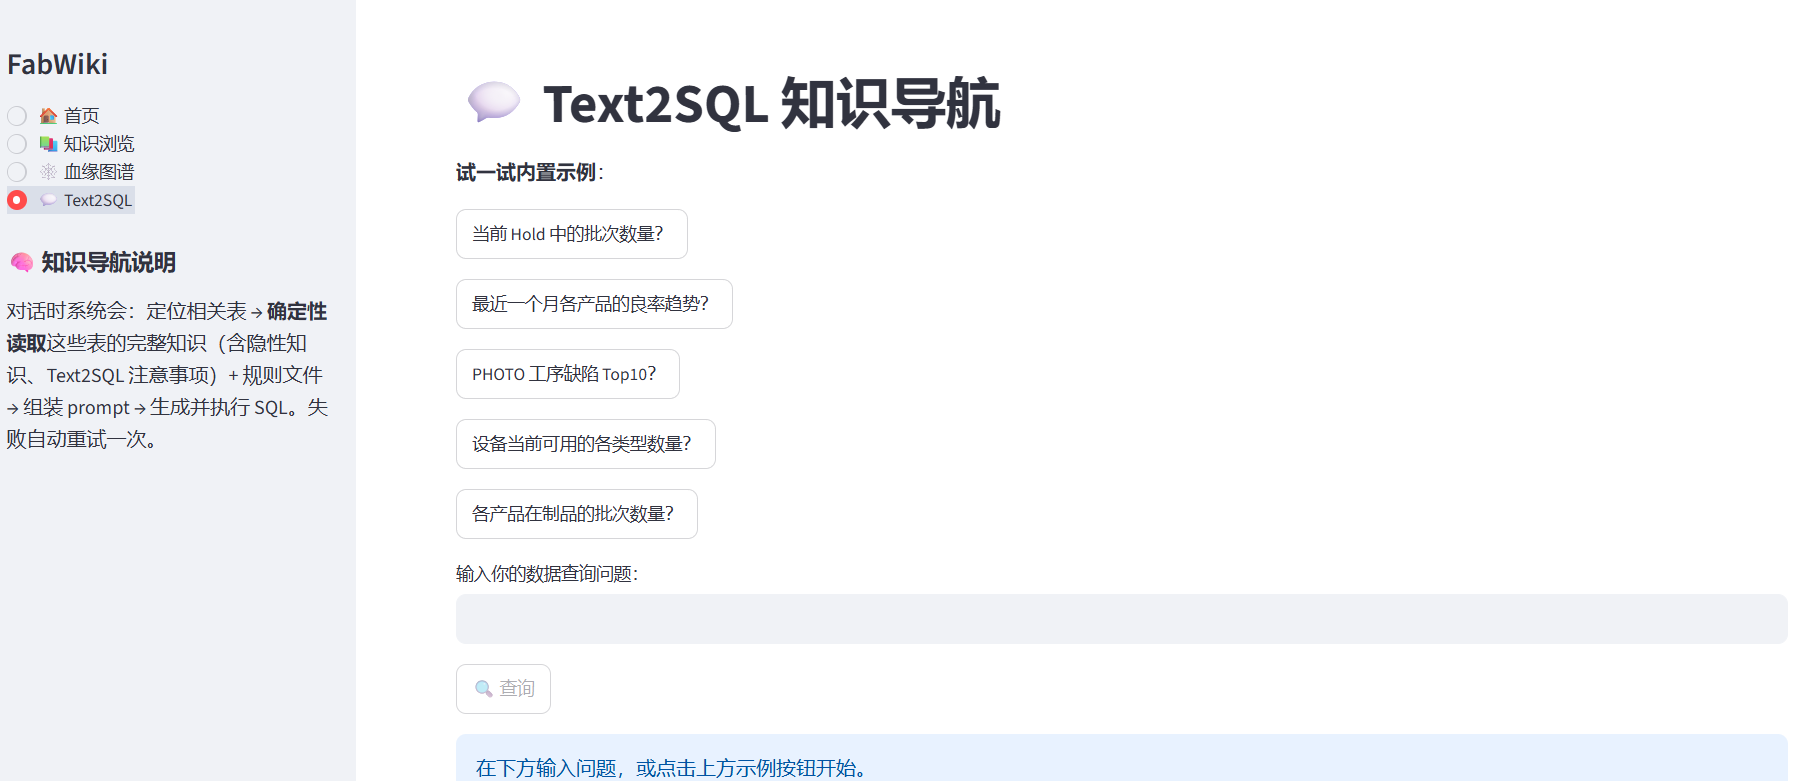
💬 Text2SQL :对话式,边栏展示「本次引用的知识文件」,结果区三个 Tab
(数据表格 / 生成 SQL / 执行日志),内置示例问题一键点。
五、运行验证:三步启动与效果验证
5.1 三步启动
bash
cd fabwiki
pip install -r requirements.txt
python -m streamlit run app.py --server.port 8506
无 API Key 时自动进入 Mock 模式 ;配置
LLM_API_KEY后切换至 真实 LLM,Mock 内容会被真实生成结果覆盖。
5.2 演示:一条「隐性知识」被正确生成
在 Text2SQL 页面提出一个天然带坑的问题:
「当前 Hold 中的批次数量?」
经知识导航后,模型(真实 LLM 实测)生成的 SQL 如下:
sql
SELECT COUNT(*) AS HOLD_LOT_CNT
FROM WIP_LOT
WHERE LOT_STS = '05' AND LOT_STS <> '99'
可以看到------模型不仅知道 05=Hold,还自动补上了 <> '99' 以排除测试批次 。这正是知识文件中「隐性知识 + Text2SQL 注意事项」被确定性读取后的效果,而非 LLM 凭空猜测。
5.3 更多演示问题(内置 Mock 示例)
- 最近一个月各产品的良率趋势?
- PHOTO 工序缺陷 Top10?
- 设备当前可用的各类型数量?
- 各产品在制品的批次数量?
5.4 冒烟测试保底
tests/test_smoke.py 覆盖全链路:建库 → 抽取 → Mock 编译 → 知识加载 → Mock Text2SQL,并专门断言「Hold 查询必须含 '05' 且排除 '99'」。
bash
python tests/test_smoke.py
# 全部 6 项冒烟测试通过
六、总结:这套方法可迁移的部分
-
将「隐性知识」显式化,是 Text2SQL 落地的第一步。 数据字典解决不了的问题,要靠业务知识文档解决。OKF 用「文件夹 + Markdown + 相对路径链接」将知识组织得可维护、可版本化。
-
知识导航优于盲目向量检索。 对「SQL 正确性依赖精确值」的场景,确定性读取相关表全文比 embedding 召回更稳定。向量检索适合「模糊概括」,不适合「精确写 SQL」这类任务。
-
分层知识(raw / wiki)+ Mock/LLM 双模式,使系统在线、离线均可运行、可演示、可测试。
-
血缘图谱不只是可视化工具,它本身就是 Text2SQL 的知识导航入口------顺着上下游,才能确定以何种粒度汇总。
-
给 LLM 的 prompt 需要持续「养」。 规则文件 + few-shot 应不断迭代,将踩过的
LOT_STS='99'、TECH_NODECAST 这类坑,逐一沉淀为查表修正规则。
七、延伸思考
最深刻的体会在于:技术难点往往不在模型本身,而在「领域知识的工程化」。
让 LLM 写出语法正确的 SQL 并不困难,真正的挑战是让它在特定业务规则下「写对」。Fab 只是其中一个例子------医疗、金融、政务,凡是「数据里藏有魔法值、口径写死在存储过程中」的行业,这套「OKF 知识资产 + 确定性知识导航」的思路都同样适用。
如果你也在做企业级 Text2SQL,不妨尝试:先别急着调大模型参数,先把领域知识用 OKF 整理成一张可导航的图谱。 很可能,几个真实案例就能显著挽回准确率。