一、前言
现在大模型已经越来越多的应用到了很多场景,智能问答、AI绘图、多模态推理、企业私有化部署等应用随处可见。但不管怎样,还是逃不掉一些核心难题:模型效果达标了,但运行速度慢、显存占用高、多模型并行卡顿、硬件资源浪费严重。很多时候我们并不是模型精度不够,而是底层运行和调度效率拖了后腿。
曾经面带这些困扰的问题,一度以为大模型优化就是简单的模型剪枝、量化压缩,随着慢慢的研究深入,越来越发现,其实真正支撑大模型高效落地的核心,是三大底层优化能力:算子优化、内存访问优化、多模型Pipeline调度优化。量化、剪枝是从模型结构上做减法,而这三项优化是从运行底层、资源调用、任务调度上做增效,是低成本、高收益的核心优化手段,从根本解决大模型推理慢、显存爆、调度乱的问题。
二、算子优化
1. 算子基础认知
要做好算子优化,首先要搞懂到底什么是算子。简单来说,算子就是大模型运行过程中最基础的计算单元,相当于模型的最小动作指令。我们熟知的矩阵乘法、卷积、激活函数、归一化、加法拼接等运算,全部都是由一个个独立算子完成的。
整个大模型的前向推理、反向训练过程,本质上就是成千上万个算子按照固定逻辑有序执行的过程。以主流的Transformer架构大模型为例,每一层编码器、解码器都包含数十种不同算子,一个完整的文本生成推理流程,需要执行上万次算子运算。模型的推理速度,本质上由算子的执行效率决定。很多时候我们感觉模型推理卡顿,不是硬件性能不足,而是部分算子计算冗余、执行逻辑低效、硬件适配性差,导致整体算力被严重浪费。
在大模型落地场景中,算子低效的问题会被无限放大。大模型参数规模动辄数十亿、上百亿,单次推理的算子计算量极大。如果普通小模型的算子低效只会带来毫秒级延迟,大模型中则会变成秒级甚至数十秒级延迟,直接导致应用无法正常使用。同时,低效算子还会增加无效算力消耗,提升设备功耗,大幅拉高落地成本。
常见的低效算子问题主要分为三类:
- 通用算子适配差:框架自带通用算子为兼容全部硬件与场景,存在大量兼容分支,在大模型特定场景产生冗余计算;
- 算子碎片化:多个小型算子独立调度执行,频繁触发计算资源申请释放,带来额外调度耗时;
- 算子精度冗余:部分算子不需要高精度计算,默认使用FP32,额外消耗算力与显存资源。
2. 核心优化方案
针对上述算子痛点,行业内主流的优化方案可以分为四大类,全部无需深厚算法功底即可操作,且优化收益极为明显。
2.1 算子定制化重构优化
- 摒弃深度学习框架自带的通用算子,针对大模型专属计算逻辑,重构极简版自定义算子。
- 通用算子兼容场景广、代码冗余多,而定制算子可以精准匹配大模型的矩阵维度、计算逻辑,删除所有无效兼容代码。
- 例如大模型核心的矩阵乘法算子,通用版本会适配任意维度矩阵,而定制版本可固定模型专属维度,大幅减少分支判断和冗余计算,单次算子计算速度可提升30%以上。
- 目前主流的TensorRT、ONNX Runtime优化,核心底层逻辑就是定制算子重构。
2.2 算子融合优化
这是最容易上手、收益最高的优化手段。
- 在大模型推理中,很多小算子是连续执行的,比如矩阵乘法+偏置加法+激活函数,这三个算子独立执行时,需要三次读取显存、三次计算、三次写入显存。
- 而算子融合可以将多个连续小算子合并为一个大算子,只需要一次数据读写、一次计算调度。
- 这种方式能彻底解决算子碎片化问题,减少调度开销和数据交互耗时。
- 常见的融合组合有Conv+BN+ReLU、MatMul+Add+GELU等,在大模型推理中,算子融合可直接降低20%-50%的推理延迟。
示例:算子融合优化示例
示例对比了未融合与融合两种MLP实现,演示了如何通过torch.compile自动触发算子融合,将MatMul、Add、GELU合并为单个CUDA Kernel,减少显存读写次数,提升推理吞吐。
- 未融合版本:Linear与GELU作为独立算子执行,中间结果需三次显存读写
- 融合版本:将GELU内联到forward中,为编译器提供融合优化机会
- torch.compile:自动分析计算图,将多个算子融合为单个Kernel执行
- 性能收益:减少显存带宽瓶颈,降低Kernel Launch开销,提升推理速度
python
import torch
import torch.nn as nn

# 未融合:三个独立算子,三次显存读写
class UnfusedMLP(nn.Module):
    def __init__(self, hidden_dim):
        super().__init__()
        self.w = nn.Linear(hidden_dim, hidden_dim)
        self.gelu = nn.GELU()
    def forward(self, x):
        x = self.w(x)    # MatMul + Add
        x = self.gelu(x) # GELU
        return x

# 算子融合版本,Torch.compile自动做算子融合
class FusedMLP(nn.Module):
    def __init__(self, hidden_dim):
        super().__init__()
        self.w = nn.Linear(hidden_dim, hidden_dim)
    def forward(self, x):
        return torch.nn.functional.gelu(self.w(x))

if __name__ == "__main__":
    hidden = 1024
    model_fused = FusedMLP(hidden).cuda()
    # 开启compile,自动执行算子融合优化
    model_fused = torch.compile(model_fused)
    x = torch.randn(128, hidden, device="cuda")
    out = model_fused(x)
    print("融合算子推理完成,输出shape:", out.shape)
2.3 算子精度自适应优化
根据算子的计算特性,动态调整计算精度,避免精度冗余。
- 大模型中部分算子对精度敏感度极低,比如归一化、池化、拼接算子,完全可以使用FP16、INT8低精度计算,不影响模型最终输出效果;
- 而矩阵乘法、损失计算等核心算子,保留FP32高精度。
- 通过精准区分算子精度需求,在保证模型精度无损的前提下,大幅降低单算子计算量,提升运算速度,同时减少显存占用。
示例:自动混合精度AMP,算子精度自适应
示例实现了自动混合精度(AMP)推理。通过autocast上下文管理器,将Linear层的矩阵乘法自动转换为FP16半精度计算,利用GPU Tensor Core加速,同时保持数值稳定性,最终实现降低显存占用并提升推理吞吐。
python
import torch
from torch.cuda.amp import autocast

model = nn.Linear(1024, 1024).cuda()
x = torch.randn(64, 1024, device="cuda")

# autocast自动对算子选择FP16/FP32,精度自适应
with autocast(dtype=torch.float16):
    y = model(x)
print("AMP混合精度推理完成")
2.4 硬件算子适配优化
- 不同硬件设备的算力特性不同,CPU、GPU、NPU的核心计算优势差异极大。
- 通常容易常犯的错误是一套算子逻辑适配所有硬件,导致硬件算力无法发挥。
- 优化时需要针对性适配硬件特性,比如:
- GPU擅长并行计算,可将算子改造为高并行逻辑;
- NPU擅长定点计算,可将算子统一优化为定点运算模式,最大化挖掘硬件算力潜力。
3. 实践应用价值
算子优化是大模型性能优化的底层基石,所有上层优化方案都需要依托高效算子才能发挥作用。从落地效果来看,单纯的算子优化,即可实现大模型推理速度提升40%-80%,显存占用降低30%左右,优化成本极低,无需修改模型结构,仅通过底层计算逻辑调优即可实现。
在企业私有化部署、端侧大模型落地、高并发推理场景中,算子优化的价值尤为突出。高并发场景下,单次推理的微小延迟损耗,会随着请求量倍增被无限放大,导致系统拥堵。通过算子优化压缩单次推理耗时,能够大幅提升系统并发承载能力,降低服务器部署数量,显著减少落地成本。同时,高效算子能够减少无效算力消耗,降低设备功耗,让端侧低性能设备也能流畅运行轻量化大模型。
算子优化也是性价比最高的优化方向。相比于模型剪枝、蒸馏需要掌握复杂算法逻辑,算子优化多为工具调用、参数配置、算子替换操作,学习门槛低、落地难度小、效果直观,是入门大模型优化的首选技术方向。
- 定位:整套大模型优化体系的底层基础,上层内存、调度优化都建立在高效算子之上;
- 收益:无损精度,推理提速40%~80%,显存下降约30%,不用改动模型权重;
- 业务价值:高并发私有化部署降低服务器数量;端侧硬件依靠算子优化获得运行能力;
- 学习门槛:相比剪枝、蒸馏更简单,以工具配置、算子替换为主,适合新手入门。
三、内存访问优化
1. 内存瓶颈解析
通常我们容易陷入认知误区:大模型推理慢、显存溢出,是因为算力不够。但实际落地中,极大部分的显存报错、推理卡顿问题,根源都不是算力不足,而是内存访问效率过低。简单来说,就是GPU算力闲置,但数据读写速度跟不上计算速度,导致算力长期等待数据,造成资源浪费。
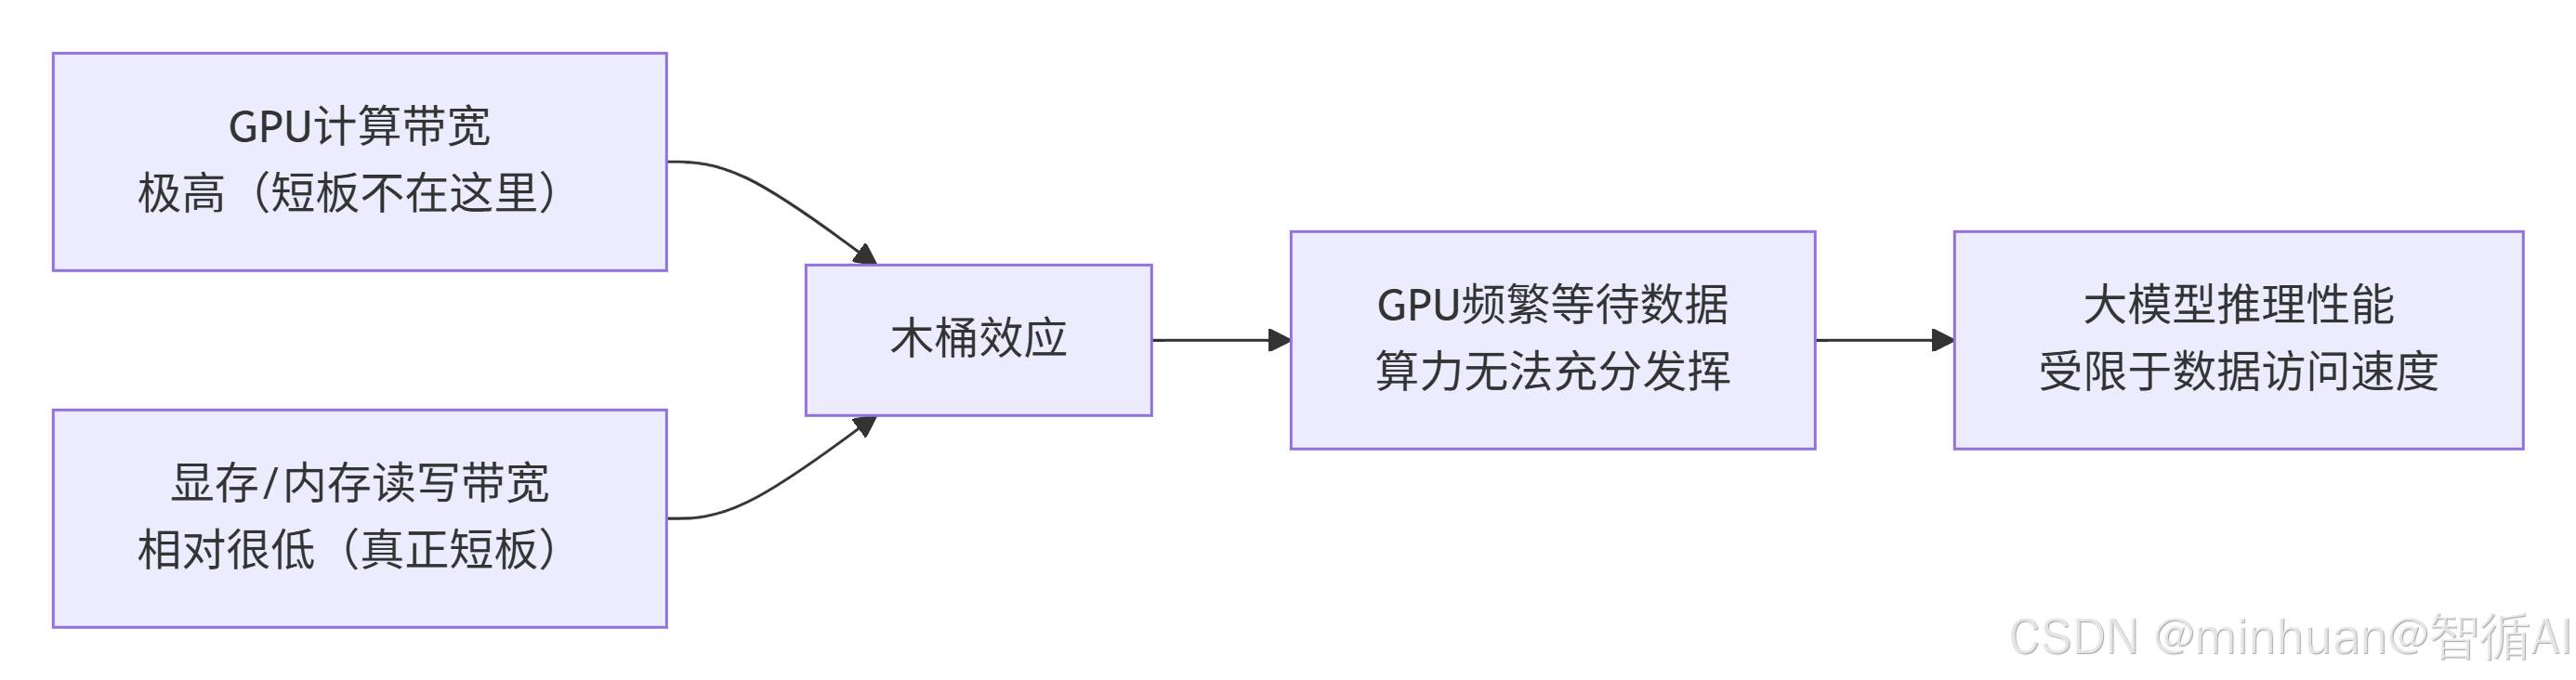
大模型的运行逻辑和传统小模型完全不同,百亿级参数的模型,权重、梯度、中间特征数据体量极大。模型推理过程中,需要频繁在显存、内存、缓存之间传输数据,而内存、显存的读写带宽,远低于GPU的计算带宽。这就形成了典型的木桶效应:短板不在计算算力,而在数据访问速度。
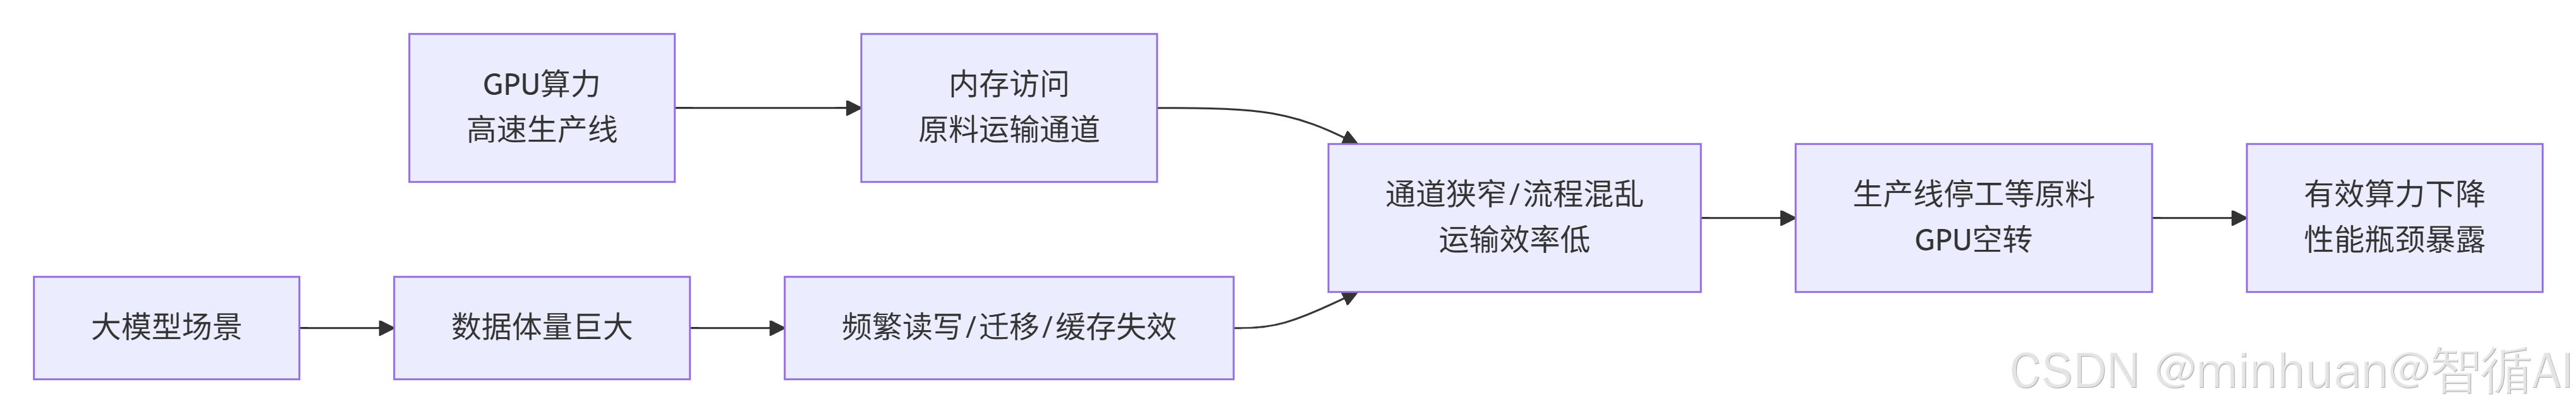
我们可以用通俗的例子理解:GPU算力就像高速生产线,计算速度极快;而内存访问就是原料运输通道,如果运输通道狭窄、运输流程混乱,生产线就会频繁停工等原料,再强的生产能力也无法发挥。大模型场景下,数据体量巨大,频繁的读写、迁移、缓存失效问题,会让内存访问瓶颈彻底暴露。
常见的内存访问问题主要有四类:
- 跨设备数据频繁迁移:CPU内存和GPU显存反复拷贝,拷贝耗时甚至超过计算耗时;
- 内存碎片化:频繁申请、释放显存,剩余显存总量充足,但没有连续大块内存,触发OOM报错;
- 缓存复用率低:相同权重、上下文特征重复加载,产生大量冗余内存读写;
- 内存分配不合理:张量内存布局零散,大块张量长期占用连续内存,挤压小任务资源。
这些问题不会影响模型的推理精度,但会直接拖慢推理速度,拉高显存占用,严重时直接导致程序崩溃。尤其是在长文本生成、多轮对话、批量推理场景中,内存访问低效的问题会持续叠加,成为制约大模型落地的核心障碍。
2. 核心优化策略
针对大模型内存访问的各类痛点,我们从数据迁移、内存规整、缓存复用、分配机制四个维度,拆解通俗易懂、可直接落地的优化策略。
2.1 严控跨设备数据迁移拷贝
CPU与GPU的数据拷贝是内存耗时的核心来源,开发中最常见的错误就是频繁进行张量设备转换。优化核心原则是:能不迁移就不迁移,能批量迁移就不单次迁移:

- 首先,统一数据运行设备,模型权重、输入数据、中间特征全程固定在GPU显存,避免反复切换设备。
- 其次,采用批量数据传输模式,将多次小数据拷贝合并为一次批量拷贝,减少传输次数和连接开销。
- 最后,禁用无效数据拷贝,推理过程中无需保留的中间结果,直接原地释放,不进行冗余存储和拷贝。
通过该优化,可直接降低60%以上的跨设备内存访问耗时。
示例:减少CPU-GPU数据拷贝
示例对比了GPU数据传输的两种写法。错误写法在循环内反复将CPU张量拷贝到GPU,每次循环都触发一次跨设备传输,导致严重的PCIe带宽瓶颈和延迟。优化写法将数据提前在CPU端拼接为批量张量,一次性传输到GPU后再在显存内迭代,大幅减少跨设备拷贝次数,显著提升数据加载效率。
python
import torch

# ❌ 错误写法:循环内反复拷贝张量
def bad_transfer():
    for i in range(10):
        cpu_tensor = torch.randn(1024,1024)
        gpu_tensor = cpu_tensor.cuda() # 每次循环都跨设备拷贝

# ✅ 优化写法:提前把数据一次性送入GPU,减少拷贝
def good_transfer():
    cpu_batch = torch.randn(10, 1024,1024)
    gpu_batch = cpu_batch.cuda() # 一次性批量传输
    for tensor in gpu_batch:
        pass
2.2 内存碎片化规整优化
内存碎片化是显存溢出的高频诱因,解决核心是统一内存申请释放规则。

- 首先,采用内存预分配机制,模型初始化阶段,提前预分配推理所需的全部连续内存空间,运行过程中不再频繁申请和释放,从根源避免碎片化。
- 其次,定期进行内存规整,针对运行过程中产生的零散空闲内存,主动合并为连续内存块,保障大张量运算的内存需求。
- 最后,优化内存释放逻辑,避免小内存块频繁申请释放,统一批量管理内存资源,让内存空间利用更规整高效。
示例:Torch显存碎片整理
示例实现了GPU显存碎片整理的操作。empty_cache()将PyTorch缓存中未使用的显存归还给CUDA驱动,synchronize()确保所有异步Kernel执行完毕后再清理。常用于长时推理服务中,防止显存碎片累积导致OOM。
python
import torch

# 主动释放未使用显存 + 内存规整
def defrag_gpu_memory():
    torch.cuda.empty_cache()
    torch.cuda.synchronize()
    print("显存碎片清理完成")
2.3 防重复缓存复用优化
大模型推理中,大量上下文特征、模型权重、固定参数会被重复调用,缓存复用可以彻底解决重复加载的冗余开销。核心优化方式分为两点:
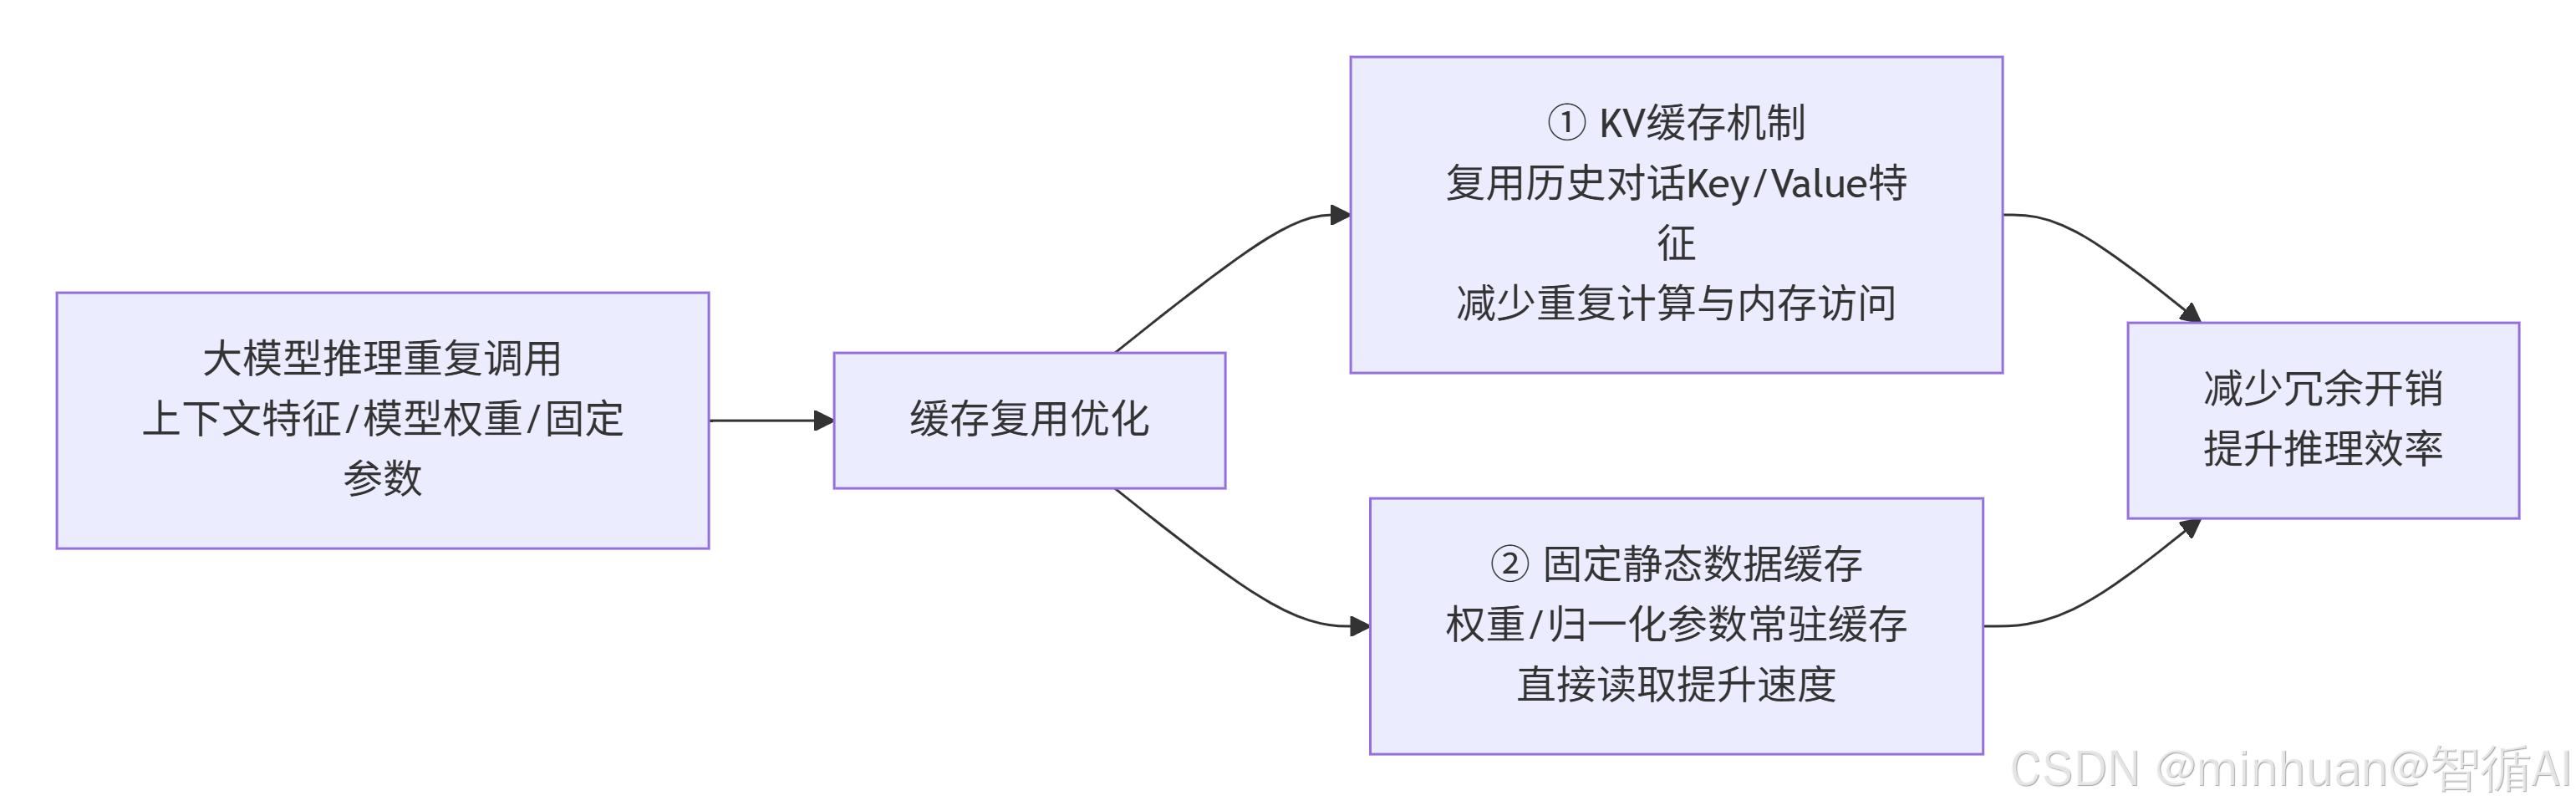
- 一是开启KV缓存机制,这是大模型对话场景的核心优化,多轮对话中,复用历史对话的Key、Value特征,无需重复计算、重复加载数据,大幅减少内存访问次数;
- 二是固定静态数据缓存,将模型权重、归一化参数等固定不变的数据,常驻缓存,每次推理直接读取缓存数据,无需重新从内存加载,极大提升数据读取速度。
示例:KV缓存简易演示
示例演示了大模型推理中KV Cache键值缓存的核心更新逻辑。它通过torch.cat将新Token的Key和Value拼接到历史缓存中,避免在自回归生成时重复计算已处理上下文的KV矩阵,以空间换时间,将推理复杂度从O(n²)降至O(n)。
python
import torch

class KVCacheDemo:
    def __init__(self):
        self.k_cache = None
        self.v_cache = None
    def update(self, new_k, new_v):
        if self.k_cache is None:
            self.k_cache = new_k
            self.v_cache = new_v
        else:
            # 拼接新增token的kv,复用历史,不重算过往上下文
            self.k_cache = torch.cat([self.k_cache, new_k], dim=1)
            self.v_cache = torch.cat([self.v_cache, new_v], dim=1)
        return self.k_cache, self.v_cache
2.4 动态内存分配优化
- 摒弃固定内存分配模式,根据推理任务大小、文本长度,动态调整内存占用。
- 短文本推理自动缩减内存分配空间,长文本推理动态扩容,避免固定大内存占用造成的资源浪费。
- 同时,优化张量内存布局,将零散的特征张量整合为连续内存布局,提升内存读写的连续性,进一步加快访问速度。
3. 应用优化效果
内存访问优化是性价比最高的降耗提速手段,也是大模型稳定落地的必备优化步骤。经过全套内存优化后,大模型推理的显存碎片化问题基本可以彻底解决,显存有效利用率可从原本的50%左右提升至85%以上,杜绝显存充足却报错溢出的问题。
在推理速度层面,内存访问耗时大幅降低后,GPU算力的有效利用率会显著提升,整体推理速度可提升30%-60%,长文本生成、多轮对话场景的优化效果尤为明显。原本卡顿严重的长文本推理任务,优化后可以实现流畅输出,大幅提升用户使用体验。
- 在资源复用层面,高效的内存管理可以让单张GPU承载更多推理任务,提升设备并发能力:对于企业部署场景,能够有效减少硬件设备投入,降低运维成本;
- 对于端侧部署场景,能够适配更低配置的硬件设备,拓宽大模型的落地场景边界。
同时,规范的内存访问逻辑,能减少设备长期高负载运行的损耗,提升设备运行稳定性,降低程序崩溃、卡死的概率。
- 核心作用:打通数据传输瓶颈,解决算力空转等待数据的"带宽瓶颈";
- 指标收益:显存利用率从50%提升至85%+,推理整体提速30%~60%,消除假性显存OOM;
- 场景增益:长文本、多轮对话优化效果最突出;
- 业务价值:单卡承载更多并发请求,降低硬件采购成本,提升服务稳定性。
四、多模型Pipeline调度优化
1. Pipeline调度痛点
随着AI应用场景的升级,单一模型已经无法满足复杂业务需求,现在主流的AI应用基本都是多模型协同工作。比如多模态AI应用,需要同时调用文本大模型、图像生成模型、图像理解模型;智能客服系统,需要调用意图识别模型、语义匹配模型、文本生成模型。多个模型串联、并联运行,就需要依靠Pipeline流水线调度实现任务流转。
多模型Pipeline最容易出现的问题不是模型效果问题,而是调度混乱、资源闲置、任务拥堵。如果我们的开发方式是简单串行调度:执行完A模型任务,再执行B模型任务,最后执行C模型任务。这种粗放的调度方式,会造成极大的资源浪费和严重的延迟堆积。
我们可以通俗理解Pipeline调度问题:多个模型就像多个工序的加工车间,简单串行调度就是一个车间完工后,下一个车间才能开工,全程大量车间处于闲置等待状态,整体生产效率极低。而不合理的调度逻辑,还会导致部分车间任务堆积拥堵,部分车间长期闲置,硬件资源分配极度不均衡。
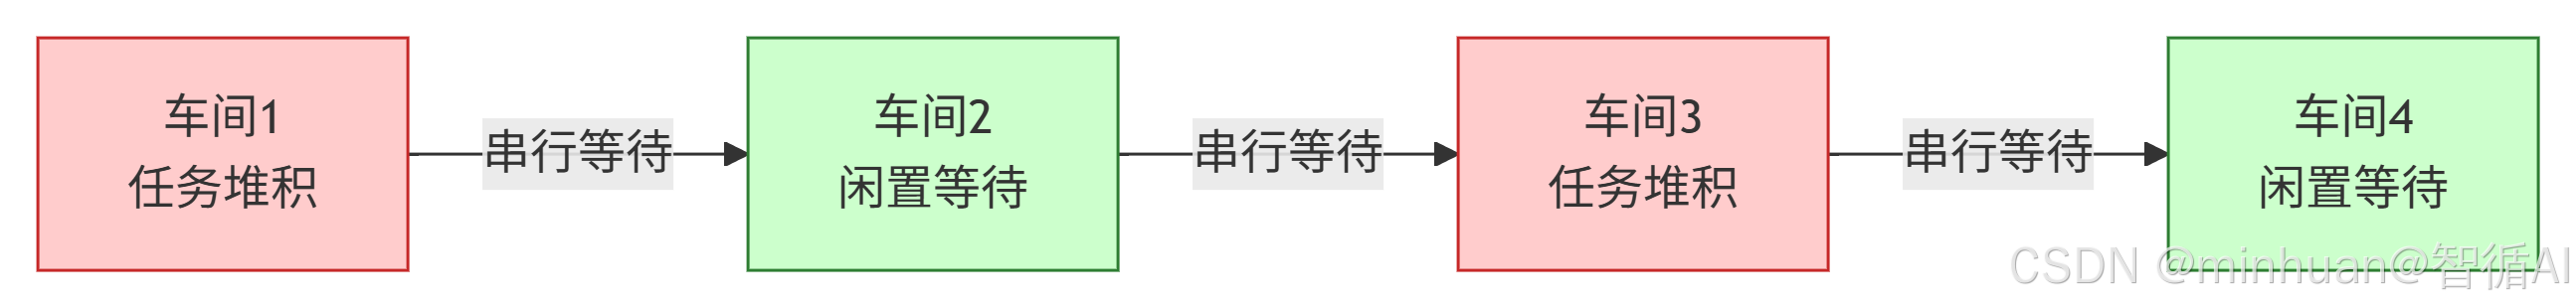
具体来看,多模型Pipeline的核心痛点有四点:
- 串行调度效率低下:可并行的独立任务被强制串行,拉长整条链路的端到端延迟;
- 资源分配失衡:热门模型抢占显存算力,冷门模型资源不足,硬件整体利用率低;
- 故障连锁阻塞:单个模型任务超时、报错,整条流水线全部卡住;
- 缺少任务优先级:高优先级业务请求和离线批量任务混排,核心业务响应得不到保障。
在高并发、多模型协同的业务场景中,这些痛点会被持续放大,导致系统响应慢、报错率高、资源浪费严重,无法支撑规模化落地。想要实现多模型高效协同,核心就是优化Pipeline调度逻辑,实现任务的合理流转、资源的精准分配、异常的快速隔离。
2. 调度优化核心方法
多模型Pipeline调度优化不修改模型本身,完全通过调度逻辑、任务管理、资源分配优化提升整体效率,核心优化方法分为四大维度,层层递进、逻辑清晰。
2.1 串行转并行,拆分任务链路
首先对多模型任务链路进行拆解,区分依赖型任务和独立型任务。
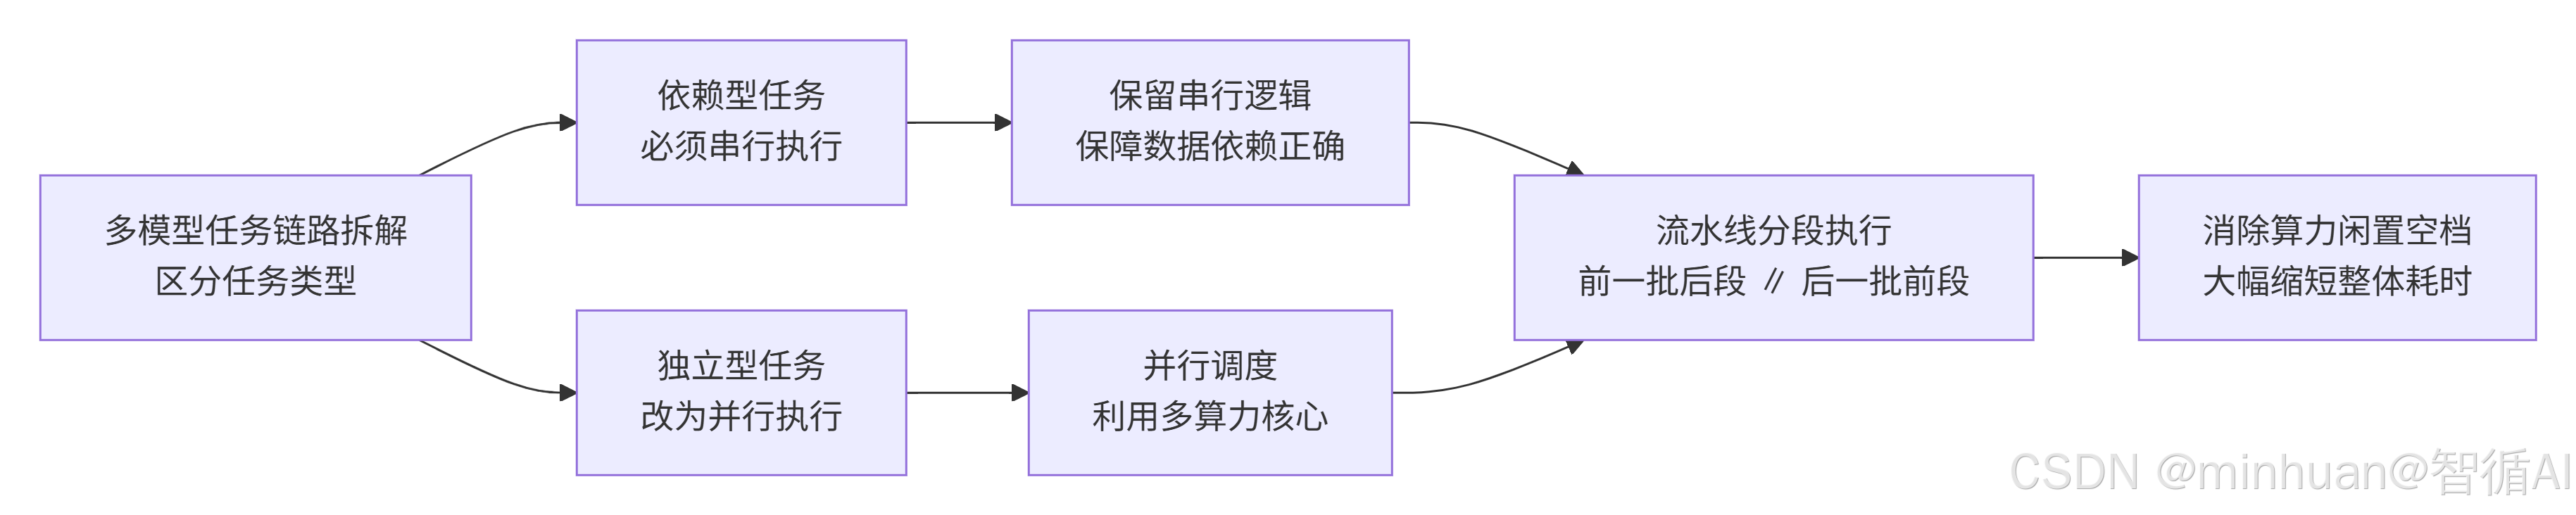
- 依赖型任务必须串行执行,比如图像预处理模型的输出,是图像理解模型的输入,存在数据依赖,无法并行;
- 而独立型任务无数据关联,比如文本识别和图像生成任务,可同时并行执行。
- 优化时,保留依赖任务的串行逻辑,将所有独立任务改为并行执行,最大化利用硬件多算力核心,大幅缩短整体任务耗时。
- 同时,采用流水线分段执行模式,上一批任务的后段工序,可与下一批任务的前段工序并行,彻底消除算力闲置空档。
示例:多模型Pipeline分段流水线(简易async调度)
示例对比了多模型推理的串行与并行两种调度方式,演示了如何利用asyncio将无依赖关系的任务并行执行,减少整体等待时间,提升多模态推理服务的吞吐量。
- 串行版本:预处理、视觉、LLM三个模型依次等待,总耗时为三者之和
- 并行版本:图像链路与文本链路无依赖,通过create_task并发调度
- 依赖管理:图像链路内部保持串行(预处理→视觉),文本链路独立并行
python
import asyncio

# 模拟三个模型
async def preprocess_model(img):
    await asyncio.sleep(0.1)
    return f"img_feat_{img}"

async def vision_model(feat):
    await asyncio.sleep(0.2)
    return f"vision_result_{feat}"

async def llm_model(text):
    await asyncio.sleep(0.3)
    return f"llm_reply_{text}"

# 串行版本(低效)
async def pipeline_serial(image):
    feat = await preprocess_model(image)
    res = await vision_model(feat)
    out = await llm_model(res)
    return out

# 并行独立任务版本(优化)
async def pipeline_parallel(image, user_text):
    # 图像链路串行依赖;文本模型独立并行执行
    task_img = asyncio.create_task(preprocess_model(image))
    task_llm = asyncio.create_task(llm_model(user_text))
    feat = await task_img
    v_res = await vision_model(feat)
    l_res = await task_llm
    return {"vision":v_res, "llm":l_res}
2.2 动态资源分配,精准匹配负载
摒弃固定资源分配模式,根据各模型的实时负载动态分配算力和显存资源:
- 系统实时监控每个模型的任务排队数量、运行耗时、资源占用情况,对高负载、高拥堵的核心模型,自动扩容算力和显存资源;
- 对低负载、闲置的模型,自动收缩资源,将闲置资源调度至紧缺环节。
- 同时,设置模型资源保底阈值,保障每个模型都有基础运行资源,避免资源抢占导致的模型卡死,实现资源利用最大化、负载均衡化。
2.3 任务优先级调度,保障核心业务
为不同业务、不同类型的任务设置优先级分层,搭建分级调度机制:
- 将付费业务、核心客服、实时交互任务设置为高优先级,将批量数据处理、离线推理、非实时任务设置为低优先级。
- 调度系统优先分配资源执行高优先级任务,低优先级任务在资源空闲时执行。
- 同时,开启任务抢占机制,紧急高优先级任务可适度抢占闲置资源,彻底解决核心任务被普通任务挤占的问题,保障核心业务响应速度。
示例:简易优先级任务队列
基于Python的heapq模块封装了一个优先级队列,用于在并发任务调度中按优先级排序执行。它利用最小堆特性,将优先级数值小的任务排在前面,确保高优先级任务(如实时问答)优先被处理,低优先级任务(如离线摘要)延后执行。
python
import heapq

class PriorityQueue:
    def __init__(self):
        self._queue = []
    def push(self, priority, task):
        heapq.heappush(self._queue, (priority, task))
    def pop(self):
        if self._queue:
            return heapq.heappop(self._queue)
        return None

q = PriorityQueue()
q.push(priority=1, task="高优先级-客服实时问答") # 数字越小优先级越高
q.push(priority=5, task="低优先级-离线批量摘要")
print(q.pop())
2.4 异常隔离与流水线解耦
解决单一故障全局阻塞的问题,核心是实现多模型流水线解耦和异常隔离。
- 为每个独立模型配置独立的任务队列、独立的资源池,模型之间互不干扰。
- 当某一个模型出现卡顿、报错、超时问题时,系统自动隔离异常模型,仅阻塞该模型的对应任务,不会影响其他模型和整体流水线运行。
- 同时,增加任务超时重试、无效任务清理机制,及时清理堆积的失效任务,避免任务拥堵持续叠加,大幅提升多模型系统的稳定性和容错能力。
3. 场景实践价值
多模型Pipeline调度优化,是复杂AI应用规模化落地的核心保障。单一模型优化的收益是有限的,而多模型调度优化,能够盘活整个系统的硬件资源,提升整体业务吞吐能力,是从单点优化到全局增效的关键升级。
从实际落地效果来看,优化后的多模型Pipeline,硬件资源整体利用率可从原本的30%-40%提升至70%以上,彻底解决算力、显存闲置问题。多模型协同推理的整体耗时可缩短40%-70%,高并发场景下的任务排队、响应延迟问题得到彻底解决,系统并发承载能力翻倍提升。
在业务层面,分级调度机制能够精准保障核心业务体验,让实时交互、核心服务的响应速度稳定高效,大幅降低用户等待延迟;异常隔离机制能够提升系统稳定性,减少服务卡顿、崩溃、报错概率,降低运维压力。在成本层面,高效的调度逻辑,能够最大化挖掘现有硬件设备的算力价值,无需新增硬件即可大幅提升业务承载能力,有效降低企业AI落地的硬件采购和运维成本。
掌握Pipeline调度优化,能够跳出单一模型优化的局限,建立全局系统优化思维,从模型运行、任务调度、资源管理全维度把控AI系统性能,是从基础开发进阶为高级AI工程优化的核心能力。
- 定位:从单点模型优化升级为全链路系统优化,面向多模型串联/并联业务;
- 指标收益:硬件整体利用率由30%~40%提升至70%+,端到端推理耗时下降40%~70%;
- 核心能力:负载均衡、任务优先级、故障隔离,避免单点故障导致整体服务宕机;
- 成长价值:帮助开发者建立大模型工程的全局视角,是AI后端工程进阶必备技能。
五、总结
大模型的落地优化从来不是单一的技术操作,而是一套从底层计算、资源访问到上层调度的完整体系。算子优化解决的是单步计算低效的问题,打磨模型最基础的计算单元,让每一次运算都精准高效;内存访问优化解决的是数据流转卡顿的问题,打通数据传输瓶颈,让算力不再空转等待;多模型Pipeline调度优化解决的是全局资源浪费的问题,实现多模型协同高效运转,盘活整体系统能力。
我们应用入手不必畏惧大模型优化的复杂性,所有高阶的工程优化,本质都是基础技术的叠加。从算子定制、融合入手,打好底层计算基础;再优化内存访问逻辑,解决资源损耗问题;最后搭建高效的Pipeline调度体系,实现全局增效,循序渐进即可完整掌握大模型工程优化的核心能力。未来大模型的实践已不是模型精度的竞争,而是工程落地效率、资源利用效率、服务稳定度的竞争。掌握算子、内存、Pipeline优化技术,实现大模型低成本、高效率、稳落地,让AI技术真正落地赋能业务。