一、前言
本地部署、微调训练的大模型,自带一套固定的静态知识库,能应对通用问答、基础业务咨询,但一旦线上业务数据发生变动,比如产品价格调整、政策规则更新、客户信息迭代、业务流程优化,模型就会输出过时、错误的内容。
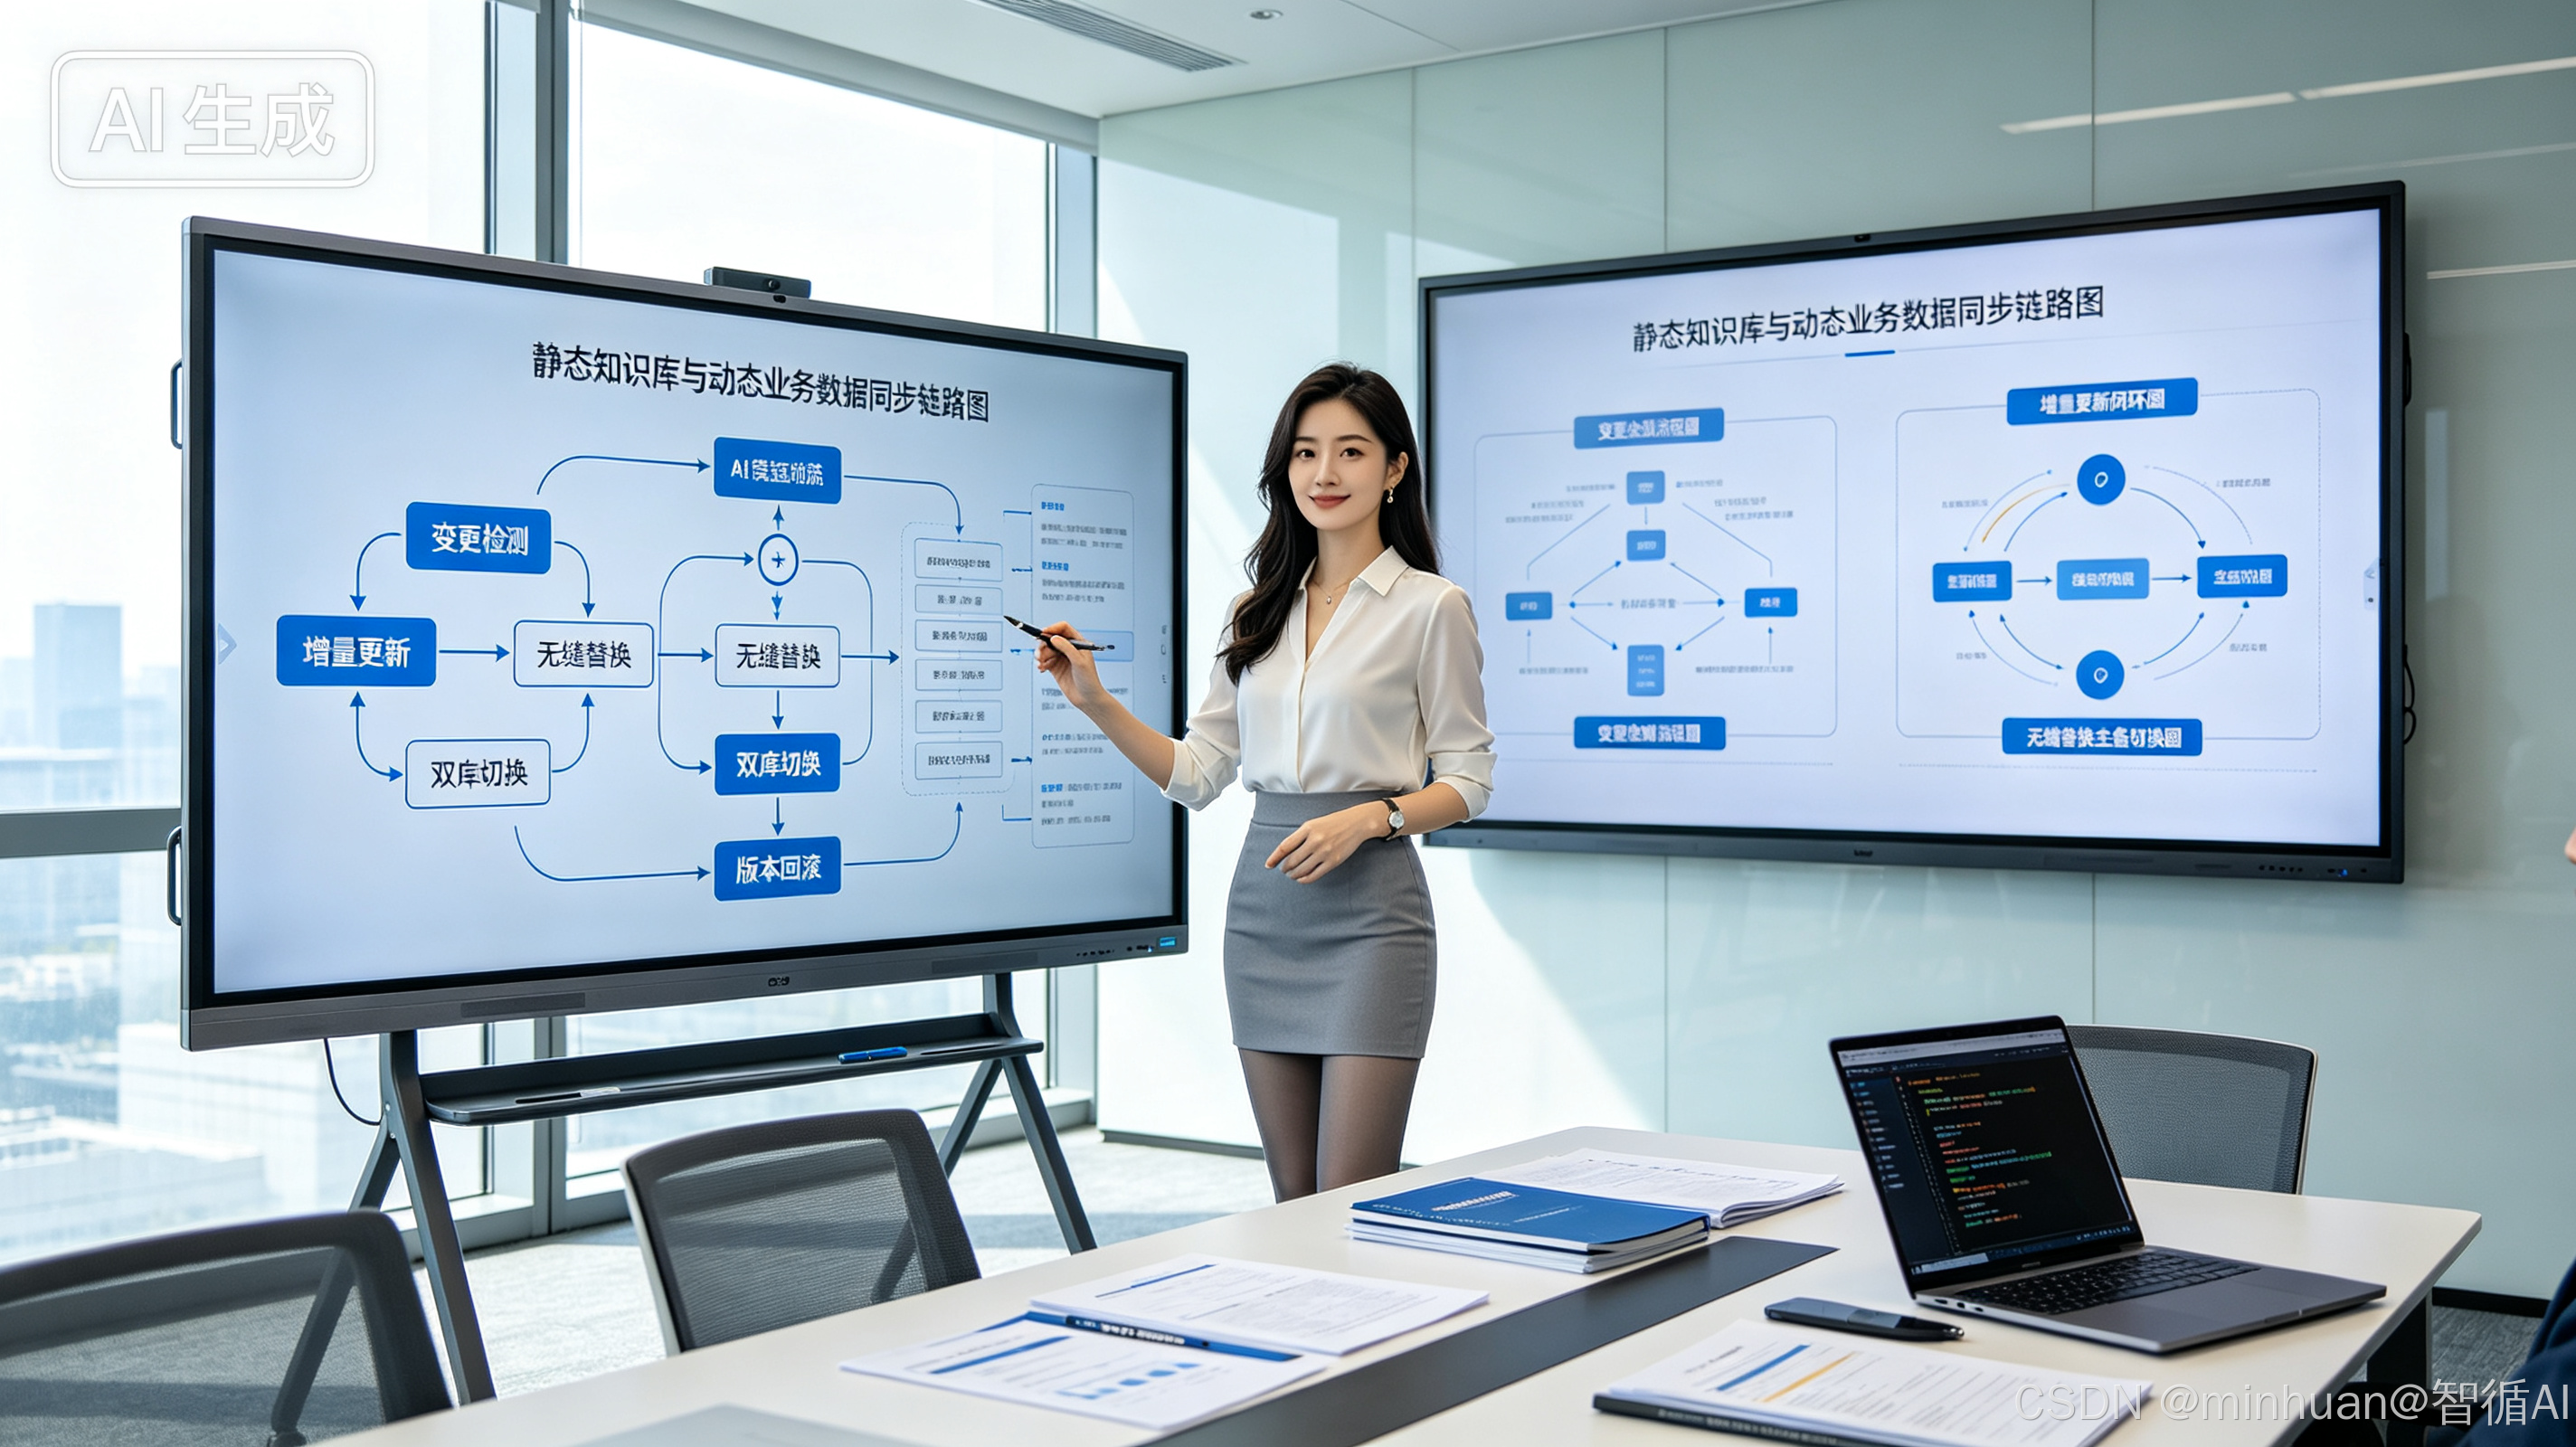
简单来说,静态知识库是死数据,存储的是训练、初始化阶段固化的文本、规则、资料;而业务数据是活数据,每时每刻都在新增、修改、删除,是企业真实运转的核心依据。如果两者无法实时同步,大模型的落地价值就会大打折扣,甚至出现误导业务、影响服务质量的问题。最初解决这个问题的第一反应是全量更新知识库,也就是每次数据变动都重新爬取、解析、入库,再刷新模型检索库。但这种方式弊端非常明显,全量更新耗时久、算力消耗大、停机影响业务运行,完全不适配企业高频、实时的业务场景。
二、分清两类数据
1. 静态知识库定义
大模型静态知识库,是指经过结构化处理、固化存储,短时间内不会频繁变动的知识集合,也是大模型检索增强生成RAG架构的核心数据底座。它的核心特点是稳定性强、更新频次低、内容权威性高,是大模型输出准确内容的基础依据。
从内容维度来看,静态知识库包含的内容十分固定,主要分为三类:、
- 第一类是企业基础固定资料,比如品牌介绍、企业文化、长期不变的产品参数、行业通用标准;
- 第二类是长效政策规则,比如固定的行业法规、企业长期管理制度、通用服务规范;
- 第三类是历史沉淀数据,比如过往的成功案例、经典问答库、归档的业务文档。
从存储和应用维度来看,静态知识库一般会经过清洗、切片、向量化处理,存储在向量数据库中,供大模型实时检索。传统落地模式中,这套知识库一旦构建完成,往往不会主动更新,只有在季度、年度大版本迭代时才会统一优化,这也是模型知识滞后的根本原因。
- 静态知识库的优势非常突出,数据规整、噪声低、检索速度快、模型调用稳定性高,不会出现临时数据错乱、缺失的问题。
- 但短板也十分致命,无法适配动态业务,面对实时变动的业务场景,极易产生知识断层,导致问答失真、决策失误。
2. 动态业务数据定义
动态业务数据是企业业务系统实时产生、持续变动的鲜活数据,是支撑业务正常运转的核心动态资源,也是大模型落地真实业务场景必须适配的数据类型。和静态知识库存活固定、长效稳定的特点完全相反,它的核心属性是高频变动、实时生成、场景适配性强。
动态业务数据的覆盖场景非常广泛,几乎涵盖企业所有一线业务:
- 电商场景的商品价格、库存数量、促销活动规则;
- 政务场景的最新政策通知、办事流程调整、材料要求更新;
- 客服场景的最新售后规则、常见问题迭代、服务时效调整;
- 企业办公场景的组织架构变动、审批流程更新、岗位权责调整,都属于典型的动态业务数据。
这类数据的存储载体也更加多元,不像静态数据仅依赖向量数据库,它主要存储在MySQL、PostgreSQL等关系型数据库,Redis缓存、业务中台、CRM、ERP等实时业务系统中。数据变动形式多样,包含新增、修改、删除、状态变更四种核心类型,且变动时间无规律,可能秒级、分钟级更新。
对于大模型而言,动态业务数据是即时知识,直接决定模型输出内容的时效性和准确性。如果大模型无法读取最新的动态业务数据,仅依赖静态知识库工作,就会出现"答非当下、答非最新"的问题,完全无法满足企业智能化业务的落地需求。
3. 数据不同步核心痛点
很多企业大模型项目落地卡顿、效果不达预期,核心问题就是静态知识库和动态业务数据脱节,两类数据各自独立、互不连通,形成了典型的数据孤岛。具体可以总结为四大核心痛点,也是所有落地项目普遍会遇到的问题。
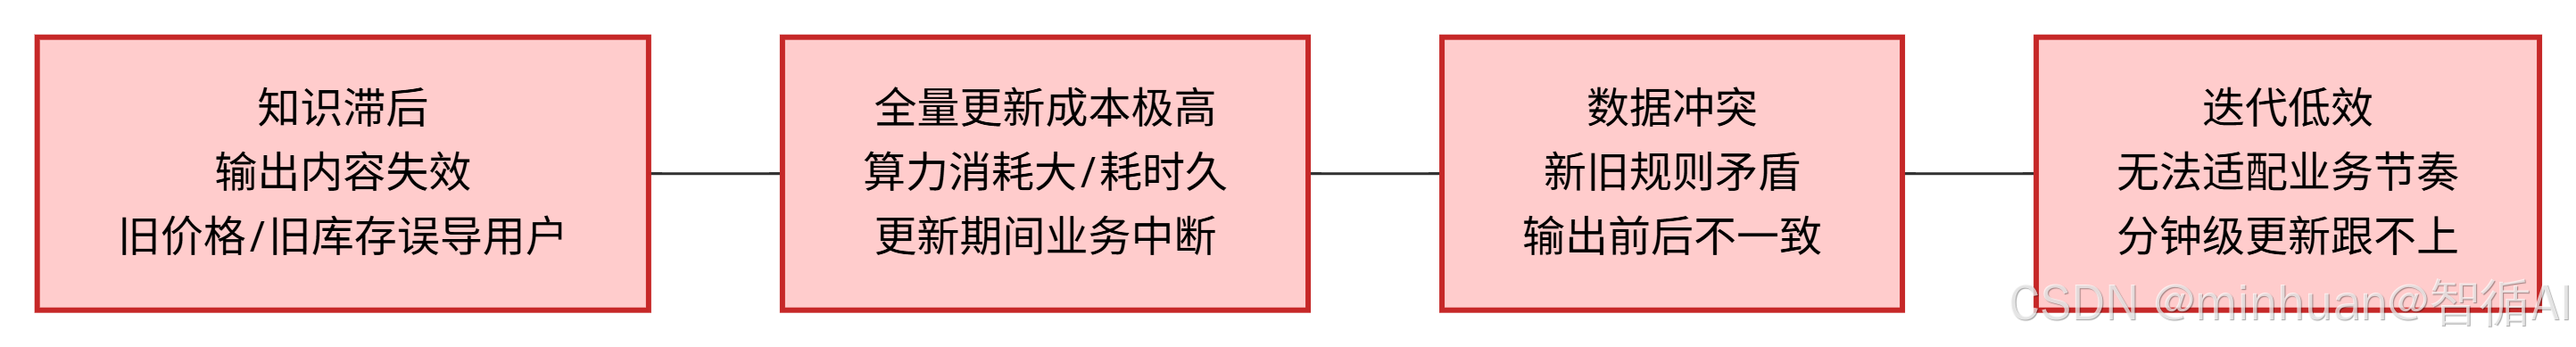
- **知识滞后,输出内容失效:**这是最直观的问题。比如电商大模型,静态知识库存储的是旧价格、旧库存,而业务端已经更新了促销价格和库存数量,模型检索静态数据后,会向用户输出错误的价格、库存信息,直接误导用户咨询,影响转化。
- 全量更新成本极高: 很多新手团队为了解决滞后问题,会采用定期全量刷新知识库的方式,每日或每周重新全量爬取、解析、向量化入库。但全量更新存在诸多弊端:
- 一是算力消耗大,大量重复处理未变动数据,造成资源浪费;
- 二是耗时久,数万、数十万条数据全量更新往往需要数小时;
- 三是存在业务中断风险,更新期间知识库锁定,模型无法正常检索服务。
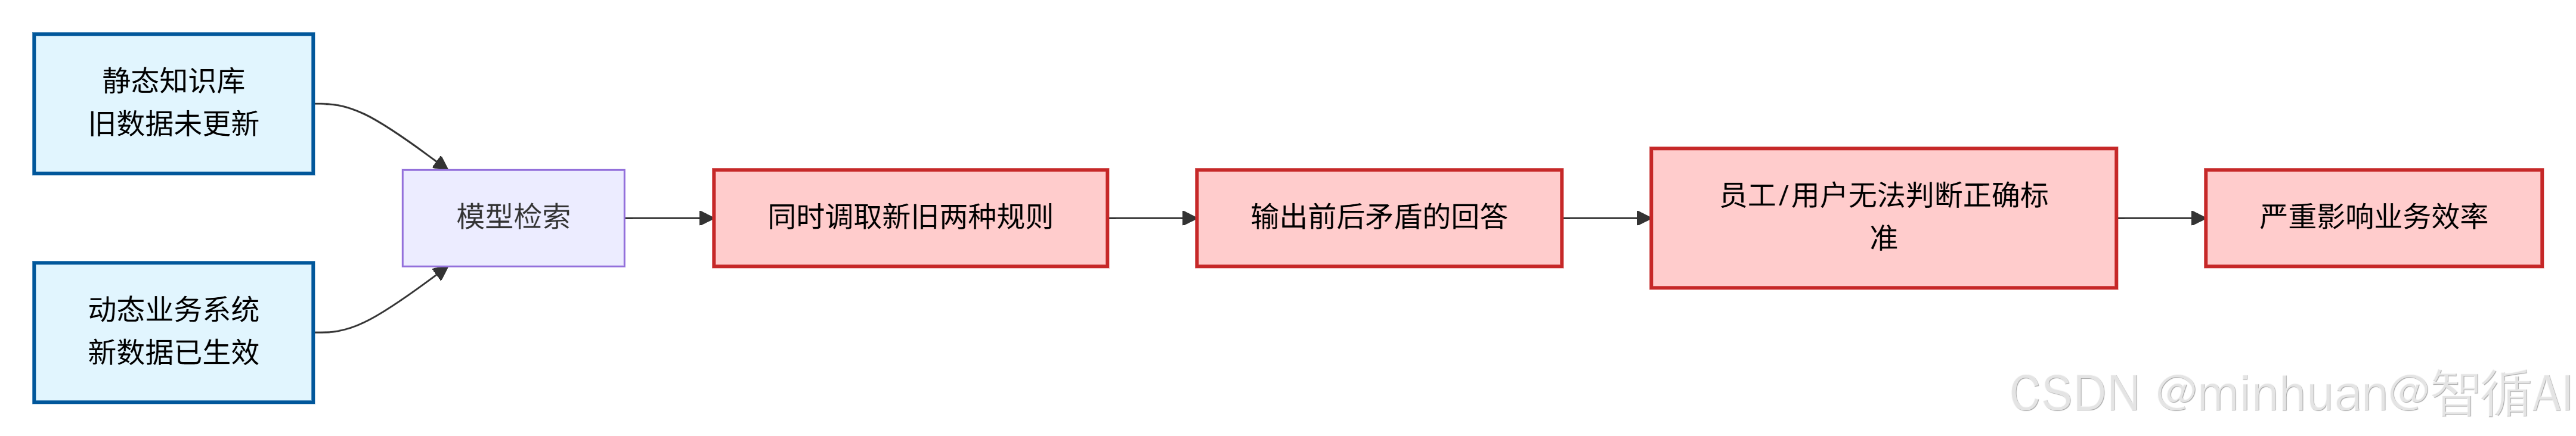
- **数据冲突,逻辑混乱:**当静态知识库旧数据未更新,动态业务新数据已生效时,会出现数据矛盾的情况。比如企业更新了审批流程,静态库还是旧流程,模型检索时可能同时调取新旧两种规则,输出前后矛盾的回答,让员工和用户无法判断正确标准,严重影响业务效率。
- **迭代低效,无法适配业务节奏:**当下企业业务迭代速度极快,部分场景分钟级就会更新数据,传统的周期性全量更新完全跟不上节奏。数据同步滞后,导致大模型始终无法适配最新业务,沦为摆设式工具,无法真正赋能业务落地。
三、同步技术方案
1. 变更检测定位变动
变更检测是数据实时同步的前置核心步骤,所有增量更新、无缝替换的前提,都是精准找到动态业务数据的变动内容、变动范围和变动类型。如果无法精准检测变更,后续所有更新操作都只能盲目进行,要么遗漏数据、要么重复更新,失去实时同步的意义。
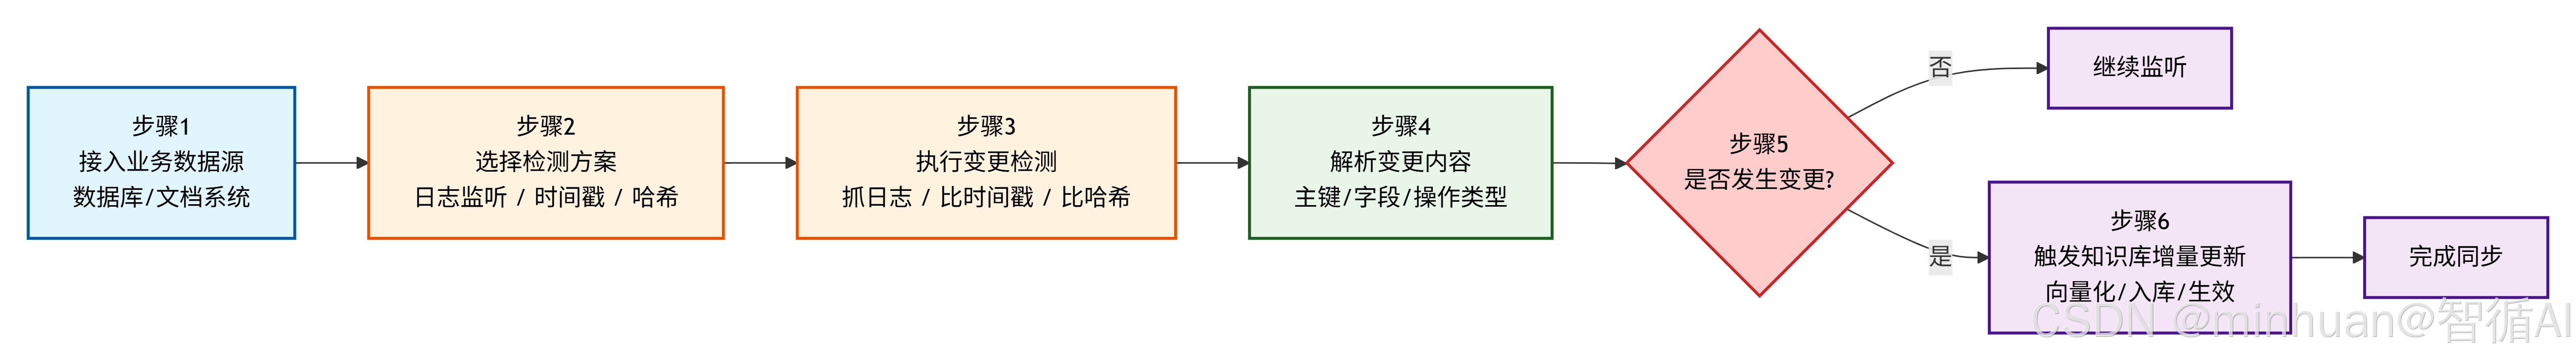
第一,日志监听检测,适配数据库核心业务数据。
- 目前主流业务数据库都自带日志记录功能,比如MySQL的Binlog、PostgreSQL的WAL日志,所有数据的新增、修改、删除操作,都会实时记录在日志中。
- 我们可以通过日志监听工具,实时抓取日志信息,解析出数据变动的主键、字段、内容、操作类型,实现秒级变更检测。
- 这种方式无需侵入业务系统,不影响业务运行,检测精度100%,是企业最主流的方案。
第二,时间戳比对检测,适配轻量业务场景。
- 对于小型企业、轻量化业务系统,数据变动频次不高、数据量较小,可采用简单高效的时间戳比对方式。
- 为每一条业务数据设置更新时间戳,同步程序定时拉取业务数据,对比本地知识库数据的时间戳,只要业务数据时间戳晚于知识库时间戳,即判定为数据发生变更。
- 该方案搭建简单、成本极低,适合新手快速落地,唯一短板是定时检测存在秒级到分钟级的延迟,无法支撑超高实时性场景。
第三,哈希校验检测,适配文本、文档类静态衍生数据。
- 针对企业制度、产品说明、业务文档等文本类数据,可通过哈希算法为每一份文档、每一条数据生成唯一哈希值。
- 系统定时对比业务端最新数据哈希值和知识库存储的历史哈希值,数值不一致则说明内容发生修改,判定为变更。
- 这种方式可以精准识别文本细微改动,避免文字修改、标点调整、内容删减等细节变更被遗漏,适配知识库文档更新场景。
变更检测的核心落地原则是"只抓变动、忽略不变",通过以上三种方案,可精准筛选出需要更新的数据,彻底避免全量扫描带来的资源浪费,为后续增量更新筑牢基础。
2. 增量更新迭代数据
增量更新是解决全量更新痛点的核心方案,也是大模型数据实时同步的核心核心。简单来说,就是只更新检测到的变动数据,未变动数据全部保留不变,用最小的资源消耗,完成知识库迭代,兼顾更新效率和业务稳定性。
做更新迭代之前,首先要了解增量更新和全量更新的区别,这里做一个通俗对比:
- 全量更新是"推倒重来",不管数据有没有变,全部重新处理、重新入库;
- 增量更新是"查漏补缺、修正错误",新增数据直接入库,修改数据覆盖更新,删除数据标记清理,旧数据完好保留。
增量更新的完整落地流程分为四步,循序渐进、逻辑清晰:
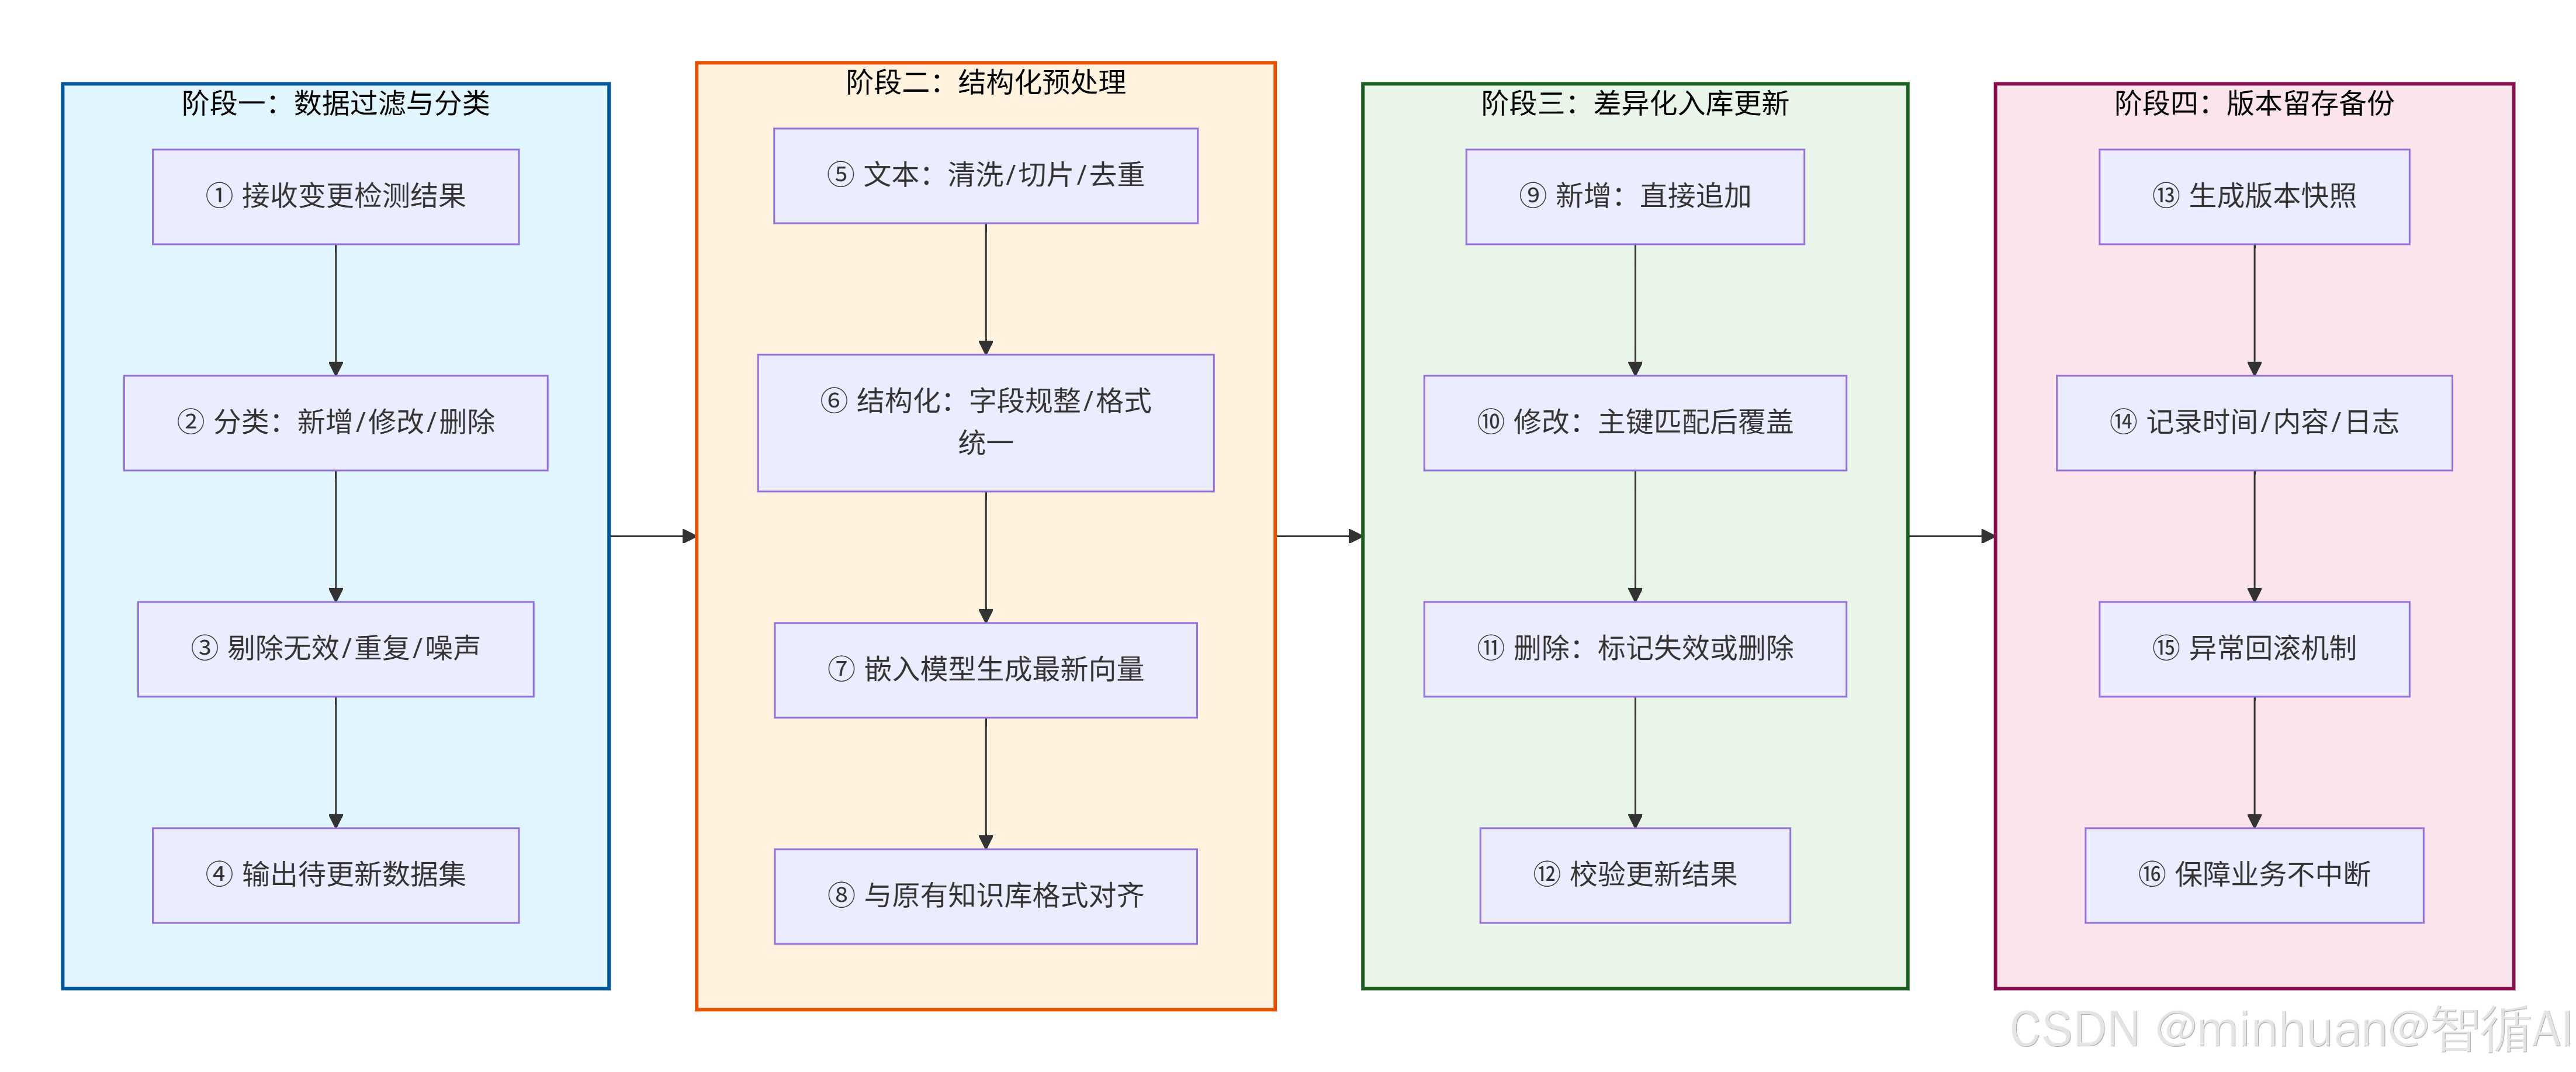
- 第一步,数据过滤与分类。基于上一步的变更检测结果,对变动数据进行分类梳理,分为新增数据、修改数据、删除数据三类,剔除无效数据、重复数据、噪声数据,保证待更新数据的准确性。
- 第二步,结构化预处理。对分类后的增量数据进行适配大模型知识库的处理,文本数据进行清洗、切片、去重,结构化数据进行字段规整、格式统一,随后通过嵌入模型生成最新向量,保证数据格式和原有静态知识库完全统一,避免格式错乱导致检索异常。
- 第三步,差异化入库更新。针对不同类型数据执行对应操作:新增数据直接追加到向量数据库和知识库体系中;修改数据根据唯一主键匹配旧数据,完成精准覆盖;删除数据在知识库中标记失效或直接删除,避免模型检索到过期数据。
- 第四步,版本留存备份。每次增量更新后,留存知识库版本快照,记录更新时间、更新内容、操作日志,一旦出现更新异常、数据错误,可快速回滚到历史稳定版本,保障业务不中断。
增量更新的核心优势十分明显:
- 首先是效率极高,仅处理变动数据,更新耗时从小时级压缩到秒级、分钟级;
- 其次是资源节省,算力、存储资源消耗降低90%以上;
- 最后是稳定性强,无需锁定全量知识库,更新过程中模型可正常提供服务,不会影响业务运行。
3. 无缝替换保障业务
有了变更检测和增量更新,已经可以实现数据的高效同步,但还存在一个关键问题:增量更新过程中,可能出现数据半截更新、新旧数据共存、检索错乱的情况,导致大模型临时输出异常内容。而无缝替换方案,就是为了解决更新过程中的业务波动问题,实现更新零感知、业务零中断、服务零异常。
无缝替换的核心逻辑并非"直接覆盖旧数据",而是采用双库切换、灰度替换的思路,这是企业生产环境的标准落地方案。
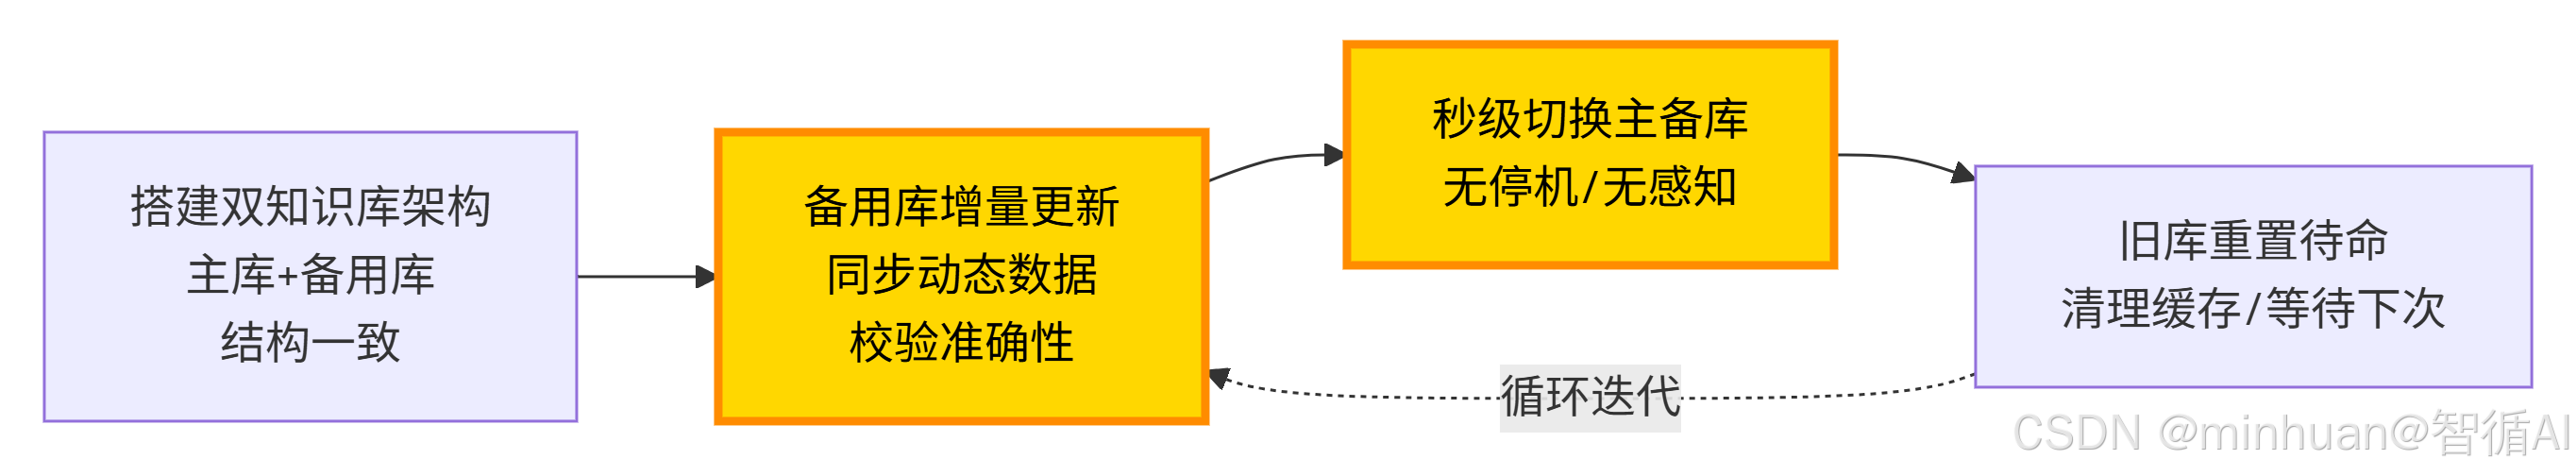
- 首先,搭建双知识库架构。系统同时维护两套结构完全一致的知识库,分别是主库和备用库。日常业务中,大模型仅调用主库数据提供服务,备用库处于闲置待命状态,不参与业务检索。
- 其次,备用库增量更新。当检测到业务数据变更后,所有增量更新操作全部在备用库完成,将最新的动态数据同步至备用库,完成数据校验、格式核验、准确性检测,确保备用库数据完全最新、无错误、无缺失。
- 然后,秒级切换主备库。备用库更新完成并校验通过后,系统通过路由切换,将大模型的检索数据源从旧主库,秒级切换为更新后的备用库。切换过程无需停机、无需重启服务,用户和业务系统完全无感知。
- 最后,旧库重置待命。切换完成后,原本的旧主库变为新的备用库,系统自动清理过期缓存、重置状态,等待下一次增量更新使用,形成循环迭代机制。
除了双库切换核心方案,无缝替换还配套两项细节保障:
-
- 灰度生效机制,针对核心业务、高敏感数据,可采用分批替换的方式,先覆盖部分测试流量,验证无误后再全量切换,彻底规避批量更新风险;
-
- 缓存预热机制,数据替换完成后,提前对高频检索数据进行缓存预热,避免切换初期检索速度变慢,保证模型响应速度稳定。
这套方案完美解决了传统更新模式的痛点,彻底实现数据实时同步和业务稳定运行的兼顾,是生产环境中最安全、最靠谱的落地方式。
四. 整体落地流程
1. 数据接入层
数据接入层是整个同步体系的入口,核心作用是统一采集、对接企业各类动态业务数据和静态基础数据,实现多源数据的统一入栈,为后续检测、更新、替换提供数据支撑。对于企业而言,业务数据来源十分分散,不同业务系统、不同数据库、不同存储载体的数据格式差异极大,接入层的核心就是解决多源数据兼容问题。
数据接入层主要适配四类数据源:
- 第一类是关系型数据库,包含MySQL、Oracle、PostgreSQL等企业核心业务数据库,存储结构化业务数据;
- 第二类是缓存数据,包含Redis、Memcached等实时缓存数据,适配高频变动的临时业务数据;
- 第三类是文档文件数据,包含PDF、Word、在线文档、网页资料等静态知识衍生数据;
- 第四类是业务接口数据,通过API接口对接CRM、ERP、商城中台等业务系统,实时拉取最新业务数据。
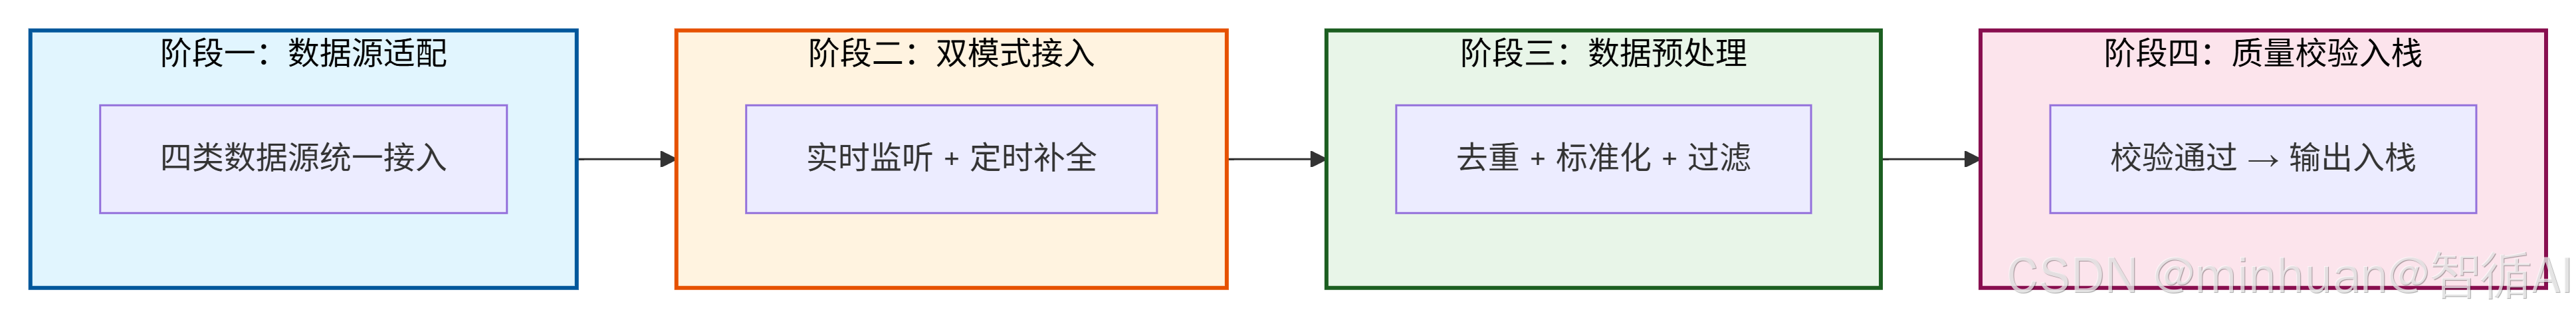
在接入逻辑上,采用"实时监听+定时补全"的双模式设计:
- 针对高频变动的核心业务数据,通过日志监听、接口推送的方式实现实时接入,秒级捕获数据变动;
- 针对低频变动的文档、规则类数据,采用定时轮询的方式接入,兼顾效率和资源消耗。
- 同时接入层自带数据去重、格式标准化、脏数据过滤功能,从源头保证入栈数据的质量,减少后续处理压力。
2. 同步处理层
同步处理层是整个体系的核心中枢,承接接入层的原始数据,完整执行变更检测、增量解析、数据预处理、更新指令生成全流程,是实现静态与动态数据同步的核心模块。该层完全对应前文讲解的三大核心技术方案,将理论逻辑转化为可落地的程序逻辑。
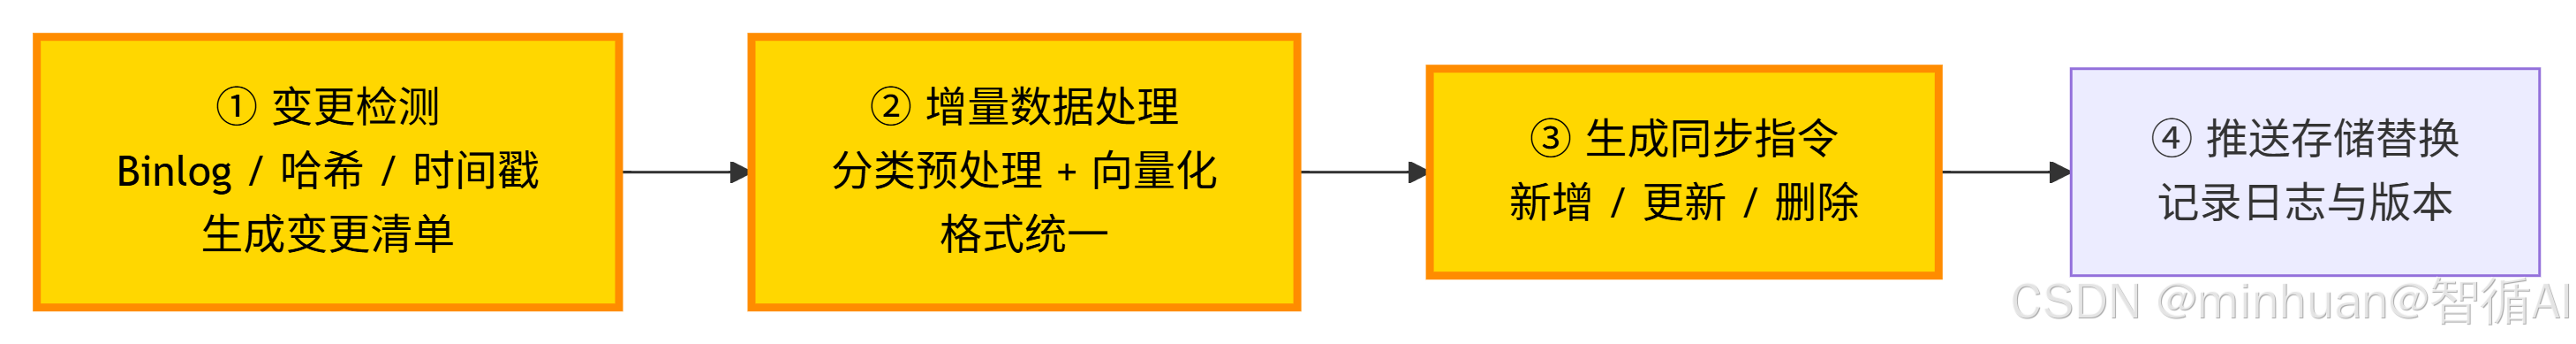
- 首先执行变更检测模块,根据不同数据源适配对应的检测规则,数据库数据采用Binlog日志检测,文档数据采用哈希校验,轻量化数据采用时间戳比对,精准筛选所有变动数据,生成变更清单,明确数据新增、修改、删除状态。
- 其次执行增量数据处理模块,对变更清单内的数据进行分类预处理,结构化数据规整字段、补全缺失信息,文本数据清洗切片、优化语义结构,随后调用嵌入模型生成最新向量数据,保证增量数据和原有知识库数据维度、格式统一。
- 最后生成同步执行指令,区分新增、更新、删除不同操作指令,推送至存储替换层,同时记录完整操作日志、更新版本信息,为数据回滚、问题排查、版本管理提供支撑。整个处理层全程自动化运行,无需人工干预,真正实现无人值守实时同步。
3. 存储替换层
存储替换层是数据落地、业务切换的最终载体,核心包含向量数据库、双知识库架构、路由切换模块,负责完成增量数据入库、新旧数据无缝替换、模型检索路由调度,保障数据落地稳定、业务运行无中断。
向量数据库是核心存储载体,主流选用FAISS、Pinecone等适配大模型的向量数据库,专门存储向量化后的知识库数据,支撑大模型快速语义检索。存储层严格区分静态基础数据和动态增量数据,静态数据长期留存、稳定存储,动态增量数据实时迭代、精准更新,两类数据融合统一,形成完整的大模型知识底座。
双知识库架构在此层落地实现,主库承载线上正式业务,备用库负责增量更新、数据校验,通过路由控制器实现秒级主备切换。同时搭配数据校验模块,每次替换完成后,自动抽样核验数据准确性、完整性,排查新旧数据冲突、数据缺失问题,确保替换质量。

此外,存储替换层自带缓存优化机制,对高频访问的业务数据、知识内容进行本地缓存,提升大模型检索响应速度,避免大量增量更新后出现接口卡顿、响应延迟的问题,兼顾数据实时性和服务高性能。
4. 模型服务层
模型服务层是最终的业务输出层,核心作用是让大模型基于同步后的最新完整知识库,为各类业务场景提供精准、实时的智能服务,是整个数据同步体系的价值落地端口。所有数据同步、更新、替换的操作,最终都是为了让模型输出贴合最新业务的内容。
该层核心包含检索服务、推理服务、业务适配三个模块:
- 检索服务负责从最新知识库中精准调取匹配的静态知识和动态业务数据,实现语义相似度匹配、精准内容召回;
- 推理服务基于召回的最新数据,完成智能问答、内容生成、业务决策、问题解答等核心能力输出;
- 业务适配模块针对不同场景微调输出逻辑,适配客服咨询、企业办公、电商导购、政务咨询等不同业务场景。
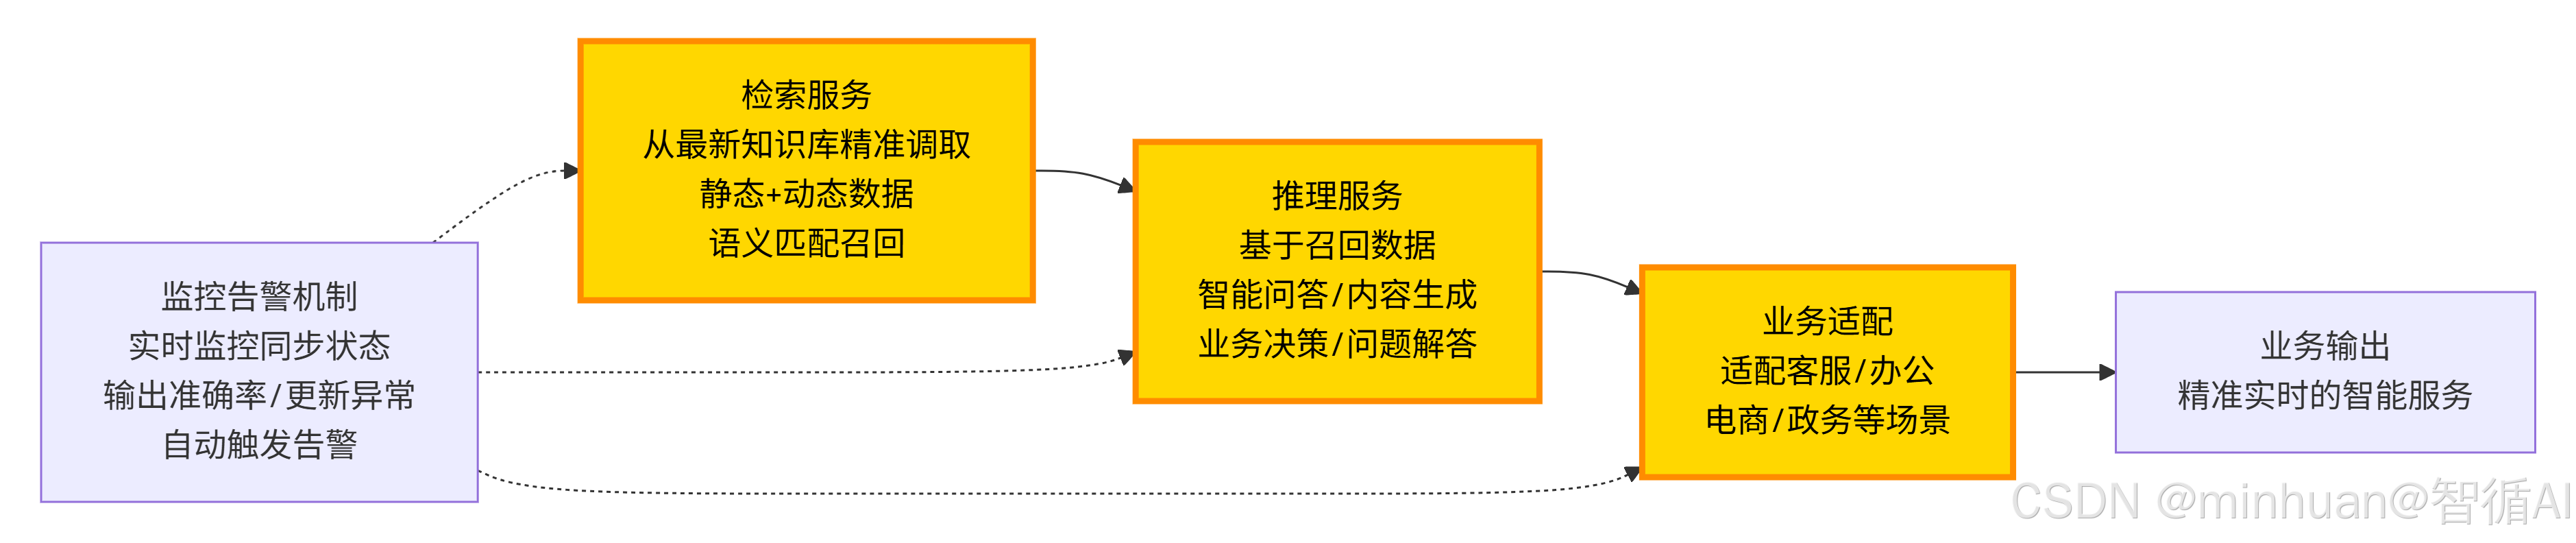
同时模型服务层配备监控告警机制,实时监控知识库同步状态、模型输出准确率、数据更新异常情况,一旦出现同步失败、数据错乱、模型输出异常,自动触发告警,及时排查问题,保障业务持续稳定运行。
五. 应用实践价值
1. 核心落地价值
通过静态知识库与动态业务数据实时同步方案,解决了行业内普遍存在的知识滞后、适配性差、落地不稳定的痛点,核心价值体现:
第一,彻底解决知识滞后问题,让大模型具备实时认知能力。
- 通过秒级、分钟级的增量同步,模型知识库可以和企业一线业务数据实时对齐,所有业务变动都能快速同步至模型底层;
- 彻底杜绝过时回答、错误输出,让大模型始终适配最新业务规则和数据状态。
第二,大幅降低运营和算力成本。
- 摒弃低效的全量更新模式,仅针对变动数据更新,算力资源消耗大幅降低;
- 同时实现自动化同步,无需人工定期维护知识库、手动更新数据,极大减少人工运营成本,让大模型运维更轻量化。
第三,保障业务7×24小时稳定运行。
- 依托双库无缝替换机制,数据更新全程无停机、无业务中断,彻底解决传统更新模式的服务卡顿、暂停问题;
- 适配企业全天候不间断的业务运转需求,提升大模型服务稳定性。
第四,拓宽大模型业务落地边界。
- 数据实时同步能力,让大模型不再局限于静态咨询、通用问答,可深度融入实时交易、动态审批、即时客服、智能决策等核心动态业务场景;
- 大幅提升大模型的业务赋能价值,真正实现智能化落地。
2. 实践问题总结
在落地数据同步方案过程中,通过碰到的一些误区,导致同步效果差、系统不稳定、业务出问题,做了一些记录总结。
- 第一,不要过度依赖全量更新。通常最容易犯的错误是图简单,直接定时全量刷新知识库,短期看似有效,但长期会造成算力浪费、业务波动、更新延迟,完全无法适配高频动态业务,必须优先采用增量更新方案。
- 第二,变更检测不要遗漏删除数据。多数人只关注新增和修改数据,忽略业务数据删除场景,导致知识库留存大量已失效的旧数据,模型依然会检索输出错误内容,检测逻辑必须覆盖增、改、删全场景。
- 第三,禁止更新后不做数据校验。增量更新、无缝替换完成后,必须进行数据抽样校验,很多格式错乱、向量维度不匹配、数据冲突的问题,都会在更新后出现,无校验直接上线会引发业务故障。
- 第四,避免新旧数据版本冲突。必须做好版本管理,留存历史快照,更新出错时可快速回滚,不要直接暴力覆盖旧数据,一旦出现更新异常,会导致知识库整体错乱无法恢复。
- 第五,不忽略缓存预热环节。很多团队完成数据替换后直接上线,导致初期检索速度慢、响应延迟,高频数据缓存预热是保障服务稳定性的关键细节,不可省略。
- 第六,杜绝多源数据接入混乱。多源数据接入时必须统一格式、统一主键、统一维度,否则会出现数据重复、检索错乱、匹配失败等问题,从源头规范数据格式是同步稳定的基础。
3. 应用场景适配
- 一是智能客服场景,适配商品价格、售后规则、活动政策、服务流程等高频变动数据的实时同步,保证客服问答内容实时准确。
- 二是企业智能办公场景,适配组织架构、审批流程、管理制度、岗位权责等内部业务数据的迭代更新,赋能企业内部智能办公。
- 三是电商交易场景,适配库存、价格、促销活动、物流规则等实时变动数据,支撑智能导购、订单咨询、售后答疑等业务。
- 四是政务、金融服务场景,适配政策更新、业务规则调整、合规要求变动等严谨数据的同步,保障服务合规、准确、权威。
六. 总结
总的来说,大模型静态知识库与动态业务数据的实时同步,解决的不是模型本身的能力问题,而是大模型落地最核心的"数据时效性"问题,我们实践过程中,先分清静态固定知识和动态业务数据的本质区别,找到数据不同步的核心痛点;再通过变更检测精准锁定变动数据,摒弃低效的全量更新,用增量更新实现轻量化、高效率迭代;最后通过双库无缝替换机制,解决更新过程的业务波动问题,实现零中断落地。搭配完整的四层架构,实现从数据接入、处理、存储到模型服务的端到端闭环。
整个过程不用一开始就追求复杂架构,可循序渐进落地:先实现基础的变更检测和增量更新,解决知识滞后核心问题;再迭代优化双库替换、版本管理、缓存预热等细节,逐步搭建稳定、高效的数据同步体系。在大模型产业落地愈发精细化的当下,模型算力、算法能力的差距正在缩小,而数据实时性、业务适配性,才是企业大模型落地的核心竞争力。做好静态知识与动态业务数据的实时同步,才能让大模型真正贴合业务、赋能业务,发挥出智能化工具的最大价值。
附录:完整应用示例
基于FAISS完整实现大模型知识库增量同步方案,依靠双FAISS索引搭建主备架构。通过时间戳 + 哈希完成业务数据变更检测,对新增、更新、删除记录做文本分块与向量化;增量数据先写入备用索引,校验无误后交换主备实现无缝切换。FAISS仅存储向量,文本、来源ID等元数据由代码自行维护,内置检索与RAG模拟调用,适合本地原型验证,生产环境需搭配数据库持久化元数据。
python
import hashlib
import time
import faiss
import numpy as np
from typing import List, Dict
from sentence_transformers import SentenceTransformer

# ====================== 全局配置 ======================
EMBEDDING_MODEL_NAME = "all-MiniLM-L6-v2"
DIM = 384  # all-MiniLM-L6-v2 向量维度

# FAISS 双索引:主库(线上检索)、备用库(增量更新)
main_index = faiss.IndexFlatL2(DIM)
standby_index = faiss.IndexFlatL2(DIM)

# 元数据管理:FAISS本身不支持存储文本、自定义字段,需手动维护
main_meta: List[Dict] = []
standby_meta: List[Dict] = []
# source_id映射:业务文档ID -> 对应向量片段下标列表
main_id_map: Dict[int, List[int]] = {}
standby_id_map: Dict[int, List[int]] = {}

# 加载Embedding模型
embed_model = SentenceTransformer(EMBEDDING_MODEL_NAME)

# ====================== 1. 变更检测模块 ======================
def calc_text_hash(text: str) -> str:
    """文档文本哈希,用于检测文档内容改动"""
    return hashlib.sha256(text.encode("utf-8")).hexdigest()

def poll_business_data() -> List[Dict]:
    """
    模拟业务数据源拉取
    生产环境替换为 Canal / Debezium 消费MySQL Binlog,实时捕获增/改/删事件
    """
    mock_biz_records = [
        {"id": 1, "content": "旧产品价格:99元", "update_ts": 1750000000, "op_type": "delete"},
        {"id": 2, "content": "新产品价格:129元,限时活动", "update_ts": 1750000010, "op_type": "add"},
        {"id": 3, "content": "售后政策:7天无理由退换,不包含定制商品", "update_ts": 1750000020, "op_type": "update"},
    ]
    return mock_biz_records

def detect_changed_records(last_sync_ts: int) -> List[Dict]:
    """时间戳+哈希双重校验,筛选发生变更的业务记录"""
    records = poll_business_data()
    changed_records = []
    for record in records:
        if record["update_ts"] > last_sync_ts:
            record["hash"] = calc_text_hash(record["content"])
            changed_records.append(record)
    return changed_records

# ====================== 2. 文本分块 & 向量化预处理 ======================
def split_text_chunk(text: str, chunk_size=128, overlap=20) -> List[str]:
    """RAG文本切片,带重叠窗口"""
    chunks = []
    start = 0
    while start < len(text):
        end = start + chunk_size
        chunk = text[start:end]
        chunks.append(chunk)
        start += (chunk_size - overlap)
    return chunks

def embed_texts(texts: List[str]) -> np.ndarray:
    """批量生成向量并归一化,适配FAISS L2检索"""
    embeddings = embed_model.encode(texts, convert_to_numpy=True)
    faiss.normalize_L2(embeddings)
    return embeddings

def prepare_increment_data(changed_records: List[Dict]) -> List[Dict]:
    """对变更记录做分块、向量化,组装增量数据结构"""
    increment_data = []
    for rec in changed_records:
        chunks = split_text_chunk(rec["content"])
        vecs = embed_texts(chunks)
        for idx, chunk in enumerate(chunks):
            increment_data.append({
                "source_id": rec["id"],
                "text": chunk,
                "vector": vecs[idx],
                "hash": rec["hash"],
                "op_type": rec["op_type"]
            })
    return increment_data

# ====================== 3. FAISS备用库增量写入、删除逻辑 ======================
def clear_standby_index():
    """清空备用索引与元数据,准备新一轮增量更新"""
    global standby_index, standby_meta, standby_id_map
    standby_index = faiss.IndexFlatL2(DIM)
    standby_meta = []
    standby_id_map = {}

def add_to_standby(vector: np.ndarray, source_id: int, text: str, hash_val: str):
    """新增单条向量片段至备用库"""
    standby_index.add(np.expand_dims(vector, axis=0))
    current_idx = standby_index.ntotal - 1
    standby_meta.append({
        "idx": current_idx,
        "source_id": source_id,
        "text": text,
        "hash": hash_val
    })
    standby_id_map.setdefault(source_id, []).append(current_idx)

def delete_from_standby_by_source_id(source_id: int):
    """删除备用库中该业务source_id对应的全部文本片段"""
    if source_id not in standby_id_map:
        return
    # 获取所有下标,逆序删除避免下标偏移
    del_index_list = sorted(standby_id_map[source_id], reverse=True)
    for idx in del_index_list:
        standby_index.remove_ids(np.array([idx], dtype=np.int64))
        del standby_meta[idx]
    # 删除后重建元数据下标
    rebuild_standby_meta()
    del standby_id_map[source_id]

def rebuild_standby_meta():
    """删除向量后,同步刷新元数据的下标索引"""
    for new_idx, meta_item in enumerate(standby_meta):
        meta_item["idx"] = new_idx

def write_increment_to_standby(increment_data: List[Dict]):
    """批量执行增量操作:先删旧数据,再新增更新片段"""
    clear_standby_index()
    for item in increment_data:
        if item["op_type"] == "delete":
            delete_from_standby_by_source_id(item["source_id"])
        else:
            add_to_standby(item["vector"], item["source_id"], item["text"], item["hash"])
    print(f"✅ 备用库增量写入完成,向量总数:{standby_index.ntotal}")

def validate_standby() -> bool:
    """简易校验备用索引是否写入成功"""
    if standby_index.ntotal > 0:
        print("✅ 备用库数据校验通过")
        return True
    print("❌ 备用库为空,校验失败,禁止切换主备")
    return False

# ====================== 4. 路由控制器:主备无缝切换 + 检索 ======================
class KnowledgeRouter:
    def __init__(self):
        self.index_main = main_index
        self.index_standby = standby_index
        self.meta_main = main_meta
        self.meta_standby = standby_meta

    def switch_main_standby(self):
        """主备库交换,实现无缝切换;交换索引与元数据"""
        self.index_main, self.index_standby = self.index_standby, self.index_main
        self.meta_main, self.meta_standby = self.meta_standby, self.meta_main
        print("🔁 FAISS主备知识库切换完成,新主库上线")

    def search(self, query: str, top_k: int = 3) -> List[Dict]:
        """基于当前主库做向量检索,返回文本与距离"""
        query_vec = embed_texts([query])
        distances, indices = self.index_main.search(query_vec, top_k)
        result_list = []
        for idx, dist in zip(indices[0], distances[0]):
            if 0 <= idx < len(self.meta_main):
                result_list.append({
                    "text": self.meta_main[idx]["text"],
                    "distance": float(dist)
                })
        return result_list

# ====================== 5. 完整同步流水线入口 ======================
def run_sync_pipeline(last_sync_timestamp: int) -> int:
    print("==== FAISS知识库增量同步流水线启动 ====")
    # Step1:变更检测
    changed_records = detect_changed_records(last_sync_timestamp)
    if not changed_records:
        print("✅ 未检测到业务变更,无需同步")
        return last_sync_timestamp
    print(f"🔍 检测到 {len(changed_records)} 条业务变更记录")

    # Step2:预处理、分块、向量化
    increment_data = prepare_increment_data(changed_records)

    # Step3:写入备用知识库
    write_increment_to_standby(increment_data)

    # Step4:校验备用库,校验失败直接终止,不切换
    if not validate_standby():
        raise RuntimeError("备用知识库校验失败,终止同步流程!")

    # Step5:主备无缝切换
    router = KnowledgeRouter()
    router.switch_main_standby()

    # Step6:检索测试
    test_query = "产品价格是多少?"
    search_result = router.search(test_query)
    print(f"\n🔎 检索测试,用户问题:{test_query}")
    for res in search_result:
        print(f"召回文本:{res['text']},距离分数:{res['distance']:.4f}")

    # 更新同步时间戳,作为下一轮变更检测基准
    new_sync_ts = int(time.time())
    print(f"\n✅ 本轮增量同步全部完成,同步时间戳更新为 {new_sync_ts}")
    return new_sync_ts

# ====================== 配套RAG调用示例 ======================
def llm_rag_answer(question: str, router: KnowledgeRouter):
    # 召回知识库上下文
    search_result = router.search(question, top_k=3)
    context = "\n".join([item["text"] for item in search_result])
    prompt = f"""基于提供的知识库内容回答用户问题,只使用上下文信息。
【知识库上下文】
{context}
用户问题:{question}
"""
    # 此处替换为真实大模型调用(Ollama/OpenAI等)
    return f"【模拟大模型回答】\nPrompt:\n{prompt}"

if __name__ == "__main__":
    last_ts = 1750000000
    last_ts = run_sync_pipeline(last_ts)
    # RAG问答测试
    router = KnowledgeRouter()
    ans = llm_rag_answer("售后包含定制商品吗?", router)
    print("\nRAG问答结果:")
    print(ans)