最近OpenAI的GPT-6 Astra上线后被它的Computer Use功能惊艳到了,在被惊艳的同时我也在想它到底是怎么实现的。带着这份好奇我让我的智能体助手帮我收集整理了Computer Use的底层实现机制,看看各大厂商的Computer Use的功能中动作靠什么表达、模型凭什么"看图操作"、安全怎么兜底,以及它和浏览器 Agent、GUI grounding 模型这些相邻路线的区别。分析来源于公开信息以及AI的整理,与厂商的实际实现可能存在差距,仅用于自己做智能体基建时的参考。
一、Computer Use 在解决什么问题
Computer Use 的定义很直接:LLM/VLM 智能体不依赖操作系统或网站的专用 API,而是通过"屏幕感知 + 虚拟键鼠动作",像人一样直接与 GUI 交互。 OpenAI, Anthropic, Google 都有相关产品,三家厂商的产品形态虽各不相同,但底层共享同一个范式------观察-思考-行动闭环(Observe-Think-Act Loop):
- 观察(Perception):采集屏幕状态,可能是截图,也可能是结构化的元素树;
- 思考(Reasoning):多模态模型推理下一步该做什么,通常带 Chain-of-Thought 或自适应思考;
- 行动(Action):输出点击/输入/滚动/拖拽等指令,由客户端执行器在沙箱里落实;
- 闭环:执行后重新采集状态,循环往复,直到任务完成或需要人工介入。
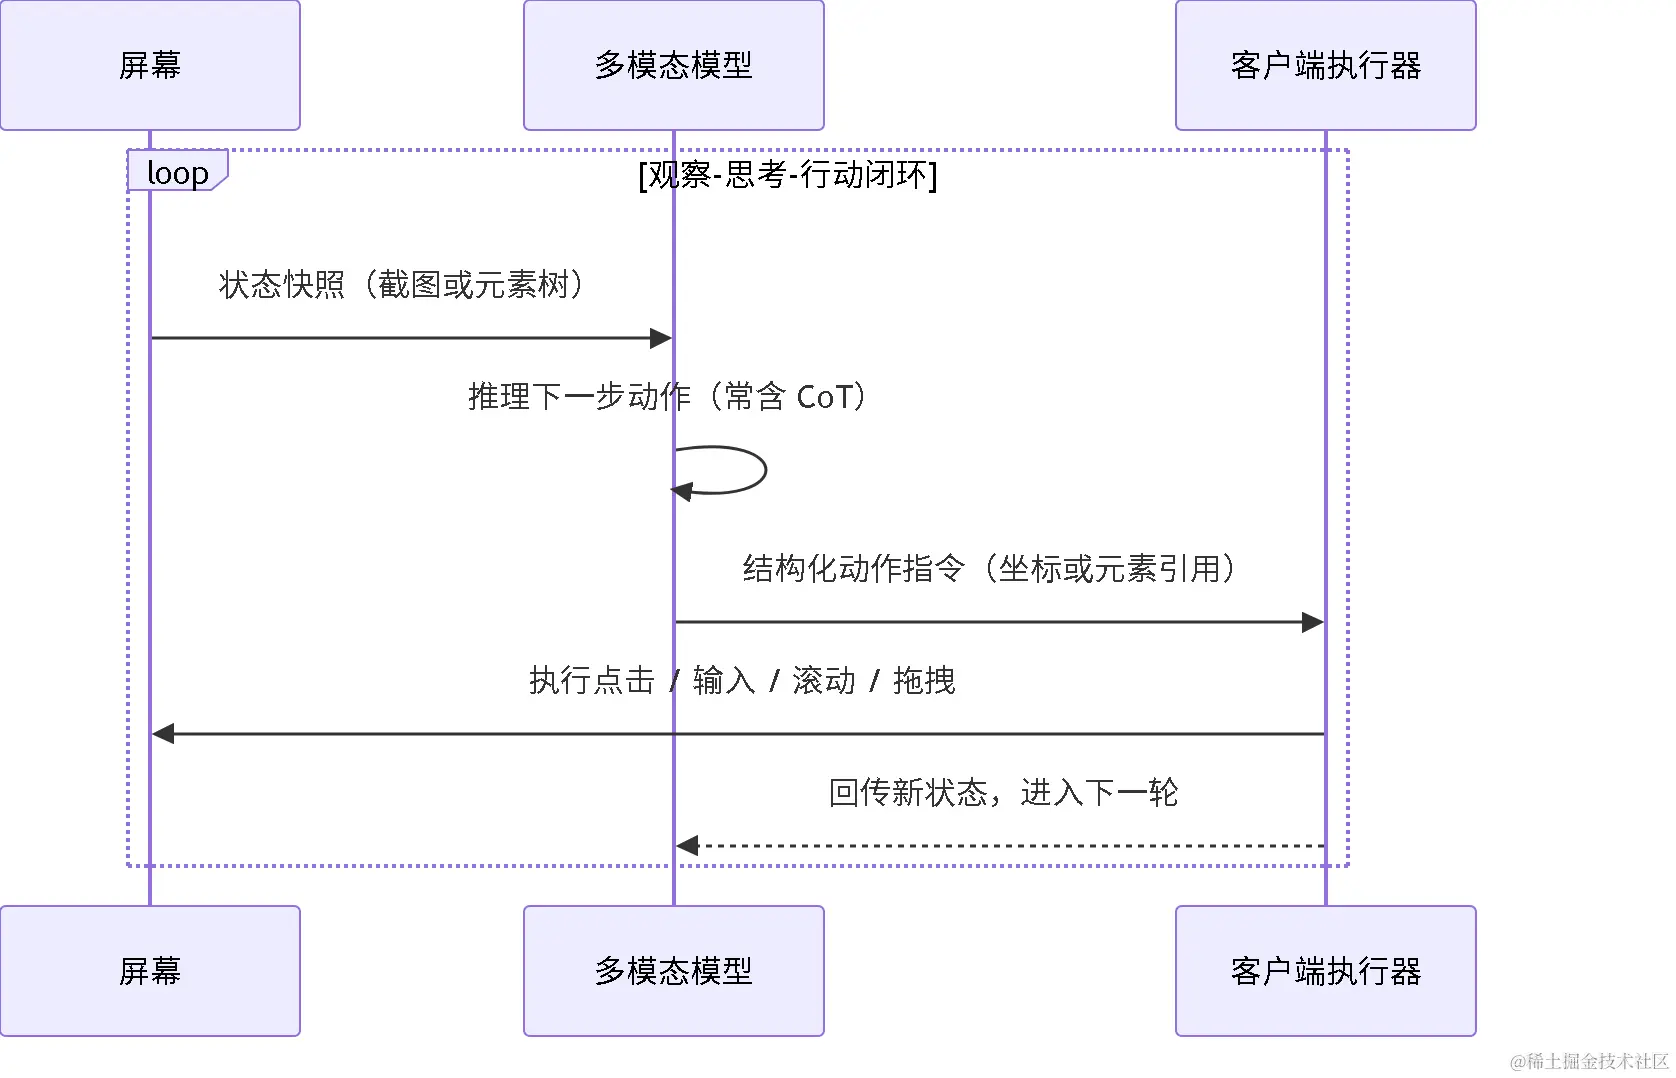
这个闭环看似统一,真正的分野在两个点:感知通道 (像素 vs 元素树 vs 混合)和动作空间(坐标 vs 元素引用)。后文所有方案的差异,都可以归结到这两根轴上的选择。
二、三大厂商的方案是怎么落地这个闭环的
2.1 OpenAI:从 Operator / CUA 到 GPT-6 Astra Computer Use
OpenAI 的 Computer Use 从 2025 年初到现在迭代了好几轮,网上大量文章还在引用旧形态,容易过时。先用一张时间表看一下演进线(据 OpenAI 发布页与帮助中心整理):
| 时间 | 事件 |
|---|---|
| 2025-01 | Operator 研究预览发布,由 CUA(Computer-Using Agent)模型驱动:纯像素截图 + 虚拟浏览器,仅美国 Pro 用户可用 |
| 2025-07 | Operator 并入 ChatGPT agent("Agent Mode"),合并远程浏览器 + Deep Research + 对话;独立站点预告下线 |
| 2025-08 | 独立 Operator 站点关停,operator.chatgpt.com 重定向至 chatgpt.com |
| 2025-10 | ChatGPT Atlas 浏览器发布,将派生能力嵌入完整浏览器 |
| 2026-07 | ChatGPT Work 推出,统一桌面应用(Chat / Work / Codex),Atlas 浏览器进入 30 天退场期 |
| 2026-08(上旬) | 旧 ChatGPT agent(Agent Mode)退役,官方指引改为"用 ChatGPT Work 处理长任务、用 cloud browser 处理浏览器工作流" |
| 2026-09-03 | GPT-6 Astra 发布 ,Computer Use 代际跃迁,API 名 gpt-6-astra |
一句话结论:Operator 与旧 Agent Mode 均已停用。 当前 OpenAI Computer Use 的官方形态是 GPT-6 Astra 的模型内置 computer_use 工具 ------消费/工作端入口是 ChatGPT Work / Codex 桌面应用,开发者入口是 Responses API 的 computer_use 工具。
历史基线:CUA / Operator(2025-01,已停用)
作为理解 OpenAI 技术路线的起点,当年的机制也值得看一下:
- 模型:Computer-Using Agent(CUA),基于 GPT-4o 视觉栈训练,叠加强化学习(RL)高级推理;
- 感知:纯原始像素截图(raw pixel data),官方评估文档明确说明不解析 DOM、也不解析 Accessibility Tree;
- 动作空间:坐标式虚拟鼠标/键盘------点击、滚动、输入;
- 闭环:感知-推理-行动迭代,敏感动作(登录、CAPTCHA)触发 Takeover Mode 用户接管;
- 训练:阶段一 SFT 教基础 GUI 感知与定位,阶段二 RL 给推理与纠错能力(Operator System Card 披露);
- 基准:OSWorld 38.1%、WebArena 58.1%、WebVoyager 87%(发布时 SOTA)。
现役核心:GPT-6 Astra Computer Use(2026-09-03 起)
- 模型内置能力 :
computer_use是 GPT-6 Astra 在 Responses API 下的原生内置工具,与web_search、file_search、code_interpreter、hosted_shell、mcp等并列;模型 IDgpt-6-astra; - 感知通道 :仍以截图为核心,并结合其他工具结果(tool results)决策下一步。developer 文档原话:"The model uses screenshots and other tool results to decide what to do next."------没有宣称改用 DOM / Accessibility Tree,视觉截图依然是主感知,这点和 CUA 一脉相承;
- 新增 code execution 混合路线(官方推荐的集成形态) :模型先生成操作脚本(如 PyAutoGUI / Playwright),由执行环境执行并把截图与输出回传,会话状态跨调用保持。脚本可以把多步动作、循环、条件逻辑压缩进单次调用------这是与 CUA"每步一个坐标动作"最大的工程差异;
- 原生 computer 工具保留 :
click/type/scroll等结构化坐标动作仍作替代方案存在,由应用层翻译为浏览器或桌面输入; - 闭环增强 :在 Observe-Think-Act 基础上新增异步工具调用(Async tool calling)与中途转向(Mid-turn steering,经 WebSocket)------模型可在工具执行期间继续推理其他部分,也能接受用户中途修正;
- 上下文与视觉精度 :1,050,000 token 上下文、128,000 max output,支持跨窗口笔记检索、避免重复摘要;computer use 截图官方建议用
detail: "original"以保留坐标精度; - 推理控制:reasoning effort 分 low / medium / high / xhigh / max 五档,作用与 Claude 的 adaptive thinking 类似;
- 训练:属于 reasoning model,经强化学习训练推理,并针对专业办公环境做定向训练;OpenAI 未公开全部训练管线细节。
基准成绩(据 OpenAI 官方发布页对比表)
| 基准 | GPT-6 Astra | GPT-5.6 Sol(对照) | 历史 CUA |
|---|---|---|---|
| OSWorld(2.0) | 72.6%(约 40 分钟/任务) | 65.7% | 38.1%(旧版 OSWorld) |
| ScreenSpot-Pro(no tools) | 92.7% | 76.9% | --- |
| AutomationBench | 41.4% | 18.1% | --- |
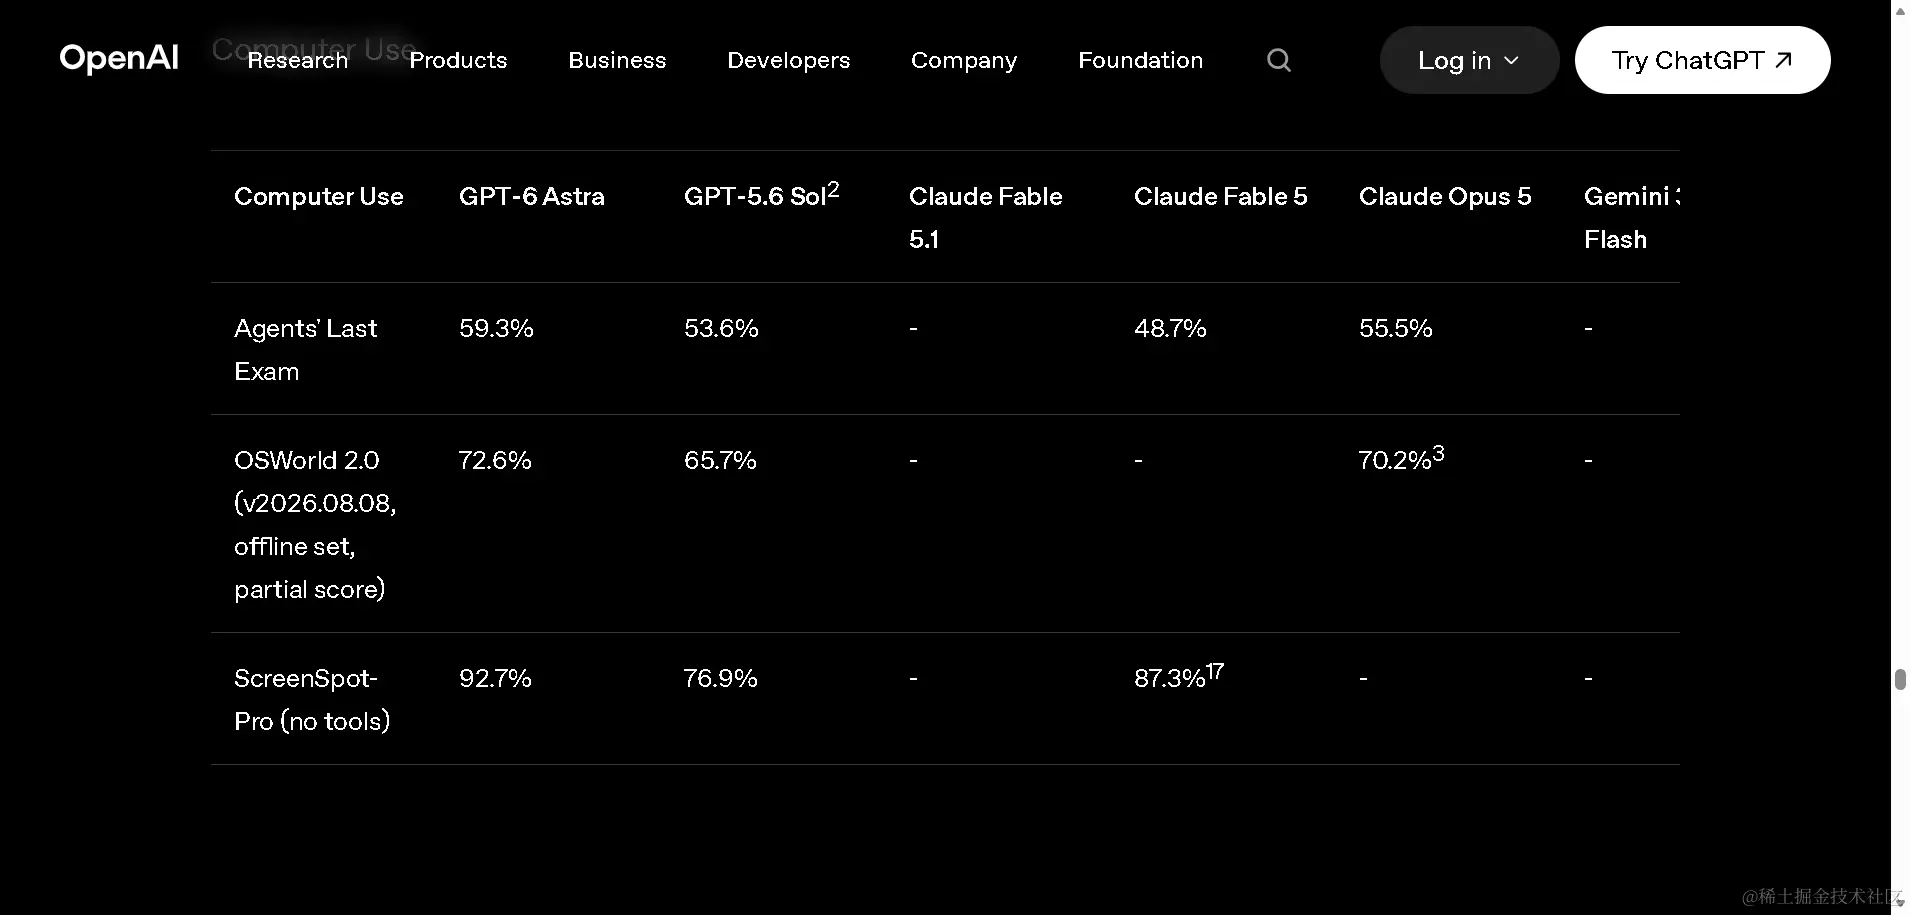
上图截自 GPT-6 Astra 官方发布页(openai.com/index/gpt-6-astra)的 Computer Use 基准对比表。
安全机制(据 GPT-6 Astra System Card 与 Safety overview 披露)
Computer Use 把风险从"回答层面跑偏"升级成"直接动你的桌面和文件",因此 OpenAI 在执行链路上挂了护栏,并有实测数据支撑(跨厂商共性的沙箱 / 人工确认 / 注入检测见 §5):
- 实时看守:外部部署的所有工具调用推理均被异步监控,命中即暂停任务(生产)或直接停止对话(API)------这是唯一真正"卡在执行链路上"的机制;
- 有效性证据:注入抗性按两套口径均有提升------OpenAI 内部间接注入评估的防御方成功率 96.23% → 99.79%,Gray Swan IPI Arena 的攻击成功率 27.0% → 8.5%(一为防御成功率、一为攻击成功率,不可互推);移除生产护栏后越权率从 Sol 的 48% 降到 0%,计算机操作安全压力测试不符预期结果 2.4%(Claude Fable 5.1 9.5% / Opus 5 11.5%);
- 一个必须点出的退化信号:上述监控依赖"能读模型推理",而 Astra 的 chain-of-thought 可监控性较前代下降,对抗条件下可能用 sandbagging 规避------对"每步都有真实副作用"的 Computer Use,这是明确风险。
参考来源:GPT-6 Astra 发布页、GPT-6 Astra System Card(Deployment Safety Hub)、Safety overview: GPT-6 Astra、开发者文档模型页、Computer use 工具指南、Operator 原始发布页、ChatGPT agent 发布说明(完整链接见文末"主要出处 · OpenAI")。
2.1.1 ChatGPT 桌面应用中的 Computer Use 插件:本机 GUI 的本地控制层
上文讲的是 Responses API 侧的原生工具,消费端还有一个与它并列、但不同层 的形态:ChatGPT 桌面应用里的 Computer Use 插件。它不是又一个 API 工具,而是桌面 agent 的本地控制层------安装在 ChatGPT Work / Codex 视图下,通过 macOS 或 Windows 的系统权限,让模型直接接管你本机的 GUI。OpenAI developer 文档的原话是:"Let ChatGPT use desktop apps while it works." "With Computer Use, ChatGPT can see and operate graphical user interfaces on macOS or Windows."
入口与启用
- 入口:ChatGPT 桌面应用 → 切换器选 Work 或 Codex → Plugins > Computer Use → Install plugin / Enable → 打开 Computer Use server 与 skill 开关 → Try now;
- 系统权限:macOS 需要
Screen Recording(看屏幕)+Accessibility(点击 / 输入 / 导航),二者缺一不可;Windows 无需这两项,但目标应用必须保持在活动桌面可见,模型才会去操作; - 应用审批:设置 → Computer use 查看权限,可配置
Always-allowed apps与应用白名单,首次操作某 App 会弹权限确认; - 启动方式:prompt 里用
@Computer或@AppName(如@Chrome)显式点名,或直接说"用 Computer Use"。
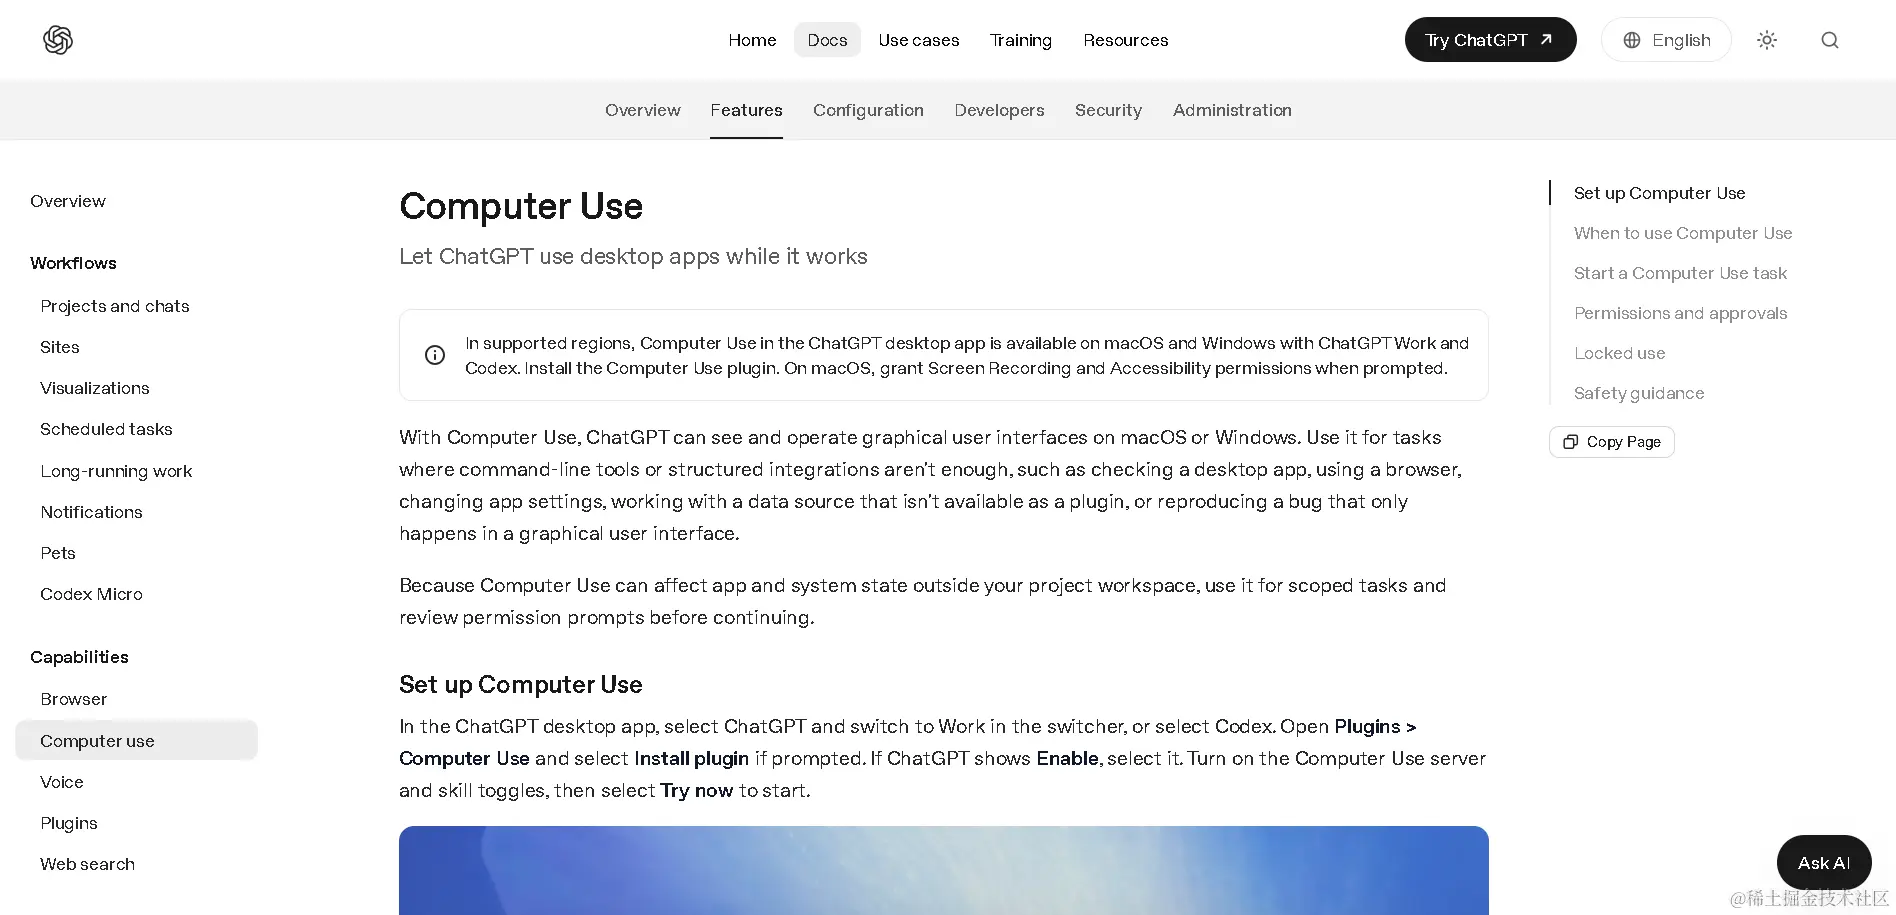
上图截自 OpenAI developer 文档的桌面 Computer Use 页面(原地址 developers.openai.com/codex/app/computer-use,现 302 迁移至 learn.chatgpt.com/docs/computer-use)。
能力边界与运行机制(据 OpenAI developer 文档整理)
| 维度 | 说明 |
|---|---|
| 适用场景 | 命令行 / 结构化集成不够用时:测桌面 App、用浏览器、改 App 设置、接无插件的数据源、复现仅 GUI 才出现的 bug |
| macOS | 可在后台运行(独立虚拟光标),你还能一边做别的事;支持 locked use(锁屏后继续) |
| Windows | 前台工作,会接管鼠标键盘;官方建议用 VM 或手机远程盯进度 |
| 细粒度控制 | 已连 Chrome / Excel / PowerPoint 的专用插件或扩展可获得"额外控制"(如 Chrome 扩展、Excel 加载项) |
| 限制 | 不能控制 Terminal、不能控制 ChatGPT 自身、不能批准系统管理员请求;敏感 / 破坏性行为前需用户确认 |
| 配额 | 消耗 Work/Codex 配额(而非普通 Chat 配额,据 OpenAI 用量帮助页);Astra 与 Sol 的相对消耗速率官方未公布 |
与 API 侧 computer_use 工具的关系 :桌面插件本质是消费端开箱即用的封装,底层仍由 Astra 驱动,把 API 的 computer_use 闭环包成"桌面 agent 体验 + 系统级权限管理 + 应用白名单"。OpenAI 官方建议也很明确:目标 App 若有专用插件 / MCP server,优先用结构化集成;只有"必须视觉操作 GUI"时才用 Computer Use 兜底。
2.1.2 Responses API computer_use 接口设计
API 侧是开发者的主战场。先澄清接口演进,避免文章过时:早期的 computer_use_preview / computer-use-preview 模型(2025 年初 Operator 研究预览)已被淘汰,现 GA 的是 type: "computer" 原生内置工具,可配 gpt-5.4、gpt-5.6-sol、gpt-6-astra 等模型。changelog(2026-09-03)明确:Astra 的 tool calling 仅走 Responses API,Chat Completions 不支持工具调用(需迁移)。
三种集成路径(据官方 tools-computer-use 指南)
| 路径 | 工具形态 | 适用 |
|---|---|---|
| Option 1:内置 computer loop | tools:[{type:"computer"}],模型返回结构化动作(click / type / scroll / ...) |
纯视觉 UI 自动化 |
| Option 2:自定义 harness | 用 Playwright / Selenium / VNC / MCP 驱动 | 已有 harness,想让模型走普通 tool calling |
| Option 3:code execution | 模型写脚本(PyAutoGUI / Playwright)跑沙箱 | 官方对 GPT-6 Astra 推荐;混合 DOM / 视觉 |
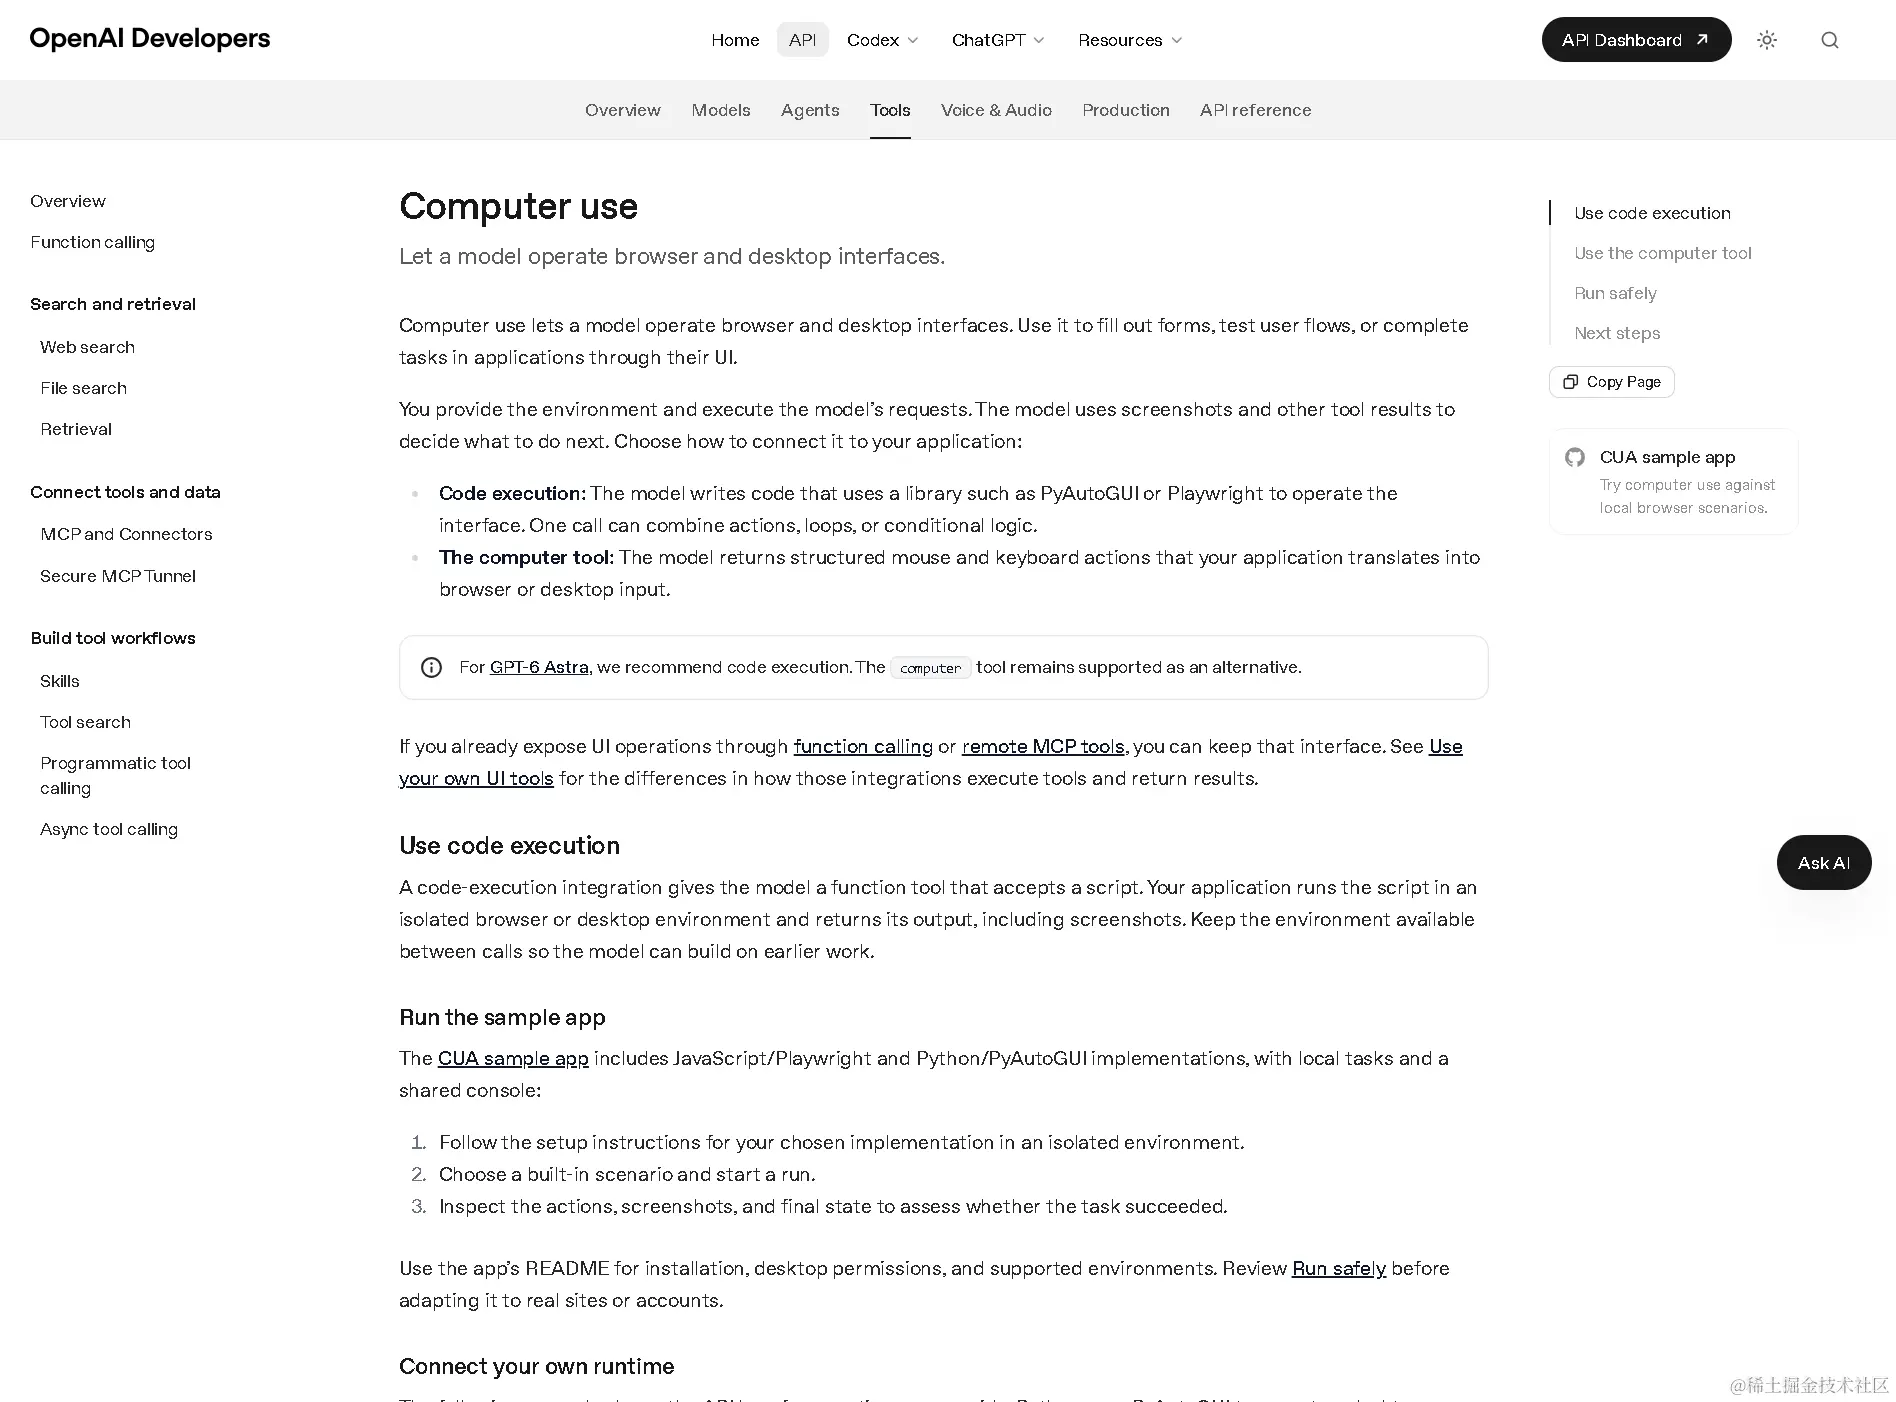
上图截自 platform.openai.com/docs/guides/tools-computer-use 官方指南页首屏,本节接口设计均以该指南为依据。
首请求
json
{
  "model": "gpt-6-astra",
  "tools": [{ "type": "computer" }],
  "reasoning": { "effort": "medium" },
  "input": "检查 Filters 面板是否打开;如果没打开就点击 'Show filters',然后在搜索框输入 penguin。使用 computer 工具完成对界面的操作。"
}
模型返回 computer_call
json
{
  "output": [{
    "type": "computer_call",
    "call_id": "call_abc123",
    "actions": [
      { "type": "click", "button": "left", "x": 135, "y": 193 },
      { "type": "type", "text": "penguin" }
    ],
    "pending_safety_checks": [],
    "status": "completed"
  }]
}
注意:
status:"completed"只表示模型生成完了这个调用,不代表你已经执行、网站已接受、任务已成功。
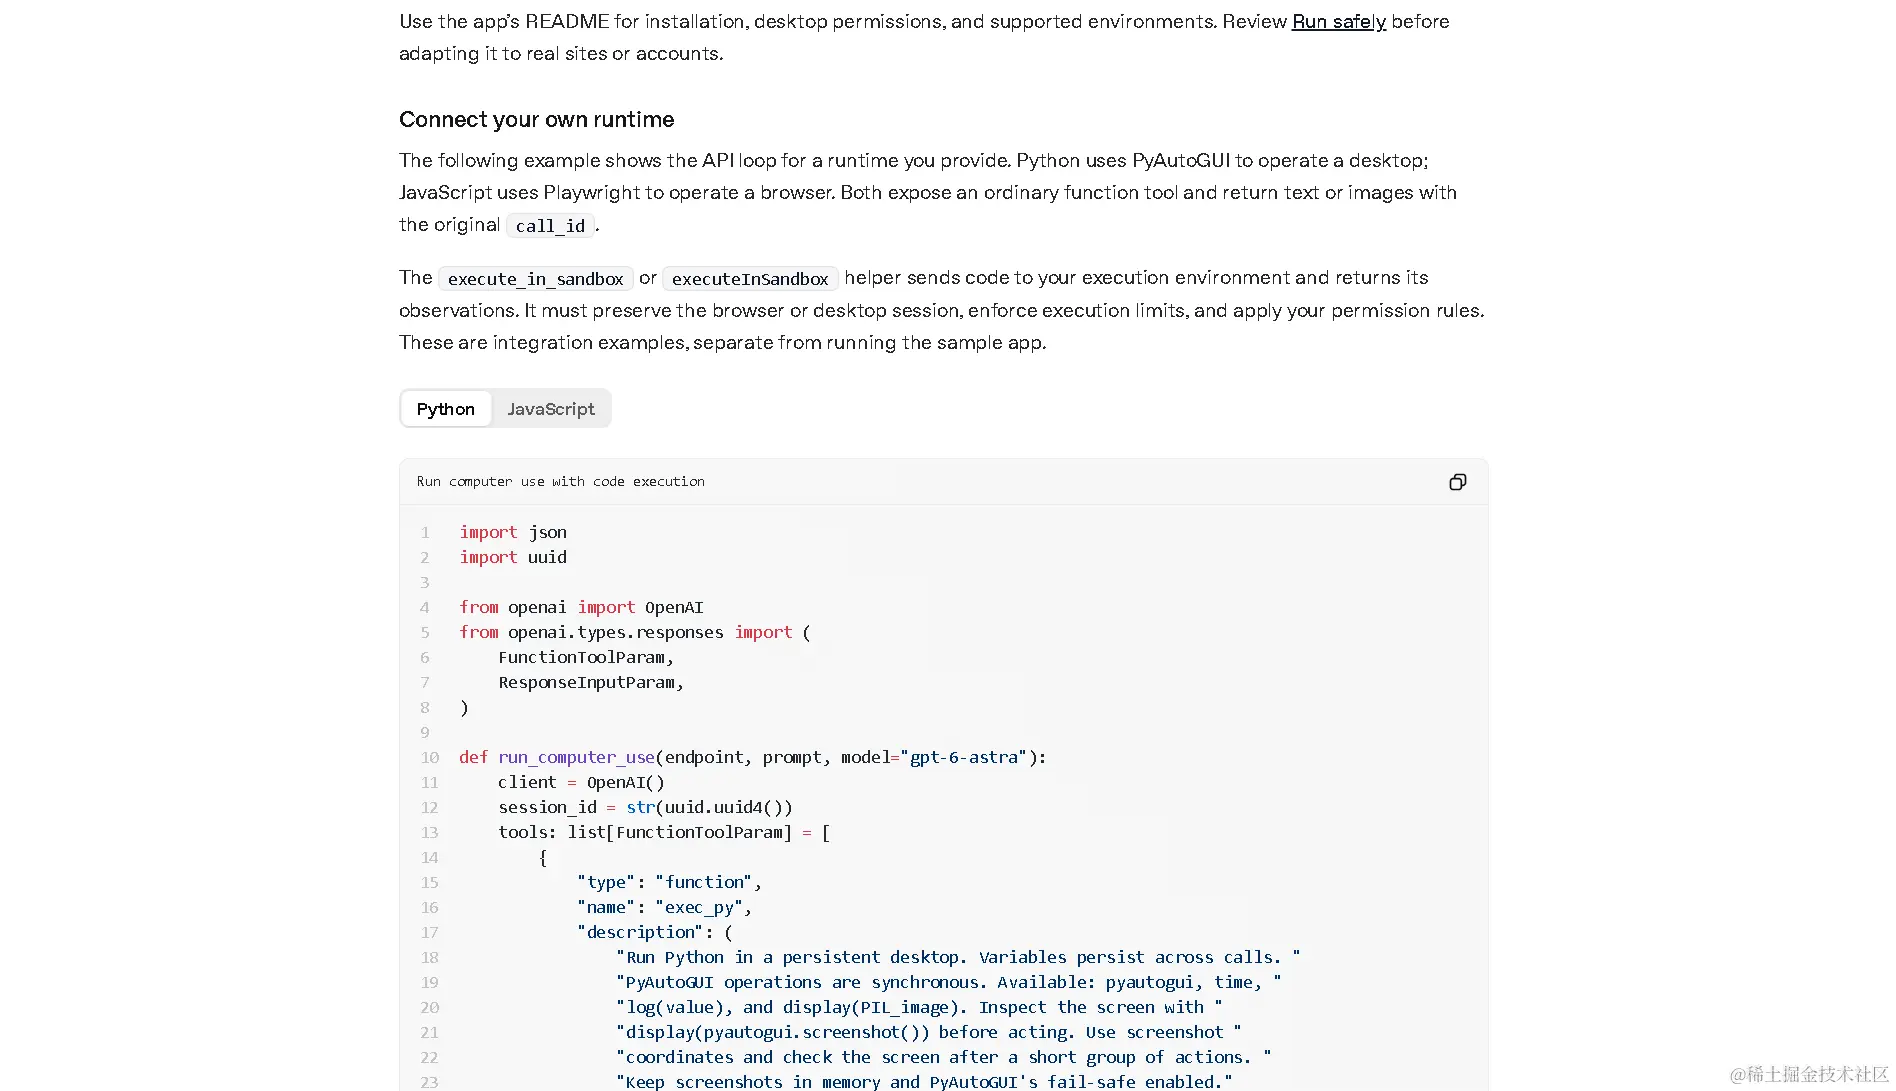
上图截自官方指南页的接入代码段(tools 定义与动作处理),即上文 computer_call 动作结构的原始出处。
闭环下一步:执行动作 → 截图 → 回传
json
{
  "model": "gpt-6-astra",
  "tools": [{ "type": "computer" }],
  "previous_response_id": "resp_xxx",
  "input": [{
    "type": "computer_call_output",
    "call_id": "call_abc123",
    "acknowledged_safety_checks": [],
    "output": {
      "type": "computer_screenshot",
      "image_url": "data:image/png;base64,<screenshot>",
      "detail": "original"
    }
  }]
}- 循环终止条件:response 里不再出现
computer_call,模型回落到文本回复; previous_response_id维持会话状态(不含 cookie / 登录态 / JS 变量 / 桌面状态,环境重启需显式报告丢失);- 截图
detail:"original"是官方强推(保留坐标几何精度);大图耗 token、超image上限会失败,降采样时须把坐标映射回真实视口; - 安全字段:
pending_safety_checks(malicious_instructions / irrelevant_domain / sensitive_domain)需以acknowledged_safety_checks回传确认才继续(注:该字段约定在新版主指南中已弱化,完整 JSON 定义现仅保留在 Azure OpenAI classic 文档中,见文末出处);
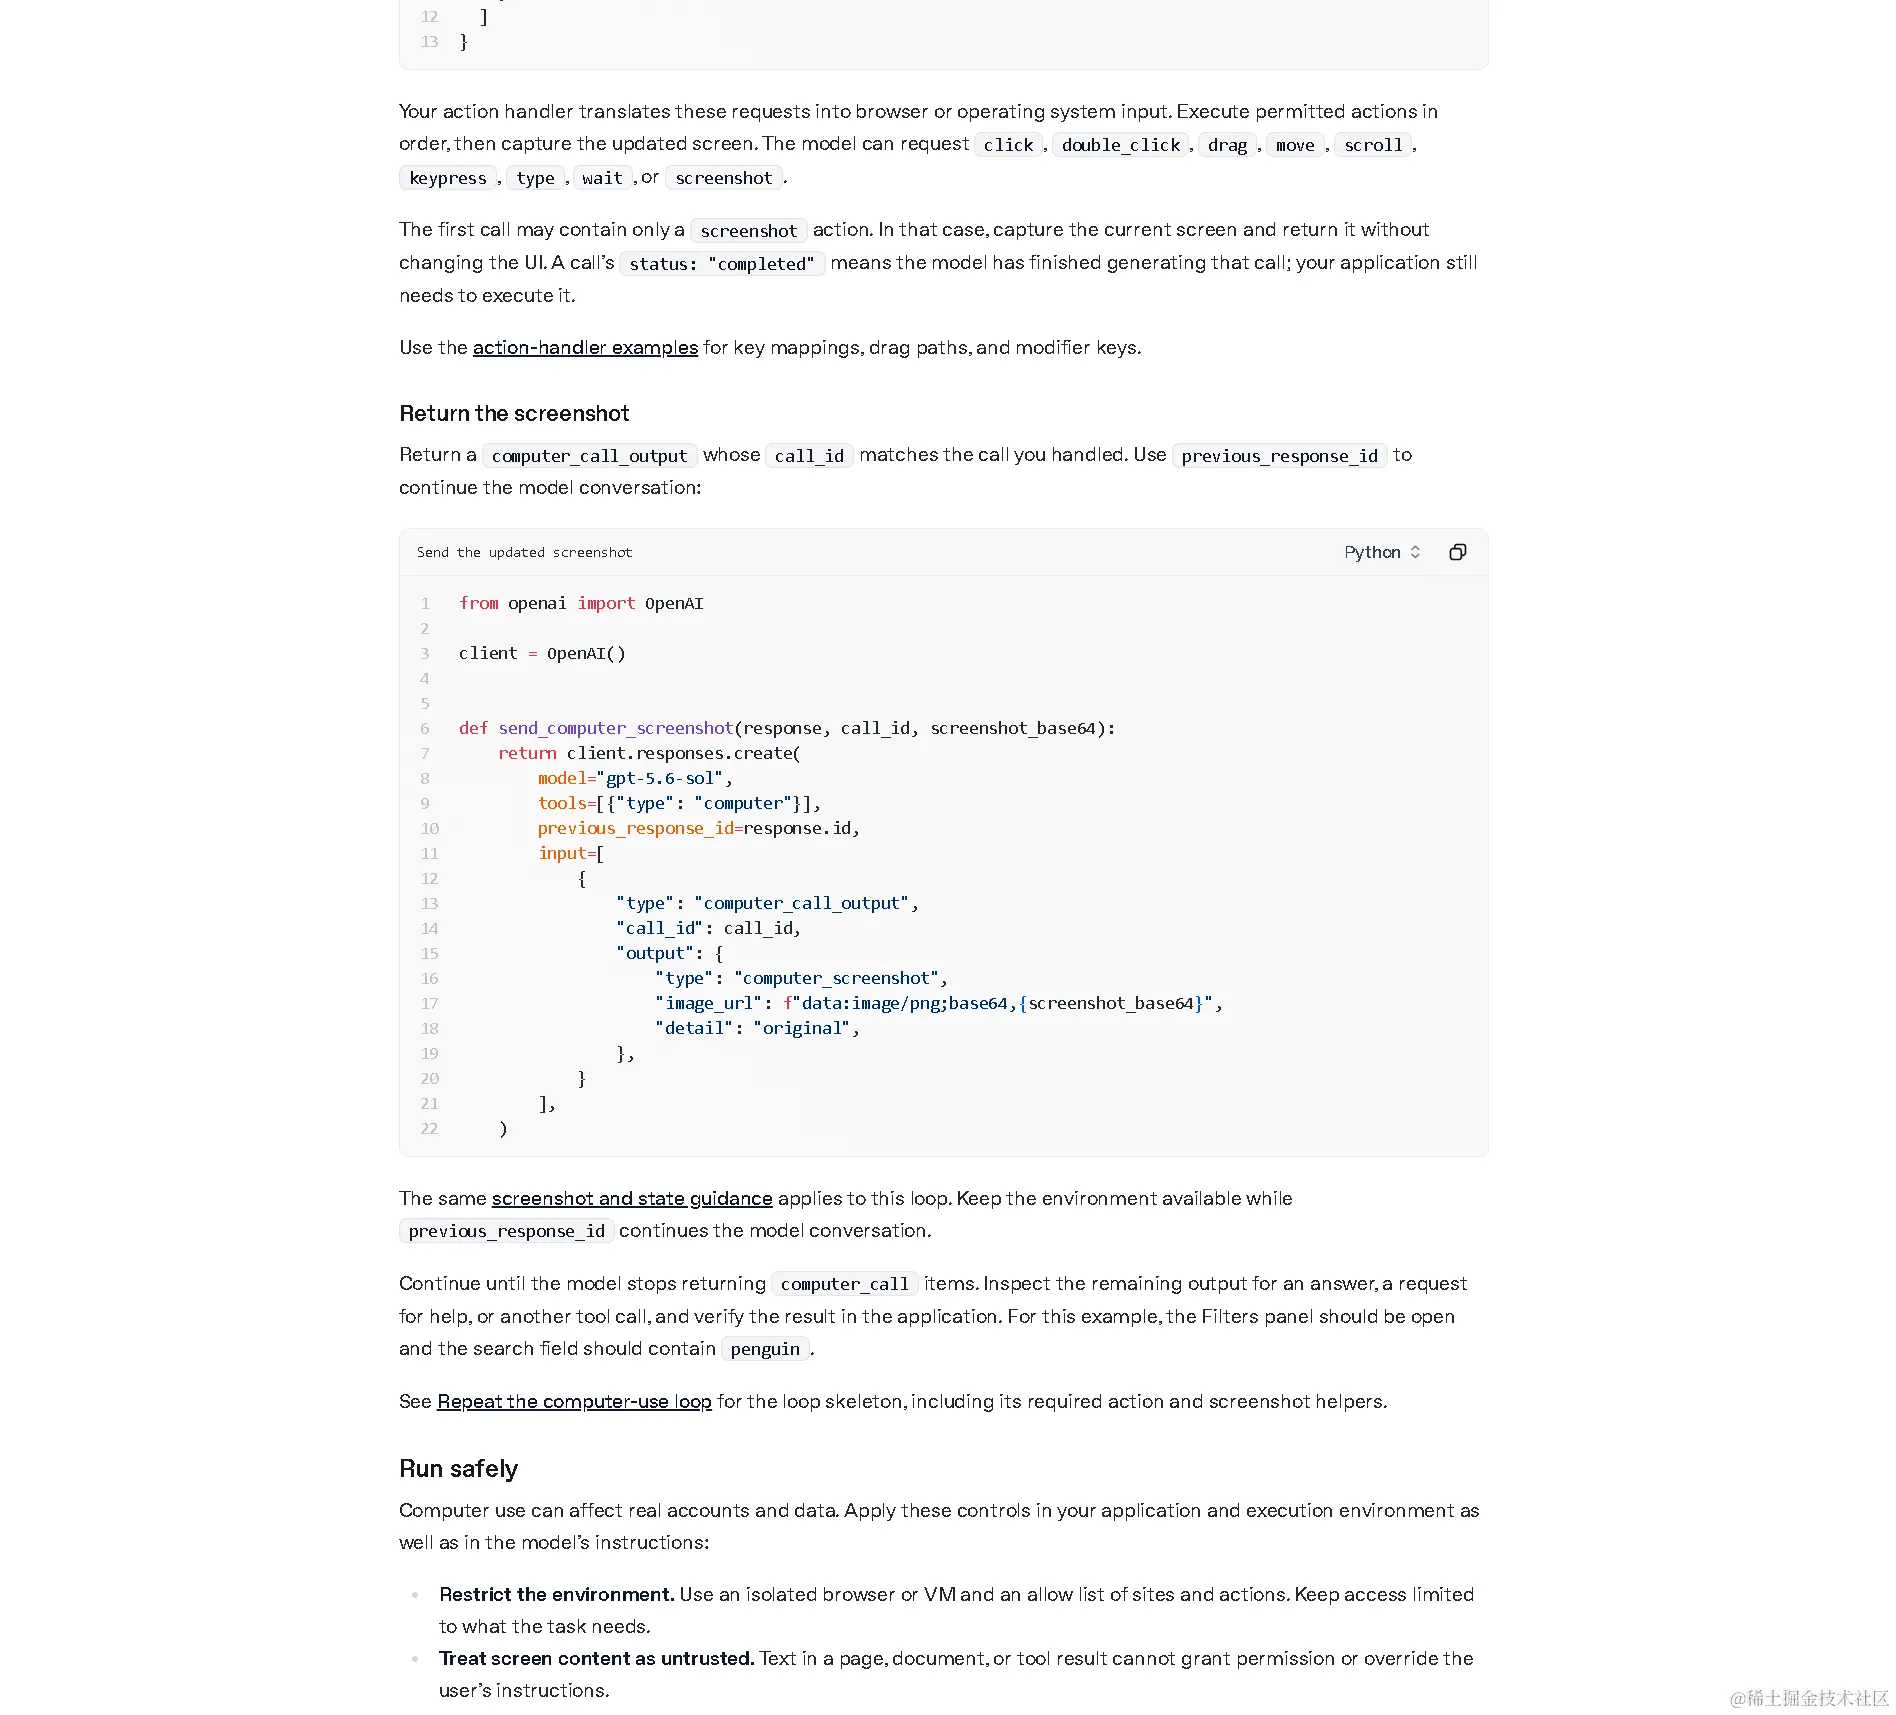
上图截自官方指南页的闭环执行与 Run safely 安全段(截图回传 + 安全确认),是上文安全字段做法的原始出处。
- 尺寸建议:桌面
1440×900/1600×900是官方实测效果最好的降采样分辨率(见官方指南"截图捕获与分辨率"一节);原生type:"computer"工具不再强制旧computer_use_preview的display_width/height参数。
动作类型 :click double_click drag keypress move screenshot scroll type wait(含 x / y / button / keys / text / scrollX / scrollY 等字段)。异步工具调用 :与 Astra 同日发布的 changelog 引入 Async tool calling(工具设 async:true,执行期间模型继续推理,结果用原 call_id 回传),配合 WebSocket 的 Mid-turn steering 使用。
官方接口文档 :Computer use 指南 developers.openai.com/api/docs/guides/tools-computer-use(新版主推 code execution,computer 工具为替代路径;集成、截图与分辨率约定见 developers.openai.com/api/docs/guides/tools-computer-use-integration 与 developers.openai.com/api/docs/guides/images-vision);模型页 platform.openai.com/docs/models/gpt-6-astra;changelog developers.openai.com/api/docs/changelog。安全确认字段(pending_safety_checks / acknowledged_safety_checks)的完整 JSON 约定见 Azure OpenAI 官方 Computer Use 文档(learn.microsoft.com/en-us/azure/foundry-classic/openai/how-to/computer-use)。
2.2 Anthropic Claude Computer Use
技术架构
- 以 Anthropic 定义的 client toolset 形式提供(新版
computer_toolset_20260801,旧版computer_20251124),schema 内置于模型、不可修改。一个 toolset 内含 17 个成员工具。 - 模型:Claude Opus / Sonnet 系列(现行 toolset 支持的具体模型清单见 §2.2 版本口径注),其中 Opus 4.7 起支持 2576px 长边视觉输入,目的就是降低 GUI 定位误差。
- 关键设计:所有动作在用户自有环境执行,Anthropic 侧不执行任何操作------模型只发出 tool_use 块,由你的 harness 去调度真实屏幕。
动作空间(坐标制)
- 坐标系统:原点 (0,0) 在屏幕左上角,X 向右增、Y 向下增,单位是像素;
- 动作族大体可以分成四类(据 Anthropic computer use 文档整理):
bash
# 观察类
screenshot              # 获取屏幕快照
cursor_position         # 查询指针当前位置

# 指针类
left_click / right_click / middle_click / double_click
mouse_move / drag

# 键盘类
type                    # 键入文本
key                     # 触发组合键

# 滚动缩放类
scroll + 方向 + 量
zoom # 放大/缩小- 坐标缩放:现行 GA 版
computer_toolset_20260801已不再接收显示尺寸参数 ------坐标一律以返回的全屏截图的像素空间为准(原点左上角,X 右增 / Y 下增);截图被缩放时须按比例映射回全屏坐标再执行,否则点击会偏移。旧版computer_20251124才需要声明display_width_px/display_height_px分辨率。这是实现里最容易踩的坑。
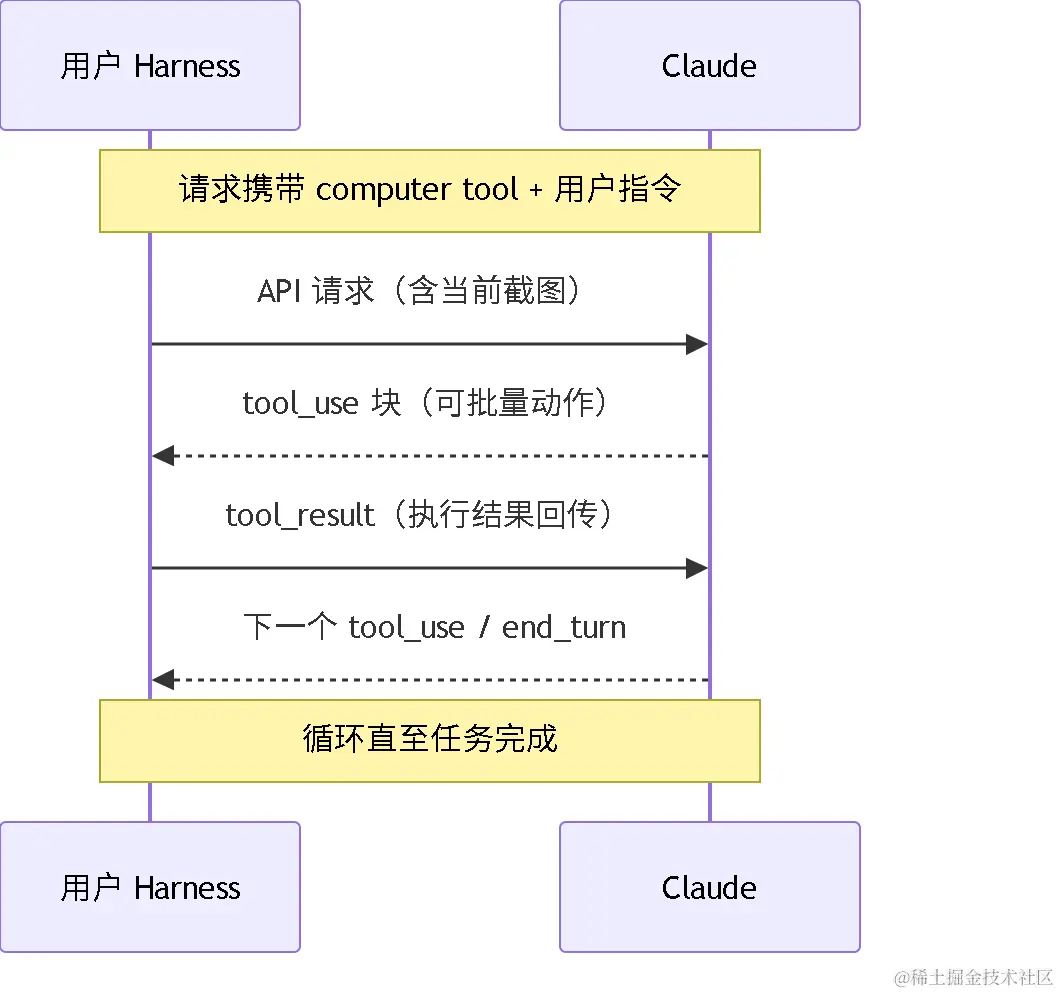
Agent Loop(由用户方实现)
- 请求携带 computer tool + 用户指令;
- Claude 返回 tool_use 块(可以批量返回多个动作);
- harness 按顺序执行,每个工具回一个 tool_result(截图以 image block 返回);
- 循环直至 end_turn。
思维控制上支持 adaptive thinking,并可用官方独立的 output_config.effort 参数(low / medium / high / xhigh / max 五档)调节思考深度。
浏览器场景的姊妹工具:browser use(browser_toolset_20260801)
- 2026-08 随 browser use 工具正式 GA,与 computer toolset 并列,内含 31 个成员工具 (其中 27 个默认启用 ,另有 4 个需显式开启 :
file_upload/javascript_exec/read_console/read_network),专门用于操作浏览器; - 感知:读取页面的 accessibility tree(AXTree) 与视口快照,而非纯像素截图;
- 动作:以元素引用 (如
ref_4这类元素 ID)定位点击,而非坐标输出------官方在产品说明中明确,浏览器场景下该方案优先于桌面坐标式方案; - 意义:Anthropic 官方自己已经在浏览器场景落地了"AXTree + 元素引用"路线,说明"Claude = 纯坐标"只是桌面形态。它本身就宣告了"结构优先、视觉兜底"的混合架构是当前收敛方向。
安全机制 :建议专用 VM/容器、最小权限、敏感数据隔离、域名白名单;模型经过抵抗 prompt injection 的训练。注:网上流传的"注入成功率 23.6% → 11.2%"出自 Anthropic 的 Claude for Chrome(浏览器扩展) autonomous mode 加安全缓解后的红队披露,并非 computer use 文档;现行 computer use 文档只描述分类器机制(扫描截图中的注入信号、命中则引导模型确认),不再给出数字统计。这个"约 1/9 仍可绕过"的数字值得对"注入防护完全可靠"的说法保持警惕。高后果动作仍需人工确认。
参考来源 :Anthropic. "Computer use tool" 官方文档(docs.anthropic.com/en/docs/agents-and-tools/computer-use)------toolset schema、坐标系统、agent loop 与安全建议均以该文档为准;Anthropic. "Browser use tool" 官方文档(platform.claude.com/docs/en/agents-and-tools/tool-use/browser-use-tool)------31 成员工具(27 默认 + 4 显式)与 browser toolset schema 均以此文档为准。版本口径说明:computer toolset 现行版本号为 computer_toolset_20260801(见 computer use 文档);"Opus 4.7 起支持 2576px 长边视觉输入"出自 Anthropic 模型发布口径------注意两个口径存在版本差:2576px 是 Opus 4.7 引入的视觉能力,而 20260801 版 toolset 的官方模型支持列表为 7 个 :claude-fable-5-1 / claude-mythos-5-1 / claude-fable-5 / claude-mythos-5 / claude-opus-5 / claude-sonnet-5 / claude-opus-4-8;Opus 4.7 / 4.6、Sonnet 4.6、Opus 4.5 不在其中,官方原句为 "Claude Opus 4.7, Claude Opus 4.6, Claude Sonnet 4.6, and Claude Opus 4.5 support computer use only through the earlier computer_20251124 tool version, which requires a beta header"------即并非"不支持",而是只能走旧版 toolset(需 beta header)。引用时需按文档口径注明版本。
2.3 Google Gemini Computer Use
技术架构
- 工具:
computer_use。Gemini 3.x 起它成为内置原生工具、无需单独模型(早期是gemini-2.5-computer-use-preview专用模型); - 环境:支持 Browser(浏览器)、Mobile(移动端)、Desktop(桌面)三类,对应
ENVIRONMENT_BROWSER / MOBILE / DESKTOP; - 执行:走类 function calling,需要客户端用 Playwright 等自行执行;官方参考实现里带 Docker 沙箱。
动作空间(归一化坐标)
- 坐标基于 1000×1000 网格,返回归一化坐标,客户端按实际视口换算成真实像素------这是和 Claude 像素坐标制的一个关键差异;
- 动作族:
open_web_browser、click_at、type_text_at、navigate、scroll_document/scroll_at、hover_at、drag_and_drop、wait_5_seconds、go_back/go_forward、key_combination、search等; - 每次响应里带 intent 字段 (解释这一步的推理原因)和 safety_decision (
regular/require_confirmation/blocked),动作不再是个黑盒,协作者能看到模型"为什么这么点"。
闭环:发送(工具 + 环境 + 指令 + 截图)→ 接收 function_call + intent + safety_decision → 客户端执行(或按需拦截)→ 捕获新截图 + URL 作为 function_response 回传 → 重复。
安全 :可配置安全策略类别与覆盖;提供 opt-in 的截图 prompt injection 检测;内置每步 safety decision 返回 regular / require_confirmation / blocked(与动作空间的 safety_decision 为同一套现行三值口径,旧文档的 ALLOWED / REQUIRES_CONFIRMATION 二值已废弃)。
基准与成本 (2.5 版自报,均未公布总分榜具体分值):WebArena 领先、Online-Mind2Web 高准确率、Mobile Control 表现强劲;定价约 1.25/10 每百万 token(preview 期口径)------截图 token 是成本开销的主要来源,这也是所有像素方案共性的成本结构。
参考来源:Google. "Computer use | Gemini API"(ai.google.dev/gemini-api/docs/computer-use)。
三、关键技术:VLM 凭什么"看图操作"
三家方案都依赖同一个核心能力:多模态模型把截图编码成视觉 token,与文本指令、历史动作一起拼进上下文里推理。但"看图操作"这件事远没有看上去简单,有三个关键点:
1. 坐标精度是真正的瓶颈。
模型需要从"看到画面"走到"给出精确坐标"。这本质上不是视觉理解问题,而是几何映射问题------输入分辨率直接决定定位精度。Claude 把截图长边上限从早期模型的 1568px(约 1.15MP)提升到 Opus 4.7 起的 2576px(约 3.75MP),连发布口径都是"降低定位误差",可见坐标准不准是这类方案的命门(注:1280×720 是当年官方"推荐分辨率",并非上限)。
2. 要不要专门微调,各家路线不同。
- OpenAI:CUA 时代明确做了 SFT + RL 两阶段训练,动作与 GUI 感知是"教出来的";现役 GPT-6 Astra 属于 reasoning model,经强化学习训练推理,并针对专业办公环境做定向训练(OpenAI 未公开全部训练管线细节);
- Anthropic:在基底模型里内置 computer tool schema,并做针对 prompt injection 的抵抗训练;
- Gemini:先出专用 preview 模型(
gemini-2.5-computer-use-preview),后续转为内置原生工具。三条路本质都是"让模型见过足够多屏幕+动作的对齐数据"。
3. 视觉 token 是成本大头。
一张高分辨率截图进入上下文,token 消耗量级是"千级别/张"(见 §4 中表格)。这意味着每一步闭环都在烧 token,任务步骤越碎、截图分辨率越高,账单涨得越快。Gemini 官方定价把截图成本列为高开销主因,是同一个原因。
四、动作空间与感知通道:三条技术路线
Computer Use 的工程实现,本质是在"用像素还是用结构"之间做取舍。主流是三套打法:
- 坐标式(像素) :模型输出 (x, y)。OpenAI / Claude / Gemini 的视觉方案都是这条。接口薄、部署简单,但每步都要视觉定位,对布局漂移、响应式排版很脆弱------页面一改版,之前学到"位置"就失效了;
- 元素引用式(Accessibility Tree) :模型输出
click(ref=e47)这样的引用,由 DOM 节点解析。确定性强、token 便宜,但脆弱于 DOM 突变,也搞不定没有 ARIA 控件的场景; - 混合式:DOM 优先、视觉兜底。这是当前生产环境收敛的方向,下一节展开。
三种定位策略的工程权衡(成本约为量级估算,供选型参考):
| 策略 | 精度 | 速度 | 成本 | 适用场景 |
|---|---|---|---|---|
| 纯视觉 LLM | 中(±10-20px) | 中(1-3s/步) | 高(1k+ token/图) | 反爬严格 / legacy 站点 / 画布类应用 |
| DOM / Accessibility Tree 选择器 | 高 | 高(<500ms) | 低(500-2k token) | 现代 SPA / 表单 |
| 混合式(DOM 优先 + 视觉兜底) | 高 | 中 | 中 | 高精度、对布局敏感的交互 |
为什么 Accessibility Tree 成了浏览器场景的生产默认:
浏览器原生 AXTree 的节点数通常只有 raw DOM 的百分之几(不同来源口径在 1%--10% 不等;本篇 §4 引用的 AgentList 按 5%--10% 估算)------典型网页折算下来数百至上千 token,而 raw DOM 往往 15k+ token。它不仅便宜,语义还清晰(role / name / state / description),确定性高。Playwright MCP、Browser-Use、Claude for Chrome 全都是"主 AXTree + 截图兜底"的混合姿势。局限也很明确:非 WCAG 合规页、Shadow DOM、画布类应用(Figma / Sheets / Canva)、z-order 遮挡都会让 AXTree 失真。
五、安全与隔离:能让它放心操作电脑的前提
让 AI 操作真实屏幕,安全问题的分量比纯代码执行更重------因为它能碰到你的真实浏览器、真实账号、真实文件。行业目前的标配是一套"三件套":
1. 沙箱 / VM / 容器隔离
- OpenAI:历史 CUA / Operator 用云端托管虚拟浏览器;现役 GPT-6 Astra 走 ChatGPT Work / Codex 桌面应用授权 + cloud browser,用户数据隔离,可一键擦除浏览数据;
- Anthropic:不代执行,要求用户自备专用 VM / 容器;
- Gemini:参考实现提供 Docker 沙箱,生产可走 Browserbase 云浏览器。
2. 敏感动作人工确认
金融交易、发信、删日历、登录、CAPTCHA------这类动作通常强制回落到人类确认。OpenAI 的 Takeover Mode(接管期操作不记录)、Anthropic 的高后果动作人工确认、Gemini 的 safety_decision 都是同一思想的不同实现。
3. prompt injection 检测
- OpenAI:实时注入监视器(命中即暂停)+ 错位监控(异步监控工具调用,触发即暂停 / 停止);
- Anthropic:自动分类器扫描截图注入信号 + 引导用户确认;官方给出的 23.6% → 11.2% 注入成功率来自 Claude for Chrome(浏览器扩展)的 autonomous mode 红队测试(加安全缓解后),现行 computer use 文档已不再给数字;
- Gemini:opt-in 截图注入检测 + 每步 safety decision(
regular/require_confirmation/blocked)。
三家的安全机制并排看:
| 机制 | OpenAI(历史 CUA / Operator 已停用;现役 GPT-6 Astra) | Anthropic Claude | Google Gemini |
|---|---|---|---|
| 沙箱方案 | 桌面应用授权 + 云端隔离 | 建议专用 VM/容器 | Docker 参考实现 |
| 敏感动作确认 | Takeover Mode 接管 | 高后果动作人工确认 | safety_decision |
| 注入防护 | 注入监视 + 错位监控,命中暂停 / 停止 | 分类器 + 用户确认 | 截图注入检测 + 安全服务 |
| 域名限制 | 网站白名单 | 建议域名白名单 | 可配置策略类别与覆盖 |
结论要客观:隔离 + 确认 + 注入检测三件套是行业标配,但注入防护目前仍非完全可靠------Anthropic 自己披露的"约 1/9 可绕过"就是证据。做产品时,不应把每一层都当成铁栅栏,而应把架构设计成"即使某一层被绕过,也伤不到用户"。
六、和相邻技术的关系:浏览器 Agent、GUI grounding 模型
Computer Use 不是孤立的,它身边至少还有两条相邻路线值得看一看。
6.1 全桌面 Computer Use vs 浏览器专用 Agent
- 全桌面 Computer Use(Claude 桌面 toolset、历史 CUA、Gemini Desktop):通用性强,能碰任何 GUI,但慢、贵、坐标脆弱;
- 浏览器专用 Agent(Browser-Use、Stagehand、Playwright MCP、Skyvern):生产更可靠------绝大多数现代网页用 DOM / Accessibility Tree 选择器就够了(经验值),定位确定、token 便宜。
这两条路不是竞争关系,而是"通用 vs 高性价比"的取舍。真实产品当下的主流做法是混合:浏览器场景走 DOM/AXTree 优先、视觉兜底;遇到画布、反爬或 legacy 站点,再退化到像素方案。
6.2 GUI grounding 专用模型:解决"语言→坐标"的瓶颈
像素方案的痛点集中在"自然语言 → 精确坐标"这一步。于是出现了一批专门的 GUI grounding 模型,它们不解决"怎么规划",只解决"到底点到哪",定位为可嵌入任意 Agent 框架的模块:
- UGround(OSU,ICLR'25 Oral):初版基于 LLaVA-NeXT(7B),用 130 万截图 / 1000 万元素的 Web 合成数据训练,纯视觉、不依赖 HTML/a11y tree,直接输出像素坐标;后续 UGround-V1 系列(2B / 7B / 72B)改用 Qwen2-VL 基底。ScreenSpot 上较当时 SOTA 提升达 20% 绝对点。配套框架 SeeAct-V 把"规划(MLLM)"与"定位(UGround)"解耦;
- ShowUI(2B):轻量 VLM,ScreenSpot 零样本 grounding 平均 75.1%,训练数据仅 256K,靠"交错视觉-动作流式"提升导航表现;
- OmniParser(Microsoft):屏幕解析工具集------检测可交互区域 + 为图标生成描述,配合 GPT-4V / GPT-4o 做 SoM(Set-of-Mark)grounding;ScreenSpot 成绩:桌面文本 91.3、图标 63.6(论文 Table 2;93.9 / 57.0 是它对 Mobile 的成绩,注意别错位);
- OS-Atlas / Aguvis / UI-TARS:大规模 GUI 基础模型,在 ScreenSpot-Pro 这类专业场景表现更强。
这批模型的定位是给"端到端厂商模型"补位的:把 grounding 从昂贵的大模型里抽出来,用轻量模型 + 低成本合成数据模块化解决,这是成本结构与闭源方案完全不同的补充路线。
七、三家方案对比总表
| 维度 | OpenAI(历史 CUA / Operator 已停用;现役 GPT-6 Astra) | Anthropic Claude Computer Use | Google Gemini Computer Use |
|---|---|---|---|
| 底座模型 | 现役 GPT-6 Astra(内置 computer_use);历史 CUA:GPT-4o 视觉 + RL | Claude Opus 5 / Sonnet 5(及 Fable / Mythos 5 系列;Opus 4.7 起 2576px 视觉输入,支持列表见 §2.2 注) | Gemini 2.5 preview → 3.x 原生内置 |
| 感知通道 | 现役:截图为主 + code execution 脚本 + 多工具混合;历史 CUA:纯像素截图(无 DOM / a11y) | 桌面:像素截图(坐标制);浏览器:browser use 读取 AXTree + 视口快照 | 截图(归一化坐标 1000×1000) |
| 动作空间 | 内置 computer 工具(click / type / scroll)+ code execution 脚本 | 桌面 computer toolset(像素坐标,17 成员工具);浏览器 browser toolset(元素引用,31 个工具) | click_at / type_text_at / navigate 等 + intent |
| 运行环境 | ChatGPT Work / Codex 桌面应用授权 + cloud browser;历史 CUA 曾用云端虚拟浏览器 | 用户自备 VM / 容器 | Docker 沙箱 / Browserbase 云 |
| 闭环 | 感知-推理-行动迭代(支持异步工具调用) | tool_use / tool_result agent loop | function_call / function_response loop |
| 安全确认 | 敏感动作接管确认 + 注入监视 / 错位监控(命中暂停或停止) | 分类器 + 用户确认 | safety_decision(regular / require_confirmation / blocked) |
| 沙箱 | 桌面应用授权 + 云端隔离 | 建议专用 VM | Docker 参考实现 |
| 基准(发布时) | 现役:OSWorld 2.0 72.6% / ScreenSpot-Pro 92.7% / AutomationBench 41.4%;历史 CUA:OSWorld 38.1% / WebArena 58.1% | 现役:OSWorld 2.0 70.2%(Claude Opus 5,据 OpenAI 发布页对比表同源,V2-Offline 子集口径);历史基线(3.5 Sonnet,screenshot-only):15 步 14.9% / 50 步放宽 22.0%(Anthropic model card addendum Table 1) | WebArena 领先 / Mind2Web 高准(2.5 版自报,均未公布具体分值) |
| 基准口径说明 | OSWorld 2.0 存在 binary 与 partial-credit 两套评分,且官方声明不同任务发布版本之间不可比;现役数字(72.6% / 70.2%)取自 OpenAI 发布页同一张对比表,历史基线(14.9% / 22.0%)另据 Anthropic model card addendum Table 1,两组口径不同、仅作并列参考 | ||
| 适用定位 | 消费 / 工作端 ChatGPT Work + API computer_use(CUA / Operator 已停用) | 开发者级桌面自动化(浏览器另走 browser use) | 浏览器 / 移动 / 桌面多环境 API |
八、结论
把整份机制梳理完,总结五个判断:
- 统一范式已经成立:三家都基于"截图/状态 → 多模态推理 → 结构化动作 → 执行回采"的闭环,差异只在感知通道(像素 vs 混合)与动作表示(坐标 vs 元素引用)两个选择轴上;
- 纯像素方案有明确代价 :坐标式视觉 Agent 通用但慢、贵、对分辨率与布局敏感。生产可靠的方向正在转向 DOM / Accessibility Tree 优先 + 视觉兜底的混合架构;OpenAI 自己也从纯 CUA 演进到"截图为主 + code execution 脚本 + 多工具混合"的形态;
- Grounding 是瓶颈,也是可模块化的机会:UGround / ShowUI / OmniParser 用低成本合成数据 + 轻量 VLM,把"语言→坐标"做成独立模块,是端到端厂商模型之外的重要补充路线;
- 安全是落地前提,且不能迷信防护:沙箱隔离 + 敏感动作人工确认 + prompt injection 检测三件套是行业标配,但注入防护并非完全可靠(Anthropic 在 Claude for Chrome 红队测试中披露仍有约 1/9 可绕过),设计上要留"即使被绕过也无害"的冗余;
- 趋势是"多技术编排":从纯视觉 Computer Use,演进到"DOM 推理 + 视觉兜底 + 确定性脚本校验"的混合编排,再叠加"探索 → 编译为确定性脚本 → 自我优化"的学习闭环。AI 用电脑这件事,正在从"像人一样手点"走向"既有人类的灵活性、又有脚本的确定性"。
主要出处
厂商官方
OpenAI(GPT-6 Astra Computer Use,截至 2026-09-07)
- OpenAI. "GPT-6 Astra 发布页"(2026-09-03,含 Computer Use 基准对比表):openai.com/index/gpt-6-astra
- OpenAI. "GPT-6 Astra System Card"(Deployment Safety Hub,含安全 / 监控性 / 训练泛述):deploymentsafety.openai.com/gpt-6-astra/
- OpenAI. "Safety overview: GPT-6 Astra":openai.com/index/safety-overview-gpt-6-astra
- OpenAI. "开发者文档 · GPT-6 Astra 模型页"(API 名 / 上下文 / 工具列表 / 定价):developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI. "Model guidance · Using GPT-6 Astra"(能力 / 异步工具 / 中途转向 / 错位监控):platform.openai.com/docs/guides/latest-model
- OpenAI. "Computer use 工具指南"(截图 + 工具结果决策、code execution 推荐、computer tool、沙箱 / 权限要求):platform.openai.com/docs/guides/tools-computer-use
- OpenAI. "Codex · Computer use(桌面应用插件)"(ChatGPT 桌面应用 Computer Use 插件:安装 / 权限 / 能力边界):learn.chatgpt.com/docs/computer-use(原 developers.openai.com/codex/app/computer-use 已 302 至此处)
- OpenAI. "ChatGPT Work / Codex 用量帮助页"(Astra 与 Work / Codex 共享配额、API key 独立计费说明):help.openai.com/zh-hans-cn/articles/20001275
- OpenAI. "API Changelog"(2026-09-03 发布条目):developers.openai.com/api/docs/changelog
- OpenAI. "Introducing Operator"(2025-01,CUA 机制、2025-07 并入 ChatGPT agent):openai.com/index/introducing-operator
- OpenAI. "Operator System Card"(2025-01-23):cdn.openai.com/operator_system_card.pdf
- OpenAI. "ChatGPT agent 发布说明"(2025-07-17,并入说明 / 站点下线):help.openai.com/en/articles/11794368-chatgpt-agent-release-notes
- OpenAI. "ChatGPT Enterprise / Edu 发布说明"(2026-07-09,ChatGPT Work 推出 / Atlas 退场):help.openai.com/zh-hans-cn/articles/10128477-chatgpt-enterprise-edu-release-notes
Anthropic(Claude Computer Use)
- Anthropic. "Computer use tool" 文档:docs.anthropic.com/en/docs/agents-and-tools/computer-use
Google(Gemini Computer Use)
- Google. "Computer use | Gemini API":ai.google.dev/gemini-api/docs/computer-use
GUI Grounding / Agent 研究
- Gou et al. "Navigating the Digital World as Humans Do: Universal Visual Grounding for GUI Agents"(UGround,ICLR'25 Oral),arXiv:2410.05243
- Lin et al. "ShowUI: One Vision-Language-Action Model for GUI Visual Agent",arXiv:2411.17465
- Lu et al. "OmniParser for Pure Vision Based GUI Agent"(Microsoft,2024),arXiv:2408.00203------屏幕解析 + GPT-4V grounding
- Wu et al. "OS-Atlas: A Foundation Action Model for Generalist GUI Agents"(2024),arXiv:2410.23218;Aguvis;UI-TARS------GUI 基础模型系列
- Cheng et al. "SeeClick: Harnessing GUI Grounding for Advanced Visual GUI Agents"(2024),arXiv:2401.10935;CogAgent(18B)
架构对比与行业分析
- Vardanyan, Aram. "Building Browser Agents: Architecture, Security, and Practical Solutions"(2025-11-22),arXiv:2511.19477
- Upton, E. & Diacono, T.(Asteroid),载 InfoWorld New Tech Forum. "When will browser agents do real work?"(2025-11-13):infoworld.com/article/4081396/when-will-browser-agents-do-real-work.html
- BestAIWeb. "DOM Trees vs Screenshots: Prerequisites and Technical Limits of Computer Use Agents in 2026"(2026):bestaiweb.ai/dom-trees-vs-screenshots-prerequisites-and-technical-limits-of-computer-use-agents-in-2026
- AgentList. "Browser Agent Data Extraction and Form Filling: From LLM Vision to DOM Selectors"(2026-07):agentlist.top/en/articles/browser-agent-data-extraction-form-filling
基准
- OSWorld(全计算机使用)、WebArena / WebVoyager(网页)、ScreenSpot / ScreenSpot-Pro(GUI grounding)、Multimodal-Mind2Web、AndroidControl、OmniACT、AITW。
(内容由AI生成,仅供参考)
本文作者,日常在公众号「围炉聊科技」分享前沿科技相关的技术文章,感兴趣可搜索关注。