8.线性回归与优化算法
线性回归
预测一个连续值,训练的时候按照和真实值的区别来作为损失
梯度下降算法
其中的η被称为超参数,不能选太大,也不能选太小;wt表示模型的参数,梯度算的是损失函数变化最大的方向,所以要沿着反方向来更新参数。
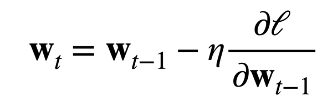
9.分类
通常会对类别做一位有效编码,y=y1,y2,...yn,结果是0,1,...就说明输出的是第二类,通常以softmax 的结果,也就是置信度最高的类别那个来作为预测的结果
softmax
所做的事情就是把原始分数压缩成一组加起来为 1 的概率(百分比),而且原来分数高的,占比会更高,得到的概率也被称为置信度
交叉熵损失
用于衡量模型预测所得的概率和真实概率之间的区别,比如模型预测结果猫,狗,兔=0.65,0.24,0.11,而真实概率却是1,0,0.而交叉熵并不是像
p−q 那样直接做差,而是通过 log 来放大差距,这样预测概率离真实概率越远,损失增长得越快,而且是指数级地快
10.感知机
单层
单层感知机只能分两类(yes/no),把几个输入加权求和,如果超过某个门槛,就输出是(1);否则输出否(0),相当于在平面上画一条分割线。
多层(MLP)
大体可以分成输入层-隐藏层-输出层,输入层接收原始数据,隐藏层提取特征,输出层综合隐藏层的结论,得出最后的结果,即这份数据代表了什么。
它与单感知层一个很大的区别就是,单感知层用阶跃函数来做分类,而多感知层用非线性激活函数,其最大的作用就是可以让网络去拟合任意复杂函数,解决非线性问题,当边界可以被扭曲模拟后,进而它可以做更多的事情,比如多分类(输出用softmax),也可以进行数据压缩。
最常用的激活函数就是relu
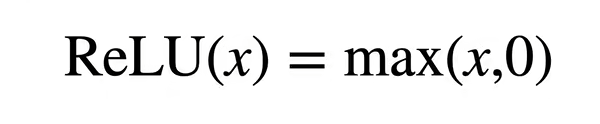
11.模型选择
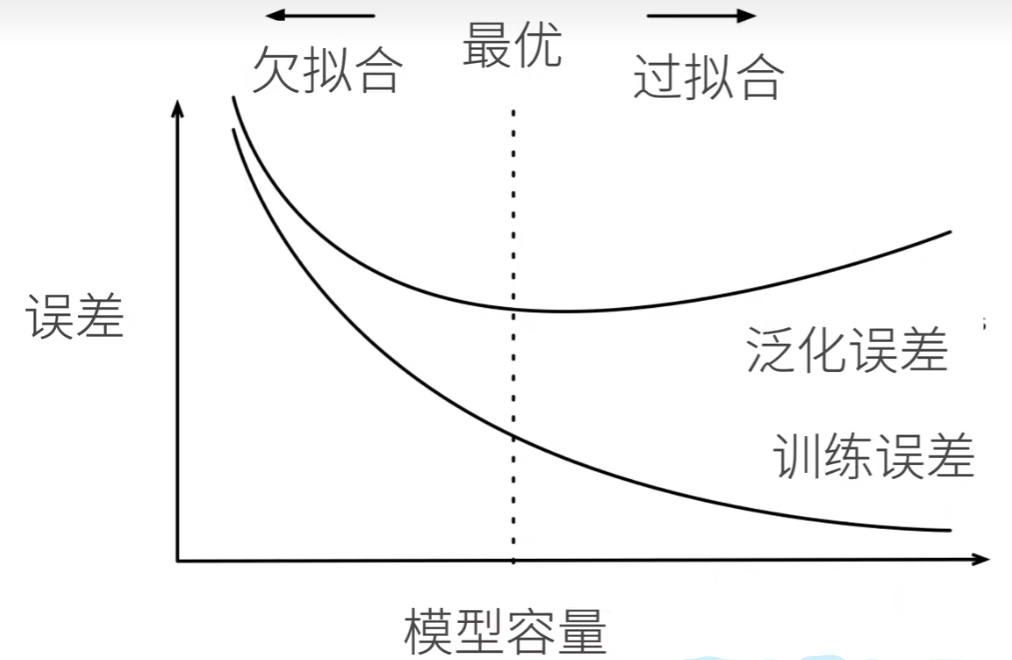
训练误差和泛化误差
训练误差:模型在训练数据上的误差
泛化误差:模型在新数据上的误差
验证数据集:通常从训练集中拿出一半左右的数据来作为验证集,用来评估模型的好坏
测试数据集:只用一次的数据集,即测试泛化误差。尤其不能在测试集上进行超参数的调整
K-则交叉验证:没有足够数据时,将数据分成k块,训练k次,每次使用第i块
来作为验证集,其他的作为训练数据集。最后取k个验证集的误差平均
欠拟合与过拟合
指的是模型容量和数据大小的关系,如果模型容量很大但是数据集很小,那就过拟合了,如果模型容量很小,数据集很大,那就欠拟合了
12.权重衰退
目的是确保模型参数不会变得过大
13.丢弃法
训练时随机暂停一部分神经元的工作,使得网络不会过分依赖某几个节点。具体的做法就是,加了 Dropout 之后,每次训练迭代时:每个神经元以概率
p(比如 0.5)被临时丢弃,输出直接置 0,被丢弃的神经元这一步不参与计算,也不更新权重。
该方法通常被用在隐藏层的输出上